

Unsupervised Learning: K-Means ile Müşteri Segmentasyonu ve Satış Anomalisi Tespiti

Label yokken model doğru cevabı değil yapıyı bulur; k-means ve anomaly detection sonuçlarının değeri iş tarafında anlam taşıyıp taşımadıklarıyla ölçülür. Bookstore müşterilerini RFM feature'larıyla k-means ile segmentlere ayırıyor, ölçeklemenin, k seçiminin ve seed'e karşı kararlılığın etkisini, günlük sipariş serisinde ML.NET'in üç anomaly detector'ının kampanyaları, kesintiyi ve fiyat hatasını nasıl ayırdığını gerçek çıktılarla gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Microsoft.ML 6.0.0 (ML.NET 6.0) ve Microsoft.ML.TimeSeries 6.0.0 ile derlenip çalıştırılmıştır. Veri, serinin seed'li generator'ıyla üretilmiş sentetik Bookstore verisidir; buradaki segmentler ve sayılar gerçek bir işletmenin sonuçları değildir.
Önce Tahmin Et
Şimdiye kadarki bütün modellerde bir label vardı: teslim süresi, iptal, yorumun konusu. Bu yazıda label yok. Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için iki soru soruyoruz: müşteriler alışveriş davranışına göre hangi gruplara ayrılıyor ve iki yıllık günlük sipariş serisinde hangi günler olağandışı?
Tahmin etmeni istediğim şey şu: müşterileri dört gruba ayırırken toplam harcama, sipariş sayısı ve son siparişten bu yana geçen gün gibi kolonları olduğu gibi k-means'e verirsen hangi kolon sonucu belirler? İkinci soru: iki yıl boyunca dört kampanya haftası olan bir seride, hiçbir ayar yapmadan çalışan bir anomaly detector'ın verdiği alarmların kaçı gerçekten bir sorunu gösterir?
Unsupervised Learning: Label Yokken Ne Öğreniyoruz?
Unsupervised learning, doğru cevabı olmayan veride yapı arar. Clustering benzer satırları gruplar, anomaly detection ise genel davranışa uymayan satırları işaretler. İkisinin de ortak sorunu değerlendirme: test setinde karşılaştıracağın bir label olmadığı için "doğru mu?" sorusunun cevabı modelden değil, iş tarafından gelir. Bu yazıdaki dosyalarda müşterinin segmentini söyleyen bir kolon da yok; generator müşterileri belirli davranışlarla üretiyor ama bunu bir kolon olarak yazmıyor. Gerçek hayattaki durum da budur.
RFM Feature'ları
Müşteri segmentasyonunda en yaygın başlangıç RFM (recency, frequency, monetary; son alışverişten bu yana geçen süre, alışveriş sıklığı ve toplam harcama). Bu üçüne Bookstore'a özgü üç kolon ekliyoruz: siparişlerin ne kadarının kampanya haftasına denk geldiği, sipariş başına ortalama kitap sayısı ve, segmentleri yorumlarken kullanmak için, iptal ve Express oranları. Her müşteri için teslim edilmiş siparişlerden bir satır üretiyoruz:
public static List<CustomerRfm> LoadRfm()
{
    List<OrderRow> orders = [.. OrderRow.Load("data/orders_clean.csv")];
    return [.. orders
        .GroupBy(o => o.CustomerId)
        .Where(g => g.Any(o => !o.IsCancelled))
        .Select(g =>
        {
            List<OrderRow> kept = [.. g.Where(o => !o.IsCancelled)];
            return new CustomerRfm
            {
                CustomerId = g.Key,
                RecencyDays = (float)(DataEnd - kept.Max(o => o.OrderedAtUtc)).TotalDays,
                Frequency = kept.Count,
                Monetary = (float)kept.Sum(o => o.OrderTotal),
                CampaignShare = kept.Count(o => o.IsCampaign) / (float)kept.Count,
                AvgItems = (float)kept.Average(o => o.ItemCount),
                CancelRate = g.Count(o => o.IsCancelled) / (float)g.Count(),
                ExpressShare = kept.Count(o => o.ShippingMethod == "Express") / (float)kept.Count,
            };
        })
        .OrderBy(c => c.CustomerId)];
}
K-Means ve Feature Scaling
K-means'in mantığı basit: k tane merkez seç, her müşteriyi en yakın merkeze ata, her merkezi kendi müşterilerinin ortalamasına taşı ve atamalar değişmeyene kadar tekrarla. "En yakın" Euclidean mesafeyle ölçülür; yani her kolonun farkı karesi alınarak toplanır. Açılıştaki ilk soruyu denemek için kolonları hiçbir dönüşüm yapmadan veriyoruz:
// 1) Ölçekleme olmadan: Monetary (binlerce TL) diğer her şeyi bastırır
MLContext ml = new(seed: 1);
IDataView data = ml.Data.LoadFromEnumerable(customers);
ITransformer raw = ml.Transforms.Concatenate("Features", "RecencyDays", "Frequency", "Monetary", "CampaignShare", "AvgItems")
    .Append(KMeans(ml, 4)).Fit(data);
Profile("k = 4, raw columns", customers, ml, raw);
dotnet run --project src/Bookstore.ML.Lab -- segmentscustomers with at least one delivered order: 3,479
k = 4, raw columns
cluster customers recency d orders spend TL campaign items cancel express
1 3,431 120 6.7 3,489 12 % 2.2 4.0 % 17 %
2 15 124 7.6 125,224 7 % 69.7 4.9 % 0 %
3 2 26 13.5 219,828 3 % 72.6 0.0 % 0 %
4 31 117 4.5 68,885 7 % 71.2 5.0 % 0 %Cevap: harcama. 3.479 müşterinin 3.431'i tek bir grupta, kalan 48 müşteri ise harcamaya göre üç ayrı gruba bölünmüş. Bu 48 müşterinin siparişi ortalama 70 kitap; bunlar Kurumsal Sipariş modülünden alışveriş eden okul ve kütüphaneler. Harcama binlerce, hatta yüz binlerce TL ile ölçülürken kampanya oranı 0 ile 1 arasında. Mesafe hesabında harcamadaki 1.000 TL'lik fark, kampanya oranındaki bütün farkları yok ediyor. Ortaya çıkan gruplar yanlış değil, ama "kim çok harcıyor?" sorusuna cevap vermek için k-means'e gerek yoktu; bir OrderBy yeterdi.
Beşinci yazıda normalization'ın linear modeller için neden önemli olduğunu görmüştük. K-means için zorunlu, çünkü algoritmanın tek ölçütü mesafe. İki adım uyguluyoruz. Sipariş sayısı, harcama ve sepet büyüklüğü sağa çarpık: çoğu müşteri az, birkaç müşteri çok sipariş veriyor. Bu kolonların log'unu alıyoruz ki 2 ile 4 sipariş arasındaki fark, 50 ile 52 arasındaki farktan büyük sayılsın. Sonra bütün kolonları ortalaması 0, varyansı 1 olacak şekilde ölçekliyoruz:
public static IEstimator<ITransformer> Scaled(MLContext ml) =>
    ml.Transforms.CustomMapping<CustomerRfm, LogRfm>((input, output) =>
        {
            output.LogFrequency = MathF.Log(1 + input.Frequency);
            output.LogMonetary = MathF.Log(1 + input.Monetary);
            output.LogAvgItems = MathF.Log(1 + input.AvgItems);
        }, contractName: null)
        .Append(ml.Transforms.Concatenate("Features", "RecencyDays", "LogFrequency", "LogMonetary", "CampaignShare", "LogAvgItems"))
        .Append(ml.Transforms.NormalizeMeanVariance("Features"));
public sealed class LogRfm
{
    public float LogFrequency { get; set; }
    public float LogMonetary { get; set; }
    public float LogAvgItems { get; set; }
}
private static IEstimator<ITransformer> KMeans(MLContext ml, int k) =>
    ml.Clustering.Trainers.KMeans(new KMeansTrainer.Options
    {
        FeatureColumnName = "Features", NumberOfClusters = k, NumberOfThreads = 1,
    });
NumberOfThreads = 1 burada da önemli. ML.NET'in XML dokümantasyonu, varsayılan paralel çalışmada sonucun deterministik olmadığını açıkça yazıyor; dördüncü yazıda SDCA (Stochastic Dual Coordinate Ascent; her adımda tek bir örnek üzerinden ilerleyen bir optimizasyon algoritması) için gördüğümüz durumun aynısı.
K Kaç Olmalı?
K-means'e grup sayısını sen veriyorsun. Bunu seçmek için üç ölçüye bakıyoruz. ML.NET'in ClusteringMetrics sınıfı iki tanesini veriyor: AverageDistance (müşterilerin kendi merkezlerine ortalama uzaklığı) ve Davies-Bouldin index'i (her grubun dağınıklığını en yakın gruba olan uzaklığıyla karşılaştıran bir ölçü; düşük olması iyi). Üçüncüsü silhouette: her müşteri için kendi grubuna ortalama uzaklık (a) ile en yakın diğer gruba ortalama uzaklık (b) karşılaştırılır, (b − a) / max(a, b) hesaplanır. 1'e yakın değer müşterinin doğru grupta olduğunu, 0 iki grubun sınırında olduğunu, negatif değer yanlış grupta olduğunu gösterir. ML.NET silhouette hesaplamıyor, birkaç satırda kendimiz yazıyoruz:
/// <summary>Ortalama silhouette: (b - a) / max(a, b); a = kendi grubuna ortalama uzaklık, b = en yakın diğer gruba.</summary>
private static double Silhouette(List<ClusterOutput> rows)
{
    int n = rows.Count;
    double total = 0;
    for (int i = 0; i < n; i++)
    {
        Dictionary<uint, (double Sum, int Count)> byCluster = [];
        for (int j = 0; j < n; j++)
        {
            if (i == j) continue;
            double d = 0;
            for (int f = 0; f < rows[i].Features.Length; f++)
            {
                double diff = rows[i].Features[f] - rows[j].Features[f];
                d += diff * diff;
            }
            (double sum, int count) = byCluster.GetValueOrDefault(rows[j].PredictedLabel);
            byCluster[rows[j].PredictedLabel] = (sum + Math.Sqrt(d), count + 1);
        }
        uint own = rows[i].PredictedLabel;
        if (!byCluster.TryGetValue(own, out (double Sum, int Count) mine)) continue;
        double a = mine.Sum / mine.Count;
        double b = byCluster.Where(c => c.Key != own).Min(c => c.Value.Sum / c.Value.Count);
        total += (b - a) / Math.Max(a, b);
    }
    return total / n;
}
// 2) Ölçeklenmiş feature'larla k seçimi: ortalama uzaklık (elbow), Davies-Bouldin ve silhouette
Console.WriteLine();
Console.WriteLine($"{"k",3}{"avg distance",14}{"Davies-Bouldin",16}{"silhouette",12}");
List<string> csv = ["k,avg_distance,davies_bouldin,silhouette"];
for (int k = 2; k <= 8; k++)
{
ml = new MLContext(seed: 1);
ITransformer model = Scaled(ml).Append(KMeans(ml, k)).Fit(data);
IDataView scored = model.Transform(data);
ClusteringMetrics m = ml.Clustering.Evaluate(scored, scoreColumnName: "Score", featureColumnName: "Features");
double s = Silhouette([.. ml.Data.CreateEnumerable<ClusterOutput>(scored, reuseRowObject: false)]);
Console.WriteLine($"{k,3}{m.AverageDistance,14:F3}{m.DaviesBouldinIndex,16:F3}{s,12:F3}");
csv.Add(string.Create(CultureInfo.InvariantCulture, $"{k},{m.AverageDistance:F4},{m.DaviesBouldinIndex:F4},{s:F4}"));
} k avg distance Davies-Bouldin silhouette
2 1.109 1.036 0.405
3 0.742 0.874 0.417
4 0.621 1.053 0.325
5 0.509 0.964 0.344
6 0.450 0.958 0.343
7 0.330 0.813 0.368
8 0.304 0.889 0.341Üç ölçü üç farklı şey söylüyor. Ortalama uzaklık k arttıkça her zaman düşer; ML.NET dokümantasyonu da bu metric'in yalnız grup sayısı artarken azaldığını hatırlatıyor. "Elbow" yöntemi bu eğride düşüşün yavaşladığı noktayı arar; burada en büyük düşüş 2'den 3'e, sonrası daha yumuşak. Silhouette en yüksek değerini k = 3'te (0,417) alıyor, Davies-Bouldin ise en düşük değerini k = 7'de (0,813). Bu tablo bir karar vermiyor, yalnız aralığı daraltıyor. Kararı segmentlerin iş tarafında bir anlam taşıyıp taşımadığına ve tekrarlanabilir olup olmadığına bakarak vereceğiz.
Segmentlere İş Anlamı Vermek
3, 4 ve 5 grup için her grubun ortalama değerlerini yazdırıyoruz. Sonra aynı k'yı farklı bir seed ile tekrar çalıştırıp müşterilerin yine aynı gruplara düşüp düşmediğine bakıyoruz:
// 3) Aday k değerleri, iş diliyle
foreach (int k in new[] { 3, 4, 5 })
{
    ml = new MLContext(seed: 1);
    uint[] labels = Profile($"k = {k}, log + NormalizeMeanVariance", customers, ml, Scaled(ml).Append(KMeans(ml, k)).Fit(data));
    Console.WriteLine($"  customers with 20+ items per order: " + string.Join(", ", customers.Zip(labels)
        .Where(x => x.First.AvgItems >= 20).GroupBy(x => x.Second).OrderBy(g => g.Key).Select(g => $"{g.Count()} in cluster {g.Key}")));
}
// 4) Aynı k, farklı seed: segmentler kararlı mı?
Console.WriteLine();
foreach (int k in new[] { 3, 4, 5 })
{
    int[] a = Assign(customers, k, seed: 1), b = Assign(customers, k, seed: 2);
    int same = 0, pairs = 0;
    Random rnd = new(5);
    for (int i = 0; i < 200_000; i++)
    {
        int x = rnd.Next(a.Length), y = rnd.Next(a.Length);
        if (x == y) continue;
        pairs++;
        if ((a[x] == a[y]) == (b[x] == b[y])) same++;
    }
    Console.WriteLine($"k = {k}, seed 1 vs seed 2: {100.0 * same / pairs:F1}% of customer pairs agree on 'same segment or not'");
}
k = 3, log + NormalizeMeanVariance
cluster customers recency d orders spend TL campaign items cancel express
1 560 83 5.8 2,820 48 % 2.2 5.3 % 9 %
2 641 347 2.8 2,183 3 % 2.9 3.9 % 22 %
3 2,278 65 7.9 5,903 5 % 3.4 3.7 % 17 %
customers with 20+ items per order: 3 in cluster 1, 10 in cluster 2, 53 in cluster 3
k = 4, log + NormalizeMeanVariance
cluster customers recency d orders spend TL campaign items cancel express
1 479 90 5.0 2,484 52 % 2.3 5.1 % 9 %
2 1,213 87 3.2 3,810 0 % 4.1 3.6 % 20 %
3 1,217 51 12.5 7,666 12 % 2.6 3.9 % 14 %
4 570 364 2.8 2,255 3 % 2.9 4.0 % 23 %
customers with 20+ items per order: 3 in cluster 1, 41 in cluster 2, 13 in cluster 3, 9 in cluster 4
k = 5, log + NormalizeMeanVariance
cluster customers recency d orders spend TL campaign items cancel express
1 671 71 6.8 3,187 35 % 2.0 5.1 % 9 %
2 1,074 91 2.7 1,576 0 % 2.4 3.7 % 20 %
3 1,076 51 12.8 10,368 7 % 4.7 3.5 % 16 %
4 562 367 2.8 2,403 3 % 3.2 4.1 % 23 %
5 96 115 2.3 918 89 % 1.8 3.7 % 12 %
customers with 20+ items per order: 2 in cluster 1, 9 in cluster 2, 44 in cluster 3, 11 in cluster 4
k = 3, seed 1 vs seed 2: 100.0% of customer pairs agree on 'same segment or not'
k = 4, seed 1 vs seed 2: 100.0% of customer pairs agree on 'same segment or not'
k = 5, seed 1 vs seed 2: 85.9% of customer pairs agree on 'same segment or not'k = 4'te dört grup okunabilir bir hikâye anlatıyor. 1 numaralı grubun siparişlerinin yarısından fazlası kampanya haftasında: kampanyayı bekleyen müşteriler (479). 3 numaralı grup ortalama 12,5 sipariş vermiş, son siparişi ortalama 51 gün önce: sadık müşteriler (1.217). 4 numaralı grubun son siparişi ortalama 364 gün önce: kaybedilmiş ya da uykudaki müşteriler (570). 2 numaralı grup az sipariş veren, kampanyaya hiç gelmeyen ve Express'i daha sık seçen müşteriler (1.213). Bu adlar modelin çıktısı değil, bizim yorumumuz; aynı tabloya bakan pazarlama ekibi başka adlar koyabilir.
Diğer seçenekler daha zayıf. k = 3'te sadık müşterilerle az sipariş verenler aynı grupta birleşiyor; silhouette'in sevdiği çözüm, pazarlama açısından iki farklı kitleyi tek kampanyaya koymak demek. k = 5'te yalnız 96 müşteriden oluşan, siparişlerinin yüzde 89'u kampanyada olan bir grup çıkıyor, ama seed değişince müşteri çiftlerinin yalnız yüzde 85,9'u aynı ilişkide kalıyor. k = 3 ve k = 4'te bu oran yüzde 100. Seed'e göre değişen bir segment tanımı, her ay yeniden eğitildiğinde müşterileri gruplar arasında rastgele gezdirir. Bu yüzden k = 4'ü seçiyoruz.
Bir de kimsenin istemediği bir sonuç var: sipariş başına 20'den fazla kitap alan 66 kurumsal müşteri hiçbir k'da kendi grubunu oluşturmuyor, dört gruba dağılıyor. Bu müşteriler sayıca az ve k-means büyük grupları bölmeyi tercih ediyor. Kurumsal müşterileri zaten hesap tipinden biliyoruz; onları clustering'e sokmadan önce bir kuralla ayırmak, modelin işini de kolaylaştırır. İptal oranının segmentler arasında yüzde 3,6 ile 5,1 arasında kalması da önemli bir bilgi: bu segmentler davranışı ayırıyor, ama yedinci yazıdaki iptal problemini tek başına çözmüyor.
Günlük Sipariş Serisi ve Anomaly Detection
İkinci problem zaman serisi. Siparişleri Türkiye saatiyle güne göre sayıyoruz: 730 gün, günde 1 ile 104 arasında sipariş, 42 kampanya günü. Microsoft.ML.TimeSeries paketi bu seri için birkaç detector sunuyor. Üçünü aynı seri üzerinde deniyoruz:
DetectIidSpike: günlerin birbirinden bağımsız ve aynı dağılımdan geldiğini varsayan IID (independent and identically distributed; her gözlemin birbirinden bağımsız ve aynı dağılımdan geldiği varsayımı) spike detector'ı. Haftalık düzeni ve büyüme trendini bilmez.DetectSpikeBySsa: SSA (Singular Spectrum Analysis; seriyi trend, mevsimsellik ve noise bileşenlerine ayıran bir yöntem) ile serinin beklenen değerini tahmin eder ve tahminden büyük sapmaları işaretler.DetectEntireAnomalyBySrCnn: Microsoft'un SR (Spectral Residual; serinin frekans spektrumundan ani değişimleri bulan yöntem) ile CNN'i (Convolutional Neural Network; evrişimli sinir ağı) birleştiren SR-CNN yöntemiyle bütün seriyi tek seferde işler.
public sealed class DailyOrders
{
    public DateTime Day { get; set; }
    public float Orders { get; set; }
    /// <summary>Aynı sayı double olarak: DetectSeasonality ve SR-CNN double, spike detector'lar float okur.</summary>
    public double OrdersAsDouble { get; set; }
    public bool IsCampaign { get; set; }
}
// 1) IidSpike günlerin bağımsız olduğunu varsayar: haftalık düzen yok, trend yok
double[][] iid = Run<SpikeOutput>(ml, series, ml.Transforms.DetectIidSpike(
"Prediction", "Orders", confidence: 99.0, pvalueHistoryLength: 28)).Select(p => p.Prediction).ToArray();
// 2) SpikeBySsa trend ve haftalık mevsimselliği ilk 120 günden öğrenir
double[][] ssa = Run<SpikeOutput>(ml, series, ml.Transforms.DetectSpikeBySsa(
"Prediction", "Orders", confidence: 99.0, pvalueHistoryLength: 28, trainingWindowSize: 120,
seasonalityWindowSize: 7)).Select(p => p.Prediction).ToArray();
// 3) SR-CNN bütün seriyi tek seferde işler; beklenen periyodu veriyoruz
IDataView sr = ml.AnomalyDetection.DetectEntireAnomalyBySrCnn(series, "Prediction", "OrdersAsDouble",
new SrCnnEntireAnomalyDetectorOptions
{
Threshold = 0.35, Sensitivity = 90, DetectMode = SrCnnDetectMode.AnomalyAndMargin, Period = 7,
});
double[][] srcnn = [.. ml.Data.CreateEnumerable<SrCnnOutput>(sr, reuseRowObject: false).Select(p => p.Prediction)];dotnet run --project src/Bookstore.ML.Lab -- anomalies730 days, 1-104 orders per day, 42 campaign days
DetectSeasonality: period = -1, with randomnessThreshold 0.5: -1
detector alerts in campaign in December other days
IidSpike 7 3 0 4
2025-06-14 Sat 1 orders
2025-08-23 Sat 10 orders
2026-02-03 Tue 104 orders
2026-07-27 Mon 53 orders
SpikeBySsa 12 3 1 8
2025-03-04 Tue 13 orders
2025-06-14 Sat 1 orders
2025-06-16 Mon 47 orders
2025-08-21 Thu 16 orders
2025-08-24 Sun 37 orders
2026-02-03 Tue 104 orders
2026-02-04 Wed 33 orders
2026-09-15 Tue 44 orders
SrCnn 3 2 0 1
2026-02-03 Tue 104 ordersKoddaki iki tip ilk denemede hata verdi. Spike detector'lar float kolon okuyor; DetectSeasonality ve SR-CNN ise double. Yanlış tipte kolon verince sınıfın kendisi değil, ML.NET'in getter'ı InvalidOperationException fırlatıyor; bu yüzden sayıyı iki kolonda tutuyoruz. İkinci sorun platformla ilgili: Microsoft.ML.TimeSeries, Intel'in MKL (Math Kernel Library; Intel'in optimize edilmiş matematik kütüphanesi) kütüphanesine bağlı ve bu kütüphanenin NuGet paketinde yalnız x64 ve x86 işlemciler için derlenmiş dosyalar var. Microsoft Learn'deki "Install extra ML.NET dependencies" sayfasına göre Windows'ta ek kurulum gerekmiyor; Linux'ta ise MKL'nin kullandığı OpenMP kütüphanesi (libiomp5.so) ayrıca kurulmalı. Bu bölümdeki çıktıları altıncı yazıdaki gibi Linux x64 bir container'da aldım; container'da libiomp5.so olarak LLVM'in (açık kaynak derleyici altyapısı projesi) OpenMP kütüphanesini bağladım. Windows'ta çalıştırmadım. K-means bölümü bu bağımlılığa ihtiyaç duymuyor ve container'da birebir aynı sonucu verdi.
Alarmları Değerlendirmek
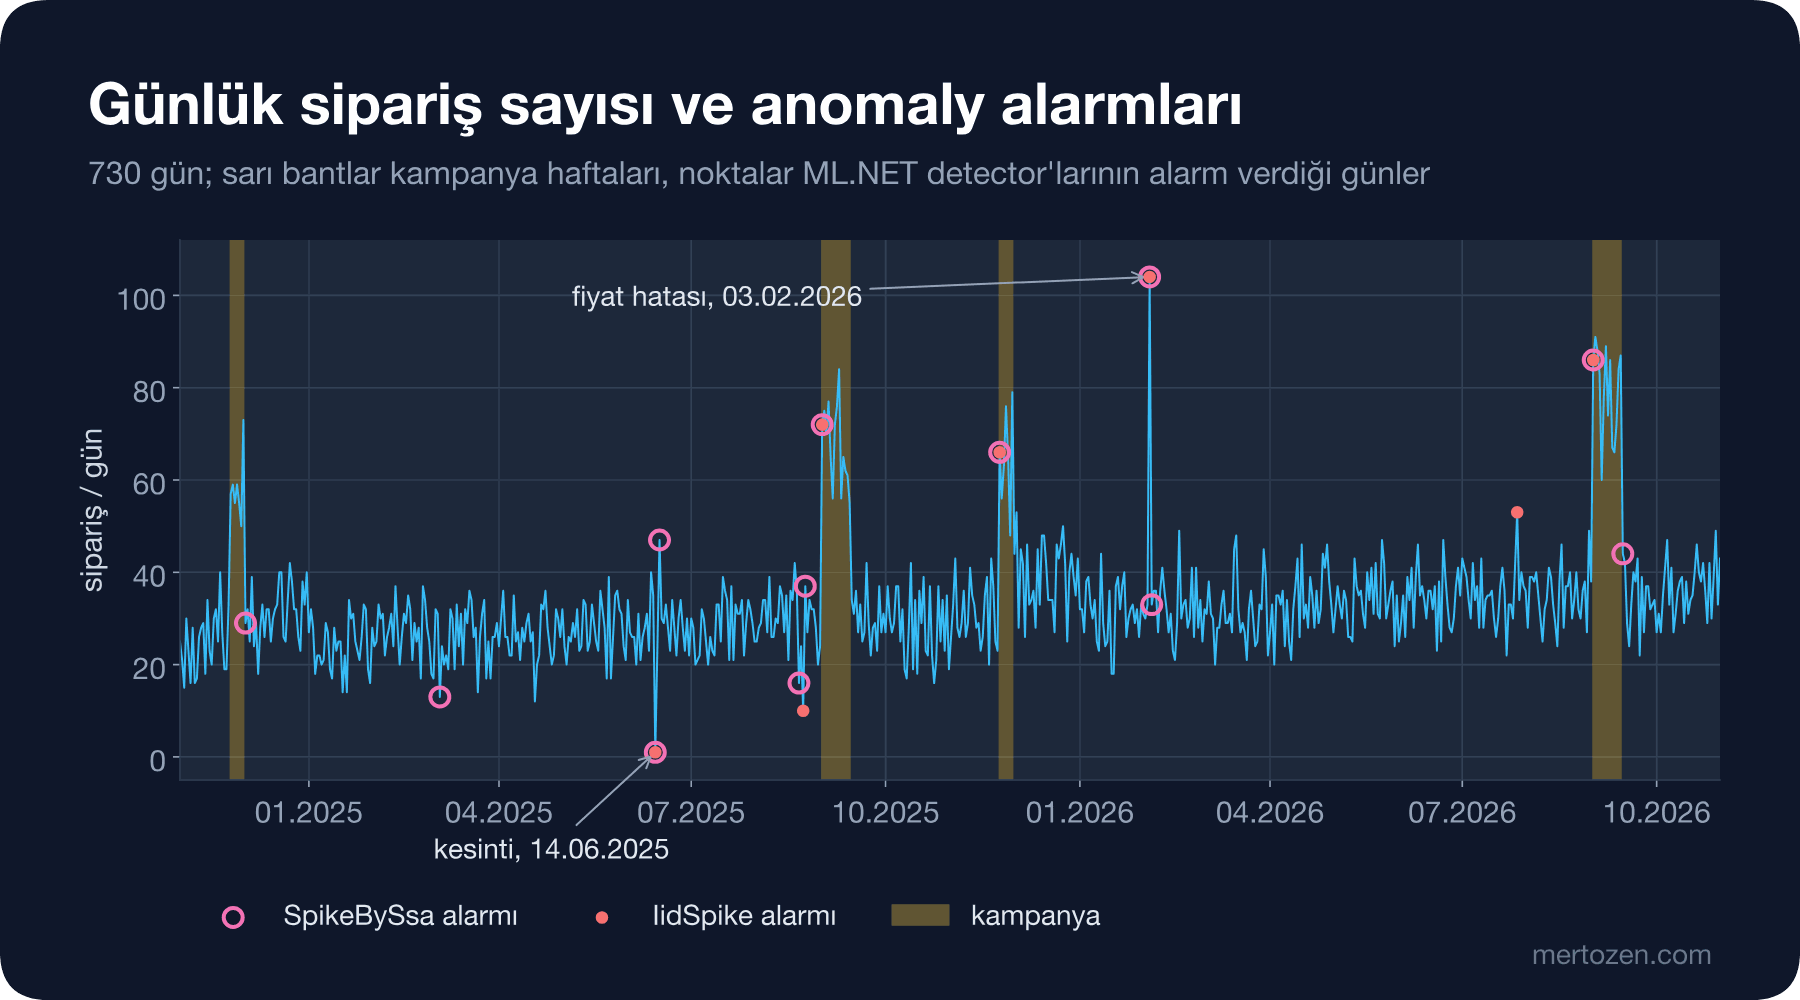
Label olmadığı için alarmları bilinen olaylarla karşılaştırıyoruz. Bu sentetik veride iki gün bilerek bozuk: 14 Haziran 2025'te site kesintisi nedeniyle yalnız 1 sipariş gelmiş, 3 Şubat 2026'da ise yanlış girilen bir fiyat yüzünden 104 sipariş. Gerçek hayatta bu bilgi olay kayıtlarından ya da operasyon ekibinden gelir. Kampanya haftaları da biliniyor: IsCampaign kolonu veride var.
Açılıştaki ikinci sorunun cevabı tabloda. DetectIidSpike 7 alarm veriyor. 3'ü kampanya haftalarının ilk günleri: sipariş sayısı bir gecede iki katına çıkıyor ve detector bunu olağandışı buluyor, ama bu bilinen, planlı bir olay. Kalan 4 alarmın 2'si gerçek olaylar, 2'si (23 Ağustos 2025'te 10 sipariş, 27 Temmuz 2026'da 53 sipariş) gürültünün uç değerleri. Yani 7 alarmdan 2'si işe yarıyor. DetectSpikeBySsa 12 alarm veriyor ve iki olayı da yakalıyor, ama bir yan etkisi var: büyük bir sapmadan sonraki günü de işaretliyor (16 Haziran 2025, 4 Şubat 2026), çünkü serinin beklenen değerini hesaplarken önceki günün aşırı değerini de kullanıyor. SR-CNN en sessizi: 3 alarm, yalnız fiyat hatasını buluyor ve kesintiyi kaçırıyor. Daha düşük bir Threshold kesintiyi yakalayabilir ama alarm sayısını da artırır; yedinci yazıdaki precision ve recall dengesi burada da geçerli.
Bir not daha: DetectSeasonality haftalık bir periyot bulamadı ve -1 döndü. Haftalık fark var ama günlük noise'a göre küçük: ortalama günde 33 sipariş civarında, günler arası rastgele dalgalanma haftanın günleri arasındaki farktan büyük. "Veride mevsimsellik var mı?" sorusunun cevabı, kullandığın ölçüye ve eşik değerine bağlı.
Üretimde Dikkat
Segmentleri bir kez üretip sonsuza kadar kullanma. Müşteri davranışı değişir, yeni müşteriler gelir, k-means her yeniden eğitimde grup numaralarını farklı verebilir. Grup numarası yerine merkezlerin iş anlamını (kampanya oranı yüksek, son sipariş eski) sakla ve yeni modelin gruplarını eskileriyle merkezlerine göre eşleştir.
Anomaly alarmlarını doğrudan bir kişiye gönderme. Önce bilinen olayları (kampanya takvimi, bayramlar, planlı bakım) ayıran bir filtre koy, kalan alarmları bir hafta boyunca yalnız kaydet ve kaç tanesinin gerçek bir olaya karşılık geldiğini say. Gereksiz alarm üreten bir detector, ekibin bütün alarmları görmezden gelmesine yol açar.
Bu detector'lar seriyi sırayla işliyor. Üretimde her gün yeni bir nokta gelir; DetectSpikeBySsa gibi detector'ların state'i vardır ve ML.NET bunun için TimeSeriesPredictionEngine ile CheckPoint method'unu sunuyor. Biz burada geçmiş seriyi toplu olarak işledik; günlük kullanımda modelin state'ini saklamak gerekir.
Platform bağımlılığını deploy'dan önce doğrula. MKL'ye bağlı paketler ARM64 (telefonlarda ve yeni dizüstü bilgisayarlarda yaygın, sunucularda da artan işlemci mimarisi) sunucuda ya da OpenMP'si eksik bir Linux image'ında çalışmaz ve hata ancak ilk çağrıda ortaya çıkar.
Sık Düşülen Tuzaklar
İlk tuzak, clustering sonucunu "doğru gruplar" sanmak. K-means her zaman k grup üretir; veride gerçekten dört grup olmasa da. Segmentlerin değeri, iş tarafında farklı bir aksiyona yol açıp açmadıklarıyla ölçülür: kampanya bekleyen müşteriye kampanya duyurusu, uykudaki müşteriye geri kazanma teklifi.
İkincisi, ölçeklemeden k-means çalıştırmak. Ham kolonlarla 3.479 müşterinin 3.431'i tek gruba düştü ve sonuç yalnız harcamayı yansıttı.
Üçüncüsü, k'yı tek bir metric'le seçmek. Silhouette 3 dedi, Davies-Bouldin 7 dedi, elbow belirsizdi. Seed'e karşı kararlılık ve iş anlamı en az bu sayılar kadar önemli.
Dördüncüsü, mevsimselliği ve planlı olayları anomali saymak. Kampanya başlangıçları ve Aralık yoğunluğu istatistik olarak olağandışı, iş açısından beklenen günlerdir. Detector'ı bu günleri bilen bir filtreyle birlikte kullan.
Beşincisi, küçük ama önemli grupları k-means'ten beklemek. 66 kurumsal müşteri kendi grubunu oluşturmadı. Bildiğin bir ayrımı kural olarak uygula, k-means'i bilmediğin yapıyı aramak için kullan.
Küçük Bir Deneme
★☆☆ Scaled pipeline'ından log dönüşümünü çıkar, yalnız NormalizeMeanVariance kalsın. k = 4 segmentleri nasıl değişiyor? Kurumsal müşteriler bu kez ayrı bir grup oluşturuyor mu?
★★☆ Sipariş başına 20'den fazla kitap alan müşterileri clustering'den önce ayır ve kalan müşterilerle silhouette tablosunu yeniden hesapla. En iyi k değişiyor mu?
★★★ DetectSpikeBySsa çağrısında confidence değerini 95 ve 99,5 yap. Her değer için kampanya dışındaki alarmları say ve iki bilinen olaydan kaçını yakaladığını yaz. Bulduğun sonucu precision ve recall cinsinden ifade et.
Bir sonraki yazıda model seçimini otomatikleştiriyoruz: hyperparameter ile parameter farkını, grid ve random search'ü, ML.NET AutoML API'sini ve mlnet CLI'ını iptal tahmini problemi üzerinde deneyecek, Permutation Feature Importance ile modelin hangi feature'lara dayandığına bakacak ve hassas feature'ların yarattığı fairness sorunlarını konuşacağız.