

Makine Öğrenmesi Nedir ve Ne Zaman Gerekir? Kural, ML ve LLM Arasında Doğru Seçim

Machine learning, kuralı senin yazdığın değil, geçmiş veriden öğrenilen bir fonksiyondur; elinde etiketli veri ve ölçülebilir bir hedef varsa işe yarar. Bookstore'un teslim süresi için elle yazılmış bir kuralı seed'li sentetik veride ölçüyor, problem tiplerini (regression, classification, clustering, anomaly detection) Bookstore örnekleriyle eşliyor ve klasik ML, deep learning ile LLM arasındaki seçimi konuşuyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ile derlenip çalıştırılmıştır. Serideki veri seti, serinin seed'li generator'ıyla üretilmiş sentetik veridir; gerçek bir şirketin verisi ya da iş sonucu değildir.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için sipariş ekranına "tahmini teslim süresi" yazman isteniyor. Elinde iki yıllık sipariş geçmişi var ama acele var, bu yüzden makul görünen bir kural yazıyorsun: depoya 100 km'den yakınsa 1 gün, 500 km'ye kadar 2 gün, 1000 km'ye kadar 3 gün, daha uzaksa 4 gün; Express kargo bir gün kısaltır, stokta olmayan bir kitap varsa beş gün eklenir.
Bu kural teslim edilmiş 23.202 siparişte ortalama kaç gün yanılır? Siparişlerin yüzde kaçında tahmin gerçek süreye bir gün yakın kalır? Bir sayı söyle, sonra okumaya devam et. Cevabı birkaç bölüm sonra gerçek çalıştırmayla göreceğiz.
Kural Yazmak mı, Veriden Öğrenmek mi?
Klasik yazılımda kuralı sen yazarsın. Girdi gelir, if/else ve switch'lerin onu işler, çıktı üretilir. Yukarıdaki teslim süresi kuralı da böyle:
public static double EstimateDays(OrderRow o)
{
    double days = o.DistanceKm switch
    {
        < 100 => 1,
        < 500 => 2,
        < 1000 => 3,
        _ => 4,
    };
    if (o.ShippingMethod == "Express") days -= 1;
    if (o.HasBackorderItem) days += 5;
    return Math.Max(1, days);
}
Machine learning (ML) bu ilişkiyi tersine çevirir. Kuralı yazmak yerine sisteme girdileri ve o girdilerde gerçekten ne olduğunu, yani geçmişteki doğru cevapları verirsin; algoritma bu ikisini birbirine bağlayan fonksiyonu kendisi bulur. Buna model denir. Sonra model, daha önce görmediği bir sipariş için cevabı tahmin eder. Kuralın içindeki 100, 500, 1000 ve 5 gibi sayıları sen seçmezsin; veriden öğrenilir.
Bu tanımın bir sonucu var: ML'in kalitesi hiçbir zaman verinin kalitesini geçemez. Elinde geçmiş siparişler, bu siparişlerin özellikleri ve gerçekleşen teslim süreleri yoksa öğrenilecek bir şey de yoktur. ML, kural yazmanın yerine geçen sihirli bir kısayol değil; yazılması zor kuralları veriden çıkarmanın bir yolu.
Bu seride ML'i bir .NET geliştiricisinin gözünden anlatıyorum. Matematik ispatı yok; doğru soruyu sormak, veriyi doğru hazırlamak ve modeli doğru ölçmek var. Kodlar ML.NET ile yazılıyor, serinin sonunda aynı problemi Python'daki scikit-learn ile çözüp ONNX (farklı framework'lerin modellerini taşımaya yarayan açık model formatı) üzerinden .NET'e taşıyacağız.
Serinin Verisi: Sentetik Bookstore Siparişleri
ML örneklerinin çoğu internetten indirilen hazır veri setleriyle anlatılır: Titanic yolcuları, ev fiyatları, iris çiçekleri. Bu seride ise bütün örnekler Bookstore'un siparişleri üzerinde dönüyor. Gerçek bir kitapçının sipariş verisini yayınlamak mümkün olmadığı için veriyi kendimiz üretiyoruz ve bunu baştan açıkça söylüyorum: yazılardaki her sayı bu sentetik veriden gelir. "Kargo firması şu kadar gecikti" gibi bir cümle gerçek bir şirket hakkında değil, generator'ın içine koyduğumuz kurallar hakkındadır.
Generator, repodaki tools/Bookstore.DataGen projesi. 2024-11-01 ile 2026-10-31 arasındaki iki yıl için 4.000 müşteri, siparişler, sipariş satırları ve müşteri yorumları üretiyor. Siparişlerin teslim süresi, iptal edilip edilmediği ve iade edilip edilmediği, kodun içinde yazılı ama yazılarda modele hiç gösterilmeyen kurallarla belirleniyor: depoya uzaklık, kargo firması, hafta sonu, kampanya haftaları, stokta olmayan kitaplar ve rastgele noise. Modellerin işi bu kuralları veriden yeniden keşfetmek. Serinin sonuna kadar Generator.cs dosyasını okumamanı öneririm; okursan modelin ne bulması gerektiğini önceden bilirsin ve ölçümler sana sürpriz yapmaz.
Veriyi üretmek için repoyu klonladıktan sonra tek komut yeterli:
dotnet run --project tools/Bookstore.DataGenseed 2026: 4000 customers, 24290 order rows, 5070 reviews
customers.csv 861f69f58de84d0a
orders.csv c402ea25e0019381
order_items.csv 7ae098da3de8756c
reviews.csv 7383faaa046d6089Çıktının son dört satırı, üretilen dosyaların SHA256 özetinin ilk 16 karakteri. Aynı seed (2026) ile senin makinende de bu dört değer birebir aynı çıkmalı. Bunun için generator System.Random kullanmıyor: .NET dokümanı, seed verilmiş bir Random'ın farklı .NET sürümlerinde farklı bir sayı dizisi üretebileceğini açıkça belirtiyor. Onun yerine SplitMix64 adlı küçük ve tanımı belli bir pseudo-random generator'ı elle yazdım:
public ulong NextUInt64()
{
    _state += 0x9E3779B97F4A7C15UL;
    ulong z = _state;
    z = (z ^ (z >> 30)) * 0xBF58476D1CE4E5B9UL;
    z = (z ^ (z >> 27)) * 0x94D049BB133111EBUL;
    return z ^ (z >> 31);
}
/// <summary>[0, 1) aralığında düzgün dağılımlı bir double.</summary>
public double NextDouble() => (NextUInt64() >> 11) * (1.0 / (1UL << 53));
Sayılar yalnız toplama, çarpma ve bölmeyle üretiliyor; Math.Log ya da Math.Sin gibi sonucu işlemciye göre son basamakta değişebilecek fonksiyonlar kullanılmıyor. Dosyalar her platformda \n satır sonu ve invariant culture ile yazılıyor. Bu kurguyu Linux x64 bir container'da da çalıştırdım, dört hash birebir aynı çıktı.
data/orders.csv dosyasının ilk satırları şöyle görünüyor:
OrderId,CustomerId,OrderedAtUtc,City,District,Warehouse,DistanceKm,Carrier,ShippingMethod,ItemCount,TotalWeightKg,OrderTotal,DiscountRate,IsCampaign,PaymentMethod,HasBackorderItem,CustomerNote,IsCancelled,DeliveryDays,TrackingEventCount,IsReturned,ReturnRequestedUtc
O000001,C03947,2024-11-01T05:16:00Z,Izmir,IZM-20,IST-1,480,CarrierA,Standard,1,0.38,209.80,0.00,false,CreditCard,false,,false,2.82,5,false,
O000002,C01509,2024-11-01T05:21:30Z,Istanbul,IST-16,IST-1,25,CarrierA,Standard,1,0.55,269.80,0.00,false,CreditCard,false,,false,1.11,4,false,
Her satır bir sipariş. Siparişin tarihi, şehri, hangi depodan çıktığı, depoya uzaklığı, kargo firması, kitap sayısı, tutarı, ödeme yöntemi, müşterinin teslimat notu ve sonunda o siparişte gerçekte ne olduğu: DeliveryDays, IsCancelled, IsReturned. Dosyada bilerek bırakılmış veri kalitesi sorunları da var; onları bir sonraki yazıda tek tek bulacağız.
Kuralın Gerçek Veride Karnesi
Şimdi açılıştaki kuralı bu veride ölçelim. Bookstore.ML.Lab projesi serinin bütün deneylerini barındıran bir console uygulaması; her yazı ona bir komut ekliyor:
dotnet run --project src/Bookstore.ML.Lab -- rulesDelivered orders : 23,202
Mean absolute error : 1.05 days
Within +/- 1 day : 63.1 %
Off by 3+ days : 2.9 %
Where the rule is wrong the most (mean error by group):
CarrierC ordered Fri/Sat=True bias -1.86 days (1,163 orders)
CarrierA ordered Fri/Sat=True bias -1.63 days (2,637 orders)
CarrierB ordered Fri/Sat=True bias -1.62 days (2,037 orders)
CarrierC ordered Fri/Sat=False bias -0.70 days (3,530 orders)
CarrierA ordered Fri/Sat=False bias -0.43 days (7,739 orders)
CarrierB ordered Fri/Sat=False bias -0.41 days (6,096 orders)Kural ortalama 1,05 gün yanılıyor ve siparişlerin yüzde 63,1'inde gerçek süreye bir gün yakın kalıyor. Tahminin daha iyi miydi, daha kötü mü? Her iki durumda da önemli olan şu: bu sayıyı ölçmeden "kural fena değil" demek mümkün değildi. Bu seride her modeli bu tür basit bir referansla, yani baseline ile karşılaştıracağız. Bu kural da ilk baseline'ımız.
Çıktının ikinci kısmı daha ilginç. Kural, cuma veya cumartesi verilen siparişlerde her kargo firması için yaklaşık 1,6–1,9 gün eksik tahmin ediyor. Negatif bias tahminin gerçekten kısa kaldığı anlamına geliyor. Kuralı yazan kişi deponun hafta sonu çalışmadığını hesaba katmamış. Bunu da bir if ile düzeltebilirsin. Ama sonra saat kaçtan sonra verilen siparişin ertesi güne kaldığını, kampanya haftalarında depoların yavaşladığını, bir kargo firmasının belli bir tarihten sonra yavaşladığını da eklemen gerekecek. Her yeni kural öncekilerle etkileşir ve hangi sayının doğru olduğunu yine veriye bakarak bulursun. Bu noktada kuralları elle yazmak yerine veriden öğrenmek daha mantıklı hâle gelir.
Supervised, Unsupervised ve Reinforcement Learning
ML problemleri, elindeki verinin doğru cevabı içerip içermediğine göre üç büyük gruba ayrılır.
Supervised learning'de her örnek için doğru cevap bilinir. Bu cevaba label denir. Teslim süresi tahmininde label DeliveryDays; model, geçmiş siparişlerin özelliklerinden bu sayıya giden yolu öğrenir. Tahmin edilen değer bir sayıysa probleme regression, bir kategori ise classification denir. "Bu sipariş iptal edilecek mi?" iki sınıflı (binary) bir classification problemi, "bu yorum kargo hakkında mı, fiyat hakkında mı, içerik hakkında mı?" ise ikiden fazla sınıflı (multiclass) bir classification problemi.
Unsupervised learning'de label yoktur. Müşterileri harcama ve sipariş alışkanlıklarına göre gruplara ayırmak istediğinde kimse sana "bu müşteri şu gruptandır" diye bir liste vermez. Algoritma benzer örnekleri bir araya toplar; buna clustering denir. Günlük satış grafiğinde olağan dışı bir günü yakalamak, yani anomaly detection, da çoğu zaman label'sız yapılır.
Reinforcement learning'de ise bir agent bir ortamda aksiyon alır ve aldığı ödüle göre davranışını değiştirir. Oyun oynayan programlar ve robotik bu alanın klasik örnekleri. Bu seride reinforcement learning'e girmiyoruz; Bookstore'un günlük problemlerinin neredeyse tamamı ilk iki gruba giriyor.
Bookstore Problem Kataloğu
Seri boyunca çözeceğimiz problemleri ve her birinin tipini aşağıdaki tabloda topladım. Bir ML projesine başlamadan önce bu tabloyu kendi problemin için doldurmak çok iş görür: neyi tahmin ettiğini, label'ın nereden geldiğini ve hangi yazıda neyi göreceğini netleştirir.
| Soru | Problem tipi | Label | Yazı |
|---|---|---|---|
| Bu sipariş kaç günde teslim edilir? | regression | DeliveryDays | 03–06 |
| Bu sipariş iptal edilecek mi? | binary classification | IsCancelled | 07 |
| Bu yorum hangi konuda? | multiclass classification | Topic | 07 |
| Müşteriler hangi gruplara ayrılıyor? | clustering | yok | 08 |
| Bugünkü satış sayısı olağan dışı mı? | anomaly detection | yok | 08 |
Listede olmayan bir problem de var: "bu müşteriye hangi kitabı önerelim?" Recommendation, kullanıcı ve ürün arasındaki etkileşimlerden öğrenen, kendine özgü algoritmaları ve ölçüm yöntemleri olan ayrı bir alan. Örneğin bir öneri sisteminin başarısı tek bir tahminin doğruluğuyla değil, önerilen listenin sırasıyla ölçülür. Bu seri recommendation'a girmiyor.
Klasik ML, Deep Learning ve LLM
"Yapay zeka" denince bugün çoğu kişinin aklına önce LLM'ler geliyor. Haritayı kabaca şöyle çizebiliriz. Klasik ML; linear modeller, karar ağaçları, ağaç topluluklarına dayanan boosting yöntemleri ve k-means gibi algoritmalardan oluşur ve en çok tablo şeklindeki veride, yani satır ve kolonlardan oluşan verilerde kullanılır. Deep learning, çok katmanlı neural network'leri eğitir; görüntü, ses ve büyük metin koleksiyonları gibi yapısı karmaşık veride güçlüdür, çoğunlukla GPU (paralel hesap için tasarlanmış ekran kartı işlemcisi) ister. LLM'ler ise deep learning'in metin üzerinde çok büyük ölçekte eğitilmiş bir dalıdır. LLM'in nasıl çalıştığını LLM Temelleri serisinin ilk yazısında anlattık; bu seride deep learning'i ve LLM'leri yalnız bu haritadaki yerleriyle anıyoruz.
Klasik ML'in LLM'den daha uygun olduğu yerler net. Birincisi tablo verisi: bir siparişin mesafesi, kargo firması ve sipariş saati gibi kolonlardan sayı tahmin etmek için tasarlanmış algoritmalar bu işte bir dil modelinden hem daha doğru hem çok daha ucuzdur. İkincisi maliyet ve latency: eğittiğimiz modeller bu seride birkaç kilobayt ile birkaç yüz kilobayt arasında bir dosya olacak, tahmin sıradan bir CPU'da uygulamanın kendi process'i içinde çalışacak; ağ çağrısı ve token ücreti yok. Üçüncüsü determinism: aynı model aynı girdiye her seferinde aynı cevabı verir. Dördüncüsü açıklanabilirlik: hangi feature'ın tahmini ne kadar etkilediğini ölçebilirsin. Bunu dokuzuncu yazıda yapacağız.
LLM'in daha uygun olduğu yerler de var: etiketli veri yokken metnin özetini çıkarmak, serbest metinden bilgi çıkarmak, kullanıcıyla doğal dille konuşmak. İkisi birbirinin rakibi değil. Bir LLM'in ürettiği embedding'leri klasik bir modele feature olarak vermek gibi birlikte kullanım da yaygın; beşinci yazıda bu fikre kısaca değineceğim.
Ne Zaman ML Kullanmamalı?
ML'in ne zaman gerektiğini konuşmak kadar ne zaman gereksiz olduğunu konuşmak da önemli. Şu durumlarda önce başka bir çözüm düşün:
- Kural net ve değişmiyorsa: kargo ücreti 500 TL'nin altındaki siparişte sabit bir tutarsa bunu model öğrenmez, kod hesaplar.
- Veri azsa veya hiç yoksa: kurumsal siparişler gibi yeni bir iş kolunda birkaç yüz kayıtla güvenilir bir model eğitemezsin; önce kuralla başla, veri biriktir.
- Başarıyı ölçemiyorsan: "daha iyi tahmin" demek yetmez, hangi metric'le ve hangi baseline'a göre daha iyi olduğunu tanımlaman gerekir.
- Kararın gerekçesini kişi bazında açıklaman zorunluysa ve hata pahalıysa: bir müşterinin ödeme yöntemini kısıtlamak gibi kararlar için model ancak insana öneri sunan bir araç olabilir.
ML İş Akışı
Bir ML projesi model eğitmekten ibaret değil. Aşağıdaki şekil serinin izleyeceği yolu ve her adımın hangi yazıda işlendiğini gösteriyor:
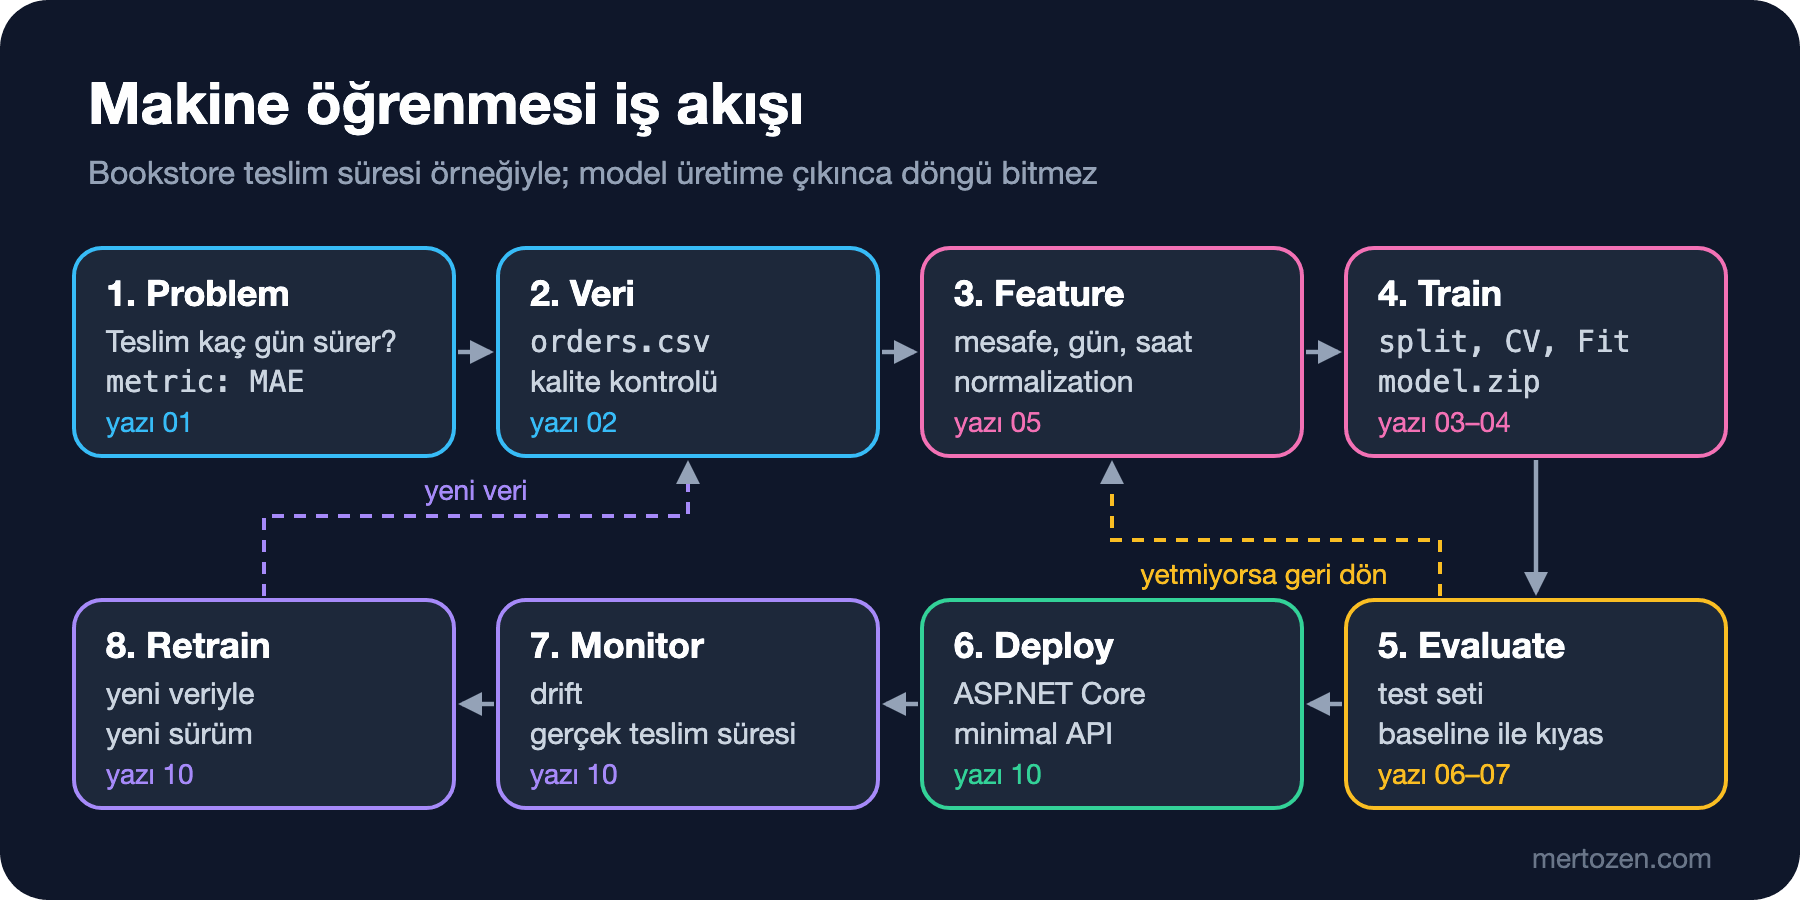
Akış problemle başlıyor: neyi tahmin ettiğimizi ve başarıyı hangi metric'le ölçeceğimizi önce yazıya döküyoruz. Teslim süresi için bu metric MAE (mean absolute error; tahminin gerçek değerden ortalama kaç gün saptığı) olacak. Sonra veriyi tanıyıp temizliyoruz, feature'ları hazırlıyoruz, modeli eğitiyoruz ve daha önce görmediği veride ölçüyoruz. Sonuç yetmiyorsa feature'lara geri dönüyoruz. Yeterliyse model bir API'nin arkasına geçiyor. Ama iş orada bitmiyor: gerçek teslim süreleri geldikçe modelin nasıl davrandığını izliyor, dünya değiştiğinde yeni veriyle yeniden eğitiyoruz. Üçüncü yazıda bir kargo firmasının belli bir tarihten sonra yavaşlamasının eski bir modeli nasıl şaşırttığını göreceğiz.
Sık Düşülen Tuzaklar
İlk tuzak, veri yokken model hedeflemek. "Bu projeye ML koyalım" kararı çoğu zaman verinin varlığı kontrol edilmeden verilir. Önce sor: label nerede tutuluyor? Teslim süresi için bu, sipariş tarihinden teslim tarihine geçen süre; bu iki tarih sistemde güvenilir şekilde kaydedilmiyorsa ilk iş model değil, o kaydı düzeltmek.
İkincisi, metric'i tanımlamadan çözmeye başlamak. "İyi tahmin" iş tarafı için farklı anlamlara gelebilir. Müşteriye söz verilen tarihten bir gün geç kalmak, bir gün erken gelmekten çok daha kötü olabilir. Bu asimetri baştan konuşulmazsa ortalama hatası düşük ama müşteriyi sürekli bekleten bir modelle karşılaşırsın.
Üçüncüsü, baseline olmadan model kurmak. Yukarıdaki kural 1,05 günlük hata yapıyor. Bir model 0,9 günlük hata yaptığında bu iyileşme, modelin bakım maliyetine değer mi? Bu soruyu baseline olmadan soramazsın.
Dördüncüsü, sentetik veriden çıkan sonucu gerçek dünyaya genellemek. Bu serideki sayılar yöntemleri göstermek için var. Kendi verinde aynı adımları atarsan farklı sayılar bulacaksın; asıl öğrenmen gereken o sayılara nasıl ulaşıldığı.
Küçük Bir Deneme
★☆☆ RuleBaseline.EstimateDays method'una hafta sonu için bir düzeltme ekle: cuma veya cumartesi verilen siparişe bir gün ekle. rules komutunu tekrar çalıştır ve ortalama hatanın, ±1 gün oranının ve grup bazındaki bias'ın nasıl değiştiğine bak.
★★☆ Generator'ı farklı bir seed ile çalıştır: dotnet run --project tools/Bookstore.DataGen -- data-seed7 7. Hash'lerin tamamen değiştiğini gör, sonra kuralın bu veri setindeki hatasını ölçmek için RuleBaseline'daki dosya yolunu geçici olarak değiştir. Sayılar ne kadar oynuyor?
★★★ Bookstore'un Kurumsal Sipariş modülü için problem kataloğuna iki satır ekle: örneğin bir satın alma onayının kaç saatte verileceği ve bir kurumun önümüzdeki ay sipariş verip vermeyeceği. Her biri için problem tipini, label'ın hangi tablodan geleceğini ve başarıyı hangi metric'le ölçeceğini yaz.
Bir sonraki yazıda modele hiç dokunmadan veriye bakacağız: row, feature ve label kavramlarını, feature tiplerini ve orders.csv içindeki kalite sorunlarını Microsoft.Data.Analysis ve LINQ (C# koleksiyonları üzerinde sorgu yazmayı sağlayan dil özelliği) ile bulup temizleyeceğiz.