

Classification ve Metric'leri: Confusion Matrix, Precision, Recall, F1 ve ROC-AUC

Dengesiz veride accuracy yanıltır; classification modelini precision, recall, PR-AUC ve iş maliyetine göre seçilmiş bir threshold ile ölçmek gerekir. Bookstore'da sipariş iptal riskini logistic regression ve FastTree ile tahmin ediyor, yüzde 95,8 accuracy'nin hiçbir iptali yakalamadığını, threshold'un validation setinde maliyete göre nasıl seçildiğini, calibration kontrolünü ve yorum metninden konu tahmin eden bir multiclass modeli gerçek çıktılarla gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Microsoft.ML 6.0.0 (ML.NET 6.0) ve Microsoft.ML.FastTree 6.0.0 ile derlenip çalıştırılmıştır. Veri, serinin seed'li generator'ıyla üretilmiş sentetik Bookstore verisidir; buradaki sayılar gerçek bir işletmenin sonuçları değildir.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için bu kez bir sayı değil, bir sınıf tahmin ediyoruz: sipariş iptal edilecek mi? Veride siparişlerin yaklaşık yüzde 4,5'i iptal ediliyor. Test setinde yüzde 95,8 accuracy alan bir model düşün. Bu model iptal edilen 198 siparişten kaçını yakalıyor olabilir?
İkinci soru: iptal riskini yüzde 20 olarak tahmin edilen 100 sipariş alsan, bunların gerçekten kaçı iptal edilir? Cevap modele göre değişiyor ve iki modelden biri bu soruda ciddi şekilde yanılıyor.
Binary Classification ve Logistic Regression
Classification, her satır için önceden belirlenmiş sınıflardan birini seçer. İki sınıf varsa (iptal / iptal değil) binary classification, daha fazlası varsa multiclass classification denir. İptal riskini sipariş anında bilmek işe yarar: riskli siparişte müşteriye kısa mesajla onay sorabilir, stokta olmayan kitabı tedarikçiden onay gelene kadar sipariş etmeyebilir, paketlemeyi bekletebilirsin.
Modelin yalnız sipariş anında bilinen bilgileri görmesi gerekiyor. Üçüncü yazıdaki data leakage dersini hatırla: teslim süresi ya da kargo hareket sayısı iptal edilen siparişte zaten boş, onları feature yaparsan model cevabı görerek öğrenir. Müşterinin geçmişini de yalnız geriye doğru hesaplıyoruz. Siparişleri zamana göre sıralayıp her müşterinin o ana kadarki sipariş sayısını sayıyoruz:
public static List<CancelInput> LoadOrders()
{
    Dictionary<string, int> seen = [];
    List<CancelInput> rows = [];
    foreach (OrderRow o in OrderRow.Load("data/orders_clean.csv").OrderBy(o => o.OrderedAtUtc))
    {
        int previous = seen.GetValueOrDefault(o.CustomerId);
        seen[o.CustomerId] = previous + 1;
        rows.Add(new CancelInput
        {
            OrderId = o.OrderId, CustomerId = o.CustomerId, OrderedAtUtc = o.OrderedAtUtc,
            PaymentMethod = o.PaymentMethod, ShippingMethod = o.ShippingMethod, Warehouse = o.Warehouse,
            ItemCount = o.ItemCount, OrderTotal = (float)o.OrderTotal, DiscountRate = (float)o.DiscountRate,
            IsCampaign = o.IsCampaign, HasBackorderItem = o.HasBackorderItem,
            PreviousOrders = previous, IsFirstOrder = previous == 0, IsCancelled = o.IsCancelled,
        });
    }
    return rows;
}
Feature pipeline'ı önceki yazılardakine benziyor: kategorik kolonlar için one-hot encoding, boolean'lar için 0/1, sonra normalization. Trainer olarak logistic regression kullanıyoruz:
public static readonly string[] OrderFeatures =
    ["Payment", "Method", "WarehouseKey", "Campaign", "Backorder", "FirstOrder", "ItemCount", "OrderTotal",
     "DiscountRate", "PreviousOrders"];
/// <summary>Kategoriler one-hot, boolean'lar 0/1, sonra linear model için mean/variance normalization.</summary>
public static IEstimator<ITransformer> Features(MLContext ml, string[]? extra = null) =>
    ml.Transforms.Categorical.OneHotEncoding(
            [new("Payment", "PaymentMethod"), new("Method", "ShippingMethod"), new("WarehouseKey", "Warehouse")])
        .Append(ml.Transforms.Conversion.ConvertType(
            [new("Campaign", "IsCampaign"), new("Backorder", "HasBackorderItem"), new("FirstOrder", "IsFirstOrder")],
            DataKind.Single))
        .Append(ml.Transforms.Concatenate("Features", [.. OrderFeatures, .. extra ?? []]))
        .Append(ml.Transforms.NormalizeMeanVariance("Features"));
public static IEstimator<ITransformer> Logistic(MLContext ml) =>
    ml.BinaryClassification.Trainers.LbfgsLogisticRegression(new LbfgsLogisticRegressionBinaryTrainer.Options
    {
        LabelColumnName = "IsCancelled", FeatureColumnName = "Features", NumberOfThreads = 1,
    });
Logistic regression, regression yazısındaki linear modelle aynı şeyi yapar: feature'ların ağırlıklı toplamını hesaplar. ML.NET bu sayıya score der. Fark, score'un sigmoid fonksiyonundan geçirilmesidir. Sigmoid, eksi sonsuzdan artı sonsuza kadar giden bir sayıyı 0 ile 1 arasına sıkıştırır: büyük pozitif score 1'e, büyük negatif score 0'a, sıfır ise tam 0,5'e gider. Sonuç Probability kolonuna yazılır. Sınıf kararı ise bir threshold ile verilir: varsayılan threshold 0,5'tir, olasılık 0,5 ve üstündeyse PredictedLabel true olur. Eğitimi yapan L-BFGS (Limited-memory Broyden–Fletcher–Goldfarb–Shanno; son birkaç adımın gradient farklarından eğriliği yaklaşık hesaplayan bir optimizasyon algoritması), loss'u en aza indiren weight'leri bulur. Classification'da loss, log-loss'tur: gerçekte iptal edilen bir siparişe düşük olasılık veren model ağır cezalandırılır.
Train, Validation ve Test
Bu yazıda veriyi üçe bölüyoruz. Threshold'u seçeceğimiz için ayrı bir validation setine ihtiyacımız var; test seti yalnız en sonda, bir kez kullanılacak. Aynı müşterinin siparişleri aynı tarafta kalsın diye split'i CustomerId'ye göre grupluyoruz:
// Müşteriye göre gruplu 60/20/20: train, validation (threshold için), test (bir kez raporlanır)
var first = ml.Data.TrainTestSplit(all, testFraction: 0.2, samplingKeyColumnName: "CustomerId", seed: 7);
// Farklı bir seed: yine seed 7 ile validation'a yalnız 1.169 sipariş düşmüştü
var second = ml.Data.TrainTestSplit(first.TrainSet, testFraction: 0.25, samplingKeyColumnName: "CustomerId", seed: 11);
IDataView train = ml.Data.Cache(second.TrainSet), validation = second.TestSet, test = first.TestSet;
foreach ((string name, IDataView set) in new[] { ("train", train), ("validation", validation), ("test", test) })
{
    bool[] labels = [.. set.GetColumn<bool>("IsCancelled")];
    Console.WriteLine($"{name,-11}{labels.Length,7:N0} orders, {labels.Count(l => l),4} cancelled ({100.0 * labels.Count(l => l) / labels.Length:F1}%)");
}
// İki model: biri linear, biri gradient boosting ağaçları; ikisi de aynı feature'larla
ITransformer logistic = Features(ml).Append(Logistic(ml)).Fit(train);
ITransformer trees = Features(ml).Append(ml.BinaryClassification.Trainers.FastTree(
    labelColumnName: "IsCancelled", featureColumnName: "Features")).Fit(train);
dotnet run --project src/Bookstore.ML.Lab -- canceltrain 14,397 orders, 673 cancelled (4.7%)
validation 5,096 orders, 204 cancelled (4.0%)
test 4,687 orders, 198 cancelled (4.2%)
test set, threshold 0.5 Accuracy AUC PR-AUC Precision Recall F1
LogisticRegression 0.958 0.724 0.110 0.000 0.000 0.000
FastTree 0.957 0.643 0.091 0.273 0.015 0.029
TEST POSITIVE RATIO: 0.0422 (198.0/(198.0+4489.0))
Confusion table
||======================
PREDICTED || positive | negative | Recall
TRUTH ||======================
positive || 0 | 198 | 0.0000
negative || 0 | 4,489 | 1.0000
||======================
Precision || 0.0000 | 0.9578 |Koddaki yorum gerçek bir hatadan geliyor. İlk denemede ikinci split'e de seed: 7 verdim ve validation setinde yalnız 1.169 sipariş çıktı. ML.NET'in kaynak kodunda gruplu split, anahtar kolonu seed ile hash'leyip 0–1 aralığına yerleştiriyor ve test setine aralığın başındaki testFraction dilimini veriyor. İlk split 0–0,20 dilimini test setine ayırmıştı. Aynı seed ile ikinci split aynı hash değerlerini üretti ve yine 0–0,25 dilimini istedi; o dilimin büyük kısmı zaten test setindeydi, geriye yalnız 0,20–0,25 kaldı. 1.169 sipariş, bütün verinin yaklaşık yüzde 5'i. Farklı bir seed ile train 14.397, validation 5.096, test 4.687 sipariş oldu. İç içe split yapıyorsan set boyutlarını her zaman yazdır.
Accuracy Neden Yanıltır?
Açılıştaki ilk sorunun cevabı tabloda. Logistic regression test setinde 0,958 accuracy alıyor ve iptal edilen 198 siparişin hiçbirini yakalamıyor. ML.NET'in confusion matrix tablosu bunu açıkça gösteriyor: model bütün siparişlere "iptal değil" diyor. Hiçbir siparişin olasılığı 0,5'e ulaşmadığı için bu threshold'da hiçbir pozitif tahmin çıkmıyor.
Confusion matrix, tahminleri dört gruba ayırır. TP (true positive; iptal edildi ve model iptal dedi), FP (false positive; iptal edilmedi ama model iptal dedi, yani yanlış alarm), FN (false negative; iptal edildi ama model kaçırdı) ve TN (true negative; iptal edilmedi ve model de iptal demedi). Accuracy, doğru tahminlerin oranıdır: (TP + TN) / toplam. Pozitif sınıf yüzde 4,2 ise "kimse iptal etmez" diyen bir model, hiçbir şey öğrenmeden 0,958 alır. Sınıflar dengesizken accuracy neredeyse her zaman bu çoğunluk sınıfı baseline'ını ölçer.
Precision, Recall, F1, ROC-AUC ve PR-AUC
Dengesiz veride bakılacak metric'ler pozitif sınıfa odaklananlar:
- Precision = TP / (TP + FP): "iptal" dediğimiz siparişlerin ne kadarı gerçekten iptal edildi? Yanlış alarmların maliyetini ölçer.
- Recall = TP / (TP + FN): iptal edilen siparişlerin ne kadarını yakaladık? Kaçırılan iptallerin maliyetini ölçer.
- F1 (precision ile recall'un harmonik ortalaması): ikisinden biri düşükse F1 de düşük kalır, tek bir sayı ister misin diye sorar.
- ROC (Receiver Operating Characteristic; farklı threshold'larda doğru ve yanlış pozitif oranlarını gösteren eğri) eğrisinin altındaki alan, yani ROC-AUC: rastgele seçilen bir iptalin rastgele seçilen bir normal siparişten daha yüksek olasılık alma ihtimaline eşittir. Threshold'dan bağımsızdır, modelin sıralama kalitesini ölçer. Rastgele tahmin 0,5 alır.
- PR (precision-recall; threshold değiştikçe precision ile recall'un birlikte nasıl değiştiğini gösteren eğri) eğrisinin altındaki alan, yani PR-AUC: yine threshold'dan bağımsız, ama pozitif sınıfa odaklı. Rastgele bir modelin PR-AUC'si pozitif sınıfın oranına, burada yaklaşık 0,042'ye eşittir.
Bu gözle tabloya tekrar bakalım. Logistic regression'ın ROC-AUC'si 0,724, PR-AUC'si 0,110. Yani model iptal edilecek siparişleri sıralamada yukarı taşıyor ve rastgele bir modelin yaklaşık 2,6 katı PR-AUC alıyor, ama hiçbir sipariş için yüksek bir olasılık vermiyor. FastTree'nin ROC-AUC'si 0,643. Bu veride ağaç modeli linear modelden zayıf: iptal riski birkaç bağımsız faktörün toplamı gibi davranıyor ve ağaçlar 14 bin satırlık eğitim verisindeki rastlantısal etkileşimleri de öğreniyor. 0,5 threshold'unda FastTree'nin precision'ı 0,273 görünüyor, ama bu 11 pozitif tahminden 3'ünün doğru olması demek. Bu kadar küçük sayılardan sonuç çıkarma.
Bir de model kullanmayan bir baseline kuralım. Önce eğitim setinde iki kolona göre iptal oranına bakıyoruz, sonra bu bilgiyle yazılmış iki koşullu bir kuralı test setinde ölçüyoruz. Kuralı test setine bakarak kurmamak önemli; yoksa kural da test setine göre ayarlanmış olur:
// Ödeme yöntemine ve stok durumuna göre iptal oranı, yalnız eğitim setinden
List<CancelInput> trainRows = [.. ml.Data.CreateEnumerable<CancelInput>(train, reuseRowObject: false)];
Console.WriteLine();
foreach (IGrouping<string, CancelInput> g in trainRows
             .GroupBy(r => r.PaymentMethod)
             .Concat(trainRows.GroupBy(r => r.HasBackorderItem ? "back-ordered" : "in stock")))
{
    Console.WriteLine($"{g.Key,-16}{g.Count(),7:N0} orders, cancelled {g.Average(r => r.IsCancelled ? 1.0 : 0.0),6:P1}");
}
// Baseline'lar: "kimse iptal etmez" ve elle yazılmış bir kural
List<CancelInput> testRows = [.. ml.Data.CreateEnumerable<CancelInput>(test, reuseRowObject: false)];
Print("rule: COD or back-order", Counts(testRows.Select(r => (r.IsCancelled,
    r.PaymentMethod == "CashOnDelivery" || r.HasBackorderItem))));
CashOnDelivery 2,816 orders, cancelled 9.1 %
CreditCard 10,586 orders, cancelled 3.6 %
BankTransfer 995 orders, cancelled 3.0 %
in stock 13,975 orders, cancelled 4.4 %
back-ordered 422 orders, cancelled 12.6 %
rule: COD or back-order: TP 112, FP 922, FN 86, TN 3,567 | accuracy 0.785, precision 0.108, recall 0.566, cost 6,206 TLKapıda ödemeli (CashOnDelivery) siparişlerde iptal oranı yüzde 9,1, stokta olmayan kitap içeren siparişlerde yüzde 12,6; ortalama yüzde 4,7. Bu iki koşuldan birini taşıyan siparişleri işaretleyen kural, test setinde iptallerin yarısından fazlasını (0,566 recall) yakalıyor, ama işaretlediği her dokuz siparişten yalnız biri gerçekten iptal ediliyor (0,108 precision). Modelin bu kuralı geçip geçmediğini birazdan göreceğiz.
Threshold'u İş Maliyetine Göre Seçmek
0,5 threshold'unun özel bir anlamı yok; yalnız bir varsayılan. Doğru threshold, iki hata türünün iş tarafındaki maliyetine bağlı. Bookstore için şöyle varsayalım: yanlış alarm, müşteriye giden bir onay mesajı ve biraz rahatsızlık demek, maliyeti 3 TL. Kaçırılan iptal ise boşuna toplanan, paketlenen ve belki tedarikçiden sipariş edilen kitaplar demek, maliyeti 40 TL. Bu iki sayı bu yazı için uydurulmuş varsayımlar; gerçek projede finans ve operasyon ekibiyle birlikte belirlenir.
/// <summary>Varsayılan maliyetler (TL): yanlış alarmda bir onay mesajı, kaçırılan iptalde boşa giden toplama ve tedarikçi siparişi.</summary>
private const double FalseAlarmCost = 3, MissedCancelCost = 40;
private static double Cost(int falsePositives, int falseNegatives) =>
    falsePositives * FalseAlarmCost + falseNegatives * MissedCancelCost;
Threshold'u yalnız validation setinde tarıyoruz. Her threshold için confusion matrix'i hesaplayıp toplam maliyeti yazıyoruz:
// Threshold taraması yalnız validation setinde
List<CancelScore> val = Scores(ml, logistic, validation);
List<string> csv = ["threshold,precision,recall,flagged"];
Console.WriteLine();
Console.WriteLine($"{"validation",-11}{"flagged",8}{"TP",5}{"FP",6}{"FN",5}{"Precision",11}{"Recall",8}{"F1",7}{"cost TL",9}");
(double Threshold, double Cost) best = (0, double.MaxValue);
for (double t = 0.02; t <= 0.301; t += 0.01)
{
    (int tp, int fp, int fn, int tn) = Counts(val.Select(s => (s.IsCancelled, s.Probability >= t)));
    double precision = tp + fp == 0 ? 0 : (double)tp / (tp + fp), recall = (double)tp / (tp + fn);
    double cost = Cost(fp, fn);
    csv.Add(string.Create(CultureInfo.InvariantCulture, $"{t:F2},{precision:F4},{recall:F4},{tp + fp}"));
    if (cost < best.Cost) best = (t, cost);
    if (Math.Round(t * 100) % 2 == 0)
    {
        Console.WriteLine($"t = {t,-7:F2}{tp + fp,8}{tp,5}{fp,6}{fn,5}{precision,11:F3}{recall,8:F3}" +
                          $"{F1(precision, recall),7:F3}{cost,9:N0}");
    }
}
Console.WriteLine($"lowest validation cost at t = {best.Threshold:F2}; " +
                  $"cost ratio {FalseAlarmCost} / ({FalseAlarmCost} + {MissedCancelCost}) = {FalseAlarmCost / (FalseAlarmCost + MissedCancelCost):F3}");
validation flagged TP FP FN Precision Recall F1 cost TL
t = 0.02 5065 204 4861 0 0.040 1.000 0.077 14,583
t = 0.04 1948 141 1807 63 0.072 0.691 0.131 7,941
t = 0.06 1188 100 1088 104 0.084 0.490 0.144 7,424
t = 0.08 473 40 433 164 0.085 0.196 0.118 7,859
t = 0.10 332 27 305 177 0.081 0.132 0.101 7,995
t = 0.12 152 13 139 191 0.086 0.064 0.073 8,057
t = 0.14 73 9 64 195 0.123 0.044 0.065 7,992
t = 0.16 58 7 51 197 0.121 0.034 0.053 8,033
t = 0.18 40 3 37 201 0.075 0.015 0.025 8,151
t = 0.20 27 3 24 201 0.111 0.015 0.026 8,112
t = 0.22 10 2 8 202 0.200 0.010 0.019 8,104
t = 0.24 7 1 6 203 0.143 0.005 0.009 8,138
t = 0.26 7 1 6 203 0.143 0.005 0.009 8,138
t = 0.28 7 1 6 203 0.143 0.005 0.009 8,138
t = 0.30 5 0 5 204 0.000 0.000 0.000 8,175
lowest validation cost at t = 0.06; cost ratio 3 / (3 + 40) = 0.070
test, LogisticRegression t = 0.06: TP 118, FP 976, FN 80, TN 3,513 | accuracy 0.775, precision 0.108, recall 0.596, cost 6,128 TL
test, flag nobody (t = 1): TP 0, FP 0, FN 198, TN 4,489 | accuracy 0.958, precision 0.000, recall 0.000, cost 7,920 TL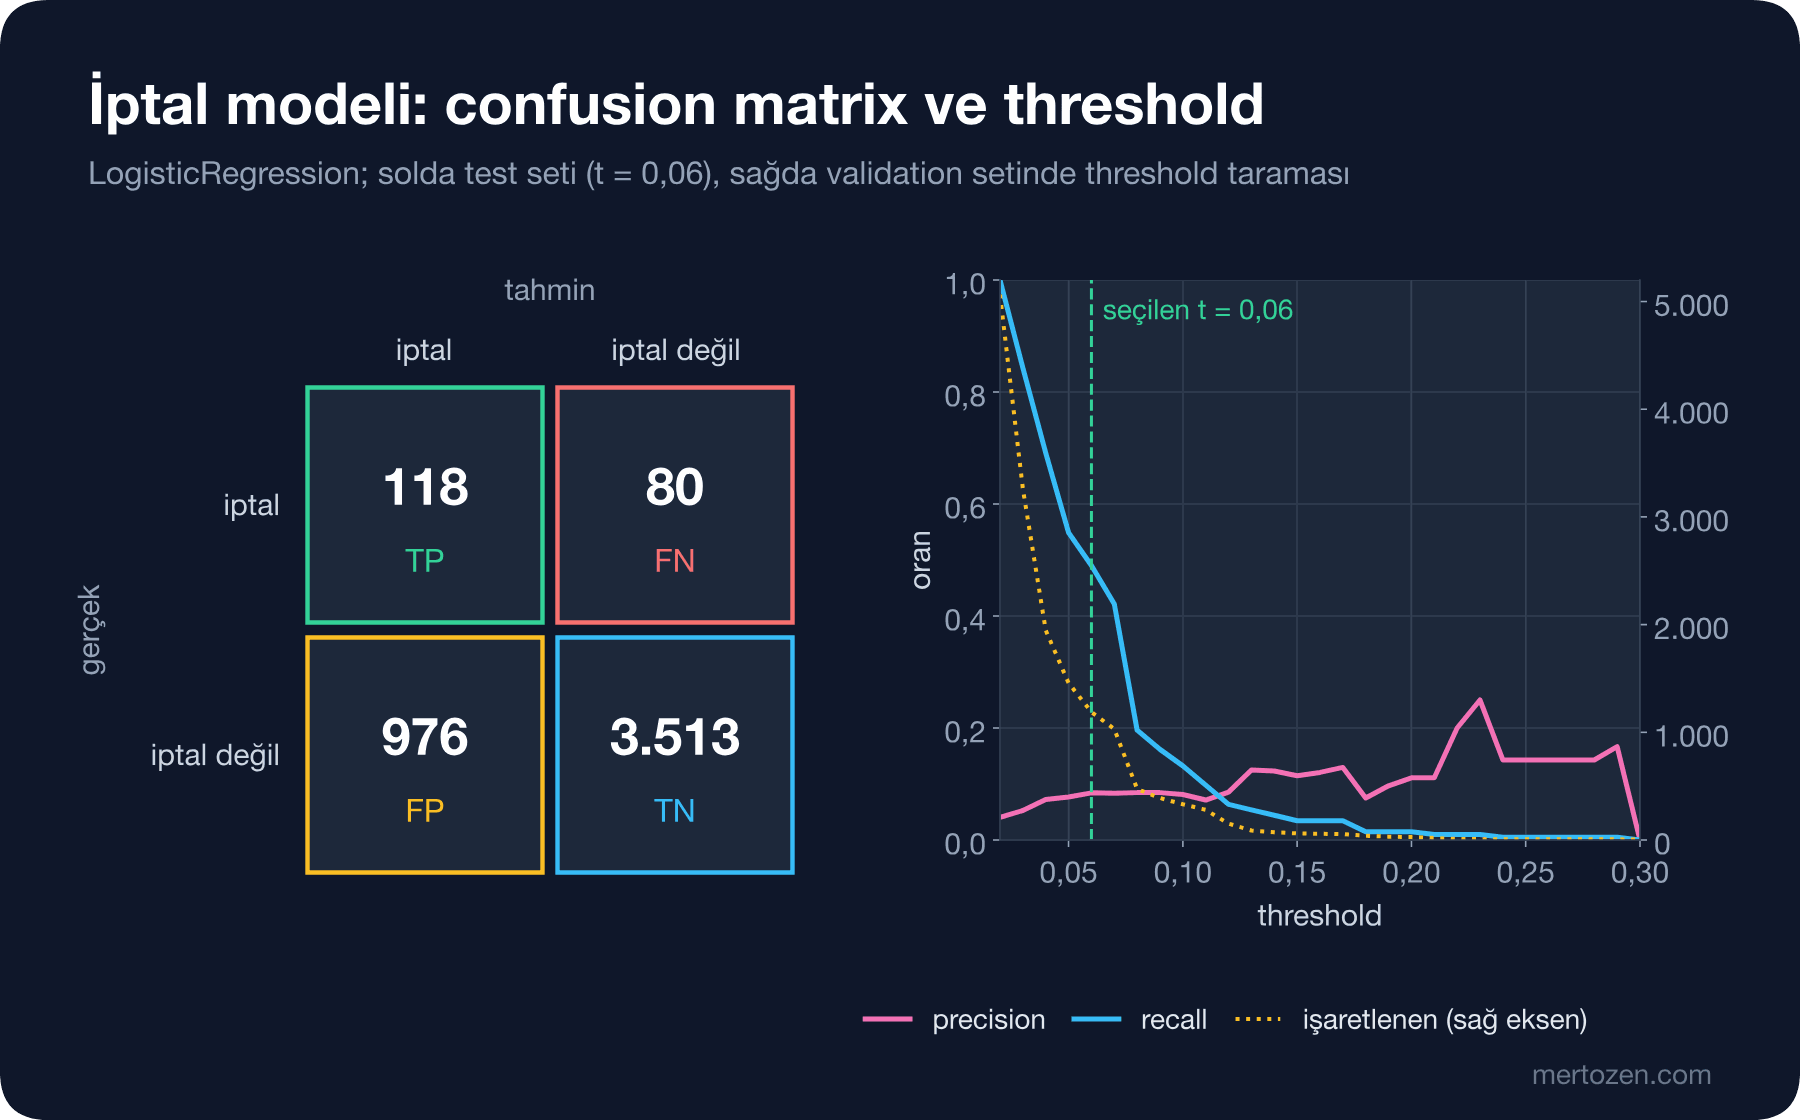
Threshold düştükçe recall artıyor ama işaretlenen sipariş sayısı da hızla büyüyor: 0,02'de bütün siparişler işaretleniyor ve maliyet 14.583 TL. Threshold yükseldikçe yanlış alarm azalıyor ama kaçırılan iptaller artıyor. En düşük validation maliyeti 0,06'da. Çıktının son satırındaki oran da dikkat çekici: probability'ler iyi kalibre edilmişse, bir siparişi işaretlemek ancak iptal olasılığı 3 / (3 + 40) = 0,070'ten büyükse kârlı olur. Tarama da bu teorik değere çok yakın bir yerde duruyor.
Seçtiğimiz 0,06'yı test setine bir kez uyguluyoruz: 1.094 sipariş işaretleniyor, iptal edilen 198 siparişin 118'i yakalanıyor. Precision 0,108, recall 0,596, maliyet 6.128 TL. Hiçbir siparişi işaretlemezsek maliyet 7.920 TL. Elle yazılmış kural ise 6.206 TL'de kalıyordu. Model kuralı yalnız 78 TL geçiyor; dürüst sonuç bu. Bu veride iptal sinyalinin büyük kısmı iki kolondan geliyor ve iki satırlık bir kural onu zaten yakalıyor. Modelin asıl katkısı, tek bir işaret yerine sıralanabilir bir olasılık vermesi: maliyetler değişince threshold'u değiştirmek kodu değiştirmekten kolaydır, ayrıca yalnız en riskli yüzde 1'i telefonla aramak gibi farklı çalışma noktaları seçebilirsin.
Calibration: 0,20 Gerçekten Yüzde 20 mi?
Maliyetten threshold hesaplamak, probability'nin gerçekten olasılık gibi davranmasına bağlı. Bunu kontrol etmenin yolu, test setindeki tahminleri olasılık aralıklarına bölüp her aralıkta tahmin edilen ortalama olasılık ile gerçek iptal oranını karşılaştırmak:
probability band   LR orders predicted  actual  FT orders predicted  actual
0.00 - 0.03            1,658     2.8 %   1.6 %      2,804     2.0 %   2.7 %
0.03 - 0.06            1,935     3.8 %   2.7 %        959     4.2 %   5.0 %
0.06 - 0.10              765     7.5 %   9.8 %        513     7.8 %   6.2 %
0.10 - 0.15              280    11.7 %  11.4 %        229    12.1 %   7.0 %
0.15 - 1.00               49    20.7 %  22.4 %        182    26.7 %  13.7 %
Açılıştaki ikinci sorunun cevabı burada. Logistic regression 0,15'in üstünde ortalama yüzde 20,7 diyor, gerçek oran yüzde 22,4. Diğer aralıklarda da fark birkaç puanı geçmiyor. FastTree ise aynı aralıkta yüzde 26,7 diyor ama gerçek oran yüzde 13,7: en emin olduğu siparişlerde iki kat iyimser. ML.NET'te FastTree'nin binary trainer'ı ham score'u bir Platt calibrator'dan (score'u sigmoid ile olasılığa çeviren küçük bir model) geçirerek Probability üretiyor. Calibrator eğitim verisi üzerinde öğrendiği için, eğitim verisine fazla uyan bir ağaç modelinin yüksek score'ları test setinde abartılı olasılıklara dönüşüyor. Probability'yi bir karar kuralına ya da maliyet hesabına sokacaksan, calibration'ı mutlaka bu tür bir tabloyla kontrol et.
Multiclass: Yorum Metninden Konu Tahmini
İkinci problem, müşteri yorumlarını konuya göre ayırmak: Shipping (kargo), Price (fiyat), Content (kitabın içeriği) ve PrintQuality (baskı kalitesi). Doğru konu, yorumun doğru ekibe gitmesini sağlar. Beşinci yazıdaki FeaturizeText metni n-gram feature'larına çeviriyor. SDCA (Stochastic Dual Coordinate Ascent; her adımda tek bir örnek üzerinden ilerleyen bir optimizasyon algoritması) tabanlı maximum entropy trainer'ı ise multiclass logistic regression'ın karşılığı. Label string olduğu için önce MapValueToKey ile key tipine çeviriyoruz, tahmini de MapKeyToValue ile geri çeviriyoruz:
MLContext ml = new(seed: 1);
IDataView data = ml.Data.LoadFromTextFile<ReviewInput>("data/reviews.csv",
    new TextLoader.Options { HasHeader = true, Separators = [','], AllowQuoting = true });
var split = ml.Data.TrainTestSplit(data, testFraction: 0.2, seed: 7);
var pipeline = ml.Transforms.Conversion.MapValueToKey("Label", "Topic")
    .Append(ml.Transforms.Text.FeaturizeText("Features", "Text"))
    .Append(ml.MulticlassClassification.Trainers.SdcaMaximumEntropy(new SdcaMaximumEntropyMulticlassTrainer.Options
    {
        LabelColumnName = "Label", FeatureColumnName = "Features", NumberOfThreads = 1,
    }))
    .Append(ml.Transforms.Conversion.MapKeyToValue("PredictedTopic", "PredictedLabel"));
ITransformer model = pipeline.Fit(split.TrainSet);
IDataView scored = model.Transform(split.TestSet);
MulticlassClassificationMetrics m = ml.MulticlassClassification.Evaluate(scored);
dotnet run --project src/Bookstore.ML.Lab -- topicstest reviews 997; always 'Content': accuracy 0.348
MicroAccuracy 0.947 MacroAccuracy 0.935 LogLoss 0.233 LogLossReduction 0.827
Confusion table
||================================
PREDICTED || 0 | 1 | 2 | 3 | Recall
TRUTH ||================================
0. Content || 339 | 1 | 1 | 6 | 0.9769
1. Price || 4 | 197 | 3 | 8 | 0.9292
2. PrintQuality || 11 | 2 | 134 | 7 | 0.8701
3. Shipping || 6 | 1 | 3 | 274 | 0.9648
||================================
Precision ||0.9417 |0.9801 |0.9504 |0.9288 |
wrong predictions (first five):
label PrintQuality predicted Content max score 0.99 "I read Anna Karenina in two days."
label Price predicted Content max score 0.77 "Not worth the money at this price. Life of Pi is a masterpiece and I could not put it down."
label Price predicted Shipping max score 0.97 "Arrived the next day and well packed. Read it for my book club."
label Price predicted Shipping max score 0.55 "Not worth the money at this price. Arrived the next day and well packed. Ordered it for my son."
label Shipping predicted Content max score 0.56 "Shipping was really slow this time. The story was slow and boring. Recommended."Her zaman en sık konuyu (Content) söyleyen bir baseline 0,348 accuracy alıyor; model 0,947. Multiclass'ta iki accuracy var. MicroAccuracy, bütün test satırlarının ne kadarının doğru olduğu: 997 yorumun 944'ü. MacroAccuracy ise her sınıfın recall'unu ayrı hesaplayıp ortalamasını alıyor; her sınıf eşit ağırlıkta sayılıyor. Burada 0,935, çünkü en küçük sınıf olan PrintQuality'nin recall'u 0,870. Sınıflar dengesizse ve küçük sınıf önemliyse macro değere bak; micro değer büyük sınıfların başarısını gösterir.
Confusion table'da satırlar gerçek, sütunlar tahmin edilen sınıf. En sık hata, PrintQuality etiketli 11 yorumun Content tahmin edilmesi. Yanlış tahminlerin ilk beşi iki farklı sebebi gösteriyor. Birincisi label hatası: "I read Anna Karenina in two days." cümlesi açıkça içerikle ilgili, ama label PrintQuality. Model burada haklı, label yanlış. İkincisi birden fazla konu içeren yorumlar: fiyattan şikâyet edip kitabı öven bir yorumun tek bir doğru label'ı yok. Yanlış etiketlenmiş yorumları ikinci yazıdaki kalite raporunda bulmuştuk; karışık konulu yorumlar da veride az değil. Ölçülen 0,947 bu yüzden bir tavanın altında kalıyor ve yüzde 100'e ulaşması beklenmemeli.
Üretimde Dikkat
Threshold, modelin değil iş kararının bir parçası. Onu modelle birlikte versiyonla, değerini configuration'da tut ve maliyet varsayımlarıyla birlikte belgele. Maliyetler değişince threshold'u validation verisinde yeniden seç.
Pozitif sınıfın oranı zamanla değişir. Kampanya dönemlerinde iptal oranı artarsa, aynı threshold daha çok siparişi işaretler. Üretimde işaretlenen siparişlerin oranını ve gerçekleşen iptal oranını izle; bu konuya onuncu yazıda drift başlığı altında döneceğiz.
Küçük test setlerinde metric'ler oynaktır. 198 pozitif örnekle hesaplanan bir recall'da birkaç siparişlik fark bile yüzdeyi belirgin şekilde değiştirir. Model karşılaştırmasını cross-validation ile yap, test setini yalnız son raporda kullan.
Multiclass modelin hatalarını rastgele birkaç örnekle değil, confusion table ile incele. Sistematik bir karışma, örneğin baskı kalitesi yorumlarının içerik sanılması, çoğu zaman eğitim verisindeki label tanımlarının belirsizliğini gösterir; çözüm modeli değil, etiketleme kılavuzunu düzeltmektir.
Sık Düşülen Tuzaklar
İlk tuzak, sınıf dengesizliğini görmezden gelip accuracy'yi raporlamak. Yüzde 95,8 accuracy, bu veride "hiçbir şey yapmayan model" demek. Pozitif sınıf küçükse precision, recall ve PR-AUC ile konuş ve her zaman çoğunluk sınıfı baseline'ını yanına yaz.
İkincisi, threshold'u test setinde ayarlamak. Test setinde en iyi threshold'u seçip aynı setteki metric'i raporlarsan, model seçiminde yaptığın hatanın aynısını yapmış olursun. Threshold da bir hyperparameter'dır: validation setinde seç, testte bir kez ölç.
Üçüncüsü, probability'yi kesinlik sanmak. FastTree'nin yüzde 26,7 dediği siparişlerde gerçek oran yüzde 13,7 idi. Modelin olasılığını müşteriye gösterecek ya da bir maliyet hesabına sokacaksan önce calibration tablosuna bak.
Dördüncüsü, iç içe split'lerde aynı seed'i kullanmak. Gruplu split'te bu, validation setini sessizce küçültebilir. Set boyutlarını ve pozitif oranlarını her split'ten sonra yazdır.
Beşincisi, label hatasını model hatası sanmak. Yanlış tahminlerin bir kısmı aslında yanlış label'lar. Hataları okumadan modeli değiştirmeye başlama.
Küçük Bir Deneme
★☆☆ Maliyetleri 3 TL ve 40 TL yerine 10 TL ve 40 TL yap. Teorik threshold 10 / 50 = 0,20 oluyor. Validation taraması nereyi seçiyor? Model bu maliyetlerde hâlâ "hiç işaretleme" stratejisini geçebiliyor mu?
★★☆ Features method'una müşterinin önceki iptal sayısını ekle. Bu bilgi sipariş anında biliniyor mu? Hesaplarken PreviousOrders ile aynı yöntemi, yalnız geçmişe bakan bir sayaç kullan ve ROC-AUC'nin değişimine bak.
★★★ Topics deneyinde Rating kolonunu da feature olarak ekle. Hangi sınıfın recall'u değişiyor? Sonra yanlış tahminleri tek tek oku ve bunların ne kadarının label hatası olduğunu tahmin et.
Bir sonraki yazıda label'ı olmayan verilere geçiyoruz: müşterileri RFM (recency, frequency, monetary; son alışverişten bu yana geçen süre, alışveriş sıklığı ve harcama tutarı) feature'larıyla k-means ile segmentlere ayıracak, günlük satış serisinde anomaly detection yapacak ve doğru cevabın olmadığı yerde sonucun nasıl değerlendirileceğini konuşacağız.