

IL ve JIT Compiler: Tiered Compilation, Dynamic PGO, Inlining ve Escape Analysis
JIT bir method'u tek seferde değil kademeli derler: önce optimizasyonsuz Tier0, sonra sayaçlı bir kopya, en son toplanan profile göre optimize edilmiş Tier1. Bookstore koduyla IL'in stack tabanlı yapısını, OSR'ı, Dynamic PGO'nun interface çağrısını tip kontrolüyle doğrudan koda çevirmesini, bounds check eliminasyonunu ve .NET 10'un escape analysis'iyle 40 byte'lık allocation'ın sıfıra inmesini DOTNET_JitDisasm çıktılarıyla gösteriyor, V8'in hidden class ve deoptimization'ıyla karşılaştırıyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (SDK 10.0.404, runtime 10.0.15) ile derlenip xUnit v3 4.0.3 testleriyle doğrulanmıştır; karşılaştırmalarda .NET 9.0.22 runtime'ı, ölçümde BenchmarkDotNet 0.15.8, JavaScript örneklerinde Node.js 26 (V8 14.6) kullanılmıştır. Decompiler çıktısı ilspycmd 11.2 ile, assembly çıktıları x64 Linux üzerinde alınmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için yazdığımız filtre dilinin front-end'i 04. yazıda bitti: metin token'a, token ağaca, ağaç doğrulanmış bir bound tree'ye ve oradan bir delegate'e dönüştü. Bu yazıda o delegate'in ve genel olarak her C# method'unun makine koduna nasıl dönüştüğüne bakıyoruz. Örnek, kataloğu bir kurala göre sayan küçük bir method:
public interface IBookRule
{
    bool Matches(Book book);
}

public sealed class InStock : IBookRule
{
    public bool Matches(Book book) => book.Stock > 0;
}

public sealed class PublishedBefore(int year) : IBookRule
{
    public bool Matches(Book book) => book.Year < year;
}

// interface çağrısı: JIT, rule'un arkasında hangi class'ın olduğunu bilmiyor
[MethodImpl(MethodImplOptions.NoInlining)]
public static int CountMatches(Book[] books, IBookRule rule)
{
    int count = 0;
    foreach (Book book in books)
    {
        if (rule.Matches(book))
            count++;
    }
    return count;
}

// method'un dışına hiç çıkmayan küçük bir array
[MethodImpl(MethodImplOptions.NoInlining)]
public static int ShippingDays(int quantity)
{
    int[] limits = [1, 5, 20];
    int days = 1;
    foreach (int limit in limits)
    {
        if (quantity > limit)
            days++;
    }
    return days;
}
Birinci soru: CountMatches binlerce kez, çoğunlukla InStock ile çağrılıyor. Uygulama bir süre çalıştıktan sonra bu method'un makine kodunda rule.Matches(book) hâlâ bir interface çağrısı mı?
İkinci soru: ShippingDays her çağrıldığında limits için heap'te kaç byte ayrılıyor? Cevap .NET 9'da ve .NET 10'da aynı mı?
NoInlining yalnız gözlem için: her method'un makine kodunu ayrı görebilmek istiyoruz.
IL: Stack Tabanlı Bir Ara Dil
Roslyn bu method'ları makine koduna değil, IL'e (Intermediate Language; .NET'in işlemciden bağımsız ara kodu) çeviriyor. Sayım için iki farklı döngü yazalım, ikisine de yazının ilerleyen bölümlerinde ihtiyacımız olacak:
// i < books.Length: JIT her index'in geçerli olduğunu kanıtlayabilir
[MethodImpl(MethodImplOptions.NoInlining)]
public static int CountInStock(Book[] books)
{
    int count = 0;
    for (int i = 0; i < books.Length; i++)
    {
        if (books[i].Stock > 0)
            count++;
    }
    return count;
}

// i < take: JIT'e take <= books.Length olduğunu söyleyen hiçbir şey yok
[MethodImpl(MethodImplOptions.NoInlining)]
public static int CountInStock(Book[] books, int take)
{
    int count = 0;
    for (int i = 0; i < take; i++)
    {
        if (books[i].Stock > 0)
            count++;
    }
    return count;
}
İlkinin IL'ine ilspycmd (ILSpy decompiler'ının komut satırı sürümü) ile bakalım:
$ ilspycmd -il -t Bookstore.JitLab.Lab samples/JitLab/bin/Release/net10.0/JitLab.dll
...
    int32 CountInStock (
    class [Bookstore.Filter]Bookstore.Catalog.Book[] books
) cil managed noinlining
{
// Method begins at RVA 0x2450
// Header size: 12
// Code size: 33 (0x21)
.maxstack 2
.locals init (
    [0] int32,
    [1] int32
)

IL_0000: ldc.i4.0
IL_0001: stloc.0
IL_0002: ldc.i4.0
IL_0003: stloc.1
IL_0004: br.s IL_0019
// loop start (head: IL_0019)
    IL_0006: ldarg.0
    IL_0007: ldloc.1
    IL_0008: ldelem.ref
    IL_0009: callvirt instance int32 [Bookstore.Filter]Bookstore.Catalog.Book::get_Stock()
    IL_000e: ldc.i4.0
    IL_000f: ble.s IL_0015

    IL_0011: ldloc.0
    IL_0012: ldc.i4.1
    IL_0013: add
    IL_0014: stloc.0

    IL_0015: ldloc.1
    IL_0016: ldc.i4.1
    IL_0017: add
    IL_0018: stloc.1

    IL_0019: ldloc.1
    IL_001a: ldarg.0
    IL_001b: ldlen
    IL_001c: conv.i4
    IL_001d: blt.s IL_0006
// end loop

IL_001f: ldloc.0
IL_0020: ret
} // end of method Lab::CountInStock
IL'de register yok. Her komut evaluation stack (değerlendirme stack'i) adı verilen bir stack'e değer koyuyor ya da oradan değer alıyor. IL_0006'dan itibaren okursan: ldarg.0 array'i, ldloc.1 i'yi stack'e koyuyor; ldelem.ref ikisini alıp yerine books[i]'yi koyuyor; callvirt onu alıp Stock'u koyuyor; ldc.i4.0 sıfırı ekliyor ve ble.s son iki değeri karşılaştırıp dallanıyor. Bu biçim taşınabilir: register sayısı ve hangi değerin hangi register'a konacağı IL'i ilgilendirmiyor, bu kararları her platformda JIT (just-in-time; IL'i çalışma anında makine koduna çeviren compiler) veriyor.
IL diskte duruyor, ama hiçbir zaman olduğu gibi çalıştırılmıyor. Bir method ilk kez çağrıldığında entry point'i henüz bir stub'ı gösteriyor; stub JIT'i çağırıyor, JIT makine kodunu üretiyor ve entry point yeni koda yönlendiriliyor. Sonraki çağrılar doğrudan makine koduna gidiyor. 01. yazıda 1.500 çağrının üç derlemeye karşılık geldiğini görmüştük; şimdi o derlemelere bakalım.
Tiered Compilation: Aynı Method, Birkaç Derleme
Deney için bir kez çağrılan ama uzun süre dönen bir method yazıyoruz; içinden iki CountInStock çağrılıyor:
static void Tiers(Book[] books)
{
    int total = 0;
    // yalnız bir kez çağrılan bir method içinde uzun süren tek bir döngü
    for (int i = 0; i < 2_000_000; i++)
        total += Lab.CountInStock(books) + Lab.CountInStock(books, 3);
    Console.WriteLine($"total: {total}");
}
$ dotnet build -c Release samples/JitLab
$ DOTNET_JitStdOutFile=jit.txt DOTNET_JitDisasmSummary=1 dotnet samples/JitLab/bin/Release/net10.0/JitLab.dll tiers
total: 14000000
$ grep -E 'Lab:|Tiers' jit.txt
8: JIT compiled Program:<<Main>$>g__Tiers|0_0(Bookstore.Catalog.Book[]) [Instrumented Tier0, IL size=77, code size=241]
9: JIT compiled Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[]) [Instrumented Tier0, IL size=33, code size=195]
11: JIT compiled Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[],int) [Instrumented Tier0, IL size=31, code size=194]
12: JIT compiled Program:<<Main>$>g__Tiers|0_0(Bookstore.Catalog.Book[]) [Tier1-OSR @0x1b with Synthesized PGO, IL size=77, code size=1794]
14: JIT compiled Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[]) [Instrumented Tier0, IL size=33, code size=195]
15: JIT compiled Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[],int) [Instrumented Tier0, IL size=31, code size=194]
17: JIT compiled Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[]) [Tier1 with Dynamic PGO, IL size=33, code size=53]
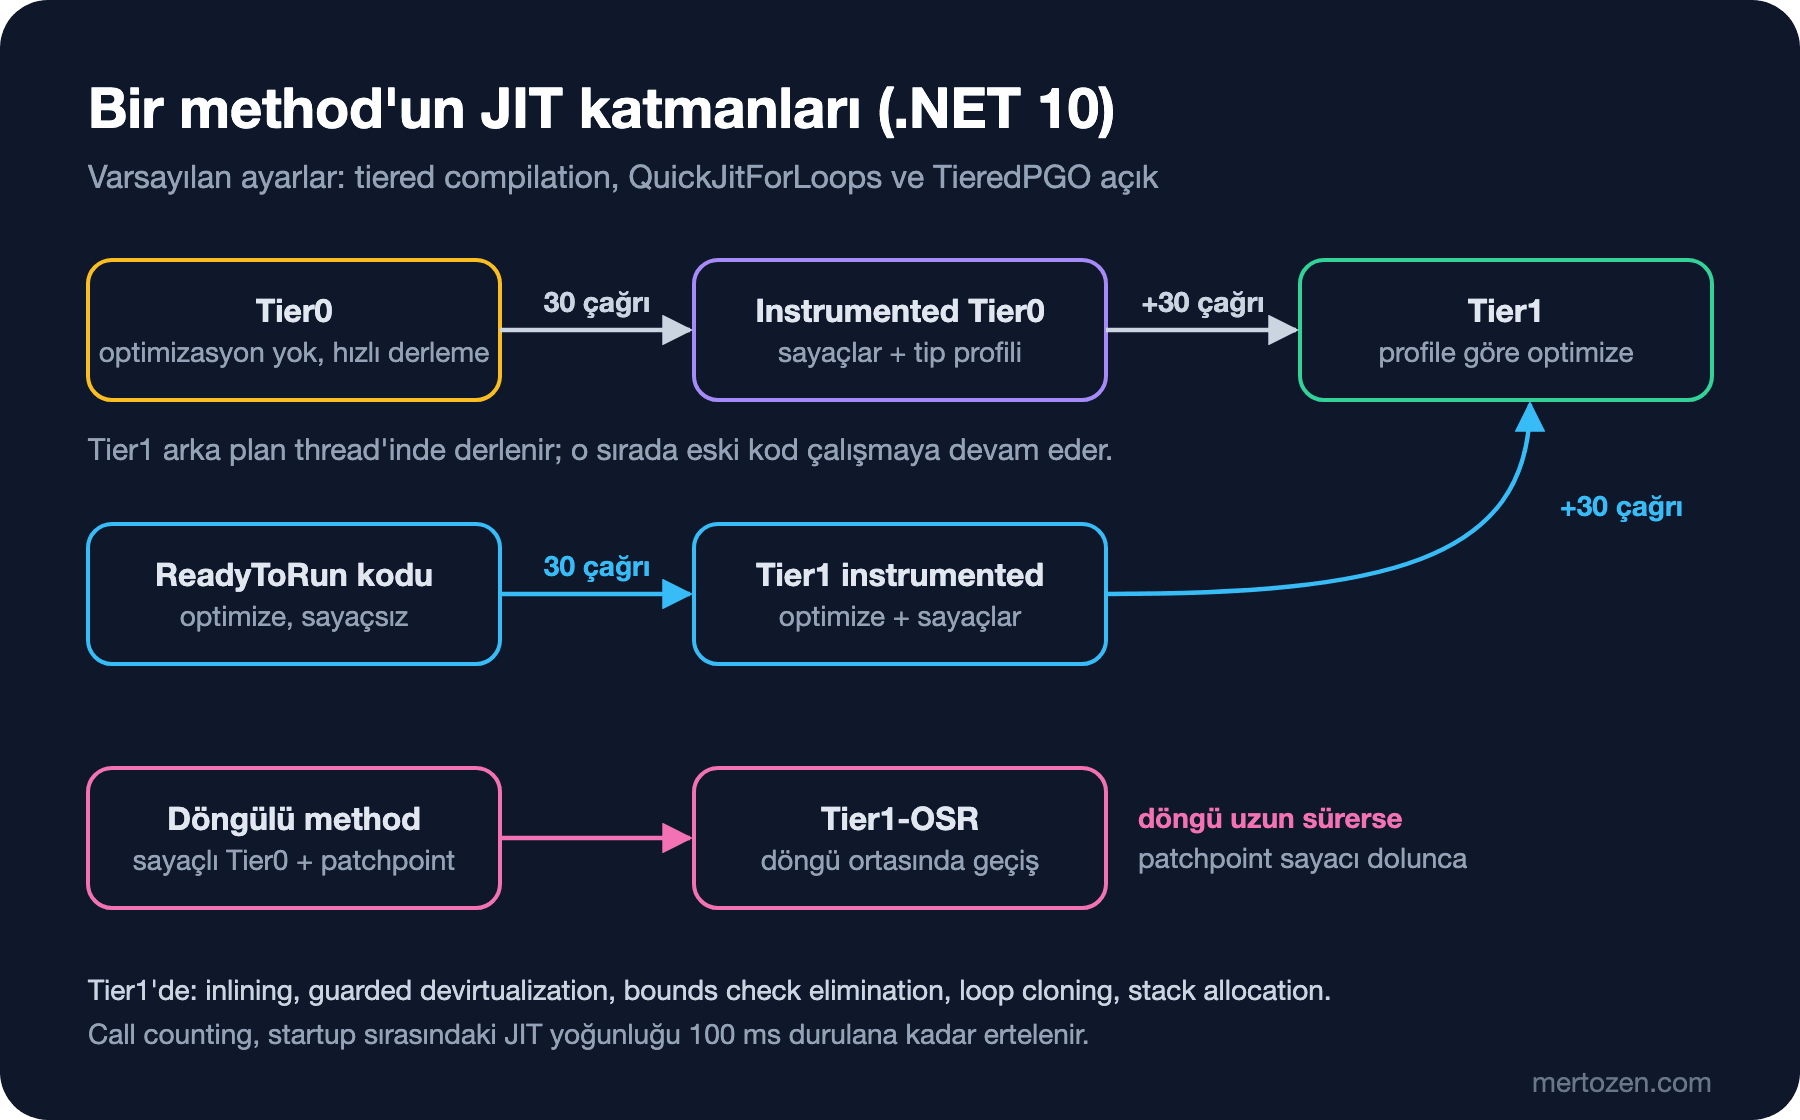
18: JIT compiled Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[],int) [Tier1 with Synthesized PGO, IL size=31, code size=81]Tiered compilation'ın fikri basit: her method'u önce optimizasyonsuz ve hızlı derle (Tier0), gerçekten sık çalışanları sonra arka planda optimize ederek yeniden derle (Tier1). Böylece startup'ta, sık çalışmayacak binlerce method'u optimize etmeye zaman harcanmıyor. Runtime'ın kaynak kodundaki varsayılanlara göre bir method 30 çağrıdan sonra sık kullanılan sayılıyor ve bu sayım, startup'taki JIT yoğunluğu 100 ms boyunca durulana kadar ertelenmiş başlıyor.
Dynamic PGO (profile-guided optimization; çalışma anında toplanan profile göre optimizasyon) .NET 8'den beri varsayılan olarak açık ve araya bir katman ekliyor: 01. yazıdaki IsCheap Tier0, Instrumented Tier0, Tier1 sırasıyla ilerlemişti. Instrumented Tier0 optimize edilmemiş ama sayaç eklenmiş bir kopya; hangi dalın kaç kez alındığını, bir interface çağrısının arkasından hangi class'ların geldiğini kaydediyor. Tier1 bu profil ile derleniyor (with Dynamic PGO).
Bizim çıktı farklı, çünkü üç method'da da döngü var. Runtime, döngülü method'ların ilk derlemesinde JIT'e "döngü varsa sayaç ekle" diyor. Tiers yalnız bir kez çağrılıyor ve 30 çağrıya hiç ulaşmayacak; burada OSR (on-stack replacement; çalışmakta olan döngüyü ortasında optimize edilmiş koda geçirmek) devreye giriyor. Tier0 kod döngü başlarına patchpoint denen sayaçlı noktalar koyuyor; sayaç dolunca JIT method'un yalnız döngüden sonrasını kapsayan bir sürümünü derliyor ve çalışan frame'i yeni koda taşıyor. @0x1b, geçişin yapıldığı IL konumu, yani döngü başı. OSR kodu da profil ile derlenebilsin diye döngülü method'lar baştan sayaçlı derleniyor.
CountInStock'un iki kez Instrumented Tier0 görünmesi de bundan: runtime ilk derlemeyi hâlâ sıradan Tier0 sayıyor ve 30 çağrıdan sonra her method gibi onun da sayaçlı kopyasını üretiyor. Tier1 derlemeleri arka plan thread'inde yapılıyor; o sırada uygulama eski kodla çalışmaya devam ediyor.
QuickJitForLoops: Doküman mı, Runtime mı?
Microsoft Learn'deki compilation ayarları sayfası, döngü içeren method'lar için quick JIT'in (Tier0) ayar verilmediğinde kapalı olduğunu yazıyor. Yukarıdaki çıktı ise açık olduğunu gösteriyor. Hangisinin doğru olduğunu runtime'ın kendisi söylüyor: .NET 10 dalındaki clrconfigvalues.h'de TC_QuickJitForLoops'un varsayılanı OSR destekleyen platformlarda 1, desteklemeyenlerde 0. switches.h OSR'ı 64-bit hedeflerde açıyor; yani x64 ve Arm64'te döngülü method'lar da Tier0'dan başlıyor. Ayarı kapatınca fark net:
$ DOTNET_TC_QuickJitForLoops=0 DOTNET_JitStdOutFile=jit.txt DOTNET_JitDisasmSummary=1 dotnet samples/JitLab/bin/Release/net10.0/JitLab.dll tiers
total: 14000000
$ grep -E 'Lab:|Tiers' jit.txt
   8: JIT compiled Program:<<Main>$>g__Tiers|0_0(Bookstore.Catalog.Book[]) [Tier-0 switched to FullOpts, IL size=77, code size=398]
   9: JIT compiled Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[]) [Tier-0 switched to FullOpts, IL size=33, code size=55]
  10: JIT compiled Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[],int) [Tier-0 switched to FullOpts, IL size=31, code size=89]
Üç method da tek seferde, profil olmadan tam optimize ediliyor ve bir daha derlenmiyor; OSR olmayan 32-bit platformlarda varsayılan davranış da bu. Dokümanla runtime çeliştiğinde belirleyici olan runtime'ın kaynak kodu ve kendi ölçümün.
Dynamic PGO ve Guarded Devirtualization
Şimdi ilk tahmine dönelim. pgo komutu CountMatches'ı çağrıların onda dokuzunda InStock, onda birinde PublishedBefore ile çağırıyor:
static void Pgo(Book[] books)
{
    IBookRule inStock = new InStock();
    IBookRule old = new PublishedBefore(1900);
    int total = 0;
    for (int round = 0; round < 50; round++)
    {
        // 10 çağrının 9'u InStock'a gidiyor
        for (int i = 0; i < 1_000; i++)
            total += Lab.CountMatches(books, i % 10 == 0 ? old : inStock);
        Thread.Sleep(10);
    }
    Console.WriteLine($"total: {total}");
}DOTNET_JitDisasm, adı verilen method'un makine kodunu yazdırıyor; DOTNET_JitDisasmOnlyOptimized=1 yalnız optimize edilmiş sürümü, DOTNET_JitDisasmDiffable=1 ise adresleri sabit bir değerle (0xD1FFAB1E) değiştirerek gösteriyor. Prolog, epilog ve başlık satırlarının bir kısmını kısalttım:
$ DOTNET_JitDisasm=CountMatches DOTNET_JitDisasmOnlyOptimized=1 DOTNET_JitDisasmDiffable=1 dotnet samples/JitLab/bin/Release/net10.0/JitLab.dll pgo
total: 245000
; Assembly listing for method Bookstore.JitLab.Lab:CountMatches(Bookstore.Catalog.Book[],Bookstore.JitLab.IBookRule):int (Tier1)
; optimized using Dynamic PGO

...
G_M000_IG04:
       mov      rsi, gword ptr [r13]
       mov      rdi, 0xD1FFAB1E
       cmp      qword ptr [rbx], rdi
       jne      SHORT G_M000_IG10
G_M000_IG05:
       cmp      dword ptr [rsi+0x24], 0
       jle      SHORT G_M000_IG07
G_M000_IG06:
       inc      r15d
G_M000_IG07:
       add      r13, 8
       dec      r14d
       jne      SHORT G_M000_IG04
...
G_M000_IG10:
       mov      rdi, rbx
       mov      r11, 0xD1FFAB1E
       call     [r11]Bookstore.JitLab.IBookRule:Matches(Bookstore.Catalog.Book):bool:this
       test     eax, eax
       je       SHORT G_M000_IG07
       jmp      SHORT G_M000_IG06
; Total bytes of code 103
Tahminin cevabı: döngünün sık çalışan yolunda interface çağrısı yok. cmp qword ptr [rbx], rdi, rule object'inin tipini InStock'un tipiyle karşılaştırıyor. Eşitse InStock.Matches'ın gövdesi doğrudan çalışıyor: cmp dword ptr [rsi+0x24], 0, book.Stock > 0'ın ta kendisi. Matches da Stock da inline edilmiş. Tip farklıysa G_M000_IG10'daki gerçek interface çağrısı yapılıyor. Buna guarded devirtualization deniyor: profil "burada neredeyse hep InStock var" dedi, JIT de bu tahmini bir tip kontrolüyle koruyarak sanal çağrıyı doğrudan koda çevirdi.
Aynı programı Dynamic PGO kapalıyken çalıştırınca döngünün her turunda bir interface çağrısı var:
$ DOTNET_TieredPGO=0 DOTNET_JitDisasm=CountMatches DOTNET_JitDisasmOnlyOptimized=1 DOTNET_JitDisasmDiffable=1 dotnet samples/JitLab/bin/Release/net10.0/JitLab.dll pgo
total: 245000
; Assembly listing for method Bookstore.JitLab.Lab:CountMatches(Bookstore.Catalog.Book[],Bookstore.JitLab.IBookRule):int (Tier1)
; No PGO data

...
G_M000_IG04:
       mov      rsi, gword ptr [r13]
       mov      rdi, rbx
       mov      r11, 0xD1FFAB1E
       call     [r11]Bookstore.JitLab.IBookRule:Matches(Bookstore.Catalog.Book):bool:this
       test     eax, eax
       je       SHORT G_M000_IG06
G_M000_IG05:
       inc      r15d
G_M000_IG06:
       add      r13, 8
       dec      r14d
       jne      SHORT G_M000_IG04
...
; Total bytes of code 80
Farkın bedelini BenchmarkDotNet ile ölçtüm; aynı benchmark iki job'da, biri DOTNET_TieredPGO=0 ile çalışıyor. Benchmark 1.000 kitaplık bir array'de InStock kuralını sayıyor. Çıktının makine bilgisi içeren başlık satırlarını çıkardım; mutlak süreler makineye göre değişir:
$ dotnet run -c Release --project benchmarks/Bookstore.Filter.Benchmarks -- --filter '*RuleBenchmarks*'
...
| Method       | Job     | EnvironmentVariables | Mean       | Error    | StdDev   |
|------------- |-------- |--------------------- |-----------:|---------:|---------:|
| CountMatches | PGO off | DOTNET_TieredPGO=0   | 1,085.0 ns | 21.27 ns | 38.89 ns |
| CountMatches | PGO on  | Empty                |   369.0 ns |  7.38 ns | 10.10 ns |
PGO açıkken yaklaşık üç kat hızlı. Kazancın çoğu çağrının kendisinden değil, devirtualization'ın açtığı kapıdan geliyor: çağrı yerinde gövde görünür olunca JIT onu inline edebiliyor, inline edilen kodu çevresiyle birlikte optimize edebiliyor. Deneyi birkaç kez çalıştırınca bir keresinde JIT'in tip kontrolünü döngünün dışına aldığını gördüm; profil zamanlamaya bağlı toplandığı için Tier1 kodunun şekli çalıştırmadan çalıştırmaya değişebiliyor.
Inlining, Bounds Check ve Loop Cloning
C#'ta books[i] her erişimde index'in array sınırları içinde olup olmadığını kontrol ettirir; geçersizse IndexOutOfRangeException fırlar. JIT bu kontrolü gereksiz olduğunu kanıtlayabildiği yerde siliyor. İlk CountInStock'un Tier1 kodu:
; Assembly listing for method Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[]):int (Tier1)
; optimized using Dynamic PGO

G_M000_IG01:
       push     rbp
       mov      rbp, rsp
G_M000_IG02:
       xor      eax, eax
       mov      ecx, dword ptr [rdi+0x08]
       test     ecx, ecx
       jle      SHORT G_M000_IG07
G_M000_IG03:
       add      rdi, 16
       align    [15 bytes for IG04]
G_M000_IG04:
       mov      rdx, gword ptr [rdi]
       cmp      dword ptr [rdx+0x24], 0
       jle      SHORT G_M000_IG06
G_M000_IG05:
       inc      eax
G_M000_IG06:
       add      rdi, 8
       dec      ecx
       jne      SHORT G_M000_IG04
G_M000_IG07:
       pop      rbp
       ret
; Total bytes of code 53
Ne bir çağrı ne bir sınır kontrolü var. i < books.Length koşulu her index'in geçerli olduğunu garanti ettiği için JIT kontrolü kaldırmış, hatta index'i hiç tutmayıp bir pointer'ı 8'er byte ilerletiyor ve kalan eleman sayısını dec ecx ile geri sayıyor. get_Stock çağrısı da yok; küçük method'lar varsayılan olarak inline ediliyor ve property okuma tek bir cmp komutuna dönüşüyor.
İkinci sürümde sınır take; JIT take'in array'in uzunluğunu aşmadığını bilemez:
; Assembly listing for method Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[],int):int (Tier1)
; optimized using Synthesized PGO

G_M000_IG01:
       push     rbp
       mov      rbp, rsp
G_M000_IG02:
       xor      eax, eax
       xor      ecx, ecx
       test     esi, esi
       jle      SHORT G_M000_IG09
G_M000_IG03:
       test     rdi, rdi
       je       SHORT G_M000_IG12
G_M000_IG04:
       cmp      dword ptr [rdi+0x08], esi
       jl       SHORT G_M000_IG12
G_M000_IG05:
       add      rdi, 16
G_M000_IG06:
       mov      rcx, gword ptr [rdi]
       cmp      dword ptr [rcx+0x24], 0
       jle      SHORT G_M000_IG08
G_M000_IG07:
       inc      eax
G_M000_IG08:
       add      rdi, 8
       dec      esi
       jne      SHORT G_M000_IG06
G_M000_IG09:
       pop      rbp
       ret
G_M000_IG10:
       inc      eax
G_M000_IG11:
       inc      ecx
       cmp      ecx, esi
       jge      SHORT G_M000_IG09
G_M000_IG12:
       cmp      ecx, dword ptr [rdi+0x08]
       jae      SHORT G_M000_IG13
       mov      edx, ecx
       mov      rdx, gword ptr [rdi+8*rdx+0x10]
       cmp      dword ptr [rdx+0x24], 0
       jle      SHORT G_M000_IG11
       jmp      SHORT G_M000_IG10
G_M000_IG13:
       call     CORINFO_HELP_RNGCHKFAIL
       int3
; Total bytes of code 81
Burada JIT loop cloning yapıyor: döngünün iki kopyası var. Döngüden önce bir kez bakıyor; array null değilse ve uzunluğu take'ten küçük değilse kontrolsüz hızlı kopyaya (G_M000_IG06) giriyor. Değilse her turda cmp ecx, dword ptr [rdi+0x08] ile sınırı kontrol eden yavaş kopya (G_M000_IG12) çalışıyor ve sınır aşılınca CORINFO_HELP_RNGCHKFAIL exception'ı fırlatıyor. Anlam değişmiyor: testlerden biri take array'den büyükken exception'ın hâlâ geldiğini doğruluyor.
.NET 10: Escape Analysis ve Stack Allocation
İkinci tahmin için ShippingDays'in yanına iki method daha koyalım:
// 'limit'i yakalayan bir lambda: closure object'i + delegate
[MethodImpl(MethodImplOptions.NoInlining)]
public static int CountCheaperThan(Book[] books, decimal limit)
{
    Func<Book, bool> cheap = book => book.Price < limit;
    int count = 0;
    foreach (Book book in books)
    {
        if (cheap(book))
            count++;
    }
    return count;
}

// IEnumerable<Book> üzerinden görülen bir array: foreach bir enumerator object'i ister
[MethodImpl(MethodImplOptions.NoInlining)]
public static int CountInStockSeq(Book[] books)
{
    IEnumerable<Book> sequence = books;
    int count = 0;
    foreach (Book book in sequence)
    {
        if (book.Stock > 0)
            count++;
    }
    return count;
}
alloc komutu önce her method'u Tier1'e ulaşacak kadar çalıştırıyor, sonra 10.000 çağrının thread'e ayırttığı byte'ları GC.GetAllocatedBytesForCurrentThread ile ölçüyor:
static void Measure(string name, Func<int> action)
{
    const int calls = 10_000;
    long before = GC.GetAllocatedBytesForCurrentThread();
    for (int i = 0; i < calls; i++)
        action();
    long perCall = (GC.GetAllocatedBytesForCurrentThread() - before) / calls;
    Console.WriteLine(string.Create(CultureInfo.InvariantCulture, $"{name,-18} {perCall,4} bytes/call"));
}
Proje net10.0 ve net9.0'ı birlikte hedefliyor; .NET 9 runtime'ı kurulu bir makinede aynı kodu iki runtime'da çalıştırabilirsin:
$ dotnet run -c Release --project samples/JitLab -f net9.0 -- alloc
.NET 9.0.22
ShippingDays         40 bytes/call
CountCheaperThan     96 bytes/call
CountInStockSeq      32 bytes/call
$ dotnet run -c Release --project samples/JitLab -f net10.0 -- alloc
.NET 10.0.15
ShippingDays          0 bytes/call
CountCheaperThan     32 bytes/call
CountInStockSeq       0 bytes/call
İkinci tahminin cevabı: .NET 9'da her çağrı 40 byte (üç int, object header'ı ve uzunluk alanıyla), .NET 10'da sıfır. Kod ve IL aynı; değişen JIT. .NET 10'un escape analysis'i limits'in method'un dışına hiç çıkmadığını görüyor: döndürülmüyor, bir alana yazılmıyor, inline edilmemiş bir method'a geçirilmiyor. Böyle bir object heap yerine method'un stack frame'inde oluşturulabilir. Makine kodu da bunu gösteriyor:
$ DOTNET_JitDisasm=ShippingDays DOTNET_JitDisasmOnlyOptimized=1 DOTNET_JitDisasmDiffable=1 dotnet samples/JitLab/bin/Release/net9.0/JitLab.dll alloc
...
; Assembly listing for method Bookstore.JitLab.Lab:ShippingDays(int):int (Tier1)
...
G_M000_IG02:
       mov      rdi, 0xD1FFAB1E
       mov      esi, 3
       call     CORINFO_HELP_NEWARR_1_VC
       mov      rcx, 0xD1FFAB1E
       mov      rdx, qword ptr [rcx]
       mov      qword ptr [rax+0x10], rdx
       mov      edx, dword ptr [rcx+0x08]
       mov      dword ptr [rax+0x18], edx
       mov      ecx, 1
       add      rax, 16
       mov      edx, 3
       align    [0 bytes for IG03]
...
; Total bytes of code 90
$ DOTNET_JitDisasm=ShippingDays DOTNET_JitDisasmOnlyOptimized=1 DOTNET_JitDisasmDiffable=1 dotnet samples/JitLab/bin/Release/net10.0/JitLab.dll alloc
...
; Assembly listing for method Bookstore.JitLab.Lab:ShippingDays(int):int (Tier1)
...
G_M000_IG02:
       mov      rax, 0xD1FFAB1E
       mov      qword ptr [rbp-0x20], rax
       lea      rax, [rbp-0x20]
       mov      dword ptr [rax+0x08], 3
       lea      rax, [rbp-0x20]
       mov      rcx, 0xD1FFAB1E
       mov      rdx, qword ptr [rcx]
       mov      qword ptr [rax+0x10], rdx
       mov      edx, dword ptr [rcx+0x08]
       mov      dword ptr [rax+0x18], edx
       mov      ecx, 1
       add      rax, 16
       mov      edx, 3
       align    [10 bytes for IG03]
...
; Total bytes of code 118
.NET 9 heap'te array ayıran CORINFO_HELP_NEWARR_1_VC helper'ını çağırıyor. .NET 10 aynı array'in header'ını ve uzunluğunu (3) kendi stack frame'ine, [rbp-0x20]'ye yazıyor; GC'nin (garbage collector; kullanılmayan object'leri toplayıp belleği geri alan bileşen) haberi bile olmuyor. Kod 28 byte uzamış, ama her çağrıda bir allocation ve ileride bir GC işi eksilmiş.
CountCheaperThan'da 96 byte'tan 32'ye inen kısım delegate. C# compiler'ı lambda için limit'i tutan bir closure class'ı ve onun method'unu gösteren bir Func<Book, bool> üretiyor. .NET 10 dışarı kaçmayan delegate'i stack'e alıyor; closure object'i hâlâ heap'te. Microsoft'un .NET 10 runtime yenilikleri sayfası closure'ların stack'e alınmasının ileriki sürümlere bırakıldığını söylüyor.
CountInStockSeq ise .NET 10'un array interface devirtualization'ını gösteriyor. Array'i IEnumerable<Book> olarak gezmek, .NET 9'da her elemanda interface çağrıları ve heap'te bir enumerator demek:
$ DOTNET_JitDisasm=CountInStockSeq DOTNET_JitDisasmOnlyOptimized=1 DOTNET_JitDisasmDiffable=1 DOTNET_JitStdOutFile=seq-net9.txt dotnet samples/JitLab/bin/Release/net9.0/JitLab.dll alloc > /dev/null
$ DOTNET_JitDisasm=CountInStockSeq DOTNET_JitDisasmOnlyOptimized=1 DOTNET_JitDisasmDiffable=1 DOTNET_JitStdOutFile=seq-net10.txt dotnet samples/JitLab/bin/Release/net10.0/JitLab.dll alloc > /dev/null
$ grep -E 'call|Total' seq-net9.txt
       call     [r11]System.Collections.Generic.IEnumerable`1[System.__Canon]:GetEnumerator():System.Collections.Generic.IEnumerator`1[System.__Canon]:this
       call     [System.ThrowHelper:ThrowInvalidOperationException_EnumCurrent(int)]
       call     [r11]System.Collections.IEnumerator:MoveNext():ubyte:this
       call     [r11]System.Collections.Generic.IEnumerator`1[System.__Canon]:get_Current():System.__Canon:this
       call     CORINFO_HELP_RNGCHKFAIL
       call     [r11]System.IDisposable:Dispose():this
       call     [r11]System.IDisposable:Dispose():this
; Total bytes of code 275
$ grep -E 'call|Total' seq-net10.txt
       call     [System.ThrowHelper:ThrowInvalidOperationException_EnumCurrent(int)]
; Total bytes of code 52
.NET 9'un 275 byte'lık kodundaki GetEnumerator, MoveNext, get_Current ve Dispose çağrıları .NET 10'da yok; JIT array'in enumerator'ını devirtualize edip inline ediyor, enumerator object'ini de stack'e alıyor ve sonuç 52 byte'lık, düz bir array döngüsü. Kalan tek çağrı hiç çalışmayan bir hata yolu.
Stack allocation yalnız boyutu derleme anında bilinen küçük object'lerde yapılıyor (JitObjectStackAllocationSize ayarının varsayılanı 528 byte). Object döndürülürse, bir field'a yazılırsa ya da inline edilmeyen bir method'a geçirilirse heap'e geri dönüyor. Kodu bu optimizasyona göre şekillendirme; JIT yapabildiği yerde yapıyor.
V8'de Aynı Fikirler: Hidden Class ve Deoptimization
V8 (Chrome ve Node.js'in JavaScript engine'i) aynı problemi tip bilgisi olmadan çözüyor. 01. yazıda gördüğümüz gibi kod Ignition interpreter'ında başlıyor, sonra Sparkplug, Maglev ve TurboFan katmanlarına çıkıyor. Optimize eden katmanların dayandığı bilgi object'lerin şekli. V8 aynı property'leri aynı sırayla alan object'lere aynı hidden class'ı (V8'in içinde "map" deniyor) veriyor:
// Çalıştırmak için: node --allow-natives-syntax shapes.js
const dune = { title: "Dune", price: 349.9 };
const emma = { title: "Emma", price: 199 };
const hobbit = { price: 289.5, title: "The Hobbit" };

console.log("dune/emma same hidden class:", %HaveSameMap(dune, emma));
console.log("dune/hobbit same hidden class:", %HaveSameMap(dune, hobbit));
$ node --allow-natives-syntax samples/v8-tiers/shapes.js
dune/emma same hidden class: true
dune/hobbit same hidden class: false%HaveSameMap yalnız --allow-natives-syntax ile açılan bir V8 iç fonksiyonu; üretim kodunda kullanılmaz. Alanlar aynı ama sıra farklı olduğu için hobbit başka bir şekle sahip. Optimize eden compiler, "book hep bu map'le geldi" varsayımıyla price'ı sabit bir offset'ten okuyan kod üretiyor ve varsayımı bir map kontrolüyle koruyor; .NET'in guarded devirtualization'ına çok benzer. Fark, kontrol başarısız olunca ne olduğunda:
function totalPrice(books) {
  let total = 0;
  for (const book of books) total += book.price;
  return total;
}

const books = [
  { title: "Dune", price: 349.9 },
  { title: "Emma", price: 199 },
  { title: "The Hobbit", price: 289.5 },
];

let sum = 0;
for (let i = 0; i < 100_000; i++) sum += totalPrice(books);

// başka bir kaynaktan gelen kitap: alanlar aynı, sıra farklı -> başka bir hidden class
books.push({ price: 310, title: "Middlemarch" });
sum += totalPrice(books);
console.log(`sum: ${sum.toFixed(1)}`);
$ node --trace-deopt samples/v8-tiers/deopt.js 2>&1 | grep -E 'totalPrice|sum'
[bailout (kind: deopt-eager, reason: wrong map): begin. deoptimizing 0x24520daab141 <JSFunction totalPrice (sfi = 0x24520daa8249)>, 0x2ac1f3e41e71 <Code MAGLEV>, opt id 2, bytecode offset 52, deopt exit 11, FP to SP delta 48, caller SP 0x00016baa5150, pc 0x0001226809b0]
sum: 83841148.4reason: wrong map: Maglev'in derlediği totalPrice, beklemediği şekilde bir object görünce bırakıldı ve fonksiyon interpreter'a geri döndü. Buna deoptimization deniyor. .NET'te bu mekanizma yok: guarded devirtualization'ın yavaş yolu aynı makine kodunun içinde duruyor, tahmin tutmayınca kod bırakılmıyor. C#'ta tipler derleme anında bilindiği için JIT'in tahmin ettiği tek şey "hangi alt tip"; "bu değer gerçekten sayı mı" sorusu hiç doğmuyor.
Üretimde Dikkat
Tiered compilation'ın bedelini uygulamanın ilk saniyeleri ödüyor: yeni açılan bir API ilk isteklerini Tier0 koduyla karşılıyor. Load balancer arkasında yeni açılan bir instance'ın hemen tam trafik alınca ilk isteklerde yavaş kalmasının bir nedeni bu. Startup'ı hazır makine koduyla başlatmanın yolları, ReadyToRun ve Native AOT (ahead-of-time; makine kodunu publish sırasında üretmek), bir sonraki yazının konusu.
CPU limit'i 1 ya da daha az olan bir container'da runtime tek işlemci görüyor ve 100 ms'lik call counting gecikmesini 10 ile çarpıyor (TC_DelaySingleProcMultiplier). Tier geçişleri bir saniye kadar gecikiyor, arka plandaki Tier1 derlemeleri de uygulamayla aynı CPU'yu paylaşıyor; küçük limitli servislerin warm-up süresinin uzun olmasının bir nedeni bu.
DOTNET_TieredPGO=0 ya da TieredCompilation=false gibi ayarlara, bir ölçüm göstermeden dokunma. Yukarıdaki benchmark'ta PGO'yu kapatmak üç kat yavaşlık demekti. DOTNET_JitDisasm ailesi Release runtime'da da çalışıyor ama çıktıyı stdout'a yazıyor; onu üretimde değil, aynı build'in yerel bir kopyasında kullan. JIT istatistiklerini üretimde izlemek .NET'te Profiling ve Diagnostics serisinin konusu.
Sık Düşülen Tuzaklar
Warm-up yapmadan ölçmek. Stopwatch ile ilk birkaç turu ölçersen Tier0 kodunu ölçersin. warmup komutu aynı CountMatches çağrısını sekiz tur ölçüyor:
$ dotnet run -c Release --project samples/JitLab -f net10.0 -- warmup
round 1:      208 us
round 2:      287 us
round 3:      237 us
round 4:      232 us
round 5:     5300 us
round 6:       16 us
round 7:       18 us
round 8:       33 us
İlk dört tur Tier0 ve sayaçlı kod, altıncı turdan sonrası Tier1: aynı iş on kattan fazla hızlanıyor, geçiş sırasındaki tur ise belirgin şekilde yavaş. BenchmarkDotNet warm-up turlarını kendisi yapıyor ve sonucu istatistikle veriyor; kullanımı C# İleri serisinin "C#'ta Performans: Allocation, Struct'lar ve BenchmarkDotNet ile Ölçmek" yazısında.
Debug build'de performans yorumlamak. dotnet run varsayılan olarak Debug derliyor ve Debug assembly'lerinde JIT optimizasyonu kapalı:
$ dotnet build samples/JitLab
$ DOTNET_JitStdOutFile=jit.txt DOTNET_JitDisasmSummary=1 dotnet samples/JitLab/bin/Debug/net10.0/JitLab.dll tiers
total: 14000000
$ grep -E 'Lab:|Tiers' jit.txt
   8: JIT compiled Program:<<Main>$>g__Tiers|0_0(Bookstore.Catalog.Book[]) [MinOpts, IL size=85, code size=233]
   9: JIT compiled Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[]) [MinOpts, IL size=50, code size=173]
11: JIT compiled Bookstore.JitLab.Lab:CountInStock(Bookstore.Catalog.Book[],int) [MinOpts, IL size=48, code size=172]MinOpts, debugger'ın her değişkeni görebilmesi için optimizasyonsuz derleme demek; tier geçişi, OSR ve PGO yok. Debug'da yapılan her performans karşılaştırması anlamsız.
[MethodImpl(MethodImplOptions.AggressiveInlining)]'i her yere koymak. Küçük method'lar zaten inline ediliyor; .NET 10 profil verisi olan çağrı yerlerinde daha büyüklerini de inline edebiliyor. Attribute JIT'in maliyet hesabını devre dışı bırakıyor: büyük bir method'u her çağrı yerine kopyalamak kodu büyütüyor ve instruction cache'i dolduruyor. Sanal ve interface çağrılarında ise hiçbir işe yaramıyor, çünkü inline edilecek gövde belli değil. Yalnız benchmark'la fark gösterdiğin yerde kullan.
Küçük Bir Deneme
★☆☆ tiers komutunu DOTNET_TieredCompilation=0 ile çalıştır ve JitDisasmSummary çıktısını yukarıdakilerle karşılaştır. Her method kaç kez derlendi, hangi etiketle?
★★☆ IBookRule'a üçüncü bir class ekle ve pgo komutunda çağrıları üç kurala eşit dağıt. CountMatches'ın Tier1 kodunda kaç tip kontrolü görüyorsun? Dağılımı 8/1/1 yapınca ne değişiyor?
★★★ ShippingDays'deki array'i dışarı kaçır: önce method'dan döndür, sonra bir static field'a yaz, en son new int[quantity % 4 + 1] ile boyutunu çalışma anına bağla. Her durumda alloc çıktısını ve CORINFO_HELP_NEWARR_1_VC'nin yerini kontrol et.
Bu yazıda makine kodu program çalışırken, kademeli olarak üretildi. Bir sonraki yazıda bu işi build'e taşıyoruz: aynı Bookstore API'sini JIT, ReadyToRun ve Native AOT ile publish edip startup süresini, belleği ve throughput'u ölçeceğiz; filtre dilimizin Expression.Compile() çağrısının Native AOT'de neye dönüştüğü de orada.