

Garbage Collection Nasıl Çalışır: Mark-Sweep-Compact, Generational GC ve .NET'in Server GC'si
Tracing GC, root'lardan ulaşılabilen object'leri işaretleyip gerisini çöp sayar; .NET bu işi generation'lara bölüp write barrier ve card table ile gen0 GC'yi ucuz tutar. Bookstore filtre dilinin interpreter'ının beş saniyede 10 GB allocation ve 1.365 gen0 GC ürettiğini, derlenmiş delegate'in ise hiç GC tetiklemediğini dotnet-counters ve BenchmarkDotNet ile gösteriyor; LOH'u, Workstation, Server GC ve DATAS'ı, gerçek leak ile toplanmamış belleğin farkını ölçüyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (SDK 10.0.404, runtime 10.0.15) ile derlenip xUnit v3 4.0.3 testleriyle doğrulanmıştır; ölçümlerde BenchmarkDotNet 0.15.8 ve dotnet-counters 10.0.750501 kullanılmıştır. Assembly çıktısı x64 Linux üzerinde alınmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için yazdığımız filtre dilinin iki implementation'ı var: 03. yazıdaki tree-walking interpreter ve 04. yazıda expression tree'den derlenen delegate. İkisi de aynı kitapları döndürüyor. 100.000 kitaplık bir katalogda price < 300 and author = "Jane Austen" filtresini beş saniye boyunca durmadan çalıştırıyoruz.
Birinci soru: Bu beş saniyede garbage collector (GC; artık kullanılmayan object'leri bulup belleği geri alan runtime bileşeni) interpreter için kaç kez, derlenmiş delegate için kaç kez çalışır?
İkinci soru: Bir kapak resmini tutan new byte[84_000] ile new byte[85_000] arasında GC açısından bir fark var mı?
Belleği Kim Geri Verir?
C'de belleği alan kod onu free ile geri vermekten de sorumlu. Unutursan memory leak, iki kez verirsen ya da verdikten sonra kullanırsan bellek bozulması oluyor. Otomatik bellek yönetiminin ilk yaygın yolu reference counting: her object'in kaç referansla tutulduğunu sayıp sayaç sıfıra inince belleği hemen geri vermek. Swift ve CPython bu yolu kullanıyor. Zayıf noktası döngüler: bir Author kitaplarını, her Book da yazarını gösteriyorsa, dışarıdan hiçbir referans kalmasa bile ikisinin sayacı sıfıra inmez. Bu yüzden ya programcı bazı referansları "weak" olarak işaretler ya da runtime döngüleri ayrıca toplayan ikinci bir mekanizma ekler.
.NET, JVM (Java Virtual Machine; Java'nın runtime'ı), V8 (Chrome ve Node.js'in JavaScript engine'i) ve Go'nun seçtiği yol tracing GC. Sayaç tutmak yerine GC zaman zaman çalışıp "programın hâlâ ulaşabildiği object'ler hangileri?" sorusunu cevaplıyor. Ulaşılamayan her şey çöp; döngü olup olmaması önemli değil. Bunun bedeli, GC'nin ne zaman çalışacağını programın değil runtime'ın belirlemesi.
Mark, Sweep, Compact
Tracing GC'nin çıkış noktası root'lar: thread'lerin stack'lerindeki local değişkenler, static field'lar, CPU register'larındaki referanslar ve GC handle'ları. Mark aşamasında GC root'lardan başlayıp referansları izliyor ve ulaştığı her object'i işaretliyor; bu, Algoritmalar serisindeki graph traversal'ın ta kendisi. Sweep aşamasında işaretlenmemiş object'lerin kapladığı alan boş sayılıyor.
Yalnız sweep yaparsan heap zamanla delik deşik olur: toplamda yer olduğu hâlde büyük bir object'i yerleştirecek tek parça bir boşluk bulunamaz. Compact aşaması yaşayan object'leri yan yana kaydırıyor ve onlara işaret eden bütün referansları yeni adreslere göre güncelliyor. Bu sayede yeni bir allocation çoğu zaman bir pointer'ı ilerletmek kadar ucuz. Bedeli, object'ler taşınırken programın durması gerekmesi. .NET bu duraklamayı kısaltmak için iki şey yapıyor: heap'in tamamını değil küçük bir parçasını toplamak ve büyük toplamaların işaretleme kısmını uygulamayla eş zamanlı yürütmek.
Generation'lar ve Write Barrier
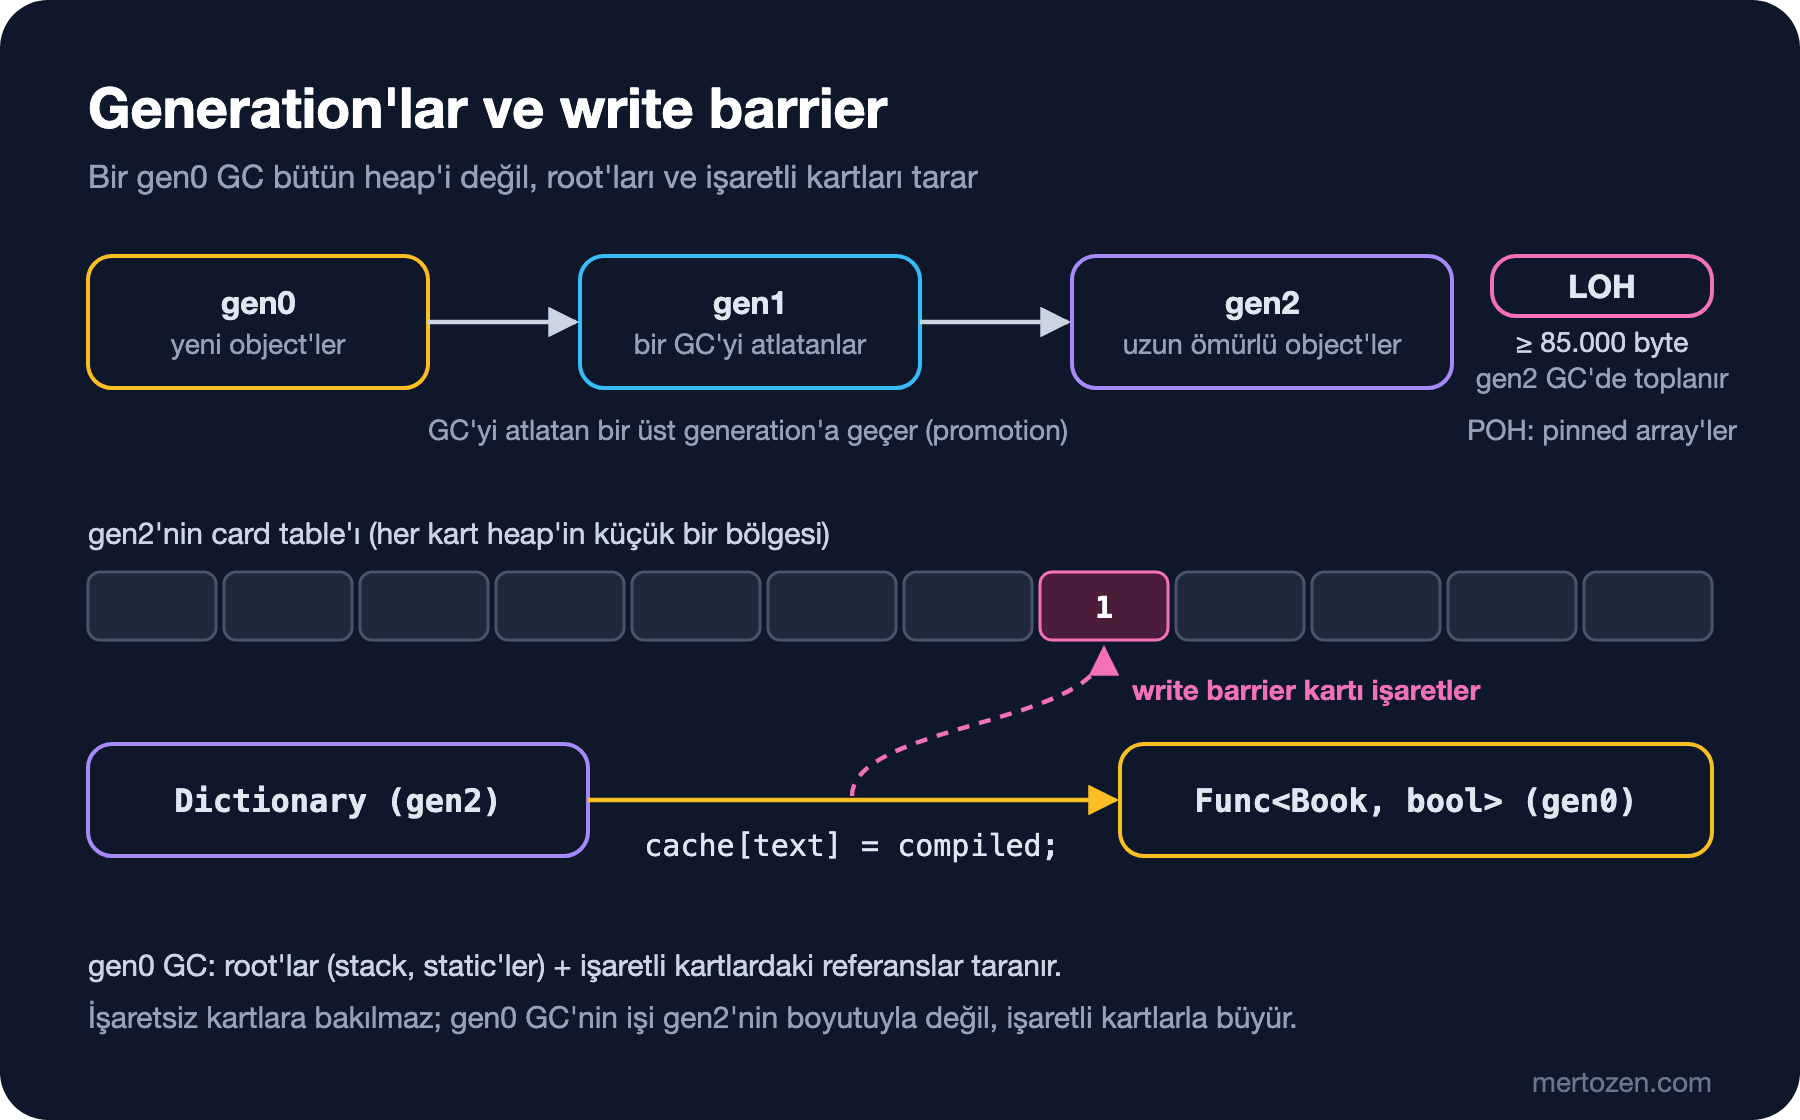
Heap'in küçük bir parçasını toplamanın gerekçesi generational hypothesis: object'lerin çoğu genç ölür. Bir HTTP isteği için üretilen string'ler, DTO'lar (data transfer object; katmanlar arasında veri taşıyan basit class'lar), LINQ (Language Integrated Query; C#'ın sorgu operatörleri) enumerator'ları istek bitince çöp oluyor; katalog cache'i ise saatlerce yaşıyor. .NET heap'i üç generation'a bölüyor: yeni object'ler gen0'da başlıyor, bir GC'yi atlatan gen1'e, bir tane daha atlatan gen2'ye geçiyor. GcLab örneğinde GC.Collect'i yalnız bu geçişi göstermek için çağırıyoruz:
Book book = new("9780441172719", "Dune", "Frank Herbert", 349.90m, 1965, 12);
Console.WriteLine($"new Book:               gen {GC.GetGeneration(book)}");
// GC.Collect yalnız promotion'ı göstermek için; bir uygulamada böyle çağırma
GC.Collect(0);
Console.WriteLine($"after a gen0 GC:        gen {GC.GetGeneration(book)}");
GC.Collect(1);
Console.WriteLine($"after a gen1 GC:        gen {GC.GetGeneration(book)}");

byte[] thumbnail = new byte[84_000];
byte[] cover = new byte[85_000];
byte[] pinned = GC.AllocateArray<byte>(4_096, pinned: true);
$ dotnet run -c Release --project samples/GcLab -- gens
new Book: gen 0
after a gen0 GC: gen 1
after a gen1 GC: gen 2
byte[84_000] thumbnail: gen 0
byte[85_000] cover: gen 2 (LOH)
pinned byte[4_096]: gen 2 (POH)Gen0 GC sık ve ucuz: yalnız genç object'lere bakıyor ve çoğu ölü olduğu için az iş çıkıyor. Ama bir sorun var. Gen2'deki eski bir object, yeni oluşturulmuş bir gen0 object'ini gösterebilir; örneğin uzun ömürlü bir cache'e yeni bir kayıt eklendiğinde. Gen0 GC gen2'yi taramazsa o object'i ölü sanıp siler. Bütün gen2'yi taramak ise generation'ların bütün faydasını götürür.
Çözüm write barrier. JIT (just-in-time; uygulama çalışırken makine kodu üreten compiler), bir object'in referans tutan bir field'ına yazan her komutun yanına küçük bir helper çağrısı ekliyor. Bu helper, yazılan adresin bulunduğu bölgeyi card table adlı bir tabloda işaretliyor. Gen0 GC root'ların yanında yalnız işaretli kartlardaki referanslara bakıyor. 05. yazıdaki DOTNET_JitDisasm ile bunu görebiliriz:
public sealed class Shelf
{
    public Book? Latest;
    public int Count;

    // referans yazmak write barrier'dan geçer, int yazmak geçmez
    [MethodImpl(MethodImplOptions.NoInlining)]
    public void Put(Book book)
    {
        Latest = book;
        Count++;
    }
}
$ DOTNET_JitDisasm=Put DOTNET_JitDisasmOnlyOptimized=1 DOTNET_JitDisasmDiffable=1 dotnet samples/GcLab/bin/Release/net10.0/GcLab.dll barrier
...
; Assembly listing for method Bookstore.GcLab.Shelf:Put(Bookstore.Catalog.Book):this (Tier1)
G_M000_IG01:
push rbx
mov rbx, rdi
G_M000_IG02:
lea rdi, bword ptr [rbx+0x08]
call CORINFO_HELP_ASSIGN_REF
inc dword ptr [rbx+0x10]
G_M000_IG03:
pop rbx
ret
; Total bytes of code 18Latest = book tek bir mov değil, CORINFO_HELP_ASSIGN_REF çağrısı; Count++ ise sıradan bir inc. Her referans yazımı bu küçük bedeli ödüyor. .NET 10, x64'te zaten olan, GC ayarına göre farklı write barrier implementation'ları arasında geçiş yapabilme yeteneğini Arm64'e de getirdi; Microsoft'un yenilikler sayfasına göre yeni varsayılan Arm64 barrier'ı biraz daha yavaş yazıyor ama GC duraklamalarını yüzde 8 ile 20'nin üzeri arasında kısaltıyor.
LOH, POH ve Region'lar
İkinci tahminin cevabı yukarıdaki çıktıda: 85.000 byte ve üzerindeki object'ler doğrudan gen2'de görünüyor. Bunlar LOH'a (large object heap; büyük object'lerin ayrı tutulduğu heap) gidiyor; eşik GC.GetConfigurationVariables()'ın döndürdüğü LOHThreshold=85000. Büyük object'leri compact sırasında taşımak pahalı olduğu için LOH varsayılan olarak compact edilmiyor ve yalnız gen2 GC'lerinde toplanıyor. Pinned allocation'lar da .NET 5'ten beri ayrı bir yerde, POH'ta (pinned object heap; yeri değişmemesi gereken object'lerin heap'i) duruyor; native koda adresi verilen ve taşınmaması gereken buffer'lar SOH'u (small object heap; gen0, gen1 ve gen2'nin bulunduğu normal heap) parçalamasın diye. .NET 7'den beri heap, segment'ler yerine region denen daha küçük parçalardan oluşuyor; GC boşalan region'ları generation'lar arasında yeniden kullanabiliyor.
LOH'un pratik sonucunu aynı miktarda çöpü iki farklı boyutta üreterek görelim. Sink.Last, array'i static bir field'a yazıyor; aksi hâlde JIT hiç okunmayan bu allocation'ları tamamen silebiliyor:
// 200 MB kısa ömürlü küçük object: gen0 bunları ucuza toplar
for (int i = 0; i < 200_000; i++)
    Sink.Last = new byte[1_000];
Report("200 MB in 1 KB arrays");

// aynı 200 MB kapak resmi olarak: her array LOH'a gider, onu yalnız gen2 GC toplar
for (int i = 0; i < 200; i++)
    Sink.Last = new byte[1_000_000];
Report("200 MB in 1 MB arrays");
$ dotnet run -c Release --project samples/GcLab -- memory
start heap 0 MB | working set 42 MB | GCs gen0 0 gen2 0
200 MB in 1 KB arrays heap 4 MB | working set 56 MB | GCs gen0 24 gen2 0
200 MB in 1 MB arrays heap 3 MB | working set 69 MB | GCs gen0 39 gen2 15
5000 cached filters, full GC heap 14 MB | working set 76 MB | GCs gen0 44 gen2 17
10000 cached filters, full GC heap 28 MB | working set 88 MB | GCs gen0 49 gen2 19Küçük array'lerle 200 MB, 24 gen0 GC ile ve hiç gen2 GC olmadan temizlendi. Aynı 200 MB 1 MB'lık array'lerle 15 gen2 GC tetikledi; gen2 GC bütün heap'i işaretliyor ve en pahalı GC türü. Büyük buffer'ları sık sık ayırıp bırakan kodda (dosya yükleme, rapor üretme, büyük JSON) ArrayPool<byte>.Shared ile buffer'ları yeniden kullanmak bu yüzden fark yaratıyor. Çıktının son iki satırına Tuzaklar bölümünde döneceğiz.
Workstation, Server, Background GC ve DATAS
.NET GC'nin iki ana modu var. Workstation GC tek bir heap kullanıyor ve console uygulamalarının varsayılanı. Server GC her CPU çekirdeği için bir heap ve bir GC thread'i açıyor, daha büyük bir gen0 bütçesiyle daha seyrek ama paralel GC yapıyor; ASP.NET Core uygulamalarının varsayılanı bu. İkisinde de background GC açık: gen2 toplamasının işaretleme kısmı uygulama thread'leri çalışırken arka planda yürüyor. .NET 9'dan beri Server GC'de DATAS (Dynamic Adaptation To Application Sizes; heap sayısını ve bütçeleri yüke göre ayarlayan mod) da varsayılan olarak açık. Microsoft Learn'deki DATAS sayfasına göre DATAS tek heap ile başlıyor, yük arttıkça heap ekliyor, azaldıkça bırakıyor ve heap boyutunu uzun ömürlü verinin boyutuna yakın tutmaya çalışıyor.
modes komutu interpreter'ı verilen sayıda thread'de beş saniye çalıştırıp GC sayılarını, toplam duraklama süresini ve working set'in tepe değerini yazdırıyor. Üç ayarı ortam değişkenleriyle seçiyoruz:
$ dotnet run -c Release --project samples/GcLab -- modes 1
$ DOTNET_gcServer=1 dotnet run -c Release --project samples/GcLab -- modes 1
$ DOTNET_gcServer=1 DOTNET_GCDynamicAdaptationMode=0 dotnet run -c Release --project samples/GcLab -- modes 1
# aynı üç komut 8 thread ile
threads=1 server=False datas=1 |   2646 passes/s | peak working set   54 MB | allocated  11610 MB | gen0 1455 gen1   1 gen2  0 | pause   66.4 ms
threads=1 server=True datas=1 |   2883 passes/s | peak working set  149 MB | allocated  12649 MB | gen0  128 gen1   1 gen2  0 | pause   46.6 ms
threads=1 server=True datas=0 |   2826 passes/s | peak working set  149 MB | allocated  12398 MB | gen0  126 gen1   1 gen2  0 | pause   49.0 ms
threads=8 server=False datas=1 |  11730 passes/s | peak working set   55 MB | allocated  51466 MB | gen0 6458 gen1   1 gen2  0 | pause  556.7 ms
threads=8 server=True datas=1 |  13880 passes/s | peak working set  150 MB | allocated  60897 MB | gen0  626 gen1   1 gen2  0 | pause  219.5 ms
threads=8 server=True datas=0 |  12658 passes/s | peak working set  149 MB | allocated  55539 MB | gen0  571 gen1   1 gen2  0 | pause  273.4 ms
Workstation ile Server arasındaki fark net: Server GC on kat daha az GC yapıyor, toplam duraklama daha kısa ve sekiz thread'de throughput daha yüksek; bedeli yaklaşık üç kat working set. DATAS açık ve kapalı Server GC arasında ise bu testte bellekte fark çıkmadı; throughput ve duraklama farkları da tekrarlarda yer değiştirecek kadar küçük. Testin uzun ömürlü verisi çok küçük ve yük beş saniye boyunca sabit; Learn'deki sayfa DATAS'ın en çok dalgalı yükte ve çok çekirdekli makinelerde fark yarattığını söylüyor, kendi ölçümlerini 48 çekirdekli bir makinede vermiş. Kendi servisinde bu ayarlara dokunmadan önce o servisin gerçek yükünü ölç.
Allocation'ı Azaltmak: Filtre Dilinin İki Hâli
Birinci tahmine dönelim. filter komutu filtreyi 100.000 kitaplık katalogda beş saniye boyunca tekrar tekrar çalıştırıyor:
$ dotnet run -c Release --project samples/GcLab -- filter interpreter 5
$ dotnet run -c Release --project samples/GcLab -- filter compiled 5
interpreter  248.2 passes/s | allocated  10888 MB | gen0 1365 gen1   1 gen2  0 | pause  127.4 ms
compiled    2060.1 passes/s | allocated      0 MB | gen0    0 gen1   0 gen2  0 | pause    0.0 ms
Interpreter beş saniyede 10 GB'tan fazla allocation yaptı ve 1.365 gen0 GC tetikledi; derlenmiş delegate hiç allocation yapmadı ve GC hiç çalışmadı. Fark, 03. yazıdaki interpreter'ın tasarımından geliyor: Evaluate her değeri object olarak döndürüyor, yani her kitabın Price'ı ve her karşılaştırmanın bool sonucu heap'te bir boxing object'i oluyor. Derlenmiş delegate ise tipleri bildiği için decimal'i ve bool'u register'larda ve stack'te taşıyor. Aynı farkı çalışan bir process'te dışarıdan dotnet-counters ile görebilirsin; araç .NET 10'un System.Runtime meter'ındaki metric'leri okuyor:
$ dotnet-counters collect --counters 'System.Runtime[dotnet.gc.collections,dotnet.gc.heap.total_allocated,dotnet.gc.pause.time]' --format csv -o gc-interpreter.csv --duration 00:00:00:05 -- dotnet samples/GcLab/bin/Release/net10.0/GcLab.dll filter interpreter 7
$ grep -E 'total_allocated|gen0|pause' gc-interpreter.csv | head -3
11/15/2026 06:39:33,System.Runtime,dotnet.gc.heap.total_allocated (By / 1 sec),Rate,2572135760
11/15/2026 06:39:33,System.Runtime,dotnet.gc.pause.time (s / 1 sec),Rate,0.017646999999999996
11/15/2026 06:39:33,System.Runtime,dotnet.gc.collections ({collection} / 1 sec)[gc.heap.generation=gen0],Rate,308
$ grep -E 'total_allocated|gen0|pause' gc-compiled.csv | head -3
11/15/2026 06:39:39,System.Runtime,dotnet.gc.heap.total_allocated (By / 1 sec),Rate,49176
11/15/2026 06:39:39,System.Runtime,dotnet.gc.pause.time (s / 1 sec),Rate,0
11/15/2026 06:39:39,System.Runtime,dotnet.gc.collections ({collection} / 1 sec)[gc.heap.generation=gen0],Rate,0
Interpreter saniyede 2,5 GB ayırıyor ve 300'den fazla gen0 GC yapıyor; GC her saniyenin yaklaşık 18 milisaniyesini duraklamaya harcıyor. Derlenmiş sürümde saniyede birkaç on KB kalıyor, onu da ölçüm oturumunun kendisi üretiyor. dotnet-counters'ın kullanımı ve diğer metric'ler .NET'te Profiling ve Diagnostics serisinin "dotnet-counters ve Built-in Metric'ler" yazısında. Aynı karşılaştırmayı BenchmarkDotNet'in MemoryDiagnoser'ıyla 1.000 kitap üzerinde yapınca:
$ dotnet run -c Release --project benchmarks/Bookstore.Filter.Benchmarks -- --filter '*EvaluationBenchmarks*'
...
| Method                 | Mean      | Error     | StdDev    | Ratio | RatioSD | Gen0    | Allocated | Alloc Ratio |
|----------------------- |----------:|----------:|----------:|------:|--------:|--------:|----------:|------------:|
| TreeWalkingInterpreter | 36.330 us | 0.7259 us | 1.0410 us |  1.00 |    0.04 | 11.4746 |   96120 B |        1.00 |
| CompiledDelegate       |  4.373 us | 0.0756 us | 0.1085 us |  0.12 |    0.00 |       - |         - |        0.00 |
Gen0 kolonu 1.000 çağrı başına gen0 GC sayısı. Derlenmiş delegate sekiz kat hızlı, ama tablonun asıl söylediği şu: hızın bir kısmı allocation'dan geliyor ve allocation yapmayan kodun GC maliyeti sıfır. GC'yi hızlandırmanın en etkili yolu, ona daha az iş vermek.
Başka Runtime'lar: V8, Go ve Rust
Aynı fikirler başka runtime'larda farklı dengelerle karşımıza çıkıyor. V8'in Orinoco adlı GC'si de generational: genç generation'ı yarı yarıya iki alana bölen ve yaşayanları bir alandan diğerine kopyalayan paralel bir scavenger topluyor, eski generation'ı ise eş zamanlı işaretleme ve paralel compact ile mark-compact topluyor. Orinoco'nun da write barrier'ları var. JavaScript tarafındaki memory leak'ler ve WeakRef, JavaScript İleri serisinin "JavaScript Bellek Yönetimi: Garbage Collection, Bellek Sızıntıları ve WeakRef" yazısında.
Go'nun GC'si Go'nun kendi kılavuzuna göre mark-sweep ve non-moving: object'leri taşımıyor, işinin çoğunu uygulamayla eş zamanlı yapıyor ve kısa stop-the-world anlarıyla yetiniyor. Taşımadığı için compact'ın faydasını alamıyor ama native koda pointer vermek kolaylaşıyor. Ayar olarak heap hedefini belirleyen GOGC ve yumuşak bir bellek sınırı koyan GOMEMLIMIT var. Rust ise GC kullanmıyor: her değerin derleme anında belirlenen tek bir sahibi var ve sahip scope'tan çıkınca bellek geri veriliyor. Bellek güvenliğini çalışma anında değil compiler'ın borrow checker'ında sağlıyor; bunun bedeli dilin öğrenme eğrisi.
Üretimde Dikkat
Container'larda GC, process'e verilen bellek sınırını görüyor ve heap'e varsayılan olarak bu sınırın bir kısmını ayırıyor; tam oranı GCHeapHardLimit ve ilgili ayarlar belirliyor. Server GC her çekirdek için heap açtığı için, çok çekirdekli bir node'da küçük bellek limitli pod'lar beklenenden erken OutOfMemory alabiliyor; Learn'e göre DATAS'ın en çok işe yaradığı yer tam da bu tür bellek kısıtlı ortamlar.
Finalizer'dan kaçın. Finalizer'ı olan bir object ölü bulunduğunda hemen silinmiyor, finalizer thread'inin kuyruğuna alınıyor ve en az bir GC daha yaşıyor; tuttuğu bütün object graph'ı da onunla birlikte yaşıyor. Unmanaged bir kaynağı serbest bırakmanın doğru yolu IDisposable ve using; kullanım tarafı C# OOP (nesne yönelimli programlama) serisinin "C#'ta Object'lerin Ömrü: Garbage Collector, IDisposable ve using" yazısında.
GC'yi izlemek için önce allocation rate'e ve gen2 GC sayısına bak. Yüksek allocation rate gen0 GC'yi, sık gen2 GC'ler uzun duraklamaları getirir. Allocation'ların nereden geldiğini bulmak ve heap snapshot'larını karşılaştırmak .NET'te Profiling ve Diagnostics serisinin "Allocation ve GC Analizi" yazısının konusu.
Sık Düşülen Tuzaklar
GC.Collect() çağırmak. Yaşayan her object'i bir generation yukarı taşıyor, böylece kısa ömürlü object'leri pahalı gen2'ye yerleştiriyor ve GC'nin kendi bütçe hesabını bozuyor. Yukarıdaki örneklerde yalnız gözlem için kullandık. Üretim kodunda neredeyse hiç gerekmiyor.
Toplanmamış belleği leak sanmak. GC çalışmadığı sürece çöp heap'te durur ve working set ancak GC'den sonra küçülür; Server GC belleği işletim sistemine geri vermekte daha da yavaş. 06. yazıda yük altında 260 MB'a çıkan API'nin belleği bu yüzden leak değildi. Gerçek leak'i ayırt etmenin yolu, tam bir GC'den sonra bile büyümeye devam eden heap. Yukarıdaki memory çıktısının son iki satırı bunun örneği: her farklı filtre metni için derlenmiş bir delegate tutan sınırsız bir Dictionary, tam GC'den sonra 5.000 filtrede 14 MB, 10.000 filtrede 28 MB. 06. yazının alıştırmasında cache'in neden "boyutu sınırlı" olması gerektiğinin cevabı bu.
LOH'u kısa ömürlü buffer'larla doldurmak. 85.000 byte'ı geçen her geçici array gen2 GC'ye doğru bir adım. Ölçtüğümüz gibi aynı miktarda veri küçük parçalarda gen0'da kalıyor, büyük parçalarda gen2 GC tetikliyor. LOH compact edilmediği için farklı boyutlardaki büyük buffer'lar zamanla fragmentation da yaratıyor.
Mikro benchmark'ta allocation'ın kaybolması. .NET 10'un JIT'i hiç okunmayan bir allocation'ı silebiliyor ya da stack'e alabiliyor; _ = new byte[1_000] döngüsü ilk denememde Tier1'e geçtikten sonra hiç bellek ayırmadı. Allocation ölçerken sonucu bir yere yaz ya da BenchmarkDotNet'te benchmark method'undan döndür.
Küçük Bir Deneme
★☆☆ gens komutuna GC.Collect(2) sonrası bir satır daha ekle. Gen2'deki bir object bir GC daha atlatınca generation'ı değişiyor mu?
★★☆ memory komutundaki 1 MB'lık döngüde her seferinde yeni array ayırmak yerine ArrayPool<byte>.Shared.Rent ve Return kullan. Gen2 GC sayısı ne oldu?
★★★ Interpreter'daki boxing'i azalt: Evaluate'in object yerine küçük bir struct (örneğin decimal, string ve bool alanları olan bir Value) döndürmesini sağla. EvaluationBenchmarks'taki Allocated ve Gen0 kolonları nasıl değişti? Interpreter ile derlenmiş delegate'in aynı kitapları döndürdüğünü kontrol eden testler hâlâ geçiyor mu?
Böylece runtime tarafını tamamladık: makine kodunun ne zaman üretildiğini ve belleğin nasıl geri alındığını gördük. Serinin son yazısında geriye çekilip dillerin nasıl evrildiğine bakıyoruz: paradigmalar, tip sistemleri ve bir dil özelliğinin compiler hilesinden runtime özelliğine dönüşmesinin örneği olarak async/await ve .NET 11'in Runtime Async'i.