

Data ve Feature: Dataset, Label, Feature Tipleri ve Veri Kalitesi

Bir modelin öğrenebileceği her şey satırlarda, feature'larda ve label'da durur; bu yüzden ilk iş modele değil veriye bakmaktır. Bookstore'un sentetik sipariş export'unda Microsoft.Data.Analysis ve LINQ ile 104 duplicate sipariş, 62 farklı şehir yazımı, kuruş olarak saklanmış tutarlar, negatif label'lar ve yanlış etiketlenmiş yorumlar buluyor, temizleme kararlarını ve kişisel veriyi eğitimden uzak tutmayı konuşuyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve Microsoft.Data.Analysis 0.24.0 ile derlenip çalıştırılmıştır. Veri, serinin seed'li generator'ıyla üretilmiş sentetik Bookstore verisidir.
Önce Tahmin Et
Elinde sitedeki serilerin ortak örnek uygulaması Bookstore'un (bir online kitapçı) 24.290 satırlık sipariş export'u var. Bu dosyayı doğrudan bir modele verirsen model duplicate satırları, aynı şehrin dört farklı yazımını, kuruş cinsinden saklanmış birkaç tutarı ve negatif teslim sürelerini kendi kendine fark edip düzeltir mi? Fark etmezse bunların modele etkisi ne olur?
Cevap kısa: model hiçbirini fark etmez. Ona verdiğin her satırı doğru kabul eder ve hatalı satırlardan da öğrenir. Bu yazıda modele hiç dokunmadan veriye bakacağız ve bu sorunları tek tek bulacağız.
Row, Feature ve Label
Supervised learning'de veri bir tablodur. Her satır (row, literatürde example ya da instance da denir) tek bir gözlemdir: bizim için tek bir sipariş. Kolonların bir kısmı feature'dır, yani modelin tahmin yaparken kullanacağı bilgiler: depoya uzaklık, kargo firması, kitap sayısı, sipariş saati. Bir kolon da label'dır, modelin tahmin etmeyi öğreneceği değer. Teslim süresi probleminde label DeliveryDays.
Bir kolonun feature olup olamayacağını belirleyen tek bir soru var: bu bilgi tahmin anında elimde olacak mı? Sipariş verildiği anda tahmini teslim süresini göstermek istiyoruz. O anda mesafe, kargo firması ve sipariş saati bellidir. Ama TrackingEventCount (kargonun takip sisteminde kaç olay kaydı oluştuğu), IsReturned ve ReturnRequestedUtc ancak teslimattan sonra oluşur. Bu kolonlar dosyada duruyor diye feature listesine girmez. Bunları modele vermenin nasıl sahte bir başarı ürettiğini bir sonraki yazıda ölçeceğiz.
Feature Tipleri
ML (machine learning, yani veriden öğrenen) algoritmaları sonunda yalnız sayılarla çalışır. Ama ham veride feature'lar farklı tiplerde gelir ve her tip modele farklı bir yoldan girer:
- Numeric:
DistanceKm,ItemCount,TotalWeightKg,OrderTotal. Doğrudan sayı olarak kullanılır, ama ölçekleri çok farklıdır (1 ile 120 kitap, 0,25 ile 122 kilo); bazı algoritmalar için normalization gerekir. - Categorical:
City,Warehouse,Carrier,ShippingMethod,PaymentMethod. Değerler arasında sıra yoktur; "CarrierB, CarrierA'nın iki katıdır" demek anlamsızdır. Modele genellikle one-hot encoding ile girer.Districtise yüzlerce farklı değeri olan yüksek cardinality'li bir categorical feature. - Boolean:
IsCampaign,HasBackorderItem. 0 ve 1'e çevrilir. - Text:
CustomerNote, yani müşterinin teslimat notu. Kelime ve kelime grubu sayımlarına dönüştürülür. - Tarih:
OrderedAtUtc. Ham tarih tek başına pek işe yaramaz; haftanın günü, saat, kampanya dönemi gibi parçalara ayrıldığında anlam kazanır.
Bu dönüşümlerin hepsini beşinci yazıda feature engineering başlığı altında ML.NET ile yapacağız. Bu yazıda yalnız verinin ne hâlde olduğuna bakıyoruz.
Veri Nereden Gelir?
Gerçek bir Bookstore'da bu tablo hazır durmaz. Siparişler BookstoreDb veritabanındaki (SQL Server) sipariş, sipariş satırı, kargo ve müşteri tablolarında dağınık hâldedir. Eğitim verisi bu tabloları birleştiren bir sorguyla çıkarılır, CSV (her satırın virgülle ayrılmış alanlardan oluştuğu düz metin dosyası) olarak dışa aktarılır ve ML.NET tarafında IDataView olarak okunur. Bu seride sorgu kısmını generator'a bırakıyoruz; ama sorgunun bir tuzağı var ve onu bilmen gerekiyor.
Export sorgusu çoğu zaman tabloların bugünkü hâlini okur. Müşterinin bugünkü adresi, bugünkü segmenti, ürünün bugünkü fiyatı. Oysa model, sipariş anındaki bilgiyle tahmin yapacak. Müşteri geçen ay taşındıysa iki yıl önceki siparişi yeni şehriyle eğitime girer ve model hiç yaşanmamış bir teslimattan öğrenir. Eğitim verisini çıkarırken her kolon için "bu değer sipariş anında neydi?" sorusunu sor. Gerekiyorsa değeri sipariş tablosunun kendisine o anda kopyala; Bookstore'un siparişinde şehir ve mesafe bu yüzden sipariş satırında tutuluyor.
DataFrame ile İlk Bakış
.NET'te tablo verisine hızlı bakmanın bir yolu Microsoft.Data.Analysis paketindeki DataFrame. Paket ML.NET ile aynı repodan çıkıyor ve hâlâ 0.x sürüm numarasıyla yayınlanıyor; ML.NET 6.0 ile birlikte gelen sürüm 0.24.0:
dotnet add src/Bookstore.ML.Lab package Microsoft.Data.Analysis --version 0.24.0public static void Run()
{
DataFrame df = DataFrame.LoadCsv("data/orders.csv");
Console.WriteLine($"{df.Rows.Count:N0} rows, {df.Columns.Count} columns");
DataFrame some = new(
df.Columns["OrderedAtUtc"], df.Columns["City"], df.Columns["DistanceKm"], df.Columns["TotalWeightKg"],
df.Columns["CustomerNote"], df.Columns["DeliveryDays"], df.Columns["ReturnRequestedUtc"]);
Console.WriteLine(some.Info());
DataFrame numeric = new(
df.Columns["DistanceKm"], df.Columns["ItemCount"], df.Columns["TotalWeightKg"],
df.Columns["OrderTotal"], df.Columns["DeliveryDays"]);
Console.WriteLine(numeric.Description());
// Description() null'lar dahil bütün satırlara bölüyor; null olmayan değerlerin LINQ ortalamasıyla karşılaştır
PrimitiveDataFrameColumn<float> label = (PrimitiveDataFrameColumn<float>)df.Columns["DeliveryDays"];
Console.WriteLine($"DeliveryDays mean over non-null values: {label.Where(v => v.HasValue).Average(v => v!.Value):F4}");
}dotnet run --project src/Bookstore.ML.Lab -- explore24,290 rows, 22 columns
Info OrderedAtUtc City DistanceKm TotalWeightKg CustomerNote DeliveryDays ReturnRequestedUtc
DataType System.DateTime System.String System.Single System.Single System.String System.Single System.String
Length (excluding null values)24290 24290 24290 23529 24290 23208 24290
Description DistanceKm ItemCount TotalWeightKg OrderTotal DeliveryDays
Length (excluding null values)24290 24290 23529 24290 23208
Max 1600 120 122.1 46980 38.17
Min 20 1 0.25 147.83 -4.35
Mean 284.98105 2.7785509 1.5052913 718.8988 2.4667072
DeliveryDays mean over non-null values: 2.5817LoadCsv kolon tiplerini kendisi çıkardı: tarih DateTime, sayılar Single, gerisi String. "Length (excluding null values)" satırı eksik değerleri gösteriyor: 24.290 satırın 761'inde ağırlık boş (23.529), 1.082'sinde teslim süresi boş (23.208). Ama dikkat: CustomerNote ve ReturnRequestedUtc 24.290 görünüyor. Bu kolonlarda boş değerler null değil, boş string olarak okunmuş; string kolonlarda eksik veriyi bu sayıdan göremezsin.
Description tablosunda iki şey hemen göze çarpıyor. OrderTotal'ın maksimumu 46.980 TL; bir kitapçı siparişi için şüpheli. DeliveryDays'in minimumu -4,35 gün; bir teslimat negatif süre alamaz. Üçüncü şey daha sinsi. Description, DeliveryDays'in ortalamasını 2,4667 veriyor; null olmayan değerlerin LINQ (C# koleksiyonları üzerinde sorgu yazmayı sağlayan dil özelliği) ile hesaplanmış ortalaması ise 2,5817. 2,4667, 2,5817'nin 23.208/24.290 ile çarpımına eşit. Yani bu sürümde Description() ortalamayı hesaplarken null değerleri de paydaya katıyor. Bir aracın verdiği istatistiği, en az bir kez başka bir yoldan doğrulamadan rapora koyma.
LINQ ile Kalite Raporu
DataFrame genel bir resim veriyor; asıl soruları LINQ ile sormak daha kolay. Dosyayı ilk yazıdaki OrderRow record'una okuyup beş grup kontrol yapıyoruz:
string[] lines = File.ReadAllLines("data/orders.csv")[1..];
List<OrderRow> rows = [.. lines.Select(l => OrderRow.Parse(Csv.Split(l)))];
// 1) Duplicate'ler: aynı OrderId iki kez mi geçiyor, satırın tamamı aynı mı
var duplicateIds = rows.GroupBy(r => r.OrderId).Where(g => g.Count() > 1).ToList();
int identical = lines.GroupBy(l => l).Sum(g => g.Count() - 1);
Console.WriteLine($"Duplicate OrderIds   : {duplicateIds.Count} (identical lines: {identical})");
// 2) Eksik değerler
Console.WriteLine($"Missing weight       : {rows.Count(r => r.TotalWeightKg is null)}");
Console.WriteLine($"Missing label        : {rows.Count(r => r.DeliveryDays is null)} " +
                  $"(cancelled: {rows.Count(r => r.IsCancelled)})");
// 3) Tutarsız kategoriler
var cities = rows.GroupBy(r => r.City).Select(g => (Name: g.Key, Count: g.Count())).ToList();
var odd = cities.Where(c => c.Name != c.Name.Trim() || c.Name == c.Name.ToUpperInvariant()
                            || c.Name == c.Name.ToLowerInvariant());
Console.WriteLine($"Distinct City values : {cities.Count}; odd spellings: " +
                  string.Join(", ", odd.OrderByDescending(c => c.Count).Take(6).Select(c => $"'{c.Name}' x{c.Count}")));
// 4) İmkânsız veya uç değerler
List<double> days = [.. rows.Where(r => r.DeliveryDays is not null).Select(r => r.DeliveryDays!.Value).Order()];
double q1 = Quantile(days, 0.25), q3 = Quantile(days, 0.75), iqr = q3 - q1;
Console.WriteLine($"DeliveryDays <= 0    : {days.Count(d => d <= 0)}");
Console.WriteLine($"DeliveryDays p50/p90/p99/max : {Quantile(days, 0.5):F2} / {Quantile(days, 0.9):F2} / " +
                  $"{Quantile(days, 0.99):F2} / {days[^1]:F2}");
Console.WriteLine($"IQR outliers (> {q3 + 1.5 * iqr:F2}) : {days.Count(d => d > q3 + 1.5 * iqr)}; " +
                  $"> 15 days: {days.Count(d => d > 15)}");
dotnet run --project src/Bookstore.ML.Lab -- qualityDuplicate OrderIds : 104 (identical lines: 104)
Missing weight : 761
Missing label : 1082 (cancelled: 1082)
Distinct City values : 62; odd spellings: 'Istanbul ' x30, 'istanbul' x29, 'ISTANBUL' x20, 'Izmir ' x16, 'ankara' x15, 'Ankara ' x15
DeliveryDays <= 0 : 6
DeliveryDays p50/p90/p99/max : 2.20 / 4.11 / 8.69 / 38.17
IQR outliers (> 5.71) : 710; > 15 days: 93
OrderTotal > 10x items subtotal : 4 (e.g. O003526: 19,980.00 vs 149.90)
IsCancelled = true : 4.5 %
IsReturned = true : 3.5 % of delivered
Review topics : Content 1796, Shipping 1395, Price 1060, PrintQuality 819
R00254 [PrintQuality] Delivered on time even during the campaign.
R01837 [PrintQuality] Shipping was really slow this time. Second copy I bought.
R03828 [PrintQuality] Shipping was really slow this time.Sonuçları tek tek okuyalım. 104 sipariş iki kez yazılmış ve bunların hepsi satır olarak birebir aynı; tipik bir export'un yeniden denenmesi sonucu. Duplicate satırlar modele o siparişlerin iki kat önemli olduğunu söyler. Daha kötüsü, bir sonraki yazıda veriyi train ve test olarak ikiye böldüğümüzde aynı siparişin bir kopyası train'e, diğeri test'e düşebilir ve model sınavda ezberden cevap verir.
Ağırlık 761 satırda boş. Label'ı boş olan 1.082 satırın hepsi iptal edilmiş sipariş; bu eksiklik bir hata değil, iptal edilen sipariş teslim edilmez. Teslim süresi modeli bu satırları kullanmayacak, ama iptal tahmini modeli için tam da bu satırlar gerekli. Hangi satırın "eksik" sayılacağı problemin kendisine bağlı.
16 şehir var ama City kolonunda 62 farklı değer görünüyor: sonunda boşluk kalmış "Istanbul ", küçük harfle "istanbul", büyük harfle "ISTANBUL". Model için bunlar dört ayrı şehir. One-hot encoding her biri için ayrı bir kolon açar ve "ISTANBUL"dan gelen 20 sipariş, İstanbul'un geri kalanından ayrı öğrenilir.
Dört siparişin tutarı, sipariş satırlarındaki kitap fiyatlarının toplamının on katından büyük. Örnekteki O003526'da kitaplar 149,90 TL ama sipariş tutarı 19.980 TL; tutarın kuruş cinsinden yazıldığı belli. Bunu tek kolona bakarak değil, iki tabloyu karşılaştırarak bulduk. Veri kalitesi kontrollerinin en değerlileri genellikle böyle iş kuralına dayanan karşılaştırmalardır.
Son olarak sınıf dağılımı: siparişlerin yüzde 4,5'i iptal edilmiş, teslim edilenlerin yüzde 3,5'i iade edilmiş. Bu tür dengesiz (imbalanced) bir veride "hiçbir sipariş iptal edilmez" diyen bir model yüzde 95,5 doğruluk elde eder ve tamamen işe yaramaz. Bu tuzağı yedinci yazıda classification metric'leriyle açacağız.
Label'ın Kendisi Yanlışsa
Altı siparişin teslim süresi negatif. Bu bir outlier değil, imkânsız bir değer. Label hatalarının kaynağı genellikle sistemdir: saat dilimi karışıklığı, işaret hatası, yanlış kolondan okunan bir tarih. Bu satırları düzeltemiyorsak çıkarmak en doğrusu.
Label hatası her zaman bu kadar görünür değil. Yorumlar dosyasında her yorumun bir konusu (Topic) var ve bu konuyu müşteri hizmetlerinden biri elle seçmiş gibi düşün. Kalite raporunun son kısmı, metni açıkça kargo hakkında olduğu hâlde "baskı kalitesi" olarak etiketlenmiş yorumları arıyor:
// 6) Label'lar da yanlış olabilir: teslimatla ilgili olup başka konuyla etiketlenmiş yorumlar
List<string[]> reviews = [.. Csv.Read("data/reviews.csv")];
Console.WriteLine("Review topics        : " + string.Join(", ", reviews.GroupBy(r => r[5])
    .OrderByDescending(g => g.Count()).Select(g => $"{g.Key} {g.Count()}")));
string[] shippingWords = ["The package", "The courier", "Shipping was", "Fast delivery", "Delivered on time"];
foreach (string[] r in reviews.Where(r => r[5] == "PrintQuality" && shippingWords.Any(r[4].StartsWith)).DistinctBy(r => r[4]).Take(3))
{
    Console.WriteLine($"  {r[0]} [{r[5]}] {r[4]}");
}
Çıktının son üç satırı bu aramanın sonucu. "Shipping was really slow this time." bir baskı kalitesi şikâyeti değil. Yedinci yazıda bu yorumlardan konu tahmin eden bir model eğiteceğiz ve model bu yanlış label'lardan da öğrenecek. Label noise'u sıfıra indirmek çoğu zaman mümkün değildir; ama ne kadar olduğunu bilmek, modelin ulaşabileceği başarının bir tavanı olduğunu kabul etmek demektir.
Dağılım ve Outlier'lar
Kalite raporundaki yüzdelik değerleri bir histogramla görmek daha kolay. Aşağıdaki grafik, raporun yazdığı yarım günlük aralıklardan çizildi:
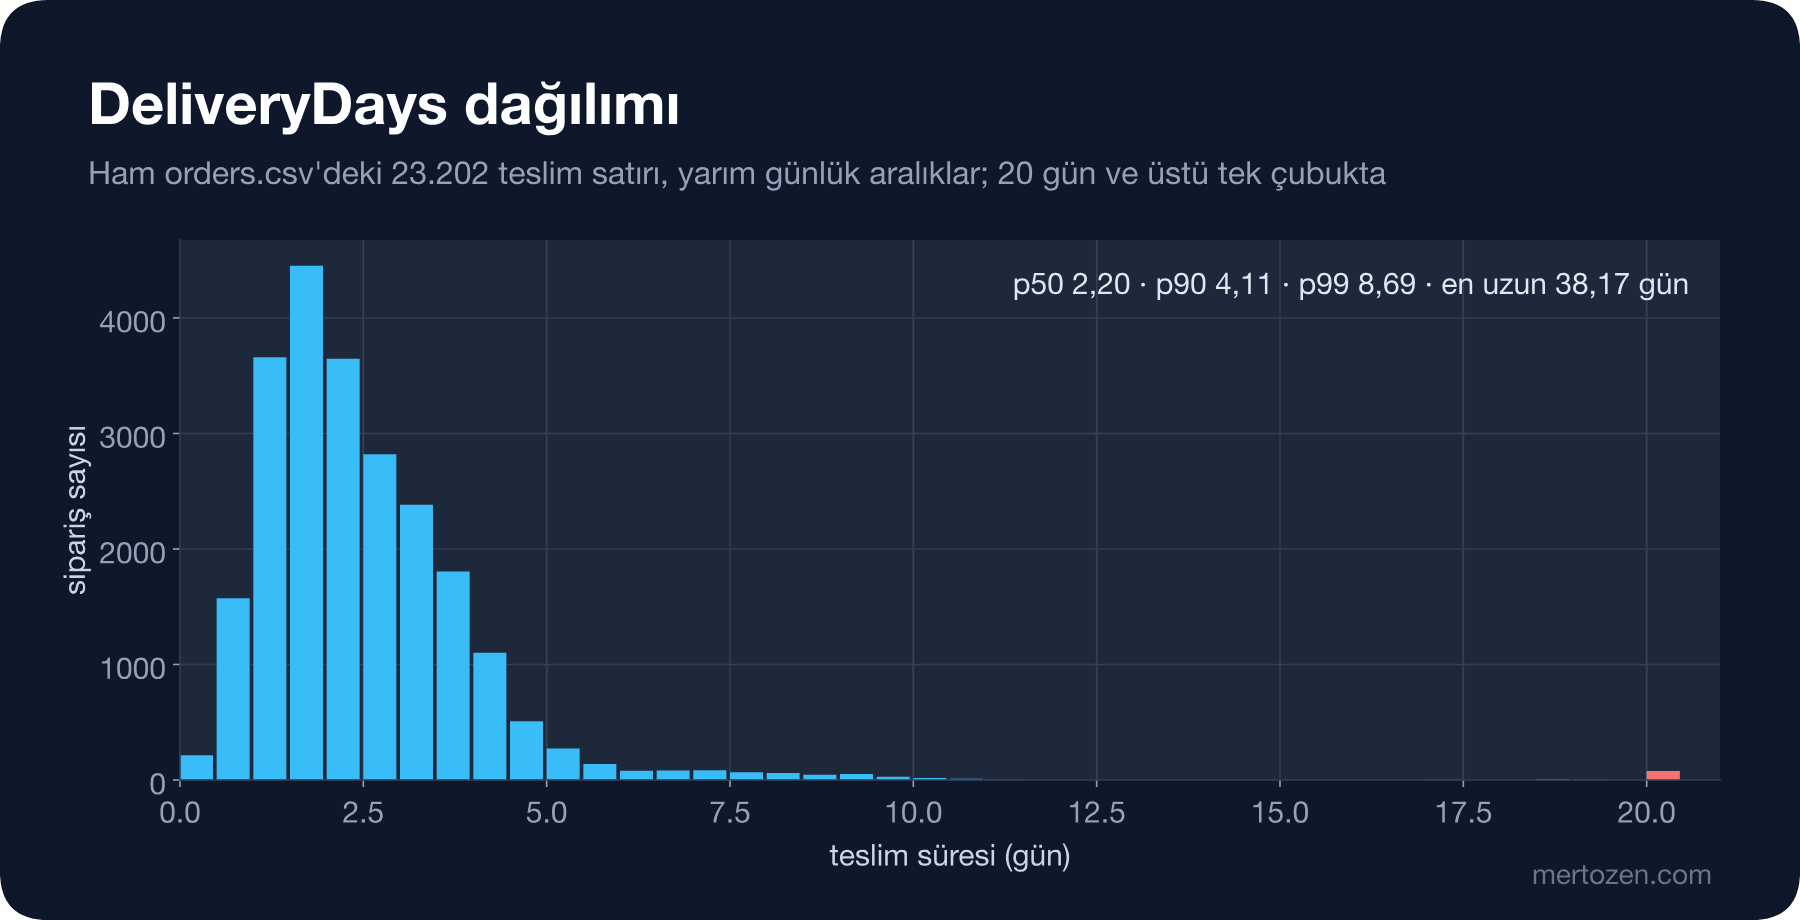
Siparişlerin yarısı 2,2 günden kısa sürede, yüzde 90'ı 4,1 günden kısa sürede teslim edilmiş. Sağa doğru uzun bir kuyruk var ve 20 gün ve üstündeki çubukta onlarca sipariş toplanmış. En uzun teslimat 38 gün sürmüş.
Ders kitaplarındaki IQR (çeyrekler arası açıklık; verinin ortadaki yarısının genişliği) kuralı, 5,71 günden uzun 710 teslimatı outlier sayıyor. Bunları otomatik olarak silmek büyük bir hata olur. 5–10 gün arasındaki teslimatların çoğu, stokta olmayan bir kitabın tedarikçiden gelmesini beklemiş gerçek siparişler. Model bu durumu öğrenmeli, çünkü müşteriye söylenecek tahmin tam olarak bu. 15 günden uzun 93 teslimat ise başka bir hikâye: büyük olasılıkla kaybolup haftalar sonra bulunan kargolar. Bunlar da gerçek, ama hiçbir feature onları önceden haber vermiyor. Şimdilik veride bırakıyoruz; altıncı yazıda bu satırların hangi metric'i nasıl etkilediğini ölçeceğiz. Bir outlier'ı silmeden önce sor: bu değer hatalı mı, yoksa sadece nadir mi?
Temizlik
Bulduklarımızı düzelten clean komutu, ham dosyaya dokunmadan data/orders_clean.csv adında yeni bir dosya yazıyor:
// 1) Export bazı siparişleri iki kez yazmış: her OrderId için tek satır kalsın
rows = [.. rows.DistinctBy(r => r.OrderId)];
int afterDedup = rows.Count;
// 2) Her şehre tek yazım: boşlukları kırpılmış, büyük/küçük harfe duyarsız adın en sık görülen biçimi
Dictionary<string, string> canonical = rows
    .GroupBy(r => r.City.Trim().ToUpperInvariant())
    .ToDictionary(g => g.Key, g => g.GroupBy(r => r.City).OrderByDescending(x => x.Count()).First().Key);
int cityFixes = rows.Count(r => r.City != canonical[r.City.Trim().ToUpperInvariant()]);
rows = [.. rows.Select(r => r with { City = canonical[r.City.Trim().ToUpperInvariant()] })];
// 3) Kuruş cinsinden saklanmış tutarlar: sipariş satırlarıyla karşılaştır, 100'e böl
Dictionary<string, decimal> itemTotals = Csv.Read("data/order_items.csv")
    .GroupBy(f => f[0])
    .ToDictionary(g => g.Key, g => g.Sum(f => int.Parse(f[2], CultureInfo.InvariantCulture)
                                              * decimal.Parse(f[3], CultureInfo.InvariantCulture)));
int totalFixes = rows.Count(r => r.OrderTotal > 10 * itemTotals[r.OrderId]);
rows = [.. rows.Select(r => r.OrderTotal > 10 * itemTotals[r.OrderId] ? r with { OrderTotal = r.OrderTotal / 100 } : r)];
// 4) Teslimat negatif süre alamaz: label yanlış, satırı çıkar
int badLabels = rows.Count(r => r.DeliveryDays <= 0);
rows = [.. rows.Where(r => r.DeliveryDays is null || r.DeliveryDays > 0)];
dotnet run --project src/Bookstore.ML.Lab -- cleanrows 24,290 -> 24,186 after de-duplication -> 24,180 written
city spellings fixed: 290, distinct cities: 16
totals divided by 100: 4, rows dropped for a negative label: 6
missing weight kept as empty: 756Bu adımların her biri bir karar. Duplicate'leri attık çünkü satırlar birebir aynıydı; aynı OrderId'nin farklı içerikle iki kez geçtiği bir durumda hangisinin doğru olduğunu sormak gerekirdi. Şehir yazımlarını en sık görülen biçime çektik; 290 satır düzeldi, 16 şehir kaldı. Kuruş hatasını sipariş satırlarına dayanarak düzelttik. Negatif label'lı altı satırı çıkardık çünkü doğru değeri bilemiyoruz. Eksik ağırlıkları ise boş bıraktık. Bir sayı uydurmak (ortalamayla doldurmak gibi) modelin işi; bunu pipeline'ın içinde, sadece train verisinden öğrenilen değerle yapmamız gerekiyor. Neden böyle olması gerektiğini üçüncü ve beşinci yazıda göreceğiz.
Ham dosyayı hiç değiştirmediğimize de dikkat et. Temizlik bir kod; tekrar çalıştırılabilir, gözden geçirilebilir ve yarın yeni bir export geldiğinde aynı kararlar aynı şekilde uygulanır. Excel'de elle yapılan bir düzeltme bunların hiçbirini sağlamaz.
Kişisel Veri ve KVKK
customers.csv dosyasında müşterinin adı, e-posta adresi (hepsi example.com alan adında, uydurma), doğum yılı ve adresi var. Teslim süresini tahmin etmek için bunların hiçbirine ihtiyacımız yok: sipariş satırı müşteriyi yalnız CustomerId ile tanıyor, şehir ve ilçe sipariş satırında zaten var. Bu yüzden eğitim verisine müşteri dosyasından tek kolon taşımıyoruz.
KVKK (Kişisel Verilerin Korunması Kanunu) açısından kural basit: amaç için gerekmeyen kişisel veri eğitim setine girmez. Ad ve e-posta bir modele hiçbir şey öğretmez, ama eğitim verisinin bulunduğu her yere (geliştiricinin bilgisayarı, CI makinesi, paylaşılan bir klasör) taşınır. Doğum yılı gibi kolonlar daha zor bir soru sorar: teslim süresiyle ilgisi yoktur ama iptal tahmini gibi bir problemde model yaşa göre ayrım yapmaya başlayabilir. Hassas feature'ları ve onların yerini dolaylı olarak tutan feature'ları dokuzuncu yazıda konuşacağız. Konunun hukuki ve teknik ayrıntıları ise Veri Gizliliği ve KVKK serisinde.
Sık Düşülen Tuzaklar
İlk tuzak, "garbage in, garbage out" ilkesini unutmak: hatalı veriyle eğitilen model hatayı öğrenir ve bunu yüksek bir güvenle tekrarlar. Modelin metric'leri iyi görünse bile, test verisi aynı hataları taşıyorsa bu iyi görüntü yanıltıcıdır.
İkincisi, outlier'ları kural gereği silmek. IQR kuralı 710 satırı işaretledi; bunların çoğu modelin öğrenmesi gereken gerçek gecikmeler. Silmeden önce her outlier grubunun nedenini anla.
Üçüncüsü, label'ı doğru kabul etmek. Negatif teslim süreleri ve yanlış etiketlenmiş yorumlar bu veride bilerek bırakıldı, ama gerçek sistemlerde de aynı sıklıkla görülür. Label'ın nasıl üretildiğini (elle mi, bir sistem tarafından mı, hangi saat diliminde) öğrenmeden modele güvenme.
Dördüncüsü, kullandığın aracın istatistiğini doğrulamadan raporlamak. DataFrame'in ortalaması bu yazıda yanlış bir sayı verdi; null'ları farklı yorumlayan iki araç aynı veride farklı sonuç üretebilir.
Beşincisi, temizliği elle yapmak. Bir dahaki export'ta aynı adımları hatırlamayacaksın. Temizlik kod olmalı ve ham veriyi değiştirmemeli.
Küçük Bir Deneme
★☆☆ Kalite raporuna District kolonu için bir kontrol ekle: kaç farklı ilçe var, en az siparişi olan on ilçede kaçar sipariş var? Bu sayı beşinci yazıda one-hot encoding ile hashing arasında seçim yaparken işine yarayacak.
★★☆ Duplicate kontrolünü sertleştir: aynı OrderId'ye sahip ama içeriği farklı satırları bulan bir sorgu yaz. Bu veride sonuç sıfır çıkmalı; gerçek bir export'ta sıfır çıkmazsa hangisini tutacağına nasıl karar verirdin?
★★★ Ağırlığı boş olan siparişleri ağırlığı dolu olanlarla karşılaştır: kargo firmasına, depoya ve aya göre dağılımları farklı mı? Eksiklik rastgele değilse (örneğin hep aynı depodan geliyorsa), ortalamayla doldurmak modele yanlış bir şey öğretebilir.
Bir sonraki yazıda veriyi train ve test olarak ayıracağız ve bir modelin testte neden parlak görünüp üretimde hayal kırıklığı yarattığını gerçek ölçümlerle göreceğiz: baseline'lar, overfitting, data leakage, zaman bazlı split ve cross-validation.