

Regression ve Metric'leri: Linear Regression, Gradient Boosting, MAE, RMSE ve R²

Regression bir sayı tahmin eder; doğru metric'i seçmek doğru algoritmayı seçmek kadar önemlidir, çünkü MAE ortalama sapmayı, RMSE büyük hataları, R² ise açıklanan varyansı ölçer. Gradient descent'i C#'ta elle yazıyor, Bookstore teslim süresinde SDCA, FastTree, FastForest ve LightGBM'i karşılaştırıyor, 21 kayıp kargonun RMSE'yi nasıl neredeyse üç katına çıkardığını, residual analizini ve eğitim aralığının dışında iki model ailesinin nasıl farklı davrandığını gerçek çıktılarla gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Microsoft.ML 6.0.0 (ML.NET 6.0), Microsoft.ML.FastTree 6.0.0 ve Microsoft.ML.LightGbm 6.0.0 ile derlenip çalıştırılmıştır. Veri, serinin seed'li generator'ıyla üretilmiş sentetik Bookstore verisidir.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için önceki yazıda kurduğumuz feature pipeline'ını sabit tutuyoruz ve sonuna dört farklı trainer takıyoruz: linear bir model (SDCA) ve üç ağaç tabanlı model (FastTree, FastForest, LightGBM). Tablo verisinde ağaç tabanlı gradient boosting modellerinin genellikle en iyi sonucu verdiği bilinir. Sence bu veride hangisi kazanır? Fark ne kadar olur?
İkinci soru metric'lerle ilgili. Test setindeki 4.489 siparişin 21'i, yani yüzde yarımdan azı, haftalar sonra bulunan kayıp kargolar. Bu 21 satırı test setinden çıkarırsan MAE (ortalama mutlak hata), RMSE (hataların karelerinin ortalamasının karekökü) ve R² ne kadar değişir?
Linear Regression ve Loss Function
Linear regression, tahmini feature'ların ağırlıklı toplamı olarak yapar: her feature'ın bir weight'i vardır, bir de sabit bir bias. Teslim süresi için tek feature'lı en basit hâli "gün = w × mesafe + b". Eğitim, w ve b için en iyi değerleri bulmaktır. "En iyi"yi tanımlayan şeye loss function denir. Regression'da en yaygın loss, hataların karesinin ortalaması, yani MSE (mean squared error; tahmin ile gerçek arasındaki farkın karesinin ortalaması).
Kare almanın iki sonucu var. Pozitif ve negatif hatalar birbirini götürmez. Büyük hatalar orantısız şekilde cezalandırılır: 10 günlük bir hata, 1 günlük hatanın 10 değil 100 katı loss üretir. Bu ikinci özellik, yazının ilerisinde kayıp kargolar konusunda karşımıza çıkacak.
Gradient Descent'i Elle Yazmak
Modelin w ve b'yi nasıl bulduğunu görmek için ML.NET'i bir kenara bırakıp kendi döngümüzü yazalım. Stokta olmayan kitabı bulunmayan Standard siparişlerde teslim süresini mesafeyle tahmin ediyoruz. Mesafeyi 1.000'e bölüyoruz ki sayılar küçük kalsın; önceki yazıdaki normalization dersini hatırla:
(double X, double Y)[] points = [.. OrderRow.Load("data/orders_clean.csv")
    .Where(o => o.DeliveryDays is not null && o.ShippingMethod == "Standard" && !o.HasBackorderItem)
    .Select(o => (o.DistanceKm / 1000.0, o.DeliveryDays!.Value))];
foreach (double learningRate in new[] { 0.1, 0.5, 1.0 })
{
    double w = 0, b = 0;
    Console.WriteLine($"learning rate {learningRate}:");
    for (int epoch = 0; epoch <= 300; epoch++)
    {
        double gradW = 0, gradB = 0, loss = 0;
        foreach ((double x, double y) in points)
        {
            double error = w * x + b - y;      // tahmin eksi gerçek
            loss += error * error;
            gradW += 2 * error * x;
            gradB += 2 * error;
        }
        loss /= points.Length;
        if (epoch is 0 or 1 or 2 or 5 or 20 or 100 or 300)
        {
            Console.WriteLine($"  epoch {epoch,3}: MSE {loss,11:G6}   w {w,10:G5}   b {b,10:G5}");
        }
        w -= learningRate * gradW / points.Length;
        b -= learningRate * gradB / points.Length;
    }
}
// Karşılaştırma için tek feature'lı least squares'in kesin cevabı
double mx = points.Average(p => p.X), my = points.Average(p => p.Y);
double slope = points.Sum(p => (p.X - mx) * (p.Y - my)) / points.Sum(p => (p.X - mx) * (p.X - mx));
Console.WriteLine($"closed form: w {slope:F4}   b {my - slope * mx:F4}   ({points.Length:N0} orders)");
dotnet run --project src/Bookstore.ML.Lab -- gdlearning rate 0.1:
epoch 0: MSE 10.3813 w 0 b 0
epoch 1: MSE 7.7049 w 0.17197 b 0.5203
epoch 2: MSE 6.06582 w 0.30848 b 0.92683
epoch 5: MSE 4.06998 w 0.57402 b 1.6856
epoch 20: MSE 3.46646 w 0.90516 b 2.337
epoch 100: MSE 3.45271 w 1.2013 b 2.2647
epoch 300: MSE 3.45191 w 1.2894 b 2.2374
learning rate 0.5:
epoch 0: MSE 10.3813 w 0 b 0
epoch 1: MSE 3.52897 w 0.85987 b 2.6015
epoch 2: MSE 3.47234 w 0.83308 b 2.3586
epoch 5: MSE 3.46336 w 0.94932 b 2.3428
epoch 20: MSE 3.45261 w 1.2072 b 2.2628
epoch 100: MSE 3.45191 w 1.2918 b 2.2366
epoch 300: MSE 3.45191 w 1.2919 b 2.2366
learning rate 1:
epoch 0: MSE 10.3813 w 0 b 0
epoch 1: MSE 13.001 w 1.7197 b 5.203
epoch 2: MSE 16.6254 w -0.10718 b -0.97154
epoch 5: MSE 38.1176 w 2.7589 b 7.6923
epoch 20: MSE 4396.67 w -17.541 b -58.466
epoch 100: MSE 7.21825E+14 w -7.6295E+06 b -2.4607E+07
epoch 300: MSE 7.8987E+42 w -7.981E+20 b -2.574E+21
closed form: w 1.2919 b 2.2366 (18,931 orders)Gradient descent'in mantığı şu: her adımda loss'un w ve b'ye göre eğimini (gradient) hesapla ve ikisini de eğimin tersi yönünde biraz kaydır. Ne kadar kaydıracağını learning rate belirler. 0,1'de model doğru yöne gidiyor ama yavaş: 300 epoch'tan sonra w hâlâ 1,2894, kesin cevap 1,2919. 0,5'te 100 epoch'ta kesin cevaba ulaşıyor. 1,0'da ise her adım vadiyi aşıp karşı yamaca çıkıyor, loss her adımda büyüyor ve 300 epoch sonunda çıktıdaki 7.8987E+42 değerine ulaşıyor. Model ıraksadı.
Sonucun anlamı da okunabilir: her 1.000 km teslim süresine yaklaşık 1,29 gün ekliyor ve mesafe sıfırken bile 2,24 günlük bir taban var. MSE'nin 3,45'te kalması ise tek feature'ın teslim süresinin küçük bir kısmını açıkladığını gösteriyor. SDCA da aynı işi yapar, ama yüzlerce feature'la, akıllı adım seçimiyle ve regularization ile. Regularization, weight'lerin aşırı büyümesini cezalandırarak overfitting'i sınırlar.
Ağaç Tabanlı Modeller
Karar ağacı, veriyi art arda sorularla böler: "bekleme süresi 40 saatten fazla mı?", "stokta olmayan kitap var mı?", "mesafe 650 km'den fazla mı?". Her yaprakta o bölgedeki siparişlerin ortalaması tahmin olur. Tek bir ağaç hızla overfit eder, bu yüzden pratikte ağaç toplulukları kullanılır. ML.NET'te üç seçenek var:
- FastTree: ML.NET dokümanının tarifiyle MART (Multiple Additive Regression Trees; art arda eklenen regression ağaçları) gradient boosting algoritmasının bir implementasyonu. Ağaçlar sırayla eğitilir; her yeni ağaç, önceki ağaçların toplamının yaptığı hatayı düzeltmeye çalışır.
- FastForest: random forest yaklaşımı. Ağaçlar birbirinden bağımsız, verinin ve feature'ların farklı rastgele alt kümeleriyle eğitilir ve tahminleri ortalanır.
- LightGBM: Microsoft'un açık kaynak gradient boosting kütüphanesi; ML.NET onu
Microsoft.ML.LightGbmpaketiyle sarıyor. Feature değerlerini histogram aralıklarına bölerek büyük veride hızlı eğitir.
Ağaçların tablo verisinde güçlü olmasının nedenleri önceki yazıda gördüklerimiz: feature etkileşimlerini kendileri bulurlar ("cuma ve saat 15'ten sonra"), ölçekten etkilenmezler ve doğrusal olmayan ilişkileri eşiklerle yakalarlar.
Aynı Pipeline, Dört Trainer
Müşteriye göre gruplanmış aynı 80/20 split üzerinde dört trainer'ı önceki yazıdaki tam pipeline ile eğitiyoruz:
Dictionary<string, IEstimator<ITransformer>> trainers = new()
{
    ["SDCA"] = ml.Regression.Trainers.Sdca(new SdcaRegressionTrainer.Options
    {
        LabelColumnName = "DeliveryDays", FeatureColumnName = "Features", NumberOfThreads = 1,
    }),
    ["FastTree"] = ml.Regression.Trainers.FastTree(labelColumnName: "DeliveryDays", featureColumnName: "Features"),
    ["FastForest"] = ml.Regression.Trainers.FastForest(labelColumnName: "DeliveryDays", featureColumnName: "Features"),
    ["LightGBM"] = ml.Regression.Trainers.LightGbm(labelColumnName: "DeliveryDays", featureColumnName: "Features"),
};
Console.WriteLine($"{"trainer",-11}{"MAE",8}{"RMSE",8}{"R2",8}");
Dictionary<string, ITransformer> models = [];
foreach ((string name, IEstimator<ITransformer> trainer) in trainers)
{
    ITransformer model = FeatureLab.Full(trainer).Fit(train);
    RegressionMetrics m = ml.Regression.Evaluate(model.Transform(split.TestSet), labelColumnName: "DeliveryDays");
    Console.WriteLine($"{name,-11}{m.MeanAbsoluteError,8:F3}{m.RootMeanSquaredError,8:F3}{m.RSquared,8:F3}");
    models[name] = model;
}
dotnet add src/Bookstore.ML.Lab package Microsoft.ML.LightGbm --version 6.0.0
dotnet run --project src/Bookstore.ML.Lab -- comparetrainer MAE RMSE R2
SDCA 0.525 1.691 0.342
FastTree 0.544 1.719 0.320
FastForest 0.611 1.722 0.317
LightGBM 0.536 1.703 0.332Açılıştaki sorunun cevabı: bu veride SDCA kazanıyor. MAE'si 0,525, LightGBM 0,536, FastTree 0,544, FastForest 0,611. Ama bu "linear modeller ağaçlardan iyidir" demek değil. Önceki yazıda gün ve saatten HoursUntilProcessing feature'ını ürettiğimizde, ağacın kendi başına bulduğu etkileşimi linear modele hazır bir sayı olarak verdik. O feature olmadan SDCA'nın cross-validation hatası 0,637, FastTree'ninki 0,541 idi. Algoritma seçimi ile feature engineering birbirinden bağımsız değil. İyi feature'larla basit bir model yeterli olabilir; ham feature'larla ağaçlar çok daha affedicidir.
Fark küçük olduğunda karar başka kriterlere kalır. SDCA'nın modeli birkaç kilobayt, her weight'i okunabilir ve hesaplaması çok hızlı. Ağaç modelleri yüzlerce ağaçtan oluşur ve dosyaları daha büyüktür. Bu veride bir de platform farkı var: LightGBM native bir kütüphane ve NuGet'teki LightGBM 4.6.0 paketi yalnız win-x64, linux-x64 ve osx-x64 için derlenmiş dosyalar içeriyor. ARM64 (telefonlarda ve yeni dizüstü bilgisayarlarda yaygın işlemci mimarisi) bir makinede ya da container'da çalışmaz. Linux'ta ayrıca OpenMP kütüphanesine ihtiyacı var: Ubuntu tabanlı .NET SDK container'ında ilk denemede libgomp.so.1 bulunamadığı için DllNotFoundException aldım, libgomp1 paketini kurunca çalıştı. Bu karşılaştırmayı bu yüzden Linux x64 bir container'da çalıştırdım. SDCA, FastTree ve FastForest sonuçları başka bir makinede de birebir aynı çıktı. Dağıtım ortamın ARM64 ise LightGBM'i baştan eleyebilirsin.
MAE, RMSE ve R²
Tablodaki üç metric farklı sorulara cevap veriyor. MAE (ortalama mutlak hata), tahminin gerçek değerden ortalama kaç gün saptığı. Birimi gün ve iş tarafına anlatması en kolay olanı: "tahminlerimiz ortalama yarım gün sapıyor". RMSE (hataların karelerinin ortalamasının karekökü) da gün cinsinden ama büyük hataları daha ağır cezalandırır, çünkü karesi alınmış hatalardan hesaplanır. RMSE'nin MAE'den çok büyük olması, hataların bir kısmının çok büyük olduğunu gösterir. Burada 0,53'e karşı 1,70.
R², modelin label'daki değişkenliğin ne kadarını açıkladığını gösterir. Her siparişe ortalamayı söyleyen bir model R² = 0 alır, kusursuz bir model 1. Ortalamadan da kötü bir model negatif R² alabilir. R² birimsiz olduğu için farklı problemler arasında karşılaştırılabilir gibi görünür, ama bu bir yanılsama; birazdan göreceğiz.
Hangisini seçeceğin iş sorusuna bağlı. Müşteriye bir tarih söylüyorsan, 2 günlük bir hata ile 10 günlük bir hatanın maliyeti aynı değildir. 10 gün geciken bir sipariş müşteri hizmetlerine çağrı, iade ve kayıp müşteri demek. Büyük hatalar pahalıysa RMSE'yi izle. Tek bir sayıyla raporlayacaksan MAE'yi seç. Ve ilk yazıdaki gibi bir iş metric'i ekle: siparişlerin yüzde kaçında tahmin gerçeğe bir gün yakın kalıyor? Geç kalmak erken gelmekten kötüyse, ortalama hatanın işaretine de bak.
Residual Analizi
Residual, tahmin ile gerçek arasındaki fark. Ortalama residual sıfıra yakın olabilir ama belli bir grupta sistematik olarak pozitif ya da negatif olabilir. Bunu yakalamak için test setini anlamlı gruplara bölüp her grubun ortalama hatasına bakıyoruz:
(string Group, Func<Scored, bool> Filter)[] groups =
[
    ("all test orders", _ => true),
    ("Express", s => s.ShippingMethod == "Express"),
    ("back-ordered", s => s.HasBackorderItem),
    ("campaign week", s => s.IsCampaign),
    ("campaign + back-ordered", s => s.IsCampaign && s.HasBackorderItem),
    ("waits > 40 h (weekend)", s => s.HoursUntilProcessing > 40),
    ("delivered in > 15 days", s => s.DeliveryDays > 15),
];
mean error (days) SDCA LightGBM orders
all test orders -0.01 -0.01 4489
Express -0.14 -0.09 734
back-ordered -0.21 -0.28 107
campaign week 0.10 0.10 513
campaign + back-ordered 0.09 -0.40 12
waits > 40 h (weekend) 0.07 0.07 590
delivered in > 15 days -22.55 -22.54 21Bütün test setinde ortalama hata -0,01: model genel olarak ne iyimser ne kötümser. Gruplarda ise tablo farklı. İki model de Express siparişleri biraz kısa tahmin ediyor (-0,14 ve -0,09 gün). Stokta olmayan kitabı olan 107 siparişte iki model de 0,2–0,3 gün eksik kalıyor; tedarik süresindeki belirsizlik büyük ve model bunu ortalamayla tahmin ediyor. Kampanya haftalarında ise iki model de 0,10 gün fazla tahmin ediyor. Kampanya ve stok eksikliği birlikteyse LightGBM -0,40 gün sapıyor, ama bu yalnız 12 sipariş ve bu kadar küçük bir gruptan sonuç çıkarmak doğru olmaz.
Son satır en dikkat çekici olanı: 15 günden uzun süren 21 teslimatta iki model de ortalama 22,5 gün eksik tahmin ediyor. Kaybolan bir kargoyu sipariş anında haber veren hiçbir feature yok. Bu satırlar modelin hatası değil, modelin göremeyeceği bir olay. Residual analizi modeli düzeltmekten çok, nerede güvenilir olduğunu ve nerede olmadığını öğrenmek için yapılır.
Outlier'lar Metric'leri Nasıl Etkiler?
Aynı LightGBM modelinin aynı tahminlerini iki kez ölçüyoruz: bir kez bütün test setinde, bir kez 15 günden uzun 21 satır olmadan. Bir de Express ve Standard siparişleri ayrı ayrı ölçüyoruz:
IDataView normal = ml.Data.FilterRowsByColumn(test, "DeliveryDays", upperBound: 15);
RegressionMetrics all = ml.Regression.Evaluate(model.Transform(test), labelColumnName: "DeliveryDays");
RegressionMetrics clean = ml.Regression.Evaluate(model.Transform(normal), labelColumnName: "DeliveryDays");
long lost = test.GetColumn<float>("DeliveryDays").Count(d => d > 15);
Console.WriteLine();
Console.WriteLine($"LightGBM, all test rows       : MAE {all.MeanAbsoluteError:F3}  RMSE {all.RootMeanSquaredError:F3}  R2 {all.RSquared:F3}");
Console.WriteLine($"without {lost} rows over 15 days : MAE {clean.MeanAbsoluteError:F3}  RMSE {clean.RootMeanSquaredError:F3}  R2 {clean.RSquared:F3}");
foreach (string method in new[] { "Express", "Standard" })
{
    IDataView subset = ml.Data.FilterByCustomPredicate<DeliveryInput>(normal, o => o.ShippingMethod != method);
    RegressionMetrics m = ml.Regression.Evaluate(model.Transform(subset), labelColumnName: "DeliveryDays");
    Console.WriteLine($"  only {method,-8}: MAE {m.MeanAbsoluteError:F3}  RMSE {m.RootMeanSquaredError:F3}  R2 {m.RSquared:F3}");
}
LightGBM, all test rows : MAE 0.536 RMSE 1.703 R2 0.332
without 21 rows over 15 days : MAE 0.432 RMSE 0.602 R2 0.800
only Express : MAE 0.363 RMSE 0.518 R2 0.829
only Standard: MAE 0.446 RMSE 0.617 R2 0.779Açılıştaki ikinci sorunun cevabı burada. Test setinin yüzde 0,5'inden azını çıkarmak MAE'yi 0,536'dan 0,432'ye indiriyor, RMSE'yi 1,703'ten 0,602'ye, yani neredeyse üçte birine düşürüyor ve R²'yi 0,332'den 0,800'e çıkarıyor. Model değişmedi; değişen, metric'in hangi satırlara baktığı. Aşağıdaki grafik bunun nedenini gösteriyor: 15 günün altındaki tahminler köşegen etrafında toplanıyor, 21 kırmızı nokta ise sağda, 2–3 günlük tahminlerle 15–38 günlük gerçek değerler arasında duruyor.
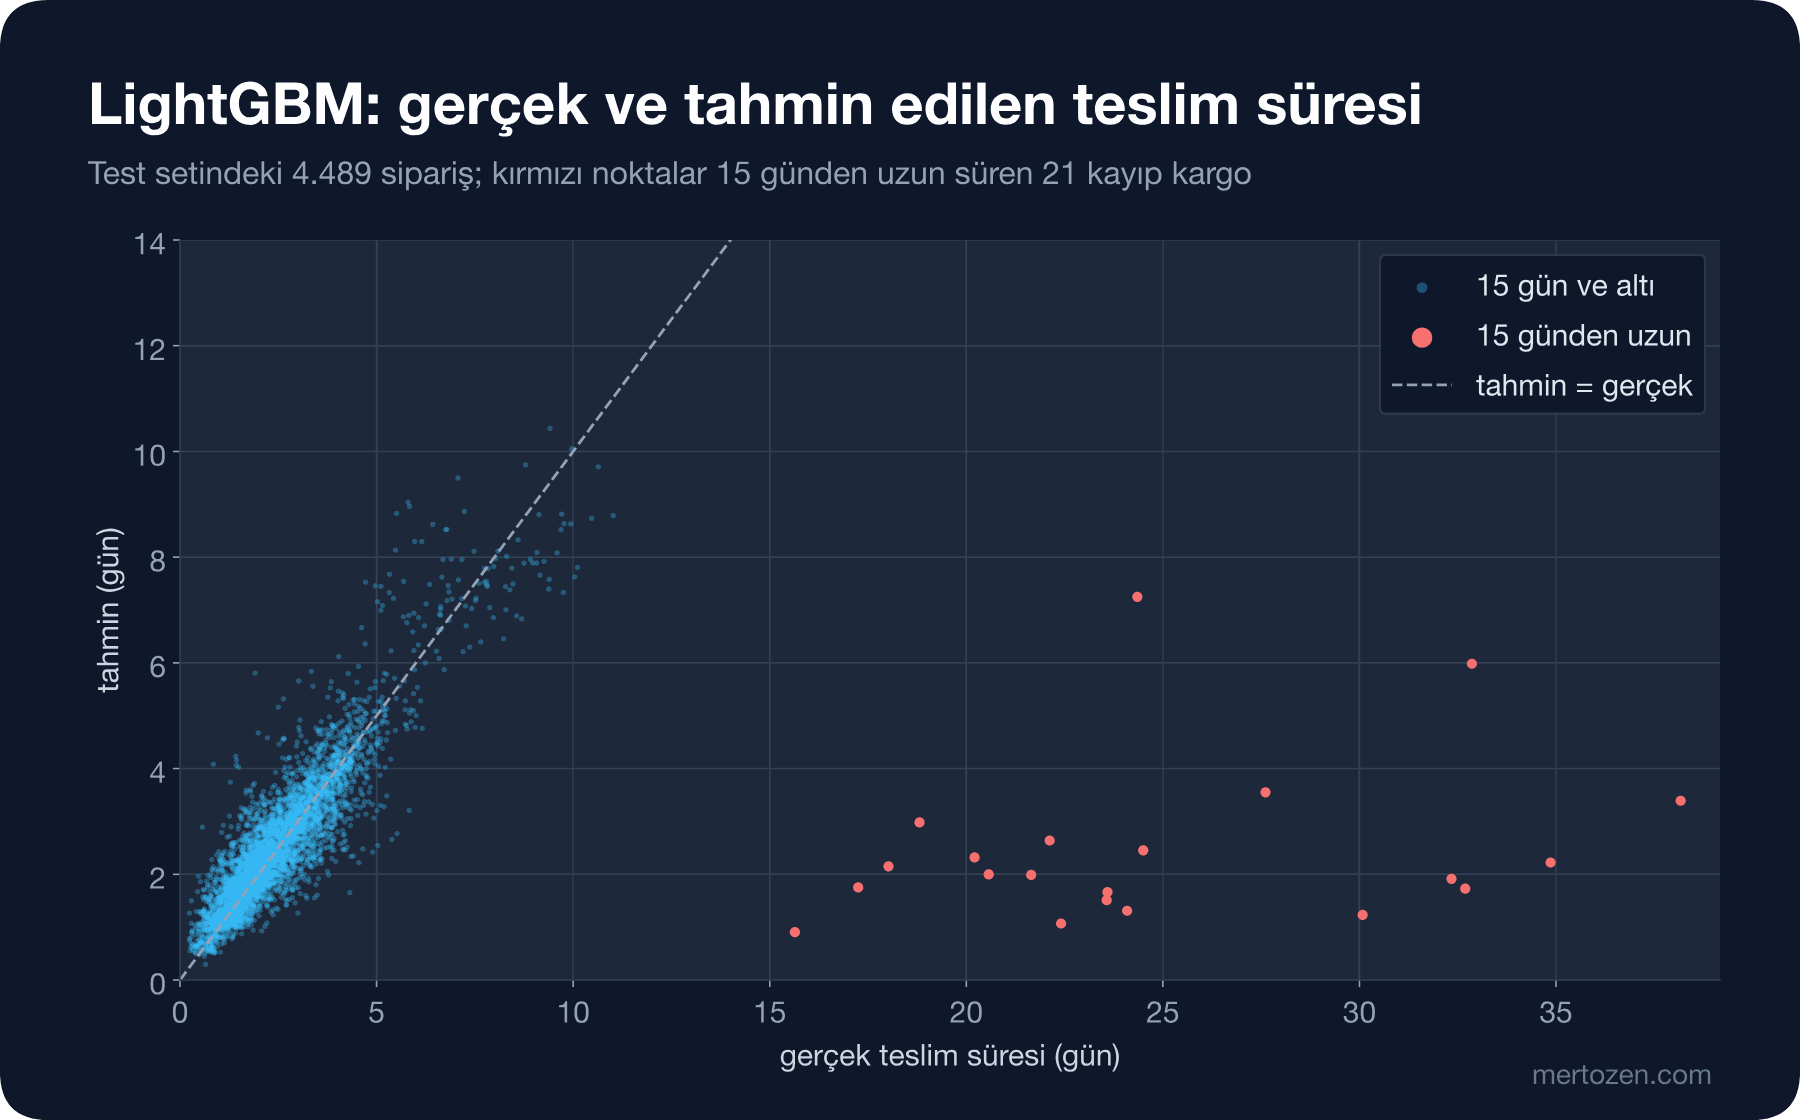
Buradan iki ders çıkıyor. Birincisi R² ile ilgili: aynı model aynı tahminlerle 0,33 de 0,80 de alabiliyor. R² modelin değil, model ile test verisinin birlikte bir özelliği. Express siparişlerin R²'sinin (0,829) Standard'dan (0,779) yüksek olması da bu yüzden dikkatli okunmalı. R²'yi tek başına yorumlama; MAE ve RMSE ile birlikte, aynı test setinde karşılaştır. İkincisi outlier'larla ilgili: 21 satırı test setinden sessizce çıkarıp 0,80'i raporlamak dürüst olmaz. Doğru yaklaşım iki sayıyı da göstermek ve kayıp kargoları ayrı bir süreçle ele almak, örneğin uzun süre hareketsiz kalan kargolar için bir uyarı ile. Bu tür olayları model değil süreç yakalar.
Extrapolation: Eğitim Aralığının Dışında
Model eğitimde gördüğü aralığın dışında ne yapar? Bookstore'da bunun gerçek bir örneği var: bireysel siparişler en fazla 12 kitap, Kurumsal Sipariş modülünden gelen siparişler ise 20 ile 120 kitap arasında. Modeli yalnız bireysel siparişlerle eğitip kurumsal siparişleri soralım:
IDataView individual = ml.Data.FilterRowsByColumn(data, "ItemCount", upperBound: 13);
List<DeliveryInput> institutional = [.. ml.Data.CreateEnumerable<DeliveryInput>(
    ml.Data.FilterRowsByColumn(data, "ItemCount", lowerBound: 20), false)];
ITransformer sdca = FeatureLab.Full(ml.Regression.Trainers.Sdca(new SdcaRegressionTrainer.Options
{
    LabelColumnName = "DeliveryDays", FeatureColumnName = "Features", NumberOfThreads = 1,
})).Fit(individual);
ITransformer gbm = FeatureLab.Full(ml.Regression.Trainers.LightGbm(labelColumnName: "DeliveryDays",
    featureColumnName: "Features")).Fit(individual);
var e1 = ml.Model.CreatePredictionEngine<DeliveryInput, DeliveryPrediction>(sdca);
var e2 = ml.Model.CreatePredictionEngine<DeliveryInput, DeliveryPrediction>(gbm);
Console.WriteLine();
Console.WriteLine($"trained on ItemCount <= 12; institutional orders in the data: {institutional.Count}, " +
                  $"mean {institutional.Average(o => o.DeliveryDays):F2} days");
double maeSdca = institutional.Average(o => Math.Abs(e1.Predict(o).PredictedDays - o.DeliveryDays));
double maeGbm = institutional.Average(o => Math.Abs(e2.Predict(o).PredictedDays - o.DeliveryDays));
Console.WriteLine($"  MAE on institutional orders: SDCA {maeSdca:F3}, LightGBM {maeGbm:F3}");
trained on ItemCount <= 12; institutional orders in the data: 310, mean 4.52 days
MAE on institutional orders: SDCA 1.597, LightGBM 1.118Kurumsal siparişlerde hata SDCA'da 1,597, LightGBM'de 1,118 gün; normal test setindeki yarım günün iki ila üç katı. Bu siparişlerin ortalama teslim süresi 4,52 gün, çünkü stok eksikliği daha sık ve ofis adreslerine hafta sonu teslimat yapılmıyor. Model bu dünyayı hiç görmedi. İkinci deney farkı daha net gösteriyor. Modeli 1.000 km'den yakın siparişlerle eğitip aynı siparişi farklı mesafelerle soruyoruz:
// Aynı soru mesafe için: 1.000 km'nin altıyla eğit, Van'ı sor (ANK-1'e 1.220 km)
IDataView near = ml.Data.FilterRowsByColumn(data, "DistanceKm", upperBound: 1000);
List<DeliveryInput> far = [.. ml.Data.CreateEnumerable<DeliveryInput>(
    ml.Data.FilterRowsByColumn(data, "DistanceKm", lowerBound: 1000), false)];
ITransformer sdcaNear = FeatureLab.Full(ml.Regression.Trainers.Sdca(new SdcaRegressionTrainer.Options
{
    LabelColumnName = "DeliveryDays", FeatureColumnName = "Features", NumberOfThreads = 1,
})).Fit(near);
ITransformer gbmNear = FeatureLab.Full(ml.Regression.Trainers.LightGbm(labelColumnName: "DeliveryDays",
    featureColumnName: "Features")).Fit(near);
var n1 = ml.Model.CreatePredictionEngine<DeliveryInput, DeliveryPrediction>(sdcaNear);
var n2 = ml.Model.CreatePredictionEngine<DeliveryInput, DeliveryPrediction>(gbmNear);
Console.WriteLine($"trained on DistanceKm < 1000; {far.Count} orders travel farther, mean {far.Average(o => o.DeliveryDays):F2} days");
DeliveryInput order = far.First(o => !o.HasBackorderItem && o.ShippingMethod == "Standard" && o.CustomerNote == "");
foreach (int km in new[] { 300, 600, 900, 1200, 1600 })
{
    order.DistanceKm = km;
    Console.WriteLine($"  {km,5} km: SDCA {n1.Predict(order).PredictedDays,5:F2}   LightGBM {n2.Predict(order).PredictedDays,5:F2}");
}
Console.WriteLine($"  MAE on the far orders: SDCA {far.Average(o => Math.Abs(n1.Predict(o).PredictedDays - o.DeliveryDays)):F3}, " +
                  $"LightGBM {far.Average(o => Math.Abs(n2.Predict(o).PredictedDays - o.DeliveryDays)):F3}");
trained on DistanceKm < 1000; 734 orders travel farther, mean 3.74 days
300 km: SDCA 4.45 LightGBM 4.21
600 km: SDCA 4.81 LightGBM 4.68
900 km: SDCA 5.17 LightGBM 4.85
1200 km: SDCA 5.53 LightGBM 4.85
1600 km: SDCA 6.01 LightGBM 4.85
MAE on the far orders: SDCA 0.701, LightGBM 0.795İki model ailesinin davranışı burada açıkça ayrışıyor. SDCA çizgiyi devam ettiriyor: her 300 km için yaklaşık 0,36 gün ekliyor ve 1.600 km'de 6,01 gün diyor. LightGBM ise 900 km'den sonra 4,85'te sabitleniyor; ağaçların yaprakları eğitimde görülen en uzak bölgenin ortalamasını vermekten başka bir şey yapamıyor. Bu veride mesafenin etkisi gerçekten doğrusal olduğu için SDCA uzak siparişlerde daha iyi (0,701'e karşı 0,795). Ama ilişki doğrusal olmasaydı linear modelin "çizgiyi devam ettirmesi" de aynı derecede yanlış olurdu. Pratik sonuç: modelin eğitim aralığını kaydet ve üretimde bu aralığın dışına düşen istekleri işaretle. Onuncu yazıda bunu drift izlemenin bir parçası olarak ele alacağız.
Sık Düşülen Tuzaklar
İlk tuzak, R²'yi tek başına yorumlamak. Aynı model, birkaç outlier'ın varlığına göre 0,33 ya da 0,80 alabiliyor. R²'yi hep MAE ve RMSE ile birlikte, aynı test setinde raporla.
İkincisi, outlier'ların RMSE'yi şişirmesini görmezden gelmek ya da tersine, onları sessizce silip güzel bir sayı raporlamak. İki durumu da ayrı ayrı göster ve outlier'ın iş tarafındaki karşılığını konuş.
Üçüncüsü, extrapolation. Eğitimde 12 kitaptan büyük sipariş görmemiş bir model 120 kitaplık kurumsal siparişi tahmin ettiğinde hata üç katına çıkıyor. Eğitim aralığını bil ve dışına düşen istekleri izle.
Dördüncüsü, algoritmayı feature'lardan bağımsız seçmek. Bu yazıda SDCA kazandı, çünkü önceki yazıda ona doğru feature'ı verdik. Algoritma karşılaştırmasını her zaman aynı feature pipeline'ı üzerinde yap ve feature'lar değiştiğinde tekrarla.
Beşincisi, tek bir metric'le karar vermek. 0,011 günlük MAE farkı için model boyutundan, açıklanabilirlikten ya da platform desteğinden vazgeçmeye değmeyebilir.
Küçük Bir Deneme
★☆☆ Gradient descent döngüsünde learning rate'i 0,9 ve 0,95 yap. Model hangi değerde ıraksamaya başlıyor? Mesafeyi 1.000'e bölmeden aynı deneyi tekrarla ve hangi learning rate'in çalıştığına bak.
★★☆ Residuals method'una kargo firmasına göre bir grup ekle ve Haziran 2026'dan sonraki CarrierB siparişlerini ayrıca ölç. Üçüncü yazıda gördüğümüz yavaşlama bu modelde de görünüyor mu? Görünüyorsa neden?
★★★ Kayıp kargoları eğitim verisinden çıkarıp (15 günden uzun teslimatlar) modeli yeniden eğit, ama test setine dokunma. MAE, RMSE ve R² nasıl değişiyor? Outlier'ları eğitimden çıkarmak ile değerlendirmeden çıkarmak arasındaki farkı yaz.
Bir sonraki yazıda sayı yerine sınıf tahmin edeceğiz: siparişin iptal edilip edilmeyeceğini tahmin eden bir binary classification modeli kuracak, confusion matrix, precision, recall, F1 (precision ile recall'un harmonik ortalaması) ve ROC (Receiver Operating Characteristic; farklı threshold'larda doğru ve yanlış pozitif oranlarını gösteren eğri) altındaki alan olan ROC-AUC metric'lerini, threshold seçimini ve yorum metninden konu tahmin eden bir multiclass modeli inceleyeceğiz.