

Train/Test Split, Overfitting ve Data Leakage: Model Neden Testte Parlar, Üretimde Çöker?

Model, eğitimde görmediği ve tahmin anında gerçekten elinde olacak bilgilerle ölçülmezse test skoru yalan söyler. Bookstore teslim süresi verisinde ML.NET ile baseline'ları, overfitting eğrisini, teslimattan sonra oluşan bir kolonun ve tüm veriden hesaplanan bir feature'ın yarattığı sahte başarıyı, zaman bazlı split'in yakaladığı kargo gecikmesini, samplingKeyColumnName'i ve cross-validation'ı gerçek ölçümlerle gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Microsoft.ML 6.0.0 (ML.NET 6.0) ve Microsoft.ML.FastTree 6.0.0 ile derlenip çalıştırılmıştır. Veri, serinin seed'li generator'ıyla üretilmiş sentetik Bookstore verisidir.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için bir teslim süresi modeli eğittin ve test setinde ortalama 0,86 gün hata yaptı. Takımdan biri modele bir kolon daha ekliyor ve hata 0,70 güne iniyor; yüzde 19'luk bir iyileşme. Bu modeli hemen üretime alır mıydın? Eklenen kolonun adı TrackingEventCount, yani kargonun takip sisteminde oluşan olay sayısı.
Önceki yazıyı okuduysan cevabı tahmin ediyorsundur: bu kolon ancak kargo yola çıktıktan sonra oluşuyor, sipariş anında yok. Model testte daha iyi görünüyor, çünkü test setinde cevabın bir kısmını görüyor. Bu yazıda bu tür sahte başarıların nereden geldiğini ve nasıl yakalandığını gerçek ölçümlerle göreceğiz.
Generalization ve Baseline
Bir modelden beklediğimiz şey, eğitimde gördüğü siparişleri ezberlemesi değil, hiç görmediği yeni siparişlerde de iyi tahmin yapması. Buna generalization denir. Bunu ölçmenin tek yolu, modeli eğitimde kullanmadığın bir veriyle test etmek. En basit yöntem veriyi rastgele ikiye ayırmak: yüzde 80'i train, yüzde 20'si test.
Bu yazıda ML.NET'i ilk kez kullanıyoruz ama pipeline'ın içini dördüncü yazıda açacağız. Şimdilik onu, birkaç kolonu alıp FastTree (karar ağaçlarını art arda eğiten bir regression algoritması) ile teslim süresi tahmin eden bir kutu olarak düşün. Bu yazıdaki komutlar önceki yazının ürettiği data/orders_clean.csv dosyasını okuyor; repoyu yeni klonladıysan önce dotnet run --project tools/Bookstore.DataGen, sonra dotnet run --project src/Bookstore.ML.Lab -- clean komutunu çalıştır. Paketleri ekleyip bölünmüş veride ilk ölçümü alalım:
/// <summary>Yalnız teslim edilmiş siparişler: iptal edilenlerin label'ı yok.</summary>
public static List<DeliveryInput> LoadDelivered()
{
    IDataView raw = Ml.Data.LoadFromTextFile<DeliveryInput>("data/orders_clean.csv", hasHeader: true, separatorChar: ',');
    return [.. Ml.Data.CreateEnumerable<DeliveryInput>(raw, reuseRowObject: false).Where(o => !o.IsCancelled)];
}
/// <summary>Küçük bir ağaç modeli; bu pipeline'ın her adımını 04. yazı anlatıyor.</summary>
public static IEstimator<ITransformer> Pipeline(string[] numericFeatures, int leaves = 20, int trees = 100, int minLeaf = 10) =>
    Ml.Transforms.Conversion.ConvertType([new("Campaign", "IsCampaign"), new("Backorder", "HasBackorderItem")], DataKind.Single)
        .Append(Ml.Transforms.Categorical.OneHotEncoding([new("CarrierKey", "Carrier"), new("MethodKey", "ShippingMethod"),
            new("WarehouseKey", "Warehouse")]))
        .Append(Ml.Transforms.Concatenate("Features", ["CarrierKey", "MethodKey", "WarehouseKey", "Campaign", "Backorder",
            .. numericFeatures]))
        .Append(Ml.Regression.Trainers.FastTree(labelColumnName: "DeliveryDays", numberOfLeaves: leaves,
            numberOfTrees: trees, minimumExampleCountPerLeaf: minLeaf));
// 1) Rastgele 80/20 split ve iki baseline
DataOperationsCatalog.TrainTestData random = Ml.Data.TrainTestSplit(all, testFraction: 0.2, seed: 7);
float trainMean = Ml.Data.CreateEnumerable<DeliveryInput>(random.TrainSet, false).Average(o => o.DeliveryDays);
List<DeliveryInput> randomTest = [.. Ml.Data.CreateEnumerable<DeliveryInput>(random.TestSet, false)];
Console.WriteLine($"rows: {rows.Count:N0}, train {random.TrainSet.GetRowCount() ?? Count(random.TrainSet):N0}, " +
$"test {randomTest.Count:N0}");
Console.WriteLine($"baseline 'always {trainMean:F2} days' MAE {randomTest.Average(o => Math.Abs(o.DeliveryDays - trainMean)):F3}");
double ruleMae = randomTest.Average(o => Math.Abs(Rule(o) - o.DeliveryDays));
Console.WriteLine($"baseline rule from post 01 MAE {ruleMae:F3}");
ITransformer model = Pipeline(Basic).Fit(random.TrainSet);
Console.WriteLine($"tree model, random split MAE {Mae(model, random.TestSet):F3}");dotnet add src/Bookstore.ML.Lab package Microsoft.ML --version 6.0.0
dotnet add src/Bookstore.ML.Lab package Microsoft.ML.FastTree --version 6.0.0
dotnet run --project src/Bookstore.ML.Lab -- splitrows: 23,105, train 18,480, test 4,625
baseline 'always 2.58 days' MAE 1.152
baseline rule from post 01 MAE 1.055
tree model, random split MAE 0.860Modelin 0,860 günlük hatası tek başına bir şey söylemiyor. Bu yüzden iki baseline'la karşılaştırıyoruz. İlki, her siparişe train setinin ortalamasını (2,58 gün) söyleyen en tembel model: 1,152 gün hata. İkincisi, ilk yazıdaki elle yazılmış kural: aynı test setinde 1,055 gün. Model kuralın hatasını yüzde 18 civarında azaltıyor. Bir model ortalama baseline'ını geçemiyorsa ya feature'larda bilgi yoktur ya da kodda bir hata vardır; her iki durumda da metric'lere bakmadan önce bunu bilmen gerekir.
Train, Validation ve Test
Gerçek bir projede veri iki değil üç parçaya ayrılır. Train seti modeli eğitmek için kullanılır. Validation seti farklı modelleri, feature setlerini ve ayarları karşılaştırıp seçmek için kullanılır. Test seti ise bütün kararlar verildikten sonra tek bir kez, raporlanacak sayıyı ölçmek için açılır.
Bu ayrımın nedeni şu: bir veri setine bakarak karar verdiğin anda o veri seti eğitimin bir parçası olur. On farklı modeli test setinde deneyip en iyisini seçersen, seçtiğin modelin test skoru o modelin değil, seçim sürecinin skorudur ve iyimserdir. Test seti, modelin üretimde karşılaşacağı bilinmeyen veriyi temsil ediyor; ona ne kadar az dokunursan söylediği sayı o kadar dürüst olur.
Overfitting ve Underfitting
Model karmaşıklığı arttıkça train hatası hep düşer. Validation hatası ise önce düşer, sonra yükselmeye başlar. Bunu görmek için FastTree'nin her ağacın kaç yaprağa (numberOfLeaves) bölünebileceğini 2'den 128'e kadar değiştiriyoruz. Etkiyi belirgin hâle getirmek için yalnız 1.500 satırla eğitiyor, 5.000 satırla ölçüyoruz:
IDataView all = Ml.Data.ShuffleRows(Ml.Data.LoadFromEnumerable(rows), seed: 5);
IDataView train = Ml.Data.TakeRows(all, 1500);
IDataView validation = Ml.Data.TakeRows(Ml.Data.SkipRows(all, 1500), 5000);
string[] features = [.. Basic, "TotalWeightKg", "OrderTotal"];
List<string> lines = ["leaves,train_mae,validation_mae"];
foreach (int leaves in new[] { 2, 3, 4, 6, 8, 12, 16, 24, 32, 48, 64, 96, 128 })
{
    ITransformer m = Pipeline(features, leaves: leaves, trees: 10, minLeaf: 1).Fit(train);
    double tr = Mae(m, train), va = Mae(m, validation);
    lines.Add(string.Create(CultureInfo.InvariantCulture, $"{leaves},{tr:F4},{va:F4}"));
    Console.WriteLine($"leaves {leaves,3}: train MAE {tr:F3}  validation MAE {va:F3}");
}
dotnet run --project src/Bookstore.ML.Lab -- complexityleaves 2: train MAE 0.926 validation MAE 0.901
leaves 3: train MAE 0.836 validation MAE 0.843
leaves 4: train MAE 0.810 validation MAE 0.822
leaves 6: train MAE 0.796 validation MAE 0.819
leaves 8: train MAE 0.788 validation MAE 0.834
leaves 12: train MAE 0.768 validation MAE 0.863
leaves 16: train MAE 0.756 validation MAE 0.881
leaves 24: train MAE 0.733 validation MAE 0.890
leaves 32: train MAE 0.708 validation MAE 0.904
leaves 48: train MAE 0.675 validation MAE 0.904
leaves 64: train MAE 0.641 validation MAE 0.913
leaves 96: train MAE 0.590 validation MAE 0.929
leaves 128: train MAE 0.550 validation MAE 0.946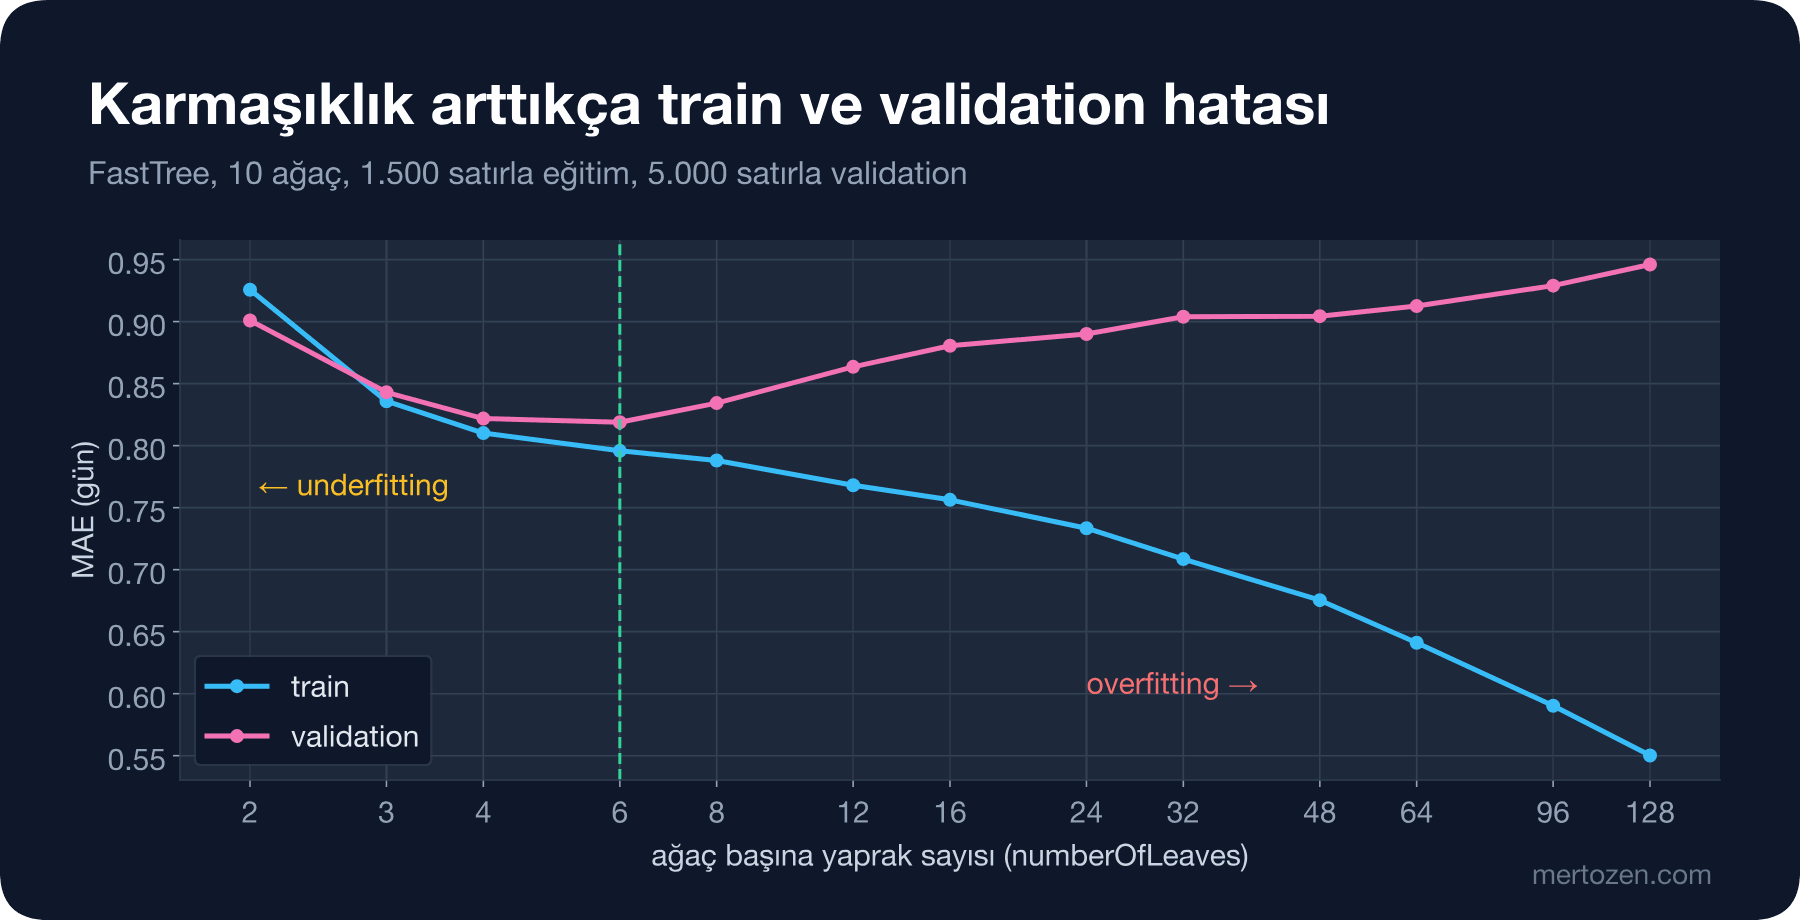
Grafiğin solunda, 2 yapraklı ağaçlarda model çok basit kalıyor; hem train hem validation hatası yüksek. Buna underfitting denir: model verideki ilişkiyi yakalayacak kapasitede değil. 6 yaprakta validation hatası en düşük noktaya (0,819) iniyor. Sağa doğru gittikçe train hatası 0,550'ye kadar düşmeye devam ediyor ama validation hatası 0,946'ya çıkıyor. Bu da overfitting: model 1.500 siparişin noise'unu da öğrenmiş, ezberlediği şeyler yeni siparişlerde işe yaramıyor.
Literatürde bu dengeye bias-variance trade-off denir. Basit bir model her veri setinde benzer ama sistematik olarak yanlış tahminler yapar (yüksek bias). Karmaşık bir model ise eğitim verisi biraz değiştiğinde bambaşka tahminler üretir (yüksek variance). Konunun matematiksel tarafını merak ediyorsan James, Witten, Hastie ve Tibshirani'nin ücretsiz yayımlanan An Introduction to Statistical Learning kitabı iyi bir başlangıç. Pratikteki ders basit: train hatasına bakarak model seçme, train ile validation hatası arasındaki farkı izle.
Target Leakage
Şimdi açılıştaki soruya dönelim. TrackingEventCount'u feature listesine eklemek tek satır:
// 2) Target leakage: TrackingEventCount ancak teslimattan sonra belli olur
ITransformer leaky = Pipeline([.. Basic, "TrackingEventCount"]).Fit(random.TrainSet);
Console.WriteLine($"+ TrackingEventCount (leak)    MAE {Mae(leaky, random.TestSet):F3}");
+ TrackingEventCount (leak) MAE 0.700Hata 0,860'tan 0,700'e indi. Model burada teslim süresini değil, cevabın bir yan ürününü öğreniyor: kargo uzun süre yolda kaldıkça takip sisteminde daha çok olay birikiyor. Buna target leakage denir. Feature, label'ın kendisinden veya label belli olduktan sonra oluşan bir bilgiden besleniyor. Bu model üretime çıktığında sipariş anında TrackingEventCount sıfır ya da boş olacak ve testteki 0,700 hiçbir zaman görülmeyecek.
Klasik bir örnek de iade tahmini. "Bu sipariş iade edilecek mi?" sorusunu cevaplayan bir modele ReturnRequestedUtc kolonunu, ya da ondan türetilen "iade talebine kadar geçen gün" gibi bir feature'ı verirsen model neredeyse kusursuz görünür, çünkü bu kolon yalnız iade edilen siparişlerde dolu. Target leakage'ı yakalamanın en iyi yolu kod değil, her feature için sorulan tek bir soru: bu değer tahmin anında hangi sistemde, hangi değerle duruyor?
Zaman Sızıntısı ve Zaman Bazlı Split
Rastgele split, test siparişlerini iki yılın her yerinden seçer. Ama model üretimde hep gelecekteki siparişler için tahmin yapacak. Bunu taklit etmek için 2026-05-01'den önceki siparişlerle eğitip son altı ayla test ediyoruz ve hatayı aya ve kargo firmasına göre kırıyoruz:
// 3) Zaman: geçmişle eğit, son altı ayda test et
DateTime cut = new(2026, 5, 1, 0, 0, 0, DateTimeKind.Utc);
IDataView past = Ml.Data.LoadFromEnumerable(rows.Where(o => o.OrderedAtUtc < cut));
List<DeliveryInput> future = [.. rows.Where(o => o.OrderedAtUtc >= cut)];
ITransformer timeModel = Pipeline(Basic).Fit(past);
Console.WriteLine($"tree model, time split         MAE {Mae(timeModel, Ml.Data.LoadFromEnumerable(future)):F3} " +
                  $"(train {Count(past):N0} before {cut:yyyy-MM-dd}, test {future.Count:N0})");
PredictionEngine<DeliveryInput, Prediction> engine = Ml.Model.CreatePredictionEngine<DeliveryInput, Prediction>(timeModel);
foreach (var g in future.GroupBy(o => (o.OrderedAtUtc.Month, o.Carrier == "CarrierB")).OrderBy(g => g.Key))
{
    double bias = g.Average(o => engine.Predict(o).Score - o.DeliveryDays);
    if (g.Key.Item2 || g.Key.Month is 5 or 10)
        Console.WriteLine($"  2026-{g.Key.Month:00} {(g.Key.Item2 ? "CarrierB" : "others  ")}  mean error {bias,6:F2} days ({g.Count()} orders)");
}
tree model, time split MAE 0.864 (train 16,388 before 2026-05-01, test 6,717)
2026-05 others mean error -0.05 days (646 orders)
2026-05 CarrierB mean error -0.03 days (358 orders)
2026-06 CarrierB mean error -0.74 days (350 orders)
2026-07 CarrierB mean error -0.90 days (358 orders)
2026-08 CarrierB mean error -0.82 days (359 orders)
2026-09 CarrierB mean error -0.74 days (520 orders)
2026-10 others mean error -0.13 days (698 orders)
2026-10 CarrierB mean error -0.88 days (371 orders)Toplam hata (0,864) rastgele split'tekiyle neredeyse aynı. Ama ayrıntı başka bir hikâye anlatıyor: Haziran 2026'dan itibaren CarrierB siparişlerinde model her ay 0,7–0,9 gün eksik tahmin ediyor. Diğer siparişlerde hata sıfıra yakın. Generator'da CarrierB'nin o tarihten sonra yavaşladığını biliyoruz; model ise geçmiş veride böyle bir şey görmediği için bilmiyor. Tek bir toplam metric'e bakan biri bunu hiç fark etmezdi. Bu yüzden hatayı her zaman anlamlı gruplara bölerek de incele.
Bir geliştiricinin aklına gelen ilk çözüm, sipariş tarihini sayı olarak (2024-11-01'den bu yana geçen gün, DaySerial) modele vermek olur. Rastgele split ile ölçünce sonuç harika görünüyor:
// 3b) Sipariş tarihi feature olarak: rastgele split modelin geleceğe bakmasına izin verir
List<DeliveryExtra> dated = [.. rows.Select(o => With(o, 0))];
var datedRandom = Ml.Data.TrainTestSplit(Ml.Data.LoadFromEnumerable(dated), testFraction: 0.2, seed: 7);
ITransformer dr = Pipeline([.. Basic, "DaySerial"]).Fit(datedRandom.TrainSet);
List<DeliveryExtra> drTest = [.. Ml.Data.CreateEnumerable<DeliveryExtra>(datedRandom.TestSet, false)];
ITransformer dt = Pipeline([.. Basic, "DaySerial"]).Fit(Ml.Data.LoadFromEnumerable(dated.Where(o => o.OrderedAtUtc < cut)));
List<DeliveryExtra> dtTest = [.. dated.Where(o => o.OrderedAtUtc >= cut)];
Console.WriteLine($"+ DaySerial, random split      MAE {Mae(dr, datedRandom.TestSet):F3}, CarrierB since June bias " +
                  $"{BiasB(dr, drTest):F2}");
Console.WriteLine($"+ DaySerial, time split        MAE {Mae(dt, Ml.Data.LoadFromEnumerable(dtTest)):F3}, CarrierB since June bias " +
                  $"{BiasB(dt, dtTest):F2}");
PredictionEngine<DeliveryInput, Prediction> randomEngine = Ml.Model.CreatePredictionEngine<DeliveryInput, Prediction>(model);
List<DeliveryInput> lateB = [.. randomTest.Where(o => o.Carrier == "CarrierB" && o.OrderedAtUtc >= new DateTime(2026, 6, 1))];
Console.WriteLine($"  random-split model on its own test rows, CarrierB since June: mean error " +
                  $"{lateB.Average(o => randomEngine.Predict(o).Score - o.DeliveryDays):F2} days ({lateB.Count} orders)");
+ DaySerial, random split MAE 0.807, CarrierB since June bias -0.15
+ DaySerial, time split MAE 0.913, CarrierB since June bias -1.09
random-split model on its own test rows, CarrierB since June: mean error -0.63 days (410 orders)Rastgele split'te hata 0,807'ye iniyor ve CarrierB'nin Haziran sonrası hatası -0,15'e düşüyor; sorun çözülmüş gibi. Zaman bazlı split'te ise aynı model 0,913 hata yapıyor ve CarrierB'yi 1,09 gün eksik tahmin ediyor; tarih eklenmeden önceki hâlinden bile kötü. Fark şuradan geliyor: rastgele split'te Haziran sonrası siparişlerin yüzde 80'i train'de duruyor ve model "tarih şu günden büyükse CarrierB yavaş" kuralını gelecekten öğreniyor. Üretimde ise gelecek hiç train'de olmayacak. Son satır da bir şeyi netleştiriyor: tarih feature'ı olmayan rastgele split modeli de bu siparişleri 0,63 gün eksik tahmin ediyor. Yani rastgele split sorunu gizlemiyor, tarih feature'ı ile birleşince gizliyor.
Kural basit: veride zaman varsa ve model geleceği tahmin edecekse, en az bir değerlendirmeyi zaman bazlı split ile yap. Dünyanın değiştiğini (bir kargo firmasının sözleşmesi, yeni açılan bir depo) bu split gösterir. Böyle değişikliklerin üretimde nasıl izleneceğine onuncu yazıda geleceğiz.
Bütün Veriye Bakarak Feature Üretmek
Leakage'ın üçüncü türü daha sinsi, çünkü feature tamamen meşru görünür. Her müşterinin geçmişteki ortalama teslim süresini feature olarak eklemek mantıklı: bazı müşteriler uzak bir ilçede oturuyor ve hep geç alıyor. Hata, bu ortalamayı split'ten önce bütün veri üzerinden hesaplamakta:
// 4) Bütün satırlardan hesaplanan bir feature: müşterinin ortalama teslim süresi
List<DeliveryInput> train = [.. Ml.Data.CreateEnumerable<DeliveryInput>(random.TrainSet, false)];
Dictionary<string, float> avgAll = rows.GroupBy(o => o.CustomerId).ToDictionary(g => g.Key, g => g.Average(o => o.DeliveryDays));
Dictionary<string, float> avgTrain = train.GroupBy(o => o.CustomerId).ToDictionary(g => g.Key, g => g.Average(o => o.DeliveryDays));
foreach ((Dictionary<string, float> avg, string name) in new[] { (avgAll, "all rows (leak)"), (avgTrain, "train rows only") })
{
    IDataView tr = Ml.Data.LoadFromEnumerable(train.Select(o => With(o, avg.GetValueOrDefault(o.CustomerId, trainMean))));
    IDataView te = Ml.Data.LoadFromEnumerable(randomTest.Select(o => With(o, avg.GetValueOrDefault(o.CustomerId, trainMean))));
    ITransformer m = Pipeline([.. Basic, "CustomerAvgDays"]).Fit(tr);
    Console.WriteLine($"+ CustomerAvgDays from {name,-16} MAE {Mae(m, te):F3}");
}
+ CustomerAvgDays from all rows (leak) MAE 0.837
+ CustomerAvgDays from train rows only MAE 0.923Ortalama bütün satırlardan hesaplandığında hata 0,837'ye iniyor, bu feature olmadan 0,860'tı. Ortalama yalnız train satırlarından hesaplandığında ise hata 0,923'e çıkıyor, yani feature modeli kötüleştiriyor. Birinci durumda test siparişinin kendi teslim süresi, müşterisinin ortalamasının içine karışmış durumda. Siparişi az olan müşterilerde bu ortalama neredeyse label'ın kendisi. İkinci durum dürüst ölçüm. Bu veri setinde müşteri ortalaması gerçek bir sinyal taşımıyor ve fazladan noise ekliyor.
Aynı tuzak her türlü preprocessing için geçerli: normalization'ın min ve max değerleri, eksik değeri dolduran ortalama, bir kategorinin ortalama label'ı. Hepsi yalnız train verisinden öğrenilmeli ve test verisine yalnız uygulanmalı. ML.NET'te bunu sağlamanın yolu bu adımları pipeline'ın içine koymak; pipeline'ı train setiyle Fit ettiğinde bu değerler yalnız oradan öğrenilir. Beşinci yazıda bunun ayrıntısına gireceğiz.
Aynı Müşteri İki Tarafta: samplingKeyColumnName
Rastgele split satırları bağımsız kabul eder. Oysa aynı müşterinin siparişleri birbirine benzer: aynı adres, aynı ilçe, aynı alışkanlıklar. Bir müşterinin üç siparişi train'de, biri test'teyse model testte kısmen tanıdığı bir müşteriyi tahmin ediyor demektir. ML.NET'in TrainTestSplit method'u bunun için samplingKeyColumnName parametresini alıyor; aynı değere sahip satırlar hep aynı tarafa düşüyor:
// 5) Aynı müşteri split'in iki tarafında
DataOperationsCatalog.TrainTestData grouped = Ml.Data.TrainTestSplit(all, testFraction: 0.2, samplingKeyColumnName: "CustomerId", seed: 7);
Console.WriteLine($"customers in both train and test: random {Overlap(random):N0}, " +
                  $"samplingKeyColumnName {Overlap(grouped):N0}");
customers in both train and test: random 2,035, samplingKeyColumnName 0Rastgele split'te test setindeki müşterilerden 2.035'inin train'de de siparişi var. CustomerId ile gruplanmış split'te bu sayı sıfır. Hangisinin doğru olduğu sorduğun soruya bağlı. Model hep mevcut müşteriler için kullanılacaksa rastgele split gerçeğe daha yakındır. Yeni müşteriler için de güvenilir olmasını istiyorsan, ya da müşteriye özgü feature'lar kullanıyorsan, gruplanmış split daha dürüst bir sayı verir. Bu seride müşteri bazlı gruplanmış split'i kullanacağız.
Cross-Validation
Tek bir split, test setine hangi satırların düştüğüne bağlı bir sayı üretir. k-fold cross-validation veriyi k parçaya böler, her seferinde bir parçayı test, kalanını train olarak kullanır ve k ayrı skor üretir. ML.NET'te bu tek bir çağrı:
var folds = Ml.Regression.CrossValidate(all, Pipeline(Basic), numberOfFolds: 5, labelColumnName: "DeliveryDays",
    samplingKeyColumnName: "CustomerId", seed: 7);
double[] maes = [.. folds.Select(f => f.Metrics.MeanAbsoluteError)];
Console.WriteLine("5-fold MAE: " + string.Join("  ", maes.Select(m => m.ToString("F3", CultureInfo.InvariantCulture))));
Console.WriteLine($"mean {maes.Average():F3}, std {Std(maes):F3}");
// Küçük veri seti: tek bir split'in sonucu şansa bağlı
IDataView small = Ml.Data.TakeRows(Ml.Data.ShuffleRows(all, seed: 3), 400);
double[] single = [.. Enumerable.Range(1, 10).Select(seed =>
{
    var s = Ml.Data.TrainTestSplit(small, testFraction: 0.2, seed: seed);
    return Mae(Pipeline(Basic, minLeaf: 5).Fit(s.TrainSet), s.TestSet);
})];
Console.WriteLine($"400 rows, 10 different 80/20 splits: MAE min {single.Min():F3}, max {single.Max():F3}");
var smallCv = Ml.Regression.CrossValidate(small, Pipeline(Basic, minLeaf: 5), numberOfFolds: 5, labelColumnName: "DeliveryDays", seed: 7);
double[] cvMaes = [.. smallCv.Select(f => f.Metrics.MeanAbsoluteError)];
Console.WriteLine($"400 rows, 5-fold CV: mean {cvMaes.Average():F3}, std {Std(cvMaes):F3}");
dotnet run --project src/Bookstore.ML.Lab -- cv5-fold MAE: 0.860 0.903 0.861 0.803 0.822
mean 0.850, std 0.039
400 rows, 10 different 80/20 splits: MAE min 1.005, max 1.629
400 rows, 5-fold CV: mean 1.222, std 0.17423.105 satırda beş fold'un hatası 0,803 ile 0,903 arasında; ortalama 0,850, standart sapma 0,039. Tek bir split ile 0,803 de 0,903 de raporlanabilirdi. Küçük veride durum çok daha kötü. 400 satırlık bir alt kümede on farklı rastgele split 1,005 ile 1,629 arasında sonuç veriyor; aynı model, aynı veri, yalnız şans farklı. Cross-validation burada 1,222 ± 0,174 diyor. Bu sayı da kesin değil, ama en azından belirsizliğin ne kadar büyük olduğunu dürüstçe gösteriyor.
Cross-validation'ın bir maliyeti de var: modeli k kez eğitirsin. Bu veri setinde birkaç saniye sürüyor. Büyük bir veri setinde ve yavaş bir algoritmada saatler sürebilir. Ölçeği Big-O ve Complexity serisindeki gibi düşün: veri iki katına çıkarsa eğitim süresi de en az iki katına çıkar, k-fold bunu k ile çarpar.
Sık Düşülen Tuzaklar
İlk tuzak, test setine bakarak model seçip test skorunu raporlamak. Seçimi validation setinde ya da train üzerinde cross-validation ile yap; test setini en sonda bir kez aç.
İkincisi, küçük veride tek bir split'e güvenmek. 400 satırda 1,0 ile 1,6 arasında değişen bir metric'le "A modeli B'den iyi" diyemezsin. Fold'ların dağılımına bak.
Üçüncüsü, tahmin anında olmayan bir kolonu feature yapmak. Kolon adı masum görünebilir (TrackingEventCount, LastStatus, UpdatedAt); her feature için "bu değer sipariş anında ne olurdu?" diye sor.
Dördüncüsü, zaman içeren veride yalnız rastgele split kullanmak. Geleceği tahmin eden bir model için en az bir zaman bazlı değerlendirme yap ve hatayı zamana göre kır.
Beşincisi, preprocessing'i ve feature üretimini split'ten önce bütün veride yapmak. Müşteri ortalaması örneğinde gördüğün gibi bu, kötü bir feature'ı iyi gösterebilir.
Küçük Bir Deneme
★☆☆ Splits.Complexity method'unda ağaç sayısını 10'dan 100'e çıkar ve eğriyi yeniden çiz. Validation hatasının en düşük olduğu yaprak sayısı nereye kayıyor?
★★☆ Zaman bazlı split'i CrossValidate yerine elle kur: ilk 12 ayla eğit 13. ayda test et, sonra 13 ayla eğit 14. ayda test et ve böyle devam et. Her ayın hatasını yazdır ve Haziran 2026'dan sonra ne olduğuna bak.
★★★ İade tahmini için target leakage'ı kendin üret: IsReturned label'ı ile ve ReturnRequestedUtc'den türetilmiş bir feature ile basit bir binary classification modeli eğit, sonra bu feature'ı çıkarıp tekrar ölç. Classification metric'lerini henüz görmedik; şimdilik accuracy'nin ne kadar değiştiğine bak, yedinci yazıda bu sayıların neden yanıltıcı olduğunu konuşacağız.
Bir sonraki yazıda bu yazıda kutu olarak kullandığımız pipeline'ı açıyoruz: MLContext, input class'ı ve [LoadColumn], IDataView'ın lazy yapısı, estimator ile transformer farkı, ilk SDCA (Stochastic Dual Coordinate Ascent; linear modeller için bir optimizasyon yöntemi) modeli, tek tahmin için PredictionEngine ve modeli dosyaya kaydedip geri yüklemek.