

Parser ve AST: Recursive Descent, Operator Precedence ve Pratt Parsing
Parser, token dizisini precedence ve associativity kurallarına göre tek bir AST'ye çevirir; Pratt parsing bu kuralları method zinciri yerine bir binding power tablosunda tutar. Bookstore filtre dili için grammar'dan recursive descent parser'ı türetiyor, aynı dili Pratt parser ile yazıp iki parser'ın aynı ağacı ürettiğini test ediyor, panic mode ile birden çok hata raporluyor ve AST'yi tree-walking interpreter ile çalıştırıyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (SDK 10.0.404) ve C# 14 ile derlenip xUnit v3 4.0.3 testleriyle doğrulanmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için yazdığımız filtre dilinde lexer hazır; şimdi token'ları bir ağaca dizeceğiz. İki soru. Birincisi: stock = 0 or price < 300 and year < 1900 filtresinin ağacının kökünde hangi operatör durur, or mu and mi? Kökteki operatör, filtrenin hangi kitapları döndüreceğini belirler.
İkincisi: Birisi arama kutusuna 100.000 açma parantezi, price < 300 ve 100.000 kapama parantezi yapıştırıyor. Grammar'dan birebir türetilmiş bir parser bu girdiye ne yapar: yavaşlar mı, hata mı verir, yoksa process'i mi düşürür?
Grammar, Ambiguity, Precedence ve Associativity
01. yazıda dilin grammar'ını EBNF (Extended Backus-Naur Form; bir dilin söz dizimini kurallarla yazma notasyonu) ile yazmıştık. Grammar'ı daha kısa da yazabilirdik:
expr = expr , op , expr | field | literal | "(" , expr , ")" ;
op   = "or" | "and" | "=" | "<" | "contains" ;
Bu grammar doğru cümleleri kabul ediyor ama ambiguous: a or b and c için iki ayrı ağaç kurulabiliyor, (a or b) and c ve a or (b and c). İkisi de grammar'a uyuyor, ama farklı kitapları döndürüyor. Bir parser'ın tek bir ağaç üretmesi için iki bilgiye ihtiyacı var. Precedence, farklı operatörlerden hangisinin daha sıkı bağlandığını söyler: and, or'dan sıkı. Associativity, aynı operatör art arda gelince gruplamanın hangi yönden yapılacağını söyler: a and b and c, (a and b) and c olarak okunur, yani and left-associative.
01'deki grammar bu iki bilgiyi kuralların yapısına gömüyor: or_expr kuralı and_expr'lerden oluşuyor, and_expr ise not_expr'lerden. Bir kural ne kadar aşağıdaysa operatörü o kadar sıkı bağlanıyor. { "and" , not_expr } biçimindeki tekrar da left-associativity'yi veriyor. Karşılaştırmada tekrar yok: comparison = primary , [ comp_op , primary ]. Bu bilinçli bir seçim; price < 300 < 400 gibi bir zinciri dil kabul etmiyor. Böylece ilk tahminin cevabı da çıkıyor: kökte or var, filtre "stoğu biten kitaplar ya da 1900'den önceki ucuz kitaplar" demek.
AST'yi C# Record'larıyla Kurmak
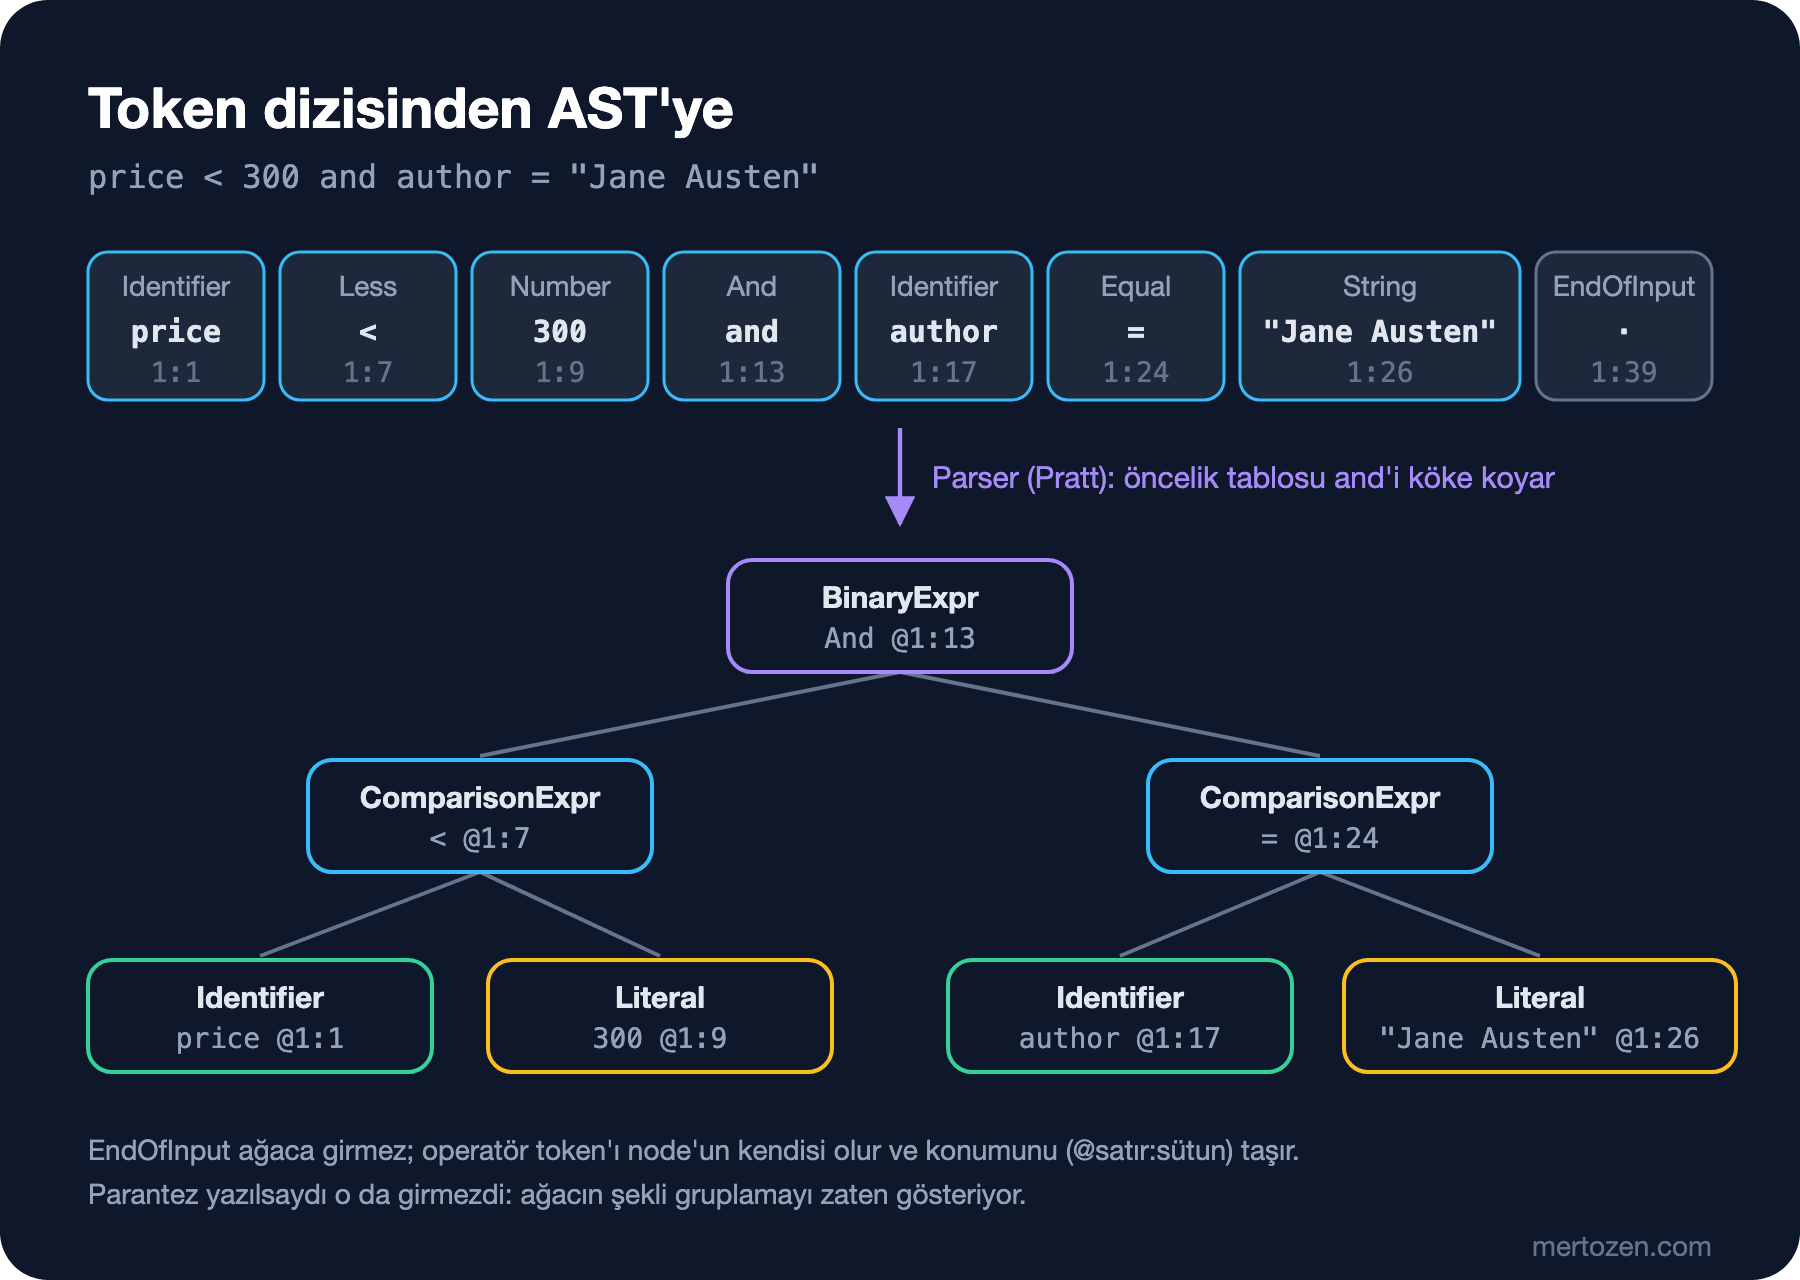
Parser'ın üreteceği ağacı önce tasarlayalım. Grammar'ı birebir yansıtan bir ağaç (parse tree) her kural için bir node taşır. price < 300 bile or_expr → and_expr → not_expr → comparison → primary zincirinden geçer; parantezler ve EndOfInput da ağaçta yer alır. Sonraki aşamaların bunların hiçbirine ihtiyacı yok. AST (abstract syntax tree; kodun anlamını taşıyan, söz diziminin ayrıntılarını atmış ağaç) yalnız anlamı tutar: bir karşılaştırma, iki kenarı ve operatörü.
namespace Bookstore.Filter.Syntax;

public enum ComparisonOperator { Equal, NotEqual, Less, LessOrEqual, Greater, GreaterOrEqual, Contains }

public enum LogicalOperator { And, Or }

// Position, node'u en iyi anlatan token'ı gösterir: binary node'larda operatörü.
public abstract record Expr(SourcePosition Position);

public sealed record Identifier(string Name, SourcePosition Position) : Expr(Position);

// Value: decimal, string ya da bool
public sealed record Literal(object Value, SourcePosition Position) : Expr(Position);

public sealed record ComparisonExpr(Expr Left, ComparisonOperator Operator, Expr Right, SourcePosition Position)
    : Expr(Position);

public sealed record BinaryExpr(Expr Left, LogicalOperator Operator, Expr Right, SourcePosition Position)
    : Expr(Position);

public sealed record NotExpr(Expr Operand, SourcePosition Position) : Expr(Position);

// parse edilemeyen bir parçanın yerini tutar; hata zaten raporlandı
public sealed record ErrorExpr(SourcePosition Position) : Expr(Position);

public sealed record ParseResult(Expr Root, IReadOnlyList<Diagnostic> Diagnostics)
{
    public bool Success => Diagnostics.Count == 0;
}
Record seçiminin üç faydası var. Node'lar immutable; bir aşama ağacı değiştiremiyor, yeni bir ağaç üretiyor. Eşitlik değer üzerinden çalışıyor; iki parser'ın aynı ağacı ürettiğini tek bir Assert.Equal ile test edebiliyoruz. Ve hiyerarşi kapalı olduğu için ağacı gezen kod switch pattern matching ile yazılıyor; visitor pattern'i için ayrı class'lara gerek kalmıyor. ErrorExpr ise hata kurtarmanın parçası: parser bozuk bir yerde durmuyor, oraya bir yer tutucu koyup devam ediyor.
Grammar'dan Recursive Descent Parser'a
Recursive descent, grammar'ın her kuralını bir method'a çevirmek demek. Kuralda başka bir kural geçiyorsa method onu çağırıyor; { ... } tekrarı bir while, [ ... ] seçeneği bir if oluyor. Grammar ile kod arasındaki eşleşme o kadar doğrudan ki method'ların üstüne kuralı yorum olarak yazdık:
// or_expr = and_expr , { "or" , and_expr } ;
private Expr ParseOr()
{
    Expr left = ParseAnd();
    while (Current.Kind == TokenKind.Or)
    {
        Token op = Advance();
        left = new BinaryExpr(left, LogicalOperator.Or, ParseAnd(), op.Position);
    }
    return left;
}

// not_expr = "not" , not_expr | comparison ;
private Expr ParseNot()
{
    if (Current.Kind != TokenKind.Not)
        return ParseComparison();
    Token not = Advance();
    return new NotExpr(ParseNot(), not.Position);
}

// comparison = primary , [ comp_op , primary ] ;
private Expr ParseComparison()
{
    Expr left = ParsePrimary();
    if (Operators.Comparison(Current.Kind) is not ComparisonOperator op)
        return left;
    Token opToken = Advance();
    return new ComparisonExpr(left, op, ParsePrimary(), opToken.Position);
}ParseOr'daki döngü left-associativity'nin kodu: her yeni or, şimdiye kadar kurulan ağacı sol çocuk yapıyor. ParseAnd aynı şekilde ParseNot'u çağırıyor (yerden tasarruf için göstermedik), ParsePrimary de alan, literal ya da parantezli ifade okuyor. Parantezin içinde yeniden ParseOr'a dönülüyor; recursive descent'teki "recursive" buradan geliyor.
Grammar'ı kodlamadan önce bir şeye dikkat etmek gerekiyor. Left-associativity'yi kuralın kendisiyle ifade etmek akla yatkın gelir: or_expr = or_expr , "or" , and_expr | and_expr. Bu kural left-recursive: kuralın ilk elemanı kendisi. Kodu birebir yazarsan ParseOr'un ilk satırı yine ParseOr() olur ve tek bir token tüketmeden kendini çağırmaya devam eder. Bunu küçük bir denemeyle çalıştırdığımızda process, Stack overflow. ve Repeated 40192 times: at LeftRec.ParseOr() yazıp kapandı. Çözüm, left recursion'ı tekrara çevirmek; EBNF'teki { ... } tam olarak bunu yapıyor.
Pratt Parsing: Önceliği Tabloya Taşımak
Recursive descent'te öncelik, method'ların birbirini çağırma sırasında saklı. Yeni bir öncelik seviyesi eklemek (örneğin xor) yeni bir method ve iki method'un çağrısını değiştirmek demek; on seviyeli bir dilde bir karşılaştırmayı parse etmek için on method'dan geçiliyor. Vaughan Pratt'in 1973'te yayımladığı "Top Down Operator Precedence" fikri önceliği bir tabloya taşıyor. Her infix operatörün bir sol, bir sağ binding power'ı var; parser tek bir döngüde, kendisine verilen minimum değerden güçlü bağlanan operatörleri topluyor:
// (sol, sağ) binding power; sol < sağ ise left-associative
private static (int Left, int Right)? BindingPower(TokenKind kind) => kind switch
{
    TokenKind.Or => (10, 11),
    TokenKind.And => (20, 21),
    TokenKind.Equal or TokenKind.NotEqual or TokenKind.Less or TokenKind.LessOrEqual
        or TokenKind.Greater or TokenKind.GreaterOrEqual or TokenKind.Contains => (40, 41),
    _ => null,
};

private Expr ParseExpression(int minBindingPower)
{
    if (++_depth > MaxDepth)
    {
        Error(Current.Position, $"filter is nested too deeply (limit {MaxDepth})");
        // EndOfInput'a atla ve sessiz kal: eksik ')' hataları bu hatayı tekrar etmekten öteye geçmez
        _tooDeep = true;
        _pos = _tokens.Count - 1;
        _depth--;
        return new ErrorExpr(Current.Position);
    }

    Expr left = ParsePrefix();
    while (BindingPower(Current.Kind) is (int leftPower, int rightPower) && leftPower >= minBindingPower)
    {
        Token op = Advance();
        Expr right = ParseExpression(rightPower);
        left = MakeInfix(left, op, right);
    }

    _depth--;
    return left;
}

private Expr MakeInfix(Expr left, Token op, Expr right)
{
    if (op.Kind == TokenKind.And)
        return new BinaryExpr(left, LogicalOperator.And, right, op.Position);
    if (op.Kind == TokenKind.Or)
        return new BinaryExpr(left, LogicalOperator.Or, right, op.Position);

    if (left is ComparisonExpr)
        Error(op.Position, "comparisons cannot be chained; combine them with 'and'");
    return new ComparisonExpr(left, Operators.Comparison(op.Kind)!.Value, right, op.Position);
}
Algoritmayı stock = 0 or price < 300 and year < 1900 üzerinde izleyelim. ParseExpression(0), stock = 0'ı kuruyor ve or'u görüyor: sol gücü 10, minimum 0'dan büyük, devam. Sağ tarafı ParseExpression(11) ile okuyor. Bu çağrı price < 300'ü kuruyor, sonra and'i görüyor: sol gücü 20, 11'den büyük, yani and bu çağrının içinde kalıyor ve year < 1900'ü de alıyor. Sonuç stock = 0 or (price < 300 and year < 1900). Left-associativity için sağ gücün soldan bir fazla olması yetiyor: a and b and c'de ikinci and'in sol gücü 20, iç çağrının minimumu 21; iç çağrı onu almıyor, dıştaki döngü alıyor ve (a and b) and c çıkıyor. Sağdan associative bir operatör eklemek istersen (üs alma gibi) sağ gücü soldan düşük yazman yeterli.
Prefix taraf ParsePrefix'te: alan, literal, parantez ve not. not, operand'ını 30 gücüyle okuyor; karşılaştırma (40) içeride kalıyor, and (20) dışarıda. not stock = 0 and price < 300 böylece (not (stock = 0)) and price < 300 oluyor; 01'deki grammar da bunu söylüyordu.
İki parser'ın gerçekten aynı dili tanıdığını bir testle sabitliyoruz. Record'ların değer eşitliği sayesinde test tek satır:
[Theory]
[InlineData("price < 300 and author = \"Jane Austen\"")]
[InlineData("stock = 0 or price < 300 and year < 1900")]
[InlineData("not not (title contains \"Dune\" or price >= 100.50) and stock != 0")]
[InlineData("true")]
public void Parse_PrattAndRecursiveDescent_ProduceTheSameAst(string text)
{
    Assert.Equal(RecursiveDescentParser.Parse(text), ParseOk(text));
}
$ dotnet run --project src/Bookstore.Filter.Cli -- ast 'price < 300 and author = "Jane Austen"'
BinaryExpr And @1:13
├─ ComparisonExpr < @1:7
│ ├─ Identifier price @1:1
│ └─ Literal 300 @1:9
└─ ComparisonExpr = @1:24
├─ Identifier author @1:17
└─ Literal "Jane Austen" @1:26Hata Kurtarma: Panic Mode ve Birden Çok Hata
Recursive descent parser'ımız ilk hatada exception fırlatıyor. Bir filtre kutusu için bu yeterli gibi görünür ama kullanıcı üç hatası olan bir filtreyi üç kez göndermek zorunda kalır. Pratt parser'ı bunun yerine panic mode kullanıyor: beklenmeyen bir token görünce hatayı kaydediyor, filtreyi devam ettirebilecek bir token'a (and, or, ) ya da girdinin sonu) kadar atlıyor ve o noktaya bir ErrorExpr koyup devam ediyor:
default:
    string found = token.Kind == TokenKind.EndOfInput ? "end of input" : $"'{token.Text}'";
    Error(token.Position, $"expected a field, a value or '(' but found {found}");
    Synchronize();
    return new ErrorExpr(token.Position);
// panic mode: filtreyi devam ettirebilecek bir token'a kadar atla
private void Synchronize()
{
while (Current.Kind is not (TokenKind.EndOfInput or TokenKind.And or TokenKind.Or or TokenKind.CloseParen))
Advance();
}$ dotnet run --project src/Bookstore.Filter.Cli -- ast 'price < and stock > or (title = "Dune"'
BinaryExpr Or @1:21
├─ BinaryExpr And @1:9
│ ├─ ComparisonExpr < @1:7
│ │ ├─ Identifier price @1:1
│ │ └─ ErrorExpr @1:9
│ └─ ComparisonExpr > @1:19
│ ├─ Identifier stock @1:13
│ └─ ErrorExpr @1:21
└─ ComparisonExpr = @1:31
├─ Identifier title @1:25
└─ Literal "Dune" @1:33
price < and stock > or (title = "Dune"
^ error at 1:9: expected a field, a value or '(' but found 'and'
price < and stock > or (title = "Dune"
^ error at 1:21: expected a field, a value or '(' but found 'or'
price < and stock > or (title = "Dune"
^ error at 1:39: expected ')' to close '(' at 1:24Tek geçişte üç hata ve her biri doğru sütunda. Ağaç bozuk yerlere rağmen tam; bir editör bu ağaç üzerinden hâlâ renklendirme ya da otomatik tamamlama yapabilir. Kapanmayan parantez hatasının açılış konumunu da söylemesi küçük ama işe yarayan bir ayrıntı. Uzun bir filtrede eksik parantezin hangi açılışa ait olduğunu bulmak kullanıcıya düşmüyor. Lexer'ın ürettiği Bad token'lar için ikinci bir hata yazmıyoruz; ParsePrefix onları sessizce ErrorExpr'e çeviriyor, çünkü kullanıcı aynı karakter için iki mesaj görmemeli.
Tree-Walking Interpreter
Ağaç hazır; onu çalıştırmanın en kısa yolu, her kitap için ağacı gezip değeri hesaplamak. Buna tree-walking interpreter deniyor ve C#'ın pattern matching'i ile tek bir switch expression'a sığıyor:
public sealed class FilterRuntimeException(string message) : Exception(message);

// Tree-walking interpreter: AST'yi her kitap için doğrudan değerlendirir. Değerler çalışma anında kontrol edilir.
public static class Interpreter
{
    public static IEnumerable<Book> Filter(IEnumerable<Book> books, Expr filter) =>
        books.Where(book => AsBool(Evaluate(filter, book), filter));

    public static object Evaluate(Expr expr, Book book) => expr switch
    {
        Literal literal => literal.Value,
        Identifier id => ReadField(id, book),
        NotExpr not => !AsBool(Evaluate(not.Operand, book), not),
        // && ve || filtre dilinde de kısa devre davranışını korur
        BinaryExpr { Operator: LogicalOperator.And } and =>
            AsBool(Evaluate(and.Left, book), and.Left) && AsBool(Evaluate(and.Right, book), and.Right),
        BinaryExpr or =>
            AsBool(Evaluate(or.Left, book), or.Left) || AsBool(Evaluate(or.Right, book), or.Right),
        ComparisonExpr comparison => Compare(comparison, Evaluate(comparison.Left, book), Evaluate(comparison.Right, book)),
        _ => throw new FilterRuntimeException($"cannot evaluate a filter that has syntax errors (at {expr.Position})"),
    };

    private static object ReadField(Identifier id, Book book) => id.Name.ToLowerInvariant() switch
    {
        "isbn" => book.Isbn,
        "title" => book.Title,
        "author" => book.Author,
        "price" => book.Price,
        "year" => (decimal)book.Year,
        "stock" => (decimal)book.Stock,
        _ => throw new FilterRuntimeException($"unknown field '{id.Name}' at {id.Position}"),
    };

    private static bool Compare(ComparisonExpr c, object left, object right) => (left, c.Operator, right) switch
    {
        (decimal l, ComparisonOperator.Equal, decimal r) => l == r,
        (decimal l, ComparisonOperator.NotEqual, decimal r) => l != r,
        (decimal l, ComparisonOperator.Less, decimal r) => l < r,
        (decimal l, ComparisonOperator.LessOrEqual, decimal r) => l <= r,
        (decimal l, ComparisonOperator.Greater, decimal r) => l > r,
        (decimal l, ComparisonOperator.GreaterOrEqual, decimal r) => l >= r,
        (string l, ComparisonOperator.Equal, string r) => string.Equals(l, r, StringComparison.Ordinal),
        (string l, ComparisonOperator.NotEqual, string r) => !string.Equals(l, r, StringComparison.Ordinal),
        (string l, ComparisonOperator.Contains, string r) => l.Contains(r, StringComparison.Ordinal),
        (bool l, ComparisonOperator.Equal, bool r) => l == r,
        (bool l, ComparisonOperator.NotEqual, bool r) => l != r,
        _ => throw new FilterRuntimeException(
            $"operator '{Operators.Symbol(c.Operator)}' at {c.Position} cannot compare {TypeName(left)} with {TypeName(right)}"),
    };
}
$ dotnet run --project src/Bookstore.Filter.Cli -- run 'price < 300 and author = "Jane Austen"'
Emma Jane Austen 199.00 TRY stock 7
Persuasion Jane Austen 185.00 TRY stock 3
Sense and Sensibility Jane Austen 210.00 TRY stock 5Book, Bookstore.Catalog namespace'inde altı alanlı bir record; örnek veri Dune, The Hobbit, Middlemarch ve üç Jane Austen romanından oluşuyor. Interpreter'ın tip anlayışı dinamik: her değer bir object, tipler karşılaştırma anında kontrol ediliyor. Bunun sonucunu görelim:
$ dotnet run --project src/Bookstore.Filter.Cli -- run 'stock > 0 or price = "abc"'
Dune                   Frank Herbert     349.90 TRY  stock 12
runtime error: operator '=' at 1:20 cannot compare number with string
Filtre açıkça hatalı, ama interpreter önce Dune'u döndürdü. or kısa devre yaptığı için stoğu olan kitaplarda sağ taraf hiç değerlendirilmedi; hata ancak stoğu sıfır olan ilk kitapta, The Hobbit'te ortaya çıktı. Katalog boş olsaydı ya da bütün kitapların stoğu olsaydı hata hiç görünmeyecekti; testlerden biri tam olarak bunu doğruluyor. Bu, dinamik tip kontrolünün tipik davranışı ve bir sonraki yazının konusu: tip hatasını filtre hiçbir kitaba dokunmadan, compile aşamasında yakalamak.
Üretimde Dikkat
İkinci tahminin cevabı. Grammar'dan birebir türetilen recursive descent parser'ın derinlik sınırı yok ve her parantez seviyesi call stack'te beş method çağrısı demek:
$ dotnet run --project src/Bookstore.Filter.Cli -- nest 100000 rd
Stack overflow.
Repeated 6294 times:
--------------------------------
   at Bookstore.Filter.Syntax.RecursiveDescentParser.ParseNot()
   at Bookstore.Filter.Syntax.RecursiveDescentParser.ParseAnd()
   at Bookstore.Filter.Syntax.RecursiveDescentParser.ParseOr()
   at Bookstore.Filter.Syntax.RecursiveDescentParser.ParsePrimary()
   at Bookstore.Filter.Syntax.RecursiveDescentParser.ParseComparison()
--------------------------------

$ dotnet run --project src/Bookstore.Filter.Cli -- nest 100000 pratt
pratt: 1 diagnostic(s)
error at 1:65: filter is nested too deeply (limit 64)
.NET'te StackOverflowException yakalanamıyor; runtime process'i sonlandırıyor. Yani bir arama kutusundan gelen tek bir istek bütün API'yi kapatabiliyor. Taşmanın kaçıncı seviyede olacağı thread'in stack boyutuna bağlı: Windows'ta main thread için varsayılan 1 MB, Linux'ta genelde daha büyük; Debug build'de frame'ler de daha büyük. "Bizim makinede 6.000 seviyeye kadar çalıştı" bir güvence değil. Pratt parser'ı derinliği sayıyor, 64'ü aşınca tek bir hata yazıp girdinin sonuna atlıyor. 64, insanın yazacağı her filtre için fazlasıyla yeterli.
Derinlik sınırı tek başına yetmiyor. a and b and c ... gibi düz bir zincir parser'ı derinleştirmiyor (Pratt döngüsü onu tek seviyede topluyor), ama ortaya çıkan AST sola doğru derinleşiyor ve ağacı recursive gezen interpreter için aynı risk geri geliyor. Bunun için girdi uzunluğuna da bir sınır koyacağız; ölçümü ve sınırı 04. yazıda göreceğiz.
Interpreter her kitap için ağacı baştan geziyor, her alan okuması bir string switch'i ve her sayı bir boxing. 10 kitapta fark etmez; 100.000 satırlık bir listede ya da saniyede binlerce istekte fark eder. Ağacı bir kez çalıştırılabilir koda çevirmek bu maliyeti kaldırıyor; bunu da bir sonraki yazıda Expression Tree'ye derleyerek yapacağız.
Sık Düşülen Tuzaklar
Left recursion'ı olduğu gibi koda çevirmek. A = A , "x" | "y" biçimindeki kural recursive descent'te tek token tüketmeden sonsuz recursion'a girer. Tekrar ({ }) ile yaz ya da Pratt döngüsünü kullan.
Derinliği sınırsız bırakmak. Kullanıcı girdisini parse eden her recursive kod (JSON, XML, kendi dilin) için bir derinlik sınırı koy. System.Text.Json'ın varsayılan MaxDepth değeri 64; bizim sınırımız da aynı.
Precedence'ı test etmemek. and ile or'un yer değiştirmesi hata vermez, sessizce yanlış kitapları döndürür. Kökteki operatörü ve associativity'yi doğrulayan testler yaz; elinde ikinci bir implementation varsa (burada recursive descent) ikisini aynı girdilerle karşılaştır.
Parser generator'a erken geçmek ya da hiç geçmemek. ANTLR (ANother Tool for Language Recognition; grammar dosyasından parser kodu üreten araç) gibi araçlar SQL ya da tam bir programlama dili gibi büyük grammar'larda, grammar sık değişiyorsa ve birden çok hedef dil gerekiyorsa işe yarar. Bizim gibi küçük dillerde elle yazılmış parser daha kısa ve hata mesajları üzerinde tam kontrol veriyor. Roslyn ve TypeScript'in parser'ları da elle yazılmış recursive descent parser'lar.
Küçük Bir Deneme
★☆☆ Dile xor operatörünü and ile or arasında bir öncelikle ekle. Pratt parser'da kaç satır değişti, recursive descent parser'da kaç method? Precedence'ı doğrulayan bir test yaz.
★★☆ price between 100 and 300 sözdizimini ekle. and keyword'ünün iki anlamı (mantıksal ve between'in parçası) parser'da nasıl ayrışıyor? price between 100 and 300 and stock > 0 için AST'yi yazdır.
★★★ Interpreter.Evaluate'i recursion kullanmadan, açık bir Stack<T> ile yeniden yaz ve 200.000 koşullu bir and zincirinde iki sürümü karşılaştır. Kısa devre davranışını korumak için stack'te neyi tutman gerekiyor?
Ağaç artık var ama price = "abc" gibi bir hatayı ancak çalışırken, o da şansımız varsa görüyoruz. Bir sonraki yazıda semantic analysis'e geçiyoruz: symbol table ile alanları Book'un property'lerine bağlayacak, tipleri kontrol edecek, ardından doğrulanmış ağacı Expression<Func<Book, bool>>'a derleyip hem bellekte çalıştıracak hem de Entity Framework Core'un (EF Core; .NET'in veritabanı erişim kütüphanesi) onu SQL'e çevirdiğini göreceğiz.