

Trace Backend'i ile Yavaş İsteği Bulmak: Jaeger v2, Grafana Tempo ve Checkout'taki N+1 Sorgusu

Yavaş isteği trace backend'inde bulmak, doğru soruyu sormaya bağlı: Jaeger v2 index'li tag aramasıyla, Tempo ise TraceQL ile span'lar arası koşullarla arıyor. Bookstore'un 7,6 saniyelik checkout'unu waterfall'da açıp retry fırtınasını ve N+1 sorgusunu buluyor, iki düzeltmeyi ve hedging'i ölçüyor, tail sampling'li trace'lerden yüzdelik hesaplamanın neden yanılttığını gösteriyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10, OpenTelemetry .NET 1.21, Microsoft.Extensions.Http.Resilience 10.11, Jaeger 2.23.0 ve grafana/otel-lgtm 0.41.0 image'ı (Tempo 3.1.1, Prometheus 3.16.0, Grafana 13.3.0) ile denenmiştir.
Önce Tahmin Et
Bookstore'a (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) 1.200 sipariş gönderdik. Trafik aracı checkout için medyanı 108 ms, p95'i 5,08 saniye ölçtü. Aynı dakikalar için Tempo'ya TraceQL ile sorduk: { span.http.route = "/api/orders/" } | quantile_over_time(duration, .5, .95). Cevap medyan 1,40 saniye, p95 7,51 saniye. Kaç checkout olduğunu sorduğumuzda da 1.200 değil 374 dedi. Tempo mu yanlış ölçüyor, trafik aracı mı? Cevap, trace'lerin Tempo'ya nasıl geldiğinde; Tuzaklar bölümünde.
Jaeger v2 ve Tempo: İki Farklı Mimari
İki açık kaynak trace backend'i aynı işi farklı varsayımlarla yapıyor. Jaeger v2, OpenTelemetry Collector'ın özelleştirilmiş bir dağıtımı: tek bir binary, config'e göre collector, query, ingester ya da hepsi bir arada (all-in-one) rolünde çalışıyor ve OTLP'yi (OpenTelemetry Protocol; telemetry taşıma protokolü) doğrudan alıyor. Trace'leri Cassandra, Elasticsearch, OpenSearch ya da Badger gibi bir storage'a yazıyor; servis, operation, tag ve süreye göre index tutuyor. Arama hızlı, ama index'in bir maliyeti var: her span için index yazılıyor ve storage o yükü taşıyacak şekilde işletilmeli.
Tempo ise index tutmuyor. Span'ları bloklar hâlinde (Parquet formatında) object storage'a yazıyor: S3 (AWS'nin object storage servisi), Azure Blob Storage, GCS (Google Cloud Storage; Google'ın karşılığı) ya da yerelde disk. Trace id ile getirmek ucuz; arama ise TraceQL ile blokların taranmasıyla yapılıyor. Storage ucuz olduğu için her şeyi uzun süre saklamak mümkün, karşılığında geniş zaman aralığında yapılan aramalar Jaeger'in index'li aramasından yavaş olabilir. Tempo 3.0 mimarisini de değiştirdi: ingester'lar tamamen kaldırıldı. Microservices modunda yazma yolu Kafka uyumlu bir sistemden geçiyor, blokları block-builder'lar üretiyor, yeni veriyi live-store'lar sorguluyor. Monolithic modda ise hepsi tek process'te, Kafka olmadan çalışıyor; otel-lgtm'in içindeki Tempo bu mod.
Seçim için pratik sorular şunlar. Ekip zaten Grafana kullanıyorsa ve trace'leri metric ve log'la aynı ekranda görmek istiyorsa Tempo doğal seçim. Elasticsearch ya da Cassandra işleten bir ekip için Jaeger mevcut altyapıyı kullanır. Saklama süresi ve hacim büyükse object storage'ın maliyeti belirleyici olur. İkisi de OTLP aldığı için uygulama tarafında değişen bir şey yok; değişen yalnızca Collector'daki exporter.
Jaeger v2 ile Arama
Jaeger'i resmi dokümandaki all-in-one image'ıyla başlattık; varsayılan config bellekte saklıyor, yani yeniden başlatınca veri gidiyor:
docker run -d --name bookstore-jaeger -p 16686:16686 -p 4317:4317 -p 4318:4318 cr.jaegertracing.io/jaegertracing/jaeger:2.23.0
# log: No '--config' flags detected, using default All-in-One configuration with memory storage.
Uygulama bu kez Collector'a değil, doğrudan Jaeger'e gönderdi (OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4317) ve 200 sipariş verdik; trafik aracı 7 saniyeden uzun 6 sipariş saydı. Jaeger'in arayüzü 16686 portunda. Aynı aramayı Jaeger'in v3 HTTP API'siyle yaptık:
curl -s -G http://localhost:16686/api/v3/traces \
  --data-urlencode 'query.service_name=bookstore-api' \
  --data-urlencode 'query.operation_name=POST /api/orders/' \
  --data-urlencode 'query.duration_min=7s' \
  --data-urlencode 'query.start_time_min=2026-11-14T19:00:00Z' \
  --data-urlencode 'query.start_time_max=2026-11-14T21:00:00Z' \
  --data-urlencode 'query.search_depth=20' \
  | jq -c '[.result.resourceSpans[].scopeSpans[].spans[] | select(.name=="POST /api/orders/") | {traceId, ms: (((.endTimeUnixNano|tonumber) - (.startTimeUnixNano|tonumber))/1e6|floor)}]'

[{"traceId":"b4743bd8e07fbdd45e4ffe2ffc6a27e5","ms":7595},{"traceId":"389b645409874ff9f129aadd80c37243","ms":7598},{"traceId":"aa12a897578191c6173d1be97f34ba4a","ms":7642},{"traceId":"06585bdacce910ec94229ecfdf8bc769","ms":9540},{"traceId":"95bb98fbb30cfdb7063792949da95575","ms":7610},{"traceId":"8b67c35430d157bac48d45806376282d","ms":7638}]
Altı trace'in altısı da orada, çünkü bu kurulumda sampling yok. query.attributes parametresiyle span attribute'una göre de aranabiliyor; {"bookstore.cart.line_count":"12"} 20 kurumsal siparişin 20'sini getirdi. Jaeger'in arama modeli bu: servis, operation, süre ve tag filtreleri. "12 satırlı sepetlerden 5 saniyeyi geçenler" gibi farklı span'lardaki koşulları birleştiren bir soruyu sormak zor. TraceQL tam bu tür sorular için var.
Tempo ve TraceQL
Jaeger'i kaldırıp otel-lgtm'e döndük; burada trace'ler Collector'daki tail sampling'den geçerek Tempo'ya gidiyor. TraceQL'de { } bir spanset, yani koşulu sağlayan span'lar. İçinde span. ile span attribute'u, resource. ile resource attribute'u, name, duration, status, kind gibi alanlarla da span'ın kendi özellikleri seçiliyor. 1.200 siparişlik koşu üzerinde çalıştırdığımız sorgular ve dönen trace sayıları:
{ span.http.route = "/api/orders/" }                                                          374
{ span.http.route = "/api/orders/" && duration > 5s }                                         71
{ span.bookstore.cart.line_count = 12 && duration > 5s }                                     0
{ span.bookstore.cart.line_count = 12 && traceDuration > 5s }                                3
{ name = "authorize payment" } > { kind = client && status = error } | count() >= 3            15
{ name = "check availability" } > { span.db.system.name = "microsoft.sql_server" } | count() > 10   35
Üçüncü satırdaki 0 öğretici. Bir spanset içindeki && aynı span için geçerli: sepet satır sayısını taşıyan span "check availability" ve o span hiçbir zaman 5 saniye sürmüyor. Trace'in toplam süresini istiyorsan traceDuration kullan. Son iki satır yapısal sorgu: > "doğrudan child'ı", >> "herhangi bir torunu" demek. Beşinci sorgu, ödeme span'ının altında en az üç başarısız HTTP denemesi olan 15 trace'i; altıncısı, stok kontrolünün altında 10'dan fazla SQL sorgusu olan 35 trace'i buldu. İkisi de vakanın iki sebebi.
Waterfall'u Okumak
Dördüncü sorgunun bulduğu 7,64 saniyelik kurumsal siparişin trace'ini Tempo'nun API'sinden alıp span ağacını yazdırdık (başlangıç ve süre milisaniye; tekrar eden satırları kısalttık):
trace deea369ce9b1bcdfc8a8efca90e25b4a 41 spans
      0.0    7639.5  POST /api/orders/
      0.2       0.7    SELECT [c].[Id] [c].[CreatedAtUtc] [c].[UpdatedAtUtc] [ordering].[Carts] [ordering].[CartItems]
      1.0       0.4    SELECT [catalog].[Books]
      1.5       6.5    check availability
      1.5       0.4      SELECT [inventory].[StockItems]
      1.9       0.4      SELECT [inventory].[StockItems]
      ...                (12 SELECTs, 0.3–0.8 ms each)
      7.7       0.3      SELECT [inventory].[StockItems]
      8.4       4.5    reserve stock
      8.4       0.4      UPDATE
      ...                (12 UPDATEs)
     21.6    7617.8    authorize payment
     21.7    1999.9      POST ERROR
   2521.8    2000.3      POST ERROR
   5024.3    2000.7      POST ERROR
   7526.6     107.3      POST
   7634.1       5.3      UPDATE
   7639.4       0.0      order-confirmations publish
   7639.5      47.1        order-confirmations process
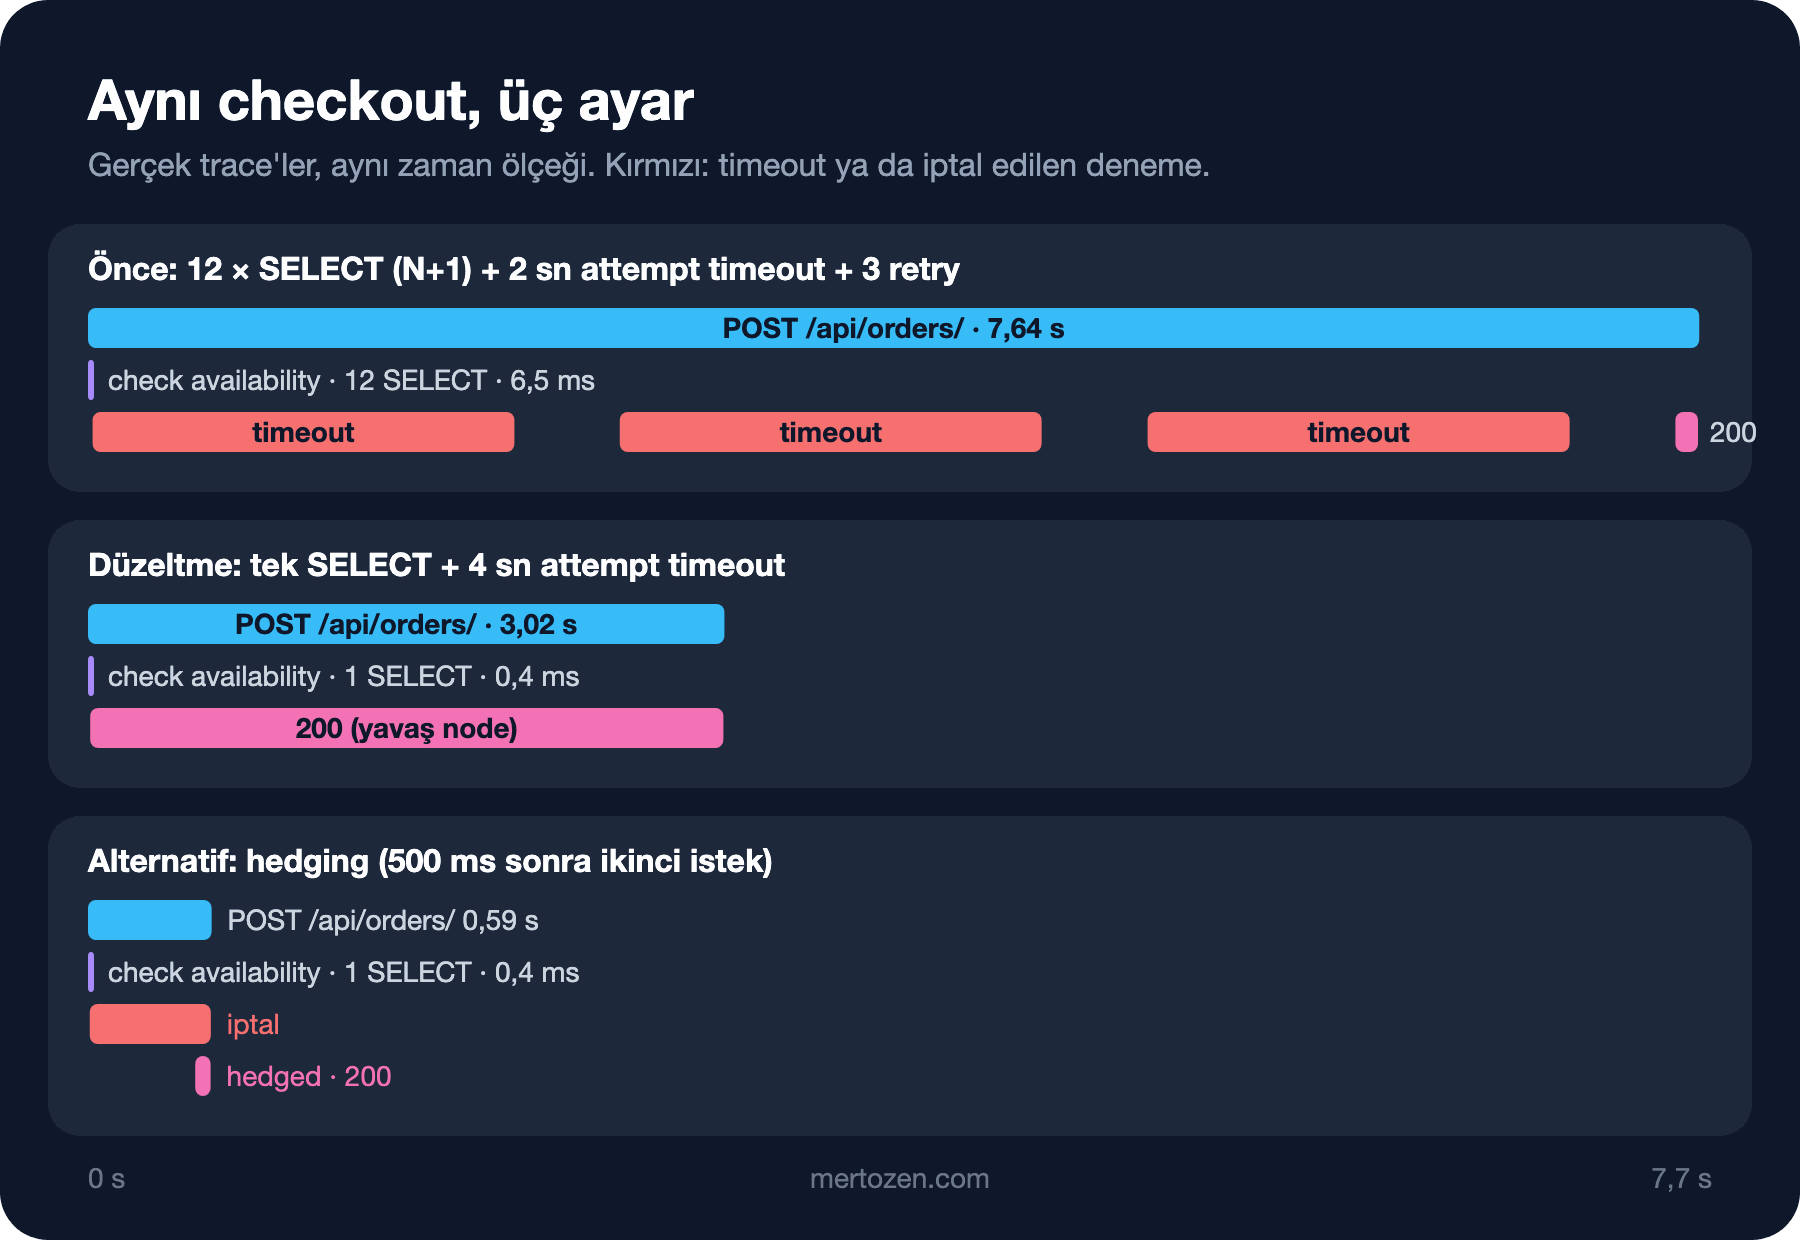
Trace iki şeyi açıkça gösteriyor. Birincisi süre: 7,64 saniyenin 7,62'si ödeme span'ında. Üç deneme tam 2.000 ms'de kesilmiş (hata tipi TaskCanceledException), aralarında 500 ms bekleme var, dördüncü deneme 107 ms'de başarılı. Ödeme sağlayıcısının yavaş node'u 3 saniyede cevap veriyor; attempt timeout'u 2 saniye olduğu için yavaş node'a düşen her deneme kesinlikle başarısız oluyor ve retry yine yüzde 25 ihtimalle aynı node'a düşüyor. Prometheus'tan baktığımızda aynı koşuda yaklaşık 1.200 ödeme çağrısına 379 retry eklenmişti; sağlayıcıya yüzde 30'u aşkın fazladan yük. Yavaş bir sağlayıcıyı daha çok istekle yükleyen bu durum retry fırtınası.
İkincisi yapı: "check availability" altında 12 ayrı SELECT. Sepetteki her satır için ayrı sorgu, yani N+1. Bu makinede veritabanı aynı bilgisayarda olduğu için 12 sorgu toplam 6,5 ms sürmüş; bu checkout'u yavaşlatan şey değil. Ama trace bunu süreden bağımsız olarak, yapısından gösteriyor. Veritabanı ağın öbür ucunda olduğunda her round trip 1–2 ms ekler ve satır sayısıyla birlikte büyür; 200 satırlık bir okul siparişinde bu fark artık hissedilir. N+1'in mekaniği ve Entity Framework Core'da nasıl önlendiği sitedeki serisinde (EF Core serisi) anlatıldı; burada önemli olan onu trace'te görmek.
Düzeltme 1: Tek Sorgu
public async Task<IReadOnlyDictionary<int, int>> GetAvailableAsync(IReadOnlyCollection<int> bookIds, CancellationToken ct) =>
    await db.StockItems.AsNoTracking()
        .Where(s => bookIds.Contains(s.BookId))
        .ToDictionaryAsync(s => s.BookId, s => s.QuantityOnHand - s.QuantityReserved, ct);
check?.SetTag("bookstore.cart.line_count", cart.Items.Count);
// Bütün sepet için tek sorgu: satır başına sorgu bir N+1'di (kurumsal siparişte 12 SELECT).
IReadOnlyDictionary<int, int> available =
await inventory.GetAvailableAsync([.. cart.Items.Select(i => i.BookId)], ct);
foreach (CartItem item in cart.Items)
{
if (available.GetValueOrDefault(item.BookId) < item.Quantity)
{
shortIsbns.Add(books[item.BookId].Isbn);
}
}reserve stock'taki satır başına UPDATE'e dokunmadık: o bilinçli bir tercih (her kitap için koşullu UPDATE, kilitleri hep aynı sırayla alıyor). Değişikliğe bir test de ekledik: TracingTests içinde bir ActivityListener, 4 satırlı bir sepetin siparişinde "check availability" span'ının tam bir child'ı olduğunu doğruluyor. Eski kodla test Assert.Single() Failure: The collection contained 4 matching items ile kırıldı. Trace'ten bulunan bir sorunu böyle bir regression testine çevirmek, aynı N+1'in bir sonraki refactoring'de sessizce geri gelmesini önlüyor. Düzeltmeden sonra aynı TraceQL metrics sorgusu ({ name = "check availability" && span.bookstore.cart.line_count = 12 } | quantile_over_time(duration, .5)) 12 satırlı sepetlerde medyanı 5,3 ms'den 0,4 ms'ye indirdi.
Düzeltme 2: Retry Fırtınasını Durdurmak
.AddResilienceHandler("payment-provider", pipeline =>
{
    // Dış katman: retry'lar dahil bütün çağrı 10 saniyeyi asla geçmez.
    pipeline.AddTimeout(TimeSpan.FromSeconds(10));
    // Yalnızca geçici hataları retry et (5xx, 408, 429, ağ hataları, attempt timeout'u), jitter'lı bekleyerek.
    pipeline.AddRetry(new HttpRetryStrategyOptions
    {
        MaxRetryAttempts = 2,
        Delay = TimeSpan.FromMilliseconds(200),
        BackoffType = DelayBackoffType.Exponential,
        UseJitter = true
    });
    // İç katman: tek deneme 4 saniye sürebilir; sağlayıcının en yavaş normal cevabının (trace'lerde 3 sn) üstünde.
    pipeline.AddTimeout(TimeSpan.FromSeconds(4));
});
Asıl değişiklik attempt timeout'unun 2 saniyeden 4 saniyeye çıkması. Kural basit: attempt timeout'u, bağımlılığın normal ama yavaş cevabını kesmemeli. Trace'ler sağlayıcının yavaş cevabının 3 saniye olduğunu gösterdi; timeout onun altında kaldıkça retry hiçbir şeyi kurtarmıyor, yalnızca yük ve bekleme ekliyordu. Yanına iki şey ekledik: dışarıya 10 saniyelik bir toplam timeout (kullanıcının bekleyeceği en uzun süre artık tek yerde yazıyor) ve sabit 500 ms yerine jitter'lı üstel bekleme; çok sayıda istemci aynı anda retry ettiğinde sağlayıcıya aynı anda yüklenmesinler. Retry ve timeout'un ayrıntısı External Service Integration ve Resilience serisinin konusu. 600 siparişlik koşunun sonucu:
orders=600 concurrency=4
status: 201=600
POST /api/orders ms: avg=868 p50=106 p95=3017 p99=3044 max=3173
slower than 2 s: 159, slower than 7 s: 0
Önceki koşuda p95 5,08, p99 7,61 saniyeydi ve 4 sipariş 502 ile bitmişti. Şimdi hata yok, en yavaş sipariş 3,17 saniye ve sağlayıcının log'unda 600 sipariş için tam 600 istek var; retry fırtınası bitti. Tempo'da aynı dakikalar için { span.http.route = "/api/orders/" && duration > 5s } artık 0 trace döndürüyor. Ama siparişlerin yüzde 26'sı hâlâ 3 saniye bekliyor; bu sağlayıcının yavaş node'u ve bizim timeout ayarımızla çözülmüyor.
Onu da azaltmanın bir yolu hedging: cevap belli bir sürede gelmezse aynı isteği paralel olarak bir kez daha gönderip ilk gelen cevabı almak. Bunu da denedik:
// Hedging: sağlayıcı 500 ms içinde cevap vermezse aynı isteği paralel olarak bir kez daha gönder
// ve önce gelen cevabı al. Yalnızca sağlayıcı Idempotency-Key'e uyduğu için güvenli.
.AddStandardHedgingHandler()
.Configure(options =>
{
    options.Hedging.MaxHedgedAttempts = 1;
    options.Hedging.Delay = TimeSpan.FromMilliseconds(500);
    options.Endpoint.Timeout.Timeout = TimeSpan.FromSeconds(4);
    options.TotalRequestTimeout.Timeout = TimeSpan.FromSeconds(10);
});
orders=600 concurrency=4
status: 201=600
POST /api/orders ms: avg=360 p50=105 p95=3011 p99=3021 max=3027
slower than 2 s: 36, slower than 7 s: 03 saniye bekleyen sipariş sayısı 159'dan 36'ya indi; kalanlar iki isteğin ikisinin de yavaş node'a düştüğü siparişler (yüzde 25 × yüzde 25 ≈ yüzde 6). Bedeli sağlayıcının log'unda: 600 sipariş için 744 istek geldi, 144'ü biz cevabı başka yerden aldığımız için iptal edildi. Yani yüzde 24 fazladan yük, üstelik zaten zorlanan bir sağlayıcıya. Hedging ancak sağlayıcı idempotent ise ve bu ek yükü kaldırabiliyorsa doğru; bunu sağlayıcıyla konuşmadan açmak bir retry fırtınasını başka bir adla geri getirmek olur. Bookstore'da repo'ya ilk çözümü koyduk; hedging'i ölçülmüş bir seçenek olarak bırakıyoruz. Üç ayarın trace'leri yan yana:
Span Metrics ve Service Graph
Tempo'nun metrics-generator'ı gelen span'lardan metric üretip Prometheus'a yazabiliyor; otel-lgtm'de iki processor açık. Span metrics, her span adı için istek sayısı, hata ve süre histogram'ı (traces_spanmetrics_calls_total, traces_spanmetrics_latency); service graph ise client ve server span çiftlerinden servisler arası kenarları (traces_service_graph_request_total) çıkarıyor. Grafana'daki Service Graph görünümü bu metric'lerden çiziliyor. 1.200 siparişlik koşu için sorduk:
sum by (span_name) (increase(traces_spanmetrics_calls_total{span_name=~"POST /api/orders/|authorize payment|check availability"}[341s]))
{span_name="POST /api/orders/"}   399.4546066374182
{span_name="authorize payment"}   399.4546066374182
{span_name="check availability"}  399.4546066374182

sum by (client, server, connection_type) (increase(traces_service_graph_request_total[341s]))
{client="user", connection_type="virtual_node", server="bookstore-api"}         955.8764706255834
{client="bookstore-api", connection_type="database", server="localhost"}        6935.7877092843855
{client="bookstore-api", connection_type="messaging_system", server="bookstore-api"}  395.1244754001562
İki gözlem. Birincisi, span metrics 1.200 değil yaklaşık 400 checkout sayıyor; sebebi Önce Tahmin Et'teki farkla aynı. İkincisi, service graph'ta veritabanı ve in-process queue kenarları var ama ödeme sağlayıcısına giden kenar yok: sağlayıcı kendi span'ını göndermiyor ve bizim client span'larımız Tempo'nun bu kurulumunda bir kenar üretmeye yetmedi. Service graph yalnızca span gönderen ya da tanıdığı attribute'larla işaretlenen bağımlılıkları gösteriyor; harici servislerin haritada eksik görünmesi normal.
Üretimde Dikkat
Trace backend'inin saklama süresini ve arama penceresini birlikte düşün. Tempo uzun süre saklamayı ucuz yapıyor ama geniş pencerede TraceQL araması çok blok tarar; arama penceresini sorunun olduğu zamana daraltmak hem hızlı hem ucuz. Jaeger'de ise saklama süresi index'in de saklama süresi; storage'ın kapasitesi buna göre planlanır.
Bir trace'in span'ları farklı makinelerden gelir ve her span kendi makinesinin saatiyle zaman damgası alır. Saatler arasında kayma (clock skew) varsa waterfall'da child, parent'ından önce başlıyor ya da sonra bitiyor görünür. NTP (Network Time Protocol; saatleri ağ üzerinden eşitleme protokolü) ile senkronizasyon, trace'lerin okunabilir olmasının ön koşulu. Bizim örneğimizde her şey aynı process'te olduğu için bu sorunu görmedik.
Trace'te bulunan bir sorunu düzelttikten sonra aynı aramayı tekrar çalıştır. "duration > 5s" sorgusunun 71'den 0'a inmesi, düzeltmenin kanıtı; bunu pull request açıklamasına koymak bir sonraki incelemeyi kısaltır.
Sık Düşülen Tuzaklar
Tail sampling'li trace'lerden yüzdelik ve sayı hesaplamak. Önce Tahmin Et'in cevabı bu. Collector bütün hataları ve 1 saniyeden yavaş bütün trace'leri, kalanların ise yüzde 10'unu tutuyor. Tempo'daki 374 checkout, 1.200'ün yavaşlara doğru çarpık bir örneği; ondan hesaplanan medyan 1,40 saniye, gerçeği 108 ms. Span metrics de sampling'den sonra üretildiği için aynı çarpıklığı taşıyor. Oran, sayı ve yüzdelik için uygulamanın kendi metric'lerine (Prometheus'taki histogram'a) bak; trace backend'i "hangi istek ve neden" sorusu için.
Aranan trace'in olmaması. Exemplar'da gördüğümüz gibi, sampling kararı trace'i atmış olabilir. Hızlı ama hatalı görünmeyen bir isteğin trace'ini arıyorsan bulamaman normal; sampling kurallarını bilmek, "trace yok" ile "istek hiç gelmedi"yi karıştırmamak için şart.
Bir spanset içinde farklı span'lardaki koşulları && ile birleştirmek. Sonuç sessizce boş döner. Farklı span'lar için { A } && { B } ya da yapısal operatörleri, toplam süre için traceDuration'ı kullan.
Timeout'u bağımlılığın normal cevap süresinin altında tutmak. Bu durumda retry her zaman kaybeder ve yalnızca yük ekler; değeri tahminle değil, trace'te görülen gerçek dağılıma göre seç.
Waterfall'da yalnızca en uzun çubuğa bakmak. N+1 burada süreyi belirlemiyordu ama yapısı trace'te açıkça görünüyordu. Tekrar eden kısa span'lar, bugün değilse veri büyüdüğünde sorun olur.
Küçük Bir Deneme
★☆☆ Tempo'da { name = "reserve stock" } > { span.db.system.name = "microsoft.sql_server" } | count() > 10 sorgusunu çalıştır ve kaç trace döndüğüne bak. Bu bir N+1 mi, yoksa bilinçli bir tercih mi? Cevabını kodun yorumuyla karşılaştır.
★★☆ Ödeme sağlayıcısını Provider:SlowDelayMs=5000 ile başlat. Yeni ayarımızın (4 saniyelik attempt timeout) bu durumda yeniden bir retry fırtınasına dönüştüğünü trace'lerde göster ve timeout'u sabit bir sayı yerine hangi metric'e bakarak ayarlaman gerektiğini düşün.
★★★ Collector'daki tail sampling'in probabilistic oranını yüzde 100 yap, aynı trafiği tekrar gönder ve quantile_over_time ile trafik aracının ölçtüğü medyanı karşılaştır. Sonra oranı yüzde 10'a döndürüp Tempo'nun span sayısındaki ve disk kullanımındaki farkı ölç.
Trace'leri bulduk, vakayı düzelttik. Bu yolculukta log'a hiç bakmadık, ama "tam olarak ne oldu" sorusunun ayrıntısı hâlâ log'da: hangi müşterinin siparişi, hangi hata mesajı. Bir sonraki yazıda log backend'lerine geçiyoruz: OpenTelemetry logs ile Loki'ye log göndermek, label ile structured metadata farkı, LogQL ve log satırından trace'e tek tıkla geçmek; ELK (Elasticsearch, Logstash ve Kibana üçlüsü) ile karşılaştırma ve Seq'in yeri.