

Observability Nedir? Monitoring'den Farkı, Log, Metric ve Trace'in Her Birinin Cevapladığı Soru

Observability, sistemin dışarıya verdiği log, metric ve trace sinyallerinden önceden düşünülmemiş bir soruyu sonradan sorup cevaplayabilmektir; monitoring ise bilinen arızaları izler. Bookstore'da bazen 8 saniye süren checkout'u log, dotnet-counters ile metric ve trace üzerinden daraltıyor, telemetry pipeline'ını ve cardinality maliyetini tanıyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10 (SDK 10.0.402), Microsoft.Extensions.Http.Resilience 10.11, dotnet-counters 10.0 ve container'da çalışan SQL Server 2025 ile denenmiştir.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'da (bir online kitapçı) müşteri hizmetlerinden Gül bir şikâyet iletiyor: "Sipariş ver butonuna basınca bazen sayfa 8 saniye bekliyor." Log'lara bakıyorsun; her sipariş için bir satır var, hata yok, hepsi 201 dönmüş. Bir de ortalama süreye bakıyorsun: yaklaşık 1 saniye. İki soru: Ortalama 1 saniyeyse "8 saniye" abartı mı? Ve log'da hatası olmayan bir yavaşlığın sebebini log'dan bulabilir misin? Bu yazının sonunda ikisinin de cevabı netleşecek; asıl düzeltme ise serinin ilerleyen yazılarında, trace backend'i ile yapılacak.
Vaka: Checkout Bazen 8 Saniye
Observability (gözlemlenebilirlik) serisi boyunca aynı uygulamayla çalışacağız: Bookstore'un referans uygulamasındaki Bookstore.Api (Catalog, Ordering ve Inventory module'leri, Entity Framework Core 10 ve SQL Server). Bu seri için ona iki şey ekledik. Birincisi Payments module'ü: sipariş kaydedildikten sonra dış ödeme sağlayıcısına bir HttpClient ile gidip ödemeyi onaylatıyor. Dış servis çağrısı olduğu için arkasında bir resilience pipeline'ı var:
services.AddHttpClient<IPaymentGateway, PaymentGatewayClient>(client => client.BaseAddress = baseAddress)
    .AddResilienceHandler("payment-provider", pipeline =>
    {
        // Dışta en fazla 3 retry, aralarında 500 ms. İçte her deneme için 2 saniye.
        pipeline.AddRetry(new HttpRetryStrategyOptions
        {
            MaxRetryAttempts = 3,
            Delay = TimeSpan.FromMilliseconds(500),
            BackoffType = DelayBackoffType.Constant,
            UseJitter = false
        });
        pipeline.AddTimeout(TimeSpan.FromSeconds(2));
    });
Retry ve timeout'un mekaniği External Service Integration ve Resilience serisinin konusu; burada önemli olan, bu ayarın kâğıt üzerinde makul görünmesi. İkincisi, ödeme sağlayıcısının yerine geçen küçük bir uygulama: tools/Bookstore.FakePaymentProvider. Gerçek bir sağlayıcının tipik bir kötü gününü taklit ediyor: arkasındaki dört node'dan biri yavaş, bu yüzden her denemenin yüzde 25 ihtimalle 3 saniye, kalanının 40–120 ms sürmesi. Bir de trafik üreten bir konsol uygulaması var: tools/Bookstore.Traffic, her sipariş için yeni bir sepet açıp 1–3 kitap ekliyor (her onuncu sipariş 12 kitaplık bir kurumsal sipariş) ve POST /api/orders çağrısının süresini ölçüyor. Üç uygulamayı çalıştırdık (SQL Server bağlantısı için repo'daki README'ye bak):
dotnet run --project tools/Bookstore.FakePaymentProvider
dotnet run --project src/Bookstore.Api
dotnet run --project tools/Bookstore.Traffic -- 300 4

orders=300 concurrency=4
status: 201=295, 502=5
POST /api/orders ms: avg=1013 p50=106 p95=5130 p99=9533 max=9557
slower than 2 s: 69, slower than 7 s: 11
Önce Tahmin Et'teki ilk sorunun cevabı burada. Ortalama 1013 ms, ama bu sayıyı yaşayan bir müşteri yok. Siparişlerin yarısı 106 ms'nin altında bitiyor; 300 siparişin 69'u 2 saniyeyi, 11'i 7 saniyeyi geçiyor. Ortalama, çok hızlı çoğunlukla çok yavaş azınlığı karıştırıp ikisini de gizliyor. p95 (isteklerin yüzde 95'inin altında kaldığı süre) ve p99 bu yüzden var: dağılımın kuyruğunu, yani şikâyet eden müşterinin yaşadığını gösteriyorlar.
Log Ne Söylüyor, Ne Söylemiyor?
Bu 300 sipariş, API'nin konsoluna 2.224 log satırı yazdı. Sipariş başına bir tane bizim satırımız var, gerisi HttpClient'ın ve Polly'nin (resilience library'si) kendi satırları. Yavaş bir siparişin satırı şöyle:
19:06:03.830 info: Bookstore.Ordering.OrderService[0] Order 2688 placed: 1 items, 429.00 TRY, took 7606 msBu satır semptomu kanıtlıyor: 2688 numaralı sipariş 7,6 saniye sürmüş. Sebep için hemen üstündeki satırlara bakıyorsun (uzun satırları kısalttık):
19:06:01.678 info: System.Net.Http.HttpClient.IPaymentGateway.LogicalHandler[100] Start processing HTTP request POST http://localhost:5090/v1/charges
19:06:01.990 warn: Polly[3] Execution attempt. Source: 'IPaymentGateway-payment-provider//Retry', ... Handled: 'True', Attempt: '0', ...
19:06:02.492 info: System.Net.Http.HttpClient.IPaymentGateway.ClientHandler[100] Sending HTTP request POST http://localhost:5090/v1/charges
19:06:03.161 warn: Polly[3] Execution attempt. Source: 'IPaymentGateway-payment-provider//Retry', ... Handled: 'True', Attempt: '0', ...
19:06:03.250 warn: Polly[3] Execution attempt. Source: 'IPaymentGateway-payment-provider//Retry', ... Handled: 'True', Attempt: '2', ...
19:06:03.679 warn: Polly[3] Execution attempt. Source: 'IPaymentGateway-payment-provider//Retry', ... Handled: 'True', Attempt: '0', ...
19:06:03.825 info: Polly[3] Execution attempt. Source: 'IPaymentGateway-payment-provider//Retry', ... Result: '200', Handled: 'False', Attempt: '3', ...
19:06:03.825 info: System.Net.Http.HttpClient.IPaymentGateway.LogicalHandler[101] End processing HTTP request after 7585.6352ms - 200
19:06:03.830 info: Bookstore.Ordering.OrderService[0] Order 2688 placed: 1 items, 429.00 TRY, took 7606 ms
İpucu var: ödeme çağrısı 7.585 ms sürmüş ve son başarılı deneme Attempt: '3', yani dördüncü deneme. Ama 2,5 saniyelik bu pencerede üç farklı siparişin denemeleri iç içe geçmiş durumda ve Polly'nin satırlarında sipariş numarası yok. Hangi timeout'un 2688'e ait olduğunu satırlara bakarak çıkaramıyorsun; aynı anda dört istek işleniyordu. Satırları istek bazında gruplayacak bir anahtar lazım. Aslında o anahtar zaten var, sadece konsolda görünmüyor. Logging ayarına IncludeScopes ekleyince aynı satır şöyle oluyor:
18:29:04.426 info: Bookstore.Ordering.OrderService[0] => SpanId:b9486bb602fccc43, TraceId:4df013bdd225d4e8888c0f12c8408ec6, ParentId:0000000000000000 => ConnectionId:0HNQ2FKGOCG4F => RequestPath:/api/orders RequestId:0HNQ2FKGOCG4F:0000001F Order 403 placed: 1 items, 219.90 TRY, took 2625 msOpenTelemetry kurulu olmasa bile ASP.NET Core her istek için bir Activity açıyor ve onun TraceId'si log scope'una giriyor. İstek bazında gruplamanın ve ileride log'dan trace'e geçmenin anahtarı bu id; ayrıntısı .NET'te Logging serisinin correlation ve trace context yazısında. Bu yazının konusu açısından önemli olan şu: log, "ne oldu" sorusuna ayrıntılı cevap veriyor ama "ne sıklıkla" ve "süre nereye gitti" sorularına ancak sen satırları elle birleştirirsen cevap veriyor.
Metric: Ne Kadar Sık, Ne Kadar Kötü?
ASP.NET Core, .NET 8'den beri http.server.request.duration adında bir histogram'ı kendisi tutuyor. Okumak için bir backend'e gerek yok; .NET'te Profiling ve Diagnostics serisinde anlatılan dotnet-counters çalışan process'e bağlanıp değerleri topluyor. Process id'sini dotnet-counters ps ile bulup trafik sırasında 10 saniyelik aralıklarla topladık:
dotnet-counters collect -p <PID> --refresh-interval 10 --format csv -o counters.csv `
    --counters "Microsoft.AspNetCore.Hosting[http.server.request.duration]"
CSV (virgülle ayrılmış değerler) dosyasından yalnız POST /api/orders satırlarını aldık (saniye; zamanlar UTC (eşgüdümlü evrensel saat) cinsinden):
19:06:01  201 p50=0.090  p95=5.070  p99=5.078
19:06:11  201 p50=0.108  p95=7.625  p99=7.625   502 p50=9.531
19:06:21  201 p50=0.124  p95=5.125  p99=5.141
19:06:31  201 p50=0.102  p95=2.629  p99=7.609   502 p50=9.547
19:06:41  201 p50=0.106  p95=5.094  p99=7.641
19:06:51  201 p50=0.113  p95=5.125  p99=7.578
19:07:01  201 p50=0.103  p95=2.613  p99=5.133   502 p50=9.531
Metric'in cevabı log'unkinden farklı ve tamamlayıcı. Sorun bir anlık değil, her 10 saniyelik pencerede tekrar ediyor. Medyan 0,1 saniye civarında sabit, kuyruk ise 2,6, 5,1 ve 7,6 saniyede kümeleniyor. Bu üç sayı rastgele değil: 2 saniyelik timeout + 0,5 saniyelik bekleme + normal bir cevap, bir, iki ve üç kere. Kuyruğun "basamaklı" olması, sorunun bir retry döngüsünde olduğunu söylüyor. 9,5 saniyelik 502'ler de dört denemenin dördünün de zaman aşımına uğradığı siparişler. Metric bunu 300 satır log okumadan, birkaç sayıyla söyledi ve maliyeti istek sayısından bağımsız: 3.000 sipariş de olsa aynı birkaç seri tutulur.
Metric'in söyleyemediği şey hangi siparişin neden yavaş olduğu. Değerler toplanmış (aggregate) durumda; 7,6 saniyelik bir istek histogram'da yalnızca bir bucket'ın sayacını bir artırdı. Sipariş numarası, kaç kitap olduğu, hangi müşterinin olduğu metric'te yok ve olmamalı da; nedenini maliyet bölümünde göreceğiz.
Trace: Süre Nereye Gitti?
Üçüncü soru: 7,6 saniyenin içinde ne var? Sepeti okumak, stok kontrolü, stok rezervasyonu, siparişi yazmak, ödeme, ödemenin dört denemesi... Log'da bunların bir kısmını gördük, metric'te süre dağılımını gördük, ama tek bir isteğin içindeki zaman çizelgesini ikisi de vermiyor. Bunu trace veriyor: bir isteğin geçtiği her adım bir span, her span'ın başlangıcı, süresi ve parent'ı var; hepsi aynı trace id'yi taşıyor. Bir sonraki yazıda OpenTelemetry'yi kurduğumuzda yavaş bir siparişin trace'i, her SQL sorgusunu ve ödeme sağlayıcısına giden her HTTP denemesini ayrı bir çubuk olarak gösterecek: zaman aşımına uğrayan denemeler tam 2 saniyede kesilmiş, sonuncusu birkaç on milisaniyede bitmiş. "Süre nereye gitti" sorusunun cevabı tek ekranda.
Trace'in de bir sınırı var: her isteğin her span'ını saklamak pahalı. Production'da genelde örnekleme (sampling) yapılır ve aradığın trace'in saklanmamış olma ihtimali vardır. Bu yüzden üç sinyal birbirinin yerine geçmiyor: metric "sorun var mı, ne kadar büyük" der ve alarmı çaldırır, trace "nerede" der, log "tam olarak ne oldu" der.
Monitoring ile Observability Arasındaki Fark
Monitoring, önceden bildiğin arızaları izlemektir: CPU yüzde 90'ı geçti mi, disk doluyor mu, hata oranı yüzde 1'i aştı mı. Soruyu önceden yazarsın, sistem cevabı sürekli hesaplar, eşik aşılınca alarm çalar. Observability ise sistemin dışarıya verdiği sinyallerden, önceden aklına gelmemiş bir soruyu sonradan sorup cevaplayabilmektir. "Kurumsal siparişlerde, ödeme sağlayıcısının ikinci denemesinde zaman aşımı yaşayanlar ne kadar sürüyor?" diye bir dashboard'u kimse önceden hazırlamaz. Ama telemetry'de sipariş tipi, deneme sayısı ve süre birbirine bağlı şekilde duruyorsa bu soruyu olay anında sorabilirsin.
İkisi rakip değil. Observability'li bir sistemde de monitoring yapılır; alarm yine bilinen semptomlar üzerine kurulur. Fark, alarm çaldıktan sonra başlıyor: monitoring yalnızca "bir şey bozuk" der, observability "neden bozuk" sorusunu yeni kod deploy etmeden araştırmanı sağlar. Google'ın SRE (Site Reliability Engineering; sistemin güvenilirliğini yazılım mühendisliğiyle yönetme yaklaşımı) kitabındaki Monitoring Distributed Systems bölümü de izlenecek temel sinyal olarak kullanıcının hissettiği şeyleri öne çıkarır: gecikme, trafik, hata ve doygunluk. Bizim vakada gecikme ilk göstergeydi; CPU ve bellek bu sırada tamamen normaldi.
Sinyaller, Köprüler ve Telemetry Pipeline'ı
Observability konuşulurken sık duyulan söylem "three pillars"dır: log, metric ve trace. Faydalı bir başlangıç, ama iki yanıltıcı tarafı var. Birincisi, üç sütunu üç ayrı araç olarak düşündürüyor; oysa değer, sinyallerin birbirine bağlanmasından geliyor. İkincisi, liste kapalı değil. OpenTelemetry bugün trace, metric, log ve baggage'ı destekliyor; profile (bir process'in CPU ve bellek zamanını hangi kodda harcadığının sürekli kaydı) ve event sinyalleri ise dokümanında hâlâ geliştirme aşamasında gösteriliyor.
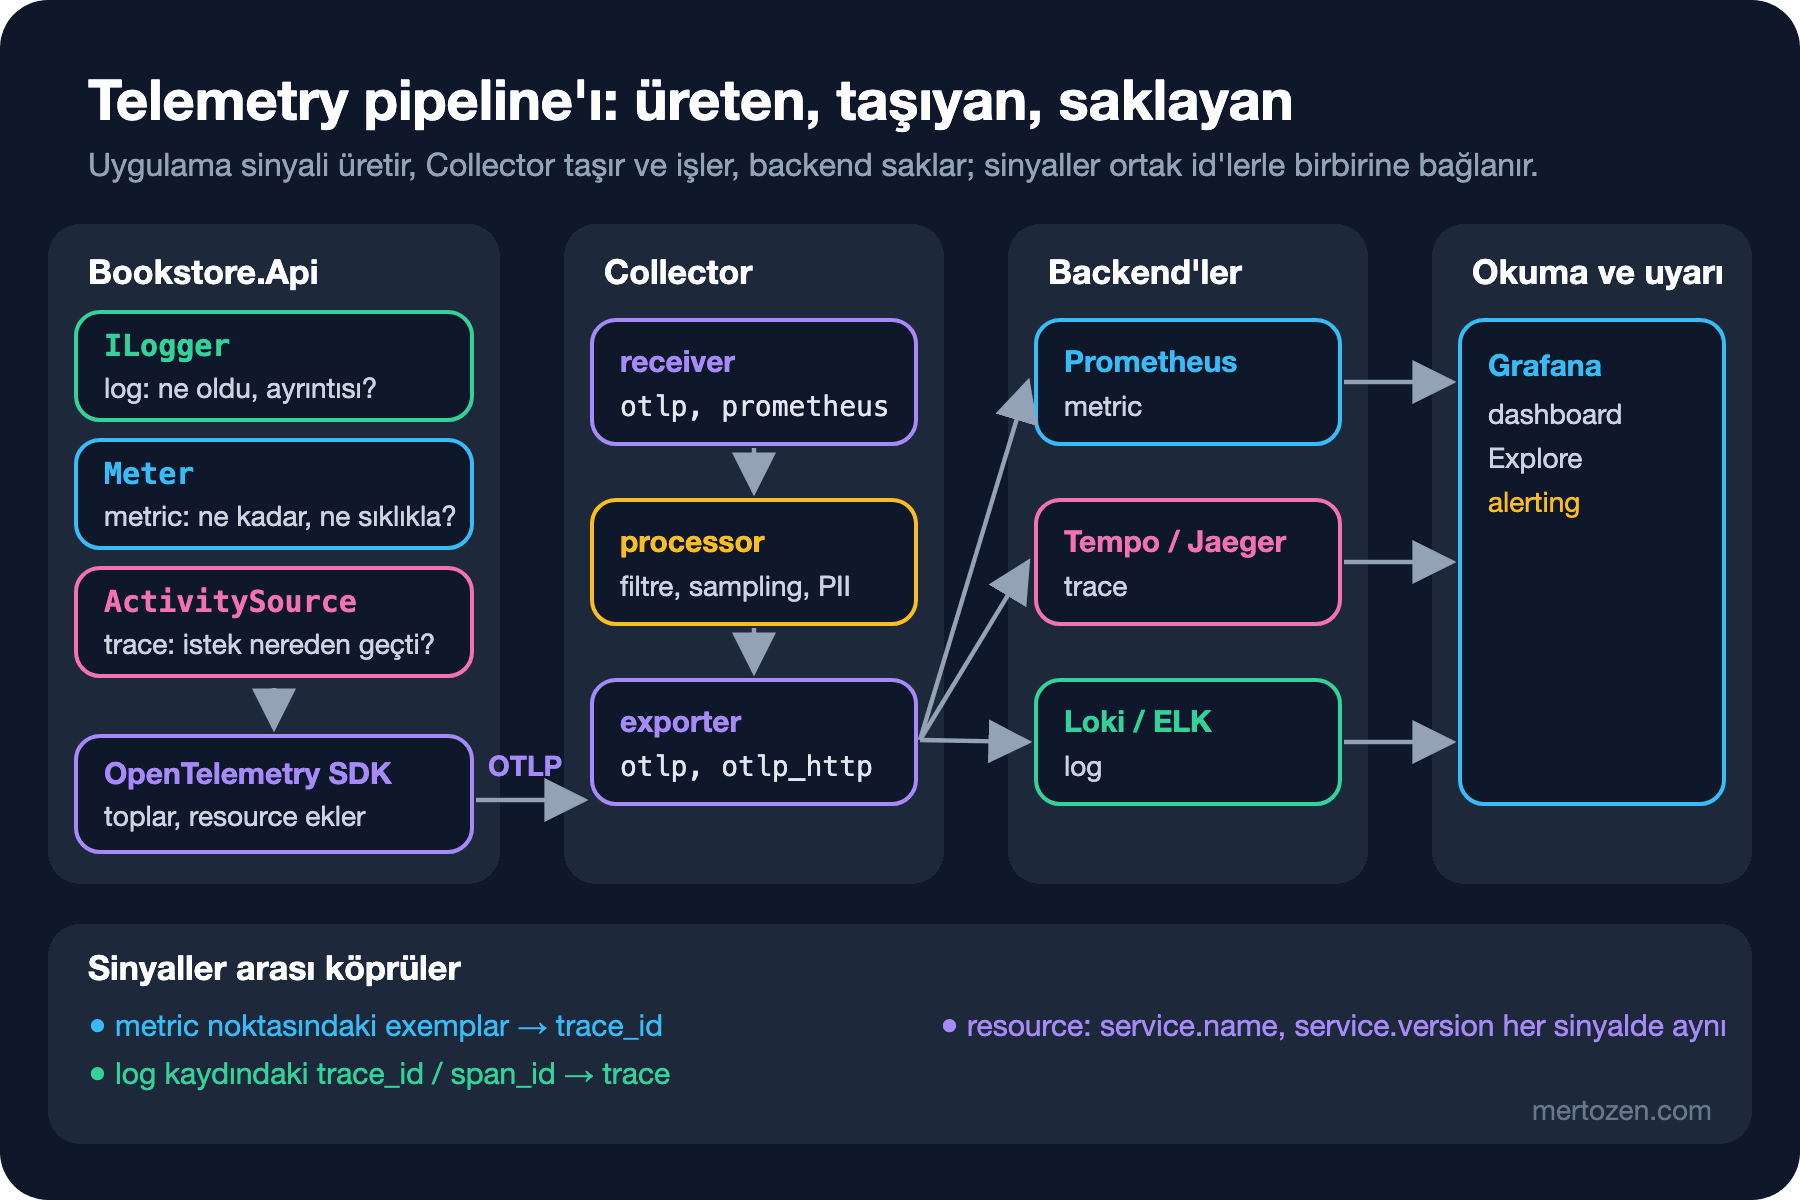
Sinyaller arasındaki köprüler somut alanlar. Bir log kaydı trace_id ve span_id taşırsa log'dan tek tıkla o isteğin trace'ine geçersin. Bir histogram noktası exemplar (o bucket'a düşen örnek ölçümlerden birinin trace id'si) taşırsa, p99 grafiğindeki bir sıçramadan o sıçramayı oluşturan isteklerden birinin trace'ine gidersin. Bütün sinyallerde aynı resource attribute'ları (service.name, service.version, ortam) varsa üçünü aynı servis ve aynı sürüm için filtrelersin.
Bu sinyallerin yolculuğu yukarıdaki görseldeki gibi. Uygulama sinyali .NET'in kendi API'leriyle üretiyor: log için ILogger, metric için Meter, trace için ActivitySource. OpenTelemetry SDK'sı bunları toplayıp resource bilgisini ekliyor ve OTLP (OpenTelemetry Protocol; telemetry verisini taşıyan standart protokol) ile gönderiyor. Arada bir OpenTelemetry Collector duruyor: veriyi alıyor, filtreliyor, örnekliyor, kişisel veriyi temizliyor ve bir ya da birden çok backend'e yolluyor. Backend'ler her sinyal için ayrı: metric için Prometheus, trace için Tempo ya da Jaeger, log için Loki ya da ELK (Elasticsearch, Logstash ve Kibana'dan oluşan log yığını). En sonda Grafana gibi bir araç dashboard'ları ve alarmları sunuyor.
Bu yapının asıl kazancı vendor bağımsızlığı. Uygulama yalnızca OTLP konuşuyor; backend'i Prometheus'tan Azure Monitor'a değiştirmek, uygulama kodunda değil Collector config'inde bir değişiklik. Serinin sırası da bu yolu izliyor: önce .NET'te sinyal üretmek (OpenTelemetry kurulumu, metric'ler, trace'ler), sonra Collector, Prometheus, Grafana, trace ve log backend'leri, en sonda alarm ve production.
Maliyet ve Cardinality'ye İlk Bakış
Üç sinyalin maliyeti çok farklı ölçekleniyor. Log ve trace, istek sayısıyla doğru orantılı büyüyor: 300 sipariş 2.224 log satırı yazdı, günde bir milyon siparişte bu 7 milyonun üzerinde satır demek ve her satır saklanıp indekslenecek. Metric ise istek sayısıyla değil, zaman serisi sayısıyla büyüyor. Bir zaman serisi, bir metric adı ile label'larının (ör. route, status code) bir kombinasyonu. Yukarıdaki histogram'da POST /api/orders için 201 ve 502 olmak üzere iki seri var; 300 ya da 3 milyon istek fark etmiyor.
Cardinality, bir label'ın alabileceği farklı değer sayısı. http.response.status_code birkaç değer alır, sorun değil. Ama metric'e sipariş numarası ya da müşteri e-postası label'ı eklersen her sipariş yeni bir zaman serisi açar ve metric, log kadar pahalı hâle gelir, üstelik log kadar ayrıntılı da olmaz. Kural kabaca şu: yüksek cardinality'li bilgi (id'ler, e-posta, URL'nin tamamı) trace ve log'a, düşük cardinality'li bilgi (sipariş tipi, ödeme yöntemi, sonuç) metric'e. Seri bütçesini ve OpenTelemetry SDK'sının bu bütçe aşıldığında ne yaptığını üçüncü yazıda ölçerek göreceğiz.
.NET'te Logging serisi uygulamanın doğru log üretmesini anlattı: neyi loglamalı, seviyeler, Serilog, redaction. Bu seri o noktadan devralıyor; log'u burada yalnızca OpenTelemetry'nin log sinyali ve bir backend olarak ele alacağız.
Üretimde Dikkat
Ortalamayla alarm kurma. Bizim vakada ortalama 1 saniyeydi ve "1 saniyenin üstü" gibi bir eşik ya hiç çalmaz ya da sürekli çalar. Eşiği yüzdelik üzerine kur (p95, p99) ve süreyi histogram olarak ölç; gauge'a yazılmış bir ortalama sonradan yüzdeliğe çevrilemez.
Retry'ı telemetry'nin parçası say. Bu vakada ödeme sağlayıcısı aslında isteklerin dörtte birinde yavaş; ama retry yüzünden sağlayıcıya giden çağrı sayısı sipariş sayısından belirgin şekilde fazla. Sahte sağlayıcının log'unda 2688'in dört denemesi ayrı ayrı görünüyor. Retry sayısını bir metric olarak tutmazsan, kendi sisteminin dışarıya yaptığı yükü göremezsin.
Telemetry'yi işin sonuna bırakma. Bu yazıdaki ölçümleri kod değiştirmeden aldık, çünkü ASP.NET Core ve HttpClient kendi metric'lerini ve Activity'lerini zaten üretiyor. Ama "sipariş tipi" gibi iş bilgisini ancak sen ekleyebilirsin ve olay anında eklemek için geç kalmış olursun.
Sık Düşülen Tuzaklar
Log'u her şeyin cevabı sanmak. Log hatasız bir yavaşlığı ancak sen satırları elle birleştirirsen gösterir; eşzamanlı isteklerde bu neredeyse imkânsız. Süre ve sıklık soruları için metric ve trace daha ucuz ve daha net.
"Three pillars"ı üç ayrı satın alma kararı gibi okumak. Üç ayrı araç kurup aralarında trace_id, resource ve exemplar köprüsü kurmazsan, olay anında üç ekran arasında saat damgasıyla eşleştirme yaparsın.
Monitoring'i observability sanmak. CPU, bellek ve disk dashboard'ları bu vakada tamamen yeşildi. Kullanıcının yaşadığı semptomu (gecikme, hata) ölçmeyen bir sistem, sorunu ancak şikâyetle öğrenir.
Lokal ölçümleri mutlak sanmak. 106 ms ve 7,6 saniye bu makinenin ve bu sahte sağlayıcının sayıları. Önemli olan dağılımın şekli: medyan ile kuyruk arasındaki fark ve kuyruğun basamakları.
Küçük Bir Deneme
★☆☆ Sahte sağlayıcının Provider:SlowRatio ayarını 0 yap (appsettings.json ya da Provider__SlowRatio environment variable'ı), aynı trafiği tekrar çalıştır. p95 ve p99 ne oluyor? Ortalama ile medyan arasındaki fark kapanıyor mu?
★★☆ Retry stratejisini pipeline'dan çıkar (yalnız timeout kalsın) ve aynı trafiği çalıştır. 502 sayısı ve kuyruk nasıl değişiyor? Kullanıcı açısından hangisi daha kötü: 7,6 saniye bekleyip başarılı olmak mı, 2 saniyede hata almak mı?
★★★ dotnet-counters'ı System.Net.Http meter'ına bağla ve http.client.request.duration'ı topla. Sunucu tarafındaki http.server.request.duration ile istemci tarafındaki ödeme çağrısı süresini karşılaştır: kuyruğun ne kadarı ödeme çağrısından geliyor?
Üç sinyalin her birinin hangi soruya cevap verdiğini ve pipeline'ın parçalarını gördük. Bir sonraki yazıda bu pipeline'ın ilk halkasını kuruyoruz: OpenTelemetry'nin yapısı (spec, API, SDK, instrumentation, OTLP), Bookstore.Api'ye OpenTelemetry'yi eklemek, resource attribute'ları ve telemetry'yi lokalde standalone Aspire Dashboard ile görmek. 2688 gibi yavaş bir siparişin trace'ini ilk kez orada açacağız.