

Gerçek Incident'lar 2: Otomasyon, Gizli Bağımlılıklar ve Kurtarma Yolları — AWS 2025, Facebook 2021, GitLab 2017, Knight Capital 2012

AWS, Facebook, GitLab ve Knight Capital vakalarında arızayı büyüten şey otomasyonun kendi hataları, gizli bağımlılıklar ve kurtarma yolunun da bozulan şeye bağlı olmasıydı; ders, kurtarma yolunu da düzenli denemektir. Dört vakayı resmî kaynaklardan anlatıyor, Bookstore'un SQL Server'ında ilk koşusu kırmızı çıkan bir restore drill çalıştırıyor, bağımlılık haritası ve break-glass erişim hazırlıyor ve sürüm karışıklığını yakalayan bir alert yazıyoruz.
Sürüm notu: Bu yazıdaki örnekler SQL Server 2025 (sqlcmd), Prometheus 3.16.0 (promtool) ve .NET 10 ile denenmiştir. Gerçek incident'larla ilgili bilgiler yalnız şirketlerin resmî yayınlarından; o sistemlerde hiçbir şey çalıştırılmadı.
Önce Tahmin Et
Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) BookstoreDb veritabanının her gece yedeği alınıyor ve iş başarısız olursa ekibe e-posta gidiyor. Son altı ayda hiç hata e-postası gelmedi. Yarın veritabanı sunucusu kaybolsa, (1) en fazla ne kadar veri kaybedersin, (2) restore kaç dakika sürer, (3) restore'u yapacak kişi hangi makineye, hangi yetkiyle, hangi doküman açıkken bağlanır? Üç sorudan kaçını bir ölçüme dayanarak cevaplayabiliyorsun? İkinci soru: production'a acil durumda girmek için kullandığın VPN (şirket ağına uzaktan güvenli bağlantı), SSO (tek oturumla birçok sisteme giriş) ya da runbook wiki'si, kurtarmaya çalıştığın altyapının üzerinde mi çalışıyor? Yazının sonunda Bookstore için bu soruların ilkini ölçüyoruz.
Dört Vaka
Bir önceki yazıda global yayılan config'in neden olduğu üç kesintiyi inceledik. Bu yazıdaki dört vaka başka bir aileden: otomasyonun kendisinin arızalandığı, bir bağımlılığın beklenmedik yerlerden ortaya çıktığı ve kurtarma yolunun da bozulan şeye bağlı olduğu durumlar. Anlatılanlar yalnız resmî kaynaklardan: AWS'in (Amazon'un bulut platformu) post-event summary'si, Meta'nın engineering blog'u, GitLab'ın postmortem'i ve Knight Capital için ABD Menkul Kıymetler ve Borsa Komisyonu'nun (SEC) kararı. Saatler kaynağın kullandığı saat diliminde.
AWS us-east-1, 19–20 Ekim 2025
DynamoDB'nin bölgesel endpoint'lerinin DNS kayıtlarını iki otomasyon yönetiyor. DNS Planner, load balancer'ların sağlığına ve kapasitesine bakıp düzenli olarak yeni DNS planları (hangi load balancer, hangi ağırlıkla) üretiyor. DNS Enactor bu planları Route 53'e uyguluyor ve dayanıklılık için üç ayrı availability zone'da birbirinden bağımsız üç kopya hâlinde çalışıyor. Her Enactor, uygulayacağı planın mevcut plandan yeni olduğunu yalnız işin başında bir kez kontrol ediyordu.
19 Ekim gecesi, saatler PDT (ABD'nin batı kıyısındaki yaz saati) cinsinden, Enactor'lardan biri birkaç endpoint'te alışılmadık gecikmeler yaşadı. Bu arada Planner yeni planlar üretmeye devam etti ve ikinci bir Enactor en yeni planı uygulayıp temizlik adımına geçti; temizlik, uygulanan plandan çok daha eski planları siliyordu. Tam o sırada gecikmeli Enactor, başta yaptığı tazelik kontrolü artık geçersiz olan eski planını bölgesel endpoint'e yazdı. Temizlik adımı bu eski planı sildiğinde endpoint'in bütün IP adresleri de silindi ve dynamodb.us-east-1.amazonaws.com boş bir DNS kaydıyla kaldı. Sistem tutarsız bir durumdaydı; hiçbir Enactor sonraki planları uygulayamadı ve düzeltme elle yapılmak zorunda kaldı. AWS'in özetine göre sebep, DNS yönetim sistemindeki uzun süredir fark edilmemiş bir race condition (iki işin zamanlamasına bağlı olarak yanlış sonuç üreten hata).
DynamoDB'nin DNS hataları 23:48'de başladı. Mühendisler 00:38'de sebebin DynamoDB'nin DNS durumu olduğunu buldu, 02:25'te bütün DNS bilgisi geri yüklendi ve istemcilerin DNS cache'i doldukça DynamoDB etkisi 02:40'ta bitti. Ama zincir burada bitmedi. EC2'de (AWS'in sanal sunucu servisi) fiziksel sunucuların durumunu yöneten DropletWorkflow Manager (DWFM), her sunucuyla bir lease (süreli kira kaydı) tutuyor ve bunun için DynamoDB'ye bağlı. DynamoDB'siz geçen saatlerde lease'ler zaman aşımına uğradı; DynamoDB dönünce DWFM aynı anda çok sayıda lease'i yenilemeye çalıştı, işler zaman aşımına uğrayıp yeniden kuyruğa girdi ve sistem toparlanamaz hâle geldi. AWS bunu congestive collapse (yükün kendini besleyerek sistemi kilitlemesi) olarak tanımlıyor ve bu durum için hazır bir kurtarma prosedürü olmadığını yazıyor. Mühendisler 04:14'te gelen işi kısıp DWFM sunucularını seçerek restart etti; 05:28'de bütün lease'ler yenilenmişti.
Sonra ağ tarafı geldi: yeni instance'ların ağ ayarlarını dağıtan Network Manager biriken işi eritirken gecikti ve yeni instance'lar ağ bağlantısı olmadan açıldı. Network Load Balancer'ın (NLB; AWS'in load balancer servisi) health check'leri bu instance'ları bir sağlıklı bir sağlıksız gördü ve otomatik availability zone failover'ı kapasiteyi düşürdü. Mühendisler 09:36'da NLB'nin otomatik health check failover'ını kapattı. Lambda, container ve kimlik servisleri, Amazon Connect ve Redshift ayrı ayrı etkilendi; EC2 13:50'de, olayın tamamı 20 Ekim 14:20'de normale döndü. Toplamda 14 buçuk saat; DNS'in kendisi ise yaklaşık 3 saatte düzelmişti.
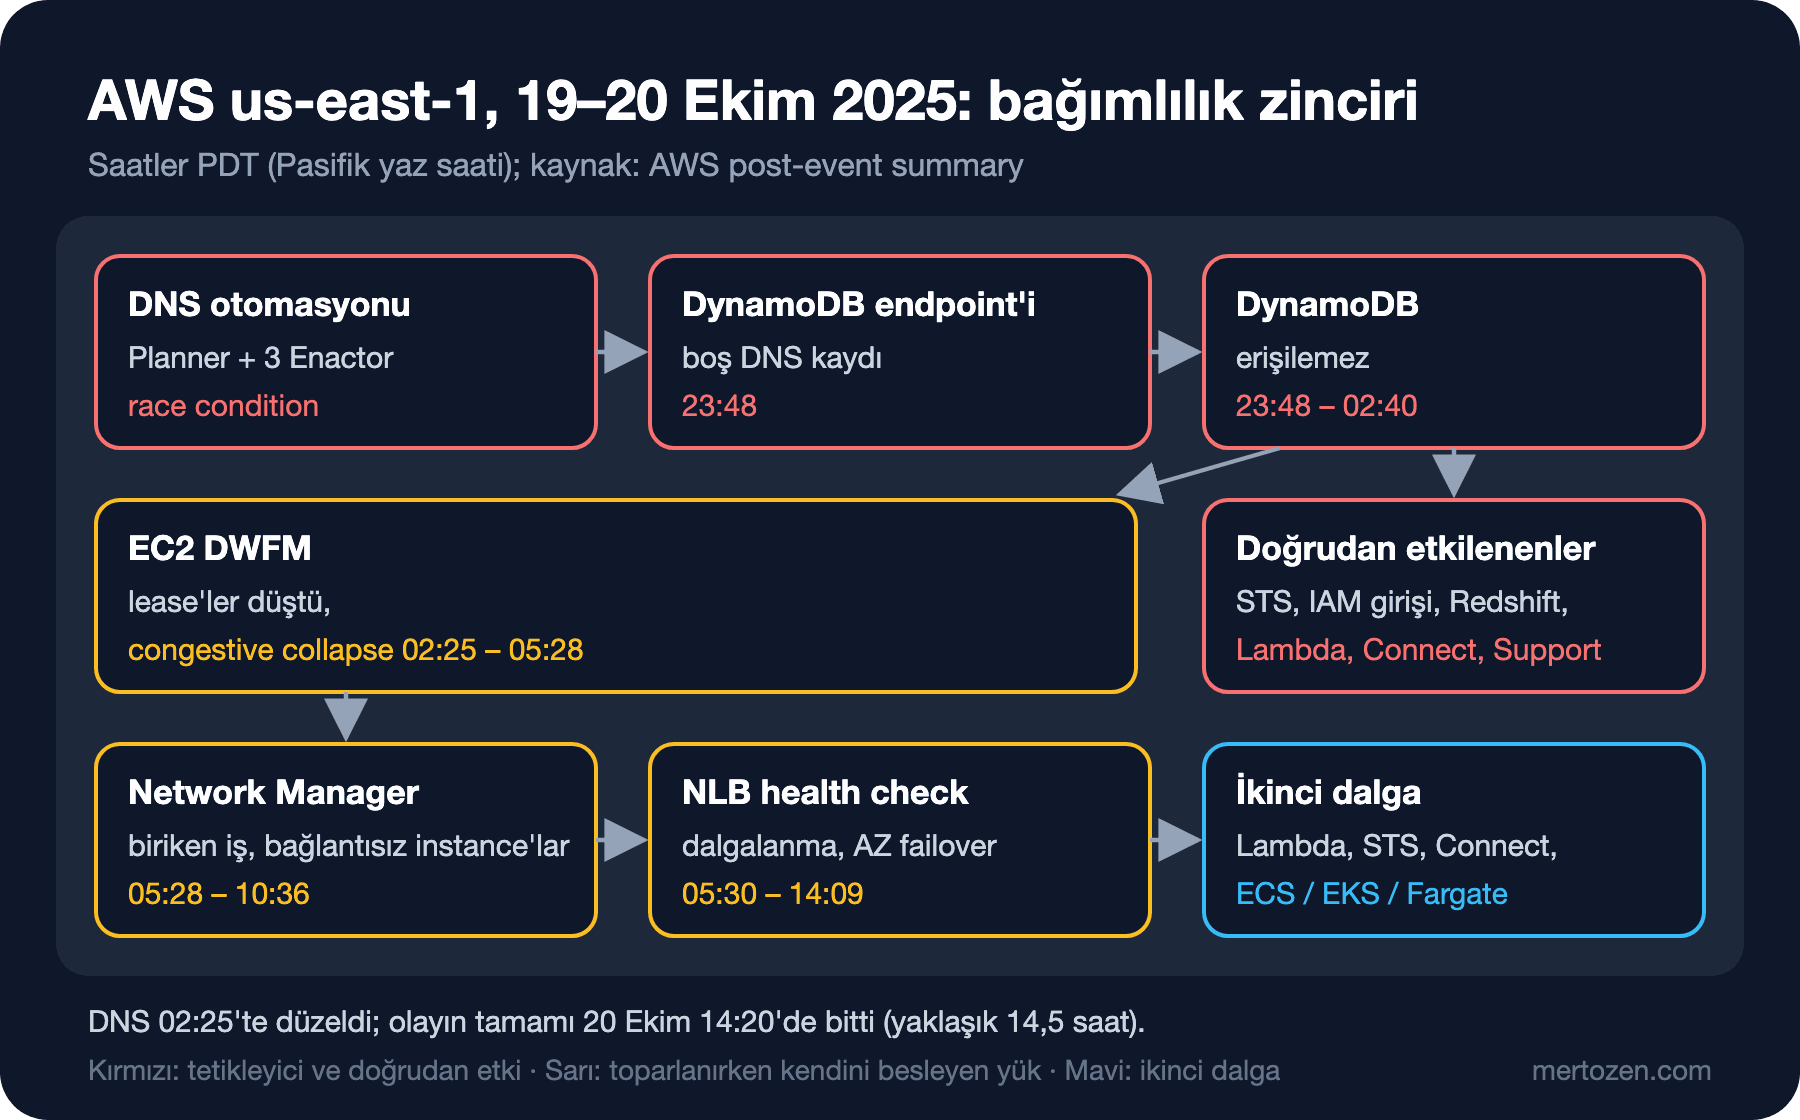
AWS'in açıkladığı ilk adım, DNS Planner ve DNS Enactor otomasyonunu bütün dünyada kapatmak oldu; race condition düzeltilip yanlış planın uygulanmasını engelleyen korumalar eklenmeden yeniden açılmayacak. Ayrıca NLB failover'ına bir hız sınırı ve DWFM'in kurtarma akışını sınayan bir test takımı ekleniyor.
Facebook, 4 Ekim 2021
Facebook'un omurga ağında rutin bir bakım sırasında, global omurga kapasitesini ölçmesi gereken bir komut bütün omurga bağlantılarını kapattı. Böyle komutları denetleyip durdurması gereken audit aracındaki bir hata komutu durduramadı. Veri merkezleri arasındaki bağlantı kopunca ikinci bir mekanizma devreye girdi: Facebook'un DNS sunucuları, veri merkezleriyle konuşamadıklarında kendilerini sağlıksız sayıp BGP (Border Gateway Protocol; internetteki ağların birbirine hangi adreslere ulaşabildiğini duyurduğu protokol) duyurularını geri çekiyordu. Bu bir güvenlik önlemiydi; sonuçta DNS sunucuları çalışıyor ama internetten ulaşılamıyordu.
Kurtarmayı uzatan, normal ağ erişimiyle birlikte out-of-band (normal ağdan bağımsız acil durum) erişimin de gitmesiydi. DNS'in kaybı, teşhis için kullanılan iç araçların birçoğunu da bozdu. Mühendisler veri merkezlerine gönderildi, ama bu binalar tasarım gereği zor girilen yerler ve donanımın fiziksel erişimle bile değiştirilmesi kolay değil. Meta bunu bilerek seçilmiş bir denge olarak anlatıyor: günlük güvenlik için kurulan engeller, nadir bir olayda kurtarmayı yavaşlattı. Servisler geri açılırken de dikkat gerekti: elektrik tüketimi on megavatlar mertebesinde düşmüştü ve yükü bir anda geri vermek elektrik sistemlerinden cache'lere kadar her şeyi riske atabilirdi. Yük, "storm" tatbikatlarının deneyimiyle kademeli verildi; ama hiçbir tatbikat global omurganın kaybını simüle etmemişti.
GitLab.com, 31 Ocak 2017
GitLab.com'un PostgreSQL replikasyonu, spam kaynaklı olduğu düşünülen bir yük artışı sırasında geride kaldı ve primary sunucu, secondary'nin ihtiyaç duyduğu WAL (Write-Ahead Log; veritabanının değişiklik kaydı) dosyalarını çoktan silmişti. Secondary'yi sıfırdan kurmaya çalışan mühendis, gece 23:30 civarında (UTC) veri klasörünü silen komutu secondary'de (db2) çalıştırdığını düşünürken primary'de (db1) çalıştırdı. Bir iki saniye içinde fark edip durdurdu ama yaklaşık 300 GB veri gitmişti.
Asıl ders bundan sonra çıktı. GitLab'ın birkaç ayrı yedekleme ve replikasyon yöntemi vardı ve hiçbiri işe yaramadı. Günlük pg_dump yedekleri, veritabanı 9.6 iken 9.2 sürümlü araçla alınmaya çalışıldığı için hiç oluşmamıştı ve S3 (AWS'in dosya depolama servisi) bucket'ı boştu. Hatayı bildirmesi gereken cron e-postaları DMARC (e-posta göndericisini doğrulayan bir kural seti) ayarı olmadığı için reddedilmişti; kimse yedeklerin alınmadığını bilmiyordu. Azure disk snapshot'ları NFS (ağ üzerinden paylaşılan dosya sistemi) sunucularında açıktı ama veritabanı sunucularında değildi. Replikasyon zaten felaket kurtarma için değil failover için kurulmuştu ve bozuktu. Geriye bir mühendisin aynı gün saat 17:20'de test için elle aldığı, yaklaşık 6 saatlik bir LVM (Linux'ta disk bölümlerini yöneten katman) snapshot'ı kaldı. Restore, yavaş disklerde yaklaşık 18 saat sürdü; GitLab.com yaklaşık 18 saat kapalı kaldı ve o 6 saatte açılan yaklaşık 5.000 proje, 5.000 yorum ve 700 yeni kullanıcı hesabı kayboldu. Git repository'leri kaybolmadı.
GitLab'ın kendi 5 Whys analizinin vardığı yer teknik değil: yedekleme prosedürünün sahibi yoktu, bu yüzden düzenli test edilmiyordu. Düzeltmeler de buna göre: prompt'ta hangi sunucuda olduğunu açıkça gösteren ayar, yedeklerin Prometheus ile izlenmesi, point-in-time recovery, veritabanı sunucularında disk snapshot'ları, restore'ların otomatik test edilmesi ve veri dayanıklılığından sorumlu bir sahip.
Knight Capital, 1 Ağustos 2012
Knight Capital, NYSE'nin (New York Borsası) yeni bir programı için SMARS (şirketin yüksek hızlı emir yönlendirme sistemi) adlı sistemi güncelledi. Yeni kod, 2003'ten beri kullanılmayan ama hâlâ kodda duran ve çağrılabilen "Power Peg" adlı eski bir fonksiyonun yerine geçti ve eskiden Power Peg'i açan bir flag'i yeni anlamıyla yeniden kullandı. Deploy birkaç gün önce elle, sekiz sunucuya tek tek yapıldı; bir teknisyen yeni kodu sekizinci sunucuya kopyalamadı. İkinci bir kişinin kontrolü yoktu ve bunu gerektiren yazılı bir prosedür de yoktu.
Borsa açılmadan önce, saat 08:01'den itibaren (ABD Doğu saati) SMARS'a ve "Power Peg disabled" ifadesine atıf yapan otomatik e-postalar gelmeye başladı; açılışa kadar 97 tane. Bunlar alarm olarak tasarlanmamıştı ve kimse okumadı. Açılışla birlikte sekizinci sunucu, yeni anlamıyla gelen flag'i eski Power Peg'i çalıştırma emri olarak yorumladı ve sınırsız emir göndermeye başladı. Müdahale sırasında ekip yeni kodu, doğru deploy edildiği yedi sunucudan da kaldırdı; bu, Power Peg'in o yedi sunucuda da çalışmasına yol açtı ve durumu kötüleştirdi. SEC kararına göre yaklaşık 45 dakikada 154 hissede 4 milyondan fazla işlem gerçekleşti ve Knight 460 milyon dolardan fazla zarar etti. SEC ayrıca giden emirleri gelenlerle karşılaştıran bir kontrolün, SMARS'ı durdurma prosedürünün ve incident müdahale prosedürünün olmadığını tespit etti ve 12 milyon dolar ceza verdi.
Ortak Temalar
Dört vaka dört farklı teknoloji, ama aynı birkaç pattern'i tekrar ediyor. Birincisi, otomasyonun kendi failure mode'ları (arıza biçimleri). AWS'te dayanıklılık için üç kopya çalışan Enactor'lar, birbirinin işini bozabilecek bir yarış durumu yarattı; Facebook'ta bir komutu durdurması gereken audit aracı hatalıydı. Otomasyon hata yaptığında bunu her yerde ve aynı hızla yapar; AWS'in ilk adımının otomasyonu dünya çapında kapatmak olması bu yüzden.
İkincisi, gizli ve dairesel bağımlılıklar. EC2'nin sunucu yönetimi DynamoDB'ye bağlıydı; Facebook'ta teşhis araçları, kurtarmaya çalışılan DNS'e bağlıydı. Bir bağımlılık haritası yalnız "uygulama neye bağlı?" sorusunu değil, "kurtarma yolu neye bağlı?" sorusunu da cevaplamalı. GitLab'da kurtarma yolu hiç denenmemiş yedeklerdi.
Üçüncüsü, toparlanmanın kendisinin yük olması. DWFM'in lease yenileme işleri zaman aşımına uğrayıp yeniden kuyruğa girdikçe yük arttı; Google'ın bir önceki yazıdaki us-central1 vakası da aynı türden. Literatürde buna metastable failure deniyor: Bronson, Aghayev, Charapko ve Zhu'nun 2021 tarihli "Metastable Failures in Distributed Systems" makalesine göre tetikleyici ortadan kalktıktan sonra da sistemi kötü durumda tutan, genelde retry yüküyle kendini besleyen bir döngü. Çıkış yolu da benzer: gelen işi kısmak (AWS'in 04:14'te yaptığı), backoff ve yükü kademeli geri vermek (Facebook'un yaptığı). Retry ve load shedding'in mekaniği System Design serisinin reliability pattern'leri yazısında.
Dördüncüsü, Knight Capital'ın dersi: deploy'un bütün sunuculara gittiğini doğrulamamak, ölü kodu silmemek, bir flag'i farklı anlamla yeniden kullanmak ve alarm olarak tasarlanmamış bir sinyali (97 e-posta) kimsenin okumaması. Bir de müdahalenin durumu kötüleştirmesi: yeni kodu geri almak eski kodu her yere açtı. Mitigation da bir hipotez; etkisi hemen ölçülmeli.
Bookstore'da Restore Drill
GitLab'ın dersini Bookstore'un SQL Server'ı üzerinde uyguladık. Restore drill, yedekten gerçekten geri dönülebildiğini düzenli olarak kanıtlayan bir prova: yeni bir yedek al, onu asıl veritabanının yanına başka bir adla restore et, tutarlılığını kontrol et, uygulamanın ihtiyaç duyduğu verinin orada olduğunu doğrula, süreleri ölç, sonra sil. Script repoda deploy/drills/restore-drill.sql; önemli kısımları:
/* BookstoreDb için restore drill: yedek al, başka adla restore et, kontrol et, karşılaştır, ölç, sil. */
/* Ayda bir ve yedek işindeki her değişiklikten sonra çalıştır: */
/*   sqlcmd -S <server> -U <user> -C -b -i deploy/drills/restore-drill.sql -v BackupDir="/var/opt/mssql/data" */
/* -b ilk hatada durur; başarısız bir adım zamanlanmış işi (ve alert'ini) de başarısız yapar. */
...
/* 3. VERIFYONLY dosyayı ve checksum'larını okur. Restore'un çalıştığını KANITLAMAZ; bunu 4. adım yapar. */
RESTORE VERIFYONLY FROM DISK = @file WITH CHECKSUM;

/* 4. Asıl veritabanının yanına, başka bir adla restore et. */
DECLARE @data nvarchar(200), @log nvarchar(200);
SELECT @data = name FROM sys.master_files WHERE database_id = DB_ID('$(SourceDb)') AND type = 0;
SELECT @log = name FROM sys.master_files WHERE database_id = DB_ID('$(SourceDb)') AND type = 1;
DECLARE @dataFile nvarchar(400) = N'$(BackupDir)/$(DrillDb).mdf', @logFile nvarchar(400) = N'$(BackupDir)/$(DrillDb)_log.ldf';
SET @t0 = SYSUTCDATETIME();
RESTORE DATABASE [$(DrillDb)] FROM DISK = @file
    WITH MOVE @data TO @dataFile, MOVE @log TO @logFile, REPLACE, CHECKSUM;
SELECT 'restore' AS step, DATEDIFF(MILLISECOND, @t0, SYSUTCDATETIME()) AS ms;
/* 5. Restore edilen veritabanı tutarlı mı? */
SET @t0 = SYSUTCDATETIME();
DBCC CHECKDB ([$(DrillDb)]) WITH NO_INFOMSGS;
SELECT 'checkdb' AS step, DATEDIFF(MILLISECOND, @t0, SYSUTCDATETIME()) AS ms;
...
/* 8. Yedek işi son 26 saatte tam yedek almadıysa drill (ve zamanlanmış işi) başarısız olur: */
/*    sessizce bozulan bir yedek işi, ona ihtiyaç duyduğumuz gün değil, burada bulunur. */
IF NOT EXISTS (SELECT 1 FROM msdb.dbo.backupset
               WHERE database_name = '$(SourceDb)' AND type = 'D' AND name IS DISTINCT FROM 'restore-drill'
                 AND backup_finish_date > DATEADD(HOUR, -26, GETDATE()))
    THROW 50001, 'No full backup of the source database from the backup job in the last 26 hours.', 1;
RESTORE VERIFYONLY tek başına yeterli değil: dosyanın okunabildiğini ve checksum'ların tuttuğunu söyler, restore'un çalıştığını değil. Asıl kanıt 4. ve 5. adımlar. Son adım ise GitLab'ın sessiz yedek hatasına karşılık: yedek işi son 26 saatte tam yedek almadıysa drill hata veriyor ve -b sayesinde sqlcmd sıfırdan farklı bir kodla çıkıyor, yani drill'i çalıştıran zamanlanmış iş ve onun alert'i kırmızıya dönüyor. Laboratuvarda ilk çalıştırmanın sonu:
sqlcmd -S localhost -U sa -C -b -i deploy/drills/restore-drill.sql -v BackupDir="/var/opt/mssql/data" -W
...
table source_rows restored_rows
----- ----------- -------------
ordering.Orders 4787 4787
ordering.OrderItems 4787 4787
ordering.Customers 50 50
inventory.StockItems 20 20
catalog.Books 20 20
step placed_at_utc
---- -------------
newest order in the restore 2026-11-14 22:32:47.3945730
Msg 50001, Level 16, State 1, Server sql, Line 55
No full backup of the source database from the backup job in the last 26 hours.
echo $?
1
Restore çalıştı, satır sayıları tuttu, ama drill kırmızı: laboratuvardaki veritabanının hiç yedeği alınmamıştı, var olan tek yedek drill'in kendi yedeğiydi. Gerçek bir sistemde bu satır "yedek işi aylardır çalışmıyor" demek. Gece yedeğini temsil eden bir tam yedek alıp drill'i tekrar çalıştırdık:
step finished_utc age_minutes
---- ------------ -----------
last full backup 2026-11-14 22:53:48.000 0
Processed 984 pages for database 'BookstoreDb', file 'BookstoreDb' on file 1.
Processed 2 pages for database 'BookstoreDb', file 'BookstoreDb_log' on file 1.
BACKUP DATABASE successfully processed 986 pages in 0.020 seconds (384.960 MB/sec).
step ms
---- --
backup 44
The backup set on file 1 is valid.
Processed 984 pages for database 'BookstoreDb_RestoreDrill', file 'BookstoreDb' on file 1.
Processed 2 pages for database 'BookstoreDb_RestoreDrill', file 'BookstoreDb_log' on file 1.
RESTORE DATABASE successfully processed 986 pages in 0.049 seconds (157.126 MB/sec).
step ms
---- --
restore 266
step ms
---- --
checkdb 111
table source_rows restored_rows
----- ----------- -------------
ordering.Orders 4787 4787
ordering.OrderItems 4787 4787
ordering.Customers 50 50
inventory.StockItems 20 20
catalog.Books 20 20
step placed_at_utc
---- -------------
newest order in the restore 2026-11-14 22:32:47.3945730
echo $?
0
Laboratuvardaki veritabanı yaklaşık 8 MB olduğu için süreler milisaniye mertebesinde; production'da ölçülecek olan bunlar. Restore süresi RTO'nun (Recovery Time Objective; bir kesintiden sonra servisin en geç ne kadar sürede geri gelmesi gerektiği), son yedeğin yaşı da RPO'nun (Recovery Point Objective; kabul edilebilir en fazla veri kaybı) gerçek ölçüsü. Her çalıştırma docs/drills/log.md'ye yazılıyor; ilk satırı yukarıdaki kırmızı sonuç ve onun üzerine eklenen 26 saat kontrolü.
Bağımlılık Haritası ve Break-Glass Erişim
Facebook vakasının dersi, kurtarma yolunun da bağımlılıkları olduğu. Bookstore'un docs/dependencies.md dosyası her bağımlılık için "o olmazsa ne bozulur, bunu nasıl görürüz, hangi kol var" sorularına ek olarak "kurtarma yolu neye bağlı" sütununu taşıyor:
| Dependency | Without it | How we see it | Lever / fallback | The recovery path needs |
|---|---|---|---|---|
| SQL Server (BookstoreDb) | everything fails | checkout SLO pages, /health | none; restore (`deploy/drills/restore-drill.sql`) | backups in a different storage account, a SQL login that is not in the same directory |
| Payment provider | checkout fails | runbook step 3, `http_client_request_duration_seconds` | `Payments:TimeoutSeconds`, `Payments:CheckoutEnabled` | the provider's status page (pinned in `docs/contacts.md`) |
| Prometheus + Alertmanager | no pages | Alertmanager's own watchdog alert at the paging tool | none | paging tool outside our cloud account |
| DNS for bookstore.example.com | nobody reaches us | external synthetic probe | none | registrar login with break-glass account |
| Identity provider (SSO) | staff cannot log in to the cloud console | — | break-glass accounts | `docs/runbooks/break-glass.md` (printed copy in the office safe) |
| Status page | customers do not hear from us | — | post on social accounts | hosted outside our cloud account |
Son satırlar break-glass erişime (normal erişim yolları çalışmadığında kullanılan, önceden hazırlanmış acil durum erişimi) gidiyor. docs/runbooks/break-glass.md iki şeyi önceden hazırlıyor: SSO'ya bağlı olmayan iki hesap ve SSO'nun arkasındaki wiki erişilemezken okunabilecek basılı bir kopya. Her kullanım kendi başına bir incident sayılıyor; hesapların şifreleri kullanımdan sonra değiştiriliyor. Bu runbook da üç ayda bir, ofis ağının dışından baştan sona deneniyor. SSO kesildiğinde ilk kez denenen bir break-glass prosedürü, büyük ihtimalle bir yerinde takılır.
Deploy Doğrulama: Bütün Instance'lar Aynı Sürümde mi?
Knight Capital'ın sekizinci sunucusu bugün çoğu ekipte otomasyonla deploy edildiği için daha az olası, ama tamamen ortadan kalkmış değil: takılan bir rolling update ya da elle müdahale edilen tek bir node aynı sonucu verir. Serinin beşinci yazısındaki runbook'ta kullandığımız target_info serisi her instance'ın sürümünü taşıyor; bunu bir alert'e çevirdik:
# Deploy'dan sonra her instance aynı build'i çalıştırmalı. Bir rollout'tan uzun süren iki sürüm, atlanan bir instance
# (ya da takılan bir rollout) demek: docs/drills/README.md'deki Knight Capital dersi.
groups:
  - name: bookstore-deploy
    rules:
      - alert: MixedVersionsAfterDeploy
        expr: count(count by (service_version) (target_info{job="bookstore-api"})) > 1
        for: 30m
        labels:
          severity: ticket
        annotations:
          summary: "{{ $value }} different Bookstore.Api versions have been running for 30 minutes"
          description: "Versions: {{ range query \"count by (service_version) (target_info{job='bookstore-api'})\" }}{{ .Labels.service_version }} ({{ .Value }} instances) {{ end }}"

promtool test rules deploy/prometheus/tests/deploy-alerts.test.yaml
Processing test file: deploy/prometheus/tests/deploy-alerts.test.yaml
  SUCCESS
Test, üç instance'tan birinin deploy'da güncellenmediği bir senaryoyu oynuyor ve geçiyor. Alert'in 30 dakika beklemesi, normal bir rolling update'in kısa süreli iki sürümlü hâlini page'e çevirmemek için. Knight'ın asıl dersi ise ölü kodla ilgili: kullanılmayan bir özelliğin kodunu silmek ve bir flag'e yeni bir anlam vermek yerine yeni bir flag açmak.
Üretimde Dikkat
Drill'i zamanlanmış bir iş yap ve sonucunu bir alert'e bağla. Bir kere elle yapılan restore denemesi, altı ay sonra değişen bir yedek ayarını yakalamaz.
Otomasyona bir durdurma düğmesi koy. AWS'in yaptığı gibi bir otomasyonu hızla ve her yerde kapatabilmek, otomasyonun kendisi kadar önemli; bu düğmenin nerede olduğu runbook'ta yazmalı.
Toparlanmayı da planla. Uzun bir kesintiden sonra bütün istemciler aynı anda geri gelir; gelen işi kısma ve trafiği kademeli açma adımları önceden runbook'ta olmalı.
Sık Düşülen Tuzaklar
"Yedeğimiz var" demek. Restore edilmemiş bir yedek bir umut. Ölçüt, son başarılı restore drill'inin tarihi.
Hata bildirimini kanıt saymak. GitLab'da hata e-postaları hiç ulaşmadı. "Hata gelmedi" ile "başarılı" aynı şey değil; başarıyı pozitif bir sinyalle ölç (son yedeğin yaşı).
Prod ve test'i aynı terminalde karıştırmak. GitLab'ın düzeltmelerinden biri prompt'ta sunucu ve ortamın açıkça görünmesiydi; küçük ama yanlış sunucuda komut çalıştırmayı zorlaştıran bir önlem.
Küçük Bir Deneme
★☆☆ Kendi sisteminin docs/dependencies.md'sini yaz ve her satırda "kurtarma yolu neye bağlı?" sütununu doldur. Bu sütunda kurtarmaya çalıştığın sistemin kendisi geçiyor mu?
★★☆ restore-drill.sql'e bir adım ekle: restore edilen veritabanında son 24 saatte verilmiş sipariş sayısını asıl veritabanındakiyle karşılaştır ve fark yüzde 1'i aşarsa THROW ile hata ver.
★★★ Laboratuvarda Bookstore.Api'nin iki instance'ını farklı commit'lerden build edip çalıştır ve MixedVersionsAfterDeploy alert'inin description'ında iki sürümü gör. Sonra alert'i promtool testindeki gibi 30 dakika yerine kendi rolling update süreni ölçerek ayarla.
Bu iki yazıdaki yedi vakanın ortak dersi, arızaların çoğunun hiç denenmemiş bir yolda çıktığı: denenmemiş bir kod yolu, denenmemiş bir config, denenmemiş bir yedek, denenmemiş bir kurtarma. Serinin son yazısında bu yolları kasıtlı olarak, kontrollü biçimde denemeyi anlatıyoruz: game day ve Polly'nin chaos strategy'leriyle Bookstore'un ödeme client'ına hata enjekte etmek.