

OpenTelemetry Collector: Receiver, Processor, Exporter, Tail Sampling ve PII Filtreleme

OpenTelemetry Collector, uygulamayı backend'den ayıran ve telemetry'yi receiver, processor ve exporter'lardan oluşan pipeline'larla alıp işleyen ayrı bir process'tir. Bookstore için tek container'lık bir LGTM stack'inde Collector'ı kuruyor, gereksiz log'ları filtreliyor, e-posta adresini hash'liyor, tail sampling ile hatalı ve yavaş trace'leri tutuyor ve head sampling'in şikâyet edilen siparişlerin yüzde 90'ını nasıl attığını ölçüyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10, OpenTelemetry .NET 1.21 ve grafana/otel-lgtm 0.41.0 image'ı (OpenTelemetry Collector contrib 0.165.0, Prometheus 3.16.0, Tempo 3.1.1, Loki 3.7.9, Grafana 13.3.0) ile Docker Desktop üzerinde denenmiştir.
Önce Tahmin Et
Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) 200 siparişlik bir trafiği yaklaşık 1.000 trace üretiyor: her sipariş için sepet oluşturma, kitap ekleme ve siparişin kendisi. Bunların yüzde 10'unu saklamak istiyorsun. İki yol var: SDK'da "her 10 trace'ten birini kaydet" demek ya da her şeyi bir Collector'a gönderip orada "hataları, yavaşları ve geri kalanın yüzde 10'unu sakla" demek. İkisi de yaklaşık aynı sayıda trace saklar. Peki checkout'un 5 saniyeyi aşan, şikâyet edilen siparişlerinin kaçı her iki yolda da elinde kalır? İkisini aynı trafikle denedik.
Neden Collector?
Şimdiye kadar uygulama telemetry'yi doğrudan bir backend'e (Aspire Dashboard) gönderdi. Production'da araya bir OpenTelemetry Collector koymanın sebepleri somut. Uygulama yalnızca "telemetry'yi şu adrese OTLP (OpenTelemetry Protocol; telemetry taşıma protokolü) ile ver" bilir; hangi backend'e gideceği, kaç backend'e gideceği, hangi verinin atılacağı Collector'ın config'inde. Backend değiştirmek uygulamayı yeniden deploy etmeyi gerektirmez. Backend yavaşladığında ya da düştüğünde retry ve kuyruklama Collector'da yapılır; uygulamanın belleği telemetry kuyruğuyla dolmaz. Filtreleme, örnekleme ve kişisel verinin temizlenmesi tek yerde, dilden bağımsız yapılır: .NET servisi de, bir Go servisi de aynı kurallardan geçer. Ve aynı veri birden çok yere gönderilebilir (fan-out): metric'ler hem Prometheus'a hem bir APM (Application Performance Monitoring; uygulama performansını izleyen ürün) servisine gibi.
Collector'ın iki dağıtımı yaygın. Core dağıtımı yalnızca temel bileşenleri (OTLP receiver ve exporter, batch, memory_limiter, debug) içeriyor. Contrib dağıtımı ise topluluğun yazdığı yüzlerce bileşeni: tail sampling, filter, transform, prometheus receiver, loadbalancing exporter ve vendor exporter'ları. Bu yazıdaki config contrib gerektiriyor. Production'da contrib'in tamamını taşımak yerine Collector Builder (ocb) ile yalnız kullandığın bileşenlerden kendi dağıtımını derlemek de bir seçenek; attack surface'i (saldırıya açık bileşenlerin toplamı) ve image boyutunu küçültür.
Yerel Stack: Tek Container'da LGTM
Gerçek bir kurulumda Collector, Prometheus, Grafana, Tempo ve Loki ayrı process'ler ve çoğu zaman ayrı container'lar. Yerelde hepsini ayrı ayrı kaldırmak yerine Grafana'nın geliştirme ve demo için yayınladığı grafana/otel-lgtm image'ını kullandık. Adı Loki, Grafana, Tempo ve Mimir'in baş harflerinden geliyor; image'da Mimir yerine Prometheus ve bir contrib Collector var, hepsi tek container'da. Image'ın kendi Collector config'i var; biz onun yerine kendi config'imizi bağladık:
# Bookstore için lokal observability stack'i: OpenTelemetry Collector (contrib), Prometheus, Tempo,
# Loki ve Grafana tek container'da. Yalnızca geliştirme için.
#   docker compose -f deploy/observability/compose.yaml up -d
#   API: OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4317   Grafana: http://localhost:3000
services:
  lgtm:
    image: grafana/otel-lgtm:0.41.0
    container_name: bookstore-lgtm
    ports:
      - "3000:3000"   # Grafana
      - "4317:4317"   # OTLP/gRPC
      - "4318:4318"   # OTLP/HTTP
      - "9090:9090"   # Prometheus
      - "3200:3200"   # Tempo API
      - "3100:3100"   # Loki API
    environment:
      # Collector log'ları (ve debug exporter'ın çıktısı) docker logs'a gider
      ENABLE_LOGS_OTELCOL: "true"
    volumes:
      - ./otelcol-config.yaml:/otel-lgtm/otelcol-config.yaml:ro
Container açılırken bileşenlerin sürümlerini yazıyor:
Starting grafana/otel-lgtm v0.41.0
Running Grafana v13.3.0 logging=false
Running Loki v3.7.9 logging=false
Running OpenTelemetry Collector v0.165.0 logging=true
Running Prometheus v3.16.0 logging=false
Running Tempo v3.1.1 logging=false
Uygulama tarafında değişen hiçbir şey yok: OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4317, artık dashboard'un değil Collector'ın portu.
Config: Receiver, Processor, Exporter, Pipeline
Collector config'i dört bölümden oluşuyor. Receiver'lar veriyi alıyor, processor'lar işliyor, exporter'lar gönderiyor; service.pipelines ise bunları sinyal bazında sıraya diziyor. Bir bileşeni tanımlamak onu çalıştırmıyor; ancak bir pipeline'da kullanılırsa devreye giriyor.
# Bookstore'un lokal Collector'ı. grafana/otel-lgtm içindeki Collector config'inin yerine geçer;
# exporter'lar aynı container'da çalışan Tempo, Prometheus ve Loki'yi gösterir.
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318
  # Collector'ın kendi metric'leri (8888 portu): ne aldığını, ne attığını, neyi örneklediğini görmek için.
  prometheus/collector:
    config:
      scrape_configs:
        - job_name: otel-collector
          scrape_interval: 10s
          static_configs:
            - targets: ["127.0.0.1:8888"]

processors:
  # Her pipeline'da ilk sırada: process'in belleği bitmeden önce veriyi reddeder.
  memory_limiter:
    check_interval: 1s
    limit_percentage: 80
    spike_limit_percentage: 20

  # Uygulama unutmuş olsa bile her sinyale ortam bilgisi eklenir.
  resource:
    attributes:
      - key: deployment.environment.name
        value: local
        action: insert

  # HttpClient her çağrı için dört Information log'u yazıyor; span'lar aynı bilgiyi zaten veriyor.
  filter/http-client-logs:
    error_mode: ignore
    log_conditions:
      - IsMatch(instrumentation_scope.name, "^System\\.Net\\.Http\\.HttpClient\\.") and log.severity_number < SEVERITY_NUMBER_WARN

  # PII: e-posta adresi hash'lenir (gruplanabilir ama okunamaz); body'deki diğer adresler maskelenir.
  transform/pii:
    error_mode: ignore
    log_statements:
      - set(log.attributes["CustomerEmail"], SHA256(log.attributes["CustomerEmail"])) where log.attributes["CustomerEmail"] != nil
      - replace_pattern(log.body, "[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\\.[A-Za-z]{2,}", "<email>")

  # Her hatayı, 1 saniyeden yavaş her trace'i ve geri kalanın yüzde 10'unu sakla.
  tail_sampling:
    decision_wait: 10s
    num_traces: 50000
    policies:
      - name: errors
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: slow
        type: latency
        latency:
          threshold_ms: 1000
      - name: ten-percent
        type: probabilistic
        probabilistic:
          sampling_percentage: 10

  batch:

exporters:
  otlp_http/tempo:
    endpoint: http://127.0.0.1:4418
  otlp_http/prometheus:
    endpoint: http://127.0.0.1:9090/api/v1/otlp
  otlp_http/loki:
    endpoint: http://127.0.0.1:3100/otlp
  debug:
    verbosity: basic

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, resource, tail_sampling, batch]
      exporters: [otlp_http/tempo]
    metrics:
      receivers: [otlp, prometheus/collector]
      processors: [memory_limiter, resource, batch]
      exporters: [otlp_http/prometheus]
    logs:
      receivers: [otlp]
      processors: [memory_limiter, resource, filter/http-client-logs, transform/pii, batch]
      exporters: [otlp_http/loki, debug]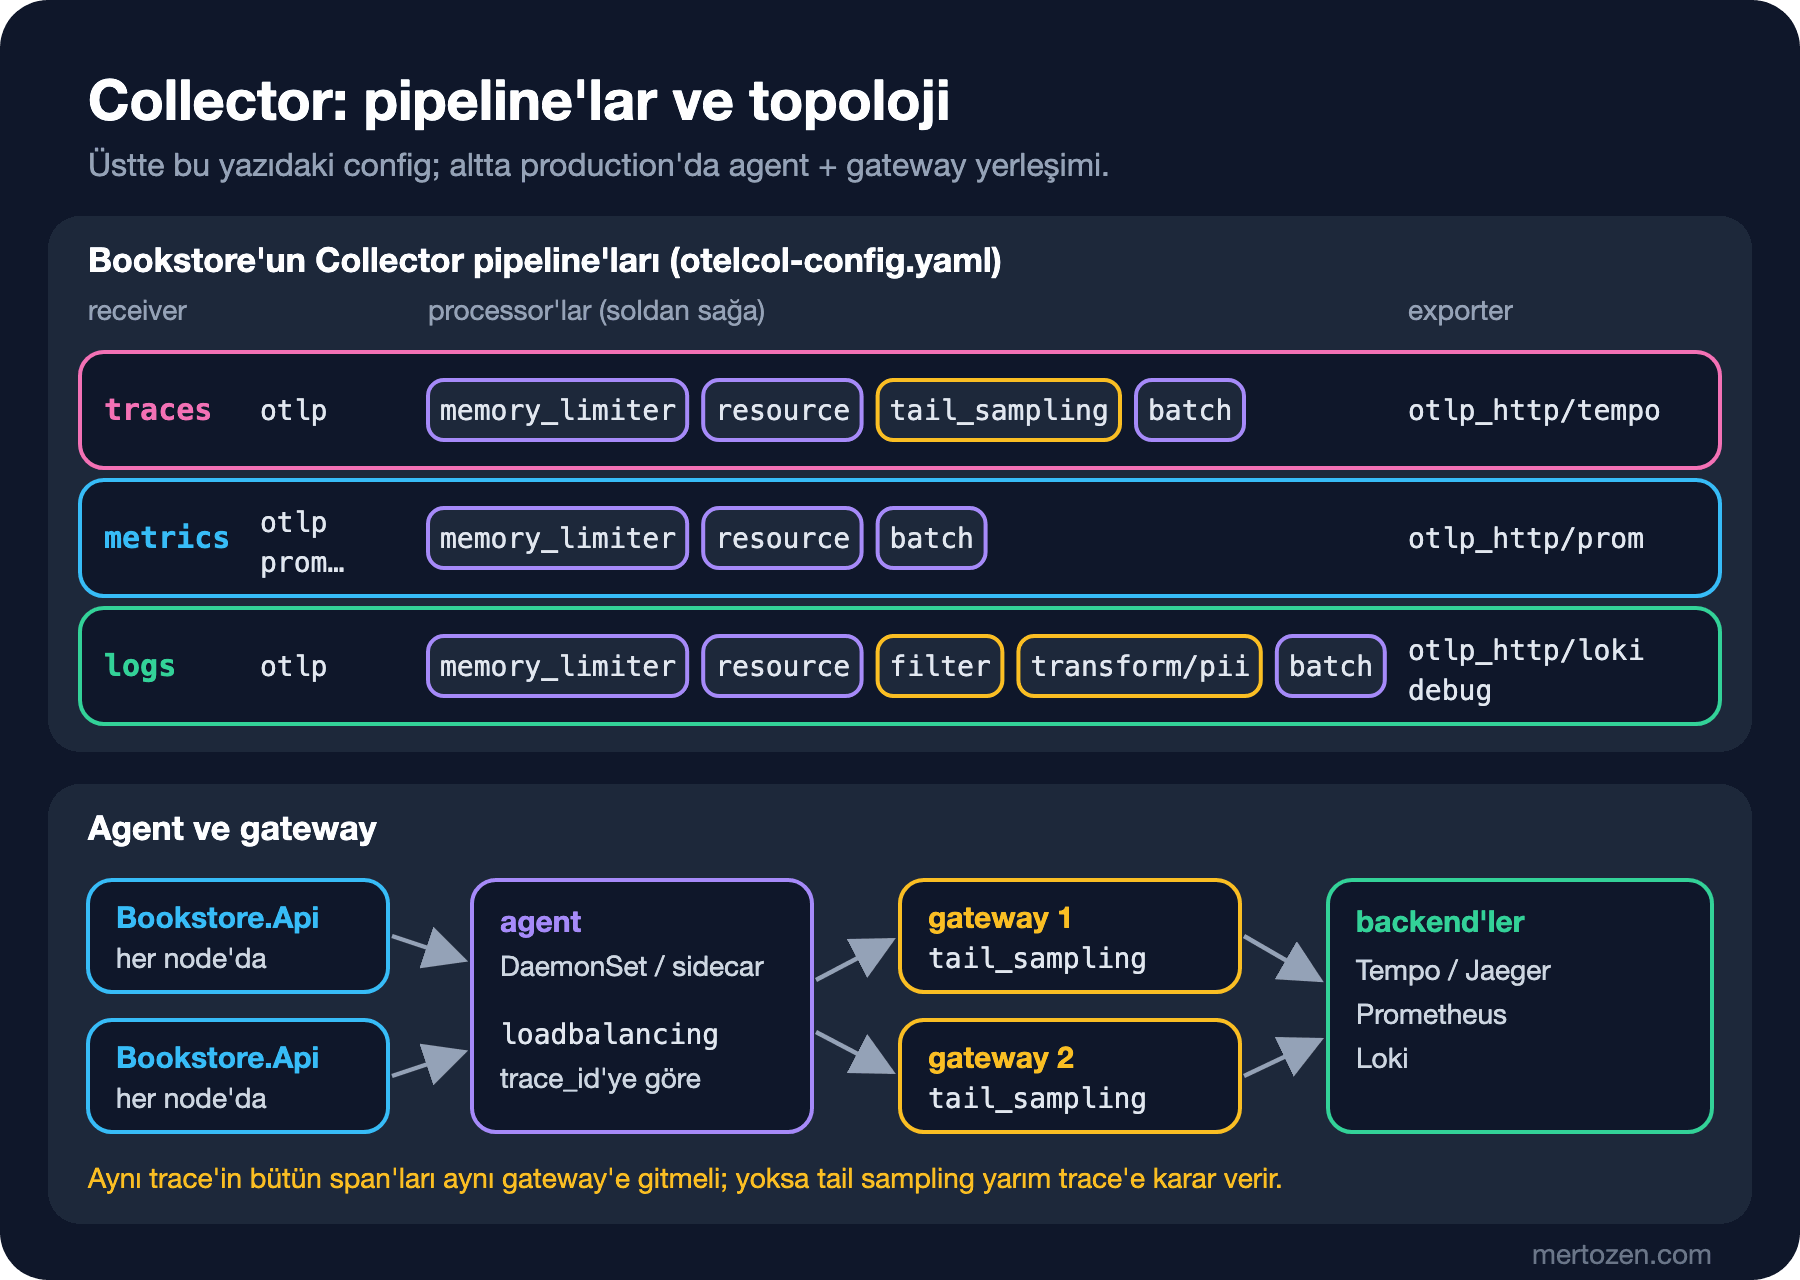
Processor'ların sırası anlamlı. memory_limiter en başta: bellek sınıra yaklaşınca receiver'a hata döndürüp veriyi reddediyor ve SDK'nın exporter'ı retry ediyor. batch en sonda, atılacak veri atıldıktan sonra: filtrelenecek ya da örneklenecek veriyi batch'lemek boşa iş. Contrib 0.165'te exporter'ların adları otlp_http ve otlp_grpc; eski config'lerde otlphttp görürsün. Batch processor hâlâ beta ve yaygın; Collector'ın exporter tarafındaki sending_queue'ya da bir batch ayarı geldi, ikisini aynı pipeline'da birlikte açarsan Collector açılışta uyarı veriyor.
Config'teki ifadeler OTTL (OpenTelemetry Transformation Language; Collector'ın telemetry üzerinde koşul ve dönüşüm yazmak için kullandığı dil) ile yazılıyor. filter processor'ında koşul doğruysa kayıt atılıyor; transform'da her satır bir ifade. Yollar bağlama göre: log için log.attributes, log.body, log.severity_number; scope için instrumentation_scope.name; resource için resource.attributes.
Sayılarla: Collector Ne Aldı, Ne Gönderdi?
200 siparişlik trafiği çalıştırdık ve Collector'ın kendi metric'lerine Prometheus'tan baktık (config'teki prometheus/collector receiver'ı bunları her 10 saniyede topluyor):
orders=200 concurrency=4
status: 201=199, 502=1
POST /api/orders ms: avg=932 p50=123 p95=2701 p99=7604 max=9572

otelcol_receiver_accepted_spans_total{receiver="otlp"}                       7559
otelcol_exporter_sent_spans_total{exporter="otlp_http/tempo"}                1876
otelcol_receiver_accepted_log_records_total{receiver="otlp"}                 1665
otelcol_processor_filter_logs_filtered_total                                  863
otelcol_exporter_sent_log_records_total{exporter="otlp_http/loki"}            802
otelcol_processor_tail_sampling_new_trace_id_received_total                  1027
otelcol_processor_tail_sampling_global_count_traces_sampled_total{sampled="true"}   153
otelcol_processor_tail_sampling_count_traces_sampled_total{policy="errors",sampled="true"}       52
otelcol_processor_tail_sampling_count_traces_sampled_total{policy="slow",sampled="true"}         52
otelcol_processor_tail_sampling_count_traces_sampled_total{policy="ten-percent",sampled="true"} 105
Log'ların yarısından fazlası (1.665'ten 863'ü) filtreye takıldı; hepsi HttpClient'ın "Start processing", "Sending", "Received", "End processing" satırlarıydı. Span'lar 7.559'dan 1.876'ya, yaklaşık dörtte bire indi. 1.027 trace'in 153'ü saklandı. Policy sayıları toplanmıyor, çünkü bir trace birden çok policy'ye uyabilir: yavaş olan 52 trace'in hepsinde zaman aşımına uğramış bir HTTP denemesi, yani ERROR status'lu bir span var. Bu yüzden errors ve slow aynı 52 trace'i seçti. Başarılı sonuçlanan bir siparişin trace'inin "hata" policy'sine takılması ilk bakışta tuhaf; ama tam da istediğimiz şey: retry'la kurtarılmış bir hata, en çok incelemek isteyeceğin şeylerden biri.
Head Sampling ve Tail Sampling
Önce Tahmin Et'teki karşılaştırmanın ikinci yarısı. Aynı uygulamayı SDK tarafında örnekleme yapacak şekilde, yalnız iki environment variable ile başlattık:
$env:OTEL_TRACES_SAMPLER = "parentbased_traceidratio"
$env:OTEL_TRACES_SAMPLER_ARG = "0.1"
Head sampling, kararı trace'in başında, kök span açılırken veriyor: trace id'ye bakıp yüzde 10'a düşenleri kaydediyor, gerisini hiç üretmiyor. parentbased ön eki, bir parent varsa onun kararına uyulmasını sağlıyor; böylece bir trace'in bir servis tarafından kaydedilip diğeri tarafından atılması önleniyor. Aynı 200 siparişlik trafikten sonra Collector'a 1.027 yerine 108 trace geldi; span sayısı 812. Tail sampling policy'leri bu 108 trace'e de uygulandı ve errors sayacı yalnızca 52'den 53'e çıktı. Yani bu koşuda 48 sipariş 2 saniyeyi geçti, ama head sampling yüzünden bunların yalnızca birinin trace'i Collector'a ulaştı. Önce Tahmin Et'in cevabı: iki yol da yaklaşık aynı sayıda trace saklıyor, ama head sampling şikâyet edilen siparişlerin yaklaşık yüzde 90'ını, kim oldukları bilinmeden atıyor; tail sampling ise hepsini tutuyor.
Tail sampling'in de bir bedeli var. Karar verebilmek için trace'in bütün span'larını görmesi gerekiyor; bu yüzden span'ları decision_wait süresi (bizde 10 saniye) boyunca bellekte tutuyor. Collector'ın belleği, saniyedeki trace sayısı ile bu sürenin çarpımıyla büyüyor; num_traces da bellekte tutulabilecek trace sayısının üst sınırı. Daha önemli kısıt şu: bir trace'in bütün span'ları aynı Collector instance'ına gelmeli. Bookstore'un tek bir API'si olduğu sürece sorun yok; ama checkout birden çok servise yayıldığında ve önünde birden çok Collector olduğunda, span'lar farklı instance'lara dağılır ve her biri trace'in yarısına karar verir. Çözüm iki katmanlı bir yerleşim: ilk katmandaki Collector'lar loadbalancing exporter'ı ile span'ları trace id'ye göre ikinci katmana dağıtıyor, tail sampling ikinci katmanda yapılıyor. Bu iki katmanlı kurulumu çalıştırmadık; yukarıdaki görselin alt kısmı tail sampling processor'ının README'sindeki öneriye dayanıyor.
Pratikte ikisi birlikte kullanılıyor: SDK'da yüksek bir oranla (ya da hiç) head sampling, Collector'da tail sampling. Head sampling ağ ve Collector maliyetini düşürüyor, tail sampling ise neyin saklanacağına akıllıca karar veriyor.
PII: Telemetry'den Kişisel Veriyi Temizlemek
Bir önceki yazıda eklediğimiz onay e-postası gönderen service'in log satırı şu: "Order confirmation for order {OrderId} sent to {CustomerEmail}". Geliştirme sırasında masum görünen bu satır, müşterinin e-posta adresini log backend'ine taşıyor; KVKK (Kişisel Verilerin Korunması Kanunu) kapsamında kişisel veri. Doğru düzeltme uygulamada: adresi log'lamamak ya da .NET'te Logging serisinin redaction yazısında anlatılan şekilde maskelemek. Collector ise bir emniyet ağı: uygulamada unutulan bir alanı tek yerde, bütün servisler için yakalıyor. Config'teki transform/pii sonrası Loki'deki kayıt:
{"CustomerEmail": "abf525f3b1abf243ae2df2310e315382cd8c0c5cd1a012f23ecafd58d4d02e39", "OrderId": "1373",
 "deployment_environment_name": "development", "scope_name": "Bookstore.Notifications.OrderConfirmationSender",
 "service_name": "bookstore-api", "severity_text": "Information", "span_id": "e6ff133160c4ec83",
 "trace_id": "f212b96ae18830980535a1a2f6c26564", ...}
Order confirmation for order {OrderId} sent to {CustomerEmail}
Üç şey dikkat çekiyor. E-posta artık SHA (Secure Hash Algorithm; kriptografik hash algoritmaları ailesi) ailesinden SHA-256 ile üretilmiş bir hash: aynı müşterinin kayıtları hâlâ birbirine bağlanabiliyor ama adres okunamıyor. Bu tam bir anonimleştirme değil; e-posta adresleri tahmin edilebilir değerler olduğu için bilinen bir adresin hash'i hesaplanıp eşleştirilebilir. Hash'e gizli bir salt eklemek ya da alanı tamamen silmek (delete_key) daha güvenli. İkincisi, body formatlanmış mesaj değil template olduğu için adresi içermiyor; IncludeFormattedMessage açık olsaydı body'deki adresi replace_pattern satırı <email> ile değiştirecekti. Üçüncüsü, deployment_environment_name hâlâ development: resource processor'ındaki action: insert yalnızca eksik olan attribute'u ekliyor, var olanı ezmiyor. Ezmek istersen upsert var; ama uygulamanın kendi söylediğini Collector'da sessizce değiştirmek, ileride kafa karıştırır.
Dikkat edilmesi gereken bir yer daha: tail sampling bir trace'i attığında o trace'e ait log'lar Loki'de duruyor. Log'daki trace_id artık hiçbir trace'e götürmüyor. Bu bir hata değil, iki sinyalin ayrı örneklenmesinin doğal sonucu; log'dan trace'e geçişte "trace bulunamadı" görürsen önce sampling'i düşün.
Agent mı Gateway mi?
Collector iki rolde çalışabiliyor. Agent, uygulamanın yanında çalışan Collector: Kubernetes'te her node'da bir DaemonSet ya da her pod'da bir sidecar. Uygulama telemetry'yi localhost'a ya da node'daki agent'a veriyor; ağ gecikmesi düşük, uygulama hızlıca kurtuluyor. Agent, host ve Kubernetes metadata'sını (pod adı, namespace) eklemek, node'un kendi metric'lerini toplamak için de doğru yer. Gateway ise bir servis olarak merkezde çalışan, bir load balancer'ın arkasında birden çok kopyası olan Collector havuzu: backend'lere giden kimlik bilgileri, tail sampling, ağır transform'lar ve birden çok backend'e dağıtım orada. Küçük bir kurulumda yalnızca gateway yeterli; ölçek büyüdükçe ikisi birlikte kullanılıyor. Kubernetes tarafındaki ayrıntılar (DaemonSet, OpenTelemetry Operator) serinin production yazısında.
Üretimde Dikkat
Collector'ın kendisini izle. Bu yazıdaki otelcol_receiver_accepted_*, otelcol_exporter_sent_* ve gönderilemeyenleri sayan otelcol_exporter_send_failed_* metric'leri, telemetry pipeline'ının sağlık göstergesi. Collector'ın kendisi sessizce veri düşürüyorsa ilk fark edeceğin yer burası.
memory_limiter'ı her pipeline'ın başına koy ve container'ın bellek sınırıyla uyumlu ayarla. Processor'ın README'si, bellek sınırı verilebilen container ortamlarında limit_percentage'ı, sınırsız çalışan bare metal ve VM kurulumlarında ise beklenen yüke göre limit_mib'i öneriyor. Container'a bellek sınırı vermeden yüzde ile ayarlamak, sınırı makinenin belleğine bağlar.
Collector'ın OTLP portlarını yalnızca iç ağa aç. Bu yazıdaki config TLS (ağ trafiğini şifreleyen protokol) ve authentication kullanmıyor; lokal makine için yeterli, ama ağa açık bir Collector'a herkes telemetry yazabilir, sahte veri ve maliyet saldırısı demek.
Exporter'larda sending_queue ve retry_on_failure varsayılan olarak açık ama kuyruk bellekte. Collector yeniden başlarsa kuyruktaki veri kaybolur; kaybın kabul edilemediği yerde kalıcı kuyruk (file storage extension) gerekiyor.
Sık Düşülen Tuzaklar
Tail sampling'i birden çok Collector kopyasının önünde load balancing olmadan çalıştırmak. Her kopya trace'in bir parçasını görür, hata içeren parçayı gören saklar, diğeri atar; backend'de yarım trace'ler birikir.
Processor'ı tanımlayıp pipeline'a eklemeyi unutmak. Tanım tek başına bir şey yapmaz ve Collector bunun için hata vermez; filtrelediğini sandığın veri backend'e gitmeye devam eder. Collector'ın otelcol_processor_incoming_items_total metric'inde processor'ın adı görünmüyorsa çalışmıyordur.
PII'yi (Personally Identifiable Information; kişiyi tanımlayan bilgi) yalnızca Collector'a bırakmak. Collector bilinen alanları ve kalıpları yakalar; bilinmeyen bir alana yazılmış bir T.C. kimlik numarasını yakalamaz. Asıl kontrol uygulamada, log ve span'a ne yazdığında.
Debug exporter'ı verbosity: detailed ile production'da bırakmak. Her kaydı stdout'a yazar; container log'u Collector'ın kendisinden daha pahalı hâle gelir. Bu yazıda basic kullandık, o da yalnızca sayıları yazıyor.
Küçük Bir Deneme
★☆☆ filter/http-client-logs'u logs pipeline'ından çıkar, aynı trafiği çalıştır ve otelcol_exporter_sent_log_records_total'daki farkı ölç. Bu oranı günde bir milyon siparişe çevir.
★★☆ ten-percent policy'sini sampling_percentage: 1 yap ve slow policy'sine upper_threshold_ms ekleyerek yalnızca 5 saniyeyi geçen trace'leri seç. Saklanan trace sayısı ve Tempo'daki checkout trace'leri nasıl değişiyor?
★★★ transform/pii'deki SHA256'yı bir salt ile kullan (salt'ı bir environment variable'dan okuyarak, ${env:...} sözdizimiyle) ve aynı e-postanın iki farklı salt ile farklı hash ürettiğini Loki'de doğrula.
Telemetry artık bir pipeline'dan geçiyor ve metric'ler Prometheus'ta. Bir sonraki yazıda Prometheus'u ayrıntılı ele alıyoruz: scrape mi push mu, .NET'ten Prometheus'a iki yol, PromQL ile rate, histogram_quantile ve hata oranı, recording rule'lar, native histogram'lar ve OpenTelemetry adlarının Prometheus'a çevrilirken nasıl değiştiği.