

Grafana ile Dashboard: RED ve USE Dashboard'ları, Variable'lar, Exemplar ile Metric'ten Trace'e ve Dashboard as Code

İyi bir Grafana dashboard'u tek bir soruya cevap verir: RED servisin sağlığını, USE kaynakların doygunluğunu gösterir. Bookstore için iki dashboard'u JSON olarak Git'te tutup provisioning ile yüklüyor, variable'ları target_info'dan besliyor ve exemplar ile p99 sıçramasından yavaş isteğin trace'ine geçiyoruz; tail sampling'in exemplar'ları neden boşa düşürdüğünü de ölçüyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10, OpenTelemetry .NET 1.21 ve grafana/otel-lgtm 0.41.0 image'ı (Grafana 13.3.0, Prometheus 3.16.0, Tempo 3.1.1, Loki 3.7.9, OpenTelemetry Collector contrib 0.165.0) ile denenmiştir.
Önce Tahmin Et
Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) checkout süresini gösteren p99 grafiğinde exemplar'ları açtık: çizgilerin üstünde, her biri tek bir isteği temsil eden küçük noktalar. 1.200 siparişlik bir koşudan sonra Prometheus checkout route'u için 119 exemplar döndürdü. Her birinin trace id'sini Tempo'ya sorduk. 1 saniyeden yavaş 51 exemplar'ın 51'i de trace'ine açıldı; 1 saniyeden hızlı 68 exemplar'ın yalnızca 5'i açıldı, 63'ü "trace not found" verdi. Exemplar'lar mı bozuk, Tempo mu veri kaybediyor? Cevap ikisi de değil; exemplar bölümünde.
Data Source'lar ve Hazır Stack
Collector yazısında kurduğumuz grafana/otel-lgtm container'ı Grafana'yı üç data source tanımlı olarak başlatıyor: Prometheus (metric), Tempo (trace) ve Loki (log). Bunlar image içindeki bir provisioning dosyasından geliyor ve aralarındaki köprüler de orada tanımlı: Prometheus'taki exemplar'ın trace_id label'ı Tempo'ya, Tempo'daki bir span da aynı trace_id ile Loki'deki log satırlarına bağlanıyor. Kendi ortamında bu stack'i kullanmıyorsan aynı ayarları data source ekranından ya da kendi provisioning dosyanla vermen gerekiyor; yoksa exemplar noktaları görünür ama tıklanınca bir yere gitmez.
Prometheus data source'unun bir ayarına dikkat: timeInterval, yani "scrape interval". otel-lgtm bunu 60 saniye olarak veriyor. Bizim uygulama ise metric'leri OTLP (OpenTelemetry Protocol; telemetry taşıma protokolü) ile 15 saniyede bir gönderiyor (OTEL_METRIC_EXPORT_INTERVAL=15000). Grafana $__rate_interval'i bu ayara göre hesapladığı için ilk ekran görüntümüzde grafikler dakikada bir noktadan oluşuyordu ve 2,5 dakikalık bir koşu üç noktaya sığdı. Çözüm iki yerden biri: data source'taki değeri gerçek gönderim aralığına çekmek ya da panelde "interval": "15s" (Min interval) vermek. Biz dashboard dosyasında ikincisini yaptık.
Doğru Panel Türünü Seçmek
Bir panelin türü, sorunun cevabını görünür kılmak ya da gizlemek arasındaki fark. Bookstore dashboard'unda kullandığımız kurallar şunlar:
- Tek sayı ve trendi (istek hızı, hata oranı, dakikadaki sipariş): stat, arkasında küçük bir trend çizgisiyle.
- Zamanla değişen hız ve oranlar: time series. Hata oranı için her zaman oran, ham sayı değil.
- Süre dağılımı: histogram bucket'larından heatmap. Yüzdelik çizgileri dağılımın yalnızca birkaç noktasını gösterir; heatmap bütününü.
- Kategorilere göre adet (sipariş tipi): yığılmış çubuk.
- Süre için gauge ve pasta grafik kullanmıyoruz; ikisi de zaman boyutunu kaybediyor.
Heatmap'te bir ayrıntı var. Prometheus'taki bucket'lar kümülatif sayaç; Grafana'nın bunları doğru çizmesi için sorgunun format'ı heatmap olmalı ve panelin kendi bucket hesabı (calculate) kapalı olmalı. Sorgu da sum by (le) (increase(bookstore_checkout_duration_seconds_bucket[$__rate_interval])). Aşağıdaki görselde sağ ortadaki panel bu: 0,05–0,25 saniye aralığı ve 2,5–7,5 saniye aralığı dolu, 0,5 ile 2,5 saniye arası tamamen boş. Ortada boşluk olan iki tepeli bir dağılım; yüzdelik çizgisi bunu göstermez, heatmap ilk bakışta gösteriyor.
RED Dashboard'u
RED (Rate, Errors, Duration; bir servisin istek hızı, hata oranı ve süresi) bir isteğe cevap veren her servis için ilk dashboard. Bookstore'unkini deploy/observability/grafana/dashboards/bookstore-api-red.json olarak repo'ya koyduk. On panel var: üstte dört stat (saniyedeki istek, 5xx oranı, checkout p95, dakikadaki sipariş), altında route kırılımı, checkout süresi, heatmap, ödeme sağlayıcısının retry ve timeout sayıları ve sipariş tipine göre siparişler. Checkout süresi paneli şöyle (ilk iki target'ı kısalttık):
{
  "id": 7,
  "type": "timeseries",
  "title": "Checkout duration (POST /api/orders/)",
  "datasource": { "type": "prometheus", "uid": "prometheus" },
  "interval": "15s",
  "targets": [
    {
      "expr": "histogram_quantile(0.99, sum by (le) (rate(http_server_request_duration_seconds_bucket{job=\"$service\", deployment_environment_name=\"$env\", instance=~\"$instance\", http_route=\"/api/orders/\"}[$__rate_interval])))",
      "legendFormat": "p99",
      "refId": "C",
      "exemplar": true
    }
  ],
  "fieldConfig": { "defaults": { "unit": "s" }, "overrides": [] }
}
Sorgular bir önceki yazıdaki PromQL'in aynısı; fark, sabit değerlerin yerini variable'ların alması ($service, $env, $instance) ve pencerenin $__rate_interval olması. $__rate_interval, Grafana'nın zaman aralığına ve scrape aralığına göre seçtiği, rate için güvenli pencere; elle [5m] yazmaktan iyidir, çünkü dashboard 7 gün gösterildiğinde de 15 dakika gösterildiğinde de doğru çalışır. "unit": "s" küçük ama önemli: Grafana değeri buna göre 250 ms, 5,53 s gibi okunur biçimde yazıyor.
1.200 siparişlik koşu sırasında dashboard şöyle görünüyordu:
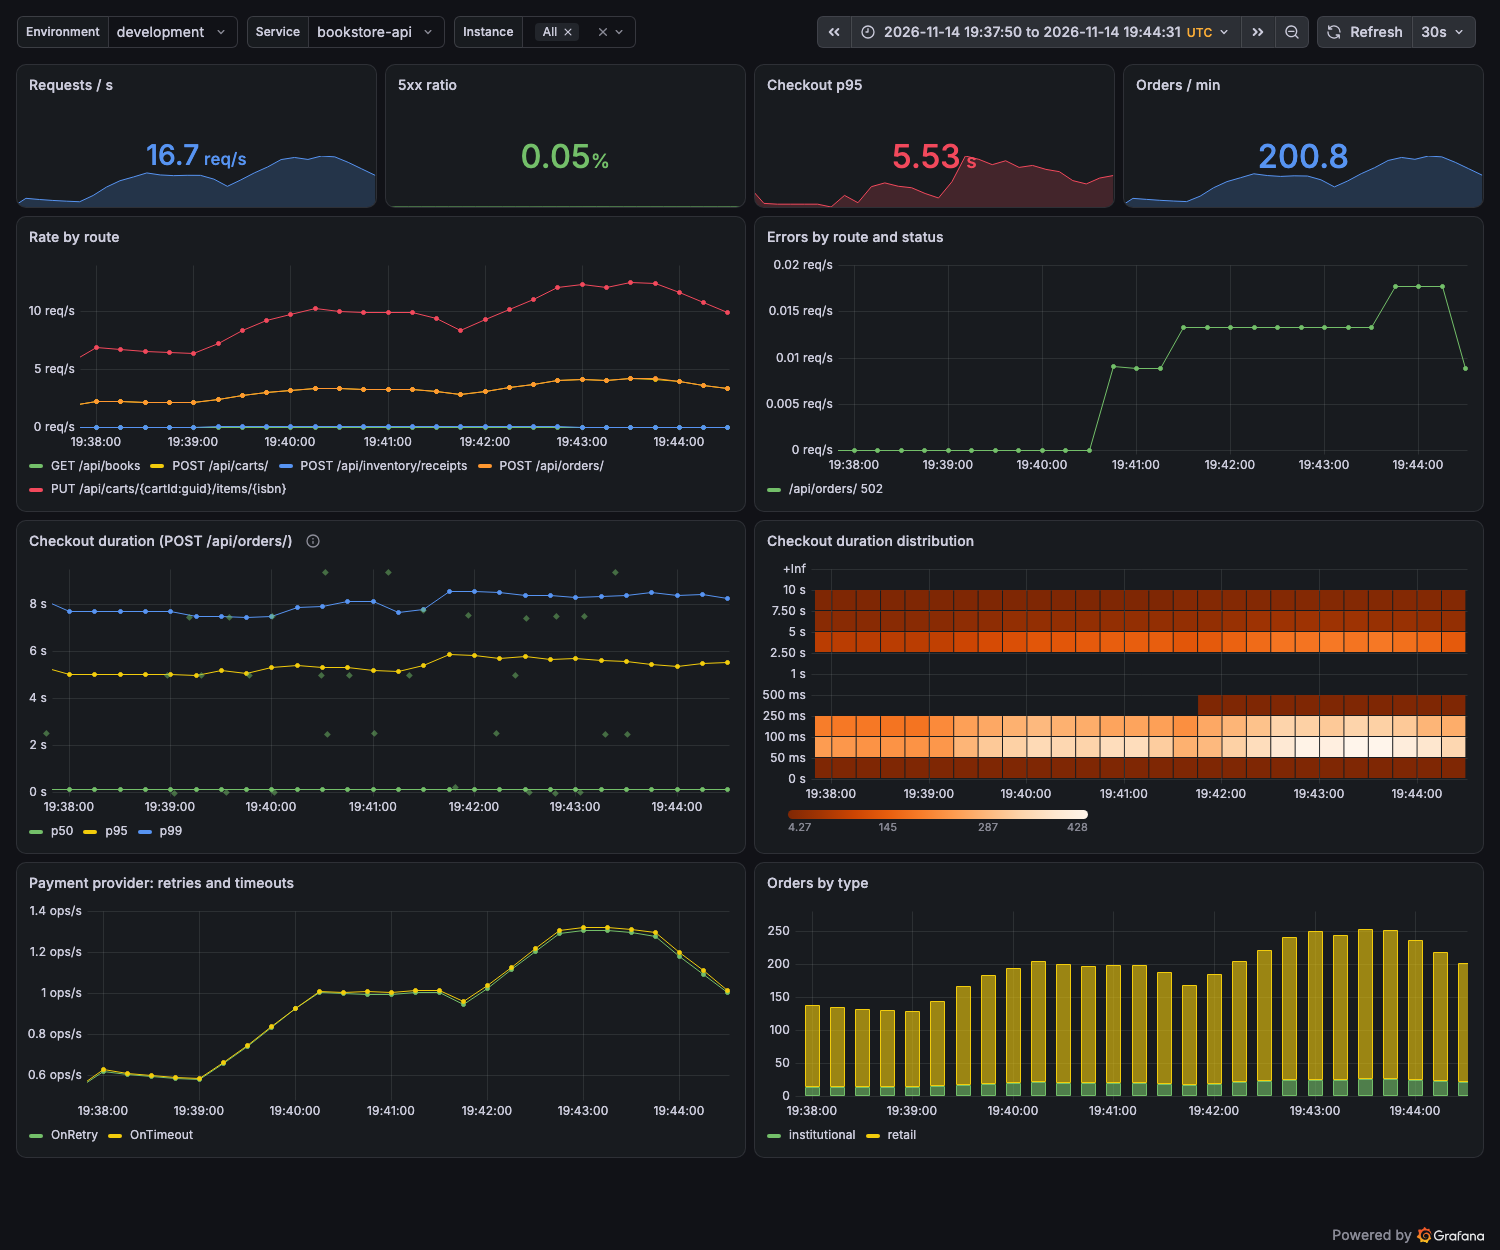
Üst satır durumu dört sayıyla veriyor: saniyede 16,7 istek, 5xx oranı yüzde 0,05, checkout p95'i 5,53 saniye, dakikada 200,8 sipariş. p95'in kırmızı olması bir eşik ayarı: 1 saniyede turuncu, 3 saniyede kırmızı. Hata oranı neredeyse sıfırken süre panelleri ve retry paneli sorunun yerini gösteriyor: p95 5 saniye, p99 8 saniye civarında sabit; ödeme sağlayıcısına saniyede 1–1,3 retry gidiyor ve retry ile timeout çizgileri üst üste. Her timeout bir retry'a dönüşüyor. Panel başlıkları ve legend'lar İngilizce; dashboard ekibin ortak aracı ve kod gibi ele alınıyor.
USE Dashboard'u: Runtime
USE (Utilization, Saturation, Errors; bir kaynağın ne kadar kullanıldığı, ne kadar sıraya girildiği ve ne kadar hata verdiği) kaynaklara bakar: CPU, bellek, thread pool. .NET'te bu sinyallerin hepsi System.Runtime meter'ından hazır geliyor (metric üretme yazısında gördük). İkinci dashboard bookstore-api-runtime.json altı panelden oluşuyor: kullanılan CPU (rate(dotnet_process_cpu_time_seconds_total[...])), working set, son GC'den (garbage collection; kullanılmayan belleğin geri toplanması) sonraki heap boyutu, generation'a göre GC sayısı, thread pool'daki thread ve kuyrukta bekleyen iş sayısı ve lock contention'ları. Doygunluk için en anlamlı panel thread pool kuyruğu: kuyruk boşalmıyorsa pool işlere yetişemiyor demektir.
Aynı koşu sırasında bu dashboard sakindi: API yaklaşık 0,05–0,07 core kullandı, heap 30–34 MiB arasında gezdi, thread pool en fazla 10 thread'e çıktı ve kuyruktaki iş sayısı en fazla 1 oldu. Bu bir bilgi: checkout'ların yüzde 5'i 5 saniyeden uzun sürerken API'nin kaynaklarında hiçbir sıkışma yok. Süre işlemcide ya da thread pool'da değil, bir şeyi beklerken geçiyor. RED "kullanıcı bekliyor" dedi, USE "makine boşta" diyor; ikisi birlikte okunduğunda şüphe dış bağımlılığa, yani ödeme sağlayıcısına dönüyor. İlk yazıda Gül'ün şikâyetinde de CPU ve bellek normaldi.
Variable'lar
Aynı dashboard'u her ortam ve her servis için kopyalamak yerine variable kullanıyoruz. Üç variable var: env, service ve instance. Değerleri target_info serisinden geliyor; OTLP ile gelen her servisin resource attribute'ları bu seride duruyor:
{
  "name": "instance",
  "label": "Instance",
  "type": "query",
  "datasource": { "type": "prometheus", "uid": "prometheus" },
  "query": {
    "query": "label_values(target_info{job=\"$service\", deployment_environment_name=\"$env\"}, instance)",
    "qryType": 1
  },
  "refresh": 2,
  "multi": true,
  "includeAll": true,
  "allValue": ".*"
}
Variable'lar birbirine zincirleniyor: service'in listesi seçilen env'e, instance'ınki seçilen servise göre geliyor. refresh: 2 listeyi zaman aralığı değiştiğinde yeniden yüklüyor; böylece bir saat önce kapanmış pod'lar listede kalmıyor. instance çoklu seçimli ve "All" seçeneği var; bu yüzden sorgularda instance=~"$instance" yazıyoruz (eşittir değil, regex) ve allValue'yu .* yaptık. Bunu yapmazsan Grafana "All" için bütün değerleri a|b|c|... diye uzun bir regex'e çeviriyor; yüz pod'lu bir serviste sorgu hem uzuyor hem yavaşlıyor.
Bir uyarı: OTLP ile gelen serilerde instance, service.instance.id'den geliyor ve .NET SDK'sı bunu her process başlangıcında rastgele bir GUID (128 bitlik benzersiz kimlik) olarak üretiyor. Legend'da okunaklı bir şey istiyorsan pod adını ya da host adını resource attribute olarak gönderip onu label'a çevirmen gerekiyor; otel-lgtm'in Prometheus config'i k8s.pod.name ve host.name'i zaten label'a çeviriyor.
Exemplar: Metric'ten Trace'e
Exemplar, histogram'ın bir bucket'ına düşen ölçümlerden birinin örneği: değeri, zamanı ve o anki trace_id/span_id. p99 çizgisinde bir sıçrama gördüğünde, o sıçramayı oluşturan isteklerden birinin trace'ine tek tıkla gidebilmeni sağlıyor. Zincirin üç halkası var. Birincisi uygulama: OpenTelemetry .NET'te exemplar'lar varsayılan olarak kapalı. Dokümanı sebebini performans maliyeti olarak açıklıyor; spesifikasyonun önerisi açık olması. Açmak tek satır:
.WithMetrics(metrics => metrics
    .AddMeter("Bookstore.*", "Polly")
    .AddAspNetCoreInstrumentation()
    .AddHttpClientInstrumentation()
    .AddRuntimeInstrumentation()
    // .NET'te exemplar'lar varsayılan olarak kapalı: her bucket için trace_id'siyle bir örnek ölçüm tut,
    // böylece dashboard'daki bir p99 sıçramasından yavaş bir isteğin trace'ine gidilebilsin.
    .SetExemplarFilter(ExemplarFilterType.TraceBased)
    // Scrape eden bir Prometheus için GET /metrics (pull); OTLP aynı metric'leri push etmeye devam eder.
.AddPrometheusExporter())TraceBased, yalnızca sampled bir span'ın içinde yapılan ölçümleri exemplar adayı yapıyor; AlwaysOn her ölçümü aday yapar ama trace'i olmayan bir exemplar'ın işe yararlığı sınırlı. Kodu değiştirmeden denemek için OTEL_METRICS_EXEMPLAR_FILTER=trace_based environment variable'ı da var; kodda SetExemplarFilter çağrılırsa o kazanıyor. Exemplar'ları OTLP exporter'ı taşıyor. İkinci halka Prometheus: exemplar'ları saklaması için --enable-feature=exemplar-storage ile başlaması gerekiyor (otel-lgtm bunu yapıyor). Üçüncü halka Grafana: panelde target'ın "exemplar": true olması ve Prometheus data source'unda trace_id label'ının Tempo'ya yönlendirilmesi. Grafana'dan bağımsız olarak exemplar'ları Prometheus'un API'sinden okuyabilirsin:
curl -s -G http://localhost:9090/api/v1/query_exemplars \
  --data-urlencode 'query=http_server_request_duration_seconds_bucket{job="bookstore-api", http_route="/api/orders/"}' \
  --data-urlencode "start=$START" --data-urlencode "end=$END" | jq -c '.data[] | select(.seriesLabels.le == "10") | .exemplars[0:2][]'

{"labels":{"span_id":"53f14ebd0181bfd5","trace_id":"f53aa1658427faaa8e1b879af6f5e460"},"value":"9.5162037","timestamp":1794685232.467}
{"labels":{"span_id":"7f1bf763439455bb","trace_id":"ee324f164139405b27daa023898c3905"},"value":"9.5233664","timestamp":1794685269.717}
İlk exemplar 9,5 saniyelik bir checkout'tan geliyor ve trace'i Tempo'da duruyor. Önce Tahmin Et'in cevabı da burada. Exemplar'ı SDK, istek bittiği anda kaydediyor; o anda span sampled olduğu için TraceBased filtre onu kabul ediyor. Trace'in saklanıp saklanmayacağına ise Collector yazısında kurduğumuz tail sampling sonradan karar veriyor: bütün hataları ve 1 saniyeden yavaş bütün trace'leri tutuyor, kalanların yüzde 10'unu. Yavaş isteklerin exemplar'larının hepsi bu yüzden açıldı (51'de 51); hızlı isteklerinkinin çoğu açılmadı (68'de 5). Kimse veri kaybetmiyor; metric tarafı örneği, trace tarafı sampling kararını ayrı ayrı veriyor. Pratikte bu bir sorun değil, çünkü exemplar'a tıklamanın sebebi zaten neredeyse her zaman yavaş ya da hatalı bir istek. Ama ekibe söylemezsen "exemplar'lar çalışmıyor" diye bir ticket açılır.
Trace'ten log'a geçiş de aynı mantıkla çalışıyor: Tempo data source'u, bir span'dan aynı trace_id'yi taşıyan Loki satırlarına bir sorgu açıyor. Bu köprüyü log backend'leri yazısında kullanacağız.
Dashboard as Code
Grafana'da arayüzden kurulan bir dashboard Grafana'nın veritabanında yaşar: kim neyi neden değiştirdi bilinmez, başka bir ortama taşınması elle yapılır, silinirse geri getirmek zordur. Bookstore'da dashboard'ların kaynağı Git. Grafana'ya bunları bir provisioning dosyasıyla gösteriyoruz:
# Grafana bu klasördeki her JSON dosyasını açılışta yükler ve 30 saniyede bir yeniden okur.
# Kaynak Git'teki dosyalar: arayüzde yapılan değişiklikler geri kaydedilemez.
apiVersion: 1

providers:
  - name: bookstore
    folder: Bookstore
    type: file
    allowUiUpdates: false
    updateIntervalSeconds: 30
    options:
      path: /otel-lgtm/bookstore-dashboards
compose dosyasına da iki volume ekledik: biri bu dosyayı Grafana'nın provisioning klasörüne, diğeri dashboard JSON'larını path'in gösterdiği yere bağlıyor:
    volumes:
      - ./otelcol-config.yaml:/otel-lgtm/otelcol-config.yaml:ro
      # Dashboard as code: provider dosyası Grafana'ya nereye bakacağını söyler, JSON dosyaları dashboard'ların kendisi.
      - ./grafana/dashboards.yaml:/otel-lgtm/grafana/conf/provisioning/dashboards/bookstore.yaml:ro
      - ./grafana/dashboards:/otel-lgtm/bookstore-dashboards:ro
allowUiUpdates: false ne işe yarıyor, denedik: dashboard'un başlığını değiştirip Grafana'nın HTTP API'siyle kaydetmeye çalıştık.
curl -s -w ' %{http_code}\n' -X POST -H 'Content-Type: application/json' http://localhost:3000/api/dashboards/db -d @edit.json
{"message":"Cannot save provisioned dashboard"} 400
Grafana dosyadan gelen dashboard'un üzerine yazmayı reddediyor. Akış şu: arayüzde dene, beğendiğin hâlin JSON'unu al, repo'daki dosyaya yaz, pull request aç. Dashboard'lar da kod gibi review'dan geçiyor ve her ortama aynı commit'ten gidiyor. JSON'u elle yazmak zahmetliyse Grafana'nın Grafonnet (Jsonnet library'si) ya da Terraform provider'ı gibi araçlar var; biz düz JSON'da kaldık.
Grafana 13 bu tarafta iki şey değiştirdi. Birincisi "dynamic dashboards" artık genel kullanımda ve varsayılan: yeni bir layout motoru ve yeni bir dashboard şeması (v2) ile geliyor; eski JSON'lar açıldıklarında otomatik olarak dönüştürülüyor. Bizim klasik JSON'umuz değişmeden yüklendi, Grafana'nın yeni API'si aynı dashboard'u v2 şemasıyla da döndürüyor:
curl -s http://localhost:3000/apis/dashboard.grafana.app/v2/namespaces/default/dashboards/bookstore-api-red \
  | jq -c '{apiVersion, managedBy: .metadata.annotations["grafana.app/managedBy"], spec: (.spec | keys)}'

{"apiVersion":"dashboard.grafana.app/v2","managedBy":"classic-file-provisioning","spec":["annotations","cursorSync","description","editable","elements","layout","links","liveNow","preferences","preload","tags","timeSettings","title","variables"]}
v2'de paneller elements altında, yerleşim ise ayrı bir layout nesnesinde tutuluyor; panelin yeri değişince panelin tanımı değişmiyor ve diff'ler okunur kalıyor. İkincisi, Grafana 13'ün sürüm notları otomasyon script'leri için /api yolunun kullanımdan kaldırıldığını ve /apis'e geçilmesini söylüyor. Yukarıdaki kayıt denemesi eski /api'de hâlâ çalışıyor, ama yeni bir script yazıyorsan /apis'i kullan. Grafana 13'le genel kullanıma açılan Git Sync ise dashboard'ları bir Git repo'suyla iki yönlü eşitliyor; arayüzden yapılan değişiklik pull request olarak repo'ya gidebiliyor. Bunu bu yazıda denemedik, dosya tabanlı provisioning yerel stack için yeterli.
Üretimde Dikkat
Dashboard sorgusu da Prometheus'a yük. On panelli bir dashboard 30 saniyede bir yenileniyorsa ve ekipte on kişi açık tutuyorsa dakikada yüzlerce sorgu demek. Yüzdelik gibi pahalı sorguları önceki yazıdaki recording rule'lara taşı; dashboard'un varsayılan yenileme süresini de ihtiyaçtan kısa tutma.
Data source'ları ve kimin neyi görebildiğini de kod olarak yönet. otel-lgtm yerelde anonim kullanıcıya Admin rolü veriyor; bu yalnızca geliştirme makinesi için kabul edilebilir. Production Grafana'sında oturum açma, rol ve klasör yetkileri olmalı; telemetry'de müşteri verisi olabileceğini Collector yazısında gördük.
Dashboard'a bir "ne yapmalıyım" bağlantısı koy. Paneldeki description alanı ve dashboard linkleri, gece 3'te bakan kişiye hangi sayının ne anlama geldiğini ve hangi runbook'a gideceğini söyleyebilir. Runbook'ları alerting yazısında yazacağız.
Sık Düşülen Tuzaklar
40 panelli "her şey" dashboard'u. Her metric'i bir panele koymak dashboard'u okunmaz yapar; sorun anında kimse 40 grafiği taramaz. Bir dashboard bir soruya cevap vermeli: "servis sağlıklı mı" (RED), "makine sıkışık mı" (USE), "işler yolunda mı" (sipariş). Ayrıntı için Explore var.
Ortalamaya bakmak. Ortalama checkout süresi bu koşuda bir saniyenin altındaydı; aynı anda isteklerin yüzde 5'i 5 saniyeden uzun sürdü. Süre panellerinde yüzdelik ve heatmap kullan; ortalamayı tek başına hiç gösterme.
"All" seçildiğinde yanlış sonuç veren sorgular. instance="$instance" yazarsan çoklu seçimde sorgu boş döner; =~ yaz. Variable'ın toplanmış sorgularda sum by ile birlikte kullanıldığından da emin ol, yoksa her instance ayrı bir çizgi olur.
Panel birimini vermemek. unit boş kalınca 0.25 ile 250'nin aynı şey olduğunu (saniye ve milisaniye) okuyan çıkarmak zorunda kalır. Metric adında birim varsa (_seconds, _bytes) panelde de aynısını seç.
Dashboard'u yalnızca arayüzde düzenlemek. Provisioning yoksa bir gün biri yanlışlıkla siler ya da "geçici" bir değişiklik kalıcı olur. Git'te olmayan dashboard yok sayılmalı.
Küçük Bir Deneme
★☆☆ RED dashboard'undaki p99 paneline bookstore_checkout_duration_seconds histogram'ından, sipariş tipine göre ayrılmış bir p95 çizgisi ekle ve kurumsal siparişlerle perakende siparişlerin süresini karşılaştır.
★★☆ Runtime dashboard'una tek bir "doygunluk" stat'ı ekle: thread pool kuyruğundaki iş sayısının son 5 dakikadaki en büyük değeri. Eşiğini 10'da turuncu, 100'de kırmızı yap ve trafik aracının concurrency değerini 4'ten 32'ye çıkarıp ne olduğuna bak.
★★★ Prometheus data source'unda exemplarTraceIdDestinations'ı kaldır, exemplar noktalarına tıklayınca ne olduğuna bak, sonra kendi provisioning dosyanla geri ekle. Ardından Collector'daki tail sampling'in probabilistic oranını yüzde 100'e çıkar ve hızlı isteklerin exemplar'larından kaçının trace'e açıldığını yeniden say.
Dashboard bize sorunun nerede olduğunu gösterdi: kaynaklar boşta, kuyruk ödeme sağlayıcısında, exemplar'lar da 7–9 saniyelik isteklerin trace'lerine götürüyor. Bir sonraki yazıda bu trace'leri açıyoruz: Jaeger v2 ve Grafana Tempo'nun mimari farkı, TraceQL ile arama ve ilk yazıdan beri süren checkout vakasının iki sebebini, retry fırtınasını ve N+1 sorgusunu trace waterfall'unda bulup düzeltmek.