

Veritabanını Ne Zaman ve Nasıl Ölçeklemeli? Ölçüm, Darboğaz ve Scaling Merdiveni
Veritabanını ölçeklemeye p50/p95/p99 latency, throughput ve aktif session'ların neyi beklediği ölçülmeden karar verilmez; çoğu zaman ilk basamak sorgu ve index'tir. Bookstore'un sipariş geçmişi sorgusu 64 istemcide 187 istek/sn'de tıkanıyordu, tek bir index p99'u 653 ms'den 5,6 ms'ye indirdi. Little's Law, pg_stat_statements ve DMV'lerle darboğaz bulmak, scaling merdiveni, kapasite hesabı ve SLO.
Sürüm notu: Bu yazıdaki örnekler PostgreSQL 18.7 ve SQL Server 2025 (CU10, 17.0.5035.5) üzerinde, .NET 10, Npgsql 10.0.3 ve Microsoft.Data.SqlClient 7.1.2 ile derlenip çalıştırılmıştır. Ölçümler tek makinelik bir lab'dan geliyor; mutlak süreler senin donanımında farklı çıkar, önemli olan oranlar ve eğrinin şekli.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) bir yılda sipariş sayısının 10 katına çıkacağını planlıyor. Ürün ekibinin ilk sorusu şu: "Veritabanını büyütmemiz, replica eklememiz ya da sharding'e geçmemiz gerekecek mi?" Bu sorunun cevabı bir ölçümle başlar. Elimizde 1 milyon sipariş ve 2,5 milyon sipariş kalemi olan bir PostgreSQL 18 veritabanı var. "Siparişlerim" sayfasının arkasındaki sorgu, bir müşterinin son 20 siparişini getiriyor:
SELECT order_id, status, total_amount, created_at
FROM orders
WHERE customer_id = @customerId
ORDER BY created_at DESC
LIMIT 20;
Bu sorguyu aynı anda 1, 4, 16 ve 64 istemciyle 20'şer saniye çalıştırıyoruz. Tahmin et: istemci sayısı 16'dan 64'e çıkınca saniyedeki istek sayısı dört katına çıkar mı? Yanıt süresi ne olur? Ölçüm şöyle:
db=pg concurrency=1 requests=1152 errors=0
throughput=57.6 req/s p50=16.3 ms p95=22.9 ms p99=26.4 ms
db=pg concurrency=4 requests=2482 errors=0
throughput=124.0 req/s p50=31.9 ms p95=38.5 ms p99=43.6 ms
db=pg concurrency=16 requests=3113 errors=0
throughput=155.1 req/s p50=96.6 ms p95=170.8 ms p99=224.7 ms
db=pg concurrency=64 requests=3769 errors=0
throughput=186.9 req/s p50=327.5 ms p95=510.8 ms p99=653.4 ms
İstemci sayısı 64 katına çıktı, throughput yalnızca 3,2 katına. Medyan yanıt süresi ise 16 ms'den 327 ms'ye fırladı. Veritabanı bir noktadan sonra işi daha hızlı yapmıyor; işler sadece sırada bekliyor. Bu yazıda bu eğriyi okumayı, darboğazı bulmayı ve "bir sonraki adım ne?" sorusunu cevaplayan scaling merdivenini kuruyoruz. Seri boyunca merdivenin her basamağını aynı Bookstore senaryosuyla tek tek çıkacağız.
"Veritabanı Yavaş" Bir Ölçüm Değildir
Bir performans şikâyetini işe yarar hâle getirmek için üç sayı gerekir. Throughput, birim zamanda tamamlanan iş miktarıdır (saniyedeki istek ya da transaction). Latency, tek bir isteğin ne kadar sürdüğüdür. Percentile ise latency dağılımının neresine baktığını söyler: p50 isteklerin yarısının bu süreden kısa sürdüğünü, p99 ise her 100 istekten birinin bu süreden uzun sürdüğünü gösterir. Ortalama bu işe yaramaz, çünkü birkaç çok yavaş istek ortalamada kaybolur ama kullanıcının hatırladığı tam olarak o isteklerdir.
Ölçümü küçük bir .NET aracıyla alıyoruz. Bookstore.ScaleLab içindeki load komutu verilen sayıda worker başlatıyor; her worker pool'dan connection alıp sorguyu çalıştırıyor ve süreyi kaydediyor:
Task[] workers = Enumerable.Range(0, concurrency).Select(async worker =>
{
    Random random = new(worker);
    while (!stop.IsCancellationRequested)
    {
        long started = Stopwatch.GetTimestamp();
        try
        {
            await using DbConnection connection = Db.Create(db);
            await connection.OpenAsync();
            await using DbCommand command = connection.CreateCommand();
            command.CommandText = sql;
            DbParameter p = command.CreateParameter();
            p.ParameterName = "customerId";
            p.Value = random.Next(1, 100_001);
            command.Parameters.Add(p);
            await using DbDataReader reader = await command.ExecuteReaderAsync();
            while (await reader.ReadAsync()) { }
            // süreyi yalnızca başarılı istek için kaydediyoruz
            latenciesMs.Add(Stopwatch.GetElapsedTime(started).TotalMilliseconds);
        }
        catch (DbException)
        {
            Interlocked.Increment(ref errors);
        }
    }
}).ToArray();

await Task.WhenAll(workers);
Percentile hesabı sıralanmış dizide basit bir index hesabı (nearest-rank yöntemi):
static double Percentile(double[] sorted, int p) =>
    sorted.Length == 0 ? 0 : sorted[Math.Min(sorted.Length - 1, (int)Math.Ceiling(p / 100.0 * sorted.Length) - 1)];
Lab'ı kurup aracı çalıştırmak için (PowerShell; veri üretimi birkaç dakika sürer):
docker run -d --name bookstore-pg -p 5432:5432 -e POSTGRES_PASSWORD=<password> -e POSTGRES_DB=bookstore postgres:18 -c shared_preload_libraries=pg_stat_statements
Get-Content db/pg-schema.sql, db/pg-data.sql | docker exec -i bookstore-pg psql -q -U postgres -d bookstore
$env:BOOKSTORE_PG = "Host=localhost;Database=bookstore;Username=postgres;Password=<password>"
dotnet run --project src/Bookstore.ScaleLab -c Release -- load --db pg --concurrency 64 --seconds 20
Bu bir load test aracı değil; amacı tek bir sorgunun eşzamanlılık altında nasıl davrandığını görmek. Gerçek load test'in tasarımı, senaryoları ve araçları Performance ve Load Testing serisinde. Bizim için önemli olan, yukarıdaki dört satırın arkasındaki ilişki. Little's Law'a göre sistemdeki ortalama iş sayısı, throughput ile ortalama süre çarpımına eşittir. 64 istemcide 186,9 istek/sn ve yaklaşık 0,33 sn medyan süre, çarpınca 61 eder; yani 64 istemcinin neredeyse hepsi her an sistemde bir şey bekliyor. Throughput tavanına ulaştıktan sonra eklenen her istemci yalnızca kuyruğu uzatır, latency'yi doğrusal olarak artırır. Eğrinin dirsek yaptığı yer (bu lab'da 4 ile 16 istemci arası) bu sorgu için kapasitenin sınırıdır.
Darboğazı Bulmak: Kaynak mı, Bekleme mi?
Bir veritabanı sunucusu beş şeyden birinde tıkanır: CPU, disk I/O, bellek, lock/blocking ya da connection sayısı. Hangisi olduğunu tahmin etmek yerine, sunucuya aktif session'ların o an ne yaptığını soruyoruz. Aracın içinde, yük sürerken her 200 ms'de bir çalışan bir sampler var. PostgreSQL için sorgu:
SELECT coalesce(wait_event_type || ':' || wait_event, 'CPU') AS wait, count(*)
FROM pg_stat_activity
WHERE state = 'active' AND backend_type = 'client backend' AND pid <> pg_backend_pid()
GROUP BY 1;
wait_event boş olan aktif bir backend o an bir şey beklemiyor, CPU üzerinde çalışıyor demektir. 64 istemcilik koşunun dağılımı:
  active sessions on CPU: 46%
  active sessions on IO:AioIoCompletion: 29%
  active sessions on LWLock:BufferMapping: 23%
  active sessions on IPC:BgworkerShutdown: 0%
Lock beklemesi yok, connection hatası yok. Zaman CPU'da, page okumada (AioIoCompletion, 18'in asynchronous I/O'su) ve shared buffers'ta page aramanın iç kilidinde (LWLock:BufferMapping) geçiyor. Bu tablo "sunucu çok sayıda page okuyor" diyor. Hangi sorgunun okuduğunu pg_stat_statements söyler:
SELECT left(query, 48) AS query, calls,
       round(mean_exec_time::numeric, 1) AS mean_ms,
       (shared_blks_hit + shared_blks_read) / calls AS blocks_per_call
FROM pg_stat_statements
WHERE dbid = (SELECT oid FROM pg_database WHERE datname = current_database())
ORDER BY total_exec_time DESC
LIMIT 2;
query | calls | mean_ms | blocks_per_call
--------------------------------------------------+-------+---------+-----------------
SELECT order_id, status, total_amount, created_a | 10516 | 156.4 | 16665
DISCARD ALL | 10435 | 0.0 | 0Her çağrı 16.665 block, yani yaklaşık 130 MB'lık bir page trafiği yapıyor: tablonun tamamı. 20 satır döndüren bir sorgu için bu, problemin büyüklüğünü tek başına anlatıyor. (İkinci satırdaki DISCARD ALL, Npgsql'in pool'a dönen connection'ı sıfırlama komutu; bir sonraki yazının konusu.) SQL Server'da aynı soruların karşılığı sys.dm_exec_requests ve plan cache istatistikleri. Aynı veriyi SQL Server 2025'e yükleyip yükü çalıştırdıktan sonra:
SELECT TOP (1) qs.execution_count,
       qs.total_logical_reads / qs.execution_count AS avg_logical_reads,
       qs.total_worker_time / qs.execution_count / 1000 AS avg_cpu_ms,
       LEFT(st.text, 70) AS query_text
FROM sys.dm_exec_query_stats AS qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) AS st
CROSS APPLY sys.dm_exec_plan_attributes(qs.plan_handle) AS pa
WHERE pa.attribute = 'dbid' AND CAST(pa.value AS int) = DB_ID()
ORDER BY qs.total_worker_time DESC;
execution_count|avg_logical_reads|avg_cpu_ms|query_text
---------------|-----------------|----------|----------
4124|6520|68|(@customerId int)SELECT TOP (20) OrderId, Status, TotalAmount, CreatedParametreli sorgularda sys.dm_exec_sql_text'in dbid kolonu boş gelir; veritabanına göre filtrelemek için plan attribute'unu kullandık. Aynı session sampler'ı burada CXCONSUMER ve CXSYNC_PORT gösterdi: sorgu her seferinde paralel bir tablo taraması yapıyor. Wait type'ların tek tek anlamı ve DMV'lerle (Dynamic Management View; sunucunun iç durumunu gösteren sistem view'ları) teşhis yöntemi SQL Server Derinlemesine serisinin "Teşhis Metodolojisi" yazısında, PostgreSQL tarafındaki plan okuma ise PostgreSQL serisinin EXPLAIN yazısında. Buradaki amaç yöntemi kurmak: belirtiden kaynağa, kaynaktan sorguya.
Merdivenin İlk Basamağı: Sorgu ve Index
Planı görelim:
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT order_id, status, total_amount, created_at
FROM orders WHERE customer_id = 4242
ORDER BY created_at DESC LIMIT 20;
-> Parallel Seq Scan on orders (actual time=4.856..17.639 rows=3.33 loops=3)
Filter: (customer_id = 4242)
Rows Removed by Filter: 333330
Buffers: shared hit=16002 read=665
Execution Time: 21.562 ms10 satır için 1 milyon satır okunup 999.990'ı atılıyor. Çözüm bir composite index:
CREATE INDEX ix_orders_customer_created ON orders (customer_id, created_at DESC); -> Bitmap Heap Scan on orders (actual time=0.019..0.097 rows=10.00 loops=1)
Recheck Cond: (customer_id = 4242)
Heap Blocks: exact=10
Buffers: shared hit=8 read=5
Execution Time: 0.127 ms16.667 block'tan 13 block'a indik. Aynı yükü tekrar çalıştırıyoruz:
db=pg concurrency=1 requests=105014 errors=0
throughput=5250.6 req/s p50=0.2 ms p95=0.3 ms p99=0.4 ms
db=pg concurrency=4 requests=253454 errors=0
throughput=12673.1 req/s p50=0.3 ms p95=0.5 ms p99=0.7 ms
db=pg concurrency=16 requests=429480 errors=0
throughput=21474.7 req/s p50=0.6 ms p95=1.3 ms p99=2.5 ms
db=pg concurrency=64 requests=495461 errors=0
throughput=24770.9 req/s p50=2.5 ms p95=4.0 ms p99=5.6 ms
64 istemcide throughput 187'den 24.771 istek/sn'ye çıktı, p99 653 ms'den 5,6 ms'ye indi: 130 kattan fazla. SQL Server'da aynı index'in (INCLUDE (Status, TotalAmount) ile covering) etkisi 6.520'den 4 logical read'e iniş oldu. Hiçbir donanım yatırımı ya da mimari değişiklik bu oranı veremez. Bu yüzden merdivenin ilk basamağı her zaman sorgu ve index'tir; sonraki basamaklara ancak bu basamak tükendiğinde çıkılır. Index tasarımının ayrıntıları SQL Server Derinlemesine serisinin "Nonclustered Index Tasarımı" yazısında.
Scaling Merdiveni
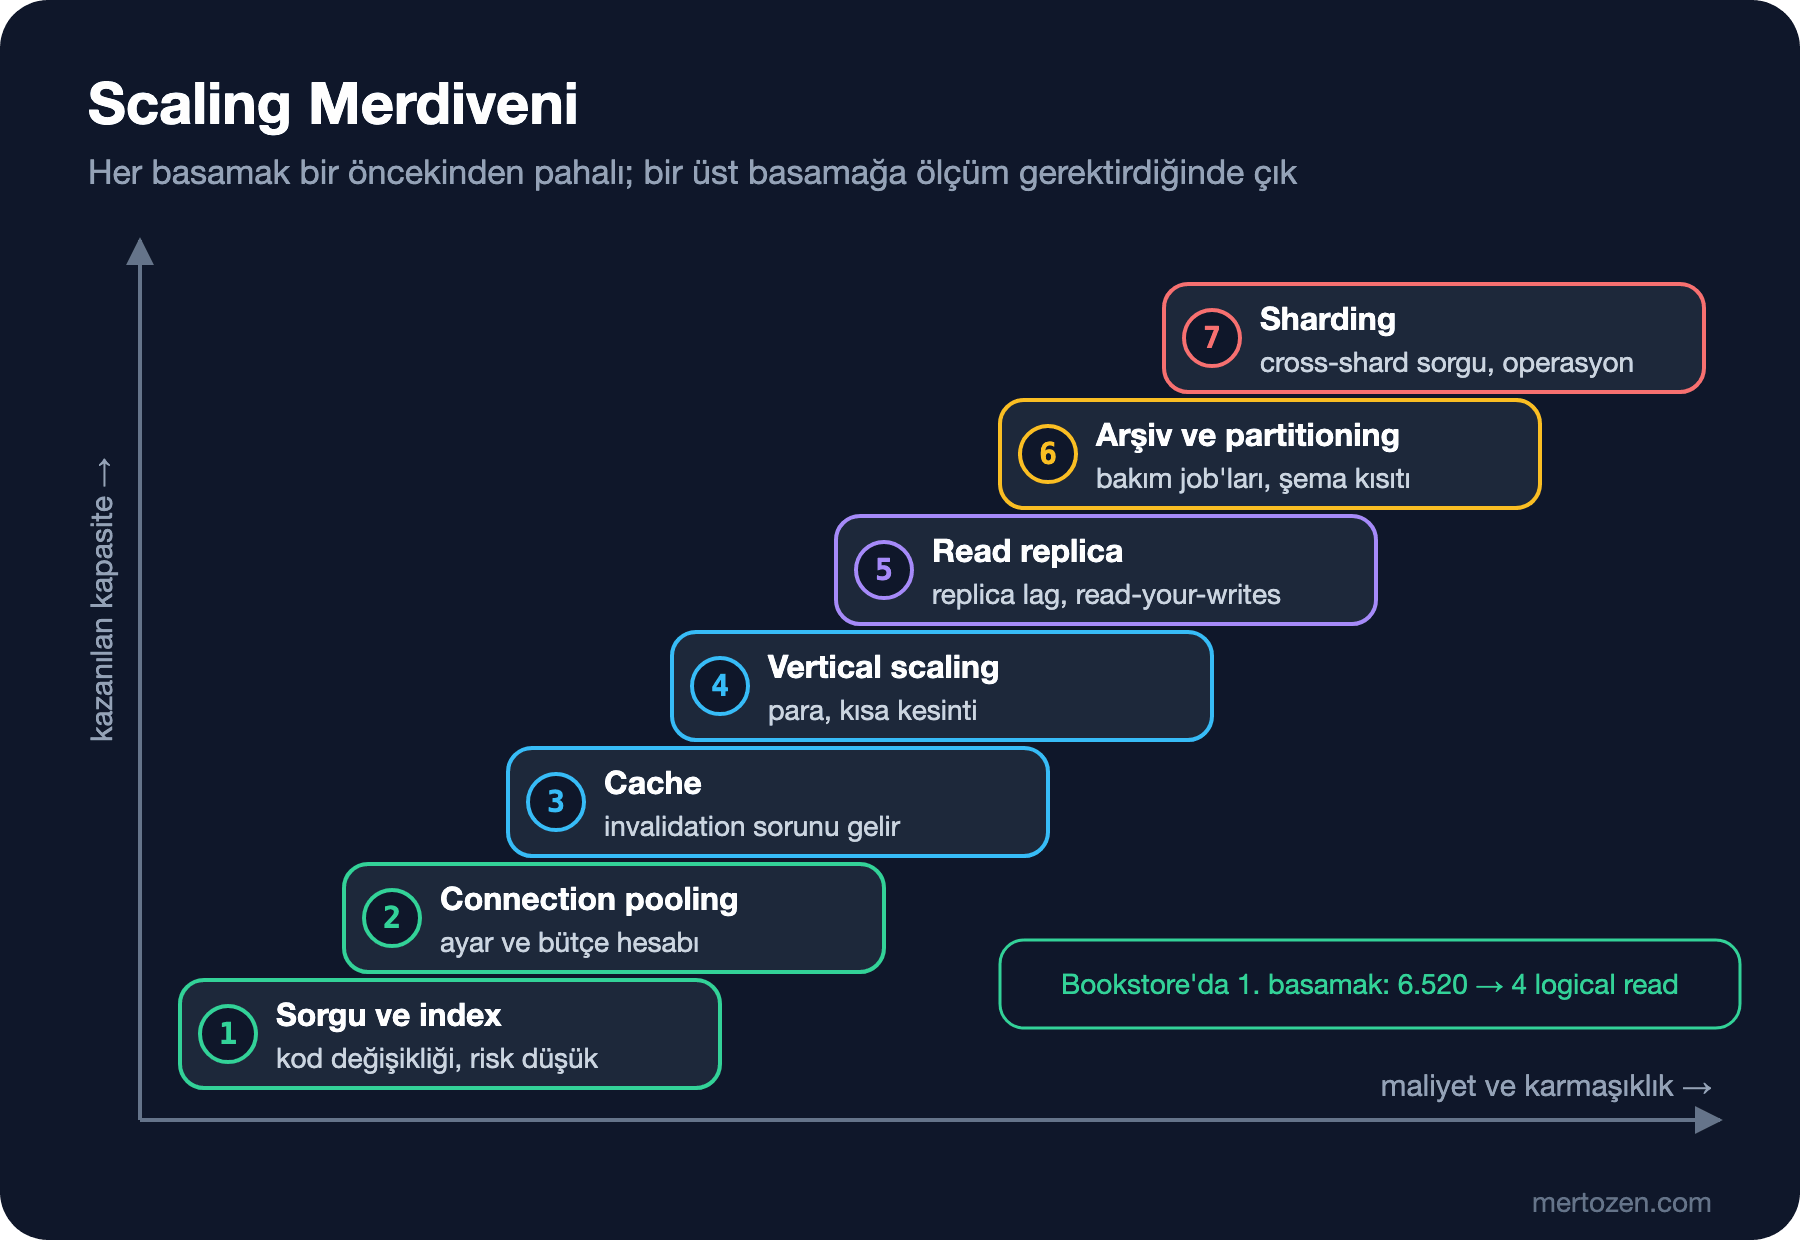
Basamakları sıralayan şey, her birinin getirdiği kalıcı maliyet. Alttakiler yerel ve geri alınabilir değişiklikler; üsttekiler sistemin şeklini değiştiriyor ve geri dönmesi zor.
| Basamak | Ne kazandırır | Kalıcı maliyeti | Seride |
|---|---|---|---|
| Sorgu ve index | Çoğu zaman 10–1000 kat | Yazma maliyeti, index bakımı | Bu yazı |
| Connection pooling | Connection kurma maliyeti ve sunucu belleği | Bütçe hesabı, PgBouncer işletimi | 02 |
| Cache | Tekrarlanan okumayı veritabanından alır | Invalidation, tutarsızlık penceresi | Caching serisi |
| Vertical scaling | Daha çok CPU, bellek, IOPS (saniyedeki disk I/O işlemi sayısı) | Para; bir sınırı var; geçişte kısa kesinti | 01, 05 |
| Read replica | Okuma kapasitesi, raporlama izolasyonu | Replica lag, read-your-writes, yönlendirme kodu | 04–06 |
| Arşiv ve partitioning | Sıcak verinin küçülmesi, bakım kolaylığı | Bakım job'ları, primary key ve sorgu kısıtları | 03, 07, 08 |
| Sharding | Yazma kapasitesi ve veri boyutu | Cross-shard sorgu ve transaction, resharding, operasyon | 09 |
Vertical scaling bugün çoğu ekibin düşündüğünden daha uzağa gider: bulutta 100'den fazla vCPU ve terabaytlarca bellekli tek instance'lar alınabiliyor. Sınırı genelde teknik değil maliyet ve tek makineye bağımlılık belirler. Read replica okumayı ölçekler ama yazmayı ölçeklemez; her replica primary'nin bütün yazmalarını yeniden uygular. Sharding ise yazmayı ölçekleyen tek basamak olduğu için cazip görünür, fakat erken sharding'in bedeli ağırdır: "müşterinin son siparişleri" gibi tek shard'a düşen sorgular kolaylaşırken "son 30 günün en çok satanları" gibi sorgular her shard'a gider, yabancı anahtarlar ve transaction'lar shard sınırında biter, şemayı değiştirmek her shard'da ayrı bir deploy'a dönüşür. Sistem seviyesindeki kararlar (hash mi range mi, consistent hashing) System Design serisinin "Veri Katmanını Ölçeklemek" ve "Consistent Hashing" yazılarında.
Kapasite Hesabı: Büyüme, Boyut ve SLO
Merdivende nerede durduğunu bilmek için iki tahmin gerekir: veri ne kadar büyüyecek ve yük ne kadar artacak. Veri tarafında satır başına boyutla başlıyoruz:
SELECT relname AS table_name,
       n_live_tup AS row_count,
       pg_size_pretty(pg_table_size(relid)) AS heap_size,
       pg_size_pretty(pg_indexes_size(relid)) AS index_size,
       round(pg_total_relation_size(relid)::numeric / n_live_tup) AS bytes_per_row
FROM pg_stat_user_tables
WHERE relname IN ('orders', 'order_items')
ORDER BY relname DESC;
table_name | row_count | heap_size | index_size | bytes_per_row
-------------+-----------+-----------+------------+---------------
orders | 1000000 | 130 MB | 73 MB | 213
order_items | 2493671 | 268 MB | 151 MB | 176n_live_tup istatistikten gelen bir tahmin; gerçek sayı 2.500.000. Sipariş başına ortalama 2,5 kalem olduğuna göre bir sipariş index'leriyle birlikte yaklaşık 213 + 2,5 × 176 = 653 byte yer tutuyor. Büyüme hızı için çeyrek bazında günlük sipariş sayısına bakıyoruz:
SELECT date_trunc('quarter', created_at)::date AS quarter,
       count(*) AS orders,
       round(count(*) / 91.0) AS per_day
FROM orders
WHERE created_at >= timestamptz '2025-07-01'
GROUP BY 1
ORDER BY 1;
quarter | orders | per_day
------------+--------+---------
2025-07-01 | 86112 | 946
2025-10-01 | 95011 | 1044
2026-01-01 | 101823 | 1119
2026-04-01 | 108374 | 1191
2026-07-01 | 117361 | 1290
2026-10-01 | 58831 | 646Son çeyrek henüz bitmediği için düşük görünüyor. Son tam çeyrekte günde 1.290 sipariş var. Ürün ekibinin hedefi bir yılda 10 kat: günde yaklaşık 12.900 sipariş. Bu, yılda 12.900 × 365 × 653 byte ≈ 3,1 GB yeni veri demek. Veri boyutu tek başına bir sunucuyu zorlamaz. Zorlayacak olan, her siparişin arkasındaki okuma trafiği (katalog, sepet, sipariş geçmişi, raporlar), kampanya günlerinin tepe yükü ve çok sayıda uygulama instance'ının açtığı connection'lar. Kaba hesabın yöntemi (QPS, depolama, bant genişliği) System Design serisinin "Back-of-the-Envelope Estimation" yazısında.
İkinci adım "veritabanı yavaş" cümlesini ölçülebilir bir hedefe çevirmek. SLO (Service Level Objective; bir servisin belirli bir pencerede tutturması hedeflenen güvenilirlik ya da performans değeri) burada işe yarar: "Siparişlerim endpoint'inin veritabanı sorgusu, 5 dakikalık pencerelerde p99'da 50 ms'nin altında kalacak; kampanya günü tepe yükünde de." Bu cümle hem bugün nerede olduğumuzu ölçmeyi hem de bir scaling adımının işe yarayıp yaramadığını doğrulamayı mümkün kılar. Index'ten önce p99 653 ms'ydi, hedefin 13 katı; index'ten sonra 5,6 ms, hedefin çok altında.
Bookstore Senaryosu: Bir Yılda 10 Kat
Seri boyunca izleyeceğimiz hikâye bu: Bookstore bir yıl içinde siparişte 10 kat büyüyecek, kurumsal siparişler (okul ve kütüphanelerin toplu alımları) ve kampanya günleri yükü dalgalı hâle getirecek. Her yazıda bir sorunla karşılaşıp bir basamak çıkacağız: API instance'ları çoğalınca connection bütçesi (02), dört yıllık siparişleri canlı sistemi durdurmadan arşive taşımak (03), raporların ve okuma trafiğinin bir replica'ya alınması (04–06), primary düşerse ödemenin ve siparişin ne olacağı (05), sipariş tablosunun partitioning'i (07–08) ve sharding'in bu aşamada neden gerekmediği (09–10). Her adımda önce ölçeceğiz, sonra karar vereceğiz, sonra aynı metrikle doğrulayacağız.
Üretimde Dikkat
Ölçümü sürekli hâle getir. Bu yazıdaki sampler'ın ve pg_stat_statements sorgusunun üretimdeki karşılığı, bir monitoring sistemine her dakika giden metric'ler: sorgu başına çağrı sayısı ve süre, aktif session'ların wait dağılımı, connection sayısı, replica lag. Bir sorun olduğunda "neydi" sorusunun cevabı geçmiş verideyse saatler kazanırsın.
Uygulama tarafında da ölç. Veritabanının gördüğü süre, kullanıcının gördüğü sürenin bir parçası; pool'dan connection beklemek, ağ ve sonuç setini okumak veritabanı metric'lerinde görünmez. .NET'te OpenTelemetry ile endpoint'ten sorguya inen trace'ler bu farkı gösterir.
Percentile'leri doğru topla. Farklı instance'ların p99'larının ortalaması bir p99 değildir. Histogram tutan bir metric sistemi kullan ya da ham süreleri birleştir.
Lab sonuçlarını üretime taşırken dikkatli ol. Buradaki sayılar tek makinede, veri büyük ölçüde bellekteyken alındı. Üretimde disk, ağ ve başka iş yükleri devreye girer; aynı yöntemi kendi ortamında, gerçek veri boyutuyla tekrarla.
Sık Düşülen Tuzaklar
Ortalama latency'ye bakmak: ortalama, en çok şikâyet üreten uzun kuyruğu gizler. En az p95 ve p99'u izle.
Throughput'u istemci sayısıyla birlikte okumamak: "saniyede 187 istek" tek başına bir şey söylemez. Aynı throughput 4 istemciyle 32 ms'de, 64 istemciyle 327 ms'de alınıyorsa ikincisi doymuş bir sistemdir.
Donanımla sorgu sorununu örtmek: tablo taraması yapan bir sorguyu iki kat CPU'lu bir makineye taşımak, en iyi ihtimalle iki kat kazanç getirir; index 130 kat getirdi. Vertical scaling'e ya da replica'ya karar vermeden önce en pahalı sorguların planına bak.
Erken sharding: 3 GB'lık yıllık büyüme için shard'lanmış bir sistem kurmak, bütün sonraki geliştirmeyi yavaşlatan kalıcı bir maliyettir. Sharding kararını yazma kapasitesi ve veri boyutu ölçümleri verir, büyüme beklentisi değil.
Test verisinin dağılımını yanlış kurmak: herkesin tek siparişi olduğu ya da bütün tarihlerin aynı gün olduğu bir test verisi, index'lerin ve planların gerçekteki davranışını göstermez. Bu yazıdaki veri dört yıla yayılıyor ve son çeyreklerde yoğunlaşıyor.
Küçük Bir Deneme
★☆☆ Index'i silip yükü 8 istemciyle çalıştır, sonra ALTER DATABASE bookstore SET max_parallel_workers_per_gather = 0 ile paralel taramayı kapatıp tekrarla. Paralel taramanın throughput'a ve p99'a etkisini karşılaştır.
★★☆ load komutuna ikinci bir senaryo ekle: order_id ile tek sipariş detayı. Aynı eşzamanlılık seviyelerinde iki senaryonun throughput eğrilerini çiz ve dirseklerin nerede olduğunu karşılaştır.
★★★ Sampler'ı SQL Server için de çalıştır ve index'siz durumda CXCONSUMER oranının istemci sayısıyla nasıl değiştiğini ölç. Sonra ALTER DATABASE SCOPED CONFIGURATION SET MAXDOP = 1 ile tekrarla ve sonucu Little's Law ile açıkla.
Sonraki yazıda merdivenin ikinci basamağına çıkıyoruz: connection pooling. ADO.NET'in (.NET'in veritabanı erişim katmanı) pool'unun nasıl çalıştığını, "max pool size reached" hatasının gerçek sebeplerini, çoğalan API instance'larının veritabanını nasıl boğabileceğini ve PostgreSQL'in önüne PgBouncer koymanın getirdiği tuzakları ölçerek göreceğiz.