

Sharding'e Giriş: Shard Key, Uygulama Seviyesinde Sharding, Citus ve Distributed SQL
Sharding yazma ölçeğini ve veri boyutunu çözer, ama tek sunucuda bedava olan global ID'yi, cross-shard sorguyu ve transaction'ı pahalı hâle getirir. Lab'da iki shard aynı order_id'yi üretti ve her shard'ın ilk 10'unu birleştiren "çok satanlar" listesi doğru listeyle hiç örtüşmedi; doğru sonuç kısmi toplamlardan geldi. .NET'te bucket tabanlı IShardResolver, shard key seçimi, Citus'ta co-location ve distributed SQL.
Sürüm notu: Bu yazıdaki örnekler PostgreSQL 18.7 (shard olarak iki bağımsız container), Citus 14.2 (PostgreSQL 18.4 üzerinde; bir coordinator ve bir worker), .NET 10 ve Npgsql 10.0.3 ile tek makinelik bir lab'da çalıştırılmıştır. CockroachDB, YugabyteDB ve Spanner bölümü lab'da denenmedi, ürünlerin dokümanına dayanıyor.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) siparişlerini iki PostgreSQL sunucusuna böldü: her müşterinin müşteri kaydı, siparişleri ve sipariş kalemleri, customer_id'den hesaplanan bir shard'da duruyor. Pazarlama ekibi ana sayfa için "son 30 günün en çok satan 10 kitabı" listesini istiyor. Akla gelen ilk çözüm, her shard'dan kendi ilk 10'unu istemek ve uygulamada birleştirmek: iki shard, 20 satır, hızlı. Tahmin et: bu liste doğru listeyle aynı mı? Aynı veride iki yöntem yan yana:
exact: 37644 rows transferred from 2 shards, 347 ms
top-10 per shard: 20 rows transferred, 209 ms
  #1  exact: book    90 sold  18 | shortcut: book   278 sold  16 (really 17)
  #2  exact: book   178 sold  18 | shortcut: book   954 sold  16 (really 17)
  #3  exact: book   266 sold  18 | shortcut: book  1510 sold  16 (really 17)
  #4  exact: book   462 sold  18 | shortcut: book  1746 sold  16 (really 17)
  #5  exact: book   550 sold  18 | shortcut: book  2166 sold  16 (really 17)
  #6  exact: book   638 sold  18 | shortcut: book  2422 sold  16 (really 17)
  #7  exact: book   834 sold  18 | shortcut: book  2578 sold  16 (really 17)
  #8  exact: book   922 sold  18 | shortcut: book  3078 sold  16 (really 17)
  #9  exact: book  1010 sold  18 | shortcut: book  4310 sold  16 (really 17)
  #10 exact: book  1206 sold  18 | shortcut: book  4390 sold  16 (really 17)
On kitabın hiçbiri ortak değil. Kısayol listesindeki kitaplar bir shard'da çok satmış ama toplamda 17'de kalmış; gerçekten 18 satan kitaplar ise iki shard'a bölündüğü için hiçbir shard'ın ilk 10'una girememiş. Doğru sonucu bulmak için her shard'dan kitap başına toplamları (37.644 satır) çekip uygulamada toplamak gerekti. Sharding'in bedeli tam olarak bu: tek sunucuda tek bir GROUP BY olan sorgular dağıtık bir algoritmaya dönüşüyor. Bu yazıda sharding'in neyi çözdüğünü, shard key seçimini, .NET'te uygulama seviyesinde bir shard resolver'ı, Citus ile veritabanı seviyesinde sharding'i ve Bookstore'un neden henüz sharding'e ihtiyacı olmadığını ele alıyoruz.
Sharding Neyi Çözer, Neyi Getirir?
Sharding, aynı şemadaki verinin satırlarını farklı sunuculara bölmek demek. 07 ve 08'deki partitioning veriyi tek sunucunun içinde böler; sharding sunucuları çoğaltır. Çözdüğü iki sorun var: tek bir primary'nin kaldıramayacağı yazma yükü ve tek bir sunucuya sığmayacak veri boyutu. 06'daki read replica'lar okuma yükünü dağıtır ama her yazma yine tek primary'ye gider; yazma tarafının sınırına gelindiğinde merdivenin son basamağı sharding.
Getirdiği sorunlar da kalıcı: birden çok shard'a dokunan sorgular ve transaction'lar, tek bir sunucuda bedava olan global unique ID, verinin shard'lar arasında yeniden dağıtılması (resharding), shard sayısı kadar backup, replica, failover ve şema değişikliği. Teori ve hash, range ve directory yaklaşımlarının karşılaştırması System Design serisinin "Veri Katmanını Ölçeklemek" ve "Consistent Hashing" yazılarında. Burada pratiğe bakıyoruz.
Bookstore için sayılar net. 01'deki kapasite hesabına göre 10 kat büyümede günde yaklaşık 12.900 sipariş ve yılda 3,1 GB yeni veri var. Bu, tek bir PostgreSQL ya da SQL Server sunucusunun rahatça taşıdığı bir yazma yükü (saniyede ortalama 0,15 sipariş; kampanya tepesinde bunun yüz katı bile tek sunucu için küçük). 07'deki pgbench denemesinde tek sunucu, her biri bir okuma ve bir yazma olan saniyede 9 bin transaction'ı karşıladı. Bookstore'un sharding'e ihtiyacı yok; bu yazı ihtiyaç doğduğunda neyle karşılaşacağını göstermek için.
Shard Key Seçimi
Shard key, bir satırın hangi shard'a gideceğini belirleyen kolondur ve sonradan değiştirmesi en pahalı karardır. İyi bir shard key üç şey sağlamalı: yük shard'lara eşit dağılmalı, en sık sorgular tek shard'a gitmeli, birlikte değişen veri aynı shard'da olmalı. Bookstore için iki aday var: customer_id ve sipariş tarihi. İki shard'daki dağılım (customer_id'ye göre hash ile bölünmüş):
== shard0
 year | orders | last_30_days
------+--------+--------------
 2022 |    556 |            0
 2023 |  39575 |            0
 2024 | 102091 |            0
 2025 | 164572 |            0
 2026 | 193197 |        19938
== shard1
 year | orders | last_30_days
------+--------+--------------
 2022 |    555 |            0
 2023 |  39591 |            0
 2024 | 102076 |            0
 2025 | 164595 |            0
 2026 | 193194 |        19937
Hash ile son 30 günün siparişleri 19.938 ve 19.937 olarak iki shard'a bölünmüş. Tarihe göre range sharding (her yıl bir shard) seçilseydi son 30 günün 39.875 siparişinin tamamı 2026 shard'ına yazılırdı; 2022 shard'ı ise toplam 1.111 siparişle boş dururdu. Monotonik artan bir key (tarih, identity, UUIDv7) ile range sharding her zaman bir hot shard üretir: bütün yeni yazmalar son shard'a gider. Hash ise "Siparişlerim" gibi bir müşterinin bütün verisine ihtiyaç duyan sorguları tek shard'da tutar, ama tarih aralığı sorgularını bütün shard'lara dağıtır. Kurumsal Sipariş tarafında ise doğal key institution_id olur: bir okulun birimleri, kullanıcıları ve siparişleri aynı shard'da kalır. Bu, Çözüm Desenleri serisinin "Multi-Tenancy'de Veri İzolasyonu" yazısındaki database-per-tenant modelinin genelleştirilmiş hâli.
Uygulama Seviyesinde Sharding: IShardResolver
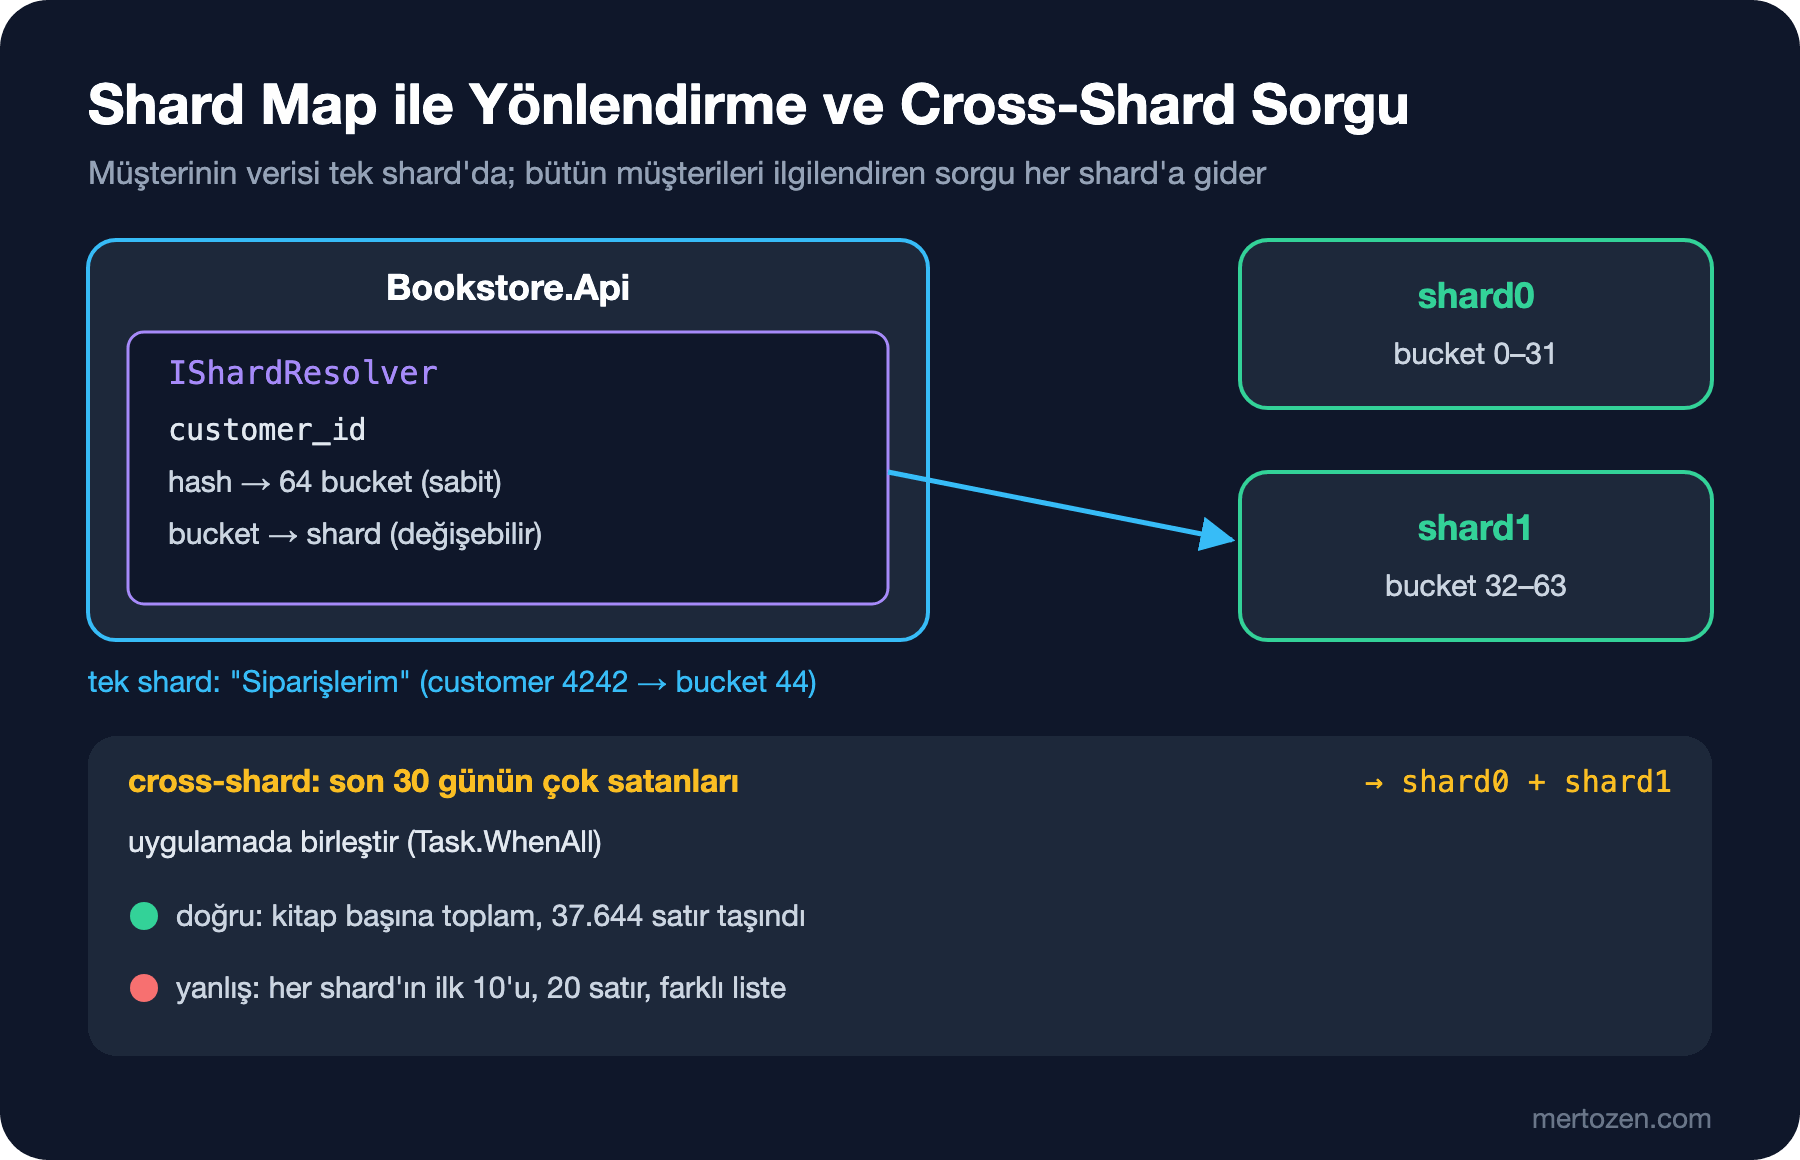
En basit sharding, uygulamanın connection'ı seçmesidir. Bookstore'da müşteri numarası önce sabit 64 bucket'tan birine, bucket da bir tablo üzerinden fiziksel shard'a eşleniyor:
// customer -> 64 bucket'tan biri (sabit, hiç değişmez) -> fiziksel shard (değişebilen bir dizin)
public sealed class BucketShardResolver(IReadOnlyList<NpgsqlDataSource> shards, int[] bucketToShard) : IShardResolver
{
    public const int BucketCount = 64;

    // SQL'deki bucket_of() ile aynı formül: Knuth'un multiplicative hash'i, 32 bit'in üst 6 bit'i
    public static int BucketOf(int customerId) => (int)((((ulong)(uint)customerId * 2654435761UL) % 4294967296UL) >> 26);

    public int ShardFor(int customerId) => bucketToShard[BucketOf(customerId)];

    public NpgsqlDataSource DataSourceFor(int customerId) => shards[ShardFor(customerId)];

    public IReadOnlyList<NpgsqlDataSource> AllShards => shards;
}
İki katman bilinçli. customer_id % 2 gibi doğrudan bir formül, shard sayısı 2'den 3'e çıktığında müşterilerin üçte ikisinin yer değiştirmesini gerektirir. Bucket sayısı ise baştan büyük seçilip hiç değişmez; yeni bir shard eklendiğinde yalnız bazı bucket'ların verisi taşınır ve dizindeki satırları güncellenir. Consistent hashing'in virtual node'ları aynı fikri uygular. Formülün bir de SQL karşılığı var (bucket_of); veriyi shard'lara dağıtırken ve taşırken uygulamayla veritabanının aynı sonucu bulması gerekiyor. string.GetHashCode() ya da HashCode.Combine bu iş için kullanılamaz: .NET bunları process başına rastgele bir seed ile hesaplar, yeniden başlayan uygulama müşteriyi başka bir shard'da arar.
Müşterinin kendi verisine giden sorgular tek shard'a gider:
customer 4242: bucket 44, shard 1, 10 orders (80.4 ms)
customer 4243: bucket 20, shard 0, 10 orders (9.2 ms)
customer 77777: bucket 53, shard 1, 10 orders (0.6 ms)
İlk iki satırdaki süreler o shard'a ilk connection'ın açılması; sonrasında pool devrede. Her shard ayrı bir NpgsqlDataSource, yani ayrı bir connection pool; 02'deki connection bütçesi artık shard sayısıyla çarpılıyor. Bir bucket'ı taşımak (resharding) üç adımlık bir iş: bucket'a ait müşterilerin satırlarını yeni shard'a kopyala, kopyalama sürerken gelen yazmaları da taşı (logical replication ya da kısa bir yazma durdurma penceresi), sonra dizindeki satırı değiştir ve eski satırları sil. 04'teki logical replication bu iş için de kullanılır.
Global ID: Identity Artık Tekil Değil
Her shard kendi identity sequence'ını tutar. İki farklı shard'daki iki müşteri aynı anda sipariş verince:
customer 4242 on shard 1: order_id 1000001
customer 4243 on shard 0: order_id 1000001
İki farklı sipariş aynı numarayı aldı. Shard'ın içinde sorun yok, ama sipariş numarası e-postada, kargo etiketinde, raporlama veritabanında ve muhasebe sisteminde shard bilgisi olmadan kullanılıyor. Çözüm, ID'yi shard'dan bağımsız üretmek: UUIDv7 (05'teki idempotency key'de kullandığımız Guid.CreateVersion7()), Snowflake gibi zaman, makine ve sayaçtan oluşan 64 bit ID'ler ya da her shard'a ayrı bir aralık veren sequence'lar. Seçeneklerin karşılaştırması System Design serisinin "Unique ID Üretimi" yazısında; müşteriye gösterilen numara ile iç ID'nin ayrılması Çözüm Desenleri serisinin "Id'yi Dışarıya Açmak" yazısında.
Cross-Shard Sorgular
Yazının başındaki çok satanlar sorgusu, cross-shard sorguların doğru yazılış biçimini gösteriyor: her shard'da kısmi toplam, uygulamada nihai toplam:
List<(int BookId, long Sold)>[] perShard = await Task.WhenAll(resolver.AllShards.Select(shard => QueryAsync(shard, perBook)));
Dictionary<int, long> totals = perShard.SelectMany(rows => rows)
    .GroupBy(r => r.BookId)
    .ToDictionary(g => g.Key, g => g.Sum(r => r.Sold));
List<(int BookId, long Sold)> exact = [.. totals
    .Select(t => (BookId: t.Key, Sold: t.Value))
    .OrderByDescending(r => r.Sold).ThenBy(r => r.BookId)
    .Take(10)];
Sorgular Task.WhenAll ile paralel gidiyor, yani toplam süre en yavaş shard kadar. COUNT, SUM, MIN ve MAX kısmi sonuçlardan doğru birleştirilir; ortalama için toplam ve sayı ayrı ayrı çekilmelidir; medyan ve yüzdelikler gibi değerler kısmi sonuçlardan hiç hesaplanamaz. ORDER BY ... LIMIT ise yazının başında gördüğümüz gibi, sıralama key'i shard key değilse yanlış sonuç verir. Shard sayısı arttıkça taşınan satır sayısı ve en yavaş shard'ı bekleme süresi büyür.
Cross-shard yazmalar daha zor. İki shard'a birlikte yazılması gereken bir işlem (örneğin bir kurumun siparişi farklı shard'lardaki müşterilerin stoklarını etkiliyorsa) distributed transaction ister; neden kaçınıldığı Distributed Systems Temelleri serisinin "Distributed Transaction ve Two-Phase Commit" yazısında. Pratik kural, shard key'i birlikte değişen veriyi aynı shard'da tutacak şekilde seçmek ve kalan durumları event'lerle eventual consistency'ye bırakmak. Raporlama ise genellikle shard'lardan değil, onları besleyen ayrı bir analitik depodan yapılır. OLTP (Online Transaction Processing; günlük işlemleri yürüten sistem) ile OLAP (Online Analytical Processing; analiz ve rapor için modellenmiş sistem) ayrımı ve star schema, Data Modeling ve Normalizasyon serisinin "OLTP ve OLAP Modeling" yazısında.
Veritabanı Seviyesinde Sharding: Citus
Citus, PostgreSQL'i bir extension olarak dağıtık hâle getirir: bir coordinator sorguları alır, tablolar shard'lara bölünüp worker node'lara dağıtılır ve sorgu planı her shard'a gönderilir. Citus 11'den beri tamamen açık kaynak; Azure'da managed hâli Azure Database for PostgreSQL elastic clusters olarak sunuluyor. Lab'da bir coordinator ve bir worker kurduk, coordinator'ın da shard tutmasına izin verdik. Uygulama seviyesindeki kuralın aynısı burada da karşımıza çıktı:
CREATE TABLE orders_try (
    order_id    bigint GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
    customer_id int NOT NULL,
    created_at  timestamptz NOT NULL
);
SELECT create_distributed_table('orders_try', 'customer_id');
ERROR: cannot create constraint on "orders_try"
DETAIL: Distributed relations cannot have UNIQUE, EXCLUDE, or PRIMARY KEY constraints that do not include the partition column (with an equality operator if EXCLUDE).Partitioning'deki kuralın aynısı: her shard tekilliği yalnız kendi içinde garanti edebilir. Bookstore şeması Citus'ta üç tür tabloyla kuruldu:
SELECT create_reference_table('books');
SELECT create_distributed_table('customers', 'customer_id');
SELECT create_distributed_table('orders', 'customer_id', colocate_with => 'customers');
SELECT create_distributed_table('order_items', 'customer_id', colocate_with => 'orders');
ALTER TABLE order_items ADD FOREIGN KEY (customer_id, order_id) REFERENCES orders;
ALTER TABLE order_items ADD FOREIGN KEY (book_id) REFERENCES books;
books reference table: her node'da tam bir kopyası var, böylece her shard kitaplarla yerel olarak join yapabiliyor. Müşteriler, siparişler ve kalemler customer_id ile dağıtıldı ve co-located: aynı müşterinin satırları aynı node'da, aynı shard numarasıyla duruyor. Bunun için orders'ın primary key'i (customer_id, order_id) oldu ve order_items'a customer_id kolonu eklendi. Foreign key'ler tablo dağıtıldıktan sonra eklendi; yerel bir tablodan dağıtık bir tabloya foreign key tanımlanamıyor. Varsayılan 32 shard iki node'a eşit dağıldı:
 nodename | shards |  size
----------+--------+--------
 citus-c  |     16 | 136 MB
 citus-w1 |     16 | 136 MB
"Siparişlerim" sorgusu tek bir shard'a yönlendirildi (router query; plan kısaltıldı):
 Custom Scan (Citus Adaptive)
   Task Count: 1
   Tasks Shown: All
   ->  Task
         Node: host=citus-c port=5432 dbname=postgres
         ->  Limit
               ->  Sort
                     Sort Key: created_at DESC
                     ->  Bitmap Heap Scan on orders_102053 orders
                           Recheck Cond: (customer_id = 4242)
Çok satanlar sorgusu ise 32 shard'ın hepsine gitti ve Citus bizim uygulamada elle yaptığımızı kendisi yaptı: her shard'da book_id'ye göre kısmi toplam (HashAggregate), coordinator'da nihai toplam ve sıralama (plan kısaltıldı):
 Limit
   ->  Sort
         Sort Key: ((pg_catalog.sum(remote_scan.sold))::bigint) DESC, remote_scan.book_id
         ->  HashAggregate
               Group Key: remote_scan.book_id
               ->  Custom Scan (Citus Adaptive)
                     Task Count: 32
                     Tasks Shown: One of 32
                     ->  Task
                           ->  HashAggregate
                                 Group Key: oi.book_id
                                 ->  Hash Join
                                       Hash Cond: ((oi.customer_id = o.customer_id) AND (oi.order_id = o.order_id))
Sonuç, uygulamada hesapladığımız doğru listeyle aynıydı (kitap 90, 178, 266… her biri 18 adet). Join koşuluna customer_id'yi eklemeyi unutunca ise Citus sorguyu reddetti:
ERROR:  the query contains a join that requires repartitioning
HINT:  Set citus.enable_repartition_joins to on to enable repartitioning
Co-located tablolar ancak dağıtım kolonu üzerinden join edildiğinde shard içinde birleşir; aksi hâlde satırların node'lar arasında yeniden dağıtılması gerekir. Citus bunu varsayılan olarak kapalı tutuyor, çünkü maliyeti veri büyüklüğüyle artıyor. Uygulama kodunda dağıtım kolonunu her sorguya taşımak, Citus'u verimli kullanmanın ilk kuralı.
Distributed SQL: CockroachDB, YugabyteDB ve Spanner
Bir başka aile, sharding'i, replication'ı ve dağıtık transaction'ı motorun kendisine gömen distributed SQL veritabanları. CockroachDB ve YugabyteDB PostgreSQL wire protocol'ünü konuşur, Google Cloud Spanner'ın PostgreSQL arayüzü var. Veriyi otomatik olarak aralıklara böler, aralıkları consensus ile (Raft ya da Paxos) çoğaltır, node eklendiğinde dengeyi kendileri kurar ve shard'lar arası transaction'ları uygulamadan saklar. Bedeli: her yazma bir consensus turu beklediği için tek satırlık yazmaların gecikmesi tek sunuculu bir PostgreSQL'den yüksektir, PostgreSQL uyumluluğu tam değildir (extension'lar, bazı tipler ve fonksiyonlar) ve işletme ile lisans modelleri farklıdır. Ne zaman düşünülmeli: birden çok bölgede aynı anda yazma, otomatik bölge failover'ı ve tek sunucunun yazma sınırını aşan bir yük birlikte gerekiyorsa. Bookstore'un bugünkü ölçeği için bunların hiçbiri geçerli değil. Bu bölümdeki ürünleri lab'da denemedik; lisans ve fiyat modellerini yazım günündeki resmî sayfalarından kontrol et. Arkalarındaki fikirler (Spanner'ın TrueTime'ı, CockroachDB'nin hybrid logical clock'u) Distributed Systems Temelleri serisinin "Gerçek Sistemlerden Dersler" yazısında. MongoDB'nin sharding'i ise MongoDB serisinin "Replica Set ve Sharding" yazısında.
Üretimde Dikkat
Sharding'i son basamak olarak tut. 01'deki merdivenin önceki basamakları (sorgu ve index, pooling, cache, vertical scaling, read replica, partitioning ve arşiv) çoğu sistemi yıllarca taşır. Sharding'e geçmeden önce hangi kaynağın tükendiğini 01'deki gibi ölç: disk yazmaları mı, log üretimi mi, CPU mu, depolama mı.
Bucket sayısını baştan büyük seç. 64 ya da 256 gibi bir bucket sayısı, ilk gün iki shard olsa bile ileride bucket'ları taşıyarak 4, 8, 16 shard'a çıkmayı sağlar. Bucket sayısını değiştirmek bütün veriyi yeniden dağıtmak demek.
Her shard bir veritabanı sunucusu. 04 ve 05'teki replica ve failover, 07 ve 08'deki partitioning ve arşiv job'ları, şema migration'ları ve backup/restore testleri artık shard sayısı kadar. Migration'ları bütün shard'lara uygulayan ve yarım kalanı fark eden bir araç gerekiyor.
Cross-shard sorguları ölç ve sınırla. Bütün shard'lara giden her sorgu en yavaş shard kadar yavaştır. Bu sorguları tespit eden bir log ya da metric tut; sayıları artıyorsa shard key yanlış seçilmiş olabilir.
Sık Düşülen Tuzaklar
Monotonik shard key ile range sharding: tarihe göre bölünmüş shard'larda bütün yeni yazmalar son shard'a gider. Hash ya da directory kullan.
Her shard'ın ilk N'ini birleştirmek: yazının başındaki liste tamamen yanlıştı. Sıralama key'i shard key değilse kısmi toplamları çek ve uygulamada topla, ya da işi bir analitik depoya bırak.
Cross-shard JOIN'i uygulama koduna gömmek: iki shard'dan veri çekip bellekte join yapan kod, veri büyüdükçe hem yavaşlar hem de belleği zorlar. Birlikte okunan veriyi aynı shard'da tut (co-location) ya da join'i raporlama tarafına taşı.
Identity'yi global ID sanmak: iki shard aynı order_id'yi üretti. ID'yi shard'dan bağımsız üret.
GetHashCode() ile shard seçmek: .NET string hash'leri process başına değişir; yeniden başlatılan uygulama veriyi başka shard'da arar.
Küçük Bir Deneme
★☆☆ BucketShardResolver'a üçüncü bir shard ekle ve 64 bucket'ı üç shard'a dağıtan bir dizin yaz. Kaç bucket'ın, dolayısıyla müşterilerin yüzde kaçının yer değiştirmesi gerekiyor? Aynı soruyu customer_id % shardCount için cevapla.
★★☆ Çok satanlar sorgusuna "kategori başına ortalama sipariş tutarı" ekle. Her shard'dan hangi kısmi değerleri çekmen gerektiğini düşün ve sonucu tek sunuculu bir PostgreSQL'deki sorguyla karşılaştırarak doğrula.
★★★ Citus'ta SELECT citus_add_node(...) ile üçüncü bir node ekle ve citus_rebalance_start() ile shard'ları dengele. Rebalance sürerken "Siparişlerim" sorgusunu 06'daki rw-routing döngüsüne benzer bir döngüyle çalıştır ve hata ya da gecikme olup olmadığını ölç.
Seri boyunca merdivenin bütün basamaklarını gördük. Son yazıda hepsini birleştiriyoruz: Bookstore'un 10 kat büyümesi için başlangıç ölçümleri, hedef SLO (Service Level Objective; servisin tutturmayı hedeflediği performans değeri), sırayla atılan adımlar, her adımın karar kaydı, aynı metrikle doğrulama ve bir failover tatbikatı.