

.NET'te Read/Write Splitting: Read Replica'ya Yönlendirmek ve Read-Your-Writes Sorunu
Okumaları replica'ya taşımak için iki context yetmez; replica'nın geride olduğu anları bilen bir router gerekir. Lab'da lag'i sıfır görünen replica'dan okuyan müşterilerin 1.000 siparişin 4'ünü, replay durunca 300'ün 300'ünü göremediğini ölçtük; lag eşiği ve kullanıcının son yazmasının LSN'ine bakan router ile kaçan sipariş sıfır. Npgsql prefer-standby, SQL Server read-only routing ve hot standby conflict.
Sürüm notu: Bu yazıdaki örnekler PostgreSQL 18.7 (iki container: primary ve streaming replica), SQL Server 2025 (CU10, 17.0.5035.5), .NET 10, Npgsql 10.0.3, Npgsql.EntityFrameworkCore.PostgreSQL 10.0.3 ve Microsoft.Data.SqlClient 7.1.2 ile tek makinelik bir lab'da çalıştırılmıştır. SQL Server'ın Always On availability group'u (AG; birden çok replica'yı tek bir grup olarak yöneten yüksek erişilebilirlik özelliği) ve read-only routing lab'da kurulmadı; o bölüm Microsoft dokümanına dayanıyor.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı), 04'te kurduğumuz streaming replica'yı yalnız yedek olarak tutmak istemiyor: "Siparişlerim" sayfasının okumaları replica'ya gidecek, primary yazmalarla uğraşacak. Akış basit: müşteri siparişi tamamlar, sipariş primary'ye yazılır, tarayıcı hemen "Siparişlerim" sayfasına geçer ve liste replica'dan okunur. Lab'da bu akışı 1.000 sipariş için çalıştırdık. Replica aynı makinede, boşta ve pg_stat_replication'a göre lag'i sıfır.
Tahmin et: 1.000 siparişin kaçında müşteri az önce verdiği siparişi listede göremez?
strategy=naive orders=1000 missing_in_list=4 replica_reads=5000 primary_reads=0
replica: reachable=True lag=0.0 s
Dört. Hiçbir yükün olmadığı, ağ gecikmesinin mikrosaniyelerle ölçüldüğü bir lab'da bile her 250 siparişten birinde müşteri "siparişim nerede?" diye düşündü. Sonra replica'nın replay'ini pg_wal_replay_pause() ile durdurduk; bu, 03'teki büyük bir silme işinin ya da replica'da çalışan ağır bir raporun replica'yı birkaç saniye geride bırakmasının kontrollü hâli:
strategy=naive orders=300 missing_in_list=300 replica_reads=1500 primary_reads=0
replica: reachable=True lag=7.8 s
300 siparişin hiçbiri listede yoktu. Bu yazıda okumaları replica'ya taşımanın .NET tarafını kuruyoruz: Npgsql'in multi-host data source'u, SQL Server'ın read-only routing'i, iki ayrı DbContext ve en önemlisi replica'ya ne zaman gitmemek gerektiğine karar veren küçük bir router.
Hangi Okumalar Replica'ya Gider?
Read replica okuma kapasitesini artırır, yazma kapasitesini artırmaz. Bookstore'un trafiğinin büyük kısmı okuma: katalog, kitap detayı, arama, "Siparişlerim", back office raporları. Bunların çoğu birkaç saniye eski veriyle sorunsuz çalışır; dün eklenen bir kitabın katalogda bir saniye geç görünmesini kimse fark etmez. Ama bazı okumalar güncel veri ister ve primary'de kalmalıdır: checkout sırasında stok ve fiyat kontrolü, ödeme durumu, bir yazmanın hemen öncesindeki "var mı?" kontrolü ve kullanıcının az önce yaptığı bir değişikliği gösteren ekranlar.
Bu ayrım CQRS'in (Command Query Responsibility Segregation; yazma ve okuma modellerini ayırmak) okuma tarafıyla doğal olarak örtüşür. CQRS ve Event Sourcing serisinin "Tek Veritabanında CQRS" yazısında okuma tarafını ayrı bir model olarak kurmanın tasarım tarafını anlatmıştık. Burada aynı fikrin veritabanı katmanındaki en basit hâlini kuruyoruz: aynı şema, aynı tablolar, iki farklı sunucu.
PostgreSQL: Multi-Host Data Source ve Target Session Attributes
05'te Npgsql'in birden çok host'u tanıyan data source'unu failover için kullanmıştık. Aynı data source okuma yönlendirmesi için de kullanılabilir. Connection string iki host'u da listeler:
Host=pg1:5432,pg2:5432;Database=bookstore;Username=bookstore_api;Password=<secret>;Timeout=3Npgsql her host'a bağlandığında onun primary mi standby mi olduğunu sorar ve bunu Host Recheck Seconds (varsayılan 10) boyunca cache'ler. WithTargetSession aynı multi-host data source'tan, yalnız belirli rolde sunuculara connection veren data source'lar üretir. Npgsql'in dokümanına göre seçenekler any, primary, standby, prefer-primary, prefer-standby, read-write ve read-only; Load Balance Hosts=true ise connection'ları uygun host'lar arasında sırayla dağıtır. Bookstore'da üç data source kullanıyoruz:
NpgsqlMultiHostDataSource cluster = new NpgsqlDataSourceBuilder(Db.Env("BOOKSTORE_PG_HA")).BuildMultiHost();
NpgsqlDataSource primary = cluster.WithTargetSession(TargetSessionAttributes.Primary);
NpgsqlDataSource preferStandby = cluster.WithTargetSession(TargetSessionAttributes.PreferStandby);
NpgsqlDataSource standbyOnly = cluster.WithTargetSession(TargetSessionAttributes.Standby);

ServiceCollection services = new();
services.AddDbContext<BookstoreContext>(o => o.UseNpgsql(primary));
services.AddDbContext<BookstoreReadContext>(o => o
    .UseNpgsql(preferStandby)
    .UseQueryTrackingBehavior(QueryTrackingBehavior.NoTracking));
primary yazmalar için, prefer-standby okumalar için: standby varsa ona, yoksa primary'ye gider. standbyOnly'yi birazdan replica'nın durumunu ölçmek için kullanacağız. Uygulamada iki context var. BookstoreContext her zamanki EF Core context'i. BookstoreReadContext aynı entity'leri map'liyor ama yazmaya izin vermiyor:
// eskimiş olabilecek okumalar: mümkünse replica, tracking yok, kaydetme yok
public sealed class BookstoreReadContext(DbContextOptions<BookstoreReadContext> options) : DbContext(options)
{
    public IQueryable<Order> Orders => Set<Order>();

    protected override void OnModelCreating(ModelBuilder modelBuilder) => OrderMapping.Configure(modelBuilder);

    public override Task<int> SaveChangesAsync(bool acceptAllChangesOnSuccess, CancellationToken cancellationToken = default) =>
        throw new InvalidOperationException("BookstoreReadContext is read-only.");
}
DbSet yerine IQueryable açmak ve SaveChangesAsync'i kapatmak, birinin yanlışlıkla okuma context'iyle yazmaya çalışmasını derleme ya da ilk test anında yakalar. NoTracking da okuma tarafında change tracker'ın gereksiz maliyetini kaldırır. Dapper kullanan bir projede aynı ayrım bir IDbConnectionFactory üzerinde OpenWriteAsync ve OpenReadAsync gibi iki method'la kurulur. Her context'in hangi sunucuya gittiğini görmek için ikisinde de current_setting('cluster_name') sorduk:
write -> pg1, read -> pg2 (271 ms)
write -> pg1, read -> pg2 (19 ms)
write -> pg1, read -> pg2 (0 ms)
İlk satırdaki süre, Npgsql'in iki host'un rolünü ilk kez öğrenmesinin ve connection'ların açılmasının bedeli; sonrasında pool devrede.
SQL Server: Read-Only Routing ve ApplicationIntent
SQL Server'da yönlendirmeyi istemci değil Always On availability group'un listener'ı yapar. İstemci listener'a bağlanırken connection string'inde ApplicationIntent=ReadOnly belirtir; listener, primary replica'nın read-only routing listesindeki ilk uygun readable secondary'ye yönlendirir. SQL Server 2016'dan beri liste iç içe parantezle bir grup replica arasında yük dağıtabilir. Microsoft'un dokümanındaki örneğe dayanan yapılandırma (lab'da AG olmadığı için çalıştırmadık):
ALTER AVAILABILITY GROUP [BookstoreAG]
MODIFY REPLICA ON N'SQL2' WITH
(SECONDARY_ROLE (ALLOW_CONNECTIONS = READ_ONLY, READ_ONLY_ROUTING_URL = N'TCP://sql2.bookstore.example:1433'));

ALTER AVAILABILITY GROUP [BookstoreAG]
MODIFY REPLICA ON N'SQL1' WITH
(PRIMARY_ROLE (READ_ONLY_ROUTING_LIST = (('SQL2', 'SQL3'), 'SQL1')));
Okuma connection string'i şuna benzer:
Server=tcp:bookstore-listener,1433;Database=BookstoreDb;Integrated Security=True;ApplicationIntent=ReadOnly;MultiSubnetFailover=TrueListede primary'nin kendisi en sonda olduğu için iki secondary de erişilemezse okuma primary'ye düşer; Npgsql'in prefer-standby'ına benzer bir davranış. Dokümanın vurguladığı koşullar: bağlantı listener üzerinden olmalı ve connection string bir veritabanı adı içermeli; aksi hâlde yönlendirme olmaz. ApplicationIntent'in kendisi yalnız bir istektir. Bunu lab'daki tek SQL Server'da gördük: aynı tabloya iki farklı intent ile yazıp veritabanının durumunu sorduk:
ApplicationIntent=ReadWrite: updateability=READ_WRITE, insert ok
ApplicationIntent=ReadOnly: updateability=READ_WRITE, insert ok
AG'siz bir sunucu intent'i yok sayar ve ReadOnly connection'la yazmaya izin verir. Yani testlerde ve geliştirme ortamında "okuma connection'ım yanlışlıkla yazıyor mu?" sorusunun cevabını bu ayar vermez; readable secondary'de aynı yazma 3906 hatasıyla düşer (04'te log shipping standby'ında görmüştük). Okuma context'inin SaveChangesAsync'i kapatması bu yüzden SQL Server'da da işe yarar.
Read-Your-Writes: Kullanıcı Kendi Siparişini Görmeli
Yazının başındaki deneyin kodu şu: sipariş primary'ye yazılır, ardından müşteri ve rastgele dört müşteri daha kendi sipariş listesini okur:
Order order = new() { CustomerId = customerId, TotalAmount = 249.90m, CreatedAt = DateTime.UtcNow };
write.Orders.Add(order);
await write.SaveChangesAsync();
orderId = order.OrderId;
lastWriteByCustomer[customerId] = await write.Database
    .SqlQueryRaw<NpgsqlLogSequenceNumber>("SELECT pg_current_wal_lsn() AS \"Value\"")
    .SingleAsync();
List<long> myOrders = await read.Orders
.Where(o => o.CustomerId == reader)
.OrderByDescending(o => o.CreatedAt)
.Select(o => o.OrderId)
.Take(20)
.ToListAsync();Async replication'da commit primary'de tamamlanır, replica aynı değişikliği biraz sonra uygular. Arada kalan süre lag'dir ve read-your-writes (bir kullanıcının kendi yaptığı yazmayı sonraki okumalarında mutlaka görmesi) garantisini bozar. Teorisi Distributed Systems Temelleri serisinin "Consistency Model'leri" yazısında. Pratikte dört yol var:
- Kritik okumaları hep primary'de tutmak: checkout, ödeme, stok. En basiti ve ilk yapılması gereken.
- Yazmadan sonra kısa bir süre o kullanıcının okumalarını primary'ye göndermek: örneğin 5 saniye. Basit, ama süre tahmine dayanıyor; lag 5 saniyeyi geçerse yine eski veri görülür.
- Kullanıcının son yazmasının WAL (Write-Ahead Log; PostgreSQL'in değişiklikleri önce yazdığı transaction log'u) konumunu (LSN, Log Sequence Number; WAL'daki bir kaydın adresi) saklamak ve replica o konumu uygulamadıysa primary'den okumak. Kesin ve ölçülebilir.
- Lag bir eşiği aşınca replica'yı bütün okumalar için devre dışı bırakmak. Read-your-writes'tan bağımsız olarak "çok eski veri" sorununu çözer.
Son iki yolu birlikte kurduk. LSN'i yazmadan hemen sonra pg_current_wal_lsn() ile alıyoruz; commit kaydı bu konumdan önce WAL'a yazılmıştır. Web uygulamasında bu değer kısa ömürlü bir cookie'de ya da oturumda tutulur; lab'da müşteri başına bir dictionary'de.
Router: Lag Eşiği ve LSN Kontrolü
Replica'nın ne kadar geride olduğunu her okumada sormak, her okumaya bir round trip ekler. Bunun yerine bir monitor replica'ya 200 ms'de bir sorar ve sonucu bellekte tutar:
SELECT pg_last_wal_replay_lsn(),
       CASE WHEN pg_last_wal_receive_lsn() = pg_last_wal_replay_lsn() THEN 0
            ELSE coalesce(extract(epoch FROM now() - pg_last_xact_replay_timestamp()), 0)
       END::float8
pg_last_wal_replay_lsn() replica'nın uyguladığı son konum. Lag için yaygın formül, alınan ve uygulanan konum eşitse sıfır, değilse son uygulanan transaction'ın commit zamanından bu yana geçen süre; primary'de yazma yokken lag'in sebepsiz büyümesini böylece engelliyoruz. Monitor standbyOnly data source'unu kullanır, çünkü prefer-standby replica düşünce primary'ye bağlanır ve primary'nin "lag'i" ölçülmüş olur. Kararı veren router:
public sealed class ReadRouter(ReplicaLagMonitor monitor, TimeSpan maxLag, TimeSpan maxSampleAge)
{
    // lastWrite: bu kullanıcının son yazmasının WAL konumu (kısa ömürlü bir cookie'de tutulur)
    public ReadTarget Choose(NpgsqlLogSequenceNumber? lastWrite)
    {
        ReplicaState replica = monitor.Current;
        if (!replica.Reachable || DateTime.UtcNow - replica.SampledAt > maxSampleAge)
        {
            return ReadTarget.Primary;
        }
        if (replica.Lag > maxLag)
        {
            return ReadTarget.Primary;
        }
        if (lastWrite is { } lsn && replica.ReplayLsn < lsn)
        {
            return ReadTarget.Primary;
        }
        return ReadTarget.Replica;
    }
}
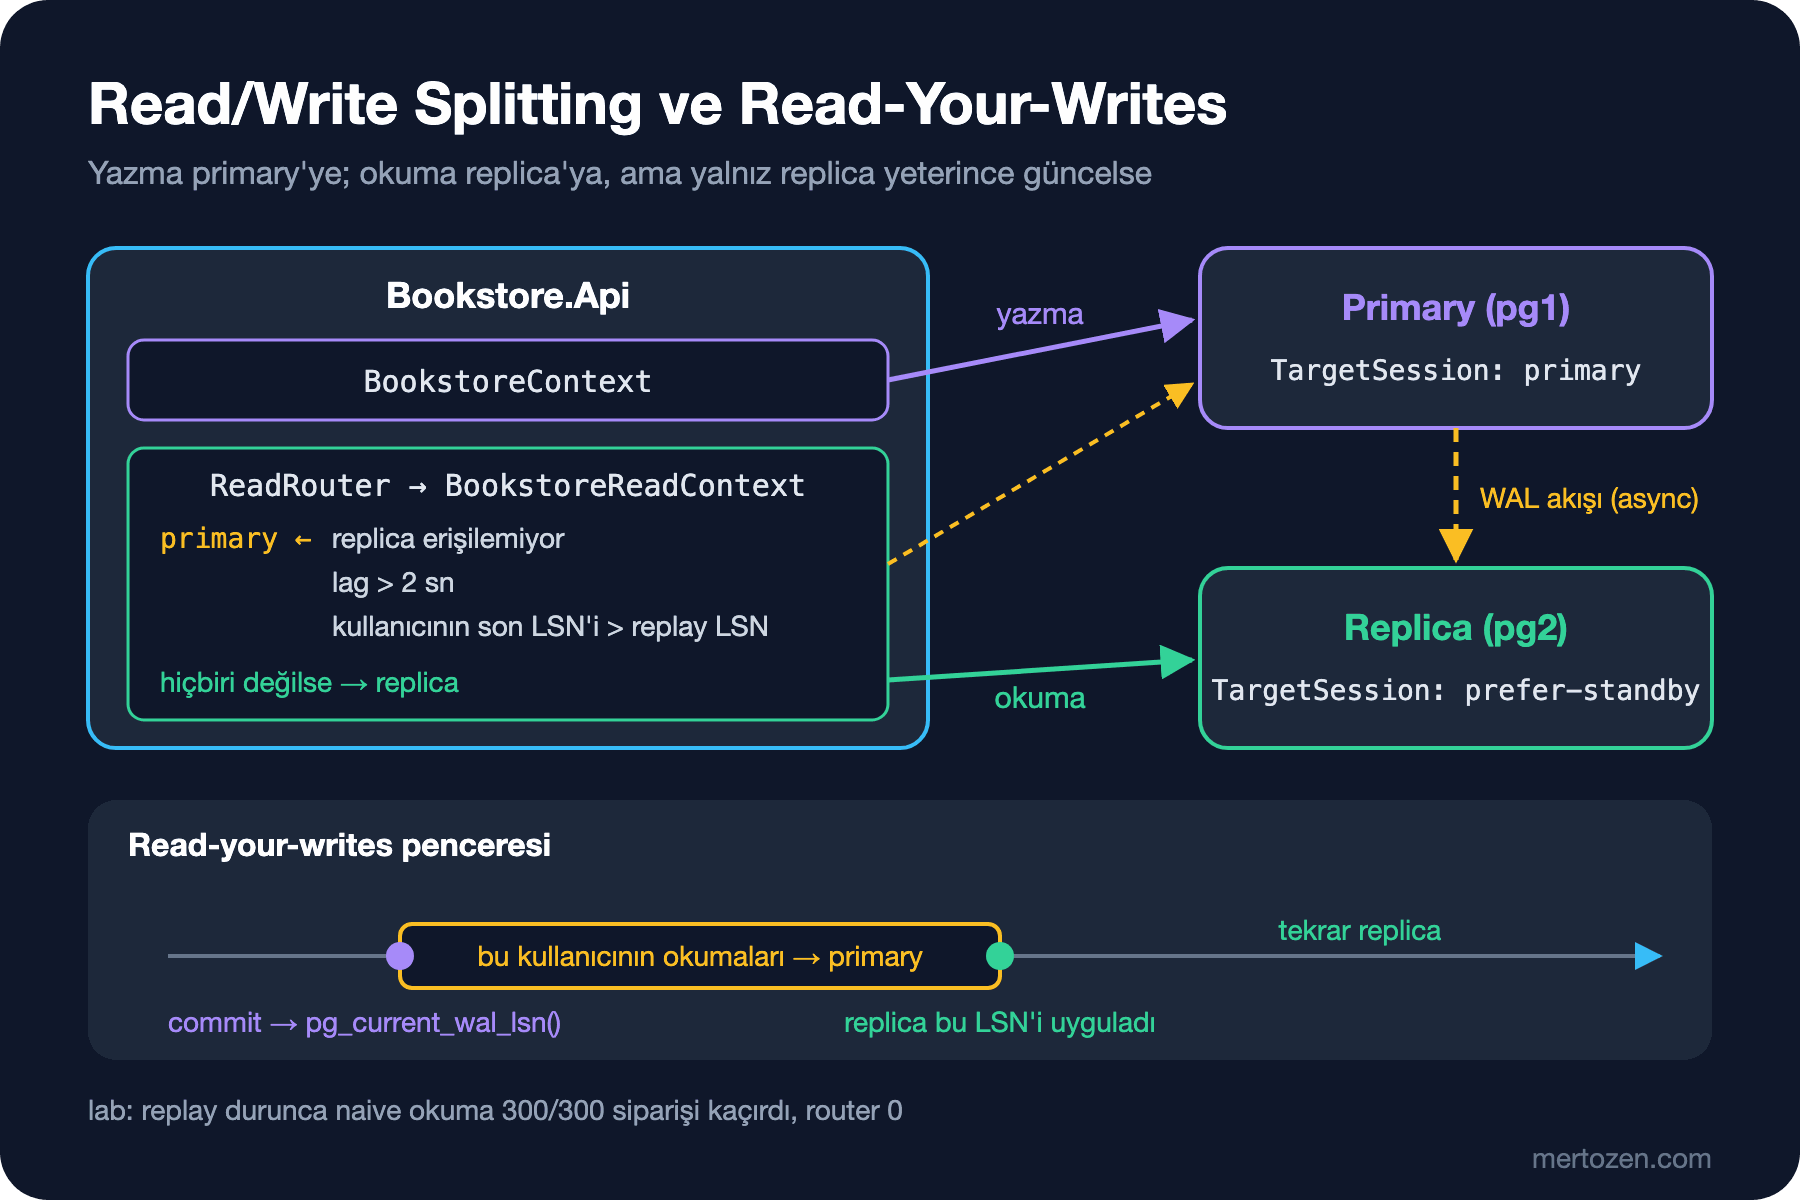
Üç kural var: replica'dan haber yoksa ya da haber eskiyse primary; lag 2 saniyeyi aşmışsa primary; kullanıcının son yazması replica'da henüz uygulanmamışsa primary. Monitor'ün değeri en fazla 200 ms eski olduğu için LSN kontrolü temkinli tarafta hata yapar: replica aslında yetişmiş olsa bile ilk birkaç yüz milisaniye primary'ye gidilir. ReadContextFactory kararı uygular ve doğru sunucuya bağlanan bir BookstoreReadContext döner:
public BookstoreReadContext Create(NpgsqlLogSequenceNumber? lastWrite, out ReadTarget target)
{
    target = router.Choose(lastWrite);
    return new BookstoreReadContext(target == ReadTarget.Replica ? replicaOptions : primaryOptions);
}
Aynı 1.000 siparişlik deney, router ile:
strategy=routed orders=1000 missing_in_list=0 replica_reads=4000 primary_reads=1000
replica: reachable=True lag=0.0 s
Kaçan sipariş yok. Siparişi veren müşterinin hemen ardından gelen okuması (1.000 okuma) primary'ye gitti, diğer müşterilerin 4.000 okuması replica'da kaldı. Replay durdurulmuş replica ile:
strategy=routed orders=300 missing_in_list=0 replica_reads=24 primary_reads=1476
replica: reachable=True lag=8.0 s
İlk iki saniyede, lag eşiği aşılana kadar, başka müşterilerin 24 okuması replica'dan yapıldı; sonra bütün okumalar primary'ye döndü ve hiçbir sipariş kaçmadı. Bedel de görünüyor: replica geride kaldığında okuma yükünün tamamı primary'ye biner. Bu yüzden eşiği ve primary'nin bu yükü kaldırıp kaldıramayacağını birlikte düşünmek gerekir; primary okumayı kaldıramıyorsa eski veri göstermek ile yavaşlamak arasında bilinçli bir seçim yapmak gerekir.
PostgreSQL 19 bu kontrolü sunucuya taşıyan bir WAIT FOR LSN komutu getiriyor: replica, verilen konumu uygulayana kadar bekliyor. 19 yazım gününde henüz GA (General Availability; herkese açık kararlı sürüm) olmadığı için örnek vermiyoruz; o zamana kadar "yetişmediyse primary'den oku" ana çözüm.
Replica Düşerse
Router'ın ilk kuralı replica'nın erişilemediği durum için. Npgsql'in prefer-standby'ı da aynı işi connection seviyesinde yapar. Okuma döngüsü çalışırken replica container'ını durdurduk:
write -> pg1, read -> pg2 (281 ms)
write -> pg1, read -> pg2 (19 ms)
write -> pg1, read -> pg2 (2 ms)
--- pg2 stopped
write -> pg1, read -> InvalidOperationException: An exception has been raised that is likely due to a transient failure. (5 ms)
write -> pg1, read -> pg1 (2 ms)
write -> pg1, read -> pg1 (1 ms)
Bir okuma hata verdi, sonrakiler primary'ye gitti. Hata veren okuma, pool'da bekleyen ve replica'ya açık olan bir connection'ı kullandı; Npgsql'in dokümanına göre failover yalnız connection açılırken çalışır, açık bir connection'da başarısız olan komut başka bir host'ta tekrar denenmez. 05'teki çözüm burada da geçerli: okuma context'ine bir retry strategy ekledik:
npgsql.EnableRetryOnFailure(maxRetryCount: 3, maxRetryDelay: TimeSpan.FromSeconds(1), errorCodesToAdd: null);write -> pg1, read -> pg2 (261 ms)
write -> pg1, read -> pg2 (19 ms)
write -> pg1, read -> pg2 (2 ms)
--- pg2 stopped
write -> pg1, read -> pg1 (6 ms)
write -> pg1, read -> pg1 (2 ms)
write -> pg1, read -> pg1 (1 ms)Retry yeni bir connection açtı, prefer-standby replica'yı bulamayınca primary'yi verdi ve kullanıcı hiçbir şey görmedi. Okumalar idempotent olduğu için burada retry güvenli; 05'teki idempotency tartışması yalnız yazmalar için gerekli.
Replica'da Uzun Sorgular: Hot Standby Conflict
Replica'ya taşınan raporlar yeni bir sorun getirir. Primary'de VACUUM, artık hiçbir transaction'ın görmediği eski satır sürümlerini siler; bu silme WAL ile replica'ya da gelir. Replica'da o satırları hâlâ görmesi gereken uzun bir sorgu varsa ikisi çakışır. 04'te bu dengeyi kuran iki ayarı anmıştık. Replica'yı hot_standby_feedback=off ve max_standby_streaming_delay=3s ile kurup replica'da 15 saniyelik bir rapor sorgusu başlattık; 2. saniyede primary'de 4.900 siparişi güncelleyip VACUUM çalıştırdık:
SELECT pg_sleep(15), count(*) AS orders_in_report FROM orders;ERROR: canceling statement due to conflict with recovery
DETAIL: User query might have needed to see row versions that must be removed.
Time: 5705.984 ms (00:05.706)Replica, replay'i 3 saniye bekletti, sonra sorguyu iptal etti; pg_stat_database_conflicts'teki confl_snapshot sayacı 1 arttı. Aynı deneyi hot_standby_feedback=on ile tekrarladık. Rapor 15 saniyede tamamlandı, ama primary'deki VACUUM'un çıktısındaki ilgili satır bedeli gösteriyor:
tuples: 0 removed, 1690171 remain, 8801 are dead but not yet removableFeedback açıkken replica, en eski snapshot'ını primary'ye bildirir ve primary o satırları silmez. Rapor bitip feedback güncellendikten sonra (varsayılan olarak 10 saniyede bir) VACUUM 8.801 satırı temizledi. Yani seçim şu: ya replica'daki uzun sorgular iptal edilir, ya replay gecikir ve lag büyür (max_standby_streaming_delay'i büyütmek), ya da primary'de bloat birikir (hot_standby_feedback=on). Saatlerce süren raporlar için en temiz yol, onları bu replica'dan ayırmak: 04'teki logical replication ile beslenen ayrı bir raporlama veritabanı.
Üretimde Dikkat
Lag'i metric ve alarm yap. Router'ın kullandığı değer aynı zamanda bir dashboard metriği olmalı. "Okumaların yüzde kaçı replica'dan yapıldı" sayısı da izlenmeli; bu oran düşerse replica sorun yaşıyor ve yük sessizce primary'ye biniyor demektir.
Primary'nin okuma yükünü kaldırabildiğinden emin ol. Router güvenli tarafta hata yapar; replica geride kaldığında bütün okuma primary'ye döner. Replica'ya güvenerek primary'yi küçültürsen ilk büyük lag'de primary de zorlanır.
Connection bütçesini iki sunucu için ayrı hesapla. Her API instance'ı artık iki pool tutar; replica düştüğünde prefer-standby pool'u da primary'ye bağlanır. 02'deki bütçe hesabı primary için iki pool'un toplamıyla yapılmalı.
Birden çok replica'da Load Balance Hosts=true okumaları dağıtır, ama her replica'nın lag'i ayrıdır. Router'ı replica başına durum tutacak şekilde genişletmek ya da lag'i eşiği aşan replica'yı listeden çıkarmak gerekir.
Sık Düşülen Tuzaklar
Transaction'ı iki sunucuya bölmek: stok replica'dan okunup sipariş primary'ye yazılıyorsa, okunan stok eski olabilir ve iki işlem aynı transaction'da değildir. Bir yazmanın kararını veren okuma, yazmayla aynı transaction'da primary'de yapılmalı.
"Okuma" sanılan bir yazma: Bookstore'da kitap detayını dönen book_details fonksiyonu, istatistik için book_views tablosuna da bir satır ekliyordu. Okuma context'inden çağırınca:
read context on pg2: PostgresException 25006: cannot execute INSERT in a read-only transaction
write context on pg1: The Hobbit #42 374.00
Replica'da her transaction read-only'dir. Bu hata geliştirme ortamında replica yoksa hiç görülmez ve ilk kez üretimde çıkar; test ortamında da en az bir replica bulundur.
Lag'i yalnız saniye olarak ölçmek: commit zamanına dayanan lag, primary'de yazma yokken anlamsızlaşır. Byte cinsinden fark (pg_wal_lsn_diff) ve kullanıcı bazında LSN karşılaştırması daha güvenilir.
ApplicationIntent=ReadOnly'ye güvenmek: AG'siz bir SQL Server'da bu bayrak hiçbir şeyi kısıtlamaz, lab'da yazma başarılı oldu.
Küçük Bir Deneme
★☆☆ Router'a beşinci bir yol ekle: yazmadan sonraki 5 saniye boyunca o müşterinin okumalarını primary'ye gönder. LSN kontrolüyle kıyasla: aynı 1.000 siparişte primary'ye giden okuma sayısı ne oluyor?
★★☆ İkinci bir replica (pg3) ekle ve Load Balance Hosts=true ile okumaları ikisine dağıt. Yalnız pg3'ün replay'ini durdur; router'ı replica başına durum tutacak şekilde değiştirmeden önce ve sonra kaçan sipariş sayısını ölç.
★★★ LSN'i bir ASP.NET Core middleware'ine taşı: yazma yapan endpoint'ler yanıtta X-Last-Write-Lsn cookie'si bıraksın, okuma endpoint'leri ReadContextFactory'ye bu değeri versin. Cookie'nin ömrünü lag eşiğine göre seç ve gerekçeni yaz.
Replica okumaları taşıdı, ama veri büyümeye devam ediyor. Sonraki yazıda PostgreSQL'de partitioning'e geçiyoruz: sipariş tablosunu aylara bölmek, partition pruning'in neyi hızlandırıp neyi hızlandırmadığı ve 03'te batch'lerle yaptığımız arşivlemeyi en eski ayın partition'ını tek komutla ayırarak yapmak.