

Veritabanı Replication'ı: Physical ve Logical, Sync ve Async, Always On ve PostgreSQL Streaming Replication
Replication, commit log'unu başka bir sunucuya taşıyıp yeniden uygulamaktır; commit'in replica'yı bekleyip beklemediği hem kaybedilebilecek veriyi (RPO) hem kullanılabilirliği belirler. Lab'da sync commit throughput'u %37 düşürdü, tek sync replica düşünce yazmalar durdu ve iptal edilen INSERT yine de commit edilmiş çıktı. Streaming replication, lag ölçümü, log shipping, Always On, diski dolduran replication slot ve logical replication.
Sürüm notu: Bu yazıdaki PostgreSQL örnekleri PostgreSQL 18.7 ile (bir primary, bir streaming replica, aynı makinede iki container), SQL Server örnekleri SQL Server 2025 (CU10, 17.0.5035.5) ile tek makinelik bir lab'da çalıştırılmıştır. SQL Server Always On availability group'u lab'da kurmadık; o kısım Microsoft dokümanına dayanıyor ve öyle belirtildi.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) ödeme olaylarını PostgreSQL'e yazıyor. Ekip veri kaybetmemek için replica'yı synchronous yapmış: synchronous_standby_names = 'pg2'. Bir gece replica'nın sunucusu kapanıyor. Ödeme servisi her zamanki komutu gönderiyor:
INSERT INTO order_events (order_id, kind) VALUES (42, 'Paid') RETURNING event_id;Ne olur? Komut hata mı verir, primary'ye yazıp devam mı eder, yoksa bekler mi? Üç saniye sonra primary'de bakıyoruz:
SELECT pid, state, wait_event_type, wait_event, left(query, 40) AS query
FROM pg_stat_activity
WHERE wait_event = 'SyncRep';
pid | state | wait_event_type | wait_event | query
-------+--------+-----------------+------------+------------------------------------------
36060 | active | IPC | SyncRep | INSERT INTO order_events (order_id, kindBekliyor ve replica dönene kadar beklemeye devam edecek. Sabırsızlanıp isteği iptal ediyoruz (pg_cancel_backend):
INSERT 0 1
WARNING:  canceling wait for synchronous replication due to user request
DETAIL:  The transaction has already committed locally, but might not have been replicated to the standby.
Uygulama bir hata ya da timeout görüyor, ama satır primary'de commit edilmiş. Aynı ödeme olayını "olmadı" sanıp tekrar yazan bir retry, çift kayıt üretir. Bu küçük deney replication'ın iki temel gerçeğini gösteriyor: commit'in neyi beklediği hem kaybedilebilecek veriyi hem de kullanılabilirliği belirler, ve uygulama bu davranışı bilmek zorundadır. Bu yazıda replication'ı motorun gözünden kuruyor, ölçüyor ve tuzaklarını görüyoruz.
Replication'ı Motor Gözüyle Okumak
Her iki motor da değişikliği önce bir log'a yazar: PostgreSQL'de WAL (Write-Ahead Log; değişikliklerin veri dosyasından önce yazıldığı log), SQL Server'da transaction log. Replication bu log'un başka bir sunucuya taşınıp orada yeniden uygulanmasıdır. İki temel tür var:
| Physical replication | Logical replication | |
|---|---|---|
| Ne taşınır | Log kayıtları, byte byte (page değişiklikleri) | Satır değişiklikleri (INSERT/UPDATE/DELETE) |
| Hedef | Birebir kopya, salt okunur | Ayrı bir veritabanı; yazılabilir, kendi index'leri olabilir |
| Kapsam | Bütün instance (PostgreSQL) ya da veritabanı (AG) | Seçilen tablolar |
| Sürüm | Aynı major sürüm | Farklı major sürümler arasında çalışır |
| Örnek | PostgreSQL streaming replication, SQL Server AG ve log shipping | PostgreSQL publication/subscription, SQL Server transactional replication |
İkinci eksen, commit'in replica'yı bekleyip beklemediği: synchronous ya da asynchronous. Kavramların teorisi (leader-based replication, quorum, consistency modelleri) Distributed Systems Temelleri serisinin "Replication: Leader-Based, Multi-Leader, Leaderless ve Quorum" yazısında; burada motorların bu kavramları nasıl uyguladığına ve ölçtüğüne bakıyoruz.
PostgreSQL Streaming Replication'ı Kurmak
Replica, primary'nin bir kopyasıyla başlar ve sonra WAL akışını takip eder. Primary'de replication yetkisi olan bir rol ve pg_hba.conf'ta ona izin veren bir satır gerekir (host replication replicator all scram-sha-256). Replica container'ında boş veri klasörünü pg_basebackup ile dolduruyoruz:
pg_basebackup -h pg1 -U replicator -D "$PGDATA" -R -X stream -C -S pg2_slot-R replica'nın bağlanacağı primary'yi (primary_conninfo) yazar ve standby.signal dosyasını oluşturur, -C -S pg2_slot primary'de bir replication slot açar. Replica başladığında log'unda started streaming WAL from primary satırı görünür. Primary tarafında durum:
SELECT application_name, state, sync_state, sent_lsn, write_lsn, flush_lsn, replay_lsn,
       write_lag, flush_lag, replay_lag
FROM pg_stat_replication;
-[ RECORD 1 ]----+---------------
application_name | pg2
state | streaming
sync_state | async
sent_lsn | 1/8DD0C08
write_lsn | 1/8DD0C08
flush_lsn | 1/8DD0C08
replay_lsn | 1/8DD0C08
write_lag | 00:00:00.00008
flush_lag | 00:00:00.00008
replay_lag | 00:00:00.00008Dört LSN (Log Sequence Number; log'daki bir konumun adresi) bir kaydın yolculuğunu gösterir: primary gönderdi (sent), replica işletim sistemine yazdı (write), diske kalıcı yazdı (flush), veriye uyguladı (replay). Replica tarafında da pg_stat_wal_receiver ve birkaç fonksiyon var:
SELECT pg_is_in_recovery(), pg_last_wal_replay_lsn(), now() - pg_last_xact_replay_timestamp() AS replay_delay;-[ RECORD 1 ]----------+----------------
pg_is_in_recovery | t
pg_last_wal_replay_lsn | 1/8DD0C08
replay_delay | 00:04:13.628531LSN'ler aynı, yani replica tamamen yetişmiş; ama replay_delay 4 dakika gösteriyor. Bu fonksiyon son uygulanan transaction'ın primary'deki commit zamanını döndürür; primary 4 dakikadır hiç yazmadıysa gecikme de 4 dakika görünür. Alarm kurarken bunu unutan ekipler gece boyunca yanlış alarm alır. Lag'ı ölçmenin güvenilir yolu primary'deki byte farkı ve replay_lag.
Sync ve Async Commit: Ne Kadar Veri Kaybedebilirsin?
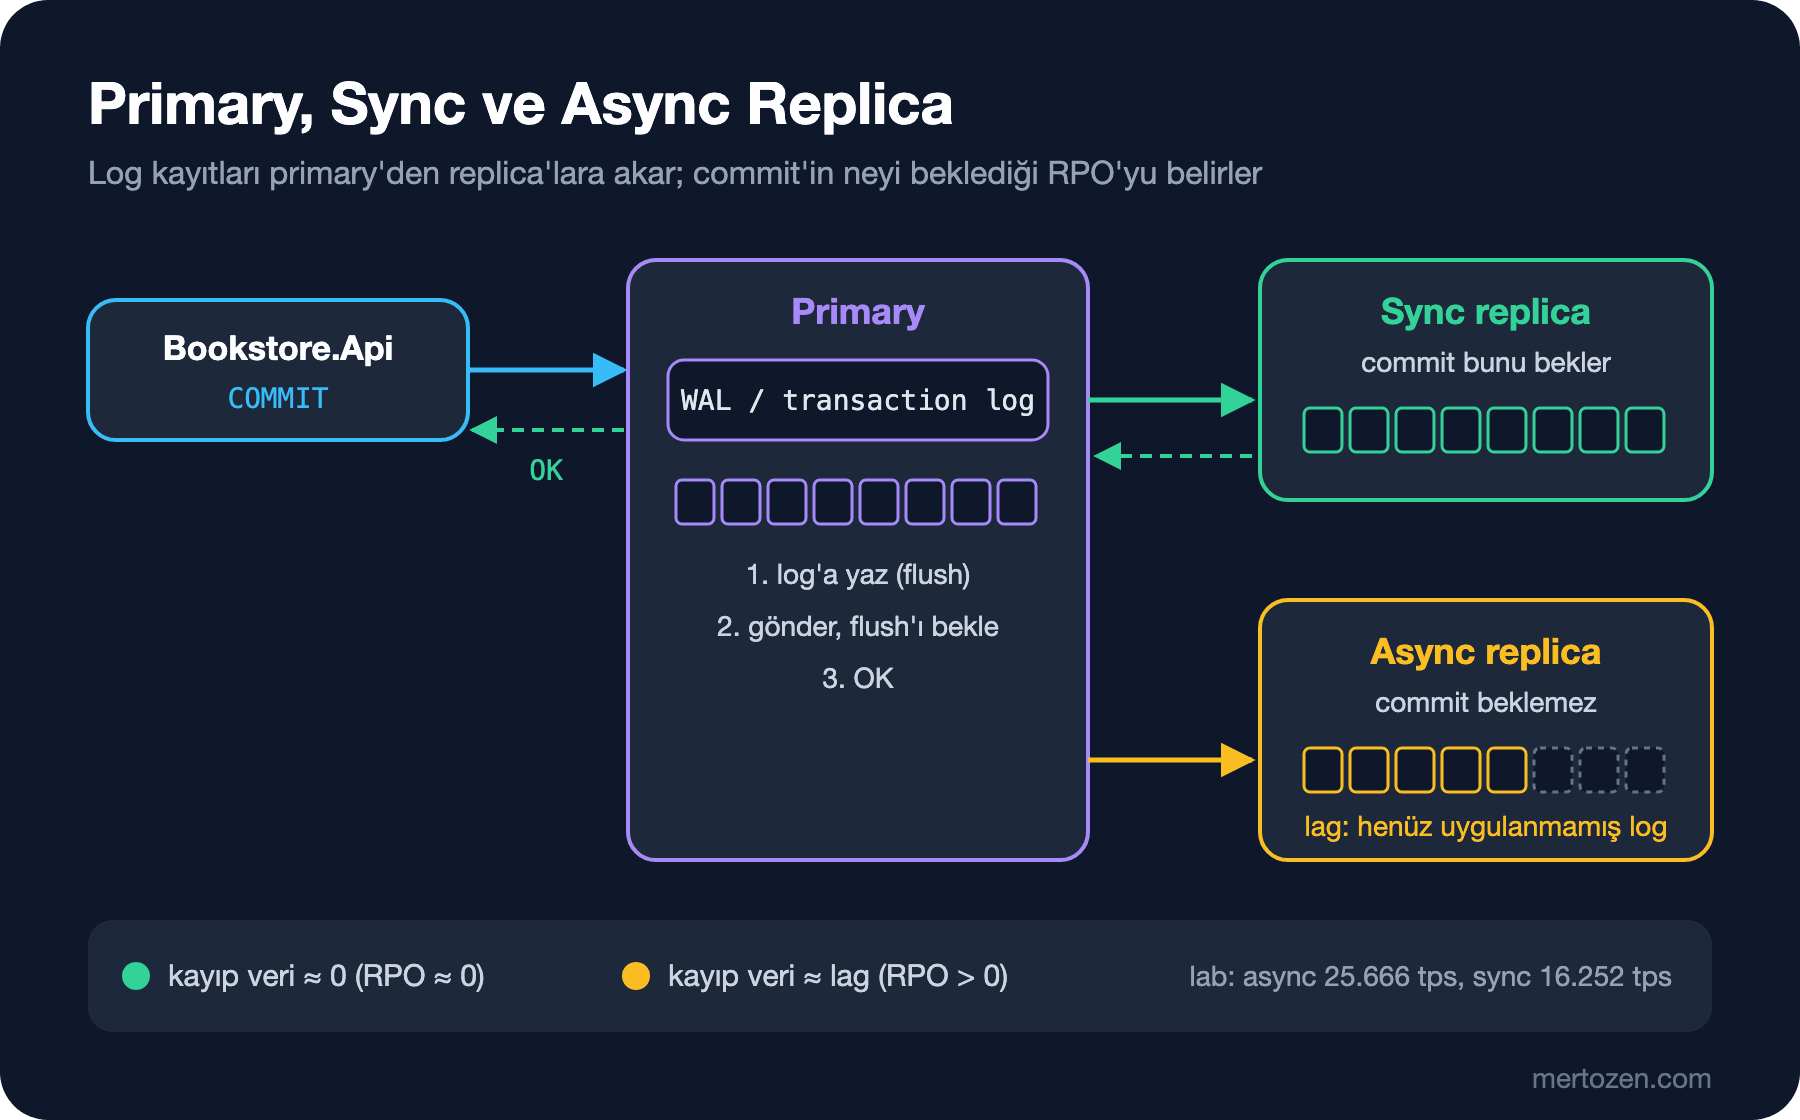
Async modda commit, kayıt primary'nin kendi diskine yazıldığında döner; replica'ya gönderim arkadan gelir. Primary o anda kaybolursa, replica'ya ulaşmamış commit'ler de kaybolur. Bu kaybın üst sınırı RPO'dur (Recovery Point Objective; bir arızada kaybedilmesi kabul edilen en fazla veri, zaman olarak). Sync modda commit, replica da kaydı aldığını söyleyene kadar bekler. PostgreSQL'de bunu iki ayar belirler: synchronous_standby_names hangi replica'ların sync olduğunu, synchronous_commit ise neyin bekleneceğini söyler (remote_write: replica işletim sistemine yazdı, on: diske kalıcı yazdı, remote_apply: uyguladı, sorgularda görünür).
Bedelini pgbench ile ölçtük: 8 istemci, 15 saniye, her transaction tek satırlık bir INSERT:
\set order_id random(1, 1000000)
INSERT INTO order_events (order_id, kind) VALUES (:order_id, 'Paid');
== async: async on
latency average = 0.312 ms
tps = 25665.588701 (without initial connection time)
== on: sync on
latency average = 0.492 ms
tps = 16252.474704 (without initial connection time)
== remote_apply: sync remote_apply
latency average = 0.515 ms
tps = 15525.947505 (without initial connection time)Replica aynı makinede olduğu hâlde sync commit throughput'u %37 düşürdü; her commit'e bir gidiş-dönüş eklendi. Gerçek bir sistemde replica başka bir availability zone'da olur ve gidiş-dönüş milisaniyeler sürer; kısa transaction'larda bu fark kat kat büyür. Yazının başındaki deney de diğer bedeli gösterdi: tek sync replica'nın düşmesi bütün yazmaları durdurur. Bu yüzden üretimde sync replication genelde ya iki ya da daha fazla replica ile (ANY 1 (pg2, pg3) gibi quorum tanımıyla) kurulur, ya da kritik veri için sync, geri kalan için async seçilir. PostgreSQL'de synchronous_commit transaction seviyesinde de ayarlanabilir: ödeme olayı SET LOCAL synchronous_commit = on ile, tıklama logu local ile yazılabilir.
Replication Lag'ı Ölçmek ve Metric Yapmak
Lag'ın iki biçimi var: byte (replica'nın kaç byte geride olduğu) ve zaman. Primary'de her replica için:
SELECT application_name,
       pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replay_lag_bytes,
       replay_lag
FROM pg_stat_replication;
03'te tek statement'lık büyük bir silme sırasında bu sorguyu 100 ms'de bir çalıştırmış ve replica'nın 22 MB geride kaldığını, batch'li silmede ise 1,1 MB'ı geçmediğini görmüştük. Bu değer uygulamanın da metric'i olmalı: replica'dan okuyan servis, okumadan önce lag'ın bir eşiğin altında olduğunu bilmek ister (06'da bunu .NET'te kullanacağız). Primary'de bir replica pg_stat_replication'da hiç görünmüyorsa, o da bir alarm: bağlantı kopmuş demektir.
SQL Server Always On'da karşılığı sys.dm_hadr_database_replica_states. Aşağıdaki sorguyu lab'da çalıştırmadık (AG kurmadık); kolonların anlamı Microsoft dokümanından:
SELECT ar.replica_server_name,
       drs.is_primary_replica,
       drs.synchronization_state_desc,
       drs.log_send_queue_size,
       drs.redo_queue_size,
       drs.secondary_lag_seconds,
       drs.last_commit_time
FROM sys.dm_hadr_database_replica_states AS drs
JOIN sys.availability_replicas AS ar ON ar.replica_id = drs.replica_id
WHERE drs.database_id = DB_ID('BookstoreDb');
log_send_queue_size primary'de henüz gönderilmemiş log'u (KB), redo_queue_size replica'ya ulaşmış ama uygulanmamış log'u (KB) gösterir. Birincisi primary kaybolursa kaybedilecek veriye (RPO), ikincisi failover sonrası veritabanının açılma süresine yakındır. Dokümana göre primary satırındaki last_commit_time ile replica satırındaki arasındaki fark yaklaşık RPO'yu verir; secondary_lag_seconds 2016'dan beri var.
SQL Server: Always On, Log Shipping ve Transactional Replication
SQL Server'da replication için üç mekanizma var. Always On availability group (AG) bir ya da daha fazla veritabanını, transaction log'u sürekli göndererek replica'lara kopyalar; replica başına synchronous ya da asynchronous commit seçilir, replica'lar okunabilir (readable secondary) yapılabilir ve bir listener ile otomatik failover desteklenir. Enterprise edition'da tam AG, Standard'da tek veritabanı ve iki replica ile sınırlı basic AG var. Linux'ta ya da cluster olmadan kurulan read-scale AG (CLUSTER_TYPE = NONE) okuma ölçeği verir ama otomatik failover vermez. Listener ve failover 05'in konusu.
Log shipping AG'den eski ve daha basit: primary'de log backup'ı alınır, replica'ya kopyalanır ve orada restore edilir. Lab'da bunu SQL Server Agent job'ları olmadan, aynı instance'taki iki veritabanı arasında elle yaptık. Önce full backup'ı STANDBY ile restore ediyoruz; bu mod veritabanını salt okunur açar ve sonraki log backup'larının uygulanmasına izin verir:
BACKUP DATABASE dbscaleseries_04 TO DISK = '/tmp/dbscaleseries_04_full.bak' WITH INIT, COMPRESSION;

RESTORE DATABASE dbscaleseries_04_standby FROM DISK = '/tmp/dbscaleseries_04_full.bak'
WITH MOVE 'dbscaleseries_04' TO '/var/opt/mssql/data/dbscaleseries_04_standby.mdf',
     MOVE 'dbscaleseries_04_log' TO '/var/opt/mssql/data/dbscaleseries_04_standby.ldf',
     STANDBY = '/tmp/dbscaleseries_04_undo.tuf';
Primary'ye yeni bir sipariş yazıp iki tarafa bakıyoruz, sonra bir log backup alıp replica'da uyguluyoruz:
last_order_on_primary
---------------------
2
last_order_on_standby
---------------------
1
BACKUP LOG successfully processed 6 pages in 0.006 seconds (7.161 MB/sec).
RESTORE LOG successfully processed 6 pages in 0.002 seconds (21.484 MB/sec).
last_order_on_standby
---------------------
2
Msg 3906, Level 16, State 1, Line 1
Failed to update database "dbscaleseries_04_standby" because the database is read-only.
Log shipping'de lag, log backup aralığı artı kopyalama ve restore süresidir; 15 dakikada bir alınan backup en az 15 dakikalık RPO demektir. Replica log restore edilirken okunamaz (STANDBY modunda restore sırasında kullanıcılar çıkarılır). Bugün en çok felaket kurtarma (DR) kopyası ya da AG kurulamayan ortamlar için kullanılır. Transactional replication ise logical bir mekanizma: seçilen tablolardaki değişiklikleri publisher, distributor ve subscriber üzerinden taşır. Farklı şemaya, alt kümeye ya da Azure SQL Database'e veri taşımak gibi işlerde hâlâ yeri var, ama okuma ölçeği ve HA (High Availability; arızada servisin kısa kesintiyle devam etmesi) için ilk seçenek AG.
Replication Slot'ları: Diski Dolduran Unutulmuş Bir Replica
PostgreSQL'de replication slot, primary'nin bir replica'nın henüz almadığı WAL'ı silmemesini garanti eder. Replica bir süre kopuk kalsa da döndüğünde kaldığı yerden devam edebilir. Bedeli: slot'u kullanan kimse yoksa WAL sonsuza kadar birikir. Bir raporlama replica'sı için slot açılıp replica hiç kurulmadığında ne olduğunu deneyelim:
SELECT pg_create_physical_replication_slot('reporting_slot', true);Ardından order_events tablosunu birkaç kez baştan sona güncelleyerek WAL ürettik:
SELECT slot_name, active, wal_status,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained
FROM pg_replication_slots;
slot_name | active | wal_status | retained
----------------+--------+------------+----------
pg2_slot | t | reserved | 0 bytes
reporting_slot | f | extended | 1598 MB
pg_wal_size
-------------
1616 MBKullanılmayan bir slot 1,6 GB WAL tutuyor; pg_wal klasörü max_wal_size'ı (varsayılan 1 GB) aştı. Üretimde bu birkaç gün içinde diski doldurur ve disk dolduğunda primary yazmayı durdurur. Koruma, slot'un tutabileceği WAL'a sınır koymak:
ALTER SYSTEM SET max_slot_wal_keep_size = '256MB';
SELECT pg_reload_conf();
CHECKPOINT;
slot_name | active | wal_status | safe_wal_size
----------------+--------+------------+---------------
pg2_slot | t | reserved | 265 MB
reporting_slot | f | lost |
pg_wal_size
-------------
848 MB
LOG: invalidating obsolete replication slot "reporting_slot"Slot geçersiz kılındı, WAL temizlendi. Bu bir takas: aynı sınır, uzun süre kopuk kalan gerçek bir replica'nın slot'unu da kaybettirir ve o replica'yı baştan kurmak gerekir. safe_wal_size bir slot'un geçersiz olmadan önce ne kadar daha WAL kaldırabileceğini gösterir; alarmı buna kur. PostgreSQL 18, belirli bir süre kullanılmayan slot'ları geçersiz kılan idle_replication_slot_timeout ayarını da getirdi.
Logical Replication: Raporlama Veritabanı ve Düşük Kesintili Upgrade
Logical replication, seçilen tabloların satır değişikliklerini başka bir veritabanına taşır. Hedef yazılabilir bir veritabanı olduğu için orada raporlara özel index'ler, ek tablolar ya da farklı bir major sürüm olabilir. Bookstore'un rapor sorguları için ayrı bir reporting veritabanı kuruyoruz. Yayıncı tarafta bir publication:
CREATE PUBLICATION bookstore_orders FOR TABLE orders, order_items;Abone tarafta tabloların şeması önceden oluşturulur (logical replication DDL'i (Data Definition Language; şemayı değiştiren komutlar) taşımaz), sonra subscription açılır. Rapor sorguları için created_at'e yalnız burada bir index ekledik:
CREATE INDEX ix_orders_created ON orders (created_at);

CREATE SUBSCRIPTION reporting_sub
CONNECTION 'host=127.0.0.1 dbname=bookstore user=postgres'
PUBLICATION bookstore_orders
WITH (create_slot = false, slot_name = 'reporting_sub');
Yayıncı ve abone aynı sunucuda olduğu için slot'u önceden pg_create_logical_replication_slot('reporting_sub', 'pgoutput') ile açtık; ayrı sunucularda CREATE SUBSCRIPTION bunu kendisi yapar. Önce tabloların mevcut verisi kopyalanır, sonra değişiklikler akmaya başlar:
    subname    | substream | subenabled
---------------+-----------+------------
 reporting_sub | p         | t

 table_name  | srsubstate
-------------+------------
 orders      | r
 order_items | r

 orders
--------
 937501
srsubstate = r ilk kopyanın bittiğini ve tablonun hazır olduğunu gösterir. substream = p, PostgreSQL 18'de varsayılanın parallel olmasının sonucu: büyük transaction'lar commit'i beklemeden akıtılıp abonede paralel uygulanır. 18 ile generated column'lar da yayınlanabiliyor (publish_generated_columns) ve uygulama sırasında çıkan çakışmalar log'a ve pg_stat_subscription_stats'a yazılıyor. Primary'ye yeni bir sipariş eklendiğinde bir saniye içinde raporlama tarafında görünüyor, primary'de de artık iki gönderici var:
 application_name |   state   | sync_state |   replay_lag
------------------+-----------+------------+-----------------
 pg2              | streaming | async      | 00:00:00.00028
 reporting_sub    | streaming | async      | 00:00:00.001525
Logical replication'ın en değerli kullanımlarından biri düşük kesintili major upgrade: yeni sürümde boş bir cluster kurulur, şema taşınır, logical replication ile veri yetiştirilir ve uygulama kısa bir kesintiyle yeni sunucuya geçirilir. Sınırlarını bilmek gerekiyor: DDL taşınmaz (şema değişikliğini iki tarafta sırayla yapmak gerekir), UPDATE ve DELETE için tabloda primary key ya da REPLICA IDENTITY gerekir, sequence değerleri 18'de taşınmaz (geçiş sırasında elle ayarlanır). PostgreSQL 19'un sürüm notları sequence'ların logical replication'ını (ALL SEQUENCES, REFRESH SEQUENCES) duyuruyor; 19 henüz release candidate aşamasında, biz denemedik. pg_upgrade ile yapılan klasik upgrade PostgreSQL serisinin "Güvenlik ve Operasyon Temelleri" yazısında.
Üretimde Dikkat
Replica'yı izlemeden kurma. Primary'de her replica'nın state'i ve byte cinsinden lag'ı, slot'ların wal_status ve safe_wal_size değeri, pg_wal klasörünün boyutu; SQL Server'da log_send_queue_size, redo_queue_size ve synchronization_health_desc. Bunların her biri bir alarm eşiğiyle izlenmeli.
Sync replica'yı tek bırakma. Tek sync replica, primary'nin kullanılabilirliğini replica'nınkine bağlar; yazının başındaki deneyde gördüğümüz gibi replica düşünce yazmalar durur. İki replica ve quorum ya da kritik transaction'lar için seçici sync kullan.
Replica'nın kendi yükünü hesaba kat. Replica primary'deki bütün yazmaları uygular; üstüne bir de okuma yükü binerse replay geride kalır. PostgreSQL'de uzun okuma sorguları replay ile çakışabilir (max_standby_streaming_delay, hot_standby_feedback); bu dengeyi 06'da okuma yönlendirmesiyle birlikte ele alacağız.
Replica bir backup değil. Primary'de yanlışlıkla çalışan bir DELETE milisaniyeler içinde replica'ya da uygulanır. Zamanda geri dönmek için backup ve WAL arşivi (point-in-time recovery) gerekir; 05'te HA ile DR ayrımını bu yüzden yapacağız.
Sık Düşülen Tuzaklar
Async replica'yı kayıpsız sanmak: primary düştüğünde replica'ya ulaşmamış commit'ler gider. RPO'yu ölçmeden "replica'mız var, veri kaybetmeyiz" demek yanlış.
Kullanılmayan replication slot'unu bırakmak: deneme için açılmış ya da kapatılmış bir replica'nın slot'u, primary'nin diskini sessizce doldurur. Slot açan her iş, onu kapatmayı da içermeli; max_slot_wal_keep_size son savunma hattı.
pg_last_xact_replay_timestamp() ile lag alarmı kurmak: primary boştayken lag büyük görünür. Byte farkını ve replay_lag'ı kullan.
Logical replication'da şema değişikliğini unutmak: yayıncıya eklenen bir kolon abonede yoksa replication durur. Lab'da 05 için orders'a bir kolon ekleyince abonenin apply worker'ı logical replication target relation "public.orders" is missing replicated column: "idempotency_key" hatasıyla durdu ve yeniden başladıkça aynı hatayı verdi. Önce aboneye, sonra yayıncıya ekle.
Sync commit'te iptal edilen isteği başarısız saymak: iptal ya da timeout, transaction'ın commit edilmediği anlamına gelmez. Ödeme gibi işlemleri idempotent yaz (05).
Küçük Bir Deneme
★☆☆ Replica'da SELECT pg_wal_replay_pause(); çalıştır, primary'ye birkaç bin satır yaz ve pg_stat_replication'daki write_lsn, flush_lsn ve replay_lsn değerlerinin nasıl ayrıştığını gözle. Sonra pg_wal_replay_resume().
★★☆ synchronous_commit'i remote_write, on ve remote_apply yaparak pgbench'i tekrarla; sonra replica container'ına tc ile 2 ms ağ gecikmesi ekleyip aynı ölçümü yap.
★★★ Logical replication ile Bookstore'u PostgreSQL 18'den başka bir PostgreSQL 18 cluster'ına taşı: şemayı pg_dump --schema-only ile aktar, subscription aç, sequence değerlerini geçişten hemen önce elle ayarla ve geçişte kaç saniye yazma kesintisi olduğunu ölç.
Sonraki yazıda replica'yı bir yedek oyuncu olarak kullanıyoruz: RPO ve RTO (Recovery Time Objective; arızadan sonra servisin en geç ne kadar sürede dönmesi gerektiği), HA ile DR'ın farkı, SQL Server listener'ı ve PostgreSQL için Patroni, ve en önemlisi primary düştüğünde Bookstore'un ödeme akışının çift sipariş üretmeden ayakta kalması.