

Structured Data Nedir? Schema.org, JSON-LD ve Google'ın Bununla Gerçekte Ne Yaptığı
Structured data, sayfanın ne anlattığını schema.org vocabulary'si ve JSON-LD gibi bir syntax ile makineye açıkça söylemektir; Google bunu sayfayı anlamak ve rich result uygunluğu için kullanır, ama markup ne rich result'ı garanti eder ne de sıralama faktörü olarak sunulur. Aynı bilgiyi Microdata, RDFa ve JSON-LD ile yazıp karşılaştırıyor, Bookstore sayfasının entity graph'ını .NET 10 ile döküyor ve Google dışındaki tüketicilere bakıyoruz.
Sürüm notu: Bu yazı schema.org 30.1 (16 Eylül 2026) sürümünü ve Google Search Central structured data dokümanlarının Kasım 2026 hâlini esas alır; kod örnekleri .NET 10 ve AngleSharp 1.10 ile derlenip denenmiştir.
Önce Tahmin Et
Bookstore'un blog'unda yeni bir yazı yayında: "Yeni Başlayanlar İçin 5 C# Kitabı". Sprint planlamasında bir ekip arkadaşın şunu öneriyor: "Sayfaya JSON-LD (JSON for Linking Data; bağlantılı veriyi JSON ile yazma standardı) bloğu ekleyelim; Google sonuçta yıldızlarla, tarihle gösterir, sıralamada da yukarı çıkarız." Üç soru: Doğru yazılmış bir structured data bloğu, Google'da zengin bir görünümü garanti eder mi? Sıralamayı yükseltir mi? Ve schema.org'da tanımlı her tip, Google'da karşılığı olan bir özellik mi?
Yazının sonunda üçünün de cevabı "hayır" olacak, ama her "hayır"ın arkasında structured data'yı yine de neden yazdığımızı anlatan bir "çünkü" var.
HTML İnsan İçin Anlam Taşır, Makine İçin Tahmindir
Tarayıcıda yazının sayfasına bakan bir okur, büyük punto metnin başlık, altındaki küçük ismin yazar, yanındaki tarihin yayın tarihi olduğunu bir bakışta anlar. HTML bu anlamın bir kısmını taşır: h1 bir başlıktır, time element'i bir zaman ifadesidir. Ama "Ada Kaplan" metninin bir kişi mi, bir kitap serisi mi, yoksa sayfada geçen bir karakter adı mı olduğunu HTML söylemez. Arama motoru bunu yerleşimden, link'lerden ve dilden çıkarmaya çalışır; yani tahmin eder.
Structured data bu tahmini açık bir beyana çevirir: "Bu sayfa bir BlogPosting. Başlığı şu. Yazarı, adı Ada Kaplan olan bir Person. İlk yayın tarihi 2026-11-10T09:30:00+03:00." Bunun için iki ayrı şeye ihtiyaç var ve ikisini karıştırmak, structured data konusundaki kafa karışıklığının çoğunun kaynağı:
- Vocabulary: hangi kavramların ve property'lerin var olduğu.
BlogPosting,Person,author,datePublishedbirer kelime; anlamları schema.org'da tanımlı. - Syntax: bu kelimeleri sayfaya nasıl yazdığın. JSON-LD, Microdata ve RDFa (Resource Description Framework in Attributes; anlamı HTML attribute'larıyla yazan biçim) aynı vocabulary'yi üç farklı biçimde taşır.
Vocabulary "ne söylediğini", syntax "nasıl yazdığını" belirler. Google'ın bir özelliği için doğru vocabulary'yi yanlış syntax'la yazarsan da, doğru syntax'la Google'ın tanımadığı bir tip yazarsan da sonuç aynı olur: hiçbir şey.
Vocabulary: Schema.org Nereden Geldi?
Fikir yeni değil. W3C (World Wide Web Consortium; web standartlarını yayımlayan kuruluş) 1999'da RDF'i (Resource Description Framework; bilgiyi özne-yüklem-nesne üçlüleriyle anlatan model) önerdi: her bilgi "özne, yüklem, nesne" üçlüsüdür, örneğin "bu yazı, yazarı, Ada Kaplan". 2000'lerin ortasında microformats akımı aynı ihtiyaca daha hafif bir cevap verdi: hCard'daki vcard gibi sabit class adlarıyla kişi ve etkinlik bilgisini HTML'e gömmek. İkisi de yaygın kullanıldı ama arama motorları için ortak bir sözlük yoktu; her biri farklı biçimleri farklı ölçüde destekliyordu.
Schema.org bu boşluğu doldurmak için 2 Haziran 2011'de Google, Bing (Microsoft) ve Yahoo'nun ortak girişimi olarak duyuruldu; Yandex aynı yılın Kasım ayında katıldı. schema.org'un kendi "About" sayfası bu dört şirketi kurucu şirketler olarak sayıyor. Bugün vocabulary, W3C bünyesindeki bir community group'ta açık olarak geliştiriliyor ve düzenli sürümlerle yayımlanıyor. Bu yazının esas aldığı 30.1 sürümü 16 Eylül 2026 tarihli; bir önceki büyük sürüm 30.0 ise 19 Mart 2026'da çıktı. Sürüm notlarını takip etmenin neden bakım işinin parçası olduğuna serinin son yazısında döneceğiz.
Syntax: Aynı Bilgi, Üç Biçim
Aşağıdaki üç parça, Bookstore yazısının başlığını, yazarını ve yayın tarihini anlatıyor. İlki Microdata: anlam, görünen HTML'in içine itemscope, itemtype ve itemprop attribute'larıyla yazılıyor.
<article itemscope itemtype="https://schema.org/BlogPosting">
  <h1 itemprop="headline">5 C# Books for Beginners</h1>
  <p>By <span itemprop="author" itemscope itemtype="https://schema.org/Person">
    <span itemprop="name">Ada Kaplan</span></span>,
    <time itemprop="datePublished" datetime="2026-11-10T09:30:00+03:00">2026-11-10</time></p>
</article>
İkincisi RDFa: fikir aynı, attribute adları farklı (vocab, typeof, property).
<article vocab="https://schema.org/" typeof="BlogPosting">
  <h1 property="headline">5 C# Books for Beginners</h1>
  <p>By <span property="author" typeof="Person">
    <span property="name">Ada Kaplan</span></span>,
    <time property="datePublished" datetime="2026-11-10T09:30:00+03:00">2026-11-10</time></p>
</article>
Üçüncüsü JSON-LD: anlam, görünen HTML'den ayrı bir script bloğunda, JSON olarak duruyor.
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "5 C# Books for Beginners",
  "author": { "@type": "Person", "name": "Ada Kaplan" },
  "datePublished": "2026-11-10T09:30:00+03:00"
}
</script>
Üçünü de schema.org'un Schema Markup Validator'ına HTML olarak verdik ve çıkardığı veriyi düz metne döktük. Üç biçimden de hatasız ve uyarısız, birebir aynı yapı çıktı:
microdata BlogPosting 0 0 ['headline = 5 C# Books for Beginners', 'datePublished = 2026-11-10T09:30:00+03:00', 'author -> Person', '  name = Ada Kaplan']
rdfa BlogPosting 0 0 ['headline = 5 C# Books for Beginners', 'datePublished = 2026-11-10T09:30:00+03:00', 'author -> Person', '  name = Ada Kaplan']
jsonld BlogPosting 0 0 ['headline = 5 C# Books for Beginners', 'datePublished = 2026-11-10T09:30:00+03:00', 'author -> Person', '  name = Ada Kaplan']
Satırdaki iki sıfır hata ve uyarı sayısı. Makine açısından üç biçim eşdeğer; fark, kodu yazan ve bakımını yapan geliştirici açısından. Google'ın structured data giriş sayfası da bunu söylüyor: üç biçim de geçerli ve doğru uygulandığı sürece eşit kabul ediliyor, ama Google JSON-LD'yi öneriyor, çünkü uygulaması ve bakımı en kolay olanı. Aynı sayfaya göre Google, JavaScript ile sonradan sayfaya eklenen JSON-LD bloklarını da okuyabiliyor.
| Ölçüt | Microdata / RDFa | JSON-LD |
|---|---|---|
| Görünen HTML ile ilişki | Aynı element'lerin üstünde | Ayrı script bloğunda |
| Tasarım değişikliğinde | Template değişince markup da bozulabilir | Template'ten bağımsız |
| Nested yapı ve tekrar kullanım | Element ağacına bağlı | @id ile serbestçe bağlanır |
| Sunucu tarafında üretim | View'ın her yerine dağılır | Tek bir serializer çıktısı |
Bir ASP.NET Core geliştiricisi için son satır belirleyici: JSON-LD'yi typed C# nesnelerinden tek bir yerde üretip layout'a gömebilirsin. Nasıl güvenli üretileceği serinin ikinci yazısının konusu.
Makinenin Gördüğü: Entity Graph
Structured data'yı "sayfaya eklenen bir JSON" diye düşünmek yerine bir graph olarak düşünmek, sonraki bütün kararları kolaylaştırıyor. Her tip bir düğüm (entity), her property ya başka bir düğüme giden bir kenar ya da düz bir değer.
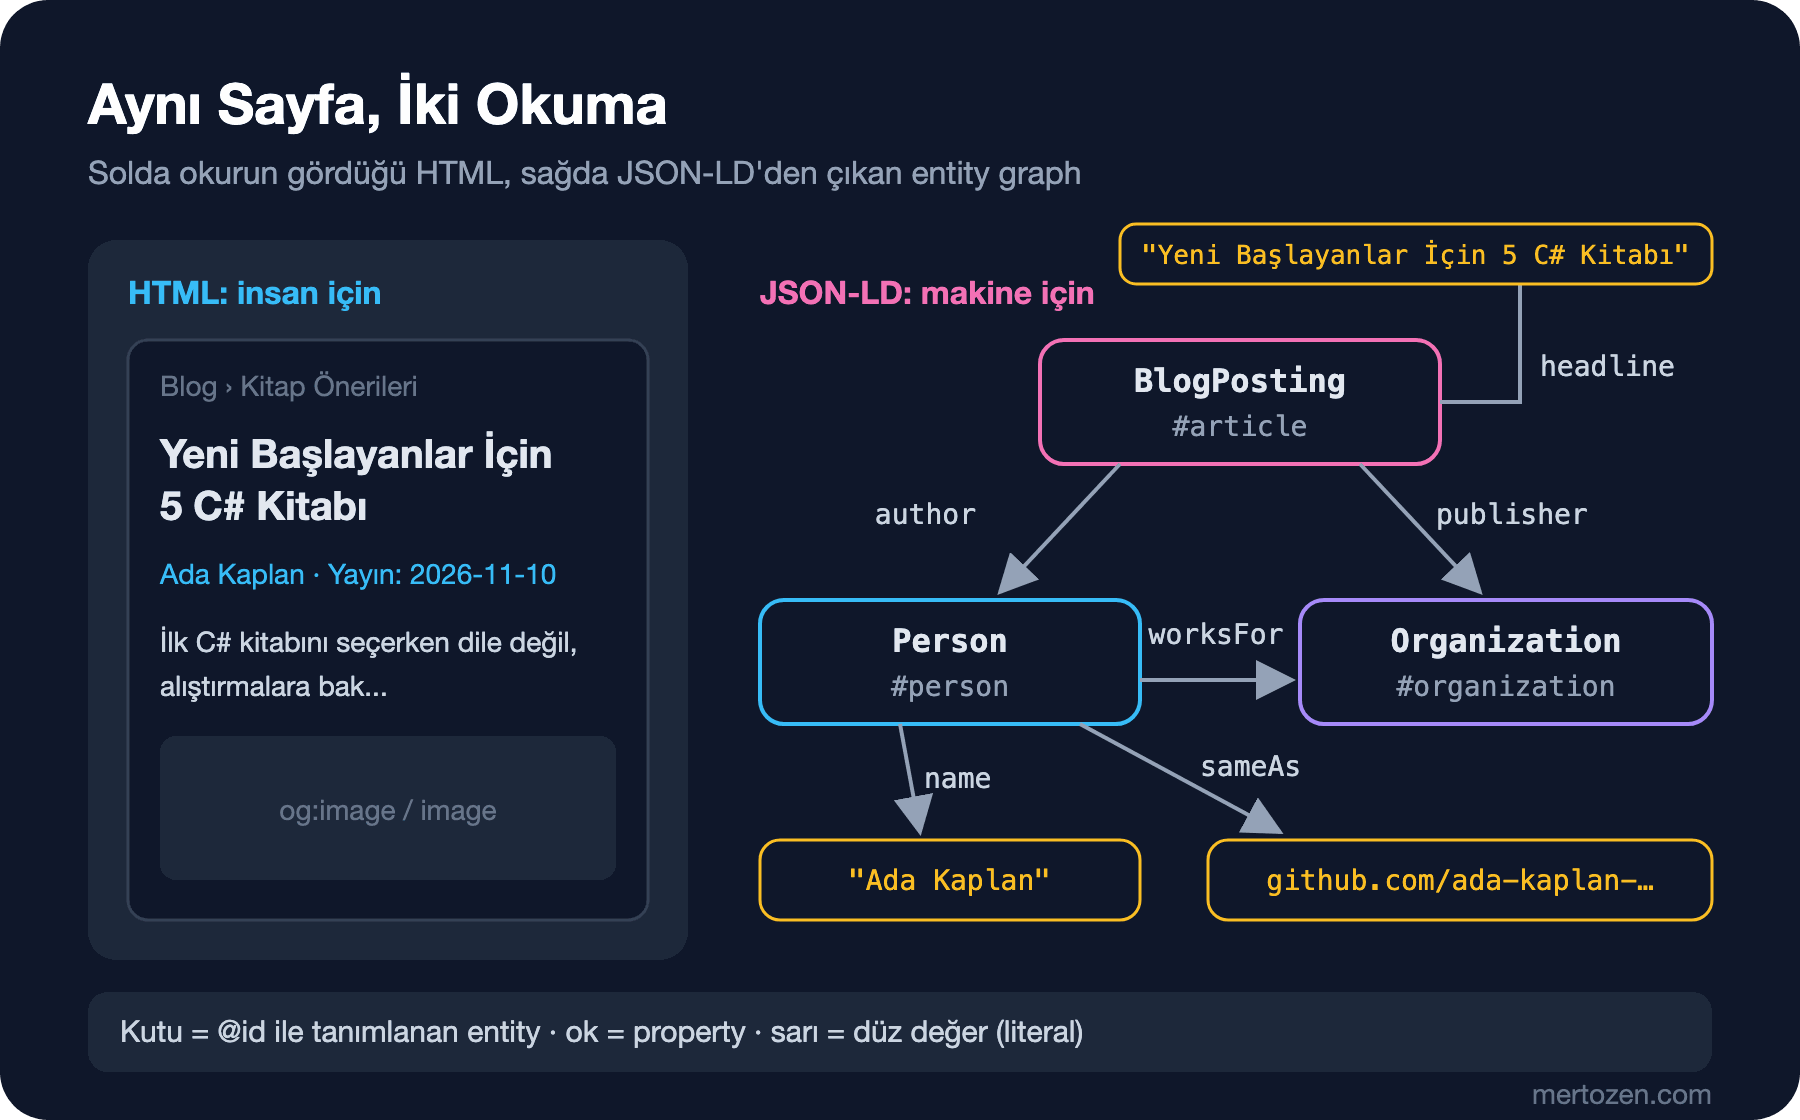
Bunu somut görmek için Bookstore'un ASP.NET Core 10 uygulamasının ürettiği sayfayı okuyup içindeki JSON-LD'yi "özne, property, nesne" satırlarına döken küçük bir console uygulaması yazdık. HTML'i regex ile değil AngleSharp ile parse ediyor; sebebini ikinci yazıda göreceğiz.
using System.Text.Json;
using AngleSharp.Html.Parser;

// Kullanım: dotnet run -- <url> [kısaltılacak-base]
string url = args[0];
string shortBase = args.Length > 1 ? args[1] : "";

using var http = new HttpClient();
string html = await http.GetStringAsync(url);
var document = new HtmlParser().ParseDocument(html);

int blank = 0;
foreach (var script in document.QuerySelectorAll("script[type='application/ld+json']"))
{
    using JsonDocument json = JsonDocument.Parse(script.TextContent);
    JsonElement root = json.RootElement;
    IEnumerable<JsonElement> nodes = root.TryGetProperty("@graph", out JsonElement graph)
        ? graph.EnumerateArray()
        : [root];
    foreach (JsonElement node in nodes)
    {
        Walk(node);
    }
}

string Walk(JsonElement node)
{
    string subject = node.TryGetProperty("@id", out JsonElement id) ? Short(id.GetString()!) : $"_:b{blank++}";
    foreach (JsonProperty property in node.EnumerateObject())
    {
        if (property.Name is "@id" or "@context")
        {
            continue;
        }
        JsonElement[] values = property.Value.ValueKind == JsonValueKind.Array
            ? [.. property.Value.EnumerateArray()]
            : [property.Value];
        foreach (JsonElement value in values)
        {
            string predicate = property.Name == "@type" ? "a" : property.Name;
            Console.WriteLine($"{subject}  {predicate}  {Describe(value)}");
        }
    }
    return subject;
}

string Describe(JsonElement value) => value.ValueKind switch
{
    // yalnızca @id taşıyan object, başka yerde tanımlı bir node'a link'tir
    JsonValueKind.Object when value.EnumerateObject().Count() == 1 && value.TryGetProperty("@id", out JsonElement id)
        => Short(id.GetString()!),
    JsonValueKind.Object => Walk(value),
    JsonValueKind.String => Quote(value.GetString()!),
    _ => value.GetRawText(),
};

string Short(string iri) => "<" + (shortBase.Length > 0 ? iri.Replace(shortBase, "") : iri) + ">";

static string Quote(string text) => text.Length > 38 ? $"\"{text[..35]}...\"" : $"\"{text}\"";
İngilizce yazının sayfasına karşı çalıştırıp breadcrumb satırlarını ayıkladığımızda çıktı şöyle:
$ dotnet run -- http://localhost:5321/en/blog/csharp-books-for-beginners https://bookstore.example | grep -v -E "_:b|breadcrumb"
</en/blog/csharp-books-for-beginners#article>  a  "BlogPosting"
</en/blog/csharp-books-for-beginners#article>  headline  "5 C# Books for Beginners"
</en/blog/csharp-books-for-beginners#article>  description  "When choosing your first C# book, l..."
</en/blog/csharp-books-for-beginners#article>  image  "https://bookstore.example/images/cs..."
</en/blog/csharp-books-for-beginners#article>  datePublished  "2026-11-10T09:30:00+03:00"
</en/blog/csharp-books-for-beginners#article>  dateModified  "2026-11-12T14:05:00+03:00"
</en/blog/csharp-books-for-beginners#article>  author  </authors/ada-kaplan#person>
</en/blog/csharp-books-for-beginners#article>  publisher  </#organization>
</en/blog/csharp-books-for-beginners#article>  mainEntityOfPage  "https://bookstore.example/en/blog/c..."
</en/blog/csharp-books-for-beginners#article>  inLanguage  "en"
</en/blog/csharp-books-for-beginners#article>  isPartOf  </#website>
</authors/ada-kaplan#person>  a  "Person"
</authors/ada-kaplan#person>  name  "Ada Kaplan"
</authors/ada-kaplan#person>  url  "https://bookstore.example/en/author..."
</authors/ada-kaplan#person>  jobTitle  "Senior Software Developer"
</authors/ada-kaplan#person>  worksFor  </#organization>
</authors/ada-kaplan#person>  sameAs  "https://github.com/ada-kaplan-example"
</authors/ada-kaplan#person>  sameAs  "https://www.linkedin.com/in/ada-kap..."
</#organization>  a  "Organization"
</#organization>  name  "Bookstore"
</#organization>  url  "https://bookstore.example/"
</#organization>  logo  "https://bookstore.example/images/lo..."
</#organization>  sameAs  "https://github.com/bookstore-example"
</#website>  a  "WebSite"
</#website>  name  "Bookstore"
</#website>  url  "https://bookstore.example/"
</#website>  inLanguage  "tr"
</#website>  inLanguage  "en"
</#website>  publisher  </#organization>
author satırının sağında bir metin değil, </authors/ada-kaplan#person> diye bir kimlik var. Bu kimlik, aşağıda Person olarak tanımlanan düğümün @id'si. Aynı düğüm worksFor ile Organization'a, publisher ile de yine aynı Organization'a bağlı. Google'ın genel structured data yönergeleri, iç içe yazılmayan ama birbiriyle ilişkili öğeleri @id ile bağlamayı açıkça öneriyor. Bu graph'ı adım adım kurmak serinin üçüncü yazısında.
Google Bununla Gerçekte Ne Yapıyor?
Google'ın dokümanları structured data'nın iki işe yaradığını söylüyor. Birincisi anlamak: sayfanın neyi anlattığını ve sayfadaki şeylerin birbirleriyle ilişkisini daha iyi kavramak. İkincisi görünüm: bazı tipler, sayfayı rich result denen zenginleştirilmiş sonuç görünümlerine uygun hâle getiriyor. Uygun hâle getiriyor, garanti etmiyor. Genel yönergeler sayfası bunu iki yerden kilitliyor: zorunlu property'leri eksik öğeler rich result'a uygun değil, eksiksiz ve doğru markup bile rich result'ın gösterileceğini garanti etmiyor.
Sıralama sorusunda Google'ın dili dikkatli. Hiçbir resmi doküman structured data'yı bir sıralama faktörü olarak sunmuyor. Tersine, iki yerde açıkça sıralamadan ayırıyor. Genel yönergelere göre structured data ihlali yüzünden manual action alan bir sayfa rich result uygunluğunu kaybediyor, ama bu Google web aramasındaki sıralamasını etkilemiyor. 2023'te FAQ (Frequently Asked Questions; sık sorulan sorular) ve HowTo rich result'larını kısıtlarken yayımlanan blog yazısı da değişikliğin bir sıralama değişikliği olarak görülmemesi gerektiğini yazıyordu. Google'ın intro sayfasında anılan başarı hikâyeleri (Rotten Tomatoes'ta structured data eklenen sayfalarda %25 daha yüksek tıklama oranı, Nestlé'de rich result olarak görünen sayfalarda %82 daha yüksek tıklama oranı gibi) da sıralama değil, sonuçta nasıl göründüğün ve tıklanma ile ilgili. Bu rakamlar o şirketlerin kendi ölçümleri; senin sitende ne olacağını söylemez.
Baştaki ilk iki sorunun cevabı burada: markup rich result'ı garanti etmez ve Google onu bir sıralama aracı olarak sunmaz. Yazmaya değmesinin sebebi, Google'ın sayfayı yanlış anlama ihtimalini azaltması ve rich result'a aday olabilmenin ön koşulu olması.
Schema.org'da Olmak, Google'da Özellik Olmak Değildir
Schema.org bir sözlük; Google onun yalnızca bir kısmını belirli özellikler için kullanıyor. Google'ın intro sayfası bu ayrımı kendisi yapıyor: Search'ün nasıl davrandığı konusunda otorite schema.org değil, Search Central dokümanları; schema.org'da Google'ın istemediği pek çok property var ve bunları başka platformlar kullanabiliyor. Google'ın desteklediği tipler Search Central'daki "Structured data search gallery" sayfasında listeleniyor ve bu liste değişiyor.
mertozen.com'dan bir örnek: blog yazılarının JSON-LD'sinde isPartOf ile bir CreativeWorkSeries bildiriliyor. Bu, schema.org açısından tamamen geçerli; yazının bir serinin parçası olduğunu doğru anlatıyor. Ama Google'ın galerisinde "seri" diye bir rich result yok. Yani bu satır, Google'ın sayfayı anlamasına katkı verebilecek bir bilgi, ama ekranda hiçbir şey değiştirmeyecek. Aynı sitede kullanılan speakable ise Google'ın dokümanında hâlâ beta olarak duruyor ve ciddi kısıtları var; FAQ rich result'ı da 2026'da tamamen kaldırıldı. Hangi tipin ne durumda olduğu serinin dördüncü yazısının konusu.
Baştaki üçüncü sorunun cevabı da bu: schema.org'daki her tip Google'da bir özellik değil. Bir tipi eklemeden önce iki soru sor: "Bu, sayfanın gerçekte ne olduğunu doğru anlatıyor mu?" ve "Google'da bir karşılığı var mı, yoksa yalnızca anlam için mi yazıyorum?" İkincisinin cevabı "yalnızca anlam" olabilir, bu da meşru; yeter ki beklentin doğru olsun.
Google Dışındaki Tüketiciler
Structured data'yı okuyan tek sistem Google değil. Bing, 2018'de Bing Webmaster Tools'a JSON-LD desteği eklediğini duyurdu; hangi tipi arama sonuçlarında nasıl kullandığını ise Google kadar ayrıntılı dokümante etmiyor. Bing için yazdığın markup'ın çoğu Google için yazdığınla aynı schema.org kelimeleri olduğundan ayrı bir iş çıkarmaz.
Sosyal ağların link önizlemesi çoğunlukla ayrı bir protokol olan Open Graph'ı (og:title, og:image) okur; o konu bu serinin dışında. Kesiştiği tek nokta görsel. Google, 2 Mart 2026'da görsel SEO'su (Search Engine Optimization; arama motorları için optimizasyon) ve Discover dokümanlarına "tercih edilen görseli metadata ile belirtme" bölümünü ekledi ve Search ile Discover'da küçük görsel seçerken hem schema.org markup'ını hem og:image meta tag'ini kullandığını yazdı. Pratik sonuç: JSON-LD'deki image ile og:image aynı, temsil edici görseli göstersin; birinde kapak, diğerinde logo olmasın.
AI answer engine'ler konusunda iddialar bol, kanıt az. Google'ın generative AI özellikleri için yayımladığı rehberi GEO (Generative Engine Optimization; içeriğin AI cevaplarında kaynak olarak görünmesi için yapılan çalışma) serisinin ikinci yazısında, "Google'ın AI Arama Rehberi: Neyi Yapmalı, Neyi Boşver?" başlığıyla okumuştuk: Google, AI Overviews ve AI Mode'da görünmek için özel bir schema.org markup'ı gerekmediğini, structured data'nın bunun şartı olmadığını söylüyor. Diğer AI ürünlerinin structured data'yı nasıl kullandığına dair birincil kaynakta doğrulanmış bir bilgi yoksa, "AI için schema" vaadini Google bunu doğrulamıyor notuyla oku.
Üretimde Dikkat
Markup'ın içeriği görünen içerikle aynı olmalı. Google'ın kalite yönergeleri okurdan gizlenen içeriğin işaretlenmemesini, sayfa gövdesinin de markup'ın anlattığı şeyleri anlatmasını istiyor. CMS'te (Content Management System; içerik yönetim sistemi) başlık değişip JSON-LD'nin eski başlıkla kalması, en sık görülen ve en sessiz tutarsızlık; bu yüzden JSON-LD'yi view'ın kullandığı aynı modelden üret, elle ikinci bir kopya tutma.
Plugin ve hazır bileşenlerin ürettiği markup'ı say. CMS eklentisi bir Article, tema bir WebPage, sen elle bir BlogPosting eklediğinde sayfada birbirini tekrar eden, bazen çelişen üç blok olur. Hangisinin doğru olduğuna Google karar verir ve bu karar senin istediğin olmayabilir. Yayın öncesi bir sayfanın kaynağında application/ld+json aratmak, kaç blok olduğunu hemen gösterir.
Bakım maliyetini baştan kabul et. Google'ın desteklediği tipler değişiyor, schema.org yılda birkaç sürüm çıkarıyor. Her tip, birinin takip etmesi gereken bir sözleşme; ihtiyaç duymadığın tipi eklememek de bir karar.
Sık Düşülen Tuzaklar
Rich result için görünmeyen içeriği işaretlemek. Sayfada olmayan yorum puanları, okurun göremediği bir soru-cevap listesi ya da gizli bir div içindeki metin, Google'ın structured data yönergelerinin doğrudan ihlali. Sonucu bir manual action ve Search Console'daki Manual Actions raporunda görünür. Yönergelere göre bu, sayfanın rich result uygunluğunu kaldırır; sıralamayı etkilemediğini söylemesi "risk yok" anlamına gelmez, sadece cezanın neyi hedeflediğini söyler.
"Markup ekledik, sıralama artacak" beklentisi. Google bunu vaat etmiyor; markup'tan sonra trafik değiştiyse önce başka değişkenleri ele. Etkiyi ölçmek ilerideki "Analytics ve Ölçüm" serisinin işi.
Geçerli olmayı uygun olmakla karıştırmak. Schema Markup Validator'dan sıfır hatayla geçmek, markup'ın schema.org'a göre geçerli olduğunu gösterir; Google'ın bir rich result'ı için gereken property'lerin tam olduğunu göstermez. İki aracın farkı serinin son yazısında.
Her şeyi Thing ya da WebPage olarak işaretlemek. Google'ın yönergeleri uygulanabilir en spesifik tipi ve property'yi kullanmanı istiyor; bir blog yazısı için BlogPosting, WebPage'den çok daha fazla şey söyler.
Küçük Bir Deneme
★☆☆ Takip ettiğin üç sitenin bir yazı sayfasını aç, kaynağında application/ld+json arat. Kaç blok var, hangi tipler kullanılmış, aynı bilgi birden fazla blokta tekrarlanıyor mu?
★★☆ Yukarıdaki Microdata parçasına bir dateModified ekle, sonra aynı bilgiyi RDFa ve JSON-LD biçimlerine taşı. Üçünü Schema Markup Validator'da HTML olarak çalıştır ve çıkan yapının aynı olduğunu doğrula.
★★★ GraphDump'ı, bir sayfadaki bir @id'ye referans verilip o @id'nin hiçbir düğümde tanımlanmadığı durumları ("sarkan" referansları) raporlayacak şekilde genişlet. Bookstore yazısında isPartOf ile verilen WebSite @id'sini graph'tan çıkarıp aracın bunu yakaladığını gör.
Bu yazıda structured data'nın ne olduğunu ve Google'ın onu neye kullandığını konuştuk. Bir sonraki yazıda JSON-LD'nin kendisine iniyoruz: @context, @type, @id ve @graph ne işe yarar, ASP.NET Core'da typed record'lardan JSON-LD nasıl üretilir ve bir başlıktaki </script> neden bütün sayfayı bozabilir.