

CPU Cache Nasıl Çalışır: Cache Line, Associativity ve Cache-Friendly C# Kodu
CPU bellekten byte değil cache line okur (x64'te 64 byte) ve bir adresi tag, index ve offset'e bölüp tek bir set'te arar; kodun hızı bu düzene uyup uymamasına bağlıdır. 4096 × 4096 tabloyu sütun sütun gezmenin 6,5 kat yavaşlığı, genişliği 16 artırınca conflict miss'in kalkıp döngünün 4,6 kat hızlanması, Struct of Arrays ile 5 kat kazanç ve field sırasıyla 40 byte'tan 24 byte'a inen struct.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ile derlenip denenmiştir; testler xUnit v3 4.0.3, ölçümler BenchmarkDotNet 0.15.8 ile Apple M5 (ARM64 işlemcili Mac) / macOS 27 / .NET 10.0.13 üzerinde, x64 çıktıları (struct layout ve assembly listeleri) Linux x64 container'ında .NET 10.0.15 ile alınmıştır.
Önce Tahmin Et
Bookstore'un depo ekranı, 4096 × 4096'lık bir int[,] tablosundaki stok hareketlerini topluyor. Aynı iki döngüyü yazmanın iki yolu var: dışta satır, içte sütun ya da dışta sütun, içte satır. İkisi de 16.777.216 element'i birer kez okuyor, ikisi de O(n²). Aralarında ne kadar fark çıkar? Peki tabloyu 256 × 256'ya küçültürsen fark büyür mü, küçülür mü?
İkinci soru: tablonun genişliğini 4096'dan 4112'ye çıkarıp yalnızca sütun sütun gezersen, yani her satırda 16 element'lik fazladan iş yüklersen, döngü yavaşlar mı hızlanır mı?
Serinin bir önceki yazısı register'dan SSD'ye (flash bellekli kalıcı disk) kadar her katmanın latency'sini ölçmüştü ("Memory Hierarchy: Register'dan SSD'ye Latency Rakamları ve Locality"). Bu yazı bir katman içeri giriyor: CPU cache'i bir adresi nasıl bulur, neden boş yer varken bile veri atar ve C# kodu buna göre nasıl yazılır.
Cache Line: CPU Bellekten Byte Değil Blok Okur
Bir int okuduğunda CPU bellekten 4 byte getirmez. Cache'ler veriyi cache line denen sabit boyutlu bloklar halinde tutar ve taşır. Intel'in SDM'sine (Software Developer's Manual; Intel'in mimari başvuru kılavuzu, Cilt 3A'nın cache bölümü) göre Core ve Atom mimarilerinde L1 (çekirdeğe en yakın, birinci seviye cache), L2 (ikinci seviye) ve L3 (üçüncü seviye, çekirdekler arasında paylaşılan) cache line'ları 64 byte'tır; AMD (Intel'in rakibi x86 işlemci üreticisi) işlemcilerde de line 64 byte'tır. Yani bir int'e dokunduğunda, onunla aynı 64 byte'lık hizalı bloktaki 15 komşusu da bedavaya gelir.
Ölçümleri yaptığım makine bir Apple M5 (ARM64 tabanlı Apple Silicon); bu yazının bütün zamanlama tabloları buradan, çünkü elimdeki tek gerçek donanım bu. Line boyutu burada farklı:
$ sysctl hw.cachelinesize hw.perflevel0.l1dcachesize hw.perflevel0.l2cachesize hw.perflevel1.l1dcachesize hw.perflevel1.l2cachesize
hw.cachelinesize: 128
hw.perflevel0.l1dcachesize: 131072
hw.perflevel0.l2cachesize: 16777216
hw.perflevel1.l1dcachesize: 65536
hw.perflevel1.l2cachesize: 6291456
Performance core'larda 128 KB L1d ve 16 MB L2, line 128 byte. Windows'ta Sysinternals Coreinfo coreinfo -l her cache'in boyutunu, associativity'sini ve line boyutunu basar (bu makinede çalıştırmadım); Microsoft'un Coreinfo sayfasındaki Intel Core Ultra 7 165U örneğinde performance core için 48 KB / 12-way L1d, 2 MB / 16-way L2, 12 MB / 12-way L3 ve hepsinde 64 byte line var. AMD'nin EPYC (sunucu işlemci ailesi) 9004 serisi için yayımladığı mimari doküman Zen 4 çekirdeğinde 32 KB / 8-way L1d veriyor. Kodun içinden aynı bilgi GetLogicalProcessorInformationEx'in döndürdüğü CACHE_RELATIONSHIP yapısında (Associativity, LineSize, CacheSize), özet hali Görev Yöneticisi'nin Performans sekmesinde.
Pratik sonuç: bellek trafiğinin birimi line'dır. Bir line'dan 4 byte kullanıp gerisini atan kod, bant genişliğinin 16'da birini kullanır.
Adres Nasıl Bölünür: Tag, Index, Offset ve Set-Associative Cache
Cache bir adresi ararken onu üç parçaya böler. En alttaki bitler offset'tir: line içindeki byte'ı seçer, 64 byte'lık line için 6 bit. Ortadaki bitler index'tir: line'ın cache'te hangi set'e gideceğini söyler. Geri kalan üst bitler tag'dir: set'e gelen line'ın gerçekten aradığın line olup olmadığını anlamak için saklanır.
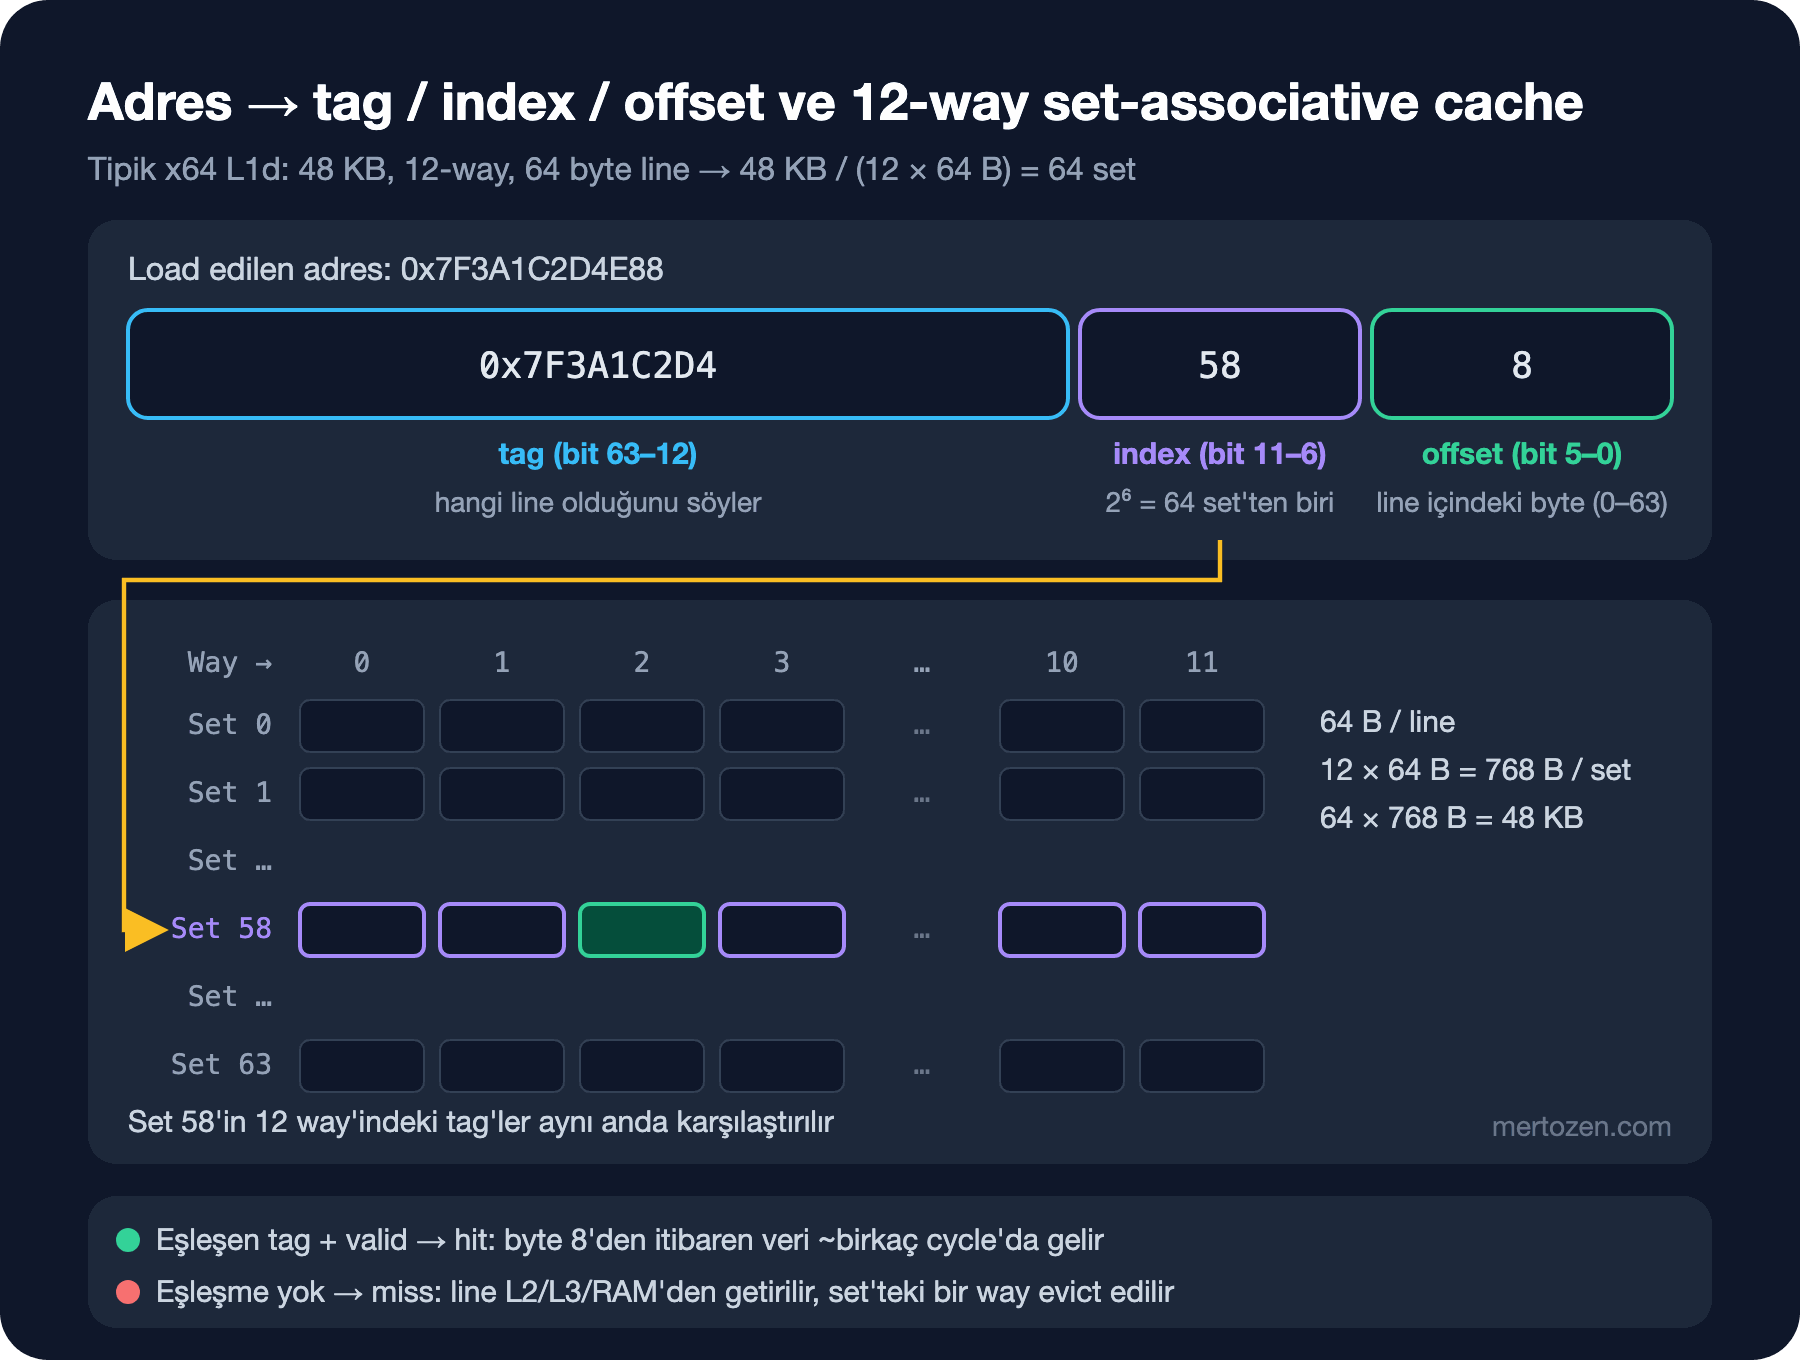
Coreinfo örneğindeki 48 KB, 12-way, 64 byte line'lık L1d'yi hesaplayalım: 48 KB / (12 × 64 B) = 64 set, yani index 6 bit. Bir adresin 0–5. bitleri offset, 6–11. bitleri index, üstü tag. Load geldiğinde cache index'le bir set seçer ve oradaki 12 line'ın tag'ini paralel karşılaştırır. Eşleşme varsa hit; yoksa miss: line alt katmandan gelir ve set'ten biri bir replacement policy'ye göre atılır; bu policy çoğu zaman LRU'ya (en uzun süredir kullanılmayanı atma) yakındır.
Associativity bu tasarımın ayarıdır. 1-way (direct-mapped) cache'te her adresin tek yeri vardır ve aynı yere düşen iki adres birbirini sürekli kovar; fully associative cache'te line her yere gidebilir ama her aramada bütün tag'leri karşılaştırmak pahalıdır. Gerçek L1/L2'ler aradadır: N-way set-associative. Akılda tutman gereken sonuç: index ve offset 6'şar bit olduğunda, aralarında 4096 byte'ın katı kadar fark olan adresler aynı set'e düşer.
Miss'leri sınıflandırmanın klasik yolu, Mark Hill'in 1980'lerin sonunda ortaya koyduğu "3C" ayrımıdır. Compulsory miss: line'a ilk kez dokunuluyor, sonsuz büyüklükte bir cache bile kaçırırdı. Capacity miss: çalışılan veri cache'e sığmıyor. Conflict miss: cache'te yer var ama line'ın düşebileceği set dolu. Serinin sonraki yazısında, çok çekirdekte ortaya çıkan dördüncü bir türü, coherence kaynaklı miss'leri göreceğiz.
Yazma tarafında modern CPU'lar write-back çalışır: store yalnızca cache'teki line'ı günceller ve line'ı "dirty" işaretler; bellek ancak line atıldığında güncellenir. Store miss'te line önce okunup getirilir, yani yalnızca yazan döngü bile okuma trafiği üretir. Okuma tarafındaki yardımcı prefetcher: sıralı ya da sabit adımlı erişimi tanıyıp sıradaki line'ları önceden getiren donanım; rastgele erişimde elinden bir şey gelmez.
Demo 1: 2D Array'i Satır Satır mı, Sütun Sütun mu Gezmeli?
İlk tahmin sorusunun kodu. Aynı toplamı dört şekilde hesaplıyoruz: int[,] ve jagged int[][] üzerinde, satır-öncelikli (row-major) ve sütun-öncelikli (column-major) gezinerek:
namespace Bookstore.Cache;

public static class GridSum
{
    public static long RowMajor(int[,] grid)
    {
        int rows = grid.GetLength(0), cols = grid.GetLength(1);
        long sum = 0;
        for (int r = 0; r < rows; r++)
            for (int c = 0; c < cols; c++)
                sum += grid[r, c];
        return sum;
    }

    public static long ColumnMajor(int[,] grid)
    {
        int rows = grid.GetLength(0), cols = grid.GetLength(1);
        long sum = 0;
        for (int c = 0; c < cols; c++)
            for (int r = 0; r < rows; r++)
                sum += grid[r, c];
        return sum;
    }

    public static long JaggedRowMajor(int[][] grid)
    {
        long sum = 0;
        foreach (int[] row in grid)
            foreach (int value in row)
                sum += value;
        return sum;
    }

    public static long JaggedColumnMajor(int[][] grid)
    {
        int cols = grid[0].Length;
        long sum = 0;
        for (int c = 0; c < cols; c++)
            for (int r = 0; r < grid.Length; r++)
                sum += grid[r][c];
        return sum;
    }
}
xUnit testi dört method'un aynı sonucu verdiğini 300 × 300'lük rastgele bir tabloda doğruluyor. BenchmarkDotNet sonucu:
| Method            | N    | Mean         | Error        | StdDev       | Ratio | RatioSD |
|------------------ |----- |-------------:|-------------:|-------------:|------:|--------:|
| RowMajor          | 256  |     33.50 us |     6.526 us |     5.095 us |  1.02 |    0.20 |
| ColumnMajor       | 256  |     48.87 us |     3.295 us |     2.179 us |  1.49 |    0.20 |
| JaggedRowMajor    | 256  |     19.96 us |     0.953 us |     0.744 us |  0.61 |    0.08 |
| JaggedColumnMajor | 256  |     22.37 us |     2.372 us |     1.715 us |  0.68 |    0.10 |
|                   |      |              |              |              |       |         |
| RowMajor          | 4096 |  8,307.33 us |   361.699 us |   261.532 us |  1.00 |    0.04 |
| ColumnMajor       | 4096 | 53,866.05 us | 4,743.503 us | 3,429.864 us |  6.49 |    0.44 |
| JaggedRowMajor    | 4096 |  4,322.25 us |    10.187 us |     6.738 us |  0.52 |    0.02 |
| JaggedColumnMajor | 4096 | 30,913.83 us | 1,414.672 us | 1,104.483 us |  3.72 |    0.17 |
4096'da sütun sütun gezmek 6,5 kat yavaş. Sebep bellek düzeni: Ecma International'ın yayımladığı CLI standardı (ECMA-335), çok boyutlu array element'lerinin bellekte row-major sırada durmasını şart koşar. grid[r + 1, c], grid[r, c]'den 16 KB ötededir. Satır döngüsü her line'dan 16 int (x64'te) kullanır; sütun döngüsü her adımda yeni bir line ister, ondan tek int alır ve line tekrar kullanılmadan atılır. Her adım başka bir 4 KB'lık page'e de düştüğü için TLB (Translation Lookaside Buffer; adres çevirilerini tutan küçük cache) zorlanır; o kısım İşletim Sistemi Temelleri serisinin konusu.
256 × 256'da fark 1,5 kata iniyor: 256 KB'lık tablo L2'ye sığıyor ve sabit adımlı erişimi prefetcher tanıyor. Big-O ve Complexity serisinin "Big-O'nun Söylemedikleri: Sabitler, Cache ve BenchmarkDotNet ile Ölçmek" yazısındaki uyarının donanım tarafı bu.
Tabloda bir sürpriz daha var: jagged array satır satır gezildiğinde int[,]'den iki kat hızlı. Bu fark cache'ten değil, JIT'in (Just-In-Time; ara kodu çalışma anında makine koduna çeviren derleyici) ürettiği koddan geliyor. x64'te tier-1 kodun iç döngülerine bakalım (Linux x64 container'ında DOTNET_JitDisasm="RowMajor JaggedRowMajor" ile alınan çıktıdan kesit):
; RowMajor(int[,]) - Tier1, inner loop
G_M000_IG08:                ;; offset=0x0037
       mov      r11d, r9d
       cmp      r11d, r10d
       jae      SHORT G_M000_IG09
       mov      ebx, dword ptr [rdi+0x14]
       imul     r11d, ebx
       mov      r15d, r8d
       sub      r15d, dword ptr [rdi+0x1C]
       cmp      r15d, ebx
       jae      SHORT G_M000_IG09
       add      r11d, r15d
       movsxd   r11, dword ptr [rdi+4*r11+0x20]
       add      rdx, r11
       inc      r8d
       cmp      r8d, ecx
       jl       SHORT G_M000_IG08

; JaggedRowMajor(int[][]) - Tier1, inner loop
G_M000_IG05:                ;; offset=0x0020
       movsxd   r8, dword ptr [rdx]
       add      rax, r8
       add      rdx, 4
       dec      esi
       jne      SHORT G_M000_IG05
int[,] döngüsü her element için iki bounds check (cmp/jae), lower bound çıkarma ve satır offset'i için bir imul yapıyor; boyut bilgisini de her turda object'in içinden ([rdi+0x14], [rdi+0x1C]) yeniden okuyor. Jagged satırdaki döngü ise beş instruction: oku, topla, pointer'ı ilerlet, sayacı azalt, dallan. Cache-friendly olmak gerekli ama yeterli değil; sıcak döngüde int[,] yerine jagged array ya da tek boyutlu bir array'i r * cols + c ile indekslemek çoğu zaman daha iyi kod üretir.
Conflict Miss: Genişliği 16 Artırınca 4,6 Kat Hızlanan Döngü
İkinci tahmin sorusu. 2048 satırlık tabloyu yalnızca sütun sütun geziyoruz, değişen tek şey satır genişliği:
[SimpleJob(warmupCount: 3, iterationCount: 12)]
public class StrideBenchmarks
{
    private int[,] _grid = null!;

    [Params(4096, 4112)]
    public int Columns { get; set; }

    [GlobalSetup]
    public void Setup() => _grid = new int[2048, Columns];

    [Benchmark]
    public long ColumnMajor() => GridSum.ColumnMajor(_grid);
}
| Method | Columns | Mean | Error | StdDev |
|------------ |-------- |----------:|---------:|---------:|
| ColumnMajor | 4096 | 30.848 ms | 5.725 ms | 4.470 ms |
| ColumnMajor | 4112 | 6.631 ms | 1.480 ms | 1.156 ms |Tablo yüzde 0,4 büyüdü, döngü 4,6 kat hızlandı. Figürdeki hesabı hatırla: 64 set'li bir L1d'de aralarında 4096 byte'ın katı kadar fark olan adresler aynı set'e düşer. 4096 sütunluk bir satır 16 KB, yani bir sütundaki 2048 element'in hepsi aynı set'e gidiyor ve o set'in yalnızca 12 way'i var. Cache'in geri kalanı boş dururken her yeni satır, bir sonraki sütunda tekrar lazım olacak line'ı kovuyor: klasik conflict miss. Aynı şey L2'de de oluyor: 2 MB, 16-way bir L2'de set'ler 128 KB'ta bir tekrar eder, 16 KB'lık adım yalnızca 8 set'i dolaşır ve 2048 line'a 8 × 16 = 128 yer kalır. 4112 sütunda satır 16.448 byte; her satır bir sonraki set'e kayıyor, line'lar bütün set'lere dağılıyor. Bir sütun için getirilen 2048 line L1'e sığmasa da L2'de kalıyor ve sonraki 15 sütun onları oradan okuyor.
Ölçüm M5'te alındı; geometrisi farklı (128 byte line, Apple set/way sayılarını belgelemiyor) ama 2'nin büyük kuvvetlerindeki adım her set-associative cache'te aynı tuzağa düşer, yalnızca kritik adım değişir. 4096'lık 2D demodaki 6,5 katın bir kısmı da conflict miss'ti. Matris ve görüntü kodunda satır genişliğine bilerek birkaç element eklemek (padding) bu yüzden yaygındır.
Demo 2: Array of Structs ve Struct of Arrays
Bookstore'un katalog raporu bir milyon kitabı tarıyor. Klasik yerleşim Array of Structs (AoS): her kitabın bütün field'ları yan yana. Alternatifi Struct of Arrays (SoA): her field kendi array'inde.
namespace Bookstore.Cache;

// Array of Structs: bir kitabın bütün field'ları yan yana
public readonly record struct BookRow(
    Guid Id, decimal Price, int AuthorId, int Stock, DateTime PublishedAt, long Flags);

// Struct of Arrays: her field kendi array'inde
public sealed class BookColumns(int count)
{
    public Guid[] Ids { get; } = new Guid[count];
    public decimal[] Prices { get; } = new decimal[count];
    public int[] AuthorIds { get; } = new int[count];
    public int[] Stocks { get; } = new int[count];
    public DateTime[] PublishedAts { get; } = new DateTime[count];
    public long[] Flags { get; } = new long[count];
    public int Count => Prices.Length;
}

public static class PriceReport
{
    public static decimal TotalAos(ReadOnlySpan<BookRow> books)
    {
        decimal total = 0m;
        foreach (ref readonly BookRow book in books)
            total += book.Price;
        return total;
    }

    public static decimal TotalSoa(ReadOnlySpan<decimal> prices)
    {
        decimal total = 0m;
        foreach (decimal price in prices)
            total += price;
        return total;
    }

    public static long StockAos(ReadOnlySpan<BookRow> books)
    {
        long total = 0;
        foreach (ref readonly BookRow book in books)
            total += book.Stock;
        return total;
    }

    public static long StockSoa(ReadOnlySpan<int> stocks)
    {
        long total = 0;
        foreach (int stock in stocks)
            total += stock;
        return total;
    }
}
BookRow 56 byte (test bunu Unsafe.SizeOf ile doğruluyor). Fiyat raporu her kitaptan 16 byte'lık decimal'ı, stok raporu 4 byte'lık int'i okuyor. AoS'ta CPU yine de 56 byte'ın tamamını line'larla taşımak zorunda; SoA'da taşınan her byte işe yarıyor.
| Method              | Books   | Mean         | Error       | StdDev      | Ratio | RatioSD |
|-------------------- |-------- |-------------:|------------:|------------:|------:|--------:|
| ArrayOfStructs      | 10000   |    46.269 us |   2.6048 us |   1.8834 us |  1.00 |    0.06 |
| StructOfArrays      | 10000   |    35.581 us |   1.7298 us |   1.3505 us |  0.77 |    0.04 |
| StockArrayOfStructs | 10000   |     5.813 us |   0.7828 us |   0.6112 us |  0.13 |    0.01 |
| StockStructOfArrays | 10000   |     3.083 us |   0.5745 us |   0.4486 us |  0.07 |    0.01 |
|                     |         |              |             |             |       |         |
| ArrayOfStructs      | 1000000 | 4,814.026 us | 338.9734 us | 224.2099 us |  1.00 |    0.06 |
| StructOfArrays      | 1000000 | 3,802.322 us | 157.4546 us | 113.8500 us |  0.79 |    0.04 |
| StockArrayOfStructs | 1000000 | 1,260.297 us |  94.3486 us |  73.6612 us |  0.26 |    0.02 |
| StockStructOfArrays | 1000000 |   249.763 us |   1.5641 us |   1.1310 us |  0.05 |    0.00 |
Stok raporunda SoA bir milyon kitapta 5 kat hızlı: 56 MB yerine 4 MB okuyor. On bin kitapta fark 1,9 kata iniyor, çünkü 560 KB'lık AoS verisi de L2'de duruyor. Asıl ders fiyat raporunda: SoA ancak yüzde 20 kazandırıyor, bir önceki koşuda ise oran 1,07 çıkmıştı; fark gürültü mertebesinde. decimal toplaması donanımda tek instruction değil, yazılımla yapılan bir işlem (iç yapısı Number System'ler ve Data Representation serisinde); döngü belleği değil CPU'yu bekliyor. Layout değişikliği yalnızca darboğaz bellek trafiği olduğunda kazandırır; önce bunu ölç.
SoA'nın bedeli: tek bir kitabı okumak altı array'e dokunmak, ekleme ve silme altı yerde. Pratikte ara yol sık kullanılır: sıcak raporun okuduğu birkaç field'ı ayrı tutup gerisini AoS bırakmak.
Demo 3: Struct Layout, Alignment ve Padding
Line başına kaç element sığacağını struct'ın boyutu belirler, boyutu da field sırası. CLR (Common Language Runtime; .NET'in çalışma ortamı), field'ları doğal hizalarına (alignment) yerleştirir: long 8'in katı olan bir offset'te başlar. Arada kalan boşluklar padding'dir.
using System.Runtime.InteropServices;

namespace Bookstore.Cache;

// Field'lar "mantıklı" sırada ama küçük ve büyük field'lar karışık
[StructLayout(LayoutKind.Sequential)]
public struct StockEntrySequential
{
    public bool IsActive;
    public long BookId;
    public byte Warehouse;
    public long Quantity;
    public bool IsReserved;
}

// Aynı field'lar, büyükten küçüğe sıralı
[StructLayout(LayoutKind.Sequential)]
public struct StockEntryOrdered
{
    public long BookId;
    public long Quantity;
    public byte Warehouse;
    public bool IsActive;
    public bool IsReserved;
}

// Sıralamayı runtime'a bırak
[StructLayout(LayoutKind.Auto)]
public struct StockEntryAuto
{
    public bool IsActive;
    public long BookId;
    public byte Warehouse;
    public long Quantity;
    public bool IsReserved;
}

// Aynı veri class olarak: header + method table pointer eklenir
public sealed class StockEntryClass
{
    public bool IsActive;
    public long BookId;
    public byte Warehouse;
    public long Quantity;
    public bool IsReserved;
}
Boyutları Unsafe.SizeOf<T>(), field offset'lerini Unsafe.ByteOffset, class'ın heap'teki boyutunu bin instance'ın GC.GetAllocatedBytesForCurrentThread farkıyla ölçen küçük bir console uygulamasının x64 çıktısı (ARM64'te birebir aynı çıktı):
Arch: X64
StockEntrySequential : 40 bytes
StockEntryOrdered    : 24 bytes
StockEntryAuto       : 24 bytes
BookRow              : 56 bytes
Sequential offsets   : IsActive=0, BookId=8, Warehouse=16, Quantity=24, IsReserved=32
Auto offsets         : IsActive=16, BookId=0, Warehouse=17, Quantity=8, IsReserved=18
StockEntryClass      : 40 bytes per object on the heap
Aynı beş field, aynı 19 byte'lık veri: sıralı yerleşimde 40 byte, büyükten küçüğe dizince 24 byte. Sequential'da her bool/byte'tan sonra 7 byte padding var. Bir milyon kayıtlık stok array'inde bu 40 MB ile 24 MB arasındaki fark. LayoutKind.Auto'da runtime sıralamayı kendisi yapıyor ve aynı 24 byte'ı buluyor.
C# struct'ları varsayılan olarak Sequential, çünkü native kodla paylaşılabilirler ve orada sıra sözleşmenin parçasıdır. Interop'a gitmeyen, milyonlarca kopyası tutulan struct'larda field'ları büyükten küçüğe dizmek ya da Auto kullanmak bedava kazançtır.
.NET'e Özgü: Object Header, Method Table ve GC Compaction
StockEntryClass'ın 40 byte tutması class'ların gizli maliyeti. 64 bit'lik bir .NET process'inde her object önce 8 byte'lık object header (sync block index alanı) ve 8 byte'lık method table pointer'ı taşır. Class'larda field yerleşimi zaten otomatik, 19 byte'lık veri 24'e yuvarlanmış ve üstüne 16 byte binmiş. Struct olarak array'de 24 byte, class olarak heap'te 40 byte artı array'de 8 byte'lık referans.
Class array'inde yalnızca referanslar yan yana durur; bunun pointer chasing maliyetini serinin bir önceki yazısında List<Book> ile ölçmüştük. Bir ayrıntı ekleyeyim: GC (garbage collector; kullanılmayan object'leri temizleyen runtime bileşeni) yeni object'leri bir allocation bölgesinde art arda yerleştirir, compaction da hayatta kalanları sıralarını koruyarak sıkıştırır. Birlikte oluşturulan object'ler çoğu zaman yan yana kalır. GC'nin nasıl çalıştığı C# Nesne Yönelimli Programlama serisinin "C#'ta Object'lerin Ömrü: Garbage Collector, IDisposable ve using" yazısında ve Compiler'lar ve Programlama Dilleri serisinin GC yazısında.
Contiguous veriyle çalışmanın .NET'teki ortak dili Span<T>: yukarıdaki raporlar array'le de, stackalloc tamponla da, CollectionsMarshal.AsSpan ile bir List<T>'in iç array'iyle de çalışır; foreach (ref readonly ...) 56 byte'lık struct'ı kopyalamadan okur. Ayrıntılar C# İleri Seviye serisinin "C#'ta Span<T> ve Memory<T>: Allocation'sız Parse, stackalloc ve ref struct Kuralları" yazısında.
Üretimde Dikkat
Bu teknikler sıcak döngü içindir; HTTP isteğinin süresi veritabanında geçiyorsa field sırasının faydası yok. Önce profiler ile sıcak yolu bul (.NET'te Profiling ve Diagnostics serisi bu araçları anlatıyor), sonra o döngünün darboğazının bellek mi hesap mı olduğunu anla. Fiyat raporu örneği bunun canlı kanıtı: aynı layout değişikliği int'te 5 kat, decimal'da gürültü kadar etki etti.
Ölçümü üretim donanımına benzer bir makinede yap: 16 MB L2'li bir M5 çekirdeği ile 2 MB L2'li bir x64 çekirdeğinde "veri cache'e sığıyor mu" sorusunun cevabı farklı n'lerde değişir. Line boyutunu ve set sayısını kodun içine sabit olarak gömme; .NET'in kendi kaynak kodu bile false sharing'e karşı kullandığı padding sabitini, yaygın cache line boyutlarının hepsini kapsasın diye 128 byte tanımlıyor. False sharing'in kendisi serinin sonraki yazısının konusu.
Büyük veri setini işlerken bloklara böl (tiling): 4096 × 4096'lık bir matrisi 64 × 64'lük karelerle gezmek, her karenin L1/L2'de kalmasını sağlar. Matris çarpımı, görüntü işleme ve büyük dosya dönüşümleri bu tekniğin klasik yeridir.
Sık Düşülen Tuzaklar
Her class'ı struct yapmak. 56 byte'lık struct'ı değerle geçirmek her çağrıda 56 byte kopyalar, interface'e atamak boxing yapar. Ölçü ve kurallar C# İleri Seviye serisinin "C#'ta Performans: Allocation, Struct'lar ve BenchmarkDotNet ile Ölçmek" yazısında.
Benchmark'ta veri setinin cache'e sığması. 256 × 256'da 1,5 kat görünen fark 4096 × 4096'da 6,5 kat. En az iki boyut ölç: biri cache'e sığan, biri sığmayan.
Prefetcher'ın farkı gizlemesi. Sabit adımlı erişimde "cache-unfriendly" sandığın kod hızlı çıkabilir; rastgele erişimde (hash tablosu, ağaç) bu yardım yoktur. Benchmark'ın erişim düzeni gerçek kodunkiyle aynı olmalı.
2'nin kuvveti boyutlar. 1024, 2048, 4096 genişlikli tablolar, aynı boyutta tamponlar ve aralarında 4 KB'ın katı kadar mesafe olan sıcak alanlar conflict miss'e davetiyedir. Genişliği bir line kadar büyütmek çoğu zaman yeter.
Pack = 1 ile padding'i silmek. Line sınırını aşan long'lar ve hizasız erişim getirir; byte düzeni dışarıdan dayatılmadıkça (ağ protokolü, dosya formatı) doğru araç field sırasıdır.
Küçük Bir Deneme
★☆☆ GridBenchmarks'a N = 1024 ve N = 1040 ekle. 2'nin kuvveti olan genişlikte ColumnMajor'ın oranı neden daha kötü? Aynı ölçümü Windows'taki x64 makinende yapıp coreinfo -l çıktısındaki L1d ve L2 boyutlarıyla karşılaştır.
★★☆ RowMajor'u int[,] yerine tek boyutlu bir int[] ve r * cols + c indeksiyle yeniden yaz. JaggedRowMajor'a yetişiyor mu? DOTNET_JitDisasm ile iç döngüdeki bounds check sayısına bak.
★★★ Matrisi 32 × 32, 64 × 64 ve 128 × 128'lik bloklarla gezen bir TiledTranspose yaz (sonucu yeni bir array'e transpose et). Naif transpose ile blok boyutlarını 4096 × 4096'da ölç; hangi blok boyutunda kazanç en yüksek ve bu, makinenin L1d boyutuyla nasıl ilişkili?
Buraya kadar hep tek çekirdek konuştuk. Serinin sonraki yazısı, "Multi-Core, Hyper-Threading ve False Sharing: Çekirdek Sayısı Neden Performansı Doğrusal Artırmaz?", aynı line'ı iki çekirdek paylaştığında ne olduğunu, yan yana duran iki sayacın paralel kodu nasıl tek thread'den yavaş hale getirebileceğini ölçüyor.