

Bir C# Satırı CPU'da Nasıl Çalışır: Kaynak Koddan IL'e, Assembly'den Instruction'a
Bir C# satırı CPU'ya iki çeviriyle ulaşır: Roslyn onu IL'e, JIT de çalışma anında o makinenin ISA'sına göre machine code'a çevirir; CPU bu byte'ları fetch-decode-execute döngüsüyle işler. TotalQuantity'nin 30 byte'lık x64 Tier-1 kodunu satır satır okuyor, ARM64 karşılığıyla, 789 byte'lık decimal versiyonuyla ve optimizasyonsuz Tier-0 ölçümüyle karşılaştırıyor, .NET 11'in x86-64-v2 tabanını anlatıyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ile derlenip denenmiştir; testler xUnit v3 4.0.3 ile yazıldı. x64 assembly listeleri Linux x64 üzerinde .NET 10.0.15 runtime'ından ve Windows x64 hedefli crossgen2 10.0.13'ten; Arm listeleri ve ölçümler BenchmarkDotNet 0.15.8 ile Apple M5 (Apple'ın Arm tabanlı işlemcisi) / macOS 27 / .NET 10.0.13 üzerinde alınmıştır. .NET 11 bilgileri 10 Kasım 2026'da çıkan kararlı sürümün resmi dokümanına dayanır.
Önce Tahmin Et
Bookstore'un sipariş servisinde şu satır var: total += item.Quantity;. Bir siparişteki kitap adetlerini topluyor. Sana iki soru. Birincisi: bu satır CPU'ya ulaşana kadar kaç kez başka bir dile çevrilir? İkincisi: aynı döngünün decimal fiyatları toplayan kardeşi total += item.UnitPrice * item.Quantity; makine koduna çevrildiğinde kaç kat büyür: iki mi, beş mi, yirmi mi?
Bir de üçüncü, daha sinsi bir soru: aynı dll dosyası bir Windows x64 sunucuda ve bir ARM64 (Arm'ın 64 bit işlemci mimarisi) dizüstünde çalışıyor. İki makinede çalışan instruction'lar aynı mı? Bu yazı bu üç sorunun cevabını gerçek JIT (Just-In-Time; .NET kodunu çalışma anında makine koduna çeviren derleyici) çıktısıyla veriyor. Serinin geri kalanında konuşacağımız pipeline, cache, çok çekirdek ve SIMD (tek instruction ile birden çok veri üzerinde işlem) konularının hepsi burada kuracağımız resmin üzerine oturuyor.
Katman Katman: C#'tan IL'e
Önce çalışacağımız kod. Bookstore'un sipariş satırı bir record struct, iki method da bir array'i tek geçişte geziyor:
using System.Runtime.CompilerServices;

namespace Bookstore.Disasm;

public readonly record struct OrderItem(string Isbn, decimal UnitPrice, int Quantity);

public static class OrderMath
{
    [MethodImpl(MethodImplOptions.NoInlining)]
    public static decimal TotalPrice(OrderItem[] items)
    {
        decimal total = 0m;
        foreach (OrderItem item in items)
        {
            total += item.UnitPrice * item.Quantity;
        }
        return total;
    }

    [MethodImpl(MethodImplOptions.NoInlining)]
    public static int TotalQuantity(OrderItem[] items)
    {
        int total = 0;
        foreach (OrderItem item in items)
        {
            total += item.Quantity;
        }
        return total;
    }
}
NoInlining yalnız deney için: method'un çağıran koda gömülmesini engelliyor, böylece JIT çıktısında onu tek başına görebiliyoruz. dotnet build dediğinde Roslyn (C# derleyicisi) bu kodu makine koduna değil, IL'e (Intermediate Language; .NET'in işlemciden bağımsız ara dili) çevirir. Derlenmiş dll'i ilspycmd 11.2 ile açınca TotalQuantity'nin döngüsü şöyle görünüyor:
IL_0008: ldloc.1
IL_0009: ldloc.2
IL_000a: ldelem Bookstore.Disasm.OrderItem
IL_000f: stloc.3
IL_0010: ldloc.0
IL_0011: ldloca.s 3
IL_0013: call instance int32 Bookstore.Disasm.OrderItem::get_Quantity()
IL_0018: add
IL_0019: stloc.0
IL_001a: ldloc.2
IL_001b: ldc.i4.1
IL_001c: add
IL_001d: stloc.2
IL_001e: ldloc.2
IL_001f: ldloc.1
IL_0020: ldlen
IL_0021: conv.i4
IL_0022: blt.s IL_0008
IL bir stack machine dilidir: ldloc bir local'i evaluation stack'e koyar, add en üstteki iki değeri alıp toplamı geri koyar. Register yok, işlemci yok, element'in bellekte kaç byte olduğu bile yazmıyor. foreach bir index döngüsüne açılmış, property erişimi gerçek bir call olarak duruyor. Toplam 38 byte IL. Bu kod hiçbir CPU'nun anlayacağı bir şey değil; o yüzden çalışma anında bir derleyiciye daha ihtiyaç var.
CPU'nun Yaptığı Tek Şey: Fetch, Decode, Execute
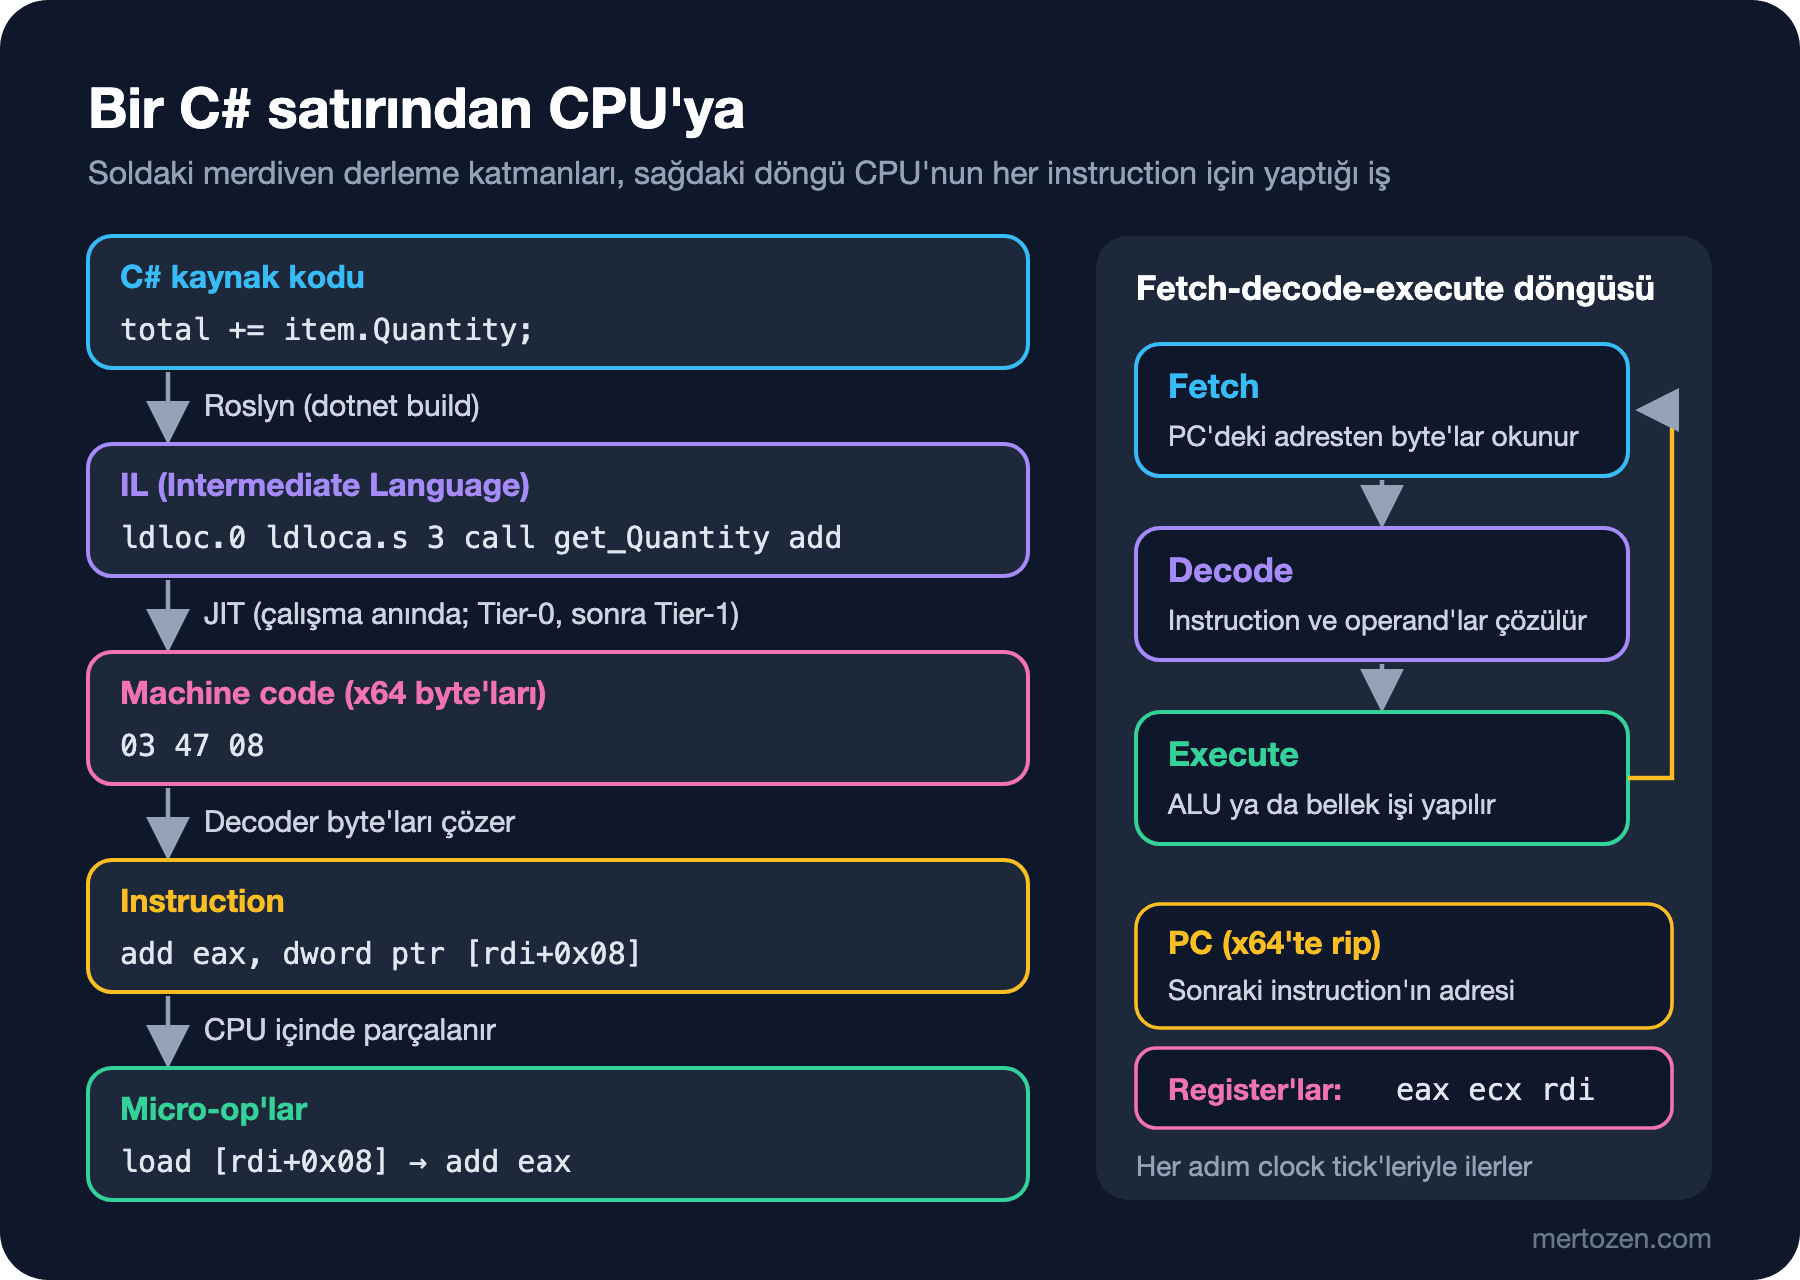
O derleyici JIT: method ilk çağrıldığında IL'i o makinenin koduna çevirir. JIT'in ürettiği şey machine code: belleğe yazılmış byte'lar. CPU açısından program, belleğin bir bölgesinde duran bu byte'lardan ibaret. Veri de aynı belleğin başka bir bölgesinde. Programı ve veriyi aynı bellekte tutup işlemcinin ikisine de aynı yoldan erişmesi fikri von Neumann mimarisi olarak bilinir; adını John von Neumann'ın 1945 tarihli EDVAC (ilk stored-program bilgisayar tasarımlarından biri) raporundan alır.
CPU'nun içinde birkaç özel kutu var. Register'lar işlemcinin içindeki, adı olan, çok küçük ve çok hızlı depolama alanları: x64'te rax, rcx, rdi gibi 16 genel amaçlı register var, ARM64'te x0–x30. Program counter (x64'te adı rip) sıradaki instruction'ın adresini tutar. CPU sonsuz bir döngü çalıştırır: program counter'ın gösterdiği byte'ları okur (fetch), bunların hangi instruction olduğunu ve hangi register'larla çalıştığını çözer (decode), işi yapar (execute) ve program counter'ı bir sonraki instruction'a ilerletir. Bir jump instruction'ı bu sırayı bozan tek şeydir: program counter'a yeni bir adres yazar. Döngülerin, if'lerin, method çağrılarının hepsi makine seviyesinde buna iner.
Bu adımların temposunu clock belirler. 4 GHz'lik bir çekirdekte bir clock cycle 0,25 nanosaniye sürer. Modern bir çekirdek bir cycle'da birden fazla instruction'ı aynı anda işleyebilir; bunun nasıl olduğu serinin sonraki yazısı "CPU Pipeline ve Branch Prediction: Sıralı Array Neden Daha Hızlı İşlenir?" yazısının konusu. Burada akılda kalması gereken model basit: byte oku, çöz, çalıştır, ilerle.
Bir kat daha aşağı inersek register'lar ve toplama devresi transistor'lardan kurulmuş logic gate'lerdir (AND, OR, NOT gibi mantık kapıları). Bütün bir bilgisayarın yalnız NAND (AND'in tersini veren mantık kapısı) kapısından başlanarak kurulabileceğini adım adım gösteren Nand2Tetris projesi (Noam Nisan ve Shimon Schocken'in The Elements of Computing Systems kitabı) bu katmanı merak edenler için en iyi başlangıç. Bu seride o katmana inmeyeceğiz; bizim için en alt katman instruction.
JIT'in Ürettiği Assembly'yi Görmek
JIT'in ürettiği kodu görmek için ek araç gerekmiyor. .NET 7'den beri DOTNET_JitDisasm ortam değişkeni Release runtime'da da çalışıyor. Önce method'ları yeterince çağıran küçük bir program:
using Bookstore.Disasm;

OrderItem[] items =
[
    new("978-0135957059", 42.50m, 2),
    new("978-1617294532", 39.99m, 1),
    new("978-0321125217", 54.90m, 3),
];

// Tier-0'dan Tier-1'e geçişi tetiklemek için method'ları bolca çağır
for (int round = 0; round < 3; round++)
{
    for (int i = 0; i < 1_000; i++)
    {
        OrderMath.TotalPrice(items);
        OrderMath.TotalQuantity(items);
    }
    Thread.Sleep(300);
}

Console.WriteLine($"TotalPrice    = {OrderMath.TotalPrice(items)}");
Console.WriteLine($"TotalQuantity = {OrderMath.TotalQuantity(items)}");
Windows'ta PowerShell'den şöyle çalıştırırsın (Linux'ta aynı değişkeni komutun önüne DOTNET_JitDisasm="TotalQuantity" dotnet run -c Release diye yazarsın):
$env:DOTNET_JitDisasm = "TotalQuantity"
$env:DOTNET_JitDisasmWithCodeBytes = "1"
dotnet run -c Release
Çıktıda aynı method için birden fazla listeleme göreceksin, çünkü .NET method'u önce hızlıca, optimizasyonsuz derler (Tier-0), çok çağrıldığını görünce arka planda optimize ederek yeniden derler (Tier-1). Asıl çalışan kod Tier-1. Linux x64'te .NET 10.0.15'in ürettiği Tier-1 kodu, byte'larıyla birlikte:
; Assembly listing for method Bookstore.Disasm.OrderMath:TotalQuantity(Bookstore.Disasm.OrderItem[]):int (Tier1)
; Emitting BLENDED_CODE for generic X64 + VEX on Unix
G_M000_IG01:                ;; offset=0x0000
       55                   push     rbp
       488BEC               mov      rbp, rsp
G_M000_IG02:                ;; offset=0x0004
       33C0                 xor      eax, eax
       8B4F08               mov      ecx, dword ptr [rdi+0x08]
       85C9                 test     ecx, ecx
       7E0F                 jle      SHORT G_M000_IG05
G_M000_IG03:                ;; offset=0x000D
       4883C710             add      rdi, 16
G_M000_IG04:                ;; offset=0x0011
       034708               add      eax, dword ptr [rdi+0x08]
       4883C720             add      rdi, 32
       FFC9                 dec      ecx
       75F5                 jne      SHORT G_M000_IG04
G_M000_IG05:                ;; offset=0x001C
       5D                   pop      rbp
       C3                   ret
; Total bytes of code 30
38 byte IL, 30 byte machine code'a dönüşmüş. Satır satır okuyalım. xor eax, eax toplamı sıfırlıyor; eax aynı zamanda dönüş değerinin register'ı, yani total baştan sona register'da yaşıyor, belleğe hiç yazılmıyor. mov ecx, dword ptr [rdi+0x08] array'in uzunluğunu okuyor: rdi array object'inin adresi, ilk 8 byte'ta tip bilgisinin pointer'ı, 8. byte'ta uzunluk duruyor. add rdi, 16 ile pointer ilk element'e taşınıyor.
Döngünün kendisi dört instruction. add eax, dword ptr [rdi+0x08] element'in 8. byte'ındaki Quantity'yi doğrudan bellekten okuyup toplama ekliyor. add rdi, 32 bir sonraki element'e geçiyor: OrderItem bellekte 32 byte (string referansı, int ve 16 byte'lık decimal; alanların bu sırayla yerleşmesini serinin "CPU Cache Nasıl Çalışır" yazısında struct layout başlığında konuşacağız). dec ecx ve jne sayacı azaltıp sıfır değilse başa dönüyor. Ne get_Quantity çağrısı kaldı ne de index'in array sınırını aşıp aşmadığını kontrol eden bounds check: JIT, sayacın uzunluktan türediğini kanıtladığı için kontrolü sildi.
Windows x64'te gövde aynı, yalnız register'lar farklı. Microsoft x64 calling convention'ı (fonksiyonlar arası parametre geçirme kuralı) ilk dört tam sayı parametreyi rcx, rdx, r8, r9'da geçirir; Linux ve macOS'un kullandığı System V kuralı ise rdi, rsi, rdx, rcx sırasını kullanır. Aynı method'u crossgen2 ile Windows x64 hedefine derleyince döngü add eax, dword ptr [rcx+0x08], add rcx, 32, dec edx, jne olarak çıkıyor. Kendi Windows makinende göreceğin Tier-1 listesi de bu dört satırın eşi olmalı.
ISA: Aynı IL, İki Farklı Makine Dili
Bir CPU'nun hangi instruction'ları anladığını, bunların byte'larla nasıl kodlandığını ve hangi register'ların olduğunu ISA (Instruction Set Architecture; işlemcinin yazılıma sunduğu instruction kümesi ve kuralları) tanımlar. Intel ve AMD'nin (x86 uyumlu işlemci üreticisi) işlemcileri x86-64 ISA'sını, Apple M serisi, Amazon'un Graviton sunucuları ve Windows on Arm cihazları ARM64 ISA'sını konuşur. Aynı dll'i Apple M5'te çalıştırınca JIT aynı IL'den bambaşka byte'lar üretiyor:
G_M000_IG04:                ;; offset=0x0020
        B9400803          ldr     w3, [x0, #0x08]
        0B010061          add     w1, w3, w1
        91008000          add     x0, x0, #32
        51000442          sub     w2, w2, #1
        35FFFF82          cbnz    w2, G_M000_IG04
İki fark hemen göze çarpıyor. Birincisi uzunluk: ARM64'te her instruction tam 4 byte, x64'te ise 1 ile 15 byte arasında değişiyor (yukarıda pop rbp 1, add rdi, 32 4 byte). Sabit uzunluk, decoder'ın bir sonraki instruction'ın nerede başladığını hesaplamadan bilmesi demek. Değişken uzunluk ise daha sık kod demek; x64 versiyonu 30, ARM64 versiyonu 64 byte. İkincisi iş bölümü: x64'te tek bir add hem bellekten okuyor hem topluyor. ARM64 bir load/store mimarisi; aritmetik yalnız register'lar üzerinde yapılır, bellekten okumak için ayrı bir ldr gerekir.
Ders kitapları bu ayrımı CISC (Complex Instruction Set Computer; tek instruction'ın çok iş yaptığı tasarım) ve RISC (Reduced Instruction Set Computer; az sayıda, basit ve sabit boyutlu instruction'la çalışan tasarım) diye anlatır. Bugün sınır bulanık: modern x64 çekirdekleri karmaşık instruction'ları içeride micro-op denen daha basit adımlara böler ve asıl çalışan şey bu micro-op'lardır. add eax, dword ptr [rdi+0x08] içeride bir load ve bir toplama olarak ilerler; yani x64 dışarıya CISC yüzü gösterip içeride RISC'e benzer çalışır. Bizim için pratik sonuç şu: aynı C# kodu iki makinede farklı instruction'larla, farklı sayıda adımda çalışır. Bir ISA'da ölçtüğün performansı diğerine olduğu gibi taşıyamazsın.
.NET'in "bir kez derle, her yerde çalıştır" vaadi tam olarak bu katmandan geliyor: dll'in içinde IL var, ISA'ya özgü kodu hedef makinedeki JIT üretiyor. Hangi ortamda olduğunu kod içinden de sorabilirsin:
using System.Runtime.InteropServices;
using System.Runtime.Intrinsics.X86;

Console.WriteLine($"Process arch : {RuntimeInformation.ProcessArchitecture}");
Console.WriteLine($"RID          : {RuntimeInformation.RuntimeIdentifier}");
Console.WriteLine($"Runtime      : {RuntimeInformation.FrameworkDescription}");
Console.WriteLine($"x86-64-v2 (SSE4.2, POPCNT) : {Sse42.IsSupported && Popcnt.IsSupported}");
Console.WriteLine($"x86-64-v3 (AVX2, BMI2, FMA): {Avx2.IsSupported && Bmi2.IsSupported && Fma.IsSupported}");
Console.WriteLine($"x86-64-v4 (AVX-512)        : {Avx512F.IsSupported && Avx512BW.IsSupported}");
AVX2'si (256 bit'lik vektör instruction'ları) olan ama AVX (Advanced Vector Extensions; x64'ün vektör instruction aileleri) ailesinin 512 bit'lik üyesi AVX-512'si olmayan bir Linux x64 ortamında çıktı:
Process arch : X64
RID          : linux-x64
Runtime      : .NET 10.0.15
x86-64-v2 (SSE4.2, POPCNT) : True
x86-64-v3 (AVX2, BMI2, FMA): True
x86-64-v4 (AVX-512)        : False
Apple M5'te ise ilk satır Arm64, RID (runtime identifier; işletim sistemi ve mimariyi birlikte tanımlayan kimlik) osx-arm64 ve üç x86 satırının üçü de False: System.Runtime.Intrinsics.X86 altındaki tipler ARM64'te derlenir ama hiçbir zaman desteklenmez.
decimal CPU'da Yok: TotalPrice Neden Bu Kadar Büyük
Şimdi tahmin sorusunun ikinci kısmı. TotalPrice'ın IL'inde döngünün içinde beş call var: iki property getter, decimal.op_Implicit(int32), decimal.op_Multiply ve decimal.op_Addition. Sebebi basit: CPU'nun decimal diye bir veri tipi yok. x64 ve ARM64 tam sayıları ve IEEE (Elektrik ve Elektronik Mühendisleri Enstitüsü) 754 standardına uyan float/double'ları donanımda işler; 128 bit'lik, 10 tabanlı ölçekli decimal ise .NET'in yazılımla, tam sayı instruction'larıyla gerçekleştirdiği bir tip. Bu temsilin ayrıntısı Number System'ler ve Data Representation serisinin "Floating Point Nasıl Çalışır: IEEE 754, 0.1 + 0.2, NaN ve double vs decimal" yazısında.
JIT çıktısının başlık satırları farkı rakamla gösteriyor:
; Assembly listing for method Bookstore.Disasm.OrderMath:TotalPrice(Bookstore.Disasm.OrderItem[]):System.Decimal (Tier1)
; Emitting BLENDED_CODE for generic X64 + VEX on Unix
; 2 inlinees with PGO data; 61 single block inlinees; 5 inlinees without PGO data
; Total bytes of code 789
TotalQuantity 30 byte'tı, TotalPrice 789 byte: 26 kat. JIT, decimal operatörlerini ve onların çağırdığı yardımcıları method'un içine gömmüş (inline etmiş); listede 200'den fazla instruction, 128 bit çarpım için beş mulx, bir div ve ölçek taşarsa çağrılan DecCalc.ScaleResult var. mulx ilginç bir ayrıntı: BMI2 (x64'ün bit işleme instruction eklentisi) ile gelen bir instruction ve JIT onu yalnız CPU destekliyorsa kullanıyor. Aynı method ARM64'te 684 byte tuttu. Optimizasyonsuz Tier-0 versiyonu ise x64'te 394 byte, yani daha küçük; çünkü orada operatörler gömülmeden, gerçek call olarak kalıyor. Küçük kod hızlı kod demek değil.
ISA Seviyeleri ve .NET 11'in x86-64-v2 Tabanı
x86-64 tek bir sabit küme değil; 2003'ten beri vektör işlemleri, bit işlemleri ve atomik işlemler için eklenen instruction aileleriyle büyüdü. Her CPU'nun hangilerini desteklediğini tek tek sormak zahmetli olduğu için 2020'de x86-64 psABI'ye (Unix sistemlerde x64 ikili arayüzünü tanımlayan belge) dört seviye eklendi: v1 ilk 64 bit kümeyi (CMOV, SSE, SSE2) tarif ediyor; v2 buna SSE3, SSSE3, SSE4.1, SSE4.2, POPCNT ve CMPXCHG16B'yi, v3 AVX, AVX2, BMI1, BMI2, FMA, LZCNT ve MOVBE'yi, v4 de AVX-512'nin temel alt kümelerini ekliyor. Yukarıdaki programın satır başlıkları bu seviyelerden geliyor.
.NET 11 bu kavramı somutlaştırdı. Resmi "What's new in .NET 11 runtime" sayfasına göre JIT ve Native AOT (uygulamayı yayımlarken tamamen önceden makine koduna derleyen mod) için asgari x64 donanımı Windows, Linux ve macOS'ta x86-64-v1'den x86-64-v2'ye çıktı. ReadyToRun (uygulama yayımlanırken önceden derlenen kod) hedefi de Windows ve Linux'ta x86-64-v3 oldu; bu seviyeyi karşılamayan ama desteklenen bir makinede önceden derlenmiş kod kullanılamadığı için açılışta ek JIT maliyeti çıkabiliyor. Sayfaya göre gerekçe, Windows 11'in zaten bu seviyeyi istemesi ve Intel ile AMD'nin hâlâ desteklediği bütün çiplerin onu karşılaması; desteği biten son eski çipler 2013 civarına ait. v2'yi karşılamayan bir makinede .NET 11 uygulaması başlamaz ve dokümana göre şu mesaja benzer bir şey yazar:
The current CPU is missing one or more of the baseline instruction sets.Pratikte bu mesajı en çok eski bir sanallaştırma host'unda ya da CPU özelliklerini kısıtlı gösteren bir VM (sanal makine) ayarında görürsün; hypervisor sanal CPU'ya SSE4.2'yi göstermiyorsa fiziksel donanım yeni olsa bile uygulama açılmaz. ARM64 tarafında Windows için taban LSE (Arm'ın atomik bellek işlemleri eklentisi) ile genişledi, Apple ve Linux'ta asgari donanım değişmedi.
Üretimde Dikkat
Gördüğün assembly'nin hangi tier'dan geldiğine bak. Tier-0 kodunu ölçmenin ne demek olduğunu görmek için aynı iki method'u BenchmarkDotNet ile iki ayrı job'da ölçtüm; ikincisinde DOTNET_JITMinOpts=1 bütün method'ları Tier-0 benzeri optimizasyonsuz kodla derletiyor:
public class TierConfig : ManualConfig
{
    public TierConfig()
    {
        AddJob(Job.Default.WithIterationCount(15).WithId("Optimized"));
        // Bütün method'ları Tier-0 benzeri, optimize edilmemiş kodla derle
        AddJob(Job.Default.WithIterationCount(15).WithId("MinOpts")
            .WithEnvironmentVariables(new EnvironmentVariable("DOTNET_JITMinOpts", "1")));
    }
}
10.000 element'lik bir sipariş array'inde sonuç:
| Method        | Job       | EnvironmentVariables | Mean       | Error      | StdDev     |
|-------------- |---------- |--------------------- |-----------:|-----------:|-----------:|
| TotalQuantity | MinOpts   | DOTNET_JITMinOpts=1  |  21.328 us |  0.4494 us |  0.3508 us |
| TotalPrice    | MinOpts   | DOTNET_JITMinOpts=1  | 138.744 us | 22.7329 us | 21.2644 us |
| TotalQuantity | Optimized | Empty                |   3.083 us |  0.2866 us |  0.2393 us |
| TotalPrice    | Optimized | Empty                |  55.284 us |  7.8430 us |  7.3364 us |
Bu makinede gerçek donanım olarak yalnız Apple M5 (ARM64) vardı; ölçümler orada ve başka işlerin de çalıştığı yüklü bir makinede alındı. Tekrar koşularda optimize TotalPrice 34 ile 55 µs arasında oynadı, oran ise hep aynı yerde kaldı: optimizasyonsuz kod TotalQuantity'de yaklaşık 7 kat, TotalPrice'ta 2,5–3 kat yavaş. Mutlak sayılar Windows x64 makinende farklı çıkacak, yön değişmeyecek. Ayrıca decimal toplamın int toplamdan 15–18 kat yavaş olduğuna dikkat: hem 26 kat büyük kod hem de her adımda 128 bit aritmetik.
Üretimde bundan çıkan üç kural var. Birincisi, servis yeni açıldığında ilk istekler Tier-0 kodla karşılanır; açılış sonrası ilk saniyelerin p99 latency'si bu yüzden yüksektir ve ReadyToRun bunun için var. Ayrıntısı Compiler'lar ve Programlama Dilleri serisinde. İkincisi, container image'ının mimarisi önemli: linux/amd64 image'ını ARM64 bir node'a koyarsan ya hiç çalışmaz ya da emülasyonla yavaş çalışır; uygulama açılışında RuntimeInformation.ProcessArchitecture'ı log'lamak ucuz bir sigorta. Üçüncüsü, .NET 11'e geçmeden önce eski sanallaştırma host'larını ve VM CPU ayarlarını x86-64-v2 açısından kontrol et.
Sık Düşülen Tuzaklar
Debug build'i ölçmek. Debug derlemede Roslyn IL'i optimize etmez ve JIT de debugger dostu, optimizasyonsuz kod üretir; çıkan sayılar Release'in birkaç katı olur. BenchmarkDotNet bu yüzden optimize edilmemiş assembly'yi varsayılan olarak ölçmeyi reddeder. Kurulumu ve diğer ölçüm hataları C# İleri Seviye serisinin "C#'ta Performans: Allocation, Struct'lar ve BenchmarkDotNet ile Ölçmek" yazısında, Big-O ile ölçüm arasındaki fark ise Big-O ve Complexity serisinin "Big-O'nun Söylemedikleri: Sabitler, Cache ve BenchmarkDotNet ile Ölçmek" yazısında.
İlk listelemeyi okuyup karar vermek. DOTNET_JitDisasm çıktısında ilk gördüğün kod Tier-0'dır. TotalQuantity'nin Tier-0 versiyonu 206 byte; local'leri her adımda stack'e yazıyor, get_Quantity'yi gerçekten çağırıyor, her element'te bounds check yapıyor ve PGO (Profile-Guided Optimization; çalışırken toplanan ölçümlere göre yapılan optimizasyon) için sayaç artırıyor. Başlıkta Tier1 yazmayan bir listelemeden performans sonucu çıkarma. SharpLab gibi çevrimiçi araçlar IL'i ve JIT çıktısını yan yana görmek için çok pratik, ama orada da hangi modda derlediğine dikkat et.
IL'e bakıp optimizasyon yapmak. IL'deki call get_Quantity makine kodunda yok; IL'de kısa görünen bir kod makinede uzun, IL'de uzun görünen bir kod makinede kısa olabilir. Performans kararını IL'e değil, Tier-1 assembly'ye ve ölçüme dayandır.
Bir ISA'daki listeyi diğerine genellemek. ARM64'te iki instruction olan iş x64'te tek instruction, x64'te mulx ile yapılan çarpım BMI2'siz bir CPU'da başka instruction'larla yapılır. Assembly'yi her zaman hedef platform için al.
Küçük Bir Deneme
★☆☆ TotalQuantity'yi long döndürecek şekilde değiştir ve Tier-1 listesine tekrar bak. Toplama instruction'ı ve register adları nasıl değişti? eax yerine hangi register çıktı?
★★☆ foreach yerine for (int i = 0; i < items.Length; i++) yaz, sonra koşulu i < 3 olarak değiştir. Bounds check ilk durumda neden yok, ikinci durumda neden geri geliyor? İpucu: listede CORINFO_HELP_RNGCHKFAIL ara.
★★★ Windows x64 makinende DOTNET_JitDisasm="TotalPrice" ile Tier-1 listesini al ve mulx var mı bak. Ardından DOTNET_EnableAVX2=0 ile tekrar dene: JIT çarpımı hangi instruction'larla yapıyor ve kod kaç byte değişiyor? (.NET 10'da bu ayar BMI2'yi de kapatıyor; DOTNET_EnableBMI2=0 tek başına denediğimde kodu değiştirmedi.)
Artık bir C# satırının CPU'ya hangi yoldan indiğini biliyoruz: Roslyn IL üretiyor, JIT o makinenin ISA'sına göre machine code yazıyor, CPU da bu byte'ları fetch, decode, execute döngüsüyle tek tek işliyor. Gerçek çekirdekler ise bu döngüyü bir instruction bitmeden sonrakine başlayarak üst üste bindiriyor. Bunun bedelini ödediğimiz yer de branch'ler. Serinin sonraki yazısı "CPU Pipeline ve Branch Prediction: Sıralı Array Neden Daha Hızlı İşlenir?" tam bunu ölçüyor.