

Multi-Core, Hyper-Threading ve False Sharing: Çekirdek Sayısı Neden Performansı Doğrusal Artırmaz?
Çekirdek sayısı performansı doğrusal artırmaz, çünkü core'lar cache line, bellek bant genişliği ve execution unit gibi kaynakları paylaşır. Dört worker'lık Bookstore sayacında paylaşılan Interlocked sayacın 15 kat yavaşlaması, yan yana slot'ların false sharing yüzünden tek thread'i geçememesi, padding ve local değişkenle düzeltme, Environment.ProcessorCount'un container limitine göre değişmesi ve Hyper-Threading ile P/E core'ların etkisi.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ile derlenip denenmiştir; ölçümler BenchmarkDotNet 0.15.8, testler xUnit v3 4.0.3 ile Apple M5 (ARM64) / macOS 27 / .NET 10.0.13 üzerinde alınmıştır. x64 assembly listeleri .NET 10.0.15 JIT'inin (kodu çalışma anında makine koduna çeviren compiler) Linux x64 container'ında ürettiği koddandır.
Önce Tahmin Et
Bookstore'un gece çalışan sipariş işleme job'ı dört worker ile çalışıyor. Her worker 50 milyon siparişlik bir dilimi işliyor ve kaç sipariş işlediğini sayıyor. Aynı 200 milyon sayma işini tek thread de yapabilir. Ekipteki dört öneri şöyle: herkes tek bir paylaşılan sayacı Interlocked.Increment ile artırsın; her worker'a bir long[] içinde kendi slot'unu verelim; aynı fikir ama her slot 128 byte'lık bir struct olsun; ya da herkes local bir değişkende saysın, en sonda bir kez yazsın.
Hangisi tek thread'den yavaş çıkar? Hangisi tek thread ile aynı sürede biter? Dört worker en iyi durumda kaç kat hızlandırır? Cevapları yazının ortasındaki ölçümde göreceksin; ikisinin sürpriz olduğunu şimdiden söyleyeyim. Bu yazıda ölçümleri elimdeki tek gerçek donanımda, Apple M5 üzerinde aldım; ARM64 ayrıntısına takılmayacağız, x64 tarafını Intel ve .NET dokümanlarından anlatacağım.
Makinede Kaç Core Var? Core, Logical Processor ve SMT
Önce donanımın kendisi. macOS'ta sysctl, Linux'ta lscpu bu bilgiyi verir:
$ sysctl hw.ncpu hw.physicalcpu hw.logicalcpu hw.perflevel0.name hw.perflevel0.physicalcpu hw.perflevel1.name hw.perflevel1.physicalcpu hw.cachelinesize
hw.ncpu: 10
hw.physicalcpu: 10
hw.logicalcpu: 10
hw.perflevel0.name: Super
hw.perflevel0.physicalcpu: 4
hw.perflevel1.name: Efficiency
hw.perflevel1.physicalcpu: 6
hw.cachelinesize: 128
Fiziksel core, kendi pipeline'ı, register'ları ve L1 (core'a en yakın, birinci seviye) cache'i olan bağımsız bir çalışma birimidir. Bu makinede 10 tane var ve 10 logical processor görünüyor; yani her core işletim sistemine tek bir CPU olarak görünüyor. Ama core'lar eşit değil: 4'ü yüksek performanslı (sysctl bunlara "Super" diyor), 6'sı enerji verimli (Efficiency) core. Aynı döngü bu iki grupta farklı hızda çalışır.
Windows'ta x64 bir makinede çoğunlukla başka bir tablo görürsün: Görev Yöneticisi'nin Performans sekmesi core sayısını ve logical processor sayısını ayrı ayrı gösterir, örneğin 8 ve 16. Aradaki fark SMT'dir (Simultaneous Multithreading; bir core'un aynı anda iki thread'in komutlarını çalıştırması); Intel buna Hyper-Threading der. Bir fiziksel core iki logical processor olarak görünür. Her logical processor'ın kendi mimari durumu vardır (register'lar, program counter), ama execution unit'ler, L1 ve L2 (ikinci seviye) cache ve branch predictor paylaşılır. Fikir şu: bir thread bellekten veri beklerken boşta kalan execution unit'leri diğer thread kullansın. Dolayısıyla iki thread aynı core'da çalışırken toplam iş artar ama iki katına çıkmaz; ikisi de hesaplama yoğunsa kazanç küçük kalır.
Son yıllarda iki eğilim daha var. Intel 12. nesilden (Alder Lake, 2021) itibaren hybrid mimari kullanıyor: Hyper-Threading'li P-core'lar (performance) ile Hyper-Threading'siz E-core'lar (efficiency) aynı çipte. Intel'in Lunar Lake ve masaüstündeki Core Ultra 200S (Arrow Lake) aileleri ise P-core'lardaki Hyper-Threading'i tamamen kaldırdı. Diğer büyük x64 üreticisinin (AMD) Zen çekirdekleri SMT'yi sürdürüyor. Apple M serisi baştan beri SMT kullanmıyor, P ve E core ayrımıyla çalışıyor. Yani "16 logical processor" bir makinede 16 eşit core, 8 core × 2 thread ya da 6 P + 8 E core gibi çok farklı şeyler anlamına gelebilir.
Büyük sunucularda bir katman daha var: NUMA (Non-Uniform Memory Access; belleğe erişim süresinin, belleğin hangi işlemci soketine bağlı olduğuna göre değiştiği mimari). Çok soketli bir makinede her soketin kendi bellek denetleyicisi vardır; bir core kendi soketine bağlı RAM'i diğer soketinkinden daha hızlı okur. Windows ayrıca 64'ten fazla logical processor'ı "processor group"lara böler; .NET'te DOTNET_Thread_UseAllCpuGroups ayarı thread pool'un bütün gruplara yayılıp yayılmayacağını belirler ve Windows 11'de varsayılan olarak açıktır. Bu yazının ölçümleri tek soketli bir makinede; NUMA'yı yalnız "aynı çekirdek sayısı her makinede aynı davranmaz" listesine ekle.
Environment.ProcessorCount ve Container'daki CPU Limiti
.NET'in kendisi kaç core gördüğünü Environment.ProcessorCount ile söyler. Thread pool'un minimum thread sayısı ve Server GC'nin (çok core'lu sunucular için ayarlanmış bellek temizleme modu) heap sayısı bu sayıdan beslenir. Küçük bir program:
using System.Runtime.InteropServices;

Console.WriteLine($"OS/Arch        : {RuntimeInformation.OSDescription} / {RuntimeInformation.ProcessArchitecture}");
Console.WriteLine($"ProcessorCount : {Environment.ProcessorCount}");
ThreadPool.GetMinThreads(out int workerThreads, out _);
Console.WriteLine($"ThreadPool min : {workerThreads}");
Önce doğrudan, sonra aynı derlenmiş dll'i Docker container'ında farklı CPU limitleriyle çalıştırdım:
$ dotnet out/cpuinfo.dll
OS/Arch        : macOS 27 / Arm64
ProcessorCount : 10
ThreadPool min : 10

$ DOTNET_PROCESSOR_COUNT=3 dotnet out/cpuinfo.dll
OS/Arch        : macOS 27 / Arm64
ProcessorCount : 3
ThreadPool min : 3

$ docker run --rm -v "$PWD/out":/app mcr.microsoft.com/dotnet/sdk:10.0 dotnet /app/cpuinfo.dll
OS/Arch        : Ubuntu 24.04.5 LTS / Arm64
ProcessorCount : 10
ThreadPool min : 10

$ docker run --rm --cpus=1.5 -v "$PWD/out":/app mcr.microsoft.com/dotnet/sdk:10.0 dotnet /app/cpuinfo.dll
OS/Arch        : Ubuntu 24.04.5 LTS / Arm64
ProcessorCount : 2
ThreadPool min : 2

$ docker run --rm --cpuset-cpus=0-2 -v "$PWD/out":/app mcr.microsoft.com/dotnet/sdk:10.0 sh -c 'nproc; dotnet /app/cpuinfo.dll'
3
OS/Arch        : Ubuntu 24.04.5 LTS / Arm64
ProcessorCount : 3
ThreadPool min : 3
Kural Microsoft Learn'deki referans sayfasında yazıyor: ProcessorCount şu üç değerin en küçüğüdür: makinedeki logical processor sayısı, process'in CPU affinity'si varsa izin verilen processor sayısı, CPU kullanım limiti varsa bu limitin yukarı yuvarlanmışı. --cpus=1.5'in 2'ye dönüşmesi bu yuvarlamadan. Değer runtime başlarken bir kez hesaplanır, process yaşadıkça değişmez. Windows'ta bu davranış .NET 6 ile geldi: o sürümden beri process affinity'si ve job object'in sert CPU limiti de hesaba katılıyor. DOTNET_PROCESSOR_COUNT environment variable'ı ise bütün bunları ezer ve runtime'a "şu kadar CPU var" der.
İki sonuç çıkar. Birincisi, ProcessorCount fiziksel core sayısı değildir: Hyper-Threading'li 8 core'luk bir dizüstünde 16 döner ve P/E ayrımını hiç göstermez. İkincisi, container'a verdiğin CPU limiti .NET'in thread ve GC kararlarını doğrudan değiştirir. Kubernetes'te limit, throttling ve GC ilişkisini Kubernetes serisinin "Resource Request ve Limit'ler: QoS, OOMKilled, CPU Throttling ve Container'da .NET GC" yazısında ayrıntılı ölçmüştük.
Cache Coherence: Core'lar Aynı Line'ı Nasıl Paylaşır?
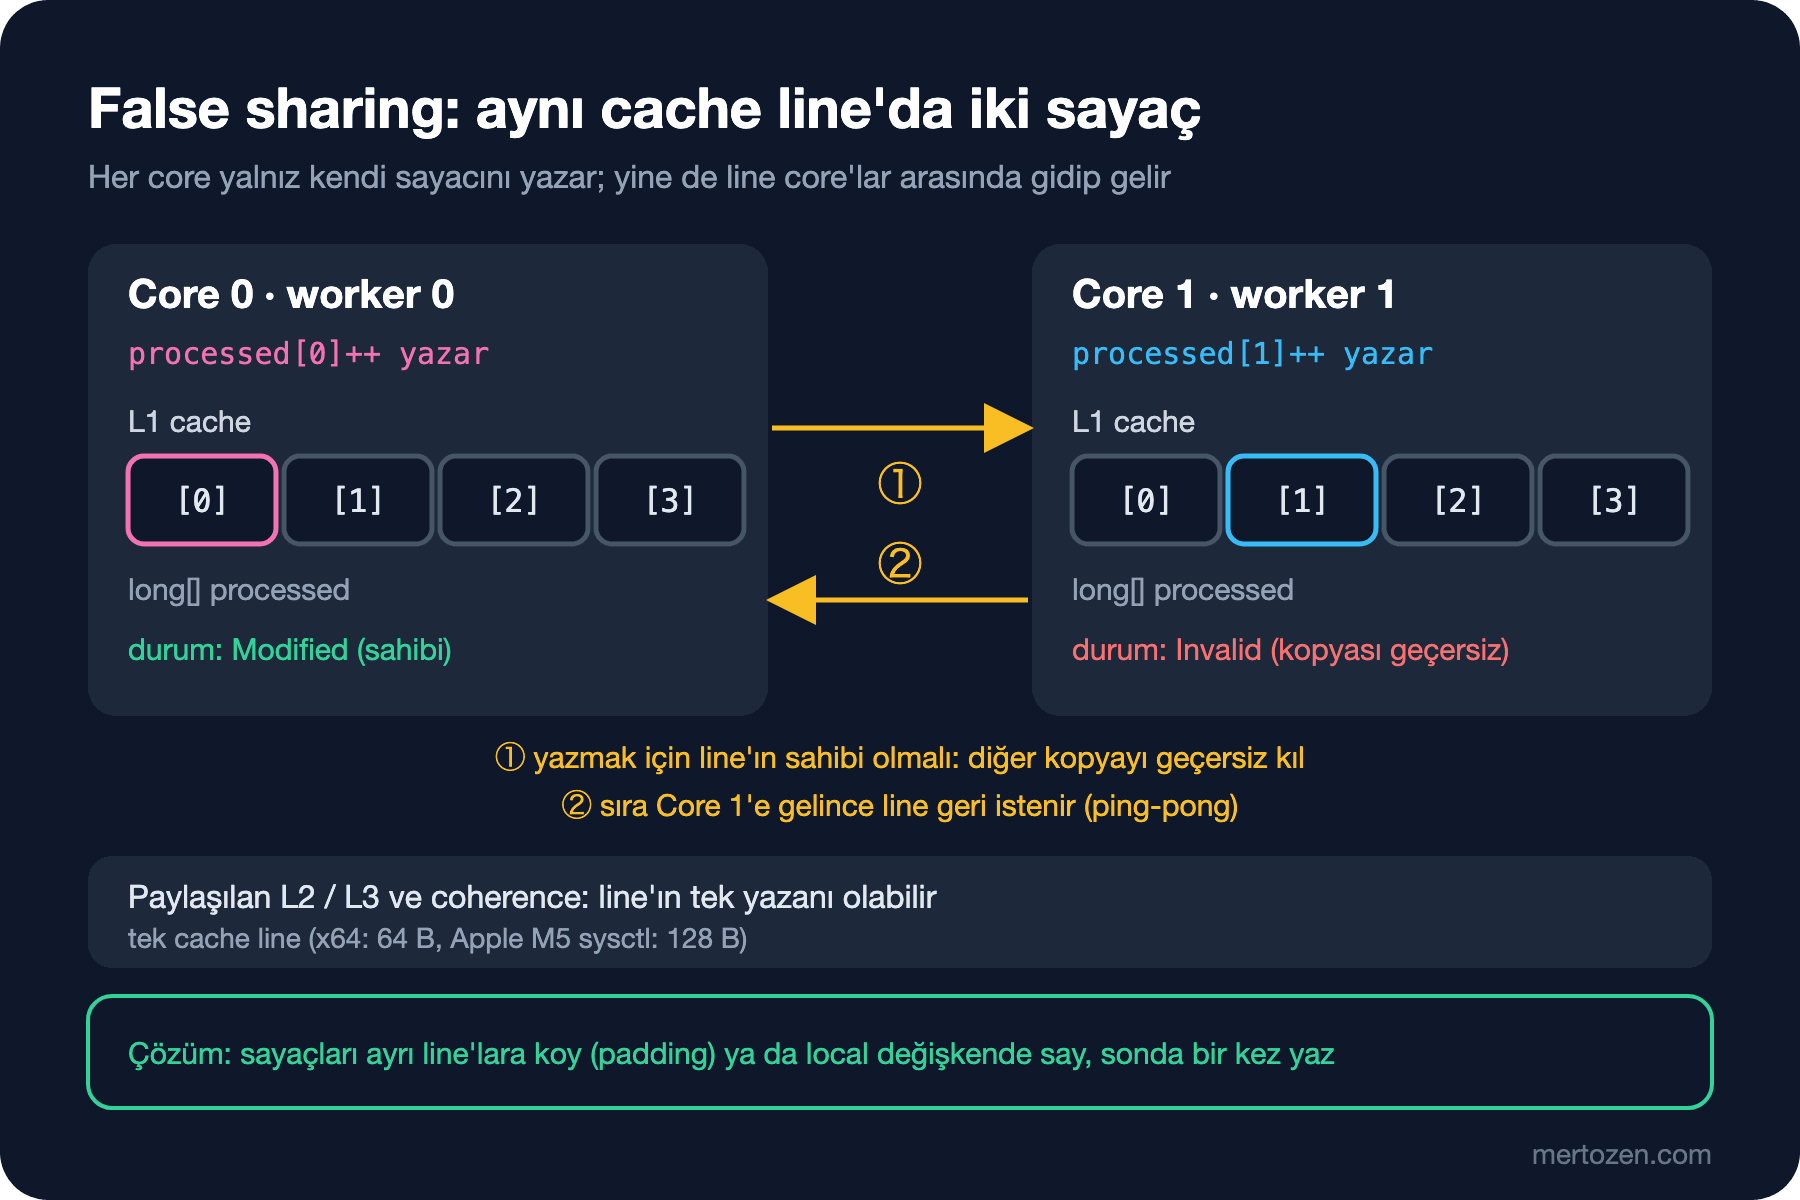
Her core'un kendi L1 cache'i var; çoğu x64 tasarımda L2 de core'a özeldir, L3 (üçüncü seviye) ise paylaşılır. Bellek cache'e tek tek byte olarak değil, serinin "CPU Cache Nasıl Çalışır: Cache Line, Associativity ve Cache-Friendly C# Kodu" yazısında gördüğümüz cache line'lar halinde gelir. İki core aynı line'ı okuyorsa sorun yok: ikisinde de birer kopya durur. Sorun yazmada başlar. Bir core bir line'a yazabilmek için o line'ın tek sahibi olmak zorundadır; donanım diğer core'lardaki kopyaları geçersiz kılar. Öteki core aynı line'a tekrar dokunduğunda line'ı geri ister ve sahiplik el değiştirir.
Bu el sıkışmayı yöneten protokol ailesinin en bilinen üyesi MESI'dir (bir line'ın alabileceği dört durumun baş harfleri: Modified, Exclusive, Shared, Invalid). Bize yeten sezgi şu: aynı line'a birden çok core sırayla yazıyorsa, line core'lar arasında gidip gelir (buna cache line ping-pong denir) ve her gidiş geliş L1'den okumaya kıyasla çok pahalıdır. Bu protokolün doğruluk tarafı, yani yazıların başka core'lara hangi sırayla göründüğü ve reordering, Concurrency Teorisi serisinin "Hardware Memory Model: Reordering, Store Buffer, Cache Coherence ve Sequential Consistency" yazısının konusu. Biz yalnız performans tarafına bakıyoruz.
False Sharing: Paylaşmadığın Veriyi Paylaşmak
Tahmin sorusundaki ikinci öneri, her worker'a kendi slot'unu veren sürüm:
public static class OrderCounters
{
    // Her worker kendi slot'unu artırır ama slot'lar yan yana: false sharing
    public static long CountAdjacent(int workers, int ordersPerWorker)
    {
        long[] processed = new long[workers];
        Parallel.For(0, workers, w =>
        {
            for (int i = 0; i < ordersPerWorker; i++)
            {
                processed[w]++;
            }
        });
        return processed.Sum();
    }
}
Mantıksal olarak hiçbir veri paylaşılmıyor: worker 0 yalnız processed[0]'a, worker 1 yalnız processed[1]'e dokunuyor, lock'a gerek yok, sonuç her zaman doğru. Ama dört long toplam 32 byte ve bellekte yan yana; hepsi tek bir cache line'a sığıyor. Her processed[w]++ bir yazma olduğu için line her iterasyonda başka bir core'a geçmek isteyebilir. Paylaşmadığın veriyi donanım seviyesinde paylaşıyorsun; buna false sharing denir.
JIT'in x64 için ürettiği iç döngü bunu açıkça gösteriyor. Listede Tier1-OSR, döngü çalışırken optimize koda geçilen sürüm demek (OSR: On-Stack Replacement; ayrıntısı Compiler'lar ve Programlama Dilleri serisinde):
; Assembly listing for method Bookstore.Cores.OrderCounters+<>c__DisplayClass0_0:<CountAdjacent>b__0(int):this (Tier1-OSR)
; Emitting BLENDED_CODE for generic X64 + VEX on Unix
G_M000_IG04:                ;; offset=0x0020
       mov      r8, gword ptr [rax+0x08]
       cmp      ecx, dword ptr [r8+0x08]
       jae      SHORT G_M000_IG06
       lea      r8, bword ptr [r8+8*rsi+0x10]
       inc      qword ptr [r8]
       inc      edx
       cmp      edx, edi
       jl       SHORT G_M000_IG04
inc qword ptr [r8] tek bir instruction ama bellekte oku-artır-yaz yapıyor ve her iterasyonda o line'a yazıyor. ARM64'te aynı satır ldr, add, str üçlüsüne dönüşüyor; davranış değişmiyor. Bu listeleri Linux x64 container'ında aldım; Windows x64'te farkı yalnız parametrelerin geldiği register'lar olur, döngünün gövdesi aynıdır. Bu listeler yalnız üretilen kodu göstermek için; süreler yazıdaki ölçüm makinesinden.
Ölçüm: Dört Worker, Dört Strateji
Diğer iki öneri: tek paylaşılan sayaç ve local değişken.
// Tek paylaşılan sayaç: doğru ama bütün core'lar aynı line için yarışır
public static long CountShared(int workers, int ordersPerWorker)
{
    long processed = 0;
    Parallel.For(0, workers, _ =>
    {
        for (int i = 0; i < ordersPerWorker; i++)
        {
            Interlocked.Increment(ref processed);
        }
    });
    return processed;
}

// Asıl çözüm: local değişkende say, sonunda bir kez yaz
public static long CountLocal(int workers, int ordersPerWorker)
{
    long[] processed = new long[workers];
    Parallel.For(0, workers, w =>
    {
        long local = 0;
        for (int i = 0; i < ordersPerWorker; i++)
        {
            local++;
        }
        processed[w] = local;
    });
    return processed.Sum();
}
Padding'li sürümü bir sonraki bölümde açacağım; şimdilik her slot'un 64 ya da 128 byte'lık bir struct olduğunu bil. Benchmark sınıfı her stratejiyi dört worker ve worker başına 50 milyon siparişle çağırıyor; baseline aynı 200 milyon artırmayı tek thread'de yapan CountSingleThread. Her strateji için ayrıca bir xUnit testi toplamın doğru çıktığını doğruluyor.
public class CounterBenchmarks
{
    private const int Workers = 4;
    private const int OrdersPerWorker = 50_000_000;

    [Benchmark(Baseline = true)]
    public long SingleThread() => OrderCounters.CountSingleThread(Workers, OrdersPerWorker);

    [Benchmark]
    public long Shared() => OrderCounters.CountShared(Workers, OrdersPerWorker);

    [Benchmark]
    public long Adjacent() => OrderCounters.CountAdjacent(Workers, OrdersPerWorker);

    [Benchmark]
    public long Padded64() => OrderCounters.CountPadded64(Workers, OrdersPerWorker);

    [Benchmark]
    public long Padded128() => OrderCounters.CountPadded(Workers, OrdersPerWorker);

    [Benchmark]
    public long Local() => OrderCounters.CountLocal(Workers, OrdersPerWorker);
}
BenchmarkDotNet v0.15.8, macOS 27
Apple M5, 1 CPU, 10 logical and 10 physical cores
.NET SDK 10.0.402
[Host] : .NET 10.0.13 (10.0.13, 10.0.1326.50504), Arm64 RyuJIT armv8.0-a
IterationCount=15 WarmupCount=3
| Method | Mean | Error | StdDev | Ratio | RatioSD |
|------------- |------------:|----------:|----------:|------:|--------:|
| SingleThread | 120.38 ms | 24.044 ms | 20.078 ms | 1.04 | 0.29 |
| Shared | 1,792.79 ms | 82.392 ms | 73.038 ms | 15.44 | 3.51 |
| Adjacent | 117.86 ms | 13.318 ms | 12.458 ms | 1.02 | 0.25 |
| Padded64 | 71.86 ms | 1.036 ms | 0.809 ms | 0.62 | 0.14 |
| Padded128 | 69.24 ms | 2.345 ms | 2.193 ms | 0.60 | 0.13 |
| Local | 12.44 ms | 0.255 ms | 0.238 ms | 0.11 | 0.02 |Dürüst bir not: makine bu ölçüm sırasında boş değildi; uptime load average'ı ölçüm boyunca 8 ile 15 arasında gösterdi. Paralel satırlar bu yüzden olması gerekenden kötü olabilir; sıralama ve kabaca oranlar birkaç tekrarda değişmedi.
Tahminlerin cevabı tabloda. Paylaşılan sayaç tek thread'den 15 kat yavaş. x64'te Interlocked.Increment bu döngüde lock inc qword ptr [rdx] instruction'ına dönüşüyor, ARM64'te ise ldaddal atomic instruction'ına. Her iterasyon hem atomic bir işlem hem de line'ın core'lar arasında el değiştirmesi demek. Sonuç doğru ama dört core birbirini bekliyor.
İkinci sürpriz: yan yana slot'lu sürüm tek thread ile aynı sürede bitti (117,9 ms'ye 120,4 ms). Dört core aldık, hiçbir şey kazanmadık. Aynı döngü slot'lar ayrı line'lara düşünce 69 ms'ye iniyor. Asıl kazanan ise local değişken: sayaç register'da yaşıyor, döngü belleğe hiç yazmıyor; tek thread'den yaklaşık 10, padding'li sürümden 5,6 kat hızlı. False sharing'in en etkili çözümü padding değil, paylaşılan belleğe sık yazmamaktır.
Padding Kaç Byte: 64 mü, 128 mi?
Padding'li slot'lar StructLayout ile sabit boyutlu struct'lar:
// 128 byte: .NET runtime'ın ARM64 için seçtiği değer; x64'te iki line'lık çift
[StructLayout(LayoutKind.Explicit, Size = 128)]
public struct PaddedCounter
{
    [FieldOffset(0)] public long Value;
}

// Yalnız 64 byte: x64 cache line'ı kadar
[StructLayout(LayoutKind.Explicit, Size = 64)]
public struct PaddedCounter64
{
    [FieldOffset(0)] public long Value;
}

public static long CountPadded(int workers, int ordersPerWorker)
{
    PaddedCounter[] processed = new PaddedCounter[workers];
    Parallel.For(0, workers, w =>
    {
        for (int i = 0; i < ordersPerWorker; i++)
        {
            processed[w].Value++;
        }
    });
    long total = 0;
    foreach (PaddedCounter counter in processed)
    {
        total += counter.Value;
    }
    return total;
}
Struct layout'un ayrıntılarını serinin dördüncü yazısında gördük; burada önemli olan iki komşu sayacın arasındaki mesafe. Bunu tahmin etmek yerine testle sabitledim:
[Fact]
public void Padded_counters_are_a_cache_line_apart()
{
    Assert.Equal(128, Unsafe.SizeOf<PaddedCounter>());
    Assert.Equal(64, Unsafe.SizeOf<PaddedCounter64>());

    PaddedCounter[] counters = new PaddedCounter[2];
    nint distance = Unsafe.ByteOffset(ref counters[0].Value, ref counters[1].Value);
    Assert.Equal(128, (int)distance);
}
x64 tarafında Intel ve AMD işlemcilerde cache line 64 byte; 64 byte'lık padding komşuları ayrı line'lara koymaya yeter. Ama Intel'in optimizasyon referans kılavuzu L2'de çalışan bir spatial prefetcher'dan bahseder: L2'ye bir line getirildiğinde onu 128 byte'a hizalı bloğu tamamlayan eşiyle birlikte getirmeye çalışır. Yani 64 byte arayla duran iki sıcak sayaç, aynı 128 byte'lık bloktaysa prefetch trafiği yüzünden yine birbirini rahatsız edebilir. Bazı library'lerin x64'te de 128 byte padding kullanmasının sebebi bu. .NET'in kendi tercihi daha sade: dotnet/runtime'daki PaddingHelpers.CACHE_LINE_SIZE sabiti ARM64 ve LoongArch64'te 128, x64 dahil diğer mimarilerde 64. ConcurrentQueue<T>'nun segment'indeki PaddedHeadAndTail struct'ı, producer'ların yazdığı Tail ile consumer'ların yazdığı Head'i bu sabit kadar ayırır ve ilk field'ın önüne de padding koyar.
Peki sysctl'ın 128 dediği M5'te 64 yetmez mi? Benchmark'ta Padded64 ile Padded128 arasında anlamlı fark yok (71,9 ms'ye 69,2 ms). Emin olmak için iki thread'i, 256 byte'a hizalı native bellekte aralarında belli bir mesafe olan iki sayaca yazdıran küçük bir deneme yazdım:
using System.Diagnostics;
using System.Runtime.InteropServices;

unsafe
{
    // 256 byte'a hizalı native bellek: iki sayacın hangi line'a düştüğünü biz belirleriz
    long* buffer = (long*)NativeMemory.AlignedAlloc(1024, 256);

    long Run(int distanceBytes, int iterations)
    {
        long* first = buffer;
        long* second = buffer + distanceBytes / sizeof(long);
        *first = 0;
        *second = 0;
        Thread a = new(() =>
        {
            for (int i = 0; i < iterations; i++)
                Volatile.Write(ref *first, Volatile.Read(ref *first) + 1);
        });
        Thread b = new(() =>
        {
            for (int i = 0; i < iterations; i++)
                Volatile.Write(ref *second, Volatile.Read(ref *second) + 1);
        });
        Stopwatch sw = Stopwatch.StartNew();
        a.Start();
        b.Start();
        a.Join();
        b.Join();
        return sw.ElapsedMilliseconds;
    }

    for (int round = 0; round < 3; round++)
    {
        foreach (int d in new[] { 8, 32, 56, 64, 96, 120, 128, 256 })
        {
            Console.Write($"{d}B={Run(d, 100_000_000)}ms ");
        }
        Console.WriteLine();
    }
}
8B=462ms 32B=469ms 56B=444ms 64B=202ms 96B=276ms 120B=212ms 128B=179ms 256B=174ms
8B=467ms 32B=470ms 56B=466ms 64B=168ms 96B=171ms 120B=171ms 128B=174ms 256B=173ms
8B=457ms 32B=463ms 56B=466ms 64B=168ms 96B=168ms 120B=168ms 128B=168ms 256B=169ms Sınır net biçimde 64 byte'ta: 56 byte'a kadar iki thread aynı işi 2,8 kat yavaş yapıyor, 64 ve üstünde fark kayboluyor (ilk turdaki dalgalanma ısınma ve makine yükü). Yani bu çipte işletim sisteminin bildirdiği line boyutu ile coherence'ın fiilen işlediği birim aynı çıkmadı. Apple bunu dokümante etmiyor; ders şu: padding değerini bir tablodan ya da tek bir sistem çağrısından alıp geçme, hedef donanımda ölç. Windows x64'te güvenli seçim .NET'in seçtiği 64, prefetcher etkisinden şüpheleniyorsan 128.
Çekirdek Sayısı Neden Performansı Doğrusal Artırmaz?
False sharing'i ve paylaşılan sayacı çıkardık. Geriye en temiz sürüm kaldı: local sayaç, sıfır paylaşım. Bu sürümde toplam iş 400 milyon artırma olarak sabit ve yalnız worker sayısı değişiyor:
public class ScalingBenchmarks
{
    private const int TotalOrders = 400_000_000;

    [Params(1, 2, 4, 8, 10)]
    public int Workers { get; set; }

    // Toplam iş sabit, worker sayısı değişiyor
    [Benchmark]
    public long Local() => OrderCounters.CountLocal(Workers, TotalOrders / Workers);
}
| Method | Workers | Mean | Error | StdDev |
|------- |-------- |----------:|---------:|---------:|
| Local | 1 | 103.60 ms | 3.859 ms | 3.223 ms |
| Local | 2 | 51.72 ms | 1.220 ms | 1.141 ms |
| Local | 4 | 27.98 ms | 2.632 ms | 2.462 ms |
| Local | 8 | 22.03 ms | 2.460 ms | 2.301 ms |
| Local | 10 | 18.47 ms | 4.419 ms | 4.133 ms |1'den 2'ye tam 2 kat, 4'e 3,7 kat hızlanıyoruz. Sonra artış yavaşlıyor: 8 worker yalnız 4,7 kat, 10 worker 5,6 kat. Bu makinede sebeplerin ilki belli: dört hızlı core var, beşinci worker'dan itibaren işi daha yavaş E-core'lar alıyor ve Parallel.For en yavaş worker bitene kadar bekliyor. İkincisi makinedeki diğer yük; hızlı core'ları başka process'ler de istiyor.
Genel listeye, bu makinede ölçemediğim x64 kalemlerini de ekle. Hyper-Threading'li bir makinede ProcessorCount logical processor'ları sayar; aynı core'u paylaşan iki hesaplama yoğun thread execution unit'ler için yarışır ve 2 kat kazanç vermez. Çok core aktifken birçok işlemci saat hızını düşürür, tek core'a verdiği turbo frekansı tüm core'lara veremez. L3 cache ve bellek bant genişliği paylaşılır; bellek yoğun bir iş core'lardan önce bant genişliğine takılır. Son olarak her paralel kodun seri bir kısmı vardır (iş dağıtma, thread'leri uyandırma, sonuçları toplama); bu kısmın tavanı Amdahl yasasıyla hesaplanır ve Concurrency Teorisi serisinin "Concurrency ve Parallelism: Interleaving, Nondeterminism ve Amdahl Yasası" yazısında anlatılıyor. Parallel.For'un kendisi ve ne zaman kullanılacağı ise C# Asenkron Programlama serisinin "C# Paralellik" yazısında.
Üretimde Dikkat
False sharing gerçek kodda bu kadar çıplak durmaz. Tipik yerleri: thread başına istatistik tutan array'ler (istek sayacı, hata sayacı, byte sayacı), farklı thread'lerin yazdığı iki sıcak field'ı yan yana taşıyan bir class (bir producer'ın _tail'i ile consumer'ın _head'i), ya da bir thread'in sürekli yazdığı field ile diğer thread'lerin sürekli okuduğu bir field'ın aynı object'te olması. Okuyan taraf da line'ı ister; yalnız yazan taraf suçlu değildir. Önce local biriktirip seyrek yazmayı dene, sonra hazır çözümleri (ConcurrentQueue gibi zaten padding yapan BCL (.NET'in standart class library'si) tipleri), en son elle padding'i.
Container'da CPU limitini bilinçli ver: limit ProcessorCount'u, o da thread pool'u ve Server GC'yi değiştirir. DOTNET_PROCESSOR_COUNT'u yalnız neden gerektiğini ölçtüğünde kullan. Worker sayısını sabit 16 gibi bir değere bağlama; ProcessorCount'tan türet ve üstüne çıkma, fazlası işletim sisteminin thread'leri sırayla çalıştırmasına (context switch) dönüşür. Scheduling'in nasıl işlediği İşletim Sistemi Temelleri serisinde.
Ölçümü hedef donanımda yap. Hybrid çekirdekli bir dizüstü, Hyper-Threading açık 32 logical processor'lı bir sunucu ve 2 vCPU limitli bir pod aynı kod için üç farklı eğri çizer. Üretimde false sharing şüphesini doğrulamak için CPU profili ve donanım sayaçları gerekir; bunlar .NET'te Profiling ve Diagnostics serisinin konusu.
Sık Düşülen Tuzaklar
- Paralel versiyonun tek thread'den yavaş çıkması: tek paylaşılan sayaç ya da sık alınan lock, bütün core'ları aynı line'da sıraya sokar. Ölçümde bu 15 kat yavaşlık demekti.
- Her sayacı 128 byte'a şişirmek: binlerce sayaçta bellek ve cache israfı olur; padding'i yalnız gerçekten farklı thread'lerin sık yazdığı birkaç field'a uygula.
- Array'in başını unutmak: .NET'te array'in uzunluk bilgisi ilk element'in hemen önündedir; ilk slot'u padding'siz bırakırsan,
Length'i okuyan thread'ler ile ilk slot'a yazan thread aynı line'ı paylaşabilir.PaddedHeadAndTail'in ilk field'ın önüne de boşluk koyması bu yüzden. ProcessorCount'u fiziksel core sayısı sanmak: Hyper-Threading'li makinede iki katı, container'da limitin yuvarlanmışı,DOTNET_PROCESSOR_COUNTvarsa ne yazıldıysa odur.- Dizüstünde ölçüp sunucuya genellemek: core türleri, turbo davranışı, SMT ve NUMA farklıdır; buradaki 2,8 kat false sharing cezası başka bir çipte farklı çıkar.
Küçük Bir Deneme
★☆☆ CounterBenchmarks'ta Workers'ı 2 ve 8 yap. Adjacent ile Padded128 arasındaki oran nasıl değişiyor? 8 worker'da sekiz long hâlâ tek bir 64 byte'lık line'a sığıyor mu?
★★☆ Kendi Windows makinende cpuinfo'yu çalıştır, sonra PowerShell'de Get-CimInstance Win32_Processor | Select-Object NumberOfCores, NumberOfLogicalProcessors ile karşılaştır. Hyper-Threading açıksa ProcessorCount hangisine eşit? ScalingBenchmarks'ı fiziksel core sayısının iki katına kadar çalıştırıp hızlanmanın nerede yavaşladığına bak.
★★★ Mesafe denemesini x64 bir makinede 8'den 256 byte'a kadar çalıştır. Sınır 64'te mi? 64 ile 128 arasında, spatial prefetcher'dan beklenebilecek küçük bir fark görüyor musun? Aynı denemeyi iki thread'i aynı fiziksel core'un iki logical processor'ına sabitleyerek tekrarla: false sharing cezası küçülüyor mu, neden?
Bu yazıda paralelliği core'lar arasında aradık ve donanımın paylaşılan kaynaklarına çarptık. Serinin son yazısı SIMD (Single Instruction, Multiple Data; tek instruction ile birden çok değer üzerinde işlem) konusunu açıyor. "SIMD ve Vectorization: Vector128, Vector256, Vector512 ve TensorPrimitives ile Aynı Anda Çok Veri" yazısında paralelliği tek bir core'un içinde arayacağız: tek instruction ile 4, 8 ya da 16 değeri birden toplamak.