

SIMD ve Vectorization: Vector128, Vector256, Vector512 ve TensorPrimitives ile Aynı Anda Çok Veri
SIMD, tek bir instruction ile geniş bir register'daki 4, 8 ya da 16 değeri aynı anda işlemektir; .NET'te bunu BCL, TensorPrimitives, Vector<T> ve Vector128/256/512 katmanlarıyla kullanırsın. Bir milyon int toplamda tek accumulator'lı vector döngüsü 2 kat, dört accumulator'lı olan 6,5 kat hızlı; x64 assembly'de vpaddd ymm/zmm, IsHardwareAccelerated'ın JIT sabiti olması ve double toplamın donanıma göre değişmesi.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ve System.Numerics.Tensors 10.0.15 ile derlenip denenmiştir; testler xUnit v3 4.0.3, ölçümler BenchmarkDotNet 0.15.8 ile Apple M5 (ARM64, macOS 27, .NET 10.0.13) üzerinde alınmıştır. .NET 11 bölümündeki örnek .NET 11 GA (SDK 11.0.100) ile çalıştırılmıştır. x64 assembly listeleri .NET 10.0.15 JIT'inden (Linux x64 container) ve Windows x64 hedefli crossgen2 10.0.13 derlemesinden alınmıştır.
Önce Tahmin Et
Bookstore'un raporlama servisi gün sonunda bir milyon sipariş satırının adetlerini topluyor: bir int[], her element 1 ile 5 arasında. Üç aday var: düz bir foreach döngüsü, LINQ (C#'ın collection'lar üzerindeki sorgu method'ları) Sum() ve System.Numerics.Tensors paketindeki TensorPrimitives.Sum. Üçü de O(n), üçü de her element'e bir kez dokunuyor. Hangisi en hızlı, aradaki fark kaç kat?
İkinci soru: aynı raporun ciro kısmı bir milyon double tutarı topluyor. Düz döngü ile TensorPrimitives.Sum aynı array'den iki farklı sonuç döndürüyor. Hangisi yanlış?
Serinin önceki yazılarında CPU'nun instruction'ları nasıl çalıştırdığını, bellekten veriyi nasıl getirdiğini ve çekirdekler arasında nasıl paylaştığını gördük. Bu yazı paralelliğin en alttaki katmanına iniyor: tek bir çekirdeğin, tek bir instruction ile aynı anda birden çok veriyi işlemesi.
SIMD: Tek Instruction, Birden Çok Lane
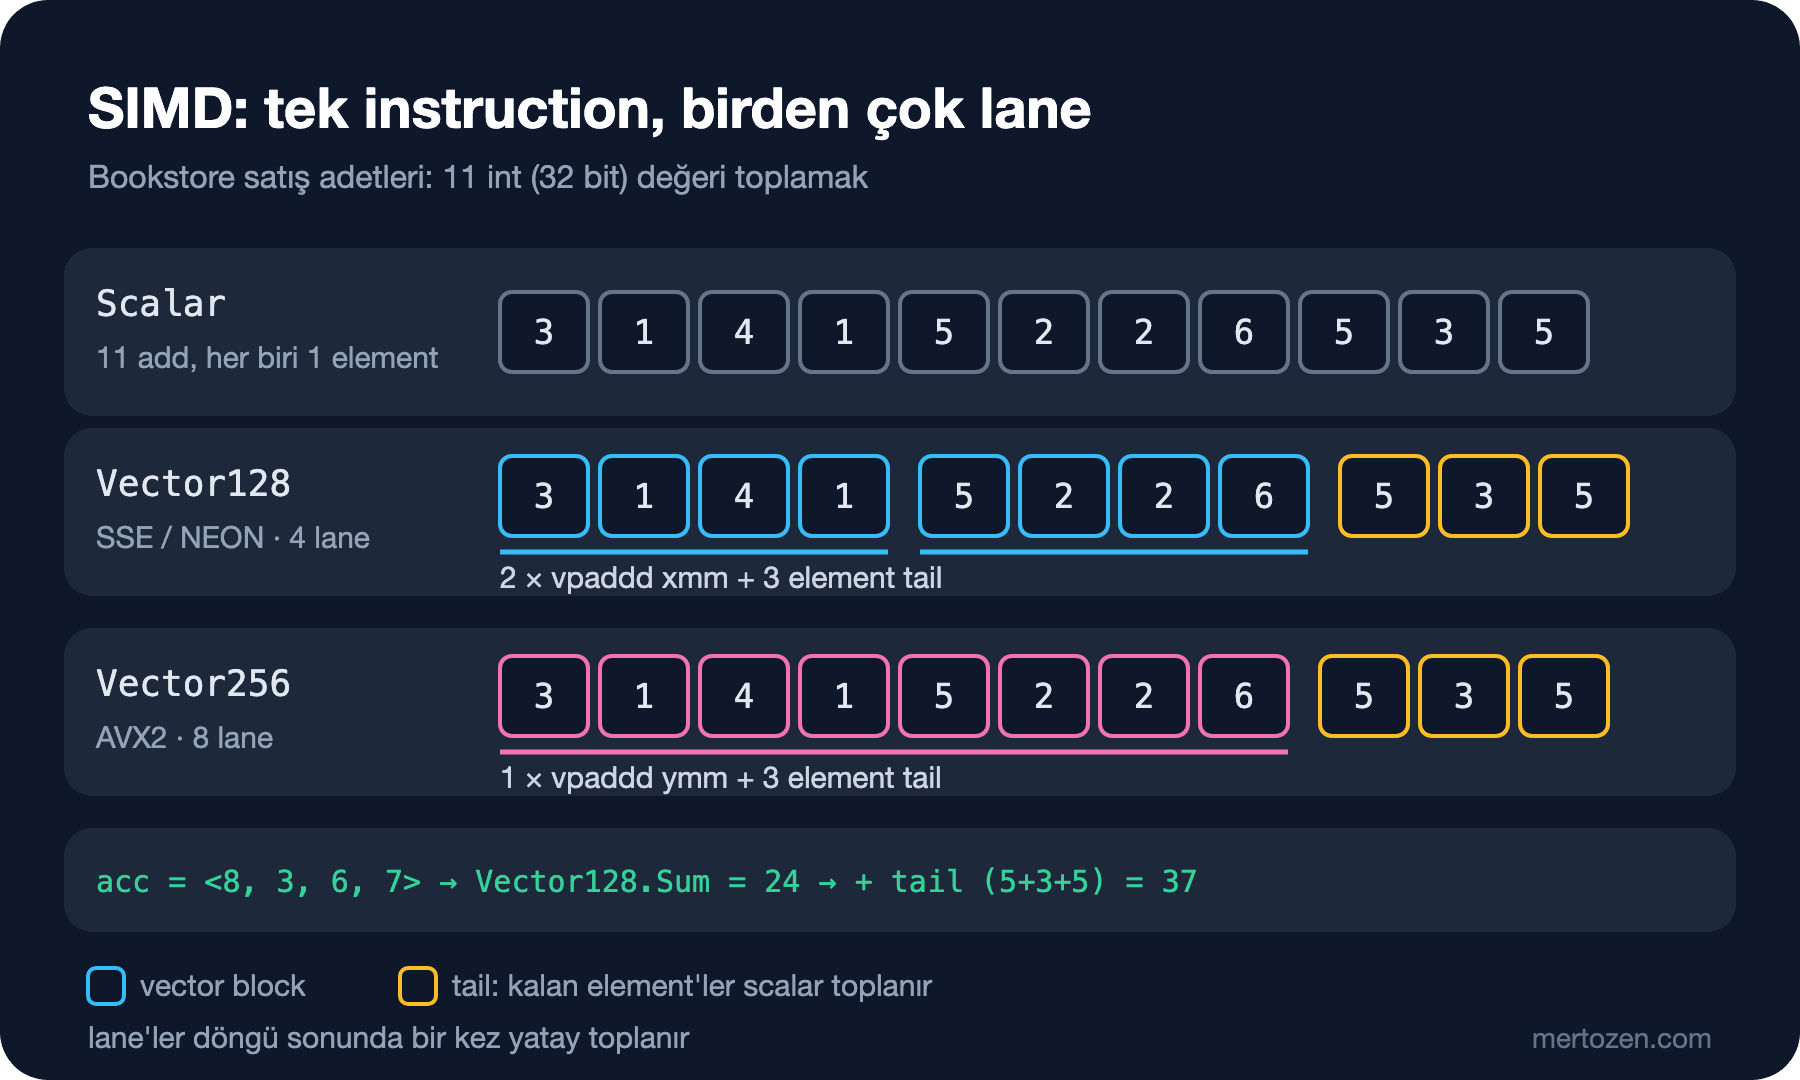
SIMD (Single Instruction, Multiple Data; tek instruction ile çok veri), tek bir instruction'ın geniş bir register'daki birden çok değer üzerinde aynı işlemi yapmasıdır. 128 bit'lik bir vector register dört int taşır; bu dört yuvanın her birine lane denir. Scalar bir add bir sayıyı bir sayıya eklerken, vector bir add dört (ya da sekiz, on altı) çifti tek seferde toplar.
Register genişliği ISA'ya (Instruction Set Architecture; işlemcinin tanıdığı instruction kümesi) göre değişir. x64'te SSE (Streaming SIMD Extensions; x64'ün ilk yaygın SIMD uzantısı) 128 bit'lik xmm register'larını kullanır. AVX (Advanced Vector Extensions; x64'ün geniş vector uzantı ailesi) ailesinde AVX2 (integer işlemleri de 256 bit'e taşıyan sürüm) 256 bit'lik ymm, AVX-512 ise 512 bit'lik zmm register'larını kullanır. ARM64'te NEON (Arm'ın 128 bit'lik Advanced SIMD uzantısı) standarttır; SVE (Scalable Vector Extension; genişliği donanıma bırakan vector uzantısı) ayrı bir modeldir. Windows x64 makinelerde AVX2 yaygın; AVX-512 ise AMD'nin (x64 işlemci üreticisi) Zen 4 ve sonrası çekirdeklerinde ve sunucu Xeon'larında var, Intel'in hibrit istemci işlemcilerinde (12. nesil Alder Lake'ten itibaren) kapalı.
Kendi makinende neyin hızlandırıldığını .NET'e sormak birkaç satır:
using System.Numerics;
using System.Runtime.Intrinsics;
using Bookstore.Simd;

Console.WriteLine($"Architecture             : {System.Runtime.InteropServices.RuntimeInformation.ProcessArchitecture}");
Console.WriteLine($"Vector.IsHardwareAccel.  : {Vector.IsHardwareAccelerated}, Vector<int>.Count = {Vector<int>.Count}");
Console.WriteLine($"Vector128.IsHardwareAccel: {Vector128.IsHardwareAccelerated}");
Console.WriteLine($"Vector256.IsHardwareAccel: {Vector256.IsHardwareAccelerated}");
Console.WriteLine($"Vector512.IsHardwareAccel: {Vector512.IsHardwareAccelerated}");
if (args.Contains("--x86"))
{
    Console.WriteLine($"Avx2.IsSupported         : {System.Runtime.Intrinsics.X86.Avx2.IsSupported}");
    Console.WriteLine($"Avx512F.IsSupported      : {System.Runtime.Intrinsics.X86.Avx512F.IsSupported}");
}
else
{
    Console.WriteLine($"AdvSimd.IsSupported      : {System.Runtime.Intrinsics.Arm.AdvSimd.IsSupported}");
}
Bu yazının ölçümlerini aldığım tek gerçek donanım sürüm notundaki Apple M5 makine; okurların çoğunun kullandığı x64 tarafı için AVX2'si olan ama AVX-512'si olmayan bir Linux x64 ortamından yalnız feature bilgisini ve JIT'in (kodu çalışma anında makine koduna çeviren derleyici) ürettiği kodu alıyorum, süre ölçmüyorum. İki çıktı:
Architecture             : Arm64
Vector.IsHardwareAccel.  : True, Vector<int>.Count = 4
Vector128.IsHardwareAccel: True
Vector256.IsHardwareAccel: False
Vector512.IsHardwareAccel: False
AdvSimd.IsSupported      : True

Architecture             : X64
Vector.IsHardwareAccel.  : True, Vector<int>.Count = 8
Vector128.IsHardwareAccel: True
Vector256.IsHardwareAccel: True
Vector512.IsHardwareAccel: False
Avx2.IsSupported         : True
Avx512F.IsSupported      : False
Vector<int> ARM64'te 4, AVX2'li x64'te 8 lane: aynı C# kodu çalıştığı makineye göre farklı genişlikte makine koduna dönüşüyor. Serinin ilk yazısında aynı IL'in (Intermediate Language; C# derleyicisinin ürettiği ara kod) iki ISA'da farklı instruction'lara dönüştüğünü görmüştük; SIMD'de fark lane sayısına kadar iniyor.
.NET'in SIMD Katmanları ve JIT'in Yapmadığı Şey
.NET SIMD'i tek bir API olarak değil, üst üste katmanlar olarak sunar. Microsoft Learn'deki SIMD sayfası da onları böyle sıralıyor:
| Katman | Örnek | Ne zaman |
|---|---|---|
| Vektörize BCL (.NET'in temel class library'si) method'ları | Span<T>.IndexOf, SequenceEqual, LINQ Sum | Her zaman önce bunlar; vektörizasyon içeride hazır |
| TensorPrimitives | TensorPrimitives.Sum, Add, Dot | Span üzerinde sayısal işlem |
| Değişken genişlik | Vector<T> | Genişliği umursamayan taşınabilir döngü |
| Sabit genişlik | Vector128<T>, Vector256<T>, Vector512<T> | Yeni bir algoritmayı elle vektörize ederken |
| Platform intrinsic'leri | Avx2.Add, AdvSimd.Add | Üst katmanların vermediği tek bir instruction lazımsa |
BCL satırının altını çizmek gerekiyor, çünkü tablonun en önemli satırı o. Kendi yazdığın döngüye ne olduğuna bak. Düz foreach toplamı:
[MethodImpl(MethodImplOptions.NoInlining)]
public static int SumScalar(ReadOnlySpan<int> quantities)
{
    int total = 0;
    foreach (int q in quantities)
    {
        total += q;
    }
    return total;
}
Bunun x64'te tier-1 (tam optimize) JIT çıktısının döngü kısmı:
G_M000_IG04:                ;; offset=0x000C
       add      eax, dword ptr [rdi+rcx]
       add      rcx, 4
       dec      esi
       jne      SHORT G_M000_IG04
Temiz, bounds check'siz, dört instruction'lık bir döngü; ama her turda tek bir int ekleniyor. JIT bu döngüyü vektörize etmedi. Kodu sen SIMD'e çevirmezsen ya da SIMD kullanan bir BCL method'unu çağırmazsan, AVX2'li bir makinede bile 256 bit'lik register'ların 224 bit'i bu döngüde boş durur. (JIT'in hangi optimizasyonları neden yaptığı Compiler'lar ve Programlama Dilleri serisinin konusu.)
Elle Vektörize Etmek: Vector<T> ve Vector128
Vector<T>: genişliği runtime seçsin
[MethodImpl(MethodImplOptions.NoInlining)]
public static int SumVectorT(ReadOnlySpan<int> quantities)
{
    int i = 0;
    int total = 0;
    if (Vector.IsHardwareAccelerated && quantities.Length >= Vector<int>.Count)
    {
        Vector<int> acc = Vector<int>.Zero;
        int lastBlock = quantities.Length - Vector<int>.Count;
        for (; i <= lastBlock; i += Vector<int>.Count)
        {
            acc += new Vector<int>(quantities.Slice(i));
        }
        total = Vector.Sum(acc);
    }
    for (; i < quantities.Length; i++)
    {
        total += quantities[i];
    }
    return total;
}
Fikir figürdeki ile aynı: bir accumulator vector'ü tut, her turda Vector<int>.Count element'i tek seferde ekle, döngü bitince lane'leri Vector.Sum ile yatay topla, kalan element'leri (tail) scalar döngüyle bitir. Vector<int>.Count JIT için bir sabittir; x64'teki tier-1 çıktısında 8 olarak gömülü:
G_M000_IG03:                ;; offset=0x001C
       cmp      ebx, esi
       ja       SHORT G_M000_IG06
       mov      ecx, ebx
       lea      rcx, bword ptr [rdi+4*rcx]
       mov      edx, esi
       sub      edx, ebx
       cmp      edx, 8
       jl       SHORT G_M000_IG07
       vpaddd   ymm0, ymm0, ymmword ptr [rcx]
       add      ebx, 8
       cmp      ebx, eax
       jle      SHORT G_M000_IG03
vpaddd ymm0, ymm0, ymmword ptr [rcx] asıl iş: 32 byte'ı (sekiz int) tek instruction'da accumulator'a ekliyor. Etrafındaki cmp ebx, esi / ja Slice(i)'nin, cmp edx, 8 / jl ise Vector<int> constructor'ının uzunluk kontrolü. Döngü sınırı bunları zaten garanti ediyor ama JIT ispatlayamadığı için her turda iki kontrol kalıyor.
Vector128 ve LoadUnsafe: BCL'nin kullandığı şekil
[MethodImpl(MethodImplOptions.NoInlining)]
public static int SumVector128(ReadOnlySpan<int> quantities)
{
    int i = 0;
    int total = 0;
    if (Vector128.IsHardwareAccelerated && quantities.Length >= Vector128<int>.Count)
    {
        ref int start = ref MemoryMarshal.GetReference(quantities);
        Vector128<int> acc = Vector128<int>.Zero;
        int lastBlock = quantities.Length - Vector128<int>.Count;
        for (; i <= lastBlock; i += Vector128<int>.Count)
        {
            acc += Vector128.LoadUnsafe(ref start, (nuint)i);
        }
        total = Vector128.Sum(acc);
    }
    for (; i < quantities.Length; i++)
    {
        total += quantities[i];
    }
    return total;
}
LoadUnsafe bounds check yapmaz; döngü sınırının doğru olduğunu sen garanti edersin. Karşılığında döngü yalnızca işi yapan instruction'lara iniyor:
G_M000_IG03:                ;; offset=0x0020
       movsxd   rdx, ecx
       vpaddd   xmm0, xmm0, xmmword ptr [rdi+4*rdx]
       add      ecx, 4
       cmp      ecx, eax
       jle      SHORT G_M000_IG03

G_M000_IG04:                ;; offset=0x002F
       vpsrldq  xmm1, xmm0, 8
       vpaddd   xmm0, xmm1, xmm0
       vpsrldq  xmm1, xmm0, 4
       vpaddd   xmm0, xmm1, xmm0
       vmovd    eax, xmm0
İkinci blok Vector128.Sum: register'ı 8 ve 4 byte kaydırıp kendisiyle toplayarak dört lane'i tek sayıya indiriyor, döngü dışında bir kez. "Unsafe"in bedeli şu: lastBlock hesabı yanlışsa exception almazsın, array'in dışını okursun. Bu yüzden xUnit testleri 0'dan 70'e kadar her uzunluğu ve 1.000.003 element'lik bir array'i, tüm implementasyonları scalar sonuçla karşılaştırarak deniyor. MemoryMarshal.GetReference ve ref kuralları C# İleri Seviye serisinin "C#'ta Span<T> ve Memory<T>: Allocation'sız Parse, stackalloc ve ref struct Kuralları" yazısında.
Vector256 ve Vector512: IsHardwareAccelerated Bir JIT Sabitidir
SumVector512 aynı method'un Vector512'li kopyası. Okurların makinelerinde ne üreteceğini görmek için onu crossgen2 ile Windows x64 hedefine ReadyToRun (R2R; uygulamayı önceden makine koduna derleme) olarak iki kez derledim: x86-64-v3 (AVX2 seviyesi) ve x86-64-v4 (AVX-512 seviyesi). Listeler aynı optimizer'ın FullOpts çıktısı; R2R yalnız daha temkinli inline ediyor (MemoryMarshal.GetReference çağrı olarak kalmış). x86-64-v3 hedefinde method'un tamamı:
G_M000_IG02:                ;; offset=0x0000
       mov      rax, bword ptr [rcx]
       mov      ecx, dword ptr [rcx+0x08]
       xor      edx, edx
       test     ecx, ecx
       jle      SHORT G_M000_IG05

G_M000_IG03:                ;; offset=0x000C
       xor      r8d, r8d

G_M000_IG04:                ;; offset=0x000F
       add      edx, dword ptr [rax+r8]
       add      r8, 4
       dec      ecx
       jne      SHORT G_M000_IG04
Vector kodu tamamen yok; geriye scalar tail döngüsü kalmış. AVX2 makinede Vector512.IsHardwareAccelerated derleme anında false sabitidir, JIT de if bloğunu dead code olarak siliyor. Kontrolün çalışma anında bir maliyeti yok; Microsoft'un dokümanı da bu yüzden değeri cache'lemeden doğrudan okumanı öneriyor. Aynı method x86-64-v4 hedefinde:
G_M000_IG04:                ;; offset=0x0041
       movsxd   rdx, edi
       vpaddd   zmm0, zmm0, zmmword ptr [rax+4*rdx]
       add      edi, 16
       cmp      edi, ecx
       jle      SHORT G_M000_IG04

G_M000_IG05:                ;; offset=0x0052
       vmovaps  zmm1, zmm0
       vextracti32x8 ymm0, zmm0, 1
       vpaddd   ymm0, ymm0, ymm1
Döngü artık her turda 64 byte, on altı int topluyor. Windows'ta parametre rcx'te geliyor (Microsoft x64 calling convention); Linux listelerindeki rdi farkı bundan.
İki ayrıntı x64 okurunu doğrudan ilgilendiriyor. Birincisi, Vector<T> AVX-512'li makinede de varsayılan olarak 256 bit kalabiliyor; dokümana göre DOTNET_MaxVectorTBitWidth=512 ile genişletilir. 512 bit'ten fayda bekliyorsan Vector512<T>'yi açıkça kullanırsın. İkincisi, DOTNET_PreferredVectorBitWidth tersini yapar: değeri düşürünce geniş tiplerin IsHardwareAccelerated'ı false döner. AVX-512'li bir makinede 256 ve 512 bit yollarını aynı benchmark'ta karşılaştırmanın kolay yolu bu. Bu ayarlar yalnız JIT'in derlediği kodu etkiler, R2R ile önceden derlenmiş koda dokunmaz.
Tablonun en altındaki platform intrinsic'leri (Avx2.Add gibi) tek bir instruction'a karşılık gelir; çağırmadan önce Avx2.IsSupported kontrolü zorunludur, yoksa PlatformNotSupportedException alırsın.
Ölçüm: Döngü, LINQ, Vector ve TensorPrimitives
Tahmin sorusunun cevabı. Sürüm notundaki gibi ölçümler Apple M5 üzerinde; burada vector genişliği 128 bit, yani AVX2'li bir x64 makinenin yarısı:
| Method      | N       | Mean         | StdDev      | Ratio |
|------------ |-------- |-------------:|------------:|------:|
| Scalar      | 4096    |   1,193.0 ns |   169.28 ns |  1.02 |
| Linq        | 4096    |     562.4 ns |    61.23 ns |  0.48 |
| VectorT     | 4096    |     576.4 ns |    47.75 ns |  0.49 |
| Vector128   | 4096    |     481.3 ns |    21.55 ns |  0.41 |
| Vector128x4 | 4096    |     140.2 ns |     2.46 ns |  0.12 |
| Vector256   | 4096    |     231.5 ns |     3.70 ns |  0.20 |
| Tensor      | 4096    |     442.3 ns |     5.38 ns |  0.38 |
|             |         |              |             |       |
| Scalar      | 1000000 | 264,012.2 ns | 4,181.78 ns |  1.00 |
| Linq        | 1000000 | 136,211.2 ns | 5,029.75 ns |  0.52 |
| VectorT     | 1000000 | 128,259.4 ns | 1,599.08 ns |  0.49 |
| Vector128   | 1000000 | 131,554.4 ns | 5,236.24 ns |  0.50 |
| Vector128x4 | 1000000 |  40,617.4 ns | 1,378.11 ns |  0.15 |
| Vector256   | 1000000 |  64,600.0 ns | 1,564.89 ns |  0.24 |
| Tensor      | 1000000 | 124,925.5 ns | 2,161.10 ns |  0.47 |
Kolonları kısalttım (hiçbir satır allocation yapmıyor). Ölçüm sırasında makinede başka işler de çalışıyordu (load average 8–11), o yüzden StdDev sütununu bıraktım; 4096'lık scalar satırındaki geniş sapma bundan.
LINQ Sum düz döngünün yarı süresinde bitiyor: int[] için içeride zaten SIMD kullanıyor, üstelik overflow kontrolüyle. Vector<T>, Vector128 ve TensorPrimitives da aynı yerde, 0,4–0,5 civarında. Dört lane var ama kazanç iki kat. Neden dört değil?
Cevap serinin "CPU Pipeline ve Branch Prediction" yazısındaki instruction-level parallelism'de. Tek accumulator'lı döngüde her acc += … bir önceki toplamanın bitmesini bekliyor; bu bir dependency chain. Ölçüme bakılırsa bu makinede bir vector toplamanın sonucunu beklemek scalar toplamanınkinden uzun sürüyor; lane'lerin getirdiği kazancın yarısı bu beklemeye gidiyor. Çözüm bağımsız accumulator'lar; Microsoft'un SIMD sayfasındaki örnek de döngüyü dört accumulator'la açıyor. SumVector128x4'ün döngüsü:
Vector128<int> acc0 = Vector128<int>.Zero;
Vector128<int> acc1 = Vector128<int>.Zero;
Vector128<int> acc2 = Vector128<int>.Zero;
Vector128<int> acc3 = Vector128<int>.Zero;
int lastBlock = quantities.Length - Vector128<int>.Count * 4;
for (; i <= lastBlock; i += Vector128<int>.Count * 4)
{
    acc0 += Vector128.LoadUnsafe(ref start, (nuint)i);
    acc1 += Vector128.LoadUnsafe(ref start, (nuint)(i + 4));
    acc2 += Vector128.LoadUnsafe(ref start, (nuint)(i + 8));
    acc3 += Vector128.LoadUnsafe(ref start, (nuint)(i + 12));
}
total = Vector128.Sum((acc0 + acc1) + (acc2 + acc3));
Aynı 128 bit'lik register'lar, aynı instruction'lar; tek fark dört zincirin birbirini beklememesi. Sonuç scalar'a göre 0,12–0,15, yani 6,5–8,5 kat. Bu kazancın büyük kısmı lane'lerden değil, pipeline'ı dolu tutmaktan geliyor.
Tablodaki tuhaf satır Vector256. Bu makinede Vector256.IsHardwareAccelerated false ve SumVector256'nın bilerek bir kontrolü yok, yine de tek accumulator'lı Vector128'den iki kat hızlı. ARM64 tier-1 çıktısı sebebi gösteriyor:
G_M000_IG03:                ;; offset=0x0028
            sbfiz   x4, x2, #2, #32
            add     x4, x0, x4
            ldp     q18, q19, [x4]
            add     v16.4s, v16.4s, v18.4s
            add     v17.4s, v17.4s, v19.4s
            add     w2, w2, #8
            cmp     w2, w3
            ble     G_M000_IG03
.NET 10'un JIT'i hızlandırılmayan Vector256'yı iki Vector128 yarısına bölmüş: tek ldp ile 32 byte okuyup iki ayrı register'a (v16, v17) ekliyor. Yani farkında olmadan iki accumulator'lı bir döngü yazmışız. x64'te AVX2'li bir makinede aynı kod gerçekten 256 bit'lik vpaddd ymm kullanır; ama tek accumulator'ın dependency chain'i orada da geçerli, çoklu accumulator tekniği genişlikten bağımsız işe yarar.
TensorPrimitives ve Floating Point'in Sırası
Tablodaki Tensor satırı tek satırlık bir çağrı ve tek accumulator'lı Vector128 döngüsüyle aynı sürede bitiyor; üstelik AVX2'li makinede 256, AVX-512'li makinede 512 bit'lik yolu, tail'i ve uzunluk kontrollerini kendisi hallediyor. Paket Add, Multiply, Dot, CosineSimilarity gibi onlarca span işlemi daha sunuyor; elle döngü yazmadan önce buraya bak.
Şimdi tahmin sorusunun ikinci yarısı. Ciro raporu bir milyon double tutarı (5,00 ile 59,99 arasında) topluyor; aynı tutarların decimal toplamı da karşılaştırma için hesaplanıyor:
decimal (exact) : 32447311.90
scalar double   : 32447311.899999037
TensorPrimitives: 32447311.899999812
difference      : -7.748603820800781E-07
Hangisi yanlış? İkisi de doğru, sadece toplama sırası farklı. Scalar döngü tutarları soldan sağa tek bir toplama ekliyor; vektörize toplam her lane'de ayrı bir ara toplam tutup sonda birleştiriyor. Floating point'te her ara adım yuvarlandığı için parantezlerin yeri sonucu değiştirir; burada vektörize sonuç exact değere daha yakın, ama bu garanti değil. IEEE'nin (floating point standardını yayımlayan mühendislik kuruluşu) 754 standardında toplamanın neden birleşme özelliği taşımadığı Number System'ler ve Data Representation serisinin "Floating Point Nasıl Çalışır: IEEE 754, 0.1 + 0.2, NaN ve double vs decimal" yazısında.
Asıl sürpriz: sıra donanıma bağlı. x64 container'ında (AVX2, 256 bit) TensorPrimitives satırı 32447311.89999982 oluyor; DOTNET_EnableHWIntrinsic=0 ile ise scalar sonucun aynısı, 32447311.899999037. Aynı veri, aynı kod, üç farklı çalışma yolunda üç farklı son basamak. İlk yazdığım Assert.NotEqual(scalar, tensor) testi intrinsic'ler kapalıyken bu yüzden kırıldı; testi toleranslı karşılaştırmaya çevirdim. Para için decimal şart, onun da SIMD karşılığı yok (serinin ilk yazısındaki TotalPrice listesi). Analitik raporda double ve SIMD kabul edilebilir, faturada değil.
Hız tarafında bir milyon double'ın scalar toplamı 583,1 µs, TensorPrimitives.Sum 247,7 µs sürdü (oran 0,42); 128 bit'e yalnız iki double sığdığı için kazanç int'tekinden az.
Peki GPU?
SIMD bir CPU çekirdeğinde 4, 8 ya da 16 lane demek. GPU (Graphics Processing Unit; grafik işlemcisi) aynı fikri binlerce lane'e taşır, ama dallanmaya ve CPU ile GPU arasındaki veri kopyalamaya karşı hassastır. Büyük matris çarpımlarından oluşan model eğitimi GPU'ya çok uygun; birkaç bin elemanlı bir array'i toplamak ise kopyalama maliyetini karşılamaz, CPU'da kalır. Makine öğrenmesi tarafı Makine Öğrenmesine Giriş serisinde.
.NET 11: Lane Construction API'leri ve Donanımda Half
.NET 11'in runtime yenilikleri sayfası (GA sürümüne göre güncel) Vector64/128/256/512 ve Vector<T> için lane'leri tek tek kuran ve yer değiştiren yeni method'lar listeliyor: CreateGeometricSequence, CreateAlternatingSequence, CreateHarmonicSequence, Zip/Unzip ailesi, Concat* ve Reverse. Bir net11.0 projesinde:
using System.Runtime.Intrinsics;

// Her lane bir öncekinin 2 katı
Vector128<int> batchSizes = Vector128.CreateGeometricSequence(1, 2);
Console.WriteLine($"Geometric : {batchSizes}");

// Kitap id'leri ile stok adetlerini (id, stock) çiftleri hâlinde iç içe geçir
Vector128<int> bookIds = Vector128.Create(101, 102, 103, 104);
Vector128<int> stock = Vector128.Create(10, 20, 30, 40);
(Vector128<int> lower, Vector128<int> upper) = Vector128.Zip(bookIds, stock);
Console.WriteLine($"Zip lower : {lower}");
Console.WriteLine($"Zip upper : {upper}");

(Vector128<int> ids, Vector128<int> back) = Vector128.Unzip(lower, upper);
Console.WriteLine($"Unzip     : {ids} {back}");
Geometric : <1, 2, 4, 8>
Zip lower : <101, 10, 102, 20>
Zip upper : <103, 30, 104, 40>
Unzip : <101, 102, 103, 104> <10, 20, 30, 40>Zip iki vector'ü lane lane iç içe geçiriyor, Unzip geri ayırıyor: (id, stok, id, stok…) düzenindeki veriyi alanlarına ayırmanın taşınabilir yolu. .NET 10'da bunun için genellikle Shuffle ya da platforma özel intrinsic gerekiyordu.
Aynı sayfaya göre .NET 11'de JIT, işlemci destekliyorsa Half için donanım FP16 (16 bit'lik floating point sayılar) instruction'larını kullanıyor: x64'te aritmetik AVX10 (AVX'in sürüm numarasıyla ilerleyen yeni ailesi) içindeki 10.1 seviyesiyle, dönüşümler F16C (half-precision dönüşüm uzantısı) ile, ARM64'te isteğe bağlı FP16 uzantısıyla; kodda değişiklik gerekmiyor. .NET 10'un Avx10v2 intrinsic'leri ise varsayılan olarak kapalı, çünkü .NET 10 yayınlandığında AVX10.2'li donanım yoktu.
Üretimde Dikkat
Ölçümü hedef donanımda yap. Bu yazıdaki oranlar 128 bit'lik NEON'dan geliyor; AVX2'li bir Windows makinede register'lar iki kat geniş, ARM64 sunucuda ise 256 bit'lik yollar hızlandırılmaz.
Uygulama açılırken Vector<int>.Count ve Vector256/512.IsHardwareAccelerated değerlerini bir kez log'la. Sanal makineler CPU feature'larını gizleyebilir; aynı fiziksel işlemci VM ayarına göre AVX-512'yi gösterir ya da göstermez.
Veri cache'e sığmadığında darboğaz bellek bant genişliğine kayar. Tablodaki 4 MB'lık veri bu makinenin cache'ine sığıyor; daha büyük veride lane eklemek aynı oranda kazandırmaz (serinin Memory Hierarchy yazısı).
Her vektörize yolun testi olmalı. Test suite'ini bir kez de DOTNET_EnableHWIntrinsic=0 ile, x64'te ayrıca DOTNET_PreferredVectorBitWidth=128 ve 256 ile çalıştır; makinenin seçmediği yollar da denenir. Bu yazının 74 testi intrinsic'ler kapalıyken de geçiyor. .NET 11'de x64 minimum donanımı x86-64-v2'ye çıktığı için daha eski bir CPU'da .NET 11 hiç başlamıyor.
Önce profiler: SIMD yalnız gerçekten sıcak döngüde kazandırır, o döngüyü .NET'te Profiling ve Diagnostics serisindeki araçlarla bul.
Sık Düşülen Tuzaklar
BCL'nin zaten vektörize ettiği işi elle yeniden yazmak. LINQ Sum, Span<T>.IndexOf, SequenceEqual ve TensorPrimitives içeride SIMD kullanıyor; elle yazdığın kod ancak ölçülebilir biçimde hızlıysa kalır.
Overflow davranışının değiştiğini fark etmemek. LINQ Sum taşmayı kontrol eder, SIMD toplamları sessizce sarar:
[Fact]
public void Linq_checks_overflow_but_simd_sums_wrap()
{
    int[] q = [int.MaxValue, 1, 0, 0, 0, 0, 0, 0];
    Assert.Throws<OverflowException>(() => SalesMath.SumLinq(q));
    Assert.Equal(int.MinValue, SalesMath.SumVector128(q));
    Assert.Equal(int.MinValue, SalesMath.SumTensor(q));
}
LINQ'i bir SIMD döngüsüyle değiştirdiğinde OverflowException yerine negatif bir toplam alırsın. Toplam taşabiliyorsa long'a genişlet ya da taşmayı ayrıca kontrol et.
Floating point sonucunu birebir eşitlikle test etmek: vektörize toplam makineden makineye son basamaklarda değişir, test tolerans kullanmalı.
Hizalanmamış veriyi hesaba katmamak. LoadUnsafe herhangi bir adresten okur, ama 16 ya da 32 byte'lık bir okuma iki cache line'ın sınırına denk gelirse iki line'a dokunur. Microsoft'un dokümanı, allocation'ların rastgele hizalanmasının benchmark sonuçlarına gürültü kattığını not ediyor ve kararlı ölçüm için NativeMemory.AlignedAlloc'u gösteriyor. Cache line'ın mekaniği serinin "CPU Cache Nasıl Çalışır" yazısında.
Hızlandırılmayan genişliğe güvenmek. Bu makinede IsHardwareAccelerated kontrolü olmayan Vector256 döngüsü en hızlı çıktı, ama bu bir JIT ayrıntısı, sözleşme değil. Doküman her genişliği ayrı kontrol etmeni söylüyor; geniş yoldan dar yola inen bir if zinciri hem doğru hem taşınabilir olandır.
Küçük girdide vektörize etmek: birkaç element'lik array'de kontrol, reduction ve tail maliyeti kazancı ortadan kaldırır. Gerçek girdi boyutlarınla ölç.
Küçük Bir Deneme
★☆☆ Feature probe'unu kendi Windows makinende çalıştır. Vector<int>.Count kaç? Sonra PowerShell'de $env:DOTNET_PreferredVectorBitWidth="128" ile tekrar çalıştır: hangi satırlar değişiyor, Vector<int>.Count değişiyor mu?
★★☆ SumBenchmarks'a N = 64_000_000 ekle (256 MB). Vector128x4/Scalar oranı 4096'daki orana göre ne oluyor? Sonucu bellek bant genişliğiyle açıkla; kendi makinende Vector256 ile Vector128x4 arasındaki fark kalıyor mu?
★★★ "Toplamı 100'den büyük sipariş satırlarını say" işini Vector128.GreaterThan, ExtractMostSignificantBits ve BitOperations.PopCount ile dallanmasız ve vektörize yaz. Tail'i scalar tamamla, 0–70 arası her uzunluk için scalar sürümle karşılaştıran bir xUnit testi ekle ve serinin "CPU Pipeline ve Branch Prediction" yazısındaki sıralı/karışık veriyle ölç: SIMD sürümünde sıralama fark yaratıyor mu?
Bilgisayar Nasıl Çalışır serisi burada bitiyor. C# satırının instruction'a inişini, pipeline'ı, memory hierarchy'yi, cache line'ı, çekirdekler arası paylaşımı ve son olarak SIMD'i gördük. Sıcak döngüyü bulmak .NET'te Profiling ve Diagnostics serisinde, çekirdeklerin paylaştığı belleğin correctness tarafı Concurrency Teorisi serisinde, JIT'in bu kodu nasıl ürettiği Compiler'lar ve Programlama Dilleri serisinde, vektörize matematiğin büyük ölçekte vardığı yer de Makine Öğrenmesine Giriş serisinde.