

Memory Hierarchy: Register'dan SSD'ye Latency Rakamları ve Locality
Bellek tek parça değildir: register ve L1'den DRAM'e, SSD'ye ve network'e indikçe her katman büyür ve yavaşlar; bir DRAM okuması L1'den yaklaşık 90 kat uzun sürer. 256 MB'lık bir array'i karışık sırayla toplamanın 13,4 kat yavaşlaması, pointer chasing ile kendi makinende latency ölçmek, stack ile heap'in aynı RAM olması ve struct array'in List<Book>'tan 6 kat hızlı taraması.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ile derlenip denenmiştir; ölçümler BenchmarkDotNet 0.15.8 ile Apple M5 (ARM64 mimarili Apple işlemcisi) / macOS 27 / .NET 10.0.13 üzerinde alınmış, testler xUnit v3 4.0.3 ile koşulmuştur.
Önce Tahmin Et
Bookstore'un gece çalışan stok raporu 64 milyon int'lik, yani 256 MB'lık bir array'i topluyor. Aynı array'i iki kez topluyorsun: bir kez index sırasıyla, bir kez de aynı index'lerin karıştırılmış bir sırasıyla. İki döngü de aynı 64 milyon toplamayı yapıyor, ikisi de O(n), ikisi de her element'e tam bir kez dokunuyor. Karışık sıra ne kadar yavaş çıkar: yüzde 10 mu, iki kat mı, on kat mı?
İkinci soru: CPU bir değeri RAM'den okurken beklediği sürede aynı değeri en yakın cache'ten kaç kez okuyabilirdi? Big-O ve Complexity serisinin "Big-O'nun Söylemedikleri: Sabitler, Cache ve BenchmarkDotNet ile Ölçmek" yazısında LinkedList'in array'den 3,8 kat yavaş çıkmasını "cache ve pointer chasing" diye kısaca açıklamıştık. Bu yazı o iki kelimenin arkasındaki donanımı ölçerek açıyor.
Register'dan Network'e: Hiyerarşinin Basamakları
Programın gözünden bellek tek ve düz bir adres alanıdır. Donanımda ise katmanlar var ve her katman bir alttakinden küçük ve hızlı: hızlı bellek pahalıdır ve çipte yer kaplar, büyük bellek ucuzdur ama uzaktadır. Bryant ve O'Hallaron'un Computer Systems: A Programmer's Perspective kitabının (3. baskı) temel fikirlerinden biri bu: her katman, bir alttaki katmanın verisi için cache gibi çalışır.
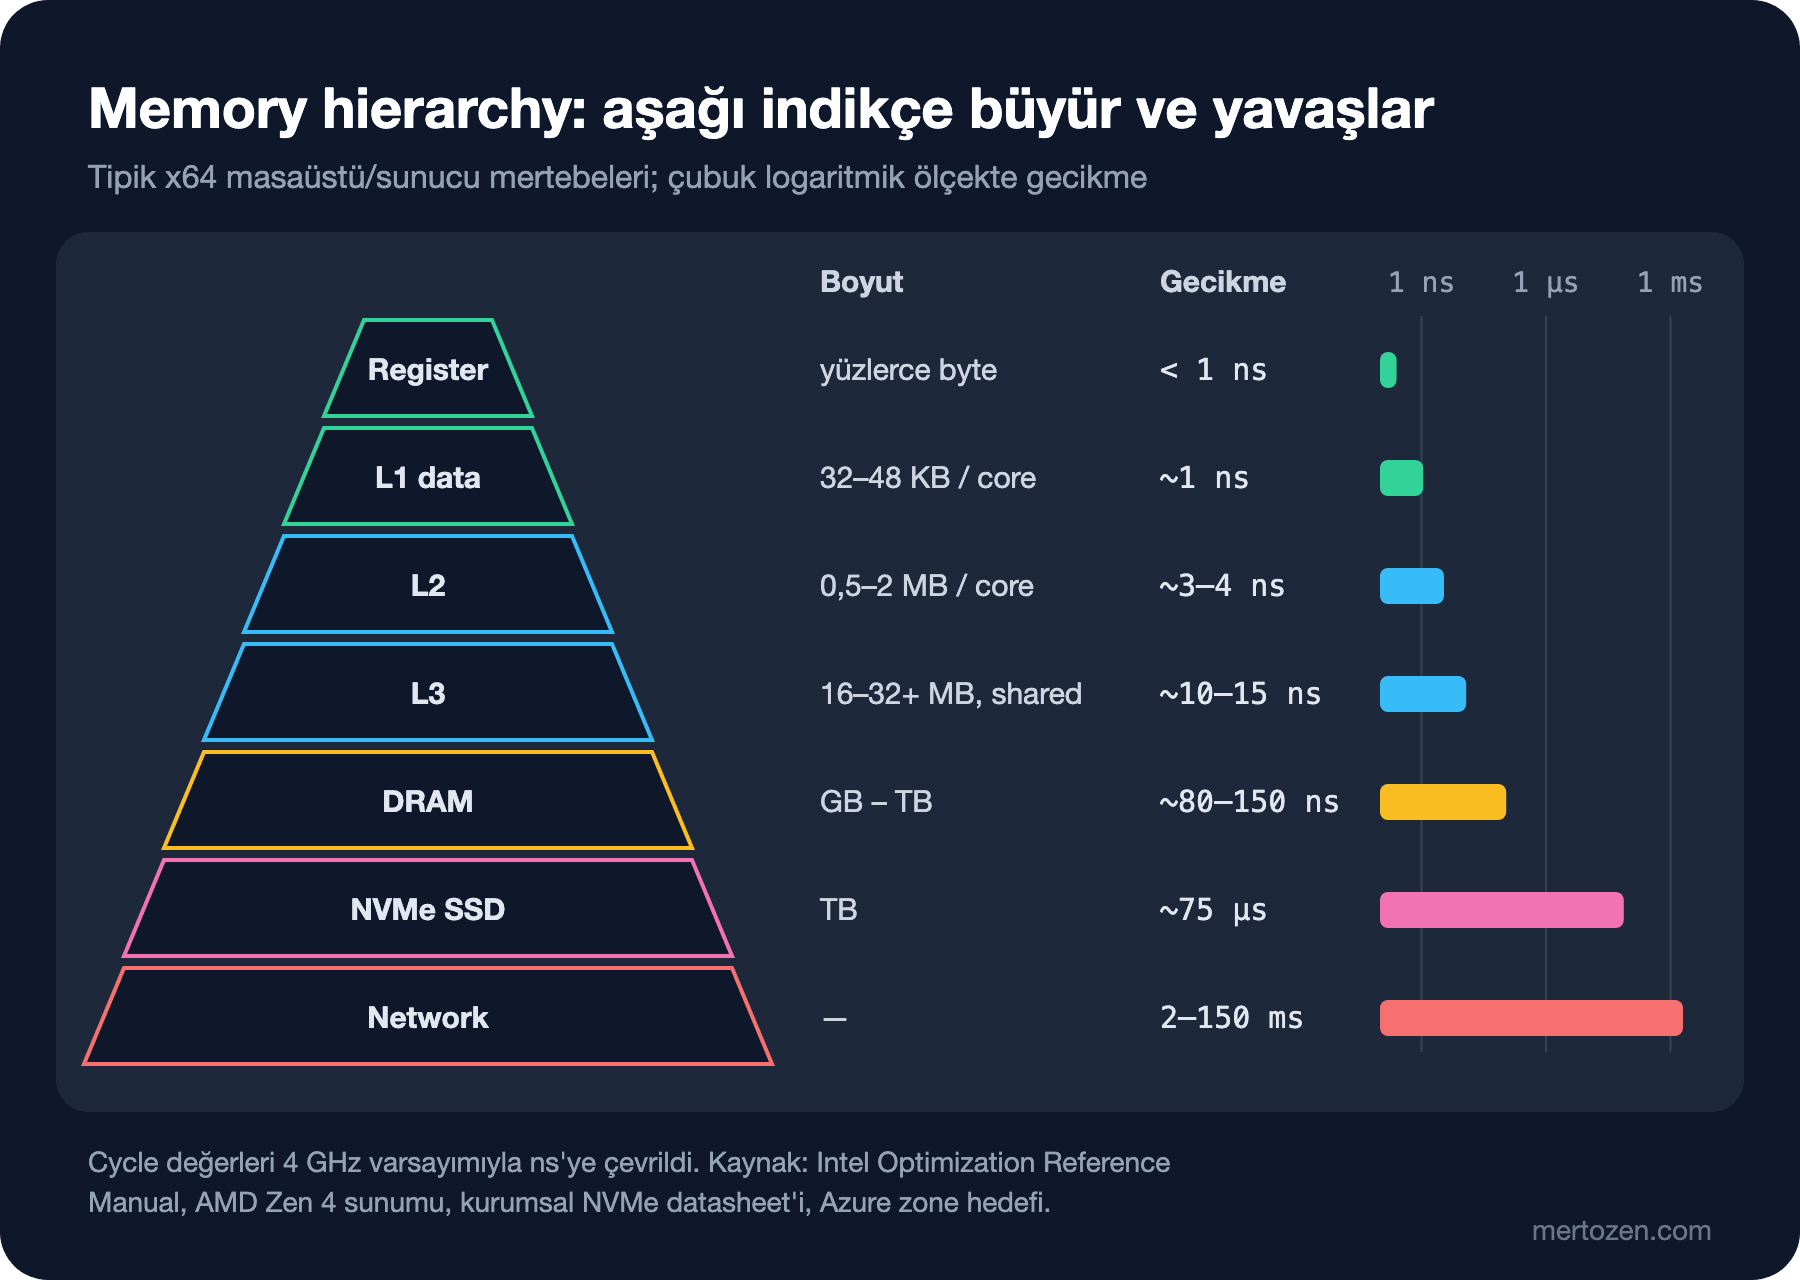
Figürdeki değerler tipik x64 masaüstü ve sunucu işlemcilerinin mertebeleri, kesin rakamlar değil. Intel'in Optimization Reference Manual'ı (Ekim 2026 sürümü) Skylake client çekirdeği için L1 (birinci seviye) data cache'te 32 KB ve en iyi durumda 4 cycle, L2 (ikinci seviye) için 256 KB ve 12 cycle, paylaşılan L3 (üçüncü seviye) için core başına 2 MB'a kadar ve 44 cycle veriyor; daha yeni Golden Cove'da L1 48 KB, L2 client'ta 1,25 MB, sunucuda 2 MB. AMD'nin (işlemci üreticisi Advanced Micro Devices) GDC (her yıl yapılan Game Developers Conference) 2024 sunumu Zen 4 için 32 KB L1 data, 1 MB L2 ve sekiz core'luk grup başına 32 MB L3 listeliyor. 4 GHz'de bir cycle 0,25 ns olduğu için L1 yaklaşık 1 ns, L2 3–4 ns, L3 10–15 ns ediyor.
Cache'ler SRAM (statik RAM; tazelenmesi gerekmeyen hızlı hücre), ana bellek DRAM (dinamik RAM; sürekli tazelenmesi gereken ucuz hücre) ile yapılır. Ulrich Drepper'in What Every Programmer Should Know About Memory (2007) makalesine göre SRAM hücresi altı transistor ister, DRAM hücresi bir transistor ve bir kapasitörden ibarettir. Intel'in manual'ında iki soketli bir Xeon sunucuda ölçülen boş sistem gecikmesi kendi soketinin belleği için 82 ns, diğer soketinki için 153 ns civarı. NVMe (SSD'ler için tasarlanmış depolama protokolü) SSD'lerde Seagate'in Nytro 5550 datasheet'i 4 KB'lık tek bir okuma için ortalama 75 µs yazıyor. Network'te Microsoft, Azure'da aynı region'ın availability zone'ları arasındaki gidiş-dönüşü 2 ms'nin altında tutmayı hedefliyor; kıtalar arası gidiş-dönüş yüz milisaniyeleri bulur.
Ölçümleri elimdeki tek gerçek donanım olan Apple M5 (ARM64) üzerinde aldım; bu çipte L3 yok, performance core'lar 128 KB L1 data cache ve paylaşılan 16 MB L2 kullanıyor (sysctl hw.perflevel0). x64 rakamları yukarıdaki dokümanlardan; aynı ölçümü Windows'ta nasıl alacağın Üretimde Dikkat bölümünde.
Nanosaniyeyi İnsan Ölçeğine Çevirmek
Nanosaniye sezgiye uymayan bir birim. L1'den bir okumayı bir saniye kabul edip diğer katmanları aynı oranla büyütünce tablo şöyle oluyor (oranlar yukarıdaki kaynaklardan, hesap benim):
| Katman | Gerçek gecikme | L1 bir saniye olsaydı |
|---|---|---|
| L1 data cache | ~1 ns | 1 saniye |
| L2 | ~3–4 ns | 3–4 saniye |
| L3 | ~10–15 ns | 10–15 saniye |
| DRAM | ~80–150 ns | 1,5–2,5 dakika |
| NVMe SSD, 4 KB okuma | ~75 µs | yaklaşık 21 saat |
| Aynı region'da zone'lar arası gidiş-dönüş | ~2 ms | yaklaşık 23 gün |
| Kıtalar arası gidiş-dönüş | ~150 ms | yaklaşık 4,8 yıl |
CPU açısından bir DRAM okuması çok uzun bir bekleme: 4 GHz'de 100 ns 400 cycle eder ve her cycle'da birkaç instruction bitirebilen bir çekirdek o sürede yüzlerce instruction çalıştırabilirdi. Bir HTTP isteğine eklenen tek bir network çağrısı ise bellek okumasından on binlerce kat pahalı. "Bu kod kaç işlem yapıyor" sorusundan önce "bu kodun verisi hangi katmanda" sorusunu sor.
Kendi Makinende Ölçmek: Pointer Chasing ile Latency Merdiveni
Kendi makinenin rakamlarını ölçmenin klasik yolu pointer chasing: her element'in bir sonraki adımın index'ini tuttuğu bir array; tek bir büyük döngü olsun diye Sattolo algoritması:
public static class PointerChase
{
    // Sattolo algoritması: bütün element'leri dolaşan tek bir döngü üretir
    public static int[] CreateCycle(int count, int seed)
    {
        int[] next = AccessPatterns.SequentialIndexes(count);
        Random random = new(seed);
        for (int i = count - 1; i > 0; i--)
        {
            int j = random.Next(i);
            (next[i], next[j]) = (next[j], next[i]);
        }
        return next;
    }

    // Her okuma bir öncekinin sonucunu bekler: CPU sıradaki adresi tahmin edemez
    public static int Walk(int[] next, int steps)
    {
        int current = 0;
        for (int i = 0; i < steps; i++)
        {
            current = next[current];
        }
        return current;
    }
}Walk'taki her okuma bir öncekinin sonucuna bağlı: next[current] gelmeden bir sonraki adresi bilmiyorsun. CPU okumaları üst üste bindiremiyor, prefetcher rastgele sırayı tahmin edemiyor. Böylece adım başına süre, array'in sığdığı katmanın gecikmesine eşit oluyor. Array boyutunu büyüttükçe veri bir alt katmana taşıyor:
[SimpleJob(warmupCount: 5, iterationCount: 10)]
[HideColumns(Column.Error)]
public class LatencyLadder
{
    private const int Steps = 1_000_000;
    private int[] _next = [];

    [Params(32, 1_024, 8_192, 65_536, 262_144)]
    public int SizeKb { get; set; }

    [GlobalSetup]
    public void Setup() => _next = PointerChase.CreateCycle(SizeKb * 1024 / sizeof(int), seed: 7);

    [Benchmark(OperationsPerInvoke = Steps)]
    public int DependentLoad() => PointerChase.Walk(_next, Steps);
}
OperationsPerInvoke sayesinde BenchmarkDotNet süreyi bir milyon adıma bölüp adım başına süreyi raporluyor. BenchmarkDotNet'in kurulumu ve tuzakları C# İleri Seviye serisinin "C#'ta Performans: Allocation, Struct'lar ve BenchmarkDotNet ile Ölçmek" yazısında; burada tekrar etmiyorum. Sonuç:
| Method        | SizeKb | Mean      | StdDev    |
|-------------- |------- |----------:|----------:|
| DependentLoad | 32     |  1.035 ns | 0.0712 ns |
| DependentLoad | 1024   |  2.912 ns | 0.0228 ns |
| DependentLoad | 8192   | 14.084 ns | 2.0706 ns |
| DependentLoad | 65536  | 88.633 ns | 3.0130 ns |
| DependentLoad | 262144 | 96.118 ns | 1.1849 ns |
32 KB L1'e sığıyor ve adım 1 ns. 1 MB L2'de, 2,9 ns. 8 MB kâğıt üzerinde 16 MB'lık L2'ye sığıyor ama 14 ns'ye çıkıyor, çünkü L2 bütün core'larla paylaşılıyor ve adres çevirisinin maliyeti devreye giriyor. 64 MB ve 256 MB DRAM'de, 89–96 ns. İkinci sorunun cevabı: bir DRAM okuması L1'den yaklaşık 90 okuma kadar sürüyor. Büyük veri setinde sürenin bir kısmı TLB (virtual adres çevirilerini tutan küçük cache) miss'lerinden geliyor; konu İşletim Sistemi Temelleri serisinin "Virtual Memory: Page, Page Table, TLB ve Page Fault" yazısında. Bu Mac'te page 16 KB, Windows ve Linux x64'te varsayılan 4 KB, o yüzden x64'te bu pay farklı çıkabilir. Asıl önemli olan mutlak rakamlar değil, katmanlar arasındaki oran.
Locality: Temporal ve Spatial
Hiyerarşi, programların belleği rastgele kullanmadığı için işe yarıyor. Temporal locality: az önce kullandığın veriyi yakında tekrar kullanman muhtemel; döngü değişkenleri ya da Bookstore'da her istekte okunan "çok satanlar" listesi gibi. Spatial locality: bir adresi kullandıysan yanındakileri de yakında kullanman muhtemel; bir array'i baştan sona taramak gibi.
Temporal locality'yi cache'in kendisi yakalıyor: kullanılan veri bir süre yukarıda kalıyor. Spatial locality için iki mekanizma var. Birincisi, bellek byte byte değil cache line denen bloklarla taşınıyor: Intel'in manual'ı x64'te bu bloğu 64 byte veriyor, bu Mac'te hw.cachelinesize 128 byte. Tek bir int okuduğunda komşu 15 (bu Mac'te 31) int da ek maliyet olmadan geliyor. İkincisi, hardware prefetcher sıralı veya sabit adımlı erişimi fark edip sıradaki line'ları önceden getiriyor; AMD'nin GDC sunumu Ryzen'de L1 ve L2 için ayrı stream ve stride prefetcher'ları listeliyor. Cache line ve associativity'nin ayrıntıları serinin sonraki yazısında.
"RAM Random Access Değildir": Sıralı ve Karışık Erişim
Şimdi birinci tahmin sorusunu ölçelim. Aynı values array'ini iki farklı index listesiyle topluyoruz. İki listede de aynı sayılar var, yalnız sıraları farklı; döngü ikisinde de index listesini sırayla okuyor, fark yalnız values'a nasıl eriştiğimizde:
public static long SumAt(int[] values, int[] indexes)
{
    long sum = 0;
    foreach (int index in indexes)
    {
        sum += values[index];
    }
    return sum;
}

[SimpleJob(warmupCount: 5, iterationCount: 10)]
[HideColumns(Column.Error, Column.RatioSD)]
public class SequentialVsRandom
{
    private int[] _values = [];
    private int[] _sequential = [];
    private int[] _shuffled = [];

    [Params(4_096, 262_144, 4_194_304, 67_108_864)]
    public int N { get; set; }

    [GlobalSetup]
    public void Setup()
    {
        _values = AccessPatterns.ShuffledIndexes(N, seed: 1);
        _sequential = AccessPatterns.SequentialIndexes(N);
        _shuffled = AccessPatterns.ShuffledIndexes(N, seed: 2);
    }

    [Benchmark(Baseline = true)]
    public long Sequential() => AccessPatterns.SumAt(_values, _sequential);

    [Benchmark]
    public long Shuffled() => AccessPatterns.SumAt(_values, _shuffled);
}
xUnit testleri iki sıranın da aynı toplamı verdiğini doğruluyor; yani ölçtüğümüz tek fark erişim sırası:
| Method     | N        | Mean           | StdDev         | Ratio |
|----------- |--------- |---------------:|---------------:|------:|
| Sequential | 4096     |       1.064 us |      0.0094 us |  1.00 |
| Shuffled   | 4096     |       1.132 us |      0.0140 us |  1.06 |
|            |          |                |                |       |
| Sequential | 262144   |      71.196 us |      2.5728 us |  1.00 |
| Shuffled   | 262144   |     119.891 us |      0.3331 us |  1.69 |
|            |          |                |                |       |
| Sequential | 4194304  |   1,188.452 us |     20.5597 us |  1.00 |
| Shuffled   | 4194304  |   2,836.390 us |    152.9758 us |  2.39 |
|            |          |                |                |       |
| Sequential | 67108864 |  19,054.474 us |    548.8265 us |  1.00 |
| Shuffled   | 67108864 | 255,293.365 us | 43,998.4974 us | 13.41 |
Cevap: 256 MB'ta karışık sıra 13,4 kat yavaş; 16 KB'ta ise fark yok, çünkü veri zaten L1'de. Element başına bakınca sıralı erişim her boyutta yaklaşık 0,28 ns'de sabit kalıyor: prefetcher bir adım önde ve getirilen her cache line'ın tamamı kullanılıyor. Karışık erişim 0,46, 0,68 ve sonunda 3,8 ns'ye çıkıyor; her erişim yeni bir line getiriyor ve ondan tek bir int kullanılıyor.
İlginç olan, 3,8 ns'nin merdivende ölçtüğümüz 96 ns'lik DRAM gecikmesinden çok küçük olması. Fark bağımlılıkta. Burada her okumanın adresi index array'inden geliyor, bir önceki okumanın sonucundan değil; CPU onlarca okumayı aynı anda yola çıkarıp cevaplarını paralel bekleyebiliyor. Intel'in manual'ı Golden Cove için bu kapasitenin artırıldığını, L1'de 16 fill buffer'a ve L2'de 48 bekleyen miss'e çıkıldığını yazıyor. Pointer chasing'de ise bu paralelliğin hiçbiri yok. RAM'in adındaki "random access", her adrese doğrudan gidebildiğini söylüyor; her adresin aynı sürede geldiğini değil. Asıl sorun da rastgele erişimden çok birbirine bağlı miss'ler: linked list, tree, object graph'ı.
Stack ve Heap Aynı RAM'dir
"Stack hızlıdır, heap yavaştır" cümlesi yarım doğru. Stack de heap de process'in virtual address space'inde birer bölge; ikisi de aynı fiziksel DRAM'e ve aynı cache'lere düşüyor. Stack'in avantajı başka yerden geliyor: allocation bir pointer kaydırmak kadar ucuz, method dönünce bellek kendiliğinden geri alınıyor ve stack'in tepesi neredeyse her zaman L1'de, çünkü sürekli aynı bölge kullanılıyor (temporal locality). Bunu ayrıştırmak için aynı 256 int'lik işi üç yerde yaptım:
public static int SumOnStack(int count)
{
    Span<int> prices = stackalloc int[count];
    return Fill(prices);
}

public static int SumOnNewArray(int count)
{
    int[] prices = new int[count];
    return Fill(prices);
}

public static int SumOnReusedArray(int[] prices) => Fill(prices);
| Method | Mean | StdDev | Ratio | Gen0 | Allocated | Alloc Ratio |
|------------ |---------:|---------:|------:|-------:|----------:|------------:|
| Stackalloc | 216.4 ns | 7.25 ns | 1.00 | - | - | NA |
| NewArray | 217.2 ns | 16.95 ns | 1.00 | 0.1249 | 1048 B | NA |
| ReusedArray | 191.5 ns | 7.50 ns | 0.89 | - | - | NA |Stack ile yeni heap array'i aynı sürede çalışıyor; 1 KB'lık veri iki durumda da L1'de. Fark Allocated sütununda: heap versiyonu her çağrıda 1048 byte (1024 byte veri, 24 byte array başlığı) bırakıyor. Gen0'daki 0,1249 ise kabaca her 8.000 çağrıda bir gen0 GC (garbage collector; kullanılmayan object'leri toplayan runtime bileşeni) toplaması demek; o maliyet GC çalıştığında ödeniyor. Tekrar kullanılan array'in yüzde 11 önde olması, her çağrıda yeni ve sıfırlanmış bellek hazırlanmamasından; C# varsayılan olarak stackalloc belleğini de sıfırlıyor. stackalloc'un kuralları C# İleri Seviye serisinin "C#'ta Span<T> ve Memory<T>: Allocation'sız Parse, stackalloc ve ref struct Kuralları" yazısında, GC'nin işleyişi C# Nesne Yönelimli Programlama serisinin "C#'ta Object'lerin Ömrü: Garbage Collector, IDisposable ve using" yazısında.
Book[] of Struct ile List<Book>: Bir Seviye Indirection
Gerçek kodda locality'yi en çok belirleyen şey data structure seçimi. Bookstore'un stok raporu bir milyon kitabın Stock'unu topluyor. Kitap bir class olabilir ya da bir record struct; ikisini de aynı veriyle dolduruyoruz:
public sealed class BookEntity(string isbn, string title, decimal price, int stock)
{
    public string Isbn { get; } = isbn;
    public string Title { get; } = title;
    public decimal Price { get; } = price;
    public int Stock { get; } = stock;
}

public readonly record struct BookRow(string Isbn, string Title, decimal Price, int Stock);

public static long TotalStock(List<BookEntity> books)
{
    long total = 0;
    foreach (BookEntity book in books)
    {
        total += book.Stock;
    }
    return total;
}

public static long TotalStock(BookRow[] books)
{
    long total = 0;
    foreach (BookRow book in books)
    {
        total += book.Stock;
    }
    return total;
}
Kitaplar veritabanından Id sırasıyla yükleniyor. Raporun bir versiyonu bu listeyi, diğeri aynı object'leri Title'a göre sıralanmış bir listede geziyor; üçüncüsü BookRow[] üzerinde çalışıyor:
| Method           | Mean       | StdDev    | Ratio |
|----------------- |-----------:|----------:|------:|
| StructArray      |   533.6 us |  17.73 us |  1.00 |
| ClassListById    | 3,337.9 us |  93.15 us |  6.26 |
| ClassListByTitle | 4,240.4 us | 410.09 us |  7.95 |
Struct array 6,3 kat önde. BookRow 40 byte (Unsafe.SizeOf ile ölçtüm) ve bir milyon satır art arda duruyor; tarama düz bir sıralı okuma. List<BookEntity>'in içindeki array ise yalnız 8 byte'lık referanslar tutuyor ve her Stock okuması başka bir object'e gidiyor. Küçük bir adres ölçümünde Id sırasındaki ardışık iki object arasında ortalama 160 byte vardı, çünkü her kitabın iki string'i de onunla birlikte allocate edilmiş; her kitap yeni bir cache line demek, ama adımlar düzenli olduğu için prefetcher yardım ediyor. Title sırasında komşu object'ler arasındaki mesafe ortalama 50 MB'a çıkıyor, prefetcher tutunamıyor ve süre yüzde 27 uzuyor. GC compaction boşlukları kapatır ama object'leri senin list sırana göre yeniden dizmez.
Burada bağımlı bir zincir yok: adresler list'in array'inden sırayla geliyor, CPU birçok object'i aynı anda isteyebiliyor; LinkedList ise bağımlı versiyondu. Contiguous belleğin gücünü Algoritmalar ve Data Structures serisinin "C# ile Array ve Dynamic Array: Contiguous Bellek, Index Erişimi ve Kendi List'ini Yazmak" yazısında görmüştük. Pratik karar: binlerce satırı tarayan raporlar ve hesaplamalar için satırları struct array'e ya da Span<T>'e almak çoğu zaman karşılığını verir; kimliği ve değişen state'i olan entity'ler class kalır.
Üretimde Dikkat
Disk ölçerken RAM'i ölçmek çok kolay. 256 MB'lık bir dosya yazıp hemen ardından rastgele 4 KB'lık parçalar okuyan şu method gerçek bir SSD üzerinde çalıştı:
public static void Run(string path)
{
    const int FileSize = 256 * 1024 * 1024;
    const int BlockSize = 4096;
    const int Reads = 20_000;

    byte[] block = new byte[BlockSize];
    using (FileStream writer = File.Create(path))
    {
        Random.Shared.NextBytes(block);
        for (int written = 0; written < FileSize; written += BlockSize)
        {
            writer.Write(block);
        }
    }

    using Microsoft.Win32.SafeHandles.SafeFileHandle handle = File.OpenHandle(path);
    Random random = new(42);
    long[] offsets = new long[Reads];
    for (int i = 0; i < Reads; i++)
    {
        offsets[i] = (long)random.Next(FileSize / BlockSize) * BlockSize;
    }

    // Isınma turu, sonra ölçüm
    foreach (long offset in offsets.AsSpan(0, 1_000))
    {
        RandomAccess.Read(handle, block, offset);
    }
    Stopwatch watch = Stopwatch.StartNew();
    foreach (long offset in offsets)
    {
        RandomAccess.Read(handle, block, offset);
    }
    watch.Stop();

    double microseconds = watch.Elapsed.TotalMicroseconds / Reads;
    Console.WriteLine($"File: {FileSize / 1024 / 1024} MB, just written");
    Console.WriteLine($"Random 4 KB reads: {Reads:N0}, average {microseconds:F2} us");
}
File: 256 MB, just written
Random 4 KB reads: 20,000, average 0.61 us0,61 µs, datasheet'teki 75 µs'den yüz kattan fazla hızlı. Ölçtüğümüz şey SSD değil, işletim sisteminin page cache'i: dosyanın sayfaları yazıldığı anda RAM'deydi ve her okuma bir system call artı bir bellek kopyası oldu. Page cache İşletim Sistemi Temelleri serisinin "File System Nasıl Çalışır: Inode, File Descriptor, Page Cache ve fsync" yazısında. Gerçek disk gecikmesi için dosyanın RAM'den büyük ya da cache'in soğuk olması gerekir.
İkinci kural: rakamları hedef donanımda ölç. Bir Windows makinesinde cache boyutlarını ve core'ların hangi cache'i paylaştığını görmek için Sysinternals'ın Coreinfo aracı ve WMI (Windows'un sistem bilgisi sorgulama altyapısı) yeterli; latency merdiveni de aynı projeyle koşar. Aşağıdaki komutlar Microsoft'un dokümanına göre yazıldı, bu yazı için çalıştırılmadı:
# Cache seviyeleri, boyutları, line size ve paylaşım haritası
coreinfo64 -l

# L2/L3 boyutları (KB) ve core sayıları
Get-CimInstance Win32_Processor | Select-Object Name, NumberOfCores, NumberOfLogicalProcessors, L2CacheSize, L3CacheSize

# Latency merdivenini kendi makinende koş
dotnet run -c Release -- --filter "*LatencyLadder*"
Üçüncüsü, sunucu laptop değildir. İki soketli bir sunucuda diğer soketin belleği yukarıdaki Intel ölçümüne göre yaklaşık iki kat uzakta; bu NUMA (her soketin kendi belleğine daha hızlı eriştiği mimari) etkisi serinin "Multi-Core, Hyper-Threading ve False Sharing" yazısında. Bulut VM'lerinde L3 başka iş yükleriyle paylaşılır; onlar cache'i doldurdukça senin verin cache'ten atılır. Bu yazının ölçümleri de yüklü bir makinede alındı, o yüzden StdDev'i tablolarda bıraktım. Production'da sorunun bellekten geldiğini kanıtlamak için profiler gerekir; o araçlar .NET'te Profiling ve Diagnostics serisinin konusu.
Sık Düşülen Tuzaklar
Ezber latency tablosunu mutlak değer sanmak. Peter Norvig'in "Teach Yourself Programming in Ten Years" yazısındaki tablo L1 için 0,5 ns, ana bellek için 100 ns ve diskte bir seek için 8 ms veriyor. Mertebeler hâlâ öğretici, ama tabloda L3 ve SSD satırı yok, disk satırı dönen plakalı disk dönemine ait. Bugün ezberlenecek şey rakamlar değil katmanlar arası oranlar; rakamı her zaman kendi donanımında ölç.
Benchmark verisini cache'e sığdırmak. 16 KB'lık testte karışık erişim sıralı erişimle aynı çıktı; oradan "erişim sırası önemsiz" sonucuna varırsan production'daki 2 GB'lık veride şaşırırsın. Birkaç boyutu [Params] ile birlikte ölç ve en az birini L3'ün çok üstüne koy.
"Stack hızlı" diye her şeyi stackalloc'a taşımak. Okuma hızı aynı, kazancın yalnız allocation ve GC tarafında. Stack megabyte mertebesinde sınırlı bir bölge ve taşarsa process StackOverflowException ile, yakalanma şansı olmadan ölür. Küçük, boyutu bilinen buffer'lar için stack, gerisi için ArrayPool<T> veya tekrar kullanılan bir array.
Küçük Bir Deneme
★☆☆ LatencyLadder'ın [Params]'ına 128, 512, 2.048, 4.096, 16.384 ve 32.768 KB'ı ekle. Adım süresinin sıçradığı boyutları bul ve Windows'ta coreinfo64 -l'in verdiği L1, L2 ve L3 boyutlarıyla karşılaştır. Sıçramalar tam cache boyutunda mı, biraz önce mi oluyor?
★★☆ ShuffledIndexes'ın bir varyantını yaz: array'i 16 element'lik (64 byte) bloklara böl, blokların sırasını karıştır ama blok içi sırayı koru. 256 MB'ta oran 13,4'ten nereye iner? Blok boyutunu 1.024 element'e çıkarınca ne oluyor? Sonucu spatial locality ve prefetcher ile açıkla.
★★★ BookEntity'ye bir Next referansı ekle ve Title sırasına göre bağlı bir zincir kur. Stok toplamını bu zinciri izleyerek hesaplayan versiyonu ClassListByTitle ile karşılaştır. İkisi de aynı object'leri aynı sırayla okuyor; aradaki farkı latency merdiveni ve bağımsız miss'lerin paralel beklenmesiyle açıkla.
Sonraki yazı "CPU Cache Nasıl Çalışır: Cache Line, Associativity ve Cache-Friendly C# Kodu" cache'in içini açıyor: bir adresin hangi set'e düştüğü, 2D array'i satır ya da sütun sırasıyla gezmenin farkı ve yalnız Price'ı tarayan bir rapor için Array of Structs ile Struct of Arrays arasındaki seçim.