

CPU Pipeline ve Branch Prediction: Sıralı Array Neden Daha Hızlı İşlenir?
Sıralı array daha hızlı işlenir çünkü içindeki if'ler tahmin edilebilir hâle gelir ve CPU pipeline'ı boşaltmak zorunda kalmaz. Bir milyon siparişte 9,4 kat fark, JIT'in döngüde neden cmov üretmediği, bit mask ile branchless toplama, bağımlılık zinciri ve ILP, Spectre'nin neden var olduğu.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ile derlenip denenmiştir; testler xUnit v3 4.0.3, ölçümler BenchmarkDotNet 0.15.8 ile Apple M5 (Apple'ın Arm tabanlı işlemcisi) / macOS 27 / .NET 10.0.13 üzerinde alınmıştır. x64 assembly listeleri .NET'in JIT'inden (Just-In-Time; kodu çalışma anında makine koduna çeviren derleyici) gelir: Windows x64 hedefi için crossgen2 10.0.13 ile, tier-1 listesi ise Linux x64 container'ında .NET 10.0.15 ile üretilmiştir.
Önce Tahmin Et
Bookstore'un raporlama ekibi her gece bir milyon sipariş tutarını tarıyor ve 100 TL'nin üzerindeki siparişleri topluyor. Kod tek bir foreach ve tek bir if. Aynı bir milyon tutarı önce rastgele sırada, sonra küçükten büyüğe sıralanmış hâlde veriyorsun. Toplanan sayılar aynı, element sayısı aynı, döngü aynı, Big-O aynı: O(n). Sence sıralı array kaç kat hızlı işlenir? Hiç fark olmaz mı, yüzde 10 mu, yoksa daha fazlası mı?
İkinci soru: aynı döngüyü 10.000 element'lik küçük bir array'de çalıştırınca fark aynı oranda mı kalır? Cevaplar serinin önceki yazısında, "Bir C# Satırı CPU'da Nasıl Çalışır" yazısında gördüğümüz fetch-decode-execute döngüsünün gerçek CPU'larda nasıl üst üste bindirildiğinde saklı.
Pipeline: Bir Instruction'ın Beş Durağı
Fetch-decode-execute döngüsünü bir instruction bitmeden sonrakine başlamayan bir makine gibi düşünürsen CPU'nun büyük kısmı çoğu zaman boş bekler: decode birimi çalışırken fetch birimi durur, execute çalışırken ikisi de durur. Pipeline bu boşluğu çamaşırhane mantığıyla doldurur. Bir makine yıkarken diğeri kurutur; her aşama bir sonraki instruction'ın kendi payına düşen işini yapar.
Ders kitaplarındaki klasik model beş aşamalıdır: instruction'ı bellekten getiren fetch (IF), çözüp register'ları okuyan decode (ID), ALU'da (Arithmetic Logic Unit; aritmetik ve mantık işlemlerini yapan birim) hesabı yapan execute (EX), gerekiyorsa belleğe erişen memory (MEM) ve sonucu register'a yazan write back (WB). Bryant ve O'Hallaron'ın Computer Systems: A Programmer's Perspective kitabı aynı fikri kendi öğretim ISA'sı (Instruction Set Architecture; işlemcinin tanıdığı instruction kümesi) üzerinde benzer aşamalarla kurar. Her aşama bir clock cycle sürerse tek bir instruction yine beş cycle'da biter ama her cycle'da bir instruction tamamlanır. Latency değişmez, throughput beş katına çıkar.
Modern x64 çekirdekleri bu modelin çok ötesindedir: çok daha fazla aşama, bir instruction'ın micro-op'lara (µop) bölünmesi, bir µop cache'i. Ama bu yazının bütün hikâyesi beş aşamalı modelde de görülen tek bir sorudan çıkar: jle gibi bir koşullu branch fetch edildiğinde, sonraki instruction'ı hangi adresten getireceğim?
Branch Prediction: CPU Sonucu Beklemeden Tahmin Eder
Bookstore'daki rapor kodu şu:
public static class OrderTotals
{
    public const int Threshold = 100;

    [MethodImpl(MethodImplOptions.NoInlining)]
    public static long SumExpensive(int[] orderAmounts)
    {
        long sum = 0;
        foreach (int amount in orderAmounts)
        {
            if (amount > Threshold)
            {
                sum += amount;
            }
        }
        return sum;
    }
}
NoInlining yalnızca JIT çıktısında method'u ayrı görebilmek için. Windows x64 için JIT'in ürettiği kod (crossgen2 ile Windows hedefli derleme, kısaltılmış):
; Assembly listing for method Bookstore.Branching.OrderTotals:SumExpensive(int[]):long (FullOpts)
; Emitting BLENDED_CODE for generic X64 on Windows
; ReadyToRun compilation
G_M000_IG02:                ;; offset=0x0000
       xor      eax, eax
       mov      edx, dword ptr [rcx+0x08]
       test     edx, edx
       jle      SHORT G_M000_IG07
G_M000_IG03:                ;; offset=0x0009
       add      rcx, 16
G_M000_IG04:                ;; offset=0x000D
       mov      r8d, dword ptr [rcx]
       cmp      r8d, 100
       jle      SHORT G_M000_IG06
G_M000_IG05:                ;; offset=0x0016
       mov      r8d, r8d
       add      rax, r8
G_M000_IG06:                ;; offset=0x001C
       add      rcx, 4
       dec      edx
       jne      SHORT G_M000_IG04
G_M000_IG07:                ;; offset=0x0024
       ret
; Total bytes of code 37
Döngünün kalbi IG04: tutarı r8d'ye yükle, 100 ile karşılaştır, küçük veya eşitse (jle) toplamayı atla. rcx array'in adresi; Windows x64 calling convention'ında ilk argüman burada gelir. Kendi Windows makinende aynı çıktıyı runtime'dan almak için:
# PowerShell: JIT'in ürettiği kodu konsola yazdır
$env:DOTNET_JitDisasm="SumExpensive"
dotnet run -c Release
Runtime'da göreceğin tier-1 kodu Dynamic PGO (Profile-Guided Optimization; çalışma anında toplanan ölçümlere göre yapılan optimizasyon) verisiyle blokların sırasını değiştirebilir; Linux x64 container'ında aldığım tier-1 çıktısında aynı cmp edx, 100 / jle çifti vardı, yalnızca blok düzeni farklıydı. Tiering ve PGO'nun nasıl çalıştığı Compiler'lar ve Programlama Dilleri serisinin konusu.
Sorun şurada: jle'nin atlayıp atlamayacağı ancak cmp execute aşamasından geçince belli olur. O ana kadar fetch birimi boş durursa pipeline'ın kazancı her branch'te kaybolur. CPU beklemek yerine tahmin eder ve tahmin ettiği yoldan instruction getirmeye, hatta çalıştırmaya devam eder. Branch predictor her branch'in geçmişini (ve son branch'lerin ortak geçmişini) tutan bir donanım tablosudur. Tahmin doğruysa hiçbir şey kaybedilmez. Yanlışsa yanlış yoldan alınmış her şey atılır ve doğru adresten yeniden başlanır. Buna pipeline flush denir.
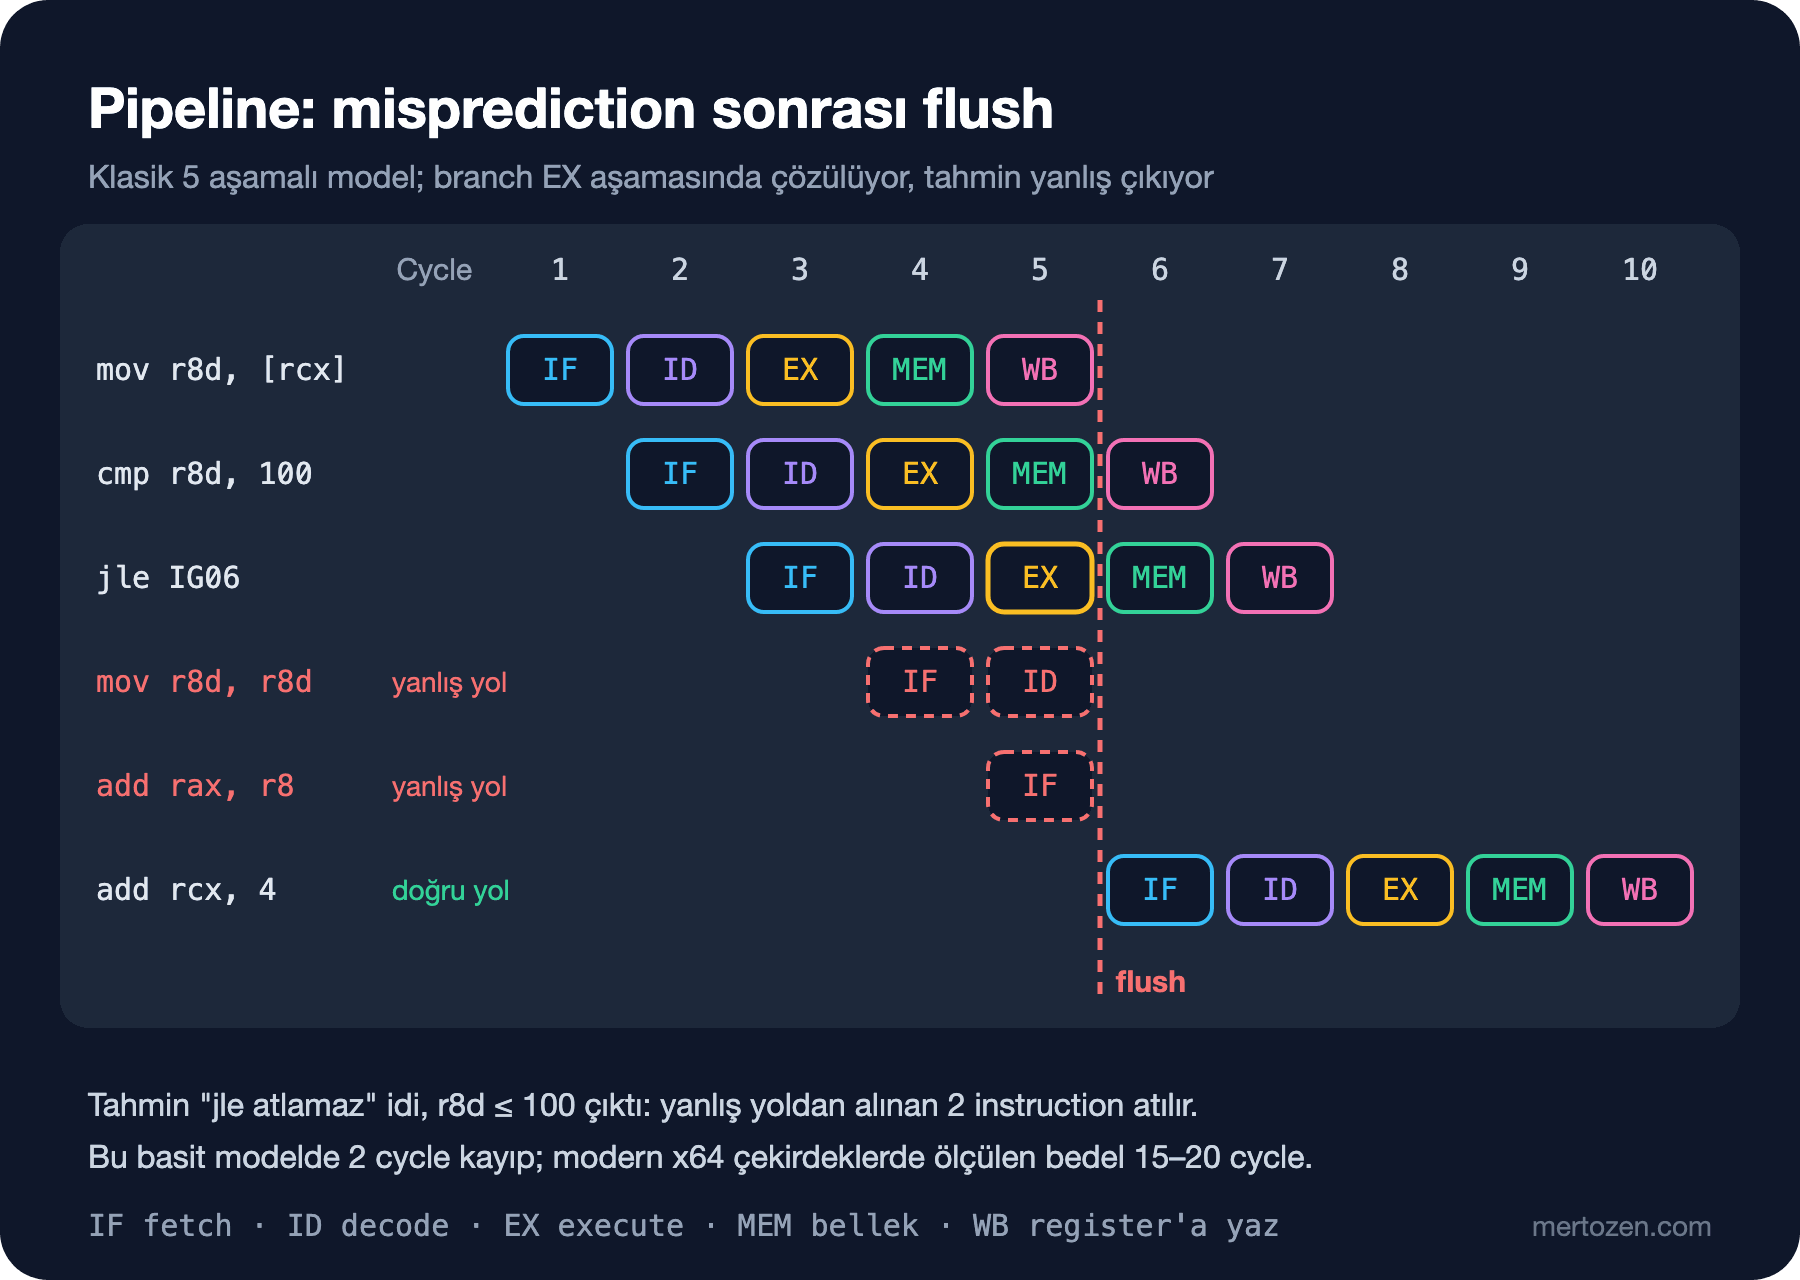
Beş aşamalı modelde bu kayıp iki cycle. Gerçek çekirdeklerde pipeline çok daha derin olduğu için bedel de büyük: Agner Fog'un mikromimari kılavuzunda Intel Haswell'den Skylake ailesine kadar ölçülen misprediction bedeli 15–20 cycle, AMD'nin (Advanced Micro Devices, x64 işlemci üreticisi) Zen 1–3 için ortalama 18 cycle, Zen 5 için 15–25 cycle aralığında.
Ölçüm: Sıralı ve Karışık Siparişler
Tutarlar 0 ile 199 arasında rastgele; yani her element için 100'ü geçme olasılığı yaklaşık yarı yarıya. Karışık veride bu, yazı tura atmak demek. Sıralı veride ise ilk yarı hep "atla", ikinci yarı hep "topla": predictor için en kolay desen.
public static class OrderData
{
    public static int[] Create(int count, bool sorted, int seed = 42)
    {
        Random random = new(seed);
        int[] amounts = new int[count];
        for (int i = 0; i < amounts.Length; i++)
        {
            amounts[i] = random.Next(0, 200);
        }
        if (sorted)
        {
            Array.Sort(amounts);
        }
        return amounts;
    }
}

[SimpleJob(warmupCount: 5, iterationCount: 15)]
public class BranchBenchmarks
{
    private int[] _amounts = [];

    [Params(10_000, 1_000_000)]
    public int N { get; set; }

    [Params(false, true)]
    public bool Sorted { get; set; }

    [GlobalSetup]
    public void Setup() => _amounts = OrderData.Create(N, Sorted);

    [Benchmark(Baseline = true)]
    public long Branchy() => OrderTotals.SumExpensive(_amounts);

    [Benchmark]
    public long Ternary() => OrderTotals.SumExpensiveTernary(_amounts);

    [Benchmark]
    public long Mask() => OrderTotals.SumExpensiveMask(_amounts);
}
BenchmarkDotNet kurulumu C# İleri Seviye serisinin "C#'ta Performans: Allocation, Struct'lar ve BenchmarkDotNet ile Ölçmek" yazısında. Ölçümleri yapabildiğim tek gerçek donanım Apple M5 olduğu için tablolar o makineden; x64 tarafını JIT'in gerçek x64 çıktısı ve Intel/AMD için yayımlanmış ölçümlerle anlatıyorum. Ternary ve Mask satırlarına birazdan geleceğiz:
| Method  | N       | Sorted | Mean         | Error      | StdDev     | Ratio | RatioSD |
|-------- |-------- |------- |-------------:|-----------:|-----------:|------:|--------:|
| Branchy | 10000   | False  |     6.852 us |  0.5513 us |  0.5157 us |  1.01 |    0.10 |
| Ternary | 10000   | False  |     6.225 us |  0.0584 us |  0.0518 us |  0.91 |    0.07 |
| Mask    | 10000   | False  |     3.319 us |  0.0139 us |  0.0108 us |  0.49 |    0.03 |
|         |         |        |              |            |            |       |         |
| Branchy | 10000   | True   |     2.390 us |  0.0203 us |  0.0180 us |  1.00 |    0.01 |
| Ternary | 10000   | True   |     2.836 us |  0.0082 us |  0.0077 us |  1.19 |    0.01 |
| Mask    | 10000   | True   |     3.379 us |  0.0359 us |  0.0318 us |  1.41 |    0.02 |
|         |         |        |              |            |            |       |         |
| Branchy | 1000000 | False  | 2,339.447 us | 22.4815 us | 17.5521 us |  1.00 |    0.01 |
| Ternary | 1000000 | False  | 2,394.782 us | 67.2474 us | 56.1546 us |  1.02 |    0.02 |
| Mask    | 1000000 | False  |   340.638 us |  1.6100 us |  1.5060 us |  0.15 |    0.00 |
|         |         |        |              |            |            |       |         |
| Branchy | 1000000 | True   |   248.656 us |  0.9305 us |  0.8249 us |  1.00 |    0.00 |
| Ternary | 1000000 | True   |   280.845 us |  4.7008 us |  3.6701 us |  1.13 |    0.01 |
| Mask    | 1000000 | True   |   337.169 us |  2.3824 us |  2.2285 us |  1.36 |    0.01 |
Bir milyon siparişte karışık veri 2.339 µs, sıralı veri 249 µs: 9,4 kat. Element başına 2,34 ns'ye karşı 0,25 ns. Sıralı veride döngü, branch'i neredeyse hiç kaçırmadan akıyor; karışık veride her iki element'ten birinde predictor yanılıyor ve pipeline boşalıyor. Kabaca bir hesapla yarım milyon misprediction 2,1 ms'lik farkı açıklıyor, yani tahmin hatası başına 4 ns civarı. Bu makinenin clock'u ve pipeline derinliği üretici tarafından yayımlanmadığı için bunu cycle'a çevirmiyorum; x64 tarafındaki 15–20 cycle, 4–5 GHz'lik bir çekirdekte aynı mertebeye düşer.
10.000 element'te tablo başka bir şey söylüyor: karışık veri yalnızca 2,9 kat yavaş. Bunun sebebi bir sonraki bölümün konusu değil, Sık Düşülen Tuzaklar'ın konusu; önce branch'ten nasıl kurtulunur, ona bakalım.
Superscalar ve Out-of-Order: Aynı Anda Birden Çok İş
Pipeline, her cycle'da bir instruction tamamlamayı vaat eder. Modern çekirdekler bunun da ötesine geçer. Superscalar bir çekirdek her cycle'da birden fazla instruction'ı decode edip birden fazla execution unit'e dağıtır. Out-of-order execution ise program sırasına bağlı kalmadan, girdisi hazır olan instruction'ı önce çalıştırır ve sonuçları yine program sırasıyla "commit" eder. İkisinin beraber sömürdüğü şeye ILP (instruction-level parallelism; instruction düzeyinde paralellik) denir: birbirine bağımlı olmayan instruction'lar aynı anda yürür.
Bağımlılık zinciri bu paralelliği öldürür. Kargo ağırlıklarını toplayan iki versiyon:
public static class ShippingWeights
{
    [MethodImpl(MethodImplOptions.NoInlining)]
    public static double TotalOneChain(double[] weights)
    {
        double total = 0;
        for (int i = 0; i < weights.Length; i++)
        {
            // Her toplama bir öncekinin sonucunu bekler
            total += weights[i];
        }
        return total;
    }

    [MethodImpl(MethodImplOptions.NoInlining)]
    public static double TotalFourChains(double[] weights)
    {
        double a = 0, b = 0, c = 0, d = 0;
        int i = 0;
        for (; i <= weights.Length - 4; i += 4)
        {
            // Dört bağımsız zincir: CPU dördünü üst üste bindirebilir
            a += weights[i];
            b += weights[i + 1];
            c += weights[i + 2];
            d += weights[i + 3];
        }
        for (; i < weights.Length; i++)
        {
            a += weights[i];
        }
        return (a + b) + (c + d);
    }
}
| Method | Mean | Error | StdDev | Ratio | RatioSD |
|----------- |---------:|---------:|---------:|------:|--------:|
| OneChain | 59.62 us | 1.314 us | 1.229 us | 1.00 | 0.03 |
| FourChains | 16.83 us | 0.942 us | 0.882 us | 0.28 | 0.02 |100.000 double, aynı sayıda toplama, 3,5 kat fark. Floating point toplama birkaç cycle süren bir işlemdir; tek zincirde her total += bir öncekinin bitmesini beklediği için CPU'nun boşta kalan toplama birimleri bir işe yaramaz. Dört zincirde out-of-order motor dört toplamayı aynı anda hatta tutar. Agner Fog da kılavuzunda, performans açısından kritik kodda uzun bağımlılık zincirlerinden mümkün olduğunca kaçınmayı öneriyor.
Bedeli: toplama sırası değişti. Floating point toplama associative değildir, bu yüzden [1e16, 1.0, -1e16, 1.0] için tek zincir 1, dört zincir 0 döndürüyor; bunu xUnit testinde sabitledim. Neden böyle olduğu Number System'ler ve Data Representation serisinin floating point yazısında. Para hesabında decimal kullanmanın bir sebebi de bu.
Branch prediction ile bağlantı şu: out-of-order motor, predictor'ın gösterdiği yoldan onlarca instruction'ı önceden çalıştırır. Tahmin doğruysa bu iş bedavaya gelir; yanlışsa hepsi çöpe gider. Derin ve geniş bir çekirdekte misprediction'ı pahalı yapan şey de budur.
Branchless Kod: cmov, csel ve Bit Mask
Tahmin edilemeyen bir branch'ten kurtulmanın yolu, onu veri bağımlılığına çevirmektir. x64'te cmov, ARM64'te (64-bit Arm mimarisi) csel instruction'ları koşula göre iki değerden birini seçer; atlama yoktur, tahmin edilecek bir şey yoktur. İlk deneme ternary:
[MethodImpl(MethodImplOptions.NoInlining)]
public static long SumExpensiveTernary(int[] orderAmounts)
{
    long sum = 0;
    foreach (int amount in orderAmounts)
    {
        sum += amount > Threshold ? amount : 0;
    }
    return sum;
}

[MethodImpl(MethodImplOptions.NoInlining)]
public static int KeepIfExpensive(int amount) => amount > Threshold ? amount : 0;
Tablodaki Ternary satırları Branchy ile aynı davranıyor: karışık veride yine 2,4 ms. JIT çıktısına bakınca sebep görülüyor: döngüdeki ternary yine cmp + jle olarak derlenmiş. Aynı ifade döngü dışında, tek başına bir method'da ise branchless:
; Assembly listing for method Bookstore.Branching.OrderTotals:KeepIfExpensive(int):int (FullOpts)
; Emitting BLENDED_CODE for generic X64 on Windows
G_M000_IG02:                ;; offset=0x0000
       xor      eax, eax
       cmp      ecx, 100
       cmovg    eax, ecx
G_M000_IG03:                ;; offset=0x0008
       ret
; Total bytes of code 9
ARM64 aynı method için kendi ISA'sının karşılığını üretiyor:
; Assembly listing for method Bookstore.Branching.OrderTotals:KeepIfExpensive(int):int (Tier1)
; Emitting BLENDED_CODE for generic ARM64 on Apple
G_M000_IG02:                ;; offset=0x0008
            cmp     w0, #100
            csel    w0, w0, wzr, gt
; Total bytes of code 24
Döngüde neden yok? .NET runtime'ının kaynak kodunda if-conversion aşaması (JIT'in koşullu atlamayı bir "select" işlemine çevirdiği yer) döngü içindeki blokları bilerek atlıyor. Gerekçe kod yorumunda yazıyor: döngüler arası taşınan bağımlılık (loop-carried dependency) if-conversion'dan sonra ciddi duraklamalara yol açabilir. cmov her iki değeri de beklediği için, iyi tahmin edilen bir branch'ten daha yavaş olabilir. JIT bu yüzden döngüde temkinli davranıyor ve tablodaki sıralı satırlar ona hak veriyor.
Döngüde gerçekten branchless kod istiyorsan bunu aritmetikle yazabilirsin:
[MethodImpl(MethodImplOptions.NoInlining)]
public static long SumExpensiveMask(int[] orderAmounts)
{
    long sum = 0;
    foreach (int amount in orderAmounts)
    {
        // amount > 100 ise (100 - amount) negatif: mask = -1 (tüm bitler 1), değilse 0
        int mask = (Threshold - amount) >> 31;
        sum += amount & mask;
    }
    return sum;
}
; Assembly listing for method Bookstore.Branching.OrderTotals:SumExpensiveMask(int[]):long (Tier1)
; Emitting BLENDED_CODE for generic X64 + VEX on Unix
G_M000_IG04: ;; offset=0x0020
mov edx, dword ptr [rdi]
mov esi, edx
neg esi
add esi, 100
sar esi, 31
and edx, esi
movsxd rdx, edx
add rax, rdx
add rdi, 4
dec ecx
jne SHORT G_M000_IG04Döngüde kalan tek branch, döngünün kendi jne'si; o da hep aynı yöne gittiği için neredeyse hiç kaçmaz. Sonuç tabloda: Mask verinin sırasından bağımsız olarak bir milyon element'te 340 µs civarında. Karışık veride 6,9 kat kazanç. Ama sıralı veride branch'li versiyon 249 µs ile daha hızlı, çünkü iyi tahmin edilen bir branch fiilen bedava, aritmetik versiyon ise her element için birkaç instruction fazla çalıştırıyor. Branchless kod bir sigortadır: en kötü durumu iyileştirir, en iyi durumu biraz kötüleştirir.
Shift'in sağ tarafta işaret bitini nasıl çoğalttığı (arithmetic shift) ve two's complement Number System'ler ve Data Representation serisinin konusu. Burada yalnızca şunu bilmek yetiyor: (100 - amount) >> 31, amount 100'den büyükse -1, değilse 0.
Speculative Execution ve Spectre
CPU tahmin ettiği yolu yalnızca fetch etmiyor, çalıştırıyor da. Buna speculative execution denir ve yanlış yolun sonuçları register'lara hiç commit edilmez. Program açısından iz kalmaz. Ama mikromimari açısından kalır: spekülatif çalışan bir load, veriyi cache'e getirmiş olabilir.
Spectre (2018'de duyurulan güvenlik açığı ailesi) tam bu boşluktan doğdu. Saldırgan, predictor'ı eğiterek kurbanın normalde erişmeyeceği bir veriyi spekülatif olarak okutuyor, sonra hangi cache line'ın ısındığını zaman ölçerek tahmin ediyor. Spectre'yi duyuran araştırmacıların sayfasına göre saldırı Intel, AMD ve Arm işlemcilerde doğrulandı; sebebi bir yazılım hatası değil, çok sayıda instruction'ı aynı anda havada tutan modern işlemcilerin tasarımı. Bu yüzden düzeltme tek bir yamayla gelmedi, katman katman geldi:
- İşletim sistemleri ve CPU mikrokodu, kernel ile kullanıcı kodu arasında predictor'ın paylaşılmasını sınırlayan güncellemeler aldı.
- Derleyiciler, hassas sınır kontrollerinin arkasına spekülasyonu durduran instruction'lar koyabilen seçenekler kazandı.
- Tarayıcılar her siteyi ayrı process'e taşıdı ve zamanlayıcıların hassasiyetini düşürdü: MDN'ye (Mozilla'nın web dokümantasyonu) göre
performance.now(), cross-origin isolated olmayan sayfalarda 100 µs, isolated sayfalarda 5 µs çözünürlükle döner.
Bir .NET geliştiricisi olarak senin yapacağın şey genellikle bu katmanları kapatmamak: güncel işletim sistemi, güncel runtime, güncel tarayıcı. Bu mitigasyonların bir performans bedeli olduğu için "kapatalım, hızlanalım" tavsiyelerine şüpheyle bak. Kernel tarafındaki ayrıntılar İşletim Sistemi Temelleri serisinde.
Üretimde Dikkat
Gerçek kodda branch'lerin büyük kısmı zaten iyi tahmin edilir: null kontrolleri, hata yolları, neredeyse hiç değişmeyen feature flag'leri. Optimizasyon fırsatı, sıcak bir döngünün içinde verinin kendisine bağlı olan ve yaklaşık yarı yarıya dağılan koşullardır: filtreler, sınıflandırmalar, eşik kontrolleri. Bunları bulmanın yolu tahmin değil, ölçmek. BenchmarkDotNet'in [HardwareCounters(HardwareCounter.BranchMispredictions, HardwareCounter.BranchInstructions)] attribute'u Windows'ta misprediction sayısını doğrudan raporlar; dokümanına göre bu özellik BenchmarkDotNet.Diagnostics.Windows paketini, ETW'yi (Event Tracing for Windows; Windows'un çekirdek düzeyindeki event izleme altyapısı) ve yönetici yetkisini gerektiriyor, Unix desteği henüz yok. Bu yazının ölçümlerini macOS'ta aldığım için bu sayaçları burada gösteremiyorum. Production'da hangi method'un sıcak olduğunu bulmak ise .NET'te Profiling ve Diagnostics serisinin işi.
Veriyi branch'e göre sıralamak da bir seçenek gibi görünür ama sıralama O(n log n) ve kendi branch'leriyle gelir. Veri zaten başka bir sebeple sıralı geliyorsa (ör. tarih sırasıyla okunan siparişler) bedavaya kazanırsın; yalnızca branch için sıralamak nadiren kârlıdır.
Sık Düşülen Tuzaklar
Micro-benchmark sonucunu genellemek. Tablodaki 10.000 element'lik satır bunun canlı örneği: karışık veri 9,4 kat değil yalnızca 2,9 kat yavaş. BenchmarkDotNet aynı array'i binlerce kez işliyor ve modern predictor'lar uzun geçmiş tuttuğu için tekrar eden bir deseni kısmen ezberleyebiliyor. Agner Fog da Skylake ailesi için çok uzun tekrar eden atlama desenlerinin neredeyse hiç kaçırılmadan tahmin edildiğini not ediyor. Bunu doğrulamak için 100 farklı 10.000'lik array'i sırayla verdim:
| Method         | Mean      | Error     | StdDev    | Ratio | RatioSD |
|--------------- |----------:|----------:|----------:|------:|--------:|
| SameArray      |  6.841 us | 0.4437 us | 0.4151 us |  1.00 |    0.08 |
| RotatingArrays | 28.454 us | 1.5892 us | 1.4088 us |  4.17 |    0.31 |
Aynı boyut, aynı dağılım, dört kat fark. Production'da her gece aynı 10.000 siparişi işlemiyorsan gerçek maliyet ikinci satırdır. (Bu ölçüm sırasında makinede başka işler de çalışıyordu; mutlak değerler biraz oynar, oran net.)
JIT'in zaten branchless ürettiği kodu "optimize etmek". KeepIfExpensive gibi küçük bir ternary'yi bit hilesine çevirmek hiçbir şey kazandırmaz, JIT orada zaten cmov üretiyor. Önce JIT çıktısına bak, sonra karar ver.
Okunabilirliği feda etmek. (Threshold - amount) >> 31 ancak bir yorumla anlaşılır ve amount çok küçük bir negatif sayı (ör. int.MinValue) olabilseydi çıkarma taştığı için yanlış sonuç verirdi. Bu yüzden testi var. Bu tür kodu ölçülmüş bir darboğaz için, testleriyle ve yorumuyla yaz; geri kalan her yerde düz if doğru seçimdir.
Debug build'i veya Tier-0 kodunu ölçmek. Serinin önceki yazısında gördüğümüz gibi Tier-0 kod register yerine stack'e yazıp okur; branch maliyetleri o gürültüde kaybolur. Ölçüm her zaman Release ve ısınmış kod üzerinde.
Küçük Bir Deneme
★☆☆ OrderData.Create'teki aralığı random.Next(0, 200) yerine random.Next(0, 1000) yap. 100'ü geçme olasılığı yüzde 90 oldu. Karışık verideki Branchy ile Mask arasındaki fark nasıl değişti? Predictor için "çoğunlukla aynı yön" ne demek?
★★☆ Benchmark'a bir SortThenSum ekle: karışık array'in kopyasını Array.Sort ile sıralayıp SumExpensive'i çağırsın. Toplam süre karışık Branchy'den kısa mı? Hangi durumda sıralamak kârlı olur?
★★★ Windows'ta yönetici olarak BranchBenchmarks'a [HardwareCounters(HardwareCounter.BranchMispredictions, HardwareCounter.BranchInstructions)] ekle. Bir milyon karışık element'te misprediction sayısı yarım milyona yakın mı? Karışık ve sıralı satırlar arasındaki süre farkını misprediction sayısına bölerek kendi işlemcinin tahmin hatası başına kaç ns ödediğini hesapla ve Agner Fog'un 15–20 cycle'ıyla karşılaştır.
Bu yazıda CPU'nun instruction'ları nasıl üst üste bindirdiğini ve bir tahmin hatasının neden pahalı olduğunu gördük. Ama döngülerimiz hep küçük array'lerdeydi; veri cache'e sığıyordu. Serinin sonraki yazısında register'dan SSD'ye (flash bellekli disk) uzanan bellek katmanlarını konuşacağız. "Memory Hierarchy: Register'dan SSD'ye Latency Rakamları ve Locality" yazısında veri cache'ten taştığında ne olduğuna bakacağız: aynı toplama, sıralı ve rastgele index'le, bu sefer branch değil bellek yüzünden kat kat yavaşlayacak.