

Unicode ve UTF-8/UTF-16: Code Point, Surrogate Pair, Rune ve Emoji'de Bozulan string.Length
string.Length emojide bozulur çünkü .NET ve JavaScript string'i UTF-16 code unit olarak sayar; aile emojisi tek bir grapheme ama 5 code point, 8 code unit ve 18 UTF-8 byte'tır. ASCII'den Unicode'a, code point, plane ve scalar value, UTF-8 ve surrogate pair'i elle encode etmek, Rune, u8 literal ve BOM, StringInfo ve Intl.Segmenter ile 280 karakterlik yorum sınırını doğru saymak.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14), TypeScript 7.0 ve Node.js 24 ile derlenip denenmiştir; C# örneklerinin testleri xUnit v3 4.0.3 ile yazılmıştır. Yazı Unicode 18.0'ı (Eylül 2026) ve RFC (Request for Comments; internet standartlarının yayımlandığı doküman serisi) 3629'u esas alır; .NET 10'un karakter verisi Unicode 16.0'a göredir.
Önce Tahmin Et
Bookstore'da kitap yorumları 280 karakterle sınırlı ve backend kontrolü şöyle: if (review.Length > 280) return BadRequest();. Bir kullanıcı yorumuna aile emojisi 👨👩👧 ekliyor. Bu tek emoji Length'e kaç ekler? 1 mi, 2 mi, daha fazlası mı?
İkinci soru: aynı yorumu bir dosyaya yazınca o emoji kaç byte tutar? Ve "ş" harfi kaç byte tutar? Bunun tek bir cevabı var mı?
Serinin önceki yazılarında sayıların bitlerine baktık. Text de sonunda sayıdır: her karaktere bir numara verilir, o numara da byte'lara çevrilir. Sorunlar, "karakter" kelimesinin bu katmanların her birinde farklı bir şey anlatmasından çıkıyor.
ASCII'den Code Page'lere, Oradan Unicode'a
ASCII (American Standard Code for Information Interchange; İngilizce harfleri, rakamları ve temel işaretleri 0–127 arasına yerleştiren 7 bitlik karakter tablosu) 1960'larda tanımlandı. A 65, a 97, 0 48. Bir byte 8 bit olduğu için 128–255 arası boş kalıyordu ve herkes bu yarıyı kendi diline göre doldurdu. Türkçe için Windows'ta Windows-1254, ISO (International Organization for Standardization; uluslararası standartlar kuruluşu) tarafında ISO-8859-9 kullanıldı; bu tablolara code page denir. Aynı byte, örneğin 0xFE, Türkçe tabloda "ş", Batı Avrupa tablosunda (Windows-1252) "þ" demekti. Byte'ın kendisi hangi tabloya göre yazıldığını söylemediği için dosyayı yanlış tabloyla açan herkes bozuk karakterler gördü.
Unicode bu sorunu tek bir tabloyla çözer: dünyadaki her karaktere tek bir numara verir. Eylül 2026'da yayımlanan Unicode 18.0 itibarıyla tanımlı karakter sayısı 170 binin üzerinde. Unicode yalnızca numarayı tanımlar; numaranın byte'lara nasıl çevrileceği ayrı bir konu, encoding'in konusu. Unicode için tanımlanan encoding'lerin adı UTF (Unicode Transformation Format; Unicode dönüşüm biçimi) ile başlar: UTF-8, UTF-16 ve UTF-32.
Code Point, Plane ve Scalar Value
Unicode'daki her numaraya code point denir ve U+ ile hex yazılır: "a" U+0061, "ç" U+00E7, "₺" U+20BA, "📚" U+1F4DA. Code point aralığı U+0000'dan U+10FFFF'e kadar, yani 17 tane 65.536'lık blok. Bu bloklara plane denir. İlki, U+0000–U+FFFF, BMP'dir (Basic Multilingual Plane; dünyadaki yaygın dillerin neredeyse tamamını içeren ilk plane). Emojilerin çoğu ve tarihî yazılar diğer plane'lerdedir.
U+D800–U+DFFF aralığı özel: bu numaralar hiçbir karaktere verilmez, UTF-16'nın iç mekanizması için ayrılmıştır. Bu aralık dışındaki code point'lere scalar value denir; "geçerli bir Unicode karakteri" dediğimiz şey teknik olarak budur. .NET'teki Rune tipi tam olarak bir scalar value'yu temsil eder.
UTF-8: Değişken Uzunluk, ASCII Uyumu
UTF-8, code point'i 1 ile 4 byte arasında yazar. Küçük numaralar az, büyük numaralar çok byte tutar:
| Code point aralığı | Byte | Bit düzeni |
|---|---|---|
| U+0000 – U+007F | 1 | 0xxxxxxx |
| U+0080 – U+07FF | 2 | 110xxxxx 10xxxxxx |
U+0800 – U+FFFF | 3 | 1110xxxx 10xxxxxx 10xxxxxx |
| U+10000 – U+10FFFF | 4 | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx |
Tabloyu serinin ikinci yazısındaki bitwise işlemlerle doğrudan koda çevirebilirsin:
// RFC 3629 tablosuna göre elle UTF-8
public static byte[] EncodeUtf8(int codePoint) => codePoint switch
{
    <= 0x7F => [(byte)codePoint],
    <= 0x7FF => [(byte)(0xC0 | (codePoint >> 6)), (byte)(0x80 | (codePoint & 0x3F))],
    <= 0xFFFF => [(byte)(0xE0 | (codePoint >> 12)), (byte)(0x80 | ((codePoint >> 6) & 0x3F)), (byte)(0x80 | (codePoint & 0x3F))],
    _ => [(byte)(0xF0 | (codePoint >> 18)), (byte)(0x80 | ((codePoint >> 12) & 0x3F)), (byte)(0x80 | ((codePoint >> 6) & 0x3F)), (byte)(0x80 | (codePoint & 0x3F))],
};

Console.WriteLine(Convert.ToHexString(TextUnits.EncodeUtf8(0x1F4DA)));  // F09F939A
Console.WriteLine(Convert.ToHexString(TextUnits.EncodeUtf8(0x00E7)));   // C3A7
Testte bu fonksiyonu 0 ile U+10FFFF arasındaki scalar value'lar üzerinde Encoding.UTF8 ile karşılaştırdım, sonuçlar aynı. Bu tasarımın üç sonucu var. ASCII metin UTF-8'de byte byte aynı kalır; 1990'lardan kalma bir İngilizce dosya zaten geçerli UTF-8'dir. Çok byte'lı bir karakterin hiçbir byte'ı 0x80'den küçük değildir, yani bir UTF-8 metinde / veya " aradığında yanlışlıkla bir Türkçe karakterin ortasına denk gelmezsin. Ve her byte'ın ilk bitlerine bakarak bir karakterin başında mı ortasında mı olduğunu anlayabilirsin; bozuk bir akışta bir sonraki karakterin başını bulmak kolaydır.
Türkçe karakterlerin hepsi (ç, ğ, ı, İ, ö, ş, ü) 2 byte, ₺ 3 byte, emojiler 4 byte tutar. İkinci sorunun cevabı da bu: "ş" UTF-8'de 2 byte'tır, ama aşağıda göreceğimiz gibi aynı görünen "ş" 3 byte da tutabilir.
UTF-16 ve Surrogate Pair
UTF-16 her code point'i 16 bitlik birimlerle yazar. BMP içindeki karakterler tek bir birim (code unit) tutar. BMP dışındakiler ise iki birime bölünür; buna surrogate pair denir ve U+D800–U+DFFF aralığının ayrılma nedeni budur:
// Elle UTF-16 surrogate pair
public static (char High, char Low) ToSurrogates(int codePoint)
{
    int v = codePoint - 0x10000;
    return ((char)(0xD800 + (v >> 10)), (char)(0xDC00 + (v & 0x3FF)));
}
U+1F4DA'dan 0x10000 çıkarınca 20 bitlik bir sayı kalır. Üst 10 bit 0xD800'e, alt 10 bit 0xDC00'e eklenir: D83D DCDA. Bu sonuç .NET'in kendi string'iyle aynı:
string books = "\U0001F4DA";
Console.WriteLine($"{(int)books[0]:X4} {(int)books[1]:X4} {char.IsHighSurrogate(books[0])} {char.ConvertToUtf32(books, 0):X}");
// D83D DCDA True 1F4DA
Önemli nokta şu: .NET'te string, bir UTF-16 code unit dizisidir ve char bir karakter değil, bir code unit'tir. string.Length code unit sayısını verir. JavaScript ve TypeScript'te de string aynı şekilde UTF-16 tutar. UTF-32 ise her code point'i sabit 4 byte ile yazar; basit ama yer kaplayan bir format olduğu için depolamada ve ağda nadiren kullanılır.
.NET'te Rune, EnumerateRunes ve u8 Literal
.NET Core 3.0 ile gelen System.Text.Rune bir scalar value'yu temsil eder ve surrogate pair'leri senin yerine birleştirir:
foreach (Rune rune in "aç₺\U0001F4DA".EnumerateRunes())
{
    byte[] utf8 = new byte[4];
    int n = rune.EncodeToUtf8(utf8);
    char[] utf16 = new char[2];
    int m = rune.EncodeToUtf16(utf16);
    Console.WriteLine($"U+{rune.Value:X4}  {rune}  utf8={Convert.ToHexString(utf8, 0, n),-8}  utf16={string.Join(" ", utf16[..m].Select(c => ((int)c).ToString("X4")))}  {Rune.GetUnicodeCategory(rune)}");
}
U+0061 a utf8=61 utf16=0061 LowercaseLetter
U+00E7 ç utf8=C3A7 utf16=00E7 LowercaseLetter
U+20BA ₺ utf8=E282BA utf16=20BA CurrencySymbol
U+1F4DA 📚 utf8=F09F939A utf16=D83D DCDA OtherSymbolKarakter kategorisi gibi bilgiler runtime'ın kendi Unicode verisinden gelir. .NET 10'un verisi Unicode 16.0'a göre; Unicode 17.0'da eklenen Sidetic alfabesinin ilk karakteri U+10940 için CharUnicodeInfo.GetUnicodeCategory OtherNotAssigned döndürüyor, Unicode 16.0'da eklenen Garay alfabesindeki U+10D40 için ise DecimalDigitNumber. Yeni emojiler tarayıcıda görünse de sunucudaki kategori kontrolü onları henüz tanımayabilir.
C# 11'den beri UTF-8 byte'larını doğrudan derleme zamanında üretebilirsin: "Kitapçı"u8 bir ReadOnlySpan<byte> verir. HTTP header'ı, JSON property adı gibi sabit metinleri her seferinde encode etmemek için kullanılır:
ReadOnlySpan<byte> literal = "Kitapçı"u8;
Console.WriteLine($"{literal.Length} {Convert.ToHexString(literal)}");   // 9 4B69746170C3A7C4B1
Dosya yazarken dikkat edilmesi gereken bir ayrıntı BOM (Byte Order Mark; dosyanın başına encoding'i belli etmek için konan özel byte'lar). UTF-8'de BOM EF BB BF'dir. File.WriteAllText varsayılan olarak BOM'suz UTF-8 yazar, ama Encoding.UTF8'i açıkça verirsen BOM ekler:
File.WriteAllText("default.txt", "Kitapçı");
File.WriteAllText("with-bom.txt", "Kitapçı", Encoding.UTF8);
File.WriteAllText("no-bom.txt", "Kitapçı", new UTF8Encoding(false));
default.txt 9 bytes 4B69746170C3A7C4B1
with-bom.txt 12 bytes EFBBBF4B69746170C3A7C4B1
no-bom.txt 9 bytes 4B69746170C3A7C4B1Dosya okuma ve yazmanın genel kullanımı C# Temelleri serisinin "C# Dosya ve Konsol: ReadLine, File, Path, Directory, using ve Encoding" yazısında anlatıldı. BOM'un ne zaman gerekli olduğunu ve eksik olduğunda Excel'in Türkçe karakterleri nasıl bozduğunu serinin sonraki yazısında göreceğiz.
Grapheme Cluster: Kullanıcının Gördüğü Karakter
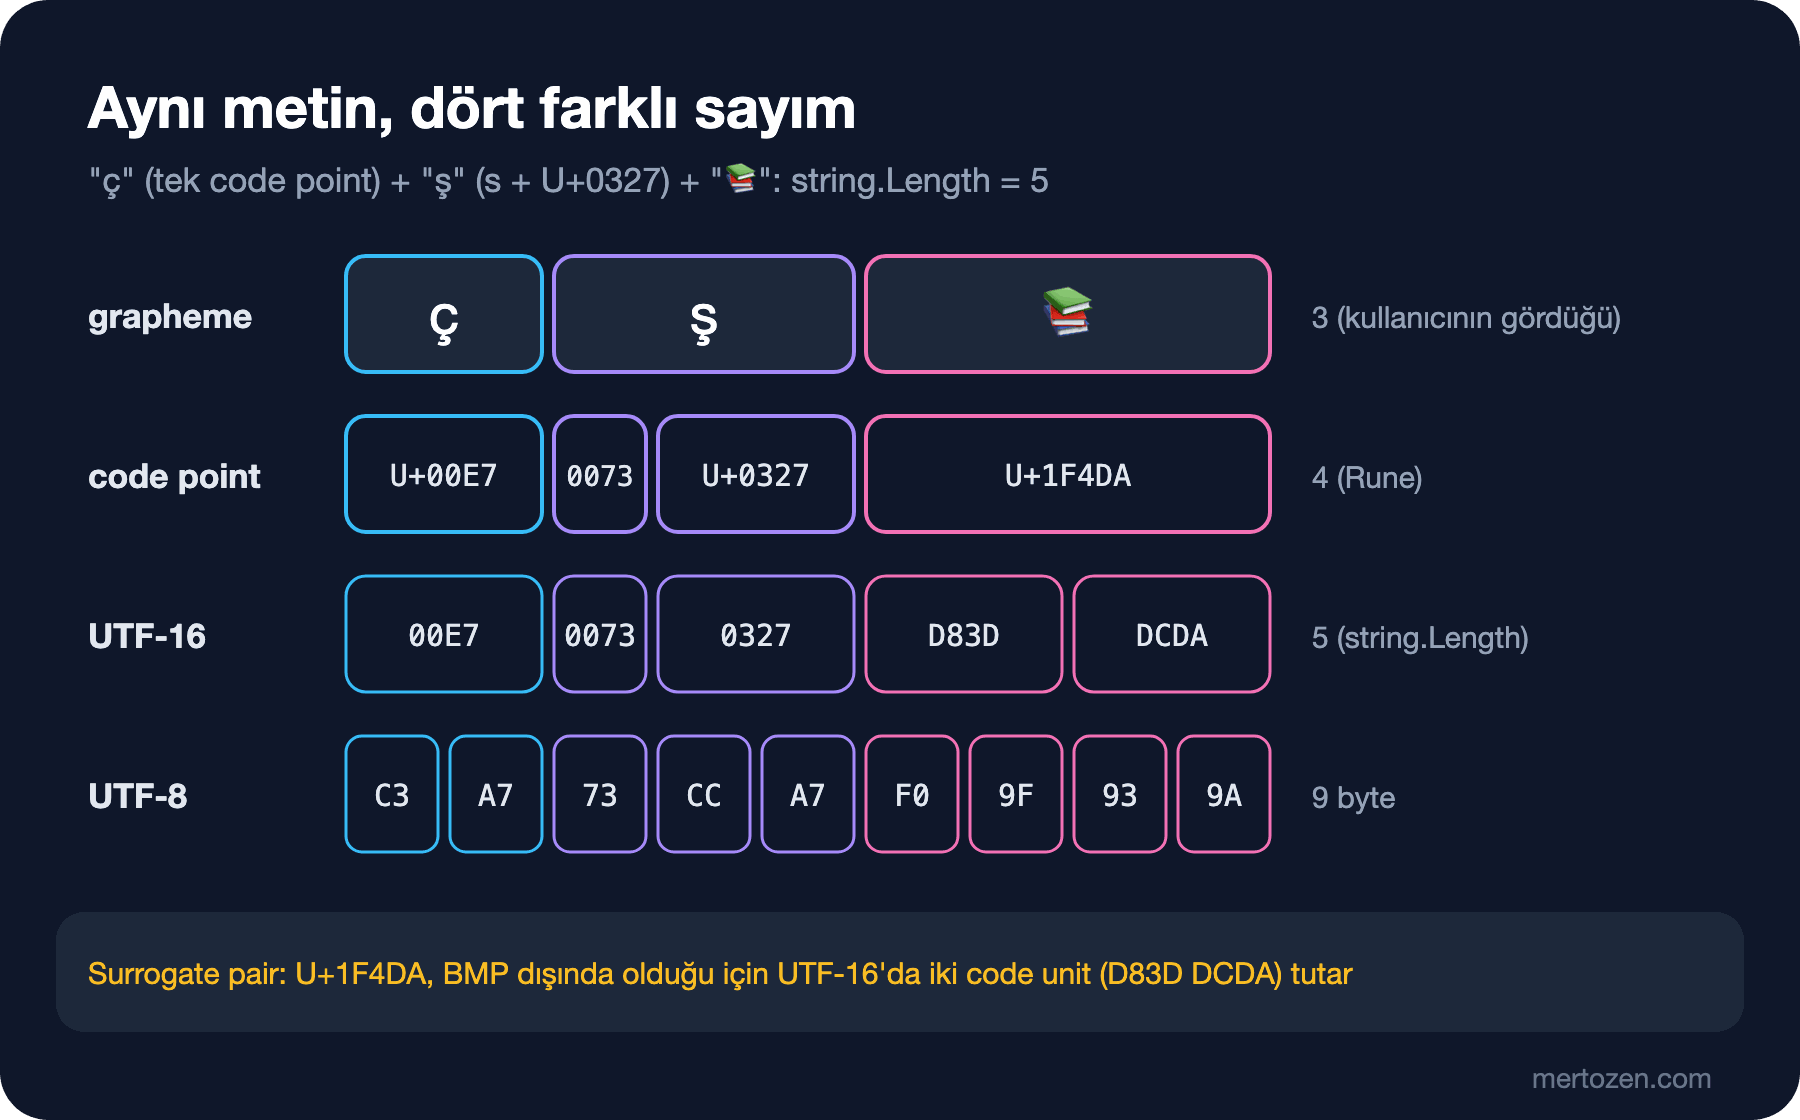
Ekranda tek bir karakter olarak gördüğün şey birden fazla code point'ten oluşabilir. "ş" iki şekilde yazılabilir: tek code point olarak U+015F, ya da "s" (U+0073) ve ardından birleşen çengel işareti (U+0327). Aile emojisi ise üç kişi emojisinin arasına iki tane ZWJ (Zero Width Joiner; iki emojiyi tek bir emoji olarak birleştiren görünmez karakter, U+200D) konarak yazılır:
string family = "\U0001F468\u200D\U0001F469\u200D\U0001F467";
Console.WriteLine(string.Join(" ", family.EnumerateRunes().Select(r => $"U+{r.Value:X4}")));
// U+1F468 U+200D U+1F469 U+200D U+1F467
Kullanıcının tek karakter olarak algıladığı bu birime grapheme cluster denir; sınırlarının nasıl bulunacağını Unicode standardının UAX (Unicode Standard Annex; standardın ek dokümanları) serisindeki 29 numaralı doküman, Text Segmentation tanımlar. .NET 5'ten beri StringInfo bu kurallara uyuyor. Dört farklı sayım yan yana:
public static string Describe(string text) =>
    $"chars={text.Length} runes={text.EnumerateRunes().Count()} " +
    $"utf8={Encoding.UTF8.GetByteCount(text)} graphemes={new StringInfo(text).LengthInTextElements}";
Kitap chars=5 runes=5 utf8=5 graphemes=5
Kitapçı chars=7 runes=7 utf8=9 graphemes=7
ş (U+015F) chars=1 runes=1 utf8=2 graphemes=1
ş (s + U+0327) chars=2 runes=2 utf8=3 graphemes=1
books emoji chars=2 runes=1 utf8=4 graphemes=1
family emoji chars=8 runes=5 utf8=18 graphemes=1İlk sorunun cevabı: aile emojisi Length'e 8 ekler. Kullanıcı tek bir karakter yazdı; Length 8, Rune sayısı 5, UTF-8 18 byte. 280 sınırını Length ile kontrol eden kod, 35 aile emojisinden sonra yorumu reddeder.
TypeScript'te aynı dört sayım:
const books = "\u{1F4DA}";
const family = "\u{1F468}\u200D\u{1F469}\u200D\u{1F467}";
const segmenter = new Intl.Segmenter("tr", { granularity: "grapheme" });
const graphemes = (s: string) => [...segmenter.segment(s)].length;

for (const s of ["Kitapçı", "s\u0327", books, family]) {
  console.log(s.length, [...s].length, new TextEncoder().encode(s).length, graphemes(s));
}
// 7 7 9 7
// 2 2 3 1
// 2 1 4 1
// 8 5 18 1
console.log(books.charCodeAt(0).toString(16), books.charCodeAt(1).toString(16), books.codePointAt(0)?.toString(16));
// d83d dcda 1f4da
[...s] string'i code point'lere böler (C#'taki EnumerateRunes gibi), Intl.Segmenter ise grapheme'lere. TextEncoder her zaman UTF-8 üretir.
Bookstore Yorum Alanı: 280 Karakter Nasıl Sayılır
"280 karakter" kuralının iki ayrı ihtiyacı var. Kullanıcıya gösterilen sınır grapheme ile sayılmalı, çünkü kullanıcı karakteri böyle görür ve frontend'deki sayaç da Intl.Segmenter ile aynı sonucu vermeli. Veritabanı sınırı ise kolonun neyi saydığına bağlı. SQL Server'da nvarchar(n)'deki n, UTF-16 code unit sayısıdır, yani .NET'teki string.Length ile aynı birim. İki kontrolü ayrı yapan bir kural:
public sealed record ReviewCheck(int Graphemes, int Utf16Units, int Utf8Bytes, bool FitsUi, bool FitsColumn);

public static class ReviewRules
{
    public const int MaxGraphemes = 280;
    public const int ColumnUnits = 1000; // nvarchar(1000)

    public static ReviewCheck Check(string text)
    {
        int graphemes = new StringInfo(text).LengthInTextElements;
        return new ReviewCheck(graphemes, text.Length, Encoding.UTF8.GetByteCount(text),
            graphemes <= MaxGraphemes, text.Length <= ColumnUnits);
    }
}
ReviewCheck { Graphemes = 38, Utf16Units = 38, Utf8Bytes = 38, FitsUi = True, FitsColumn = True }
ReviewCheck { Graphemes = 280, Utf16Units = 2240, Utf8Bytes = 5040, FitsUi = True, FitsColumn = False }
ReviewCheck { Graphemes = 281, Utf16Units = 281, Utf8Bytes = 281, FitsUi = False, FitsColumn = True }İkinci satır 280 aile emojisinden oluşan bir yorum: kullanıcıya göre sınırın içinde, ama 2240 code unit ile nvarchar(1000)'e sığmıyor. Kolonu "280 × 8" diye boyutlandırmak yerine iki sınırı da açıkça kontrol et ve veritabanına sığmayan ama kullanıcı sınırını geçmeyen durum için anlamlı bir hata ver. Bir grapheme'in kaç code unit tutabileceğinin pratik bir üst sınırı olmadığını da unutma; birleşen işaretler üst üste eklenebilir.
Kısaltma gerektiğinde de grapheme sınırına saygı göster. Liste sayfasında yorumun ilk birkaç karakterini gösterirken:
public static string TruncateGraphemes(string text, int maxGraphemes)
{
    int length = 0;
    int count = 0;
    while (length < text.Length && count < maxGraphemes)
    {
        length += StringInfo.GetNextTextElementLength(text.AsSpan(length));
        count++;
    }
    return text[..length];
}
Üretimde Dikkat
Encoding'i her sınırda açıkça belirt: dosya yazarken, HTTP yanıtında, veritabanı kolonunda, mesaj kuyruğunda. Varsayılan değerler platformdan platforma değişebilir; açıkça yazılmış new UTF8Encoding(false) değişmez.
Sunucu tarafındaki uzunluk kontrolünü frontend'deki sayaçla aynı birimde yap. Frontend Intl.Segmenter ile 280 gösterirken backend Length ile 300 sayıyorsa kullanıcı "280'in altındayım" dediği yorumu kaydedemez ve hatayı anlamaz.
Runtime'ın Unicode sürümünü bil. Karakter kategorisine göre doğrulama yapıyorsan (örneğin "yalnızca harf ve rakam") yeni eklenen karakterler sunucuda OtherNotAssigned görünebilir. Bu tür kontrolleri gerçekten gerekli yerlerle sınırla.
LLM'e (Large Language Model; büyük dil modeli) gönderilen metinde karakter sayısı ile token sayısı farklı şeyler. Model sınırları token'la ölçülür ve Türkçe metin İngilizceden daha fazla token tutar; ayrıntısı LLM Temelleri serisinin "LLM'lerde Token ve Tokenizer: Türkçe Neden Daha Çok Token Tutar?" yazısında.
Sık Düşülen Tuzaklar
Substring ile surrogate pair'i ortadan bölmek. Yalnız kalan bir high surrogate geçerli bir karakter değildir ve UTF-8'e çevrilince yerine U+FFFD (yerine geçme karakteri, ekranda �) yazılır:
string banner = "\U0001F4DA New arrivals";
string cut = banner.Substring(0, 1);
Console.WriteLine($"{cut.Length} {char.IsSurrogate(cut[0])}");          // 1 True
Console.WriteLine(Convert.ToHexString(Encoding.UTF8.GetBytes(cut)));     // EFBFBD
Console.WriteLine(TextUnits.TruncateGraphemes(banner, 1));               // 📚
Hata fırlatılmaz, veri sessizce bozulur. Bozuk veriyi kabul etmek yerine hata almak istiyorsan new UTF8Encoding(false, throwOnInvalidBytes: true) kullan; bu encoder aynı string için EncoderFallbackException fırlatır. JavaScript'te ES2024 ile gelen isWellFormed() ve toWellFormed() aynı kontrolü yapar.
Büyük harfe çevirmenin uzunluğu değiştirmeyeceğini varsaymak. JavaScript tam Unicode büyük harf eşlemesini uygular; .NET ise karakter başına basit eşleme kullanır ve uzunluğu korur:
Console.WriteLine($"{"straße".ToUpperInvariant()} {"straße".ToUpperInvariant().Length}");  // STRAßE 6
Console.WriteLine($"{"\uFB01le".ToUpperInvariant()} {"\uFB01le".ToUpperInvariant().Length}");        // fiLE 3
console.log("straße".toUpperCase(), "straße".toUpperCase().length); // STRASSE 7
console.log("\uFB01le".toUpperCase(), "\uFB01le".toUpperCase().length); // FILE 4Aynı metin iki tarafta farklı uzunlukta ve farklı içerikte büyük harfe çevriliyor. Büyük harfe çevrilmiş metni karşılaştırma ya da unique key olarak kullanıyorsan iki tarafın aynı sonucu vermediğini hesaba kat. Türkçe I ile ilgili culture tuzağı ayrı bir konu ve C# Temelleri serisinin "C# String'ler: Interpolation, StringBuilder ve Türkçe I Tuzağı" yazısında anlatıldı.
Byte limiti ile karakter limitini karıştırmak. Bir mesaj kuyruğu, HTTP header'ı ya da varchar kolonu byte sınırıyla çalışıyorsa 100 karakterlik Türkçe metin 100 byte değildir. Sınırı her zaman ölçtüğün birimle (byte, code unit, grapheme) adlandır.
Küçük Bir Deneme
★☆☆ Kendi adını ve soyadını TextUnits.Describe ile ölç. Türkçe karakter varsa UTF-8 byte sayısının Length'ten ne kadar büyük olduğunu kontrol et ve her Türkçe karakter için Rune ile code point'ini yazdır.
★★☆ EncodeUtf8'in tersini yaz: bir byte dizisinden code point'leri çıkaran bir DecodeUtf8. Geçersiz bir başlangıç byte'ı ya da eksik devam byte'ı gördüğünde U+FFFD üretsin. Sonucu Encoding.UTF8.GetString ile birkaç bozuk girdi üzerinde karşılaştır.
★★★ Bookstore yorum formu için Angular tarafında Intl.Segmenter kullanan bir karakter sayacı, backend'de ReviewRules kullanan bir doğrulama yaz. Emoji, birleşen işaret ve Türkçe karakter içeren 20 örnek metin için iki tarafın aynı sayıyı verdiğini gösteren bir test hazırla.
Bu yazıda bir karakterin byte'lara nasıl dönüştüğünü gördük. Serinin son yazısı "Text'i Doğru İşlemek: Normalization, Mojibake Teşhisi ve Base64" ters yönü anlatıyor: aynı görünen iki string'in neden eşit olmadığını, "ÅŸ" gibi bozuk karakterleri hex dump ile nasıl teşhis edeceğini ve binary veriyi text'e çeviren Base64'ü göreceğiz.