

Regular Expression Nasıl Okunur? Literal, Metakarakter, Character Class, Anchor ve Escape Kuralları
Engine pattern'i input'un her başlangıç pozisyonunda soldan sağa dener ve en soldaki eşleşmeyi döndürür; metakarakterleri kaçışlamak, character class aralıklarını doğru yazmak ve anchor'ları bilmek bu yüzden şart. .NET'te \d'nin Arap-Hint rakamlarını, $'ın sondaki \n'i kabul ettiğini gerçek çıktılarla gösteriyor, ISBN-13 ve sipariş numarasını .NET, JavaScript ve grep ile doğruluyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10 (SDK 10.0.404), Node.js 26.13 (LTS), grep 3.12 (GNU), PCRE2 (Perl uyumlu regex library'si) 10.49, pcre2test 10.49 ve ripgrep 15.2.0 ile denenmiştir. grep, rg ve pcre2test komutları Linux'ta, WSL'de (Windows içindeki Linux ortamı) ya da Git Bash'te çalışır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'da (bir online kitapçı) müşteri, iade formuna sipariş numarasını yazıyor. Numara BKS-2026-000123 biçiminde: önek, yıl, altı haneli sıra. Angular formu numarayı JavaScript ile, API aynı numarayı .NET ile kontrol ediyor ve iki tarafta da aynı pattern var:
^BKS-\d{4}-\d{6}$İki müşteri formu biraz farklı dolduruyor. Birincisi numarayı e-postadan kopyalıyor ve sonuna bir satır sonu karakteri geliyor: "BKS-2026-000123\n". İkincisi telefonunda Arapça klavye açık olduğu için rakamları Arap-Hint rakamlarıyla yazıyor: "BKS-2026-٠٠٠١٢٣". Bu iki input için .NET ve JavaScript ne der? İkisi aynı cevabı verir mi? Bir tahmin yap; cevap yazının ortasında, gerçek çıktılarla.
Engine Bir Pattern'i Nasıl Dener?
Regular expression okumayı öğrenmenin en kısa yolu, engine'in ne yaptığını bir kez adım adım görmek. JavaScript Temel serisinin "JavaScript RegEx Temelleri" yazısında test, match, replace, temel character class'lar, quantifier'lar ve g/i/m flag'leri anlatıldı; burada onları tekrar etmeyeceğiz, altlarındaki mekanizmaya bakacağız. Bu seri bir dil serisi değil: her konuda .NET, JavaScript ve komut satırı karşılığını yan yana çalıştıracağız.
PCRE2 ile gelen pcre2test aracı (grep -P ve Nginx de bu library'yi kullanır), auto_callout seçeneğiyle engine'in her adımını yazdırabiliyor. Pattern BKS-\d, input BK BKS-7:
$ cat shell/trace.txt
/BKS-\d/auto_callout,no_start_optimize
BK BKS-7
$ pcre2test shell/trace.txt
PCRE2 version 10.49 2026-09-28 (8-bit)
/BKS-\d/auto_callout,no_start_optimize
BK BKS-7
--->BK BKS-7
 +0 ^            B
 +1 ^^           K
 +2 ^ ^          S
 +0  ^           B
 +0   ^          B
 +0    ^         B
 +1    ^^        K
 +2    ^ ^       S
 +3    ^  ^      -
 +4    ^   ^     \d
 +6    ^    ^    End of pattern
 0: BKS-7
Her satırda soldaki ^ denemenin başladığı pozisyonu, ikinci ^ engine'in o an input'ta nerede olduğunu, en sağdaki sütun da pattern'in sıradaki parçasını gösteriyor. Engine 0. pozisyonda başlıyor: B tutuyor, K tutuyor, S boşluğa çarpıyor. Bu deneme bitti; engine başlangıç noktasını bir kaydırıyor. 1. pozisyonda K var, B tutmuyor. 2. pozisyonda boşluk var, yine tutmuyor. 3. pozisyonda pattern'in bütün parçaları sırayla tutuyor ve eşleşme BKS-7 oluyor.
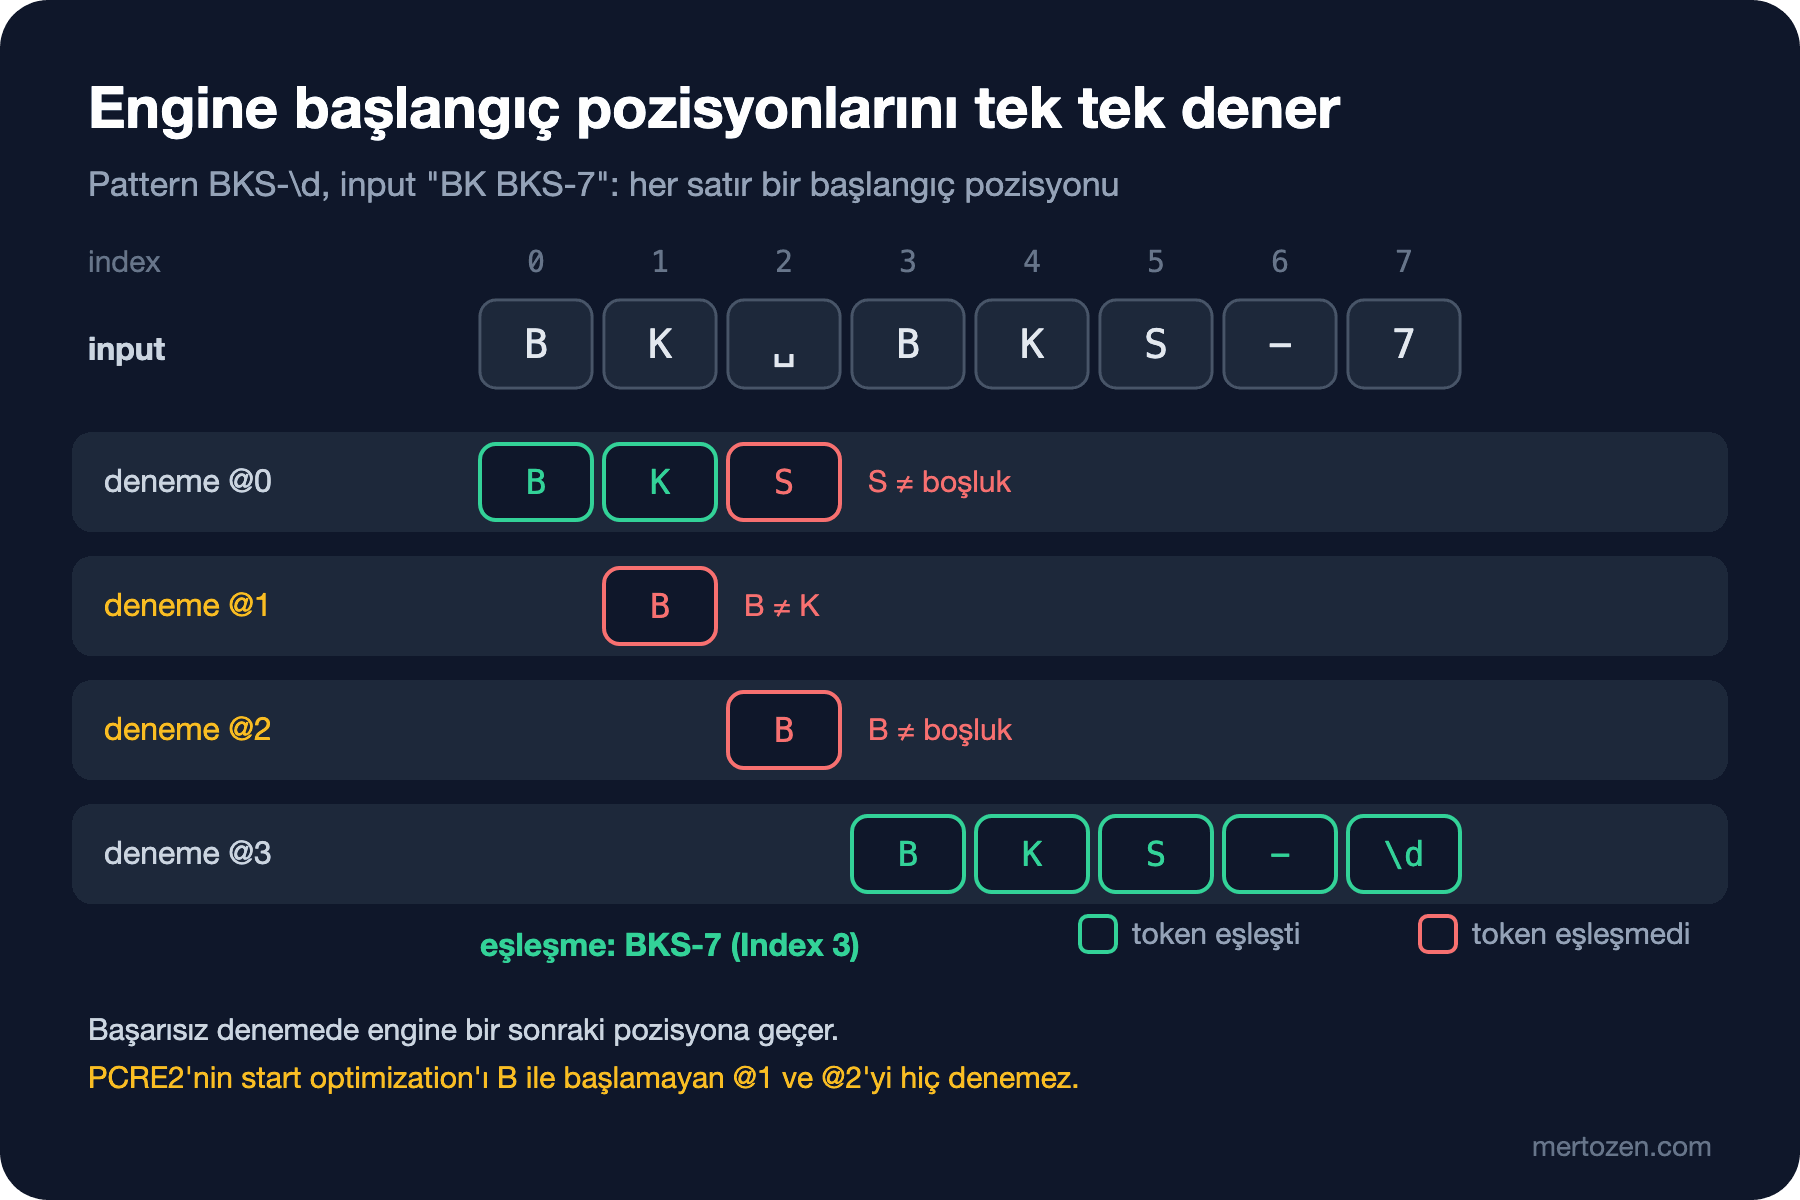
Bu basit mekanizmadan iki önemli sonuç çıkıyor. Birincisi, anchor kullanmadığın sürece pattern input'un herhangi bir yerinde eşleşebilir; "en soldaki" eşleşme kazanır. İkincisi, başarısız denemelerin bir maliyeti var ve bu maliyet input uzadıkça büyür. no_start_optimize seçeneğini kaldırınca PCRE2'nin bu işi nasıl kısalttığı görülüyor:
$ pcre2test shell/trace-optimized.txt
PCRE2 version 10.49 2026-09-28 (8-bit)
/BKS-\d/auto_callout
BK BKS-7
--->BK BKS-7
 +0 ^            B
 +1 ^^           K
 +2 ^ ^          S
 +0    ^         B
 +1    ^^        K
 +2    ^ ^       S
 +3    ^  ^      -
 +4    ^   ^     \d
 +6    ^    ^    End of pattern
 0: BKS-7
Pattern B harfiyle başlamak zorunda olduğu için engine 1. ve 2. pozisyonları hiç denemedi. Hem .NET'in hem V8'in (Chrome ve Node.js'in JavaScript engine'i) benzer optimizasyonları var. Yani adım sayısı engine'e göre değişir, ama mantık aynı: başlangıç pozisyonu seç, pattern'i parça parça dene, olmazsa bir sonraki pozisyona geç. .NET, JavaScript ve PCRE2 bu işi backtracking ile yapan engine'ler; bir parça tutmadığında geri dönüp başka bir yol denerler. Bunun ayrıntısını bir sonraki yazıda quantifier'larla göreceğiz.
Literal ve Metakarakter: Hangi Karakter Kendisi Değil?
Pattern'deki karakterlerin çoğu literal'dir: B yalnızca B ile eşleşir. Özel anlamı olan karakterlere metakarakter denir ve listesi kısa: . ^ $ * + ? ( ) [ ] { } | \. JavaScript'te literal yazımda / da pattern'i bitirdiği için kaçış ister. Bunlardan birini kendisi olarak aramak istediğinde önüne \ koyarsın.
En sık yapılan hata nokta. Müşteri e-postalarını alan adına göre süzerken:
$ cat data/emails.txt
orders@example.com
orders@exampleXcom
$ grep -E '@example.com$' data/emails.txt
orders@example.com
orders@exampleXcom
$ grep -E '@example\.com$' data/emails.txt
orders@example.com
$ grep -F '@example.com' data/emails.txt
orders@example.com
Kaçışsız nokta "herhangi bir karakter" demek olduğu için exampleXcom da geçti. Aradığın şey sabit bir metinse en iyisi regex kullanmamak: grep -F, C#'ta string.Contains, JavaScript'te includes metni olduğu gibi arar.
Pattern'in bir kısmı kullanıcıdan geliyorsa kaçışı elle yapmazsın; iki platformun da hazır fonksiyonu var:
using System.Text.RegularExpressions;

string term = "Dune (1965).";
string text = "Dune (1965). Frank Herbert";

Console.WriteLine(Regex.Escape(term));
Console.WriteLine(Regex.IsMatch(text, "^" + Regex.Escape(term)));

try
{
    Regex.IsMatch(text, "^" + "Dune (1965");
}
catch (ArgumentException ex)
{
    Console.WriteLine(ex.Message);
}
$ dotnet run dotnet/escape.cs
Dune\ \(1965\)\.
True
Invalid pattern '^Dune (1965' at offset 11. Not enough )'s.
$ node js/escape.mjs
\x44une\x20\(1965\)\.
true
SyntaxError: Invalid regular expression: /^Dune (1965/: Unterminated groupC# örnekleri .NET 10'un file-based app özelliğiyle tek bir .cs dosyası olarak çalışıyor; proje dosyası gerekmiyor. JavaScript tarafındaki RegExp.escape Mayıs 2025'ten beri bütün güncel tarayıcılarda var. Baştaki D harfini \x44 olarak kaçışlaması tuhaf görünebilir; bunun sebebi, kaçışlanmış metin \1 gibi bir ifadenin hemen arkasına eklendiğinde rakam ya da harfin o ifadeye karışmasını önlemek. Çıktılar farklı ama iki fonksiyon da aynı işi yapıyor: metindeki her metakarakteri literal'e çeviriyor. C#'ta pattern'leri @"..." verbatim string ile yazmanın sebebi de bu: \d içindeki ters bölü C# string'i tarafından yorumlanmadan engine'e ulaşır.
Character Class: Köşeli Parantezin İçi
[...] tek bir karakterle eşleşir; içindeki listeden herhangi biri olabilir. [^...] listede olmayan herhangi bir karakter demektir. Aralıklar [0-9], [a-f] gibi yazılır. Köşeli parantezin içinde kurallar değişir: dışarıdaki metakarakterlerin çoğu burada sıradan karakterdir. [.] gerçek bir noktadır, [+*?] bu üç işaretten biridir. İçeride özel olan yalnızca dört karakter var: \, kapanış ], başta duran ^ ve iki karakter arasında duran -. Tire'yi literal istiyorsan başa ya da sona koyarsın: [0-9-] bir rakam ya da tire demek.
Aralıklar karakter kodlarına göre çalışır ve burada bilinen bir tuzak var. [A-z] "bütün harfler" gibi görünür, ama ASCII (128 karakterlik temel İngilizce karakter seti) tablosunda Z ile a arasında altı karakter daha durur:
// [A-z] "bütün harfler" değil: [ \ ] ^ _ ` karakterlerini de kapsar
Console.WriteLine(string.Concat(Regex.Matches("A_z^`[", "[A-z]").Select(m => m.Value)));
$ dotnet run dotnet/shorthand.cs | sed -n 6p
A_z^`[
$ printf 'A_z^`[\n' | grep -oP '[A-z]' | tr -d '\n'
A_z^`[
$ printf 'A_z^`[\n' | grep -oE '[A-z]'
grep: Invalid range end
$ printf 'A_z^`[\n' | LC_ALL=C grep -oE '[A-z]' | tr -d '\n'
A_z^`[.NET, JavaScript ve PCRE2 altı karakterin hepsini harf saydı. GNU grep'in -E modu ise, yani POSIX (Unix araçlarının uyduğu standart) tanımındaki ERE (genişletilmiş regular expression syntax'ı), en_US.UTF-8 locale'inde bu aralığı hiç kabul etmedi; C locale'inde diğerleri gibi davrandı. GNU grep kılavuzu da C dışındaki locale'lerde aralıkların davranışının tanımsız olduğunu söylüyor. Harf istiyorsan [A-Za-z] yaz, Türkçe harfler de gerekiyorsa birazdan göreceğimiz Unicode yollarına bak.
\d, \w, \s: Kısaltmaların Flavor'a Göre Anlamı
\d rakam, \w harf, rakam ya da alt çizgi, \s boşluk karakteri demek; büyük harfli hâlleri tersini anlatır. Buraya kadar bütün regex dünyası anlaşıyor. Ayrıştıkları nokta, "rakam" ve "harf"in hangi alfabeye göre sayıldığı. Farklı regex engine'lerinin bu tür syntax ve davranış farklarına flavor denir ve serinin beşinci yazısı tamamen bu konuya ayrıldı. Burada yalnızca kısaltmalara bakalım:
using System.Text.RegularExpressions;

// .NET'te \d, \w ve \s Unicode'a göre çalışır; RegexOptions.ECMAScript bunu kapatır
Console.WriteLine(Regex.IsMatch("٣", @"^\d$"));                               // Arap-Hint rakamı üç
Console.WriteLine(Regex.IsMatch("٣", @"^\d$", RegexOptions.ECMAScript));
Console.WriteLine(Regex.IsMatch("Şükrü", @"^\w+$"));
Console.WriteLine(Regex.IsMatch("Şükrü", @"^\w+$", RegexOptions.ECMAScript));
Console.WriteLine(Regex.IsMatch("\u00A0", @"^\s$"));                          // bölünemez boşluk
$ dotnet run dotnet/shorthand.cs | head -5
True
False
True
False
True
$ node js/shorthand.mjs | head -3
false false true
false false true
trueJavaScript dosyasındaki ilk iki satır \d ve \w'yu flag'siz ve u flag'iyle, üçüncüsü de \p{Nd} ve \p{L} ile deniyor. Komut satırı araçlarının sonuçları da şöyle:
$ printf '٣\n' | grep -cP '^\d$'
0
$ printf 'Şükrü\n' | grep -cP '^\w+$'
1
$ grep -E '^BKS-\d{4}-\d{6}$' data/order-numbers.txt
grep: warning: stray \ before d
grep: warning: stray \ before d
$ printf 'Şükrü\n' | grep -cE '^\w+$'
1
$ printf 'Şükrü\n' | LC_ALL=C grep -cE '^\w+$'
0
$ rg '^BKS-\d{4}-\d{6}$' data/order-numbers.txt
BKS-2026-000123
BKS-2026-٠٠٠١٢٣
Tabloya dökünce fark netleşiyor:
| Kısaltma | .NET | JavaScript | grep -P (PCRE2) | grep -E (POSIX ERE) | ripgrep |
|---|---|---|---|---|---|
\d | Unicode rakamları (٣ dahil) | yalnız 0-9, u ile de | yalnız 0-9 | yok; \d düz d olur | Unicode rakamları |
\w | Unicode harfler | yalnız ASCII | Unicode harfler | locale'e bağlı | Unicode harfler |
| Unicode istersen | varsayılan | \p{Nd}, \p{L} ve u | varsayılan (\w) | [[:digit:]], [[:alpha:]] | varsayılan |
Tahminin cevabının yarısı burada: .NET'te \d Arap-Hint rakamlarını da rakam sayıyor, JavaScript saymıyor. PCRE2 kütüphanesi kendi başına Unicode modunda \d'yi genişletebiliyor (ucp seçeneği), ama GNU grep -P'de \d'yi bilinçli olarak ASCII'de tutuyor; kılavuz bunu açıkça yazıyor. Sipariş numarası, posta kodu, telefon gibi alanlarda kastettiğin neredeyse her zaman 0-9'dur. Bu yüzden doğrulama pattern'lerinde [0-9] yazmak her flavor'da aynı sonucu verir. .NET'te RegexOptions.ECMAScript da \d ve \w'yu ASCII'ye çeker, ama bu option yalnızca IgnoreCase, Multiline ve Compiled ile birleştirilebiliyor; diğerleriyle exception fırlatıyor.
Anchor'lar: ^, $, \A, \z ve \b
Anchor bir karakterle değil, bir pozisyonla eşleşir. ^ başı, $ sonu, \b kelime sınırını gösterir. Multiline modunda ^ ve $ her satırın başını ve sonunu gösterir. Tahminin ikinci yarısı $'ın ayrıntısında saklı:
using System.Text.RegularExpressions;

string batch = "BKS-2026-000123\nBKS-2026-000124\nBKS-2026-000125\n";

// Multiline olmadan ^ ve $ bütün string'in başı ve sonudur
Console.WriteLine(Regex.Matches(batch, @"^BKS-\d+-\d+$").Count);
Console.WriteLine(Regex.Matches(batch, @"^BKS-\d+-\d+$", RegexOptions.Multiline).Count);

// $ sondaki \n'den önce de eşleşir; \z eşleşmez, \Z ise $ gibi davranır
string input = "BKS-2026-000123\n";
Console.WriteLine($"{Regex.IsMatch(input, @"^BKS-\d+-\d+$")} {Regex.IsMatch(input, @"\ABKS-\d+-\d+\Z")} {Regex.IsMatch(input, @"\ABKS-\d+-\d+\z")}");

// \b, .NET'in Unicode \w'suna göre çalışır; "kitapçı"da "kitap"tan sonra sınır yoktur
Console.WriteLine(Regex.IsMatch("kitapçı", @"\bkitap\b"));
$ dotnet run dotnet/anchors.cs
0
3
True True False
False
$ node js/anchors.mjs
null
3
false
true true.NET'te ve PCRE2'de $, string'in sonundaki tek bir \n'den hemen önce de eşleşir. Bu, Perl'den gelen ve satır sonuyla biten metinleri rahat işlemek için konmuş bir kural; doğrulama yaparken ise açık bir kapı. .NET'te gerçekten "string burada bitiyor" demek istiyorsan \z kullanırsın. \A ve \z Multiline'dan etkilenmez, \Z ise $ gibi sondaki \n'e izin verir. PCRE2'de de aynı \A, \z ve \Z var. JavaScript'te \A ve \z yok; ama m flag'i olmadan $ zaten yalnızca en sonu gösteriyor, bu yüzden JavaScript yukarıdaki input'a false dedi.
Son satırlar \b'nin flavor farkını gösteriyor. JavaScript'in \w'su ASCII olduğu için ç onun gözünde harf değil ve kitap ile ç arasında bir "kelime sınırı" görüyor; u flag'i de bunu değiştirmiyor. .NET, grep -E, grep -P ve ripgrep aynı input'ta eşleşme bulmadı. Türkçe metinde \b'ye güvenmeden önce hangi engine'de çalıştığına bak; Unicode ve Türkçe karakterleri dördüncü yazıda ayrıntılı ele alacağız.
Şimdi tahminin tamamı. Aynı pattern ve düzeltilmiş hâli .NET'te:
using System.Text.RegularExpressions;

string[] inputs =
[
    "BKS-2026-000123",
    "BKS-2026-000123\n",
    "BKS-2026-٠٠٠١٢٣",
];

string[] patterns = [@"^BKS-\d{4}-\d{6}$", @"^BKS-[0-9]{4}-[0-9]{6}\z"];

foreach (string pattern in patterns)
{
    Console.WriteLine(pattern);
    foreach (string input in inputs)
    {
        bool ok = Regex.IsMatch(input, pattern);
        Console.WriteLine($"  {Show(input),-26} {ok}");
    }
}

// \n'i görünür yazmak için
static string Show(string s) => "\"" + s.Replace("\n", "\\n") + "\"";
$ dotnet run dotnet/order-number.cs
^BKS-\d{4}-\d{6}$
"BKS-2026-000123" True
"BKS-2026-000123\n" True
"BKS-2026-٠٠٠١٢٣" True
^BKS-[0-9]{4}-[0-9]{6}\z
"BKS-2026-000123" True
"BKS-2026-000123\n" False
"BKS-2026-٠٠٠١٢٣" False
$ node js/order-number.mjs
/^BKS-\d{4}-\d{6}$/
"BKS-2026-000123" true
"BKS-2026-000123\n" false
"BKS-2026-٠٠٠١٢٣" false
/^BKS-\d{4}-\d{6}$/u
"BKS-2026-000123" true
"BKS-2026-000123\n" false
"BKS-2026-٠٠٠١٢٣" falseAynı pattern .NET'te üç input'u da kabul etti, JavaScript'te yalnızca ilkini. Angular formu geçmeyen bir numarayı API kabul ediyor; tersi de olabilirdi. [0-9] ve \z ile yazılan ikinci pattern iki tarafta aynı sonucu veriyor.
Bookstore: ISBN-13 ve Sipariş Numarası
ISBN (kitapların uluslararası standart numarası) 13 haneli ve tireli yazıldığında beş parçadan oluşur: 978 ya da 979 öneki, kayıt grubu, yayıncı, yayın numarası ve kontrol hanesi. Dune'un 978-0-441-17271-9 numarasında parçaların uzunlukları 3-1-3-5-1. Ortadaki üç parçanın uzunluğu değişir, toplam hane sayısı değişmez. Regex şekli kontrol eder, kontrol hanesini hesaplamak ise kodun işi:
using System.Text.RegularExpressions;

string[] inputs = ["978-0-441-17271-9", "978-0-141-43958-7", "978-0-441-17271-8", "978-0441-17271-9", "978-0-441-17271-9\n", "977-0-441-17271-9"];

foreach (string input in inputs)
    Console.WriteLine($"{input.Replace("\n", "\\n"),-20} {IsIsbn13(input)}");

static bool IsIsbn13(string input)
{
    // biçim: 978/979 önek, dört tire, toplam 17 karakter
    if (!Regex.IsMatch(input, @"^97[89]-[0-9]{1,5}-[0-9]{1,7}-[0-9]{1,7}-[0-9]\z") || input.Length != 17)
        return false;

    // kontrol hanesi regex'in işi değil: 1 ve 3 ağırlıkları, mod 10
    string digits = input.Replace("-", "");
    int sum = 0;
    for (int i = 0; i < 12; i++)
        sum += (digits[i] - '0') * (i % 2 == 0 ? 1 : 3);
    return (10 - sum % 10) % 10 == digits[12] - '0';
}
$ dotnet run dotnet/isbn.cs
978-0-441-17271-9 True
978-0-141-43958-7 True
978-0-441-17271-8 False
978-0441-17271-9 False
978-0-441-17271-9\n False
977-0-441-17271-9 FalsePattern'i soldan sağa okuyalım: ^ başta ol, 97 literal, [89] 8 ya da 9, - literal tire (dışarıda metakarakter değil), [0-9]{1,5} bir ile beş rakam, iki tane [0-9]{1,7} grubu, son rakam ve \z. Toplam uzunluğun 17 olması ("13 rakam ve 4 tire") regex'le de söylenebilir, ama bunun için dördüncü yazıdaki lookahead gerekiyor; şimdilik input.Length bunu daha okunur hâlde yapıyor. Üçüncü satır şekli doğru ama kontrol hanesi yanlış bir numara; regex onu geçirdi, toplam kontrolü yakaladı. Regex ile yapabileceğinin sınırı bu: biçimi doğrular, anlamı doğrulamaz.
Aynı pattern'i anchor'sız ve \b ile kullanınca bir metinden ISBN çıkarmak için kullanabilirsin. Müşteri hizmetlerine gelen bir e-posta:
$ cat data/support-mail.txt
From: ada@example.com
Subject: Order BKS-2026-000123 is missing a book
Hi, order BKS-2026-000123 arrived without Dune (ISBN 978-0-441-17271-9).
Emma (978-0-141-43958-7) was in the box. My old order BKS-2025-98765 was late too.
$ grep -oE '\b97[89]-[0-9]{1,5}-[0-9]{1,7}-[0-9]{1,7}-[0-9]\b' data/support-mail.txt
978-0-441-17271-9
978-0-141-43958-7
$ grep -onE '\bBKS-[0-9]{4}-[0-9]{6}\b' data/support-mail.txt
2:BKS-2026-000123
3:BKS-2026-000123
$ node js/isbn.mjs
true false false
978-0-441-17271-9 at 124 true
978-0-141-43958-7 at 150 true
-o yalnızca eşleşen kısmı, -n satır numarasını basar. Beş haneli eski sipariş numarası BKS-2025-98765 biçime uymadığı için gelmedi. JavaScript tarafında aynı iş matchAll ile yapılıyor ve her eşleşmenin index'i de geliyor; kodun tamamı repodaki js/isbn.mjs dosyasında.
Üretimde Dikkat
Doğrulama pattern'ini bir kez yazıp iki yerde kullanıyorsan (Angular formu ve API gibi), flavor'lar arasında aynı davranan küçük bir syntax alt kümesinde kal: [0-9], [A-Za-z], açık anchor'lar. .NET tarafında sonu \z ile kapat; JavaScript'te m flag'i kullanma. Tarayıcıdaki kontrol kullanıcıya hızlı geri bildirim içindir, asıl karar her zaman sunucuda verilir.
Kabul etmediğin bir input'u sessizce düzeltmeye çalışma. Arap-Hint rakamları gerçek bir müşteri durumu: ya ASCII rakamlara çevirip öyle kaydedersin ya da "rakamları 0-9 ile yazın" diye açık bir hata dönersin. Hangisi olduğu iş kararı; regex'in görevi yalnızca hangi durumda olduğunu doğru söylemek.
Pattern'e kullanıcıdan gelen bir metin giriyorsa Regex.Escape ya da RegExp.escape şart. Kaçışsız bir parantez yukarıdaki gibi exception fırlatır; daha kötüsü, kötü niyetli biri engine'i saniyelerce meşgul edecek bir pattern gönderebilir. Bunun adı ReDoS (regex ile servis dışı bırakma saldırısı); .NET'teki timeout ve NonBacktracking seçenekleri yedinci, ölçümleri sekizinci yazıda.
Log'da ya da codebase'de arama yaparken hangi aracın hangi flavor'ı kullandığını bil. grep -E ile \d yazdığında hata yerine yalnızca bir uyarı aldık ve pattern sessizce başka bir şey aradı. Script'lerde bu uyarı kolayca gözden kaçar.
Sık Düşülen Tuzaklar
Kaçışsız nokta
@example.com pattern'i @exampleXcom ile de eşleşir. Metakarakter listesini ezberlemek yerine şunu alışkanlık hâline getir: pattern'de gördüğün her noktanın "herhangi bir karakter" mi yoksa "nokta" mı olduğunu kendine sor.
[A-z] aralığı
ASCII tablosunda Z ile a arasındaki altı karakteri de kapsar; GNU grep'te locale'e göre hata da verebilir. [A-Za-z] yaz.
Noktanın satır sonunu yakalamaması
Dune.Emma pattern'i "Dune\nEmma" input'unda eşleşmez; .NET'te RegexOptions.Singleline, JavaScript'te s flag'i noktayı satır sonuyla da eşleştirir. Dosyadaki çok satırlı bir bloğu ararken bunu unutmak "pattern doğru ama sonuç boş" durumunun en yaygın sebebi.
$ ile doğrulama
.NET ve PCRE2'de $ sondaki \n'e izin verir. Doğrulamada \z kullan.
JavaScript Temel'den hatırlatmalar
"JavaScript RegEx Temelleri" yazısındaki tuzaklar burada da geçerli: g flag'li bir pattern'le test çağırınca lastIndex yüzünden ikinci çağrı false dönebilir; anchor'sız bir doğrulama pattern'i metnin bir parçası uyduğunda bütününü geçerli sayar; new RegExp("\d+") içindeki tek ters bölü string tarafından yutulur.
Küçük Bir Deneme
★☆☆ Bookstore'un kampanya kodları PROMO- ile başlıyor ve arkasından iki büyük harf ile üç rakam geliyor (PROMO-TR250). .NET'te ve JavaScript'te aynı sonucu veren bir doğrulama pattern'i yaz; PROMO-TR250\n ve PROMO-tr250 geçmesin.
★★☆ pcre2test ile /[0-9]+-[0-9]/auto_callout,no_start_optimize pattern'ini BKS-2026-000123 üzerinde çalıştır. Engine hangi pozisyonlarda deneme başlatıyor, ilk eşleşme hangi index'te? Çıktıyı çalıştırmadan önce kâğıda çiz.
★★★ data/support-mail.txt içindeki bütün ISBN'leri bul, ama yalnızca kontrol hanesi doğru olanları yazdır. Komut satırında grep -oE ile adayları çıkarıp, C# ya da JavaScript'teki IsIsbn13 fonksiyonuna pipe ile ver.
Bu yazıda pattern'i soldan sağa okumayı ve engine'in başlangıç pozisyonlarını nasıl denediğini gördük. Bir sonraki yazıda engine'in bir pozisyonun içinde nasıl geri döndüğüne bakacağız: greedy ve lazy quantifier'lar, backtracking, possessive quantifier ve atomic group; örnek de Bookstore'un access log'undan endpoint, status ve süre çekmek olacak.