

Regex'in Bedeli: ReDoS, Catastrophic Backtracking, Okunabilirlik ve Regex'i Test Etmek
İç içe quantifier, çakışan alternation ya da art arda .* içeren bir pattern, neredeyse eşleşen bir input'ta üstel ya da polinom sayıda deneme yapar; ölçümümüzde ^(a+)+$ 28 harfte .NET'te 10 saniye sürdü, NonBacktracking 0,07 ms. Tehlikeli yapıları PCRE2 adım sayılarıyla tanıyor, Cloudflare'in 2019 kesintisini, Angular validator'ı ve sunucu doğrulamasını, (?x) ile okunur pattern'i, xUnit [Theory] ile test tablosunu ve e-posta için MailAddress kararını gösteriyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10 (SDK 10.0.404), xUnit v3 4.0.3, Node.js 26.13 (LTS), PCRE2 (Perl uyumlu regex library'si) 10.49, grep 3.12 (GNU) ve ripgrep 15.2.0 ile denenmiştir. Süre ölçümleri tek bir makinede yapılmıştır; mutlak değerler senin makinende farklı olur, büyüme oranları aynı kalır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'un (bir online kitapçı) Angular arayüzündeki üyelik formunda müşteri adı alanı internetten bulunmuş bir pattern'le doğrulanıyor: harfler, araya isteğe bağlı bir boşluk, bu tekrarlanabilir. Aynı pattern API'de de var:
^([a-zA-Z]+\s?)*$Üç müşteri formu dolduruyor: Ada Lovelace, Grace Hopper-Smith ve Maximiliane Josephine Vanderbilt-Rockefeller. İkinci ve üçüncüsü tire yüzünden reddedilecek; bu beklenen davranış. Asıl soru süre: her biri için tarayıcı kaç milisaniye harcar? Üçüncü isme üç harf daha eklenseydi ne olurdu?
Catastrophic Backtracking'i Ölçmek
Tahmindeki pattern'in özü daha kısa bir pattern'de görülüyor: ^(a+)+$. İçerideki a+ bir ya da daha fazla a alıyor, dışarıdaki + bunu bir ya da daha fazla kez tekrarlıyor. aaaa dört karakterlik bir input için engine'in elinde (aaaa), (aaa)(a), (a)(aaa), (aa)(aa) gibi sekiz farklı bölme var; her ek karakter bu sayıyı ikiye katlıyor. Input eşleşirse sorun yok, engine ilk denemede bitiriyor. Sondaki ! yüzünden eşleşme başarısız olunca ise ikinci yazıda gördüğümüz backtracking, $'ın tutmadığını kabul etmeden önce bütün bölmeleri tek tek deniyor. Ölçelim:
using System.Diagnostics;
using System.Globalization;
using System.Text.RegularExpressions;

CultureInfo.CurrentCulture = CultureInfo.InvariantCulture;

// ^(a+)+$, n harf ve sonunda "!": backtracking engine'i harfleri bölmenin her yolunu dener
Regex backtracking = new(@"^(a+)+$");
Regex nonBacktracking = new(@"^(a+)+$", RegexOptions.NonBacktracking);
Regex rewritten = new(@"^a+$");
foreach (Regex regex in new[] { backtracking, nonBacktracking, rewritten })
    regex.IsMatch("aaaa!"); // warm-up

Console.WriteLine($"{"n",3} {"backtracking ms",16} {"NonBacktracking ms",19} {"^a+$ ms",8}");
for (int n = 16; n <= 28; n += 2)
{
    string input = new string('a', n) + "!";
    Console.WriteLine($"{n,3} {Time(backtracking, input),16:F1} {Time(nonBacktracking, input),19:F3} {Time(rewritten, input),8:F3}");
}

static double Time(Regex regex, string input)
{
    Stopwatch sw = Stopwatch.StartNew();
    regex.IsMatch(input);
    return sw.Elapsed.TotalMilliseconds;
}
// aynı pattern V8'de: timeout seçeneği yok, çağrı bitene kadar thread'i bloklar
const backtracking = /^(a+)+$/;
console.log("n".padStart(3), "backtracking ms".padStart(16));
for (let n = 16; n <= 28; n += 2) {
const input = "a".repeat(n) + "!";
const start = performance.now();
backtracking.test(input);
console.log(String(n).padStart(3), (performance.now() - start).toFixed(1).padStart(16));
}$ dotnet run dotnet/catastrophic.cs
n backtracking ms NonBacktracking ms ^a+$ ms
16 2.4 0.001 0.000
18 9.4 0.001 0.000
20 37.6 0.001 0.000
22 155.2 0.003 0.000
24 635.1 0.014 0.001
26 2527.2 0.006 0.001
28 10147.4 0.068 0.001
$ node js/catastrophic.mjs
n backtracking ms
16 2.4
18 1.2
20 4.6
22 16.8
24 67.2
26 288.0
28 1101.9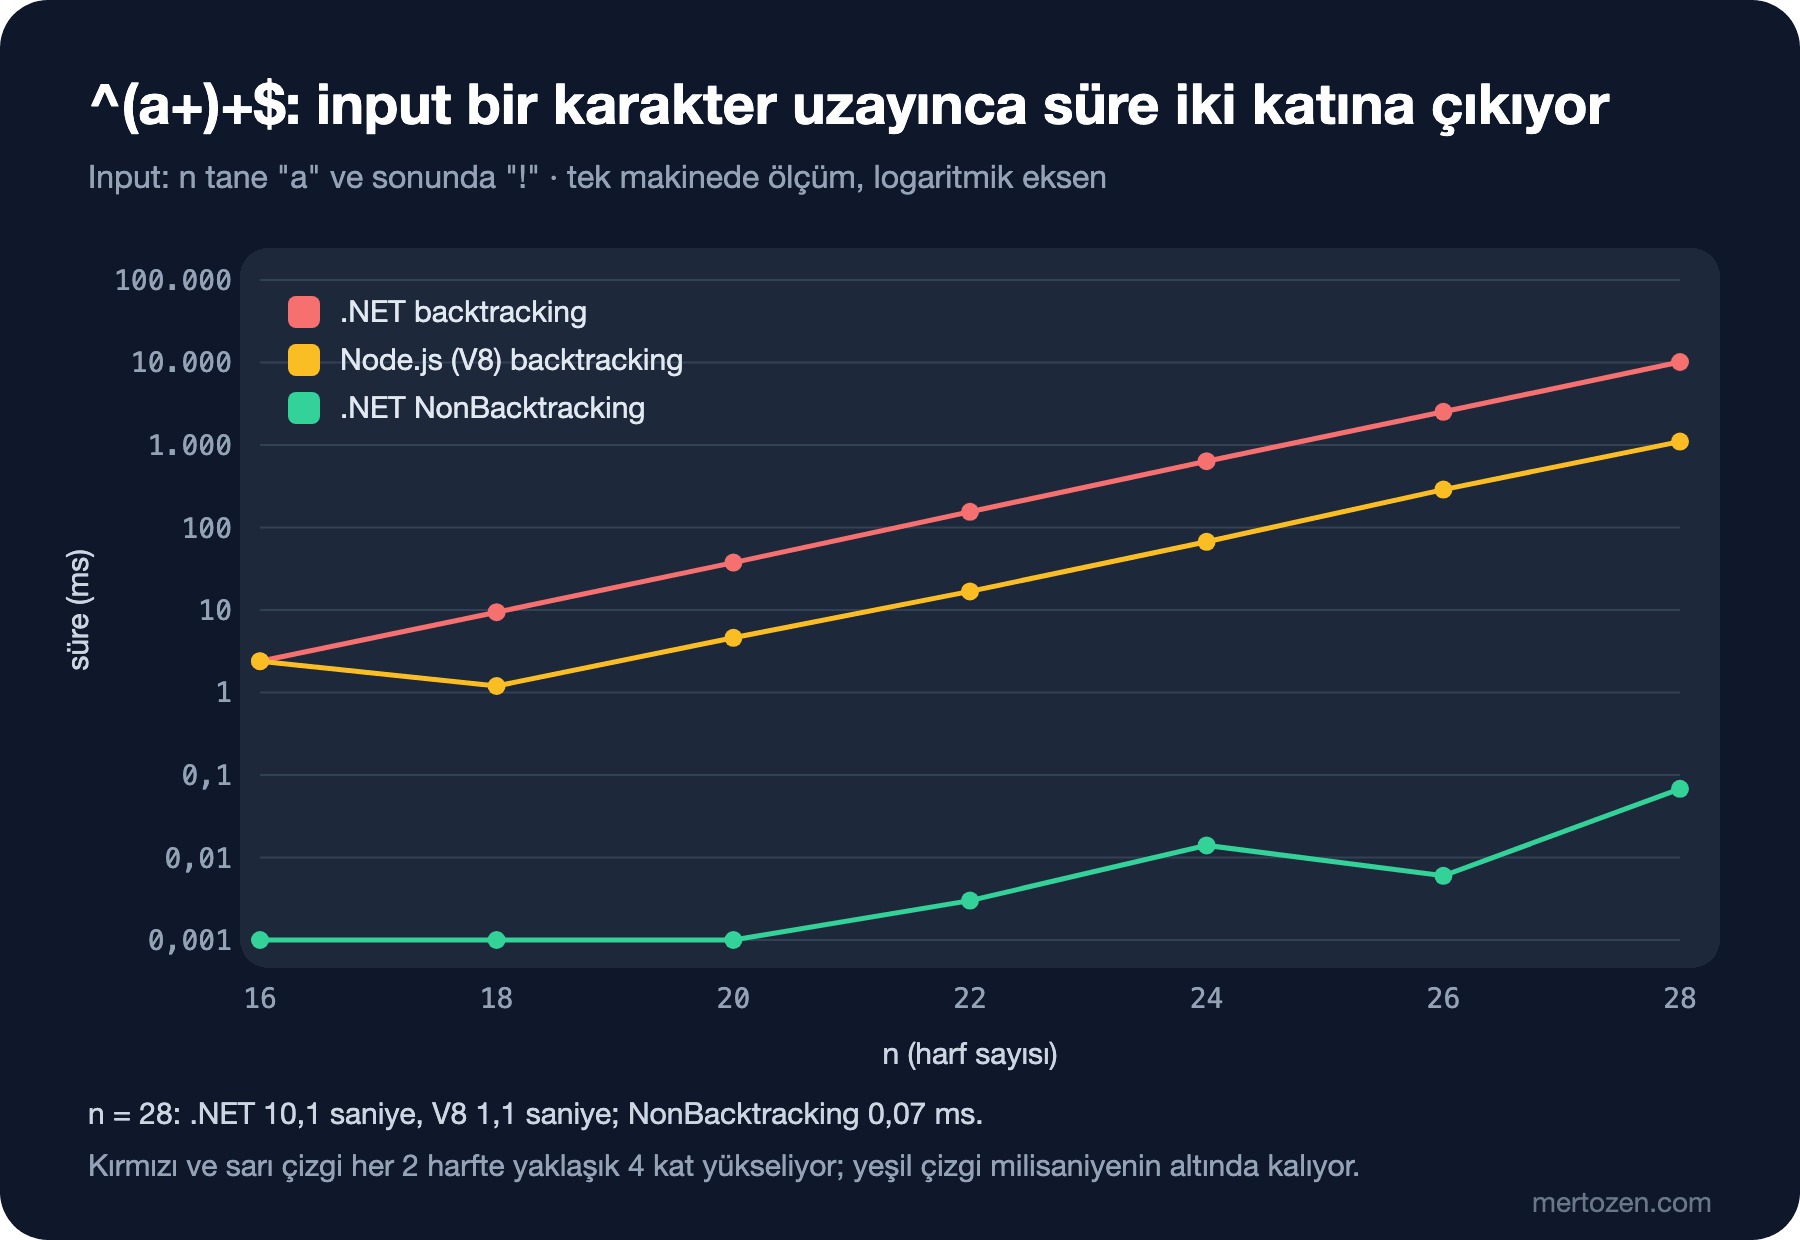
Her iki harfte süre dört katına çıkıyor: 28 harf .NET'in backtracking engine'inde 10 saniye, V8'de (Chrome ve Node.js'in JavaScript engine'i) 1,1 saniye. V8 burada yaklaşık on kat hızlı, ama eğri aynı; aynı oranla 32 harfte V8'in de on beş saniyeyi geçmesi beklenir. NonBacktracking aynı pattern'i 28 harfte 0,07 milisaniyede bitirdi, pattern'i ^a+$ olarak yeniden yazmak ise mikrosaniyenin altında kaldı. İki +'nın üst üste gelmesi, bir eşleşmede tek bir harfin hem içteki hem dıştaki tekrara ait olabilmesi demek. Sorunun kaynağı bu belirsizlik.
Tehlikeli Pattern'leri Tanımak
Süre makineden makineye değişiyor, adım sayısı değişmiyor. PCRE2'nin pcre2test aracı find_limits seçeneğiyle bir input'un kaç iç adım gerektirdiğini yazdırabiliyor. Aynı tabloya üç tehlikeli yapıyı ve üç güvenli karşılığı koyalım:
$ cat shell/redos-limits.sh
#!/usr/bin/env bash
# PCRE2'nin "minimum match limit" değeri: başarısız bir input'un gerektirdiği iç adım sayısı
# limit PATTERN UNIT COUNT TAIL: subject, UNIT'in COUNT kez tekrarı ve ardından TAIL
limit() {
    local subject
    subject=$(printf "%${3}s" '' | sed "s/ /$2/g")$4
    printf '/%s/\n%s\\=find_limits\n' "$1" "$subject" > /tmp/limits.txt
    pcre2test /tmp/limits.txt | sed -n 's/^Minimum match limit = //p'
}
printf '%-28s %8s %8s %10s\n' pattern n=10 n=15 n=20
while IFS=$'\t' read -r pattern unit tail; do
    printf '%-28s %8s %8s %10s\n' "$pattern" "$(limit "$pattern" "$unit" 10 "$tail")" \
        "$(limit "$pattern" "$unit" 15 "$tail")" "$(limit "$pattern" "$unit" 20 "$tail")"
done <<'PATTERNS'
^(a+)+$	a	!
^(\w+\s?)*$	a	!
^(\d|\d\d)+$	1	x
^.*.*=.*;$	x	=;x
^(?>a+)+$	a	!
^a+$	a	!
^\w+(?:\s\w+)*$	a	!
PATTERNS
rm -f /tmp/limits.txt
# grep -P takılıp kalmak yerine PCRE2'nin varsayılan sınırında durur
printf '%040d!\n' 0 | tr 0 a | grep -cP '^(a+)+$'
$ bash shell/redos-limits.sh
pattern                          n=10     n=15       n=20
^(a+)+$                          2560    81920    2621440
^(\w+\s?)*$                      2561    81921    2621441
^(\d|\d\d)+$                      697     7750      85969
^.*.*=.*;$                        128      223        343
^(?>a+)+$                           6        6          6
^a+$                                2        2          2
^\w+(?:\s\w+)*$                     3        3          3
grep: (standard input): exceeded PCRE's backtracking limit
İlk dört satır üç tehlikeli yapıyı gösteriyor. İç içe quantifier: (a+)+ ve tahmindeki (\w+\s?)*. İkincisinde \s? isteğe bağlı olduğu için boşluksuz bir kelime de (a+)+ gibi sayısız biçimde bölünebiliyor; adım sayısı neredeyse aynı. Çakışan alternation: (\d|\d\d)+'da iki rakam ya tek parça ya iki ayrı parça olabiliyor; büyüme daha yavaş ama yine üstel. Art arda gelen .*'lar: .*.*=.* input'u birden fazla yoldan bölüyor; büyüme üstel değil polinom, ama uzun input'ta ve saniyede binlerce istekte bu da yetiyor.
Alt üç satır aynı işi güvenli yapan yazımlar. Atomic group (?>a+) aldığını geri vermediği için bölme sayısı bire iniyor. ^a+$ zaten tek yoldan eşleşiyor. ^\w+(?:\s\w+)*$ tahmindeki pattern'in doğru hâli: kelimeler arasındaki boşluk zorunlu olduğu için bir harfin hangi tekrara ait olduğu hiçbir zaman belirsiz değil. Kural şu: bir karakterin pattern'in iki farklı tekrarına ait olabildiği her yer bir risk; regex'i okurken bunu ara.
Son satır PCRE2'nin kendi savunması. PCRE2'nin varsayılan bir adım sınırı var ve grep -P 40 harflik input'ta sonsuza kadar beklemek yerine bu sınıra çarpıp hata veriyor. Beşinci yazıdaki ripgrep'in varsayılan engine'i aynı input'ta zaten backtracking yapmıyor.
Cloudflare, 2 Temmuz 2019
Bunun production'daki en bilinen örneği Cloudflare'in 2 Temmuz 2019 kesintisi. Şirketin resmî postmortem'ine göre WAF'a (web uygulama güvenlik duvarı) eklenen yeni bir XSS (siteler arası script çalıştırma) kuralındaki regex, bütün dünyadaki sunucularda HTTP trafiğini işleyen CPU'ları neredeyse yüzde yüze çıkardı ve 27 dakika boyunca ziyaretçiler 502 hatası aldı. Raporun sorunlu bulduğu kısım .*(?:.*=.*): yukarıdaki tablodaki art arda .* yapısı. Kural bütün dünyaya aynı anda dağıtıldığı için etkisi de aynı anda her yerde görüldü. Raporda sayılan önlemler arasında daha önce kaldırılmış CPU koruma mekanizmasını geri getirmek, kuralları kademeli dağıtmak, kuralların performansını test aşamasında ölçmek ve çalışma süresi garantisi veren re2 ya da Rust regex engine'ine geçmek var. Yani savunma tek bir şey değil: engine seçimi, ölçüm ve dağıtım süreci birlikte.
Angular Validator'ı ve Sunucuda Tekrar Doğrulama
Tahmine dönelim. Angular'ın Validators.pattern'ı tarayıcının regex engine'ini kullanıyor; Angular dokümanına göre string olarak verilen pattern'in başına ^, sonuna $ ekleniyor. Aynı ölçümü form alanındaki pattern'le yapalım:
// müşteri adı alanındaki Angular Validators.pattern(...) pattern'i
const naive = /^([a-zA-Z]+\s?)*$/;
const safe = /^[a-zA-Z]+(?: [a-zA-Z]+)*$/;

for (const name of ["Ada Lovelace", "Grace Hopper-Smith", "Maximiliane Josephine Vanderbilt-Rockefeller"]) {
  for (const [label, re] of [["naive", naive], ["safe", safe]]) {
    const start = performance.now();
    const ok = re.test(name);
    console.log(`${label.padEnd(5)} ${String(ok).padEnd(5)} ${(performance.now() - start).toFixed(1).padStart(8)} ms  ${name}`);
  }
}
$ node js/name-validator.mjs
naive true 0.0 ms Ada Lovelace
safe true 0.0 ms Ada Lovelace
naive false 0.0 ms Grace Hopper-Smith
safe false 0.0 ms Grace Hopper-Smith
naive false 976.9 ms Maximiliane Josephine Vanderbilt-Rockefeller
safe false 0.0 ms Maximiliane Josephine Vanderbilt-RockefellerTahminin cevabı: ilk iki isim ölçülemeyecek kadar kısa sürüyor, üçüncüsü bu makinede yaklaşık bir saniye. Tirenin önünde 30 harf var ve her ek harf süreyi ikiye katlıyor; üç harf daha sekiz kat, yani yaklaşık sekiz saniye demek. Angular validator'ı her tuş vuruşunda çalıştığı için müşteri isim yazarken sayfa her harfte biraz daha uzun donuyor. JavaScript'te regex için timeout yok; tarayıcıda tek savunma pattern'in kendisi.
Bu müşterinin kendi sekmesini kilitliyor, sunucuyu değil. Asıl risk sunucu tarafında. İstemci tarafındaki doğrulama bir kolaylık; API'ye doğrudan istek atan biri onu hiç çalıştırmaz. API aynı alanı mutlaka yeniden doğrulamalı ve bunu yaparken aynı pattern'i kopyalamamalı: .NET'te [GeneratedRegex] ile güvenli pattern, bir timeout ve bir uzunluk sınırı. Bir harf sınırı da tek başına yetmiyor: tablo, (a+)+ için 30 harfin bile saniyeler sürdüğünü gösteriyor. Uzunluk sınırı polinom büyüyen pattern'lerde işe yarıyor, üstel olanlarda ancak pattern'i düzeltmekle birlikte. V8'in deneysel --enable-experimental-regexp-engine seçeneğiyle gelen l flag'i lineer bir engine kullanıyor; Node.js 26'da denedim, 100 bin harflik input'ta bile milisaniyeler sürdü. Ama deneysel ve tarayıcılarda yok; production'da güvenebileceğin bir şey değil.
Okunabilirlik: (?x), İsimli Gruplar ve Parçalardan Kurmak
ReDoS'u (regex ile servis dışı bırakma saldırısı) code review'da yakalamanın ön koşulu pattern'i okuyabilmek. Bookstore'un access log satırını parse eden pattern'i üç biçimde yazalım:
using System.Text.RegularExpressions;

string line = File.ReadLines("data/access.log").First();

// 1. tek satır: doğru, ama review etmesi zor
Regex dense = new(@"^(?<ip>\S+) \S+ \S+ \[(?<time>[^\]]+)\] ""(?<method>[A-Z]+) (?<path>\S+) [^""]*"" (?<status>[0-9]{3}) (?<bytes>[0-9]+) ""[^""]*"" ""[^""]*"" (?<seconds>[0-9.]+)$");

// 2. IgnorePatternWhitespace: boşluklar yok sayılır, # yorum başlatır, gerçek boşluk \x20 diye yazılır
Regex commented = new("""
    ^(?<ip>\S+)                  # client address
    \x20\S+\x20\S+               # identity and user, always "-"
    \x20\[(?<time>[^\]]+)\]      # [15/Nov/2026:10:42:07 +0000]
    \x20"(?<method>[A-Z]+)       # "GET
    \x20(?<path>\S+)             #  /api/books/978-0-441-17271-9
    \x20[^"]*"                   #  HTTP/1.1"
    \x20(?<status>[0-9]{3})      # 200
    \x20(?<bytes>[0-9]+)         # response size
    \x20"[^"]*"\x20"[^"]*"       # referer and user agent
    \x20(?<seconds>[0-9.]+)$     # duration in seconds
    """, RegexOptions.IgnorePatternWhitespace);

// 3. derleme sırasında isimli parçalardan kuruluyor: aşağıdaki AccessLog.Line
foreach (Regex regex in new[] { dense, commented, AccessLog.Line })
{
    Match m = regex.Match(line);
    Console.WriteLine($"{m.Groups["method"].Value} {m.Groups["path"].Value} {m.Groups["status"].Value} {m.Groups["seconds"].Value}");
}

// (?x) içinde düz boşluk yok sayılır: bu pattern "GET/api" arar
Console.WriteLine($"(?x) with a plain space: {Regex.IsMatch(line, "(?x)GET /api")}");

static partial class AccessLog
{
    private const string Ip = @"(?<ip>\S+)";
    private const string Identity = @"\S+ \S+";
    private const string Time = @"\[(?<time>[^\]]+)\]";
    private const string Request = @"""(?<method>[A-Z]+) (?<path>\S+) [^""]*""";
    private const string Status = "(?<status>[0-9]{3})";
    private const string Bytes = "(?<bytes>[0-9]+)";
    private const string Quoted = @"""[^""]*""";
    private const string Seconds = @"(?<seconds>[0-9.]+)";

    [GeneratedRegex($"^{Ip} {Identity} {Time} {Request} {Status} {Bytes} {Quoted} {Quoted} {Seconds}$")]
    public static partial Regex Line { get; }
}
$ dotnet run dotnet/readable-pattern.cs
GET /api/books/978-0-441-17271-9 200 0.042
GET /api/books/978-0-441-17271-9 200 0.042
GET /api/books/978-0-441-17271-9 200 0.042
(?x) with a plain space: FalseÜç pattern aynı sonucu veriyor, ama review'da aynı şeyi söylemiyorlar. İkincisi dördüncü yazıda gördüğümüz (?x) modunun RegexOptions.IgnorePatternWhitespace ile verilmiş hâli: her parçanın yanında ne yakaladığı yazıyor. C# 11'in raw string literal'ı tırnak ve ters bölü kaçışını ortadan kaldırdığı için pattern olduğu gibi okunuyor. Bu modda bir tuzak var: boşluk karakteri yok sayılıyor, bu yüzden gerçek bir boşluğu \x20 ya da [ ] diye yazmak gerekiyor; son satır düz boşluklu bir pattern'in sessizce GET/api aradığını gösteriyor. Üçüncüsü pattern'i isimli sabitlerden kuruyor; C# 10'dan beri sabit string'lerden oluşan interpolation da sabit sayıldığı için [GeneratedRegex] attribute'unun içinde kullanılabiliyor. Quoted gibi bir parçayı bir kez yazıp test edip iki yerde kullanmak, uzun bir pattern'i elle kopyalamaktan daha güvenli.
Pattern'i anlamak için regex101 ya da regexr gibi sitelerin açıklama ve adım sayma özellikleri çok işe yarıyor. Tek kural: oraya gerçek veri yapıştırma. Müşteri e-postaları, token'lar ya da production log satırları yerine Bookstore'un örnek verisi gibi uydurma metin kullan; yapıştırdığın metnin nerede saklandığını sen kontrol etmiyorsun.
Regex'i Test Etmek: xUnit [Theory] ile Örnek Tablosu
Bir regex'in doğru olduğunu söylemenin tek yolu pozitif ve negatif örneklerle denemek. Bookstore'un sipariş numarası ve müşteri adı pattern'leri src/Bookstore.Text library'sinde:
using System.Text.RegularExpressions;

namespace Bookstore.Text;

public static partial class BookstorePatterns
{
    // $ değil \z: sondaki \n geçmemeli
    [GeneratedRegex(@"^BKS-[0-9]{4}-[0-9]{6}\z")]
    private static partial Regex OrderNumber { get; }

    // harfler, kelimeler arasında tek ayırıcı; iç içe quantifier yok, catastrophic backtracking yok
    [GeneratedRegex(@"^\p{L}+(?:[ '-]\p{L}+)*\z", RegexOptions.None, matchTimeoutMilliseconds: 100)]
    private static partial Regex CustomerName { get; }

    public static bool IsOrderNumber(string input) => OrderNumber.IsMatch(input);

    public static bool IsCustomerName(string input) => input.Length <= 100 && CustomerName.IsMatch(input);
}
Testler [Theory] ve [InlineData] ile bir örnek tablosu olarak yazılıyor. Her satır bir input ve beklenen sonuç; birinci yazıdaki \n ve Arap-Hint rakamı tuzakları da tabloda:
using System.Text.RegularExpressions;
using Bookstore.Text;
using Xunit;

namespace Bookstore.Text.Tests;

public class BookstorePatternsTests
{
    [Theory]
    [InlineData("BKS-2026-000123", true)]
    [InlineData("BKS-2026-000123\n", false)]   // sondaki satır sonu, birinci yazıdaki $ tuzağı
    [InlineData("BKS-2026-٠٠٠١٢٣", false)]      // Arap-Hint rakamları
    [InlineData("bks-2026-000123", false)]
    [InlineData("BKS-26-000123", false)]
    [InlineData(" BKS-2026-000123", false)]
    public void OrderNumber(string input, bool expected) =>
        Assert.Equal(expected, BookstorePatterns.IsOrderNumber(input));

    [Theory]
    [InlineData("Ada Lovelace", true)]
    [InlineData("Ayşe Gül", true)]
    [InlineData("Jean-Luc", true)]
    [InlineData("O'Brien", true)]
    [InlineData("Ada  Lovelace", false)]
    [InlineData("Ada1", false)]
    [InlineData(" Ada", false)]
    [InlineData("", false)]
    public void CustomerName(string input, bool expected) =>
        Assert.Equal(expected, BookstorePatterns.IsCustomerName(input));

    [Fact]
    public void CustomerName_LongNearMiss_FinishesQuickly() =>
        Assert.False(BookstorePatterns.IsCustomerName(new string('a', 99) + "!"));

    // değiştirdiğimiz pattern için regresyon testi: timeout ile başarısız olmaya devam etmeli
    [Fact]
    public void NaiveNamePattern_TimesOut() =>
        Assert.Throws<RegexMatchTimeoutException>(() =>
            Regex.IsMatch(new string('a', 30) + "!", @"^([a-zA-Z]+\s?)*$", RegexOptions.None, TimeSpan.FromMilliseconds(50)));
}
$ dotnet test --project tests/Bookstore.Text.Tests 2>&1 | tail -6
Test run summary: Passed!
total: 16
failed: 0
succeeded: 16
skipped: 0
duration: 288msxUnit v3 Microsoft.Testing.Platform üzerinde çalışıyor; .NET 10 SDK'sında dotnet test'in bu modu kullanması için repo kökündeki global.json'da "test": { "runner": "Microsoft.Testing.Platform" } ayarı var. Tablonun iki ayrıntısı önemli. CustomerName_LongNearMiss_FinishesQuickly ReDoS'a karşı bir test: güvenli pattern 99 harf ve bir ünlemde anında False dönüyor; pattern bir gün iç içe quantifier'lı bir hâle dönerse matchTimeoutMilliseconds sayesinde test asılı kalmıyor, RegexMatchTimeoutException ile kırmızıya dönüyor. Ayşe Gül satırı da [a-zA-Z] yerine \p{L} seçmemizin sebebini kayıt altına alıyor.
Bu tablo, bir AI asistanından ya da Stack Overflow'dan alınan her pattern için kabul kriteri. Önerilen pattern'i ürüne koymadan önce bu testlerden geçir ve tabloya kendi bildiğin uç durumları ekle: Türkçe harfler, sondaki satır sonu, boş string, çok uzun ve neredeyse eşleşen input. Tahmindeki pattern'in kaynağı da bir internet cevabıydı; ilk iki isimle denendiğinde hiçbir sorun göstermiyordu.
E-posta: Regex Yerine MailAddress ve Doğrulama Maili
E-posta adresi regex'le doğrulanmak istenen alanların başında geliyor. .NET'in MailAddress class'ı ile tipik bir pattern'i yan yana koyalım:
using System.Net.Mail;
using System.Text.RegularExpressions;

// tipik bir "e-posta regex'i" ve MailAddress.TryCreate
Regex emailRegex = new(@"^[^@\s]+@[^@\s]+\.[^@\s]+$");

string[] addresses =
[
    "ada@example.com",
    "ada.lovelace+books@example.com",
    "ada@example",
    "\"Ada Lovelace\"@example.com",
    "Ada Lovelace <ada@example.com>",
    "ada@example..com",
    "ada@@example.com",
];

Console.WriteLine($"{"address",-34} {"regex",-6} MailAddress");
foreach (string address in addresses)
{
    bool parsed = MailAddress.TryCreate(address, out MailAddress? mail);
    string result = parsed ? $"True  -> {mail!.Address}" : "False";
    Console.WriteLine($"{address,-34} {emailRegex.IsMatch(address),-6} {result}");
}
$ dotnet run dotnet/email-check.cs
address regex MailAddress
ada@example.com True True -> ada@example.com
ada.lovelace+books@example.com True True -> ada.lovelace+books@example.com
ada@example False True -> ada@example
"Ada Lovelace"@example.com False True -> "Ada Lovelace"@example.com
Ada Lovelace <ada@example.com> False True -> ada@example.com
ada@example..com True False
ada@@example.com False Falseİkisi dört satırda anlaşmıyor ve hiçbiri "bu adrese mail gidiyor mu?" sorusunu cevaplamıyor. MailAddress standardın izin verdiği tırnaklı adresleri ve noktasız domain'leri kabul ediyor, ama Ada Lovelace <ada@example.com> gibi görünen adlı bir metni de adres sayıyor; onu doğrulayıcı olarak kullanıyorsan mail.Address == input kontrolünü eklemen gerekiyor. Regex ise geçerli adresleri reddedip ..'lı bir adresi kabul ediyor. Bookstore'un kararı şu: kayıt formunda yalnızca kaba bir kontrol (bir @, iki tarafında boş olmayan metin), sunucuda MailAddress.TryCreate ve adresin tamamını karşılaştırma, asıl doğrulama ise adrese gönderilen bir onay bağlantısı. Adresin gerçekten var olduğunu ve müşteriye ait olduğunu yalnızca bu gösterir.
Üretimde Dikkat
ReDoS'u yalnızca kendi kodunda arama. Kullandığın NuGet ve npm paketlerinin içindeki pattern'ler de aynı riski taşıyor ve bu tür açıklar CVE (bilinen güvenlik açıklarının ortak kayıt numarası) olarak yayınlanıyor. Onları bulmanın yolu dependency scanning; ayrıntısı DevSecOps serisinin "Dependency Scanning Derinlemesine" yazısında.
Timeout'ları görünür kıl. RegexMatchTimeoutException'ı yakalayan her yerde pattern adını ve input uzunluğunu log'la ve bunun için bir metrik tut. Bir timeout ya bir saldırının ya da pattern'deki bir hatanın ilk işaretidir; ikisinde de bilmek istersin.
Code review'da regex'e bak. Kontrol listesi kısa: iç içe quantifier var mı ((x+)+, (x*)*, (x+\s?)*), alternation'ın dalları aynı metni eşleştirebiliyor mu, art arda .* var mı, input güvenilir mi, timeout ya da NonBacktracking var mı, pozitif ve negatif test var mı. Pattern büyükse parçalara bölünmüş ya da (?x) ile yorumlanmış mı.
Regex'in doğru araç olmadığı yerleri ayır. HTML, JSON, CSV (virgülle ayrılmış değerler), e-posta ve URL için standart parser'lar var; ikinci yazıda dediğimiz gibi regex orada yanlış sonuç vermenin yanında bu yazıdaki riskleri de taşıyor.
Sık Düşülen Tuzaklar
ReDoS'u yalnızca kendi kodunda aramak
Bağımlılıklardaki pattern'ler de çalışıyor. Dependency scanning'i CI pipeline'ına ekle.
Kısa test input'larıyla yetinmek
^(a+)+$ 16 harfte 2 milisaniye sürüyor, testte hiçbir şey göstermiyor. Her pattern için neredeyse eşleşen uzun bir input'u da test et.
İstemci doğrulamasına güvenmek
Angular validator'ı kullanıcıya kolaylık, güvenlik değil. Sunucu aynı alanı güvenli bir pattern, timeout ve uzunluk sınırıyla yeniden doğrulamalı.
Lazy quantifier'ı çözüm sanmak
(a+?)+ da üstel: redos-limits.sh'deki yöntemle 20 harfte 3.145.728 adım. İkinci yazıda dediğimiz gibi lazy quantifier deneme sırasını değiştirir, deneme sayısını değil. Çözüm belirsizliği kaldırmak.
AI'ın ya da bir cevabın verdiği pattern'i test etmeden kullanmak
Pattern ilk birkaç örnekte doğru görünür. Test tablosuna Türkçe harfleri, satır sonlarını ve uzun, neredeyse eşleşen input'ları ekle.
Küçük Bir Deneme
★☆☆ redos-limits.sh'ye ^(a|a)+$ ve ^(a|b)+$ satırlarını ekle. İki alternation'dan hangisi tehlikeli, neden?
★★☆ BookstorePatternsTests'e ISBN (kitapların uluslararası standart numarası) için bir [Theory] ekle. Yedinci yazıdaki IsIsbn13'ü library'ye taşı; tabloya yanlış kontrol haneli, boşluklu ve \n ile biten örnekler koy.
★★★ Bookstore API'sinin müşteri adı doğrulamasını bir ASP.NET Core endpoint'ine bağla ve RegexMatchTimeoutException geldiğinde 400 döndürüp olayı log'la. Sonra (?x) ile yazılmış bir sürüme geçir ve testlerin aynı kaldığını gör.
Seri burada bitiyor. Sekiz yazıda engine'in bir pattern'i pozisyon pozisyon nasıl denediğinden başladık; quantifier'lar ve backtracking, gruplar ve replace, lookaround ve Türkçe karakterler, flavor'lar arasındaki farklar, komut satırında ve IDE'de toplu değişiklik, .NET'in Regex API'leri ve son olarak regex'in bedeli. Elinde kalması gereken alışkanlık kısa: pattern'i okuyarak yaz, hangi engine'de çalıştığını bil, örnek tablosuyla test et ve güvenilmeyen input'u timeout ya da backtracking'siz bir engine olmadan işleme. Stack Overflow'dan kopyaladığın bir regex'i artık hem okuyabilir hem de neyi neden eşleştirdiğini test edebilirsin.