

Regex Flavor'ları: .NET, JavaScript, PCRE2, POSIX BRE/ERE ve RE2 Arasındaki Farklar, Glob ile Regex'i Ayırmak
Aynı pattern flavor'a göre çalışır, hata verir ya da hata vermeden başka bir şey eşleştirir: Perl ailesi (.NET, JavaScript, PCRE2) backtracking ile lookaround sunar, RE2 ve Rust regex lineer zaman için bunlardan vazgeçer, POSIX en uzun eşleşmeyi seçer. Aynı probe listesini beş engine'de çalıştırıyor, Prometheus'un =~ ile tam eşleşmesini promtool ile, glob ile regex farkını .gitignore ve PowerShell ile gösteriyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10 (SDK 10.0.404), Node.js 26.13 (LTS), grep 3.12 (GNU), sed 4.10 (GNU), PCRE2 (Perl uyumlu regex library'si) 10.49, ripgrep 15.2.0, git 2.43, PowerShell 7.7, promtool 3.16 (Prometheus'un komut satırı aracı) ve Python 3.14 ile denenmiştir. grep, sed, rg ve git komutları Linux'ta, WSL'de (Windows içindeki Linux ortamı) ya da Git Bash'te çalışır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'un (bir online kitapçı) ödeme loglarında reddedilen ödemeleri bulmak için Emre'nin elinde .NET'te test edilmiş bir pattern var:
Payment [0-9]+(?= declined)Production sunucusunda .NET yok; Emre aynı pattern'i önce grep -E ile, sonra rg ile, en son grep -P ile çalıştırıyor. Bir de Prometheus'ta kitap endpoint'lerine gelen istekleri saymak için path=~"/api/books" yazıyor; metriklerde /api/books ve /api/books/9780441172719 diye iki path var.
Üç komuttan hangisi sonucu bulur, hangisi hata verir, hangisi hiçbir şey söylemeden boş döner? Prometheus sorgusu kaç series sayar?
Flavor Nedir, Aileler Nereden Geliyor?
Regex syntax'ı tek bir standart değil. Aynı fikri (karakter, tekrar, alternatif) uygulayan birçok engine var ve her birinin hangi yapıları desteklediği, aynı işareti nasıl yorumladığı farklı. Bu farkların toplamına flavor diyoruz. Flavor'ları ezberlemek yerine üç aileye ayırmak işi kolaylaştırıyor:
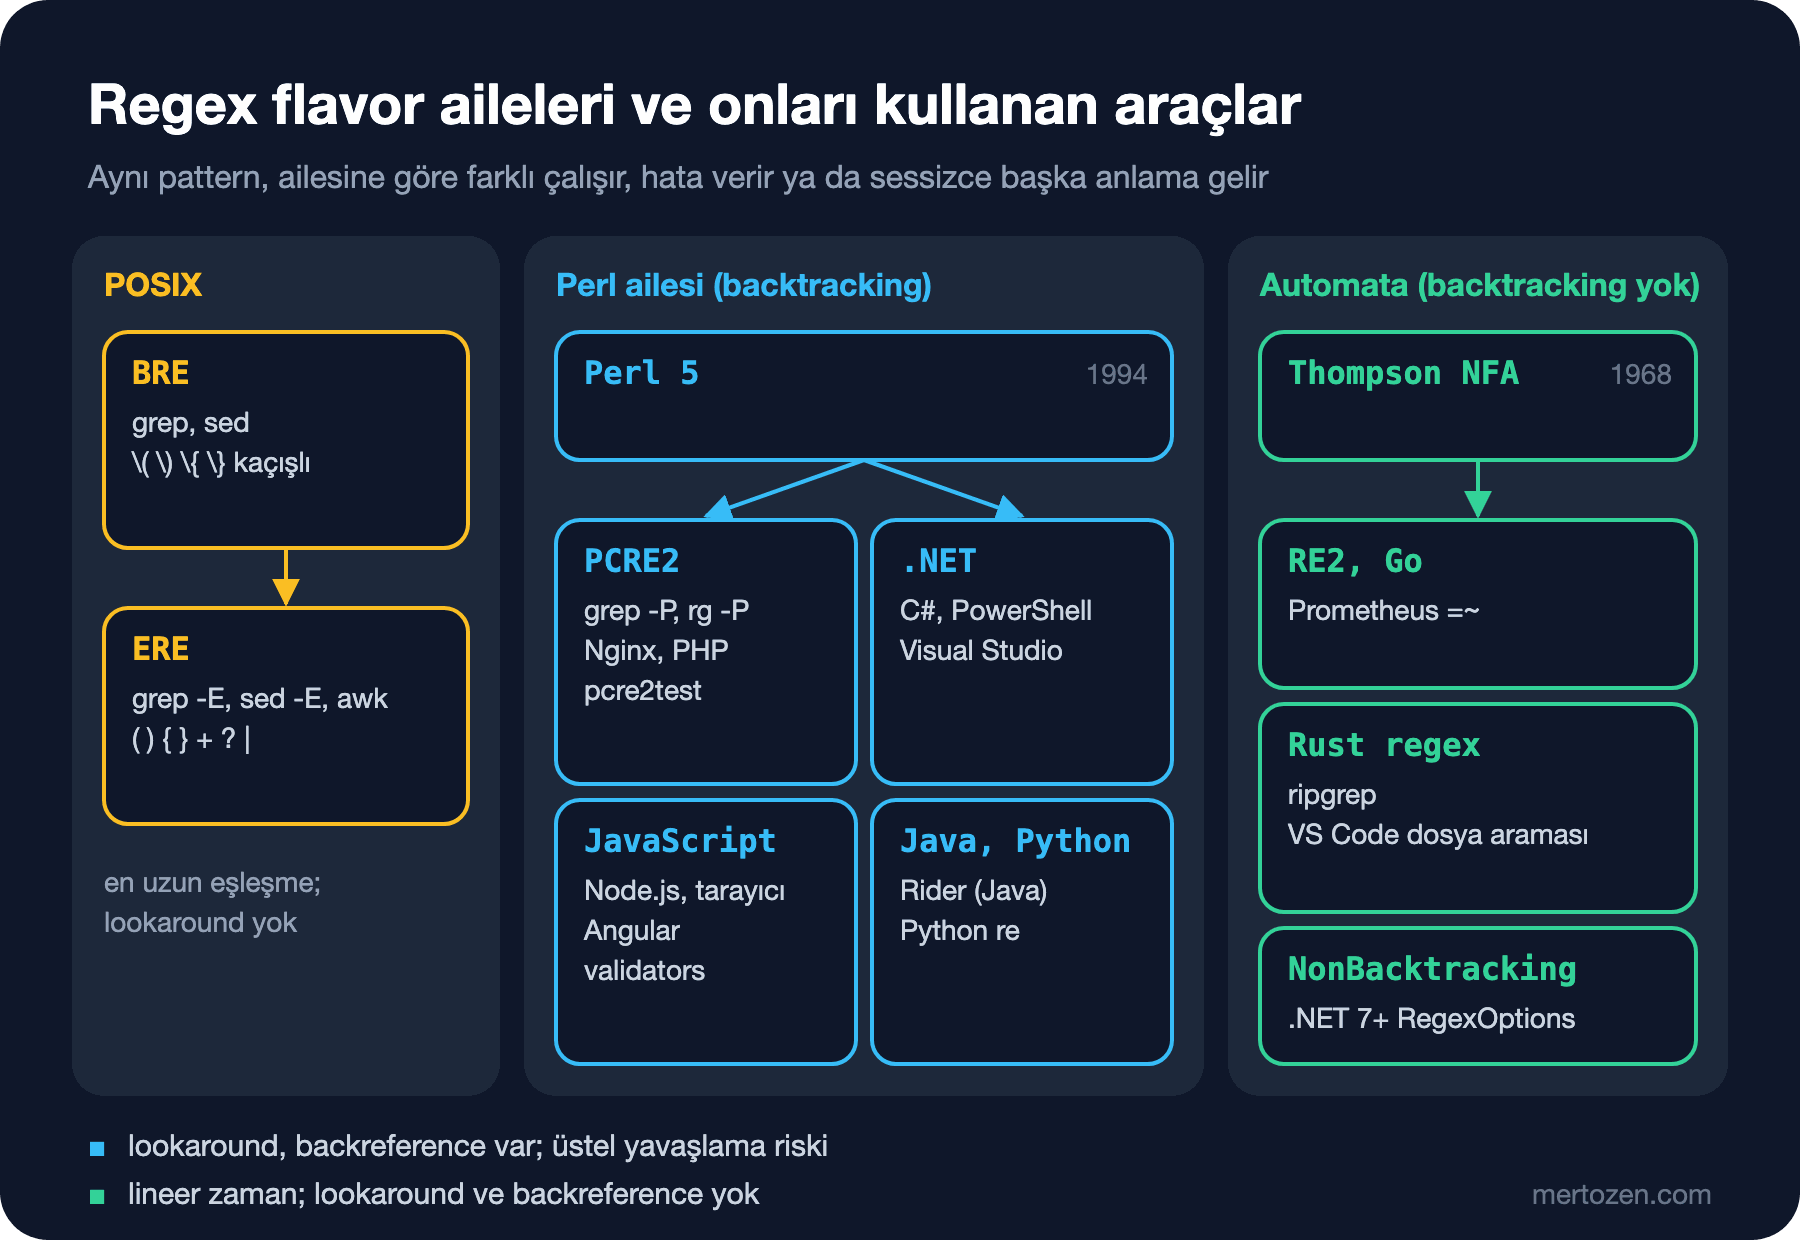
İlk aile POSIX (Unix araçlarının uyduğu standart). grep ve sed'in varsayılan syntax'ı BRE (temel regular expression), grep -E ve awk'ınki ERE (genişletilmiş regular expression). İkinci aile Perl'den geliyor. Perl 5, 1994'te lookahead, lazy quantifier ve non-capturing group gibi yapıları getirdi; PCRE2, .NET, JavaScript, Java ve Python bu syntax'ı temel alıyor ve hepsi backtracking engine'i kullanıyor. Üçüncü aile Ken Thompson'ın 1968'de yayımladığı, input'u bir kez soldan sağa okuyan automata yaklaşımına dayanıyor: Google'ın RE2'si (C++ ile yazılmış, backtracking yapmayan regex library'si), Go'nun regexp paketi, Rust'ın regex crate'i (ripgrep bunu kullanır) ve .NET 7 ile gelen RegexOptions.NonBacktracking.
Bu ayrım tahmindeki soruların da cevabı. Bir pattern'i başka bir araca taşıdığında üç şeyden biri olur: aynı çalışır, hata verir ya da hata vermeden başka bir şey eşleştirir. En pahalısı üçüncüsü.
POSIX BRE ve ERE: Ters Bölü Nereye Gider?
BRE'de { } ( ) + ? | işaretlerinin özel anlam kazanması için önlerine ters bölü koyman gerekiyor; çıplak hâlleri düz karakter. ERE'de tam tersi. +, ? ve | POSIX BRE tanımında hiç yok; GNU grep ve sed bunları \+, \?, \| olarak ek özellik diye kabul ediyor.
$ cat shell/bre-ere.sh
#!/usr/bin/env bash
line=$(tail -1 data/app.log)
# BRE: { } ( ) + ? | ters bölü ister; çıplak hâlleri düz karakterdir
echo "$line" | grep -o 'BKS-[0-9]\{4\}-[0-9]\{6\}'
echo "$line" | grep -o 'BKS-[0-9]{4}' || echo "BRE {4}: no match"
# ERE: aynı metakarakterler ters bölüsüz
echo "$line" | grep -oE 'BKS-[0-9]{4}-[0-9]{6}'
# sed de varsayılan olarak BRE, -E ile ERE
echo "$line" | sed 's/.*Payment \([0-9]*\) \(declined\).*/\2: \1/'
echo "$line" | sed -E 's/.*Payment ([0-9]+) (declined).*/\2: \1/'
# ERE'de lookahead yok: grep uyarı verir ve eşleşme bulamaz
echo "$line" | grep -oE 'Payment [0-9]+(?= declined)' || echo "ERE lookahead: no match"
$ bash shell/bre-ere.sh
BKS-2026-000126
BRE {4}: no match
BKS-2026-000126
declined: 4713
declined: 4713
grep: warning: ? at start of expression
ERE lookahead: no match
İkinci satır BRE'nin tuzağı: {4} burada süslü parantez, 4 ve süslü parantez karakterleri demek ve log'da öyle bir metin yok. sed'in iki satırı aynı sonucu veriyor; -E yalnızca parantezlerin ters bölüsünü kaldırıyor. Bugün yazdığın her script'te grep -E ve sed -E kullan; BRE'yi okuyabilmen yeterli, çünkü eski script'lerde ve Stack Overflow cevaplarında hep karşına çıkacak.
Son satır tahminin ilk cevabı. ERE'de lookahead yok; GNU grep (? dizisini görünce bir uyarı yazıyor ve pattern'i kendi kurallarıyla yorumlayıp hiçbir satır bulamıyor. Script'in içinde stderr başka bir yere yönlendirilmişse bu uyarıyı hiç görmezsin ve "log'da reddedilen ödeme yok" diye yanlış bir sonuca varırsın.
POSIX'in bir farkı daha var: alternatiflerden en soldakini değil, en uzun eşleşmeyi seçiyor. Üçüncü yazıda BKS|BKS-2026 ile gördüğümüz bu kural aşağıdaki tabloda da çıkacak.
Perl Ailesi: PCRE2, .NET ve JavaScript Aynı Dili Konuşmuyor
Perl ailesindeki engine'ler temel syntax'ta anlaşıyor, ayrıntıda ayrışıyor. Farkı görmenin en hızlı yolu aynı pattern listesini her engine'e vermek. Her satırda bir probe adı, pattern ve input var; araya tab karakteri konmuş:
$ cat data/flavor-probes.tsv
lookahead	[0-9]+(?= TRY)	450 TRY
lookbehind	(?<=BKS-)[0-9]{4}	BKS-2026-000123
backref	\b(\w+) \1\b	is is
atomic	(?>[0-9]+)0	1230
possessive	[0-9]++0	1230
named	(?<year>[0-9]{4})	2026
named-P	(?P<year>[0-9]{4})	2026
unicode-prop	\p{Lu}+	ÇALIKUŞU
digit	\d	٣
recursion	\((?:[^()]|(?R))*\)	f(a(b)c)
inline-i	(?i)bks	BKS
posix-class	[[:digit:]]+	2026
alternation	BKS|BKS-2026	BKS-2026
portable	^BKS-[0-9]{4}-[0-9]{6}$	BKS-2026-000123
.NET ve JavaScript tarafında dosyayı okuyup her satırı deneyen kısa programlar var:
using System.Text.RegularExpressions;

// aynı probe dosyası .NET'te: eşleşen ilk metin, "-" ya da exception mesajının sonu
Console.WriteLine($"{"probe",-14}.NET");
foreach (string line in File.ReadLines("data/flavor-probes.tsv"))
{
    string[] parts = line.Split('\t');
    string result;
    try
    {
        Match m = Regex.Match(parts[2], parts[1]);
        result = m.Success ? m.Value : "-";
    }
    catch (ArgumentException ex)
    {
        result = "error: " + ex.Message.Split(". ")[^1].TrimEnd('.');
    }
    Console.WriteLine($"{parts[0],-14}{result}");
}
import { readFileSync } from "node:fs";
// aynı probe dosyası JavaScript'te: flag'siz ve u flag'iyle
const lines = readFileSync("data/flavor-probes.tsv", "utf8").trim().split("\n");
const cell = (pattern, flags, input) => {
try {
const m = new RegExp(pattern, flags).exec(input);
return m ? m[0] : "-";
} catch (e) {
return "error: " + e.message.split(": ").at(-1);
}
};
console.log("probe".padEnd(14) + "no flag".padEnd(28) + "u flag");
for (const line of lines) {
const [name, pattern, input] = line.split("\t");
console.log(name.padEnd(14) + cell(pattern, "", input).padEnd(28) + cell(pattern, "u", input));
}$ dotnet run dotnet/flavor-probes.cs
probe .NET
lookahead 450
lookbehind 2026
backref is is
atomic -
possessive error: Nested quantifier '+'
named 2026
named-P error: Unrecognized grouping construct
unicode-prop ÇALIKUŞU
digit ٣
recursion error: Unrecognized grouping construct
inline-i BKS
posix-class -
alternation BKS
portable BKS-2026-000123
$ node js/flavor-probes.mjs
probe no flag u flag
lookahead 450 450
lookbehind 2026 2026
backref is is is is
atomic error: Invalid group error: Invalid group
possessive error: Nothing to repeat error: Nothing to repeat
named 2026 2026
named-P error: Invalid group error: Invalid group
unicode-prop - ÇALIKUŞU
digit - -
recursion error: Invalid group error: Invalid group
inline-i error: Invalid group error: Invalid group
posix-class - error: Lone quantifier brackets
alternation BKS BKS
portable BKS-2026-000123 BKS-2026-000123Komut satırı tarafında aynı dosyayı grep -E, grep -P ve rg ile deneyen bir script var. Her hücrede eşleşen ilk metin, eşleşme yoksa -, araç uyarı verip bir şey bulamadıysa warning, pattern'i reddettiyse error yazıyor:
$ cat shell/flavor-probes.sh
#!/usr/bin/env bash
# her probe'u grep -E, grep -P ve rg ile dene: eşleşen ilk metin, "-" (eşleşme yok),
# "warning" (uyarı verip eşleşmedi) ya da "error"
cell() {
    local out err
    out=$(printf '%s\n' "$2" | "${@:3}" -o -e "$1" 2>/dev/null | head -1)
    err=$(printf '%s\n' "$2" | "${@:3}" -o -e "$1" 2>&1 >/dev/null)
    if [[ -n $err && -z $out ]]; then
        [[ $err == *warning:* ]] && out=warning || out=error
    fi
    out=${out:--}
    printf '%s%*s' "$out" $((17 - ${#out})) ''
}
printf '%-14s%-17s%-17s%s\n' probe grep-E grep-P rg
while IFS=$'\t' read -r name pattern input; do
    printf '%-14s' "$name"
    cell "$pattern" "$input" grep -E
    cell "$pattern" "$input" grep -P
    cell "$pattern" "$input" rg
    echo
done < data/flavor-probes.tsv | sed "s/ *$//"
$ bash shell/flavor-probes.sh
probe         grep-E           grep-P           rg
lookahead     warning          450              error
lookbehind    warning          2026             error
backref       is is            is is            error
atomic        warning          -                error
possessive    1230             -                1230
named         warning          2026             2026
named-P       warning          2026             2026
unicode-prop  warning          ÇALIKUŞU         ÇALIKUŞU
digit         warning          -                ٣
recursion     warning          (a(b)c)          (b)
inline-i      warning          BKS              BKS
posix-class   2026             2026             2026
alternation   BKS-2026         BKS              BKS
portable      BKS-2026-000123  BKS-2026-000123  BKS-2026-000123
Perl ailesi içindeki farkları okuyalım. Atomic group (?>...) .NET ve PCRE2'de var; ikinci yazıda gördüğümüz gibi 1230'u eşleştirmiyor, çünkü grup aldığı rakamları geri vermiyor. JavaScript'te atomic group yok. Possessive quantifier ++ yalnızca PCRE2'de var; .NET Nested quantifier diye, JavaScript Nothing to repeat diye reddediyor. Python tarzı (?P<year>...) isimli grubu PCRE2 kabul ediyor, .NET ve JavaScript etmiyor.
Recursion yalnızca PCRE2'de: (?R) bütün pattern'i kendi içinde yeniden çağırıyor ve iç içe parantezleri (a(b)c) olarak tek parça yakalıyor. .NET'te aynı işi balancing group'larla yapmak mümkün ama okunması zor; dengeli parantez gerçekten gerekiyorsa çoğu zaman doğru araç küçük bir parser. [[:digit:]] gibi POSIX class'ları PCRE2 tanıyor; .NET hata vermeden başka bir class olarak okuyup eşleşme bulamıyor, JavaScript u flag'i olmadan aynısını yapıyor, u ile reddediyor. Inline (?i) JavaScript'te yok; dördüncü yazıda gördüğümüz (?i:...) modifier'ı tek seçenek.
Nginx de bu ailede. location ~ ve büyük/küçük harf duyarsız location ~* blokları Perl uyumlu syntax kullanıyor; Nginx 1.21.5'ten beri PCRE2 ile derlenebiliyor. Nginx dokümanına göre önce = ile tam eşleşme, sonra en uzun prefix aranıyor; prefix ^~ ile işaretliyse regex'lere hiç bakılmıyor, değilse regex location'ları dosyadaki sırayla deneniyor ve ilk tutan kazanıyor. Yani regex location'larda sıra önemli, prefix'lerde değil. Ayrıntısı Web Server'lar ve Hosting serisinin "Nginx Temelleri" yazısında.
RE2 ve Rust regex: Backtracking Yoksa Ne Kaybedersin?
Tahmindeki ikinci komutun cevabı ripgrep'in hata mesajında:
$ cat shell/rg-engines.sh
#!/usr/bin/env bash
# varsayılan engine (Rust regex): lookaround yok, hata verir
rg -o 'Payment [0-9]+(?= declined)' data/app.log
# -P ile PCRE2, --engine auto ile "gerekiyorsa PCRE2"
rg -oP 'Payment [0-9]+(?= declined)' data/app.log
rg -o --engine auto 'Payment [0-9]+(?= declined)' data/app.log
# hata vermeyen ama başka anlama gelen syntax'lar
printf 'f(a(b)c)\n' | rg -o '\((?:[^()]|(?R))*\)'
printf 'f(a(b)c)\n' | rg -oP '\((?:[^()]|(?R))*\)'
printf '1230\n' | rg -o '[0-9]++0'
printf '1230\n' | rg -oP '[0-9]++0' || echo "PCRE2 possessive: no match"
$ bash shell/rg-engines.sh
rg: regex parse error:
    (?:Payment [0-9]+(?= declined))
                     ^^^
error: look-around, including look-ahead and look-behind, is not supported

Consider enabling PCRE2 with the --pcre2 flag, which can handle backreferences
and look-around.
Payment 4713
Payment 4713
(b)
(a(b)c)
1230
PCRE2 possessive: no match
Bu engine'ler pattern'i bir automata'ya çeviriyor ve input'u bir kez soldan sağa okuyor. Bir karaktere birden fazla kez dönmedikleri için çalışma süresi input uzunluğuyla doğru orantılı kalıyor; Rust regex dokümanı en kötü durumu pattern ve input boyutunun çarpımıyla sınırlı olarak veriyor. Bunun bedeli backtracking gerektiren yapılar: backreference, lookahead, lookbehind, atomic group, recursion. RE2'nin syntax sayfası bunları açıkça desteklenmiyor diye listeliyor. Kazanç ise sekizinci yazının konusu olan üstel yavaşlamanın hiç olmaması.
ripgrep bu yüzden iki engine taşıyor: varsayılanı Rust regex, -P ile PCRE2, --engine auto ile pattern'in gerektirdiği engine. Lookaround'a ihtiyacın varsa -P yaz; yoksa varsayılanı kullan, büyük repo'larda çoğu zaman daha hızlı.
Asıl dikkat edilecek yer son dört satır. Rust regex'te R bir inline flag: satır sonlarını \r\n olarak tanıyan mod. Bu yüzden (?R) hata vermiyor, boş bir flag grubu olarak okunuyor ve pattern "parantez içinde parantez olmayan metin" anlamına geliyor; sonuç (a(b)c) değil (b). [0-9]++0 de hata vermiyor: iki quantifier üst üste yazılabiliyor ve sonuç sıradan bir greedy eşleşme, 1230. Aynı şey grep -E'de de oluyor. PCRE2'de ise possessive quantifier rakamları geri vermediği için eşleşme yok. Bir pattern'i flavor değiştirerek taşıdığında hata almamak, aynı şeyi yaptığı anlamına gelmiyor.
Prometheus'ta =~ Her Zaman Tam Eşleşmedir
Prometheus Go ile yazılmış ve label matcher'larında Go'nun RE2 syntax'ını kullanıyor. Dokümanına göre bir fark daha var: =~ pattern'i otomatik olarak baştan sona sabitliyor, yani path=~"/api/books" aslında ^(?:/api/books)$. Bunu bir Prometheus sunucusu kurmadan promtool'un kural testleriyle görebilirsin:
# promtool test rules prometheus/anchoring-test.yml
rule_files: []
evaluation_interval: 1m
tests:
  - interval: 1m
    input_series:
      - series: 'http_requests_total{path="/api/books"}'
        values: '1+1x5'
      - series: 'http_requests_total{path="/api/books/9780441172719"}'
        values: '1+1x5'
      - series: 'http_requests_total{path="/api/orders"}'
        values: '1+1x5'
    promql_expr_test:
      # beklenti: "/api/books içeriyor", yani 2 series
      - expr: count(http_requests_total{path=~"/api/books"})
        eval_time: 5m
        exp_samples:
          - value: 2
      # tam eşleşme olarak yazınca aynı beklenti tutar
      - expr: count(http_requests_total{path=~"/api/books.*"})
        eval_time: 5m
        exp_samples:
          - value: 2
      # negative lookahead: "orders dışında /api altındaki her şey"
      - expr: count(http_requests_total{path=~"/api/(?!orders).*"})
        eval_time: 5m
        exp_samples:
          - value: 2
$ promtool test rules prometheus/anchoring-test.yml
Processing test file: prometheus/anchoring-test.yml
FAILED:
expr: "count(http_requests_total{path=~\"/api/books\"})", time: 5m,
exp: {} 2E+00
got: {} 1E+00
expr: "count(http_requests_total{path=~\"/api/(?!orders).*\"})", time: 5m, err: 1:27: parse error: error parsing regexp: invalid or unsupported Perl syntax: `(?!`Tahminin Prometheus cevabı 1: /api/books/9780441172719 sayılmadı. İkinci test .* eklenince geçtiği için çıktıda görünmüyor. Üçüncü test Go'nun regexp paketinin lookahead'i reddettiğini gösteriyor. Grafana dashboard'larında ve alert kurallarında =~ yazarken pattern'i grep gibi "içinde geçiyor" diye değil, bütün değeri tarif eden bir ifade olarak düşün.
Karşılaştırma Tablosu
Yukarıdaki çıktıları ve önceki yazılarda gördüklerimizi tek tabloda toplayalım. Sütunlarda .NET, JavaScript (u flag'iyle), PCRE2 (grep -P), POSIX ERE (grep -E) ve RE2 ailesi (ripgrep'in varsayılan engine'i ve Go) var:
| Özellik | .NET | JavaScript | PCRE2 | POSIX ERE | RE2 / Rust |
|---|---|---|---|---|---|
| Lookahead | var | var | var | yok | yok |
| Lookbehind | her uzunluk | her uzunluk | sınırlı uzunluk | yok | yok |
| Backreference | var | var | var | GNU eki | yok |
| Atomic group | var | yok | var | yok | yok |
Possessive ++ | hata | hata | var | greedy olur | greedy olur |
| Named group | (?<n>) | (?<n>) | (?<n>), (?P<n>) | yok | (?<n>), (?P<n>) |
\d | Unicode rakamları | 0-9 | 0-9 | yok | Rust: Unicode, RE2: 0-9 |
Unicode property \p{Lu} | var | u ile | var | yok | var |
| Recursion | balancing group | yok | (?R) | yok | yok |
Inline (?i) | var | yalnız (?i:...) | var | yok | var |
| Alternation | ilk tutan | ilk tutan | ilk tutan | en uzun | ilk tutan |
| Lineer zaman garantisi | yalnız NonBacktracking | yok | yok | uygulamaya bağlı | var |
İki satıra not düşelim. Lineer zaman satırında POSIX için "uygulamaya bağlı" yazdım, çünkü standart bir engine tarif etmiyor; GNU grep çoğu pattern'de automata tabanlı hızlı bir matcher kullanıyor, backreference görünce daha yavaş bir yedek matcher'a geçiyor. Prometheus sütunda yok, ama Go ile aynı satırlara sahip ve buna bir de otomatik tam eşleşme ekleniyor.
Glob ile Regex'i Ayırmak
Regex'le en sık karışan şey glob: shell'in *.cs gibi dosya adı pattern'leri. İkisi de yıldız kullanıyor ama anlamları farklı. Glob'da * tek başına "herhangi bir metin", ? "tek bir karakter" demek. Regex'te * önündeki şeyin tekrarı, ? önündekinin isteğe bağlı olması, . herhangi bir karakter. Python'un fnmatch module'ü bir glob'un hangi regex'e karşılık geldiğini gösteriyor:
import fnmatch

# fnmatch bir glob'u karşılık geldiği regex'e çevirir
for glob in ["*.cs", "Order?.cs", "[!.]*.log"]:
    print(f"{glob:12} {fnmatch.translate(glob)}")
$ python3 python/glob-translate.py
*.cs (?s:.*\.cs)\z
Order?.cs (?s:Order.\.cs)\z
[!.]*.log (?s:[^.].*\.log)\zGlob otomatik olarak tam eşleşme; nokta düz nokta; [!...] regex'teki [^...]. PowerShell iki dünyayı yan yana koyuyor: -like wildcard (glob benzeri) alıyor, -match .NET regex'i:
$files = 'OrderService.cs', 'OrderService.cs.bak', 'Orders.csv', 'app.log'

# -like wildcard pattern'i, -match .NET regex'i alır
$files | Where-Object { $_ -like '*.cs' }
'---'
$files | Where-Object { $_ -match '.cs' }
'---'
$files | Where-Object { $_ -match '\.cs$' }
'---'
# -match'e verilen glob geçersiz bir regex'tir
try { 'OrderService.cs' -match '*.cs' } catch { $_.Exception.Message }
$ pwsh -NoProfile -File powershell/glob-vs-regex.ps1
OrderService.cs
---
OrderService.cs
OrderService.cs.bak
Orders.csv
---
OrderService.cs
---
Invalid pattern '*.cs' at offset 1. Quantifier '*' following nothing.-match '.cs' Orders.csv'yi de buldu: nokta herhangi bir karakter ve sona sabitlenmemiş. Glob'u regex yerine yazınca bazen hata alırsın, bazen de bu örnekteki gibi fazla eşleşme. Ters yöndeki hata daha sinsi, çünkü hiç hata mesajı yok. .gitignore satırları glob; regex yazarsan Git onu sessizce hiçbir şeyle eşleşmeyen bir glob olarak okuyor:
$ cat shell/gitignore-glob.sh
#!/usr/bin/env bash
# .gitignore satırları glob'dur: regex yazınca sessizce hiçbir şeyi eşleştirmez
repo=$(mktemp -d)
cd "$repo" && git init -q
mkdir -p src/Bookstore.Api/bin logs
touch src/Bookstore.Api/Program.cs src/Bookstore.Api/bin/Bookstore.Api.dll logs/app.log logs/app.log.1
printf '%s\n' '.*\.log$' 'bin' > .gitignore
git check-ignore -v --no-index src/Bookstore.Api/bin/Bookstore.Api.dll logs/app.log logs/app.log.1
echo '---'
printf '%s\n' '*.log' '*.log.[0-9]' 'bin/' > .gitignore
git check-ignore -v --no-index src/Bookstore.Api/bin/Bookstore.Api.dll logs/app.log logs/app.log.1
rm -rf "$repo"
$ bash shell/gitignore-glob.sh
.gitignore:2:bin	src/Bookstore.Api/bin/Bookstore.Api.dll
---
.gitignore:3:bin/	src/Bookstore.Api/bin/Bookstore.Api.dll
.gitignore:1:*.log	logs/app.log
.gitignore:2:*.log.[0-9]	logs/app.log.1
İlk .gitignore'daki .*\.log$ satırı hiçbir dosyayı yakalamadı; log dosyaları commit'e girmeye hazır bekliyor. git check-ignore -v bir dosyayı hangi satırın yakaladığını gösterdiği için bu tür hataları bulmanın en kısa yolu.
GitHub Actions'ın branches ve paths filtreleri ise ikisinin karışımı; bunu çalıştırmadım, GitHub'ın workflow syntax dokümanındaki filtre tablosuna göre yazıyorum. * / dışında her şey, ** / dahil her şey demek; ama ? ve + regex'teki gibi önündeki karakterin sıfır ya da bir, bir ya da daha fazla tekrarı. Yani v2.? glob alışkanlığıyla okunduğu gibi "v2. ve ardından tek karakter" değil, "v2 ya da v2." demek. Aynı dosyada iki farklı mini dil olduğu için şüphede kaldığında dokümandaki örnek tabloya bak.
Bookstore'da Taşınabilir Pattern
Bookstore'da sipariş numarası pattern'i birçok yerde yaşıyor: Angular formundaki validator JavaScript'te, API'deki doğrulama .NET'te, log aramaları grep ve ripgrep'te, sipariş endpoint'inin metrikleri Prometheus'ta. Hepsinde aynı davranışı istiyorsan pattern'i bütün flavor'ların ortak kümesinde yaz. Probe dosyasının son satırı, ^BKS-[0-9]{4}-[0-9]{6}$, bu yüzden bütün engine'lerde aynı sonucu verdi. Ortak kümenin kuralları kısa:
- Rakam için
\dyerine[0-9], harf için açık aralıklar ya da gerçekten Unicode gerekiyorsa her engine'de ayrı test edilmiş\p{L}. - Lookaround, backreference, atomic group, possessive quantifier ve recursion yok.
- Inline flag yok; büyük/küçük harf duyarsızlığını her platformun kendi option'ıyla ver.
- Anchor'ları açıkça yaz: Prometheus otomatik tam eşleşme yapıyor, grep ve .NET yapmıyor;
^...$yazmak ikisinde de aynı sonucu veriyor. - İsimli grup gerekiyorsa
(?<name>...); PCRE2, .NET, JavaScript ve RE2 ailesinin hepsi kabul ediyor, POSIX ERE etmiyor.
Pattern bir yerde tanımlanıp diğerlerine kopyalanıyorsa (örneğin API bir endpoint'ten Angular'a validator pattern'i gönderiyorsa) bu kurallar zorunlu. .NET tarafında RegexOptions.ECMAScript \d ve \w'yu JavaScript gibi ASCII'ye (temel İngilizce karakter seti) çekiyor, ama birinci yazıda gördüğümüz gibi JavaScript'in bütün davranışını taklit etmiyor; asıl güvence pattern'i iki tarafta aynı test listesiyle denemek.
Üretimde Dikkat
Konfigürasyonda duran bir pattern'in yanına hangi engine'de çalıştığını yaz. appsettings.json'daki bir log filtresi .NET'te, bir alert kuralı Go'da, Nginx'teki bir rewrite PCRE2'de çalışıyor. Aynı ekip üçünü de "regex" diye düzenliyor; bir yerde çalışan pattern'in diğerinde hata vereceğini ya da daha kötüsü başka bir şey eşleştireceğini kimse fark etmiyor.
Script'lerde grep uyarılarını yutma. 2>/dev/null ile susturulmuş bir grep -E, lookahead'li bir pattern'de sessizce boş döner ve "sonuç yok" ile "pattern çalışmadı" arasındaki farkı kaybedersin. set -o pipefail ve çıkış kodunu kontrol etmek bu farkı yakalamaya yardım eder: grep eşleşme yoksa 1, hata varsa 2 döndürür.
Kullanıcının yazdığı metinle arama yapan bir özellik (gelişmiş arama, log viewer filtresi) tasarlıyorsan metni doğrudan regex olarak çalıştırma. Kullanıcıya glob gibi basit bir wildcard syntax'ı sun ve onu kendin regex'e çevir; yukarıdaki fnmatch.translate bunun bir örneği. Input'un kendisi güvenilmezse, örneğin dışarıdan gelen uzun metinleri tarıyorsan, backtracking'siz bir engine seç: .NET'te RegexOptions.NonBacktracking, Go'da standart regexp. Yedinci ve sekizinci yazıda bunun neden önemli olduğunu ölçeceğiz.
Sık Düşülen Tuzaklar
Shell glob'unu regex sanmak
-match '*.cs' hata verir, -match '.cs' fazla eşleştirir. Dosya adı filtrelerinde -like, rg -g ya da find -name glob ister; regex istiyorsan \.cs$ yaz.
grep -P'de denediğin pattern'i ripgrep'te çalıştırmak
Lookaround ve backreference ripgrep'in varsayılan engine'inde yok. Hata mesajı açık, çözüm de: rg -P ya da --engine auto.
Hata almamayı doğru çalışmak sanmak
ripgrep'te (?R) bir flag, [0-9]++ greedy bir tekrar; grep -E'de (?=...) bir uyarı ve boş sonuç; .NET'te [[:digit:]] başka bir class. Pattern'i taşıdıysan sonucunu da karşılaştır.
Prometheus'ta =~'yi "içeriyor" diye okumak
=~ her zaman bütün label değerini eşleştirir. "İçeriyor" istiyorsan .*/api/books.* yaz.
.gitignore'a regex yazmak
Git hata vermez, yalnızca hiçbir dosyayı yok saymaz. git check-ignore -v ile kontrol et.
Küçük Bir Deneme
★☆☆ data/app.log'daki BKS-2026-000126 numarasını BRE, ERE ve PCRE2 ile ayrı ayrı yazılmış üç grep komutuyla bul. Hangisinde ters bölü sayısı en fazla?
★★☆ data/flavor-probes.tsv'ye \bBKS\b ve [\w-]+ için iki satır ekle ve üç script'i yeniden çalıştır. Input'a Türkçe karakter koyunca hangi sütunlar değişiyor?
★★★ Emre'nin Payment [0-9]+(?= declined) pattern'ini lookaround kullanmadan, ripgrep'in varsayılan engine'inde ve grep -E'de çalışacak biçimde yeniden yaz. İpucu: eşleşmenin tamamını değil, bir grubu çıktı olarak almanın yolunu ara (rg -r).
Flavor'ları ve araçları tanıdık. Bir sonraki yazıda bu araçlarla gerçek iş yapacağız: grep, ripgrep, sed, git grep ve PowerShell ile repo genelinde arama ve toplu değişiklik, Visual Studio Code (VS Code), Visual Studio ve Rider'da regex find/replace, Bookstore'da string interpolation'lı log çağrılarını message template'e çeviren bir refactor ve CRLF'li (satır sonu \r\n olan) dosyalarda $'ın beklenmedik davranışı.