

Quantifier'lar ve Backtracking: Greedy, Lazy, Possessive ve Atomic Group
Greedy quantifier önce alabildiğini alır ve pattern'in geri kalanı tutmazsa karakter karakter geri verir; lazy quantifier az alıp tek tek ekler, ama ikisi de ayırıcıyı arayarak adım harcar ve en doğru, en hızlı yol çoğu zaman negated class'tır. PCRE2'nin adım sayılarıyla greedy, lazy, possessive ve atomic group'u karşılaştırıyor, Bookstore'un access log'undan endpoint, status ve süreyi .NET, JavaScript ve sed ile çekiyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10 (SDK 10.0.404), Node.js 26.13 (LTS), grep 3.12 (GNU), PCRE2 (Perl uyumlu regex library'si) 10.49, sed 4.10 (GNU) ve ripgrep 15.2.0 ile denenmiştir. Adım sayıları PCRE2'nin pcre2test aracından alındı; grep, sed, rg ve pcre2test komutları Linux'ta, WSL'de (Windows içindeki Linux ortamı) ya da Git Bash'te çalışır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'un (bir online kitapçı) önündeki web sunucusu her isteği access log'a bir satır olarak yazıyor:
203.0.113.24 - - [15/Nov/2026:10:42:07 +0000] "GET /api/books/978-0-441-17271-9 HTTP/1.1" 200 1532 "-" "Mozilla/5.0" 0.042Satırdaki ilk tırnaklı alan isteğin kendisi: method, path ve protokol. Bunu almak için akla ilk gelen pattern ".*": bir tırnak, arada ne varsa, bir tırnak daha. Bu pattern yukarıdaki satırda tam olarak neyi yakalar? Bir de şunu düşün: ".*?" yazınca sonuç doğru çıkıyorsa, iş çözülmüş sayılır mı?
Quantifier'lar: Kaç Kez?
Quantifier, kendinden önceki parçanın kaç kez tekrarlanacağını söyler. * sıfır ya da daha fazla, + bir ya da daha fazla, ? sıfır ya da bir, {n} tam n, {n,} en az n, {n,m} n ile m arası. Bunlar JavaScript Temel serisinin "JavaScript RegEx Temelleri" yazısında anlatıldı ve bütün flavor'larda aynı.
Aynı olmayan bir yazım var: {,3}. Perl 5.34 bunu "en fazla üç" olarak kabul etmeye başladı, PCRE2 de 10.43 sürümünde aynı yolu izledi. Diğerleri farklı düşünüyor:
using System.Text.RegularExpressions;

// {,3} "en fazla üç" mü, yoksa dört literal karakter mi?
Console.WriteLine($"{Regex.IsMatch("xx", "^x{,3}$")} {Regex.IsMatch("x{,3}", "^x{,3}$")}");
$ dotnet run dotnet/brace-quantifier.cs
False True
$ node js/brace-quantifier.mjs
false true
SyntaxError: Invalid regular expression: /^x{,3}$/u: Incomplete quantifier
$ printf 'xx\nx{,3}\n' | grep -E '^x{,3}$'
xx
$ printf 'xx\nx{,3}\n' | grep -P '^x{,3}$'
xx
$ printf 'xx\nx{,3}\n' | rg '^x{,3}$'
rg: regex parse error:
(?:^x{,3}$)
^
error: repetition quantifier expects a valid decimal.NET ve flag'siz JavaScript {,3}'ü dört sıradan karakter olarak okudu ve x{,3} metnini buldu. JavaScript u flag'iyle hata verdi, GNU grep ve PCRE2 "en fazla üç" dedi, ripgrep pattern'i reddetti. Aynı pattern dört farklı anlama geliyor. Taşınabilir yazmak istiyorsan alt sınırı her zaman yaz: {0,3}.
Greedy: Önce Hepsini Al, Sonra Geri Ver
Varsayılan olarak quantifier'lar greedy'dir: alabildikleri kadar çok karakter alırlar. Ama bu, pattern'in geri kalanı tutmazsa geri vermeyecekleri anlamına gelmiyor. Engine bir parça tutmayınca son kararına geri döner ve quantifier'dan bir karakter geri ister; buna backtracking denir. Kısa bir input üzerinde üç pattern'in izini PCRE2'ye yazdıralım:
$ cat shell/trace-quotes.txt
/".*"/auto_callout
"GET /" 200

/".*?"/auto_callout
"GET /" 200

/"[^"]*"/auto_callout
"GET /" 200
$ pcre2test shell/trace-quotes.txt
PCRE2 version 10.49 2026-09-28 (8-bit)
/".*"/auto_callout
"GET /" 200
--->"GET /" 200
 +0 ^               "
 +1 ^^              .*
 +3 ^          ^    "
 +3 ^         ^     "
 +3 ^        ^      "
 +3 ^       ^       "
 +3 ^      ^        "
 +3 ^     ^         "
 +4 ^      ^        End of pattern
 0: "GET /"

/".*?"/auto_callout
"GET /" 200
--->"GET /" 200
 +0 ^               "
 +1 ^^              .*?
 +4 ^^              "
 +4 ^ ^             "
 +4 ^  ^            "
 +4 ^   ^           "
 +4 ^    ^          "
 +4 ^     ^         "
 +5 ^      ^        End of pattern
 0: "GET /"

/"[^"]*"/auto_callout
"GET /" 200
--->"GET /" 200
 +0 ^               "
 +1 ^^              [^"]*
 +6 ^     ^         "
 +7 ^      ^        End of pattern
 0: "GET /"
İlk izde .* tek hamlede satırın sonuna kadar gidiyor; ikinci ^ işareti 11. pozisyonda. Sonra kapanış tırnağı aranıyor: satır sonunda yok, engine .*'dan bir karakter geri alıyor, 10. pozisyonda deniyor, yine yok. Bu beş kez tekrarlanıyor ve tırnak ancak 6. pozisyonda bulunuyor. Bu kısa input'ta sonuç doğru çıktı, çünkü satırda yalnızca iki tırnak var.
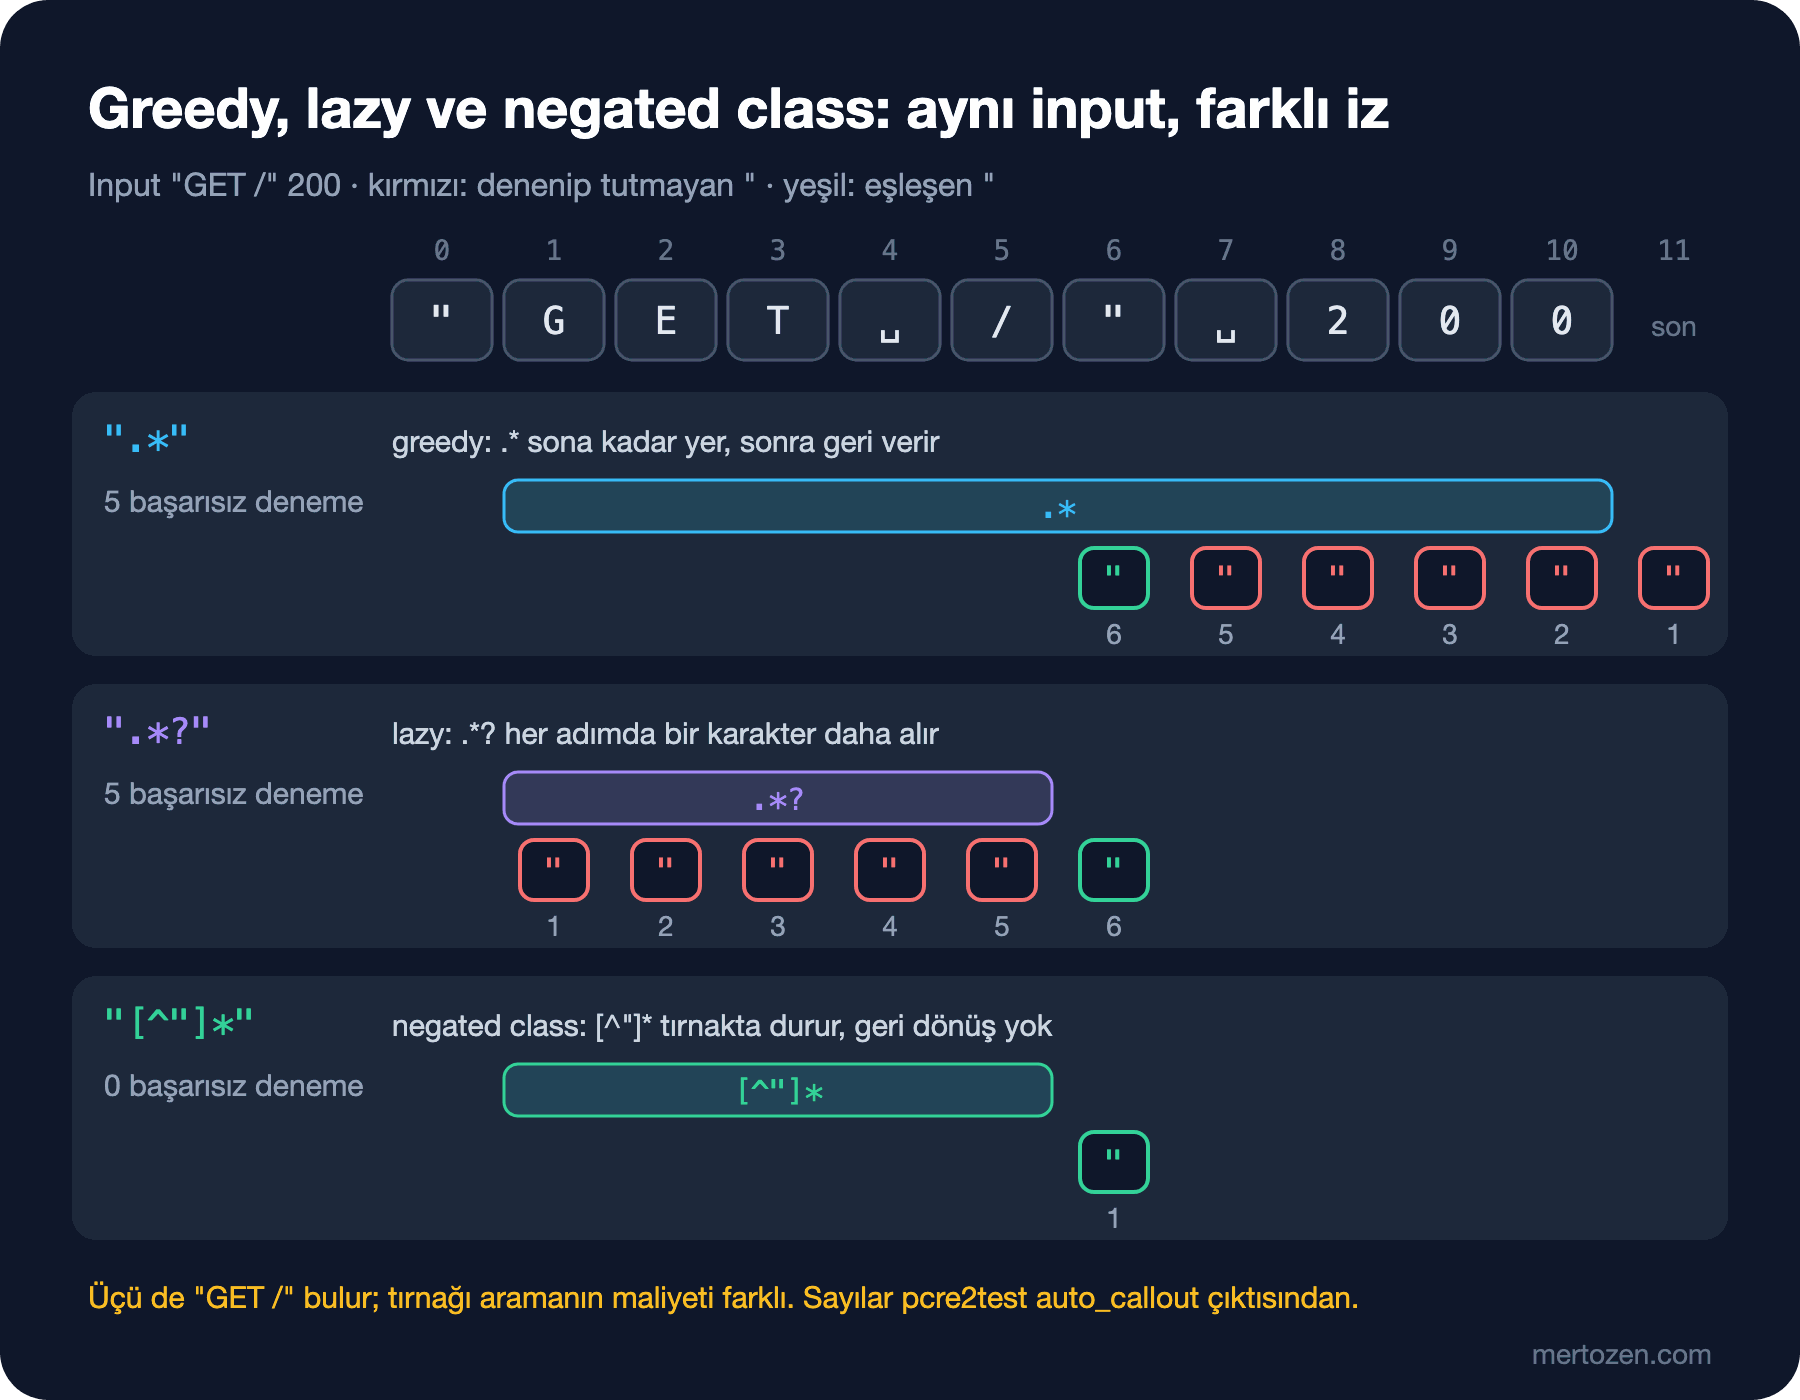
Tahminin cevabı da buradan çıkıyor. Gerçek log satırında altı tırnak var. Greedy .* satırın sonuna kadar gidip geri verirken karşılaştığı ilk tırnakta, yani sondan ikinci tırnakta duruyor:
$ cat shell/steps.sh
#!/usr/bin/env bash
# her pattern için PCRE2 kaç adım raporluyor?
line=${1:-$(head -1 data/access.log)}
input=$(mktemp)
for p in '".*"' '".*?"' '"[^"]*"' '^.*" ([0-9]{3}) ' '^.*?" ([0-9]{3}) ' '^[^"]*"[^"]*" ([0-9]{3}) '; do
    printf '/%s/auto_callout%s\n%s\n' "$p" "${OPTS:-}" "$line" > "$input"
    out=$(pcre2test "$input")
    steps=$(grep -c '^ *+[0-9]' <<< "$out")
    match=$(grep -m1 '^ 0:' <<< "$out" | cut -c5-)
    printf '%-26s %4s  %s\n' "$p" "$steps" "${match:-no match}"
done
rm -f "$input"
$ bash shell/steps.sh
".*"                         11  "GET /api/books/978-0-441-17271-9 HTTP/1.1" 200 1532 "-" "Mozilla/5.0"
".*?"                        45  "GET /api/books/978-0-441-17271-9 HTTP/1.1"
"[^"]*"                       4  "GET /api/books/978-0-441-17271-9 HTTP/1.1"
^.*" ([0-9]{3})              51  203.0.113.24 - - [15/Nov/2026:10:42:07 +0000] "GET /api/books/978-0-441-17271-9 HTTP/1.1" 200
^.*?" ([0-9]{3})             98  203.0.113.24 - - [15/Nov/2026:10:42:07 +0000] "GET /api/books/978-0-441-17271-9 HTTP/1.1" 200
^[^"]*"[^"]*" ([0-9]{3})     11  203.0.113.24 - - [15/Nov/2026:10:42:07 +0000] "GET /api/books/978-0-441-17271-9 HTTP/1.1" 200
".*" isteği değil, istekten user agent'a kadar her şeyi yakaladı. Sayılar pcre2test'in her token denemesinde bastığı satırların sayısı; mutlak bir maliyet değil, ama aynı engine'de pattern'leri karşılaştırmak için iyi bir ölçü.
Lazy: Az Al, Gerekirse Bir Daha
Quantifier'ın arkasına ? koyunca lazy olur: *?, +?, ??, {n,m}?. Lazy quantifier önce mümkün olan en az karakteri alır ve pattern'in geri kalanını dener; tutmazsa bir karakter daha alır. İkinci izde .*? sıfır karakterle başlıyor ve kapanış tırnağını 1., 2., 3. pozisyonda sırayla deniyor; altıncı denemede buluyor. Yön ters ama iş aynı: deneme sayısı tırnağın ne kadar uzakta olduğuna bağlı.
Gerçek satırda ".*?" doğru alanı buldu ama 45 adım attı; greedy olan yanlış sonuç için 11 adım atmıştı. Status kodunu almak için yazılan ^.*?" ([0-9]{3}) ise 98 adımla en pahalısı. Lazy quantifier doğruluk sorununu çözer, performans sorununu çözmez. "Kapanış tırnağına kadar" demenin doğrudan bir yolu varken engine'e her karakterde "burada bitti mi?" diye sordurmuş oluyorsun.
Negated Class: Doğru ve Hızlı Olan
Üçüncü izde [^"]* tırnak olmayan her karakteri alıyor ve tırnağa gelince duruyor. Durduğu yerde kapanış tırnağı zaten var; geri dönüşe gerek kalmıyor. Gerçek satırda 4 adım. Status pattern'inin negated class'lı hâli de 11 adımda bitiyor.
Fark eşleşme olmadığında daha da büyüyor. Log dosyası bir yerde kesilmiş ve son satır kapanış tırnağı olmadan bitmiş olsun. PCRE2 bu satırı optimizasyonlarıyla hiç denemeden eler (ikinci tırnak yoksa eşleşme olamayacağını önceden bilir); engine'in gerçekte ne kadar çalıştığını görmek için no_start_optimize ile çalıştıralım:
$ OPTS=,no_start_optimize bash shell/steps.sh '203.0.113.24 - - [15/Nov/2026:10:42:20 +0000] "GET /api/books/978-0-441-17271-9 HTTP/1.1'
".*"                        132  no match
".*?"                       132  no match
"[^"]*"                      91  no match
^.*" ([0-9]{3})              92  no match
^.*?" ([0-9]{3})             92  no match
^[^"]*"[^"]*" ([0-9]{3})      5  no match
Başarısız aramada greedy ile lazy arasında hiç fark yok: ikisi de bütün olasılıkları deneyip vazgeçiyor. Anchor'lı ve negated class'lı pattern 5 adımda pes ediyor, çünkü [^"]*'nin alacağı karakterler belli ve geri verdiği hiçbir karakter işe yaramıyor. Ayırıcıyla biten bir alanı alırken kural basit: ayırıcı olmayan her şey, sonra ayırıcı. Tırnak için "[^"]*", köşeli parantez için \[[^\]]*\], boşlukla ayrılmış alan için \S+.
Possessive Quantifier ve Atomic Group
Bazen engine'e "bu parçayı aldıysan geri verme" demek istersin. PCRE2'de bunun yolu possessive quantifier: *+, ++, ?+. .NET'te possessive quantifier yok, aynı işi atomic group (?>...) yapıyor; PCRE2 ikisini de destekliyor. Atomic group'un içi bir kez eşleştikten sonra engine oraya geri dönmez:
using System.Text.RegularExpressions;

// \d+ son rakamı geri verir ki 0 eşleşebilsin; atomic group hiçbir şey geri vermez
Console.WriteLine(Regex.IsMatch("1230", @"^\d+0$"));
Console.WriteLine(Regex.IsMatch("1230", @"^(?>\d+)0$"));

// .NET'te atomic group var ama possessive quantifier yok
try
{
    Regex.IsMatch("1230", @"^\d++0$");
}
catch (ArgumentException ex)
{
    Console.WriteLine(ex.Message);
}
$ dotnet run dotnet/atomic.cs
True
False
Invalid pattern '^\d++0$' at offset 5. Nested quantifier '+'.
$ node js/atomic.mjs
^\d+0$ true
^(?>\d+)0$ SyntaxError: Invalid regular expression: /^(?>\d+)0$/: Invalid group
^\d++0$ SyntaxError: Invalid regular expression: /^\d++0$/: Nothing to repeat
^(?=(\d+))\1(?:0)$ false
$ printf '1230\n' | grep -P '^[0-9]++0$'
$ printf '1230\n' | grep -P '^(?>[0-9]+)0$'
$ printf '1230\n' | grep -E '^[0-9]++0$'
1230
$ printf '1230\n' | rg '^[0-9]++0$'
1230^\d+0$ eşleşiyor, çünkü \d+ dört rakamı aldıktan sonra 0 tutmayınca son rakamı geri veriyor. Atomic hâlinde \d+ dört rakamı alıp kilitliyor, 0 için karakter kalmıyor ve eşleşme yok. Bu örnek yapay, ama mantığı önemli: atomic group ve possessive quantifier sonucu değiştirebilir, yalnızca hızlandırmaz.
JavaScript ikisini de desteklemiyor ve açık bir syntax hatası veriyor. Son satırdaki (?=(\d+))\1 JavaScript'te atomic group'un bilinen karşılığı: lookahead içinde yakalanan metin backreference ile tüketiliyor ve lookahead'in içine geri dönülmüyor. Lookahead'i dördüncü, backreference'ı üçüncü yazıda göreceğiz. Komut satırındaki son iki satır daha tehlikeli bir durumu gösteriyor: GNU grep -E ve ripgrep ++'yı hata vermeden normal bir greedy quantifier gibi yorumladı ve 1230'u buldu. PCRE2'de çalışan bir pattern'i başka bir araca taşırken hata almaman, aynı şeyi yaptığı anlamına gelmiyor.
Pratikte possessive ve atomic yapılar en çok şu işe yarar: negated class gibi geri dönüşün zaten anlamsız olduğu yerde engine'e bunu söylemek. "[^"]*+" eşleştiğinde "[^"]*" ile aynı sonucu verir; fark yalnızca eşleşme olmadığında engine'in boşuna geri dönmemesidir. Sekizinci yazıdaki catastrophic backtracking örneklerinde bunun neden önemli olduğunu ölçeceğiz.
Bookstore: Access Log'dan Endpoint, Status ve Süre
Şimdi bütün satırı okuyalım. Hedef: her istek için method, path, status ve süre; 1 saniyeyi aşan istekleri işaretlemek. Her alan için negated class ya da sınırlı bir character class kullanıyoruz; .* yok:
using System.Globalization;
using System.Text.RegularExpressions;

// bir access log satırından method, path, status ve süre
Regex line = new(@"^\S+ \S+ \S+ \[[^\]]*\] ""([A-Z]+) ([^ ""]+) [^""]*"" ([0-9]{3}) [0-9-]+ ""[^""]*"" ""[^""]*"" ([0-9]+\.[0-9]+)$");

foreach (string text in File.ReadLines("data/access.log"))
{
    Match m = line.Match(text);
    if (!m.Success)
    {
        Console.WriteLine($"no match: {text}");
        continue;
    }

    double seconds = double.Parse(m.Groups[4].Value, CultureInfo.InvariantCulture);
    string flag = seconds >= 1 ? "  <-- slow" : "";
    Console.WriteLine($"{m.Groups[3].Value} {m.Groups[1].Value,-4} {m.Groups[2].Value,-36} {m.Groups[4].Value}s{flag}");
}
$ dotnet run dotnet/access-log.cs
200 GET /api/books/978-0-441-17271-9 0.042s
201 POST /api/orders 0.318s
200 GET /api/books?q=dune 0.087s
404 GET /api/orders/BKS-2026-000123 0.006s
200 GET /api/books/978-0-141-43958-7 1.204s <-- slowPattern'i alan alan okuyalım. \S+ \S+ \S+ IP adresi ve iki kullanıcı alanı. \[[^\]]*\] köşeli parantezdeki zaman. "([A-Z]+) ([^ "]+) [^"]*" istek satırı: büyük harflerden oluşan method, boşluk ve tırnak içermeyen path, sonra tırnağa kadar protokol. ([0-9]{3}) status, [0-9-]+ byte sayısı (yanıt gövdesi yoksa - yazılabilir), iki tırnaklı alan referer ve user agent, en sonda ([0-9]+\.[0-9]+)$ süre. C# string'inde tırnak "" olarak yazılıyor; pattern'in kendisinde tek tırnak var. Süreyi double'a çevirirken CultureInfo.InvariantCulture şart: Türkçe kültürde ondalık ayırıcı virgül olduğu için "1.204" başka bir sayıya dönüşür.
JavaScript tarafında aynı pattern, tırnaklar kaçışsız:
const line = /^\S+ \S+ \S+ \[[^\]]*\] "([A-Z]+) ([^ "]+) [^"]*" ([0-9]{3}) [0-9-]+ "[^"]*" "[^"]*" ([0-9]+\.[0-9]+)$/;$ node js/access-log.mjs
200 GET /api/books/978-0-441-17271-9 0.042s
201 POST /api/orders 0.318s
200 GET /api/books?q=dune 0.087s
404 GET /api/orders/BKS-2026-000123 0.006s
200 GET /api/books/978-0-141-43958-7 1.204s <-- slowKomut satırında aynı soruyu sed ile soruyoruz: en yavaş istekler en üstte.
$ cat shell/access-log.sh
#!/usr/bin/env bash
# her istek için süre, status, method ve path; en yavaşı en üstte
sed -E 's/^[^"]*"([A-Z]+) ([^ "]+) [^"]*" ([0-9]{3}) .* ([0-9.]+)$/\4 \3 \1 \2/' data/access.log | sort -rn
$ bash shell/access-log.sh
1.204 200 GET /api/books/978-0-141-43958-7
0.318 201 POST /api/orders
0.087 200 GET /api/books?q=dune
0.042 200 GET /api/books/978-0-441-17271-9
0.006 404 GET /api/orders/BKS-2026-000123
Burada bilerek bir .* bıraktım: status'tan sonraki .* ([0-9.]+)$ kısmında greedy davranış tam istediğimiz şey, çünkü süre satırın son alanı ve .*'ın son boşluğa kadar uzanması gerekiyor. Sorun .*'ın kendisi değil, sınırını bilmeden kullanılması. sed'in kullandığı POSIX (Unix araçlarının uyduğu standart) engine'i backtracking yapmaz, en uzun eşleşmeyi seçer; bu tek satırda sonuç aynı, farkı üçüncü yazıda alternation'la göreceğiz. sed'deki \1-\4 referansları da o yazının konusu.
Üretimde Dikkat
Log dosyaları uzun satırlar ve milyonlarca satırdır. Satır başına birkaç düzine adım fark, büyük bir dosyada saniyelere dönüşür. Ayırıcıyla biten alanlar için negated class kullan, pattern'i mümkünse ^ ile başlat; anchor'sız bir pattern her başlangıç pozisyonunda yeniden denenir.
Log yapılandırılmışsa regex yazma. Bookstore API'nin uygulama log'ları JSON formatındaysa satırı parser'a ver. Regex ile JSON okumak ilk denemede çalışır, ilk iç içe object'te bozulur:
using System.Text.Json;
using System.Text.RegularExpressions;

string json = """{"orderId":"BKS-2026-000123","shipment":{"status":"Delayed"},"status":"Paid"}""";

// regex, hangi object'e ait olursa olsun ilk "status" key'ini bulur
Console.WriteLine(Regex.Match(json, @"""status"":""([^""]*)""").Groups[1].Value);

// parser, siparişe ait "status"ı bilir
Console.WriteLine(JsonDocument.Parse(json).RootElement.GetProperty("status").GetString());
$ dotnet run dotnet/json-status.cs
Delayed
PaidSiparişin durumu Paid, regex'in bulduğu ise kargonun durumu. Key sırası değiştiğinde, araya boşluk girdiğinde ya da değerin içinde kaçışlanmış bir tırnak olduğunda başka hatalar da çıkar. HTML ve CSV (virgülle ayrılmış değer formatı) için de durum aynı; .NET'te I/O İşlemleri serisinin System.Text.Json ve CSV yazıları bu formatları doğru okumanın yollarını anlatıyor. Regex, formatı düz metin olan ve satır yapısı sabit kalan girdiler için doğru araç: access log, eski sistemlerin metin çıktıları, commit mesajları.
Bir pattern'in maliyetini merak ediyorsan tahmin etme, ölç. pcre2test ile adım saymak hızlı bir yöntem; .NET'te gerçek süreyi ölçmek ve kötü bir pattern'in sunucuyu nasıl kilitleyebileceğini görmek yedinci ve sekizinci yazıların konusu.
Sık Düşülen Tuzaklar
Lazy quantifier'ı performans çözümü sanmak
.*? fazla yakalama sorununu çözer, ama engine'i her karakterde durup sormaya zorlar ve eşleşme olmadığında greedy kadar adım atar. Ayırıcı belliyse negated class yaz.
Pattern'in başına .* koymak
.*ERROR ile ERROR aynı satırları bulur; ilki her satırda önce sona gidip geri gelir. Satırı bulmak için grep ERROR yeter; satırın tamamını eşleşme olarak istiyorsan bunu ^.*ERROR.*$ ile açıkça söyle.
{,n} yazımı
.NET'te literal, JavaScript'te u flag'ine göre literal ya da hata, PCRE2 ve GNU grep'te "en fazla n", ripgrep'te hata. Her zaman {0,n} yaz.
Possessive pattern'i başka araca taşımak
[0-9]++ PCRE2'de possessive, .NET'te hata, GNU grep -E ve ripgrep'te sessizce greedy. Taşıdığın pattern'i hedef araçta mutlaka dene.
HTML, JSON ve CSV'yi regex ile parse etmek
Basit örnekte çalışır, gerçek veride bozulur. Formatın bir parser'ı varsa onu kullan.
Küçük Bir Deneme
★☆☆ data/access.log içindeki her satırdan yalnızca köşeli parantezdeki zamanı grep -oE ile çıkar. Önce \[.*\] ile dene, sonra negated class ile; iki sonucu karşılaştır.
★★☆ shell/steps.sh'e "[^"]*+" ve ^[^"]*+"[^"]*+" ([0-9]{3}) pattern'lerini ekle. Tam satırda ve kesilmiş satırda adım sayıları possessive olmayan hâlleriyle aynı mı?
★★★ Access log'a referer'ı tırnak içinde tırnak barındıran bir satır ekle (ör. "https://bookstore.example.com/search?q=\"dune\""). .NET pattern'imiz bu satırda ne yapıyor? Alanı "(?:[^"\\]|\\.)*" ile yeniden yaz ve sonucu açıkla.
Bu yazıda engine'in bir pozisyon içinde nasıl geri döndüğünü ve quantifier seçiminin hem sonucu hem maliyeti nasıl değiştirdiğini gördük. Access log'da alanları numaralı gruplarla aldık; bir sonraki yazıda grupları ayrıntılı ele alacağız: named group'lar, non-capturing group'lar, alternation'ın önceliği, backreference ile tekrar eden kelimeyi bulmak ve replace'te $1 ile ${name}, örnek de CSV'deki "Herbert, Frank" yazar adlarını "Frank Herbert" biçimine çevirmek olacak.