

MongoDB Nedir? Document Model, BSON, Collection ve İlişkisel Dünyadan Farkları

MongoDB, veriyi tablo satırları yerine tipli alanlar taşıyan BSON document'leri olarak saklayan bir document veritabanıdır; birlikte okunan veri tek document'te durduğu için çoğu ekran tek okumayla gelir, ama model tablolardan değil sorgulardan türetilmelidir. Gerçek çıktılarla string tarih tuzağı, BSON byte'ları, Decimal128, ObjectId'nin yapısı, kavram eşlemesi, WiredTiger, lisans ve ne zaman seçilmemesi gerektiği.
Sürüm notu: Bu yazıdaki örnekler MongoDB 9.0.8 Community Server (resmî mongodb/mongodb-community-server Docker image'ı), mongosh 2.6, .NET 10 ve MongoDB.Driver 3.14 ile çalıştırılmıştır. Aynı script'ler MongoDB 8.0.38'de de aynı çıktıyı verdi.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için bir ödeme servisi sipariş kayıtlarını MongoDB'ye yazıyor. Servis JSON aldığı için tarihi olduğu gibi string olarak kaydetmiş. Aynı collection'a yeni kod ise tarihi gerçek bir tarih olarak yazıyor. İki siparişin orderedAt değeri ekranda aynı ana işaret ediyor:
// 01 - Önce Tahmin Et: aynı alan, iki farklı BSON tipi
db = db.getSiblingDB("bookstore_try");
db.orders.drop();

db.orders.insertMany([
    { _id: 1, status: "Delivered", orderedAt: "2026-06-29T10:15:00Z" },
    { _id: 2, status: "Delivered", orderedAt: ISODate("2026-06-29T10:15:00Z") }
]);

const since = ISODate("2026-06-01T00:00:00Z");
printjson(db.orders.find({ orderedAt: { $gte: since } }).toArray());

// Cevap: iki document'te alanın BSON tipi
printjson(db.orders.aggregate([
    { $project: { orderedAtType: { $type: "$orderedAt" } } }
]).toArray());
Script'i sen de çalıştırmak istersen kısa ömürlü bir container yeterli. Kalıcı ve parola korumalı lab'ı bir sonraki yazıda kuracağız; bu container yalnız 127.0.0.1'e açık ve işin bitince silinecek:
docker run -d --name bookstore-mongo-try -p 127.0.0.1:27017:27017 `
  -v "${PWD}\scripts:/lab/scripts:ro" `
  mongodb/mongodb-community-server:9.0-ubuntu2204

# işin bitince
docker rm -f bookstore-mongo-try
1 Haziran'dan beri verilen siparişleri soruyoruz. Kaç sipariş döner: iki, bir, yoksa sorgu tip uyuşmazlığı yüzünden hata mı verir?
docker exec bookstore-mongo-try mongosh --quiet /lab/scripts/01-guess.js[
{
_id: 2,
status: 'Delivered',
orderedAt: ISODate('2026-06-29T10:15:00.000Z')
}
]
[
{
_id: 1,
orderedAtType: 'string'
},
{
_id: 2,
orderedAtType: 'date'
}
]Yalnız bir sipariş döndü ve hata da yok. MongoDB alanın tipini tablo tanımından değil, her document'teki değerin kendisinden bilir. $gte gibi karşılaştırmalar varsayılan olarak yalnız aynı tipteki değerler arasında yapılır; bir date ile bir string karşılaştırılmaz, o document sessizce dışarıda kalır. İkinci çıktıdaki $type sonucu farkı açıkça gösteriyor: biri string, diğeri date. İlişkisel veritabanında kolonun tipi tektir ve yanlış formatta bir değer insert anında reddedilir. MongoDB'de, sen kural koymadıkça (schema validation 5. yazının konusu) iki şekil yan yana yaşar. Bu yazı bu farkın nereden geldiğini anlatıyor: document modeli, BSON (Binary JSON; JSON'un tip bilgisi taşıyan ikili karşılığı) tipleri, _id ve ObjectId, sunucunun yapısı ve MongoDB'nin hangi işte doğru seçim olduğu.
Document, Collection ve Database
MongoDB'de en küçük kayıt birimi document. Bir document, sıralı alan/değer çiftlerinden oluşur; değer bir sayı ya da string olabileceği gibi başka bir document ya da bir array de olabilir. Document'ler collection'larda, collection'lar database'lerde durur. Bir yorum ekleyerek üçüne birden bakalım:
// 01 - document, collection, BSON tipleri ve ObjectId
db = db.getSiblingDB("bookstore_try");
db.reviews.drop();

print("collections before:", db.getCollectionNames().filter(n => n === "reviews").length);
const result = db.reviews.insertOne({
    bookId: 26,
    customer: { customerId: 3, name: "Grace Hopper" },
    rating: 5,
    body: "Still the best science fiction novel I have read.",
    reviewedAt: new Date("2026-06-29T10:15:00Z")
});
print("collections after:", db.getCollectionNames().filter(n => n === "reviews").length);
printjson(result);

const doc = db.reviews.findOne({ _id: result.insertedId });
print("bsonsize:", bsonsize(doc));
print("id time :", doc._id.getTimestamp().toISOString());
collections before: 0
collections after: 1
{
acknowledged: true,
insertedId: ObjectId('6af857ff9de5cff09f284d0c')
}
bsonsize: 180
id time : 2026-11-14T12:45:51.000ZÜç şey dikkat çekiyor. Birincisi, reviews collection'ını hiç oluşturmadık; ilk insert onu oluşturdu. CREATE TABLE karşılığı bir adım zorunlu değil, aynı şey database için de geçerli. İkincisi, document'e _id vermedik ama sonuçta bir insertedId var. Her document'in collection içinde benzersiz, sonradan değiştirilemeyen bir _id alanı olmak zorunda; sen vermezsen istemci (burada mongosh, uygulamada driver) bir ObjectId üretip ekler. _id array ya da regex dışında herhangi bir tipte olabilir; sonraki yazıda Bookstore verisini yüklerken kitaplar ve siparişler için SQL'deki integer kimlikleri koruyacağız. Üçüncüsü, customer alanı başka bir document: müşterinin kimliği ve adı yorumun içinde duruyor. Yorumu ekranda göstermek için müşteri tablosuna gitmek gerekmiyor.
Bir document'in sınırları da belli. Dokümana göre bir BSON document en fazla 16 MiB olabilir ve iç içe en fazla 100 seviye desteklenir; her alt document ve her array bir seviye sayılır. Database ve collection adlarından oluşan namespace sharding olmayan collection'larda en fazla 255 byte. Bu sınırların pratikteki etkisi, özellikle sınırsız büyüyen array'ler, 4. yazının konusu.
BSON: JSON'a Benzeyen Ama JSON Olmayan Format
mongosh'ta gördüğün çıktı JSON'a benziyor, ama MongoDB veriyi diskte, ağda ve bellekte BSON olarak tutar. Farkı görmenin en kolay yolu byte'lara bakmak. Lab projesindeki küçük console uygulaması aynı kitabı hem JSON hem BSON olarak üretiyor ve BSON byte'larını element element ayırıyor. Bunun için sunucu gerekmiyor; yalnız MongoDB.Driver paketindeki BSON library'si kullanılıyor:
// Aynı kitap: JSON metni ve BSON byte'ları
BsonDocument book = new()
{
    { "_id", 26 },
    { "title", "Dune" },
    { "listPrice", new Decimal128(390.50m) },
    { "listedOn", new DateTime(2024, 6, 1, 0, 0, 0, DateTimeKind.Utc) },
};

byte[] bson = book.ToBson();
dotnet run --project src/Bookstore.MongoLab -- bsonJSON : 78 bytes {"_id":26,"title":"Dune","listPrice":390.50,"listedOn":"2024-06-01T00:00:00Z"}
BSON : 75 bytes
length = 75 4b 00 00 00
_id (int32) 10 5f 69 64 00 1a 00 00 00
title (string) 02 74 69 74 6c 65 00 05 00 00 00 44 75 6e 65 00
listPrice (decimal128) 13 6c 69 73 74 50 72 69 63 65 00 8a 98 00 00 00 00 00 00 00 00 00 00 00 00 3c 30
listedOn (date) 09 6c 69 73 74 65 64 4f 6e 00 00 94 18 d1 8f 01 00 00
end of document 00Document, toplam uzunluğunu veren 4 byte ile başlıyor (4b 00 00 00, little-endian 75). Ardından her element bir tip byte'ı, sonu 00 ile biten alan adı ve değerle geliyor. _id için tip 0x10 yani 32 bit integer ve değer 1a 00 00 00, yani 26. String önce kendi uzunluğunu (5, sondaki 00 dahil) sonra metnin byte'larını (UTF-8 kodlamasıyla) taşıyor. Fiyat 0x13 tipiyle 16 byte'lık bir Decimal128; ilk iki byte 8a 98 39050 sayısını, son byte'lardaki üs ise 10 üzeri eksi 2'yi kodluyor: 390.50. Tarih 0x09 tipiyle 8 byte: 1970'ten beri geçen milisaniye, yani 2024-06-01 için 1717200000000.
Buradan üç sonuç çıkıyor. BSON her zaman JSON'dan küçük değil; bu örnekte 75 ile 78 byte neredeyse aynı. Asıl kazanç boyut değil, tip ve gezinme: her değerin tipi byte'ın içinde yazılı ve uzunluk önekleri sayesinde sunucu ilgilenmediği bir alanı parse etmeden atlayabiliyor. Ayrıca alan adları her document'te tekrar ediyor; bir milyon kitapta listPrice adı bir milyon kez saklanıyor. Bu yüzden WiredTiger'ın varsayılan sıkıştırması önemli, ama alan adlarını okunmaz kısaltmalara çevirmek genelde değmez. Son olarak JSON'un tarih ve decimal tipi yok: JSON'da tarih bir string, fiyat bir double. "Önce Tahmin Et"teki sorunun kökü burası. MongoDB araçları bu tipleri JSON'da taşımak için Extended JSON kullanır: {"$date": "..."} ya da {"$numberDecimal": "390.50"} gibi. Bir sonraki yazıda Bookstore verisini mongoimport ile bu formatta yükleyeceğiz.
En sık karşılaşacağın BSON tipleri şunlar: double, string, object (alt document), array, binData (byte dizisi; UUID (128 bitlik evrensel benzersiz kimlik) değerleri de alt tip 4 ile burada durur), objectId, bool, date, null, int (32 bit), long (64 bit) ve decimal (Decimal128). timestamp adında bir tip de var ama o replication'ın kendi iç kullanımı için; uygulama verisinde tarih için her zaman date kullanılır. undefined, symbol gibi birkaç tip ise deprecated. Hangi değerin hangi tipte saklandığını $type ile görebilirsin; yorumun alanlarına bakalım:
// Alanların BSON tipleri ($type aggregation operator'ü ile)
printjson(db.reviews.aggregate([
    { $match: { _id: result.insertedId } },
    { $project: {
        _id: { $type: "$_id" },
        bookId: { $type: "$bookId" },
        rating: { $type: "$rating" },
        customer: { $type: "$customer" },
        reviewedAt: { $type: "$reviewedAt" }
    } }
]).toArray());
[
{
_id: 'objectId',
bookId: 'int',
rating: 'int',
customer: 'object',
reviewedAt: 'date'
}
]mongosh'ta yazdığın 26 gibi bir tam sayı int olarak saklandı; 0.1 gibi ondalıklı bir sayı ise double olurdu. Uygulamada hangi tipin yazılacağına senin kodun ve driver'ın serialization ayarları karar verir. .NET tarafında decimal, Guid ve DateTime eşlemelerinin ayrıntısı 9. yazıda.
Para, Tarih ve Kimlik: Decimal128, Date ve ObjectId
Fiyatı double olarak saklamanın sonucu bir aggregation'da hemen görünüyor:
// 01 - double ile Decimal128 farkı
db = db.getSiblingDB("bookstore_try");
db.prices.drop();
db.prices.insertMany([
    { book: "Dune", asDouble: 0.1, asDecimal: Decimal128("0.1") },
    { book: "Emma", asDouble: 0.2, asDecimal: Decimal128("0.2") }
]);
printjson(db.prices.aggregate([
    { $group: { _id: null, doubleSum: { $sum: "$asDouble" }, decimalSum: { $sum: "$asDecimal" } } }
]).toArray());
[
{
_id: null,
doubleSum: 0.30000000000000004,
decimalSum: Decimal128('0.3')
}
]Double, ikilik tabanda kayan noktalı bir sayı olduğu için 0.1'i tam olarak temsil edemez. Decimal128 ise 128 bitlik ondalık bir format (IEEE 754-2008; kayan noktalı sayı formatlarını tanımlayan standart); 34 anlamlı basamak taşır ve 0.1 + 0.2'yi 0.3 olarak toplar. Para, oran ve miktar için Decimal128 kullan. C#'taki decimal ile aynı şey değil ama ikisi arasında kayıpsız dönüşüm, Bookstore'un fiyat aralığında sorun değil; ayrıntı 9. yazıda.
BSON date, 1970'ten bu yana geçen milisaniyeyi tutan imzalı 64 bit bir sayı. Saat dilimi saklanmaz; değer her zaman UTC (koordineli evrensel zaman) olarak yorumlanır. Bookstore'da bütün zamanları UTC yazıyoruz ve kullanıcıya gösterirken yerel saate çeviriyoruz. Yalnız gün bilgisi gereken alanlar, örneğin kitabın listeye girdiği gün, için de date kullanılır ve saat 00:00 UTC olarak tutulur.
ObjectId 12 byte: 4 byte saniye cinsinden oluşturulma zamanı, 5 byte process başına bir kez üretilen rastgele değer ve 3 byte artan bir sayaç. Bu yapı sayesinde ObjectId'yi sunucuya sormadan istemci üretebiliyor. İki ObjectId'yi art arda üretip parçalarına ayıralım:
dotnet run --project src/Bookstore.MongoLab -- objectid6af858014801f064df566334 time=6af85801 random=4801f064df counter=566334
6af858014801f064df566335 time=6af85801 random=4801f064df counter=566335
CreationTime (UTC): 2026-11-14T12:45:53Z
first < second : TrueZaman ve rastgele kısım aynı, sayaç bir arttı. Zaman bilgisi en başta olduğu için ObjectId'ye göre sıralamak kabaca oluşturulma sırasına göre sıralamak demek; getTimestamp() ile ayrı bir alan tutmadan oluşturulma zamanını okuyabilirsin. Kabaca, çünkü doküman açıkça monotonluk garantisi vermiyor: çözünürlük bir saniye, aynı saniyede farklı process'lerin ürettiği değerlerin sırası belli değil ve her istemcinin saati farklı olabilir. Kesin sıra gerekiyorsa ayrı bir tarih alanına ve onun index'ine güven. Kimlik üretme stratejilerinin genel karşılaştırması (auto-increment, UUIDv7, Snowflake) System Design serisinin "Unique ID Üretimi: Auto-Increment, UUIDv4, UUIDv7 ve Snowflake" yazısında.
Tablo ile Collection Aynı Şey Değil: Kavram Eşlemesi ve Sınırı
İlişkisel veritabanından gelen biri için ilk akla gelen eşleme şu tablo. Kavramları yerleştirmek için faydalı, ama son sütunu okumadan kullanma:
| İlişkisel | MongoDB | Fark |
|---|---|---|
| database | database | Aynı kavram; ilk yazmada kendiliğinden oluşur. |
| table | collection | Collection şemayı zorunlu tutmaz; kurallar schema validation ile eklenir. |
| row | document | Document iç içe alt document ve array taşır. |
| column | field | Tipi değerle birlikte gelir; document'ten document'e değişebilir. |
| primary key | _id | Her collection'da zorunlu, değiştirilemez, varsayılan tipi ObjectId. |
| foreign key | id ile referans | Veritabanı ilişkiyi kontrol etmez; tutarlılık uygulamanın işi. |
| JOIN | embed ya da $lookup | Birlikte okunan veri genelde aynı document'e gömülür. |
| transaction | tek document yazma, gerekirse multi-document transaction | Tek document'e yazma her zaman atomik. |
Tablonun yanıltıcı yanı, ilişkisel şemayı satır satır document'lere çevirmenin yeterli olduğunu düşündürmesi. Aynı siparişi iki modelde yan yana koyalım:
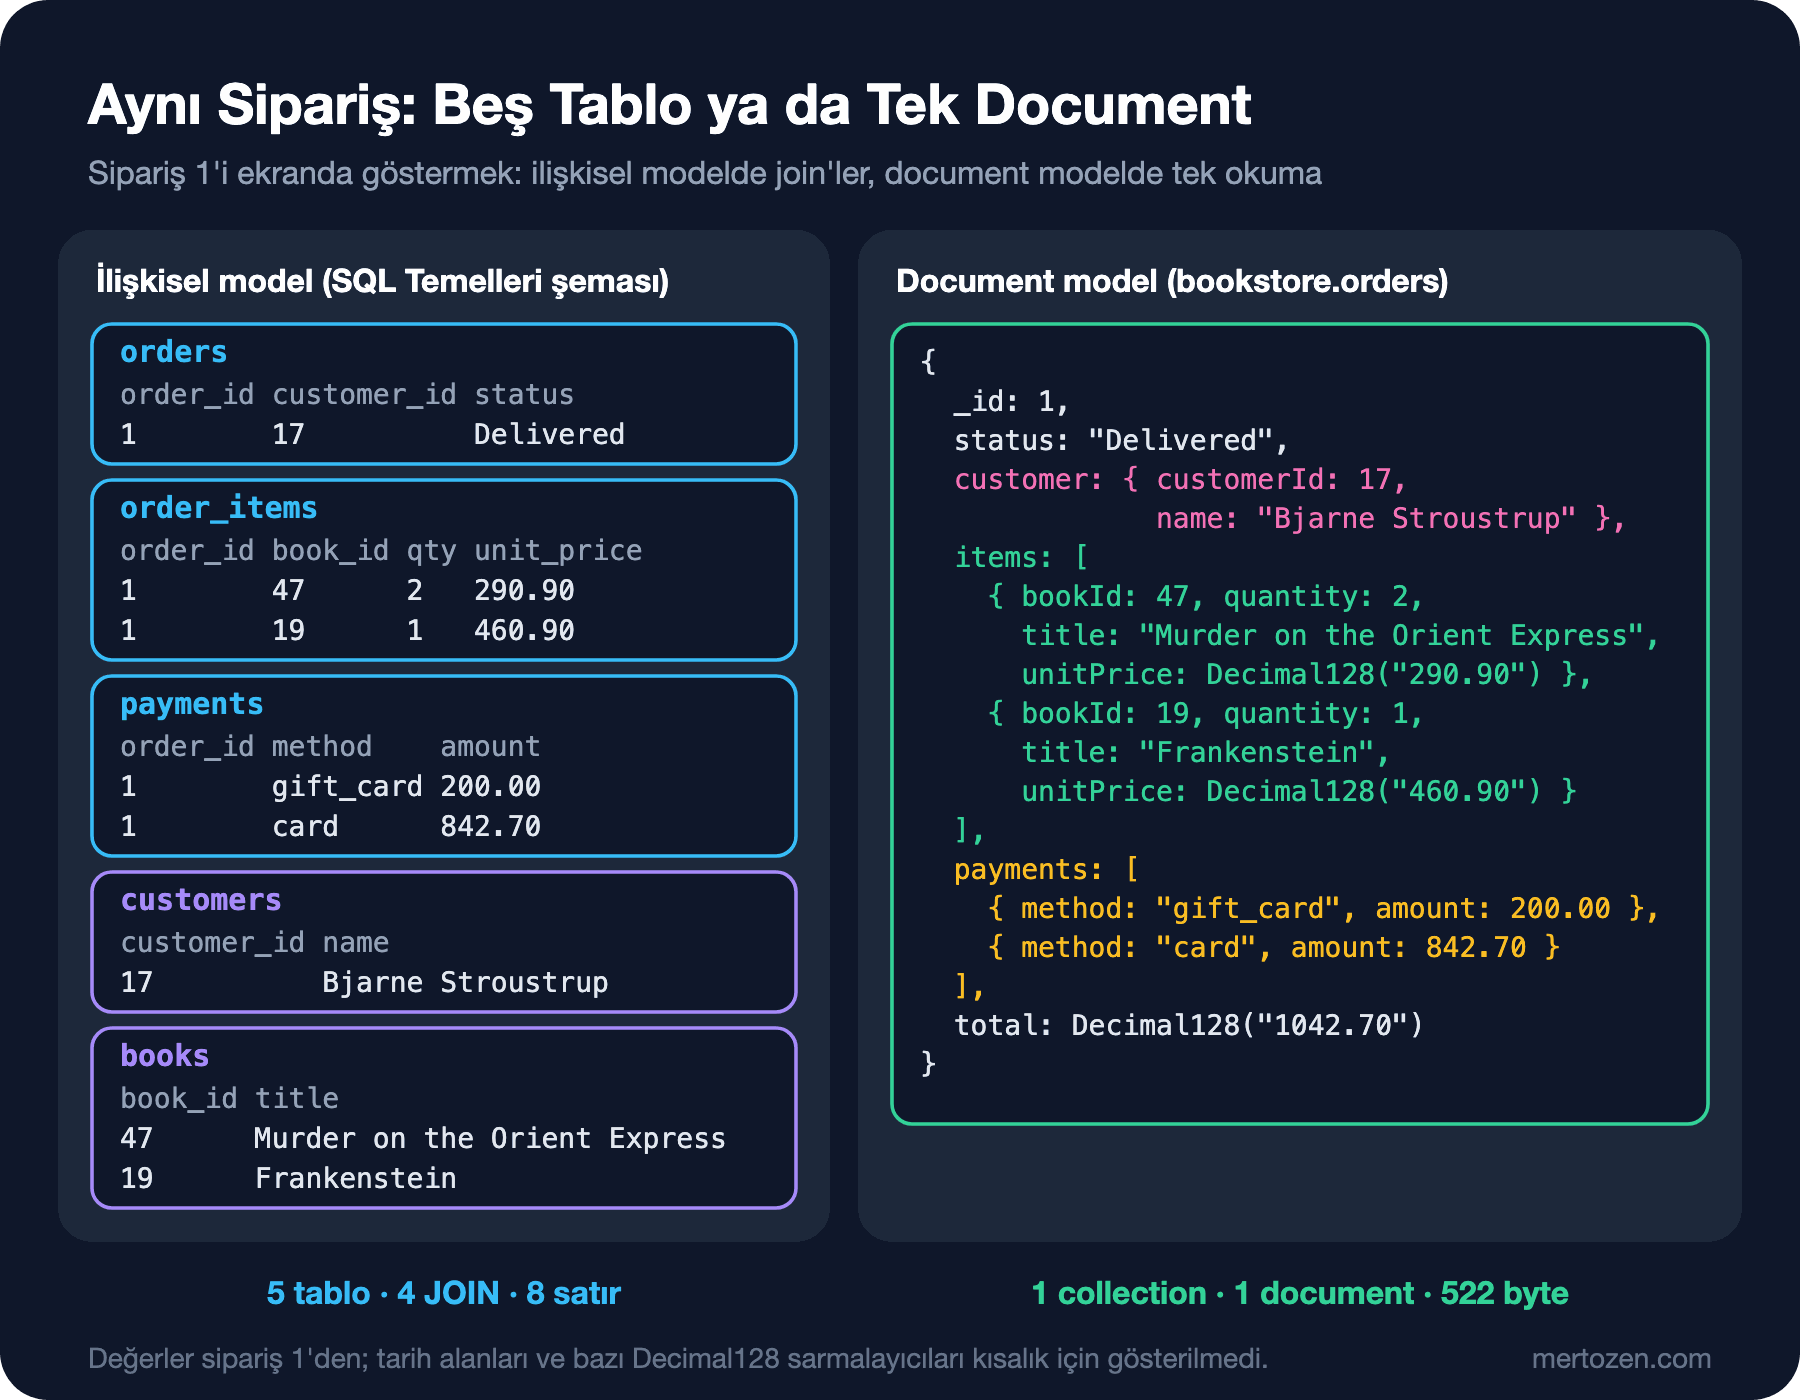
İlişkisel modelde sipariş 1'i ekranda göstermek için beş tablodan sekiz satır okunuyor ve dört join yapılıyor. Document modelde sipariş, kalemleri ve ödemeleriyle tek bir document. Ama bu document'in şekli tablolardan çıkmadı; sipariş ekranının ne okuduğundan çıktı. Kalemlerdeki kitap adı ve birim fiyat, kitabın o anki hâli değil, satış anının kopyası. Müşteri adı da bir kopya. Yorumlar ise siparişe değil kitaba ait ve sayıları sınırsız büyüyebileceği için ayrı bir collection'da. İlişkisel modeling'de soru "veri nedir?"; document modeling'de ise "veriye nasıl erişeceğim?". Aynı Bookstore'un iki modelle kurulup karşılaştırıldığı yazı Data Modeling ve Normalizasyon serisinin "İlişkisel mi Document mı? Aynı Bookstore'u İki Şekilde Modellemek" yazısı. Bu seride modelin MongoDB'ye özgü kurallarını 4. ve 5. yazılarda ayrıntılı göreceğiz.
mongod, WiredTiger ve Replica Set: Sunucunun İçinde Ne Var?
// 01 - sunucuya kısa bir bakış: sürüm, storage engine, cache, topoloji
const status = db.serverStatus();
print("version       :", db.version());
print("storageEngine :", status.storageEngine.name);
print("cache (bytes) :", status.wiredTiger.cache["maximum bytes configured"]);
print("replica set   :", db.hello().setName ?? "(none, standalone)");
version : 9.0.8
storageEngine : wiredTiger
cache (bytes) : Long('3571449856')
replica set : (none, standalone)Sunucu tarafındaki process mongod. Veriyi diske yazan ve okuyan katman storage engine; varsayılanı ve bugün pratikte tek seçenek WiredTiger. WiredTiger yazmalarda document seviyesinde concurrency control kullanır: iki istemci aynı collection'daki farklı document'leri aynı anda değiştirebilir, ikisi aynı document'e çarpışırsa biri write conflict alır ve MongoDB işlemi kendisi yeniden dener. Varsayılan olarak collection verisi snappy ile, index'ler prefix compression ile sıkıştırılır. Değişiklikler önce journal'a yazılır, 60 saniyede bir de checkpoint ile veri dosyalarına; beklenmedik bir kapanmada son checkpoint'ten sonrası journal'dan tekrar oynatılır. PostgreSQL serisinde WAL (write-ahead log; değişikliklerin veri dosyasından önce yazıldığı günlük) ve checkpoint için anlattıklarımızın burada da karşılığı var.
WiredTiger'ın kendi cache'i varsayılan olarak "RAM eksi 1 GB'ın yarısı ya da 256 MB, hangisi büyükse" kadar yer alır. Bu lab'daki Docker VM'i yaklaşık 7,6 GB bellek görüyor; (7,6 - 1) / 2 hesabı çıktıdaki 3,3 GB'ı veriyor. Container'a bellek limiti koyduğunda dokümanın uyarısı önemli: WiredTiger bazı durumlarda container limitini değil makinenin belleğini görebilir, bu durumda cache'i --wiredTigerCacheSizeGB ile kendin ayarlaman gerekir. Kalan bellek boşa gitmez; işletim sisteminin dosya cache'i ve bağlantılar onu kullanır.
Çıktının son satırı bu sunucunun standalone çalıştığını söylüyor. Production'da MongoDB'nin varsayılan topolojisi replica set: aynı veriyi taşıyan, biri primary diğerleri secondary olan bir grup mongod. Yazmalar primary'ye gider, secondary'ler oplog adı verilen değişiklik kaydını takip ederek kopyayı günceller, primary düşerse kalanlar yeni bir primary seçer. Replica set yalnız yüksek erişilebilirlik için değil: multi-document transaction ve change stream yalnız replica set'te (ve sharded cluster'da) çalışır, varsayılan write concern olan majority de replica set üyelerinin çoğunluğunu bekler. Bu yüzden 2. yazıda lab'ı tek node'lu bir replica set olarak kuracağız. Veri tek sunucuya sığmadığında devreye sharding girer: veri shard'lara bölünür, istemciler mongos router'ı üzerinden bağlanır, metadata config server'larda durur. Replication ve sharding'in MongoDB tarafı 13. yazıda; teorisi System Design ve Distributed Systems Temelleri serilerinde.
Lisans, Sürümler ve Atlas
MongoDB Community Server 16 Ekim 2018'den beri yayımlanan sürümlerde SSPL (Server Side Public License; MongoDB'nin yazdığı, servis olarak sunmaya koşul getiren lisans) ile dağıtılıyor; daha eskiler AGPL (ağ üzerinden sunulan yazılımda da kaynak kodunun paylaşılmasını şart koşan özgür yazılım lisansı) sürüm 3 altında kaldı. SSPL, OSI (açık kaynak lisanslarını onaylayan kuruluş) tarafından onaylanmış bir lisans değil. Pratik etkisi dar: MongoDB'yi kendi uygulamanın veritabanı olarak kullanmak, uygulama bir SaaS (internet üzerinden hizmet olarak sunulan yazılım) olsa bile, ek bir yükümlülük getirmiyor. Koşul, MongoDB'nin kendisini üçüncü taraflara servis olarak sunduğunda devreye giriyor; o durumda servisi çalıştıran yazılımın kaynak kodunu da açman gerekiyor. Driver'lar Apache 2.0 lisanslı. Ücretli seçenekler Enterprise Advanced (kendi sunucunda, ek güvenlik ve yönetim özellikleriyle) ve MongoDB'nin yönetilen bulut servisi Atlas. Bu seride Atlas hesabı kullanmıyoruz; Atlas'a özgü özellikleri resmî dokümandan anlatıp çalıştırmadığımızı belirteceğiz.
Sürüm tarafında MongoDB yılda bir major sürüm çıkarıyor ve her major beş yıl destekleniyor. 8.0 Ekim 2024'te çıktı ve 31 Ekim 2029'a kadar destekli; 9.0 28 Eylül 2026'da GA (genel kullanıma açık kararlı sürüm) oldu ve 31 Ekim 2031'e kadar destekli. Bu serinin lab'ı 9.0 üzerinde, ama yazılardaki her şey aksi belirtilmedikçe 8.0'da da aynı çalışıyor; fark olan yerleri not edeceğiz. 9.0 ile minor sürümler yalnız Atlas'a çıkıyor, kendi sunucunda çalıştıranlar ise yılda bir "Feature Update" (x.5) alacak. Sürüm modelinin ve 6.0'dan 9.0'a değişikliklerin ayrıntısı 15. yazıda.
Ne Zaman MongoDB, Ne Zaman Değil?
MongoDB'nin en iyi oturduğu yer, verinin doğal olarak bir kök etrafında okunduğu ve yapısının kayıttan kayda değiştiği durumlar. Bookstore'da katalog iyi bir örnek: basılı kitabın sayfa sayısı ve ağırlığı, e-kitabın dosya formatları, sesli kitabın seslendireni ve süresi var. İlişkisel modelde bunlar ya çok sayıda boş kolon ya da ayrı tablolar demek; document modelde her kitap kendi alanlarını taşır. Sipariş geçmişi gibi okuma ağırlıklı ve tek bir aggregate (birlikte değişen ve tutarlılığı birlikte korunan veri grubu) etrafında dönen ekranlar da iyi aday: sipariş, kalemleri ve ödemeleriyle tek okuma ve tek atomik yazma. Event, log ve ölçüm gibi zamanla biriken veriler de rahat oturur.
Zorlandığı yerler de belli. Çok sayıda tabloya yayılan, önceden bilinmeyen sorularla yapılan raporlama ilişkisel veritabanında daha kolay; JOIN optimizer'ı ve SQL'in ifade gücü orada. Varlıkların birbirine çok yönlü bağlı olduğu ve foreign key, unique, check gibi kuralların veritabanında zorunlu tutulması gereken domain'lerde ilişkisel model daha güvenli. Neredeyse her işlem birden çok bağımsız kaydı birlikte değiştiriyorsa, MongoDB'de sürekli multi-document transaction'a yaslanırsın; bu çalışır ama hem pahalıdır hem de modelin yanlış olduğunun işaretidir. Arada bir seçenek de var: ilişkisel bir veritabanında yalnız değişken kısmı JSON kolonunda tutmak. PostgreSQL'de bunun aracı JSONB (PostgreSQL'in ikili JSON kolon tipi) ve GIN (array ve JSON içinde arama için kullanılan index tipi) index; ayrıntısı PostgreSQL serisinin "PostgreSQL'de JSONB: Operator'ler, SQL/JSON Function'ları, GIN Index ve Ne Zaman Kullanmamalı?" yazısında. Genel "SQL mi NoSQL mi" kararı ise System Design serisinin "Veri Katmanını Ölçeklemek: Replication, Sharding ve SQL mi NoSQL mi?" yazısında.
Üretimde Dikkat
Tipleri baştan sabitle. Tarih her zaman date, para her zaman Decimal128, kimlikler bir collection içinde tek tip olsun. MongoDB yanlış tipi reddetmez; bir yıl sonra raporda eksik çıkan siparişleri ararken bulursun. Uygulama tarafında tek bir mapping katmanı, veritabanı tarafında schema validation bunun iki güvencesi.
Image etiketini bilinçli seç. latest bir gün yeni bir major'a geçer; 9.0-ubuntu2204 9.0'ın son patch'ini takip eder, 9.0.8-ubuntu2204 ise sürümü sabitler. Major yükseltme, veri dosyalarının ve feature compatibility version'ın da yükseltilmesi demek; bunu image güncellemesine bırakma.
Belleği ölç. WiredTiger cache'i ve working set (sık kullanılan document'ler ve index'ler) belleğe sığdığı sürece okumalar diske gitmez. Container'da çalışıyorsan cache boyutunu açıkça ver ve serverStatus() içindeki cache istatistiklerini izle; izleme ayrıntıları 14. yazıda.
Sık Düşülen Tuzaklar
Tarihi string olarak saklamak. "Önce Tahmin Et"teki durum gerçek projelerde genelde JSON'u olduğu gibi kaydeden bir servisten çıkar. 2026-06-29T10:15:00Z biçimindeki string'ler metin olarak sıralanabilse de tarih aritmetiği, saat dilimi dönüşümü ve date tipindeki diğer kayıtlarla karşılaştırma bozulur.
Kavram eşlemesini birebir uygulamak. Her tabloyu bir collection'a, her foreign key'i bir referansa çevirirsen ilişkisel modelin bütün join ihtiyacını, ilişkisel veritabanının foreign key ve JOIN optimizer'ı olmadan taşırsın. Model ekranlardan ve sorgulardan türetilmeli.
Alan adındaki yazım hatasını fark etmemek. listprice ile listPrice MongoDB için iki ayrı alan. Yanlış adla yapılan bir sorgu hata vermez, boş sonuç döner; yanlış adla yapılan bir update ise document'e yeni bir alan ekler. Uygulamada alan adlarını tek yerde tanımlamak ve validation kullanmak bu yüzden önemli.
ObjectId'yi kesin sıra ya da gizli kimlik sanmak. ObjectId kabaca zamana göre sıralanır ama garanti vermez ve içindeki zaman damgası herkes tarafından okunabilir. Dışarıya açılan bir kimlikte oluşturulma zamanının görünmesi sorun olabilir.
Küçük Bir Deneme
★☆☆ 01-money.js içindeki iki fiyata { book: "Middlemarch", asDouble: 0.7, asDecimal: Decimal128("0.7") } ekle ve toplamları yeniden hesapla. Double toplamın tam 1 çıkıp çıkmadığına bak; sonucu 1 ile $eq karşılaştırmasında kullan.
★★☆ 01-guess.js'teki string tarihi düzeltmeye çalış: $dateFromString ile string değerleri date'e çeviren bir pipeline update yaz ve sorgunun artık iki sipariş döndürdüğünü göster. Pipeline update'leri 3. ve 5. yazılarda tekrar göreceğiz.
★★★ BsonLab içindeki kitaba bir bool (isActive) ve bir array (tags) alanı ekle, Dump metodunu bu iki tipi çözecek şekilde genişlet. Array'in BSON'da anahtarları "0", "1" olan bir document olarak saklandığını byte'larda göster.
Bir sonraki yazıda deneme container'ını bırakıp kalıcı lab'ı kuruyoruz: Docker'da parola korumalı, tek node'lu bir replica set, mongosh ve Compass ile bağlantı ve SQL Temelleri serisindeki Bookstore verisinin mongoimport ile MongoDB'ye taşınması.