

MongoDB Index'leri: Compound Index ve ESR Kuralı, Multikey, Partial, TTL, Collation ve explain

MongoDB'de compound index'in alan sırası sorgudan türetilir: önce eşitlik, sonra sıralama, en son aralık (ESR); range çok seçiciyse aralığı sıralamadan önce koymak (ERS) daha az key okur. Gerçek explain çıktılarıyla COLLSCAN ve IXSCAN, covered query, $in ve SORT_MERGE, multikey, unique, partial, sparse ve TTL index'ler, Türkçe collation tuzağı, $indexStats ile kullanılmayan index'i bulmak ve hidden index.
Sürüm notu: Bu yazıdaki örnekler MongoDB 9.0.8 Community Server ve mongosh 2.6 ile çalıştırılmıştır. Script'lerin tamamı MongoDB 8.0.38'de de aynı çıktıyı verdi.
Önce Tahmin Et
Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) "siparişlerim" ekranında bir filtre var: müşterinin en az 1000 TL'lik son üç siparişi. Sorgu üç parçadan oluşuyor: müşteri numarasında eşitlik, orderedAt'e göre sıralama ve total üzerinde bir aralık. Aynı üç alanla iki compound index kuralım, aralarındaki tek fark alan sırası olsun:
db.orders.createIndex({ "customer.customerId": 1, orderedAt: -1, total: 1 }, { name: "esr" });
db.orders.createIndex({ "customer.customerId": 1, total: 1, orderedAt: -1 }, { name: "ers" });
db.orders.createIndex({ total: 1, "customer.customerId": 1, orderedAt: -1 }, { name: "range_first" });

// Ada'nın (müşteri 1) en az 1000 TL'lik son 3 siparişi
for (const min of ["1000", "3000"]) {
    print(`total >= ${min}`);
    for (const name of ["esr", "ers", "range_first"]) {
        summary(name, db.orders.find({ "customer.customerId": 1, total: { $gte: Decimal128(min) } })
            .sort({ orderedAt: -1 }).limit(3).hint(name).explain("executionStats"));
    }
}
Üçüncü index'i de karşılaştırma için ekledik: aralık alanı en başta. hint sorguyu belirtilen index'i kullanmaya zorluyor. Ada'nın 39 siparişi var. Hangi index daha az index key'i okur, hangisi sonucu bellekte sıralamak zorunda kalır?
total >= 1000
esr          LIMIT <- FETCH <- IXSCAN       keys  11  docs   3  returned 3
ers          FETCH <- SORT <- IXSCAN        keys  11  docs   3  returned 3
range_first  FETCH <- SORT <- IXSCAN        keys 148  docs   3  returned 3
esr ve ers aynı sayıda key okudu ama yalnız ers'in planında SORT var: sonuç bellekte sıralandı. Aralık alanını başa koyan index 148 key okudu, çünkü total >= 1000 koşulu bütün müşterilerin 158 siparişini kapsıyor ve müşteri filtresi o aralığın içinde uygulanıyor. Hikâyenin ikinci yarısı total >= 3000 satırlarında. Bu yazı index'leri explain çıktısının sayılarıyla ele alıyor: compound index ve ESR (Equality, Sort, Range; alanların eşitlik, sıralama ve aralık sırasıyla dizilmesi) kuralı, multikey, unique, partial, sparse ve TTL (süresi dolan document'leri silen) index'ler, Türkçe için collation ve gereksiz index'leri bulmak.
Script'ler uygulama kullanıcısıyla çalışıyor, örneğin docker compose exec mongo mongosh "mongodb://bookstore_app@localhost:27017/bookstore?authSource=bookstore" --quiet /lab/scripts/06-esr.js -p. Her script çalıştığı collection'ın index'lerini silip kendi index'lerini kuruyor. Bookstore'un kalıcı index setini 06-bookstore-indexes.js kuruyor; sonraki yazılar 02-load.sh'den sonra bu script'le başlıyor.
explain("executionStats") Okumak
Index'i değerlendirmenin tek güvenilir yolu explain çıktısı. explain("executionStats") sorguyu gerçekten çalıştırır ve seçilen planı istatistikleriyle döndürür. Bu yazının bütün script'leri aynı küçük yardımcıyı kullanıyor: planın stage zincirini ve üç sayıyı yazdırıyor.
// 06 - explain("executionStats"): COLLSCAN, IXSCAN ve covered query
function summary(label, explain) {
    const s = explain.executionStats;
    const stages = [];
    for (let st = s.executionStages; st; st = st.inputStage) stages.push(st.stage);
    print(`${label.padEnd(10)} ${stages.join(" <- ").padEnd(36)} keys ${String(s.totalKeysExamined).padStart(3)}  docs ${String(s.totalDocsExamined).padStart(3)}  returned ${s.nReturned}`);
}

const filter = { "customer.customerId": 17 };
summary("no index", db.orders.find(filter).explain("executionStats"));

db.orders.createIndex({ "customer.customerId": 1, orderedAt: -1 });
summary("index", db.orders.find(filter).explain("executionStats"));

// Filtrede ve projection'da yalnız index'teki alanlar, _id hariç: document'ler okunmaz
summary("covered", db.orders.find(filter, { _id: 0, orderedAt: 1 }).explain("executionStats"));

// Prefix kuralı: index customer.customerId ile başlıyor; yalnız orderedAt sorgusu onu kullanamaz
summary("no prefix", db.orders.find({ orderedAt: { $gte: ISODate("2026-06-01") } }).explain("executionStats"));
no index COLLSCAN keys 0 docs 379 returned 5
index FETCH <- IXSCAN keys 5 docs 5 returned 5
covered PROJECTION_COVERED <- IXSCAN keys 5 docs 0 returned 5
no prefix COLLSCAN keys 0 docs 379 returned 15Okuma sırası sağdan sola: IXSCAN index'ten key okur, FETCH o key'lerin gösterdiği document'leri getirir, COLLSCAN bütün collection'ı tarar. Asıl bakılacak şey üç sayının oranı: totalKeysExamined, totalDocsExamined ve nReturned. İdeal durumda üçü birbirine yakın; 5 sonuç için 379 document okumak index eksikliğinin ya da yanlış index'in işareti. Projection'da yalnız index'teki alanlar olduğunda ve _id dışarıda bırakıldığında MongoDB document'e hiç gitmiyor (PROJECTION_COVERED, docs 0): buna covered query deniyor. Son satır prefix kuralı: compound index yalnız soldan başlayan alanlarıyla (prefix'leriyle) kullanılabilir. { customerId, orderedAt } index'i customerId sorgusuna yarar, yalnız orderedAt sorgusuna yaramaz.
Plan nasıl seçiliyor? Birden çok uygun index varsa query planner aday planları kısa bir deneme süresi boyunca çalıştırır; en az işle en çok sonuç üreten plan kazanır ve karar sorgunun şekli için plan cache'e yazılır. 8.3'ten beri, dolayısıyla 9.0'da, deneme sonuç vermezse bazı sorgularda maliyet tahminine dayanan bir yedek mekanizma (cost-based ranker) devreye giriyor; 8.0'da yalnız klasik yöntem var. "Önce Tahmin Et"teki sorguda planner esr'yi seçti ve iki planı reddetti (rejectedPlans).
Compound Index ve ESR Kuralı
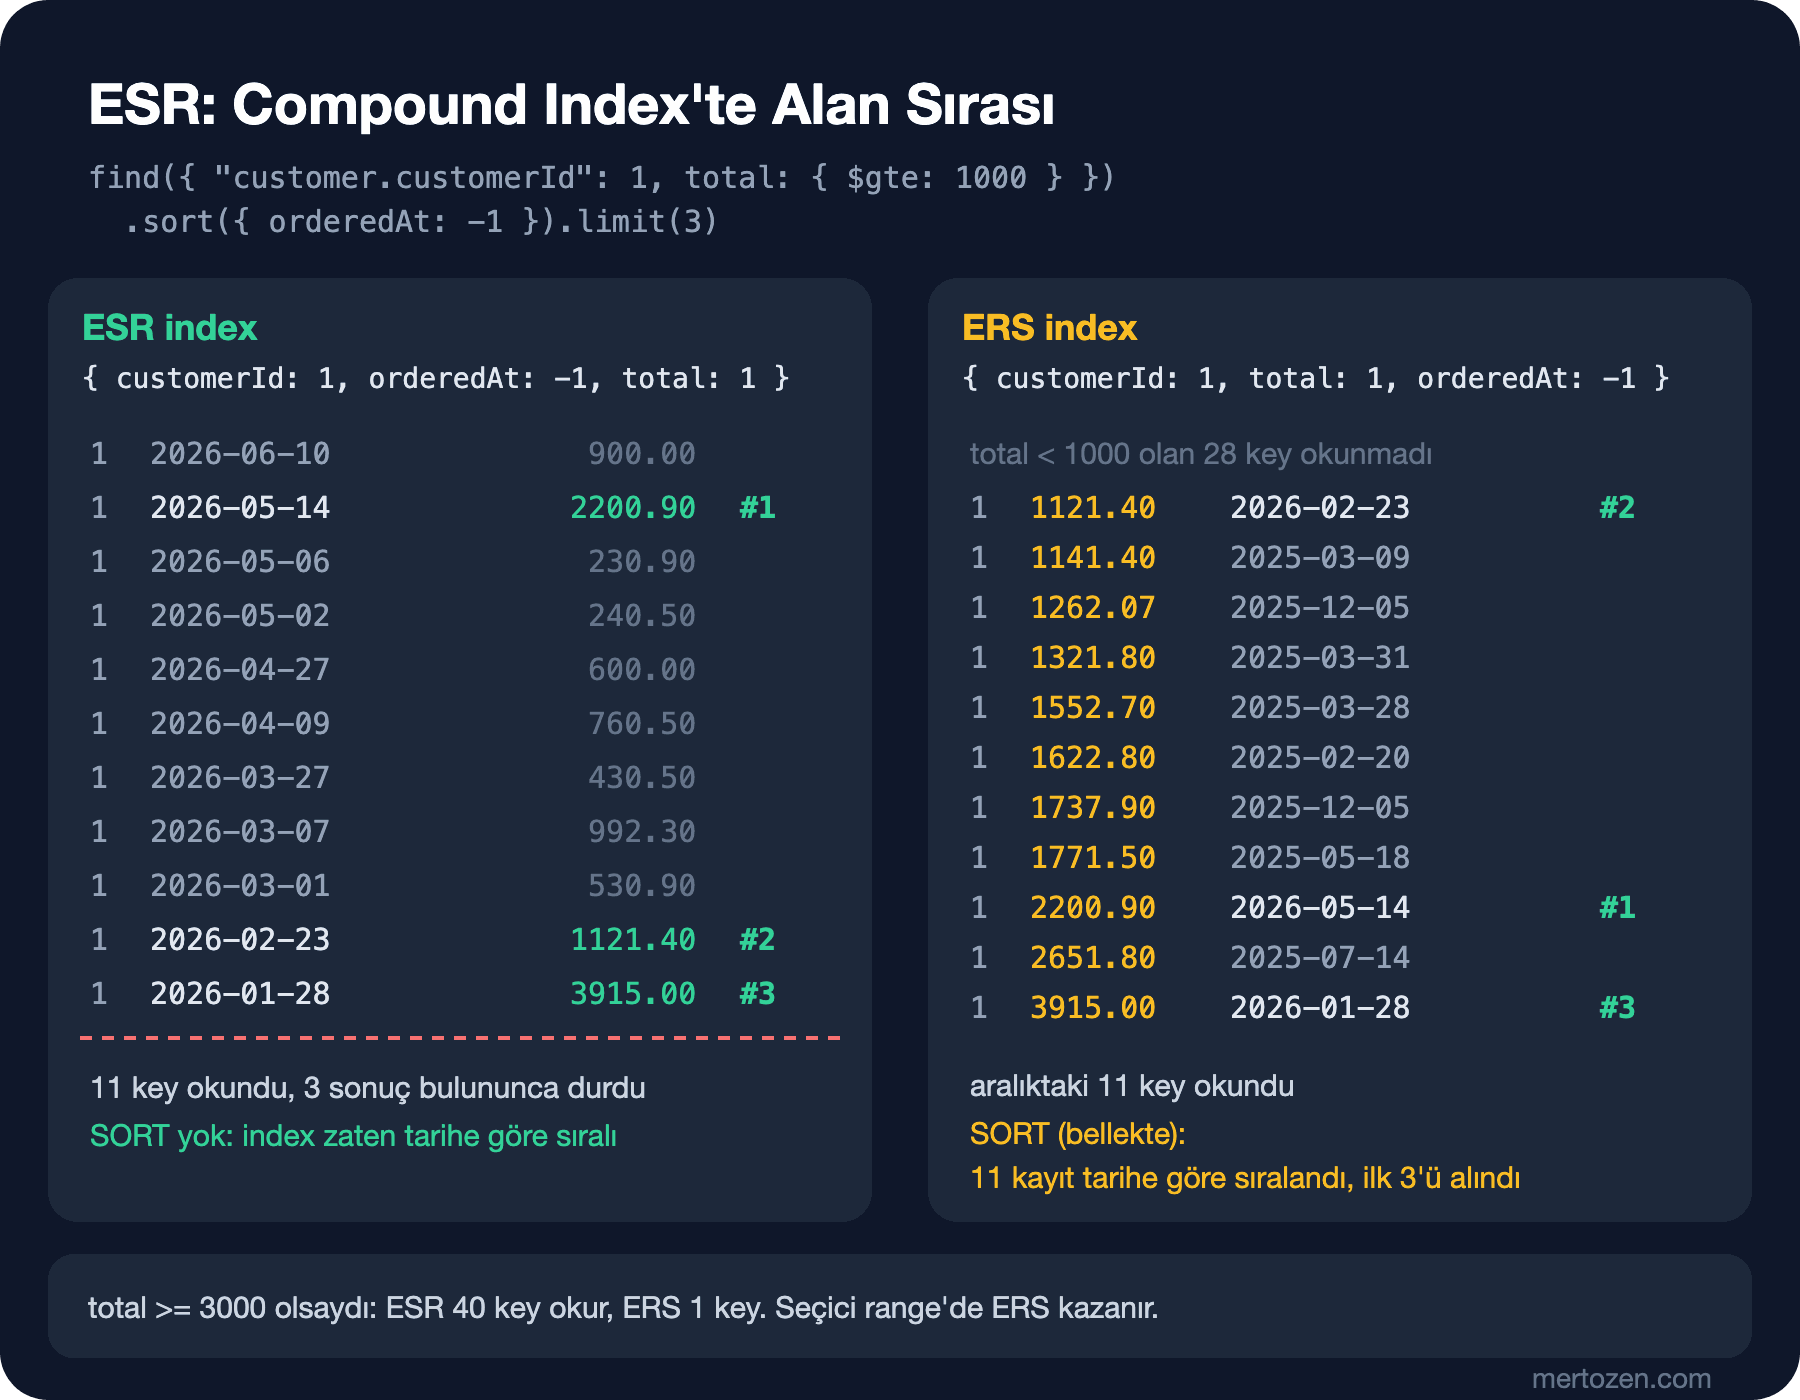
MongoDB'nin ESR kılavuzunun özü şu: eşitlik alanları her zaman önce gelir, çünkü index'i tek bir bloğa daraltırlar ve geri kalan alanları o blok içinde sıralı tutarlar. Sonra sıralama alanı gelir; index zaten o sırada olduğu için SORT stage'i gerekmez ve limit(3) üç sonuç bulununca okumayı durdurur. Aralık en sona kalır. Şekilde görüldüğü gibi esr Ada'nın siparişlerini tarih sırasıyla okuyor ve 11. key'de üçüncü sonucu bulup duruyor. ers ise aralıktaki 11 key'in hepsini okumak, sonra bellekte tarihe göre sıralamak zorunda.
total >= 3000
esr          LIMIT <- FETCH <- IXSCAN       keys  40  docs   1  returned 1
ers          FETCH <- SORT <- IXSCAN        keys   1  docs   1  returned 1
range_first  FETCH <- SORT <- IXSCAN        keys  11  docs   1  returned 1
chosen: esr  rejected plans: 2
Eşik 3000 TL olunca tablo dönüyor. Ada'nın bu tutarı geçen tek siparişi var; esr üç sonuç arayıp bulamadığı için müşterinin bütün key'lerini okudu (40 key), ers ise aralığın başına atlayıp tek key okudu. Kılavuzun istisnası bu: range koşulu çok seçiciyse aralığı sıralamadan önce koymak (ERS) daha az key okur, bedeli küçük bir bellek içi sıralama. Hangisinin doğru olduğu verinin dağılımına bağlı, bu yüzden karar gerçek verideki explain sayılarıyla verilir. Sıralama yönü için de bir kural var: { customerId: 1, orderedAt: -1 } index'i sort({ orderedAt: -1 })'i ve tersini karşılar, ama iki alanlı sıralamalarda index'teki yönlerin ya aynısı ya da tamamen tersi gerekir.
$in için kılavuz ilginç bir ayrıntı veriyor: sıralamalı bir sorguda $in listesi 201 elemandan kısaysa MongoDB her değer için ayrı bir index taraması yapıp sonuçları SORT_MERGE ile birleştiriyor, yani $in eşitlik gibi davranıyor. Liste uzunsa aralık gibi davranıyor ve bellek içi sıralama geri geliyor:
// Sıralamalı $in: kısa liste eşitlik gibi (SORT_MERGE), uzun liste aralık gibi (SORT) davranır
db.orders.createIndex({ status: 1, orderedAt: -1 });
const open = ["Pending", "Paid", "Shipped"];
const padded = open.concat(Array.from({ length: 198 }, (_, i) => `Unused${i}`));
for (const list of [open, padded]) {
    summary(`$in ${list.length}`, db.orders.find({ status: { $in: list } }).sort({ orderedAt: -1 }).limit(5).explain("executionStats"));
}
$in 3 LIMIT <- FETCH <- SORT_MERGE keys 5 docs 5 returned 5
$in 201 FETCH <- SORT <- IXSCAN keys 10 docs 5 returned 5Doküman bu 201 sınırını garanti etmiyor. Pratik sonuç: kısa $in listeleriyle sorgulanan alan eşitlik alanlarının yanına, uzun listelerle sorgulanan alan aralık yerine. $ne, $nin ve $regex her zaman aralık sayılır.
Multikey Index: Array Alanlarında
Array içeren bir alana index koyduğunda MongoDB array'in her element'i için ayrı bir key üretir ve index'i kendiliğinden multikey olarak işaretler; ayrı bir index türü seçmen gerekmez. "Dune'u içeren siparişler" sorgusu için items.bookId:
// 06 - multikey index: her array element'i için bir index key'i
db.orders.createIndex({ "items.bookId": 1 });

const e = db.orders.find({ "items.bookId": 26 }).explain("executionStats");
const ix = e.queryPlanner.winningPlan.inputStage;
print("stage", ix.stage, " isMultiKey", ix.isMultiKey, " multiKeyPaths", JSON.stringify(ix.multiKeyPaths),
      " keys", e.executionStats.totalKeysExamined, " returned", e.executionStats.nReturned);

// Index'in tam taraması her key'i bir kez okur: document'ten fazla key var
const full = db.orders.find().hint({ "items.bookId": 1 }).explain("executionStats").executionStats;
print("orders", full.nReturned, " index keys", full.totalKeysExamined);

// $elemMatch aynı index'i kullanır; iki koşul aynı element'te kontrol edilir
const em = db.orders.find({ items: { $elemMatch: { bookId: 26, quantity: { $gte: 2 } } } }).explain("executionStats");
print("$elemMatch keys", em.executionStats.totalKeysExamined, " docs", em.executionStats.totalDocsExamined, " returned", em.executionStats.nReturned);

// Bir compound index'te iki array alanına izin yok ("parallel arrays")
try {
    db.orders.createIndex({ "items.bookId": 1, "payments.method": 1 });
} catch (err) {
    print(err.codeName + ":", err.message.split(" :: caused by :: ").pop());
}
stage IXSCAN isMultiKey true multiKeyPaths {"items.bookId":["items"]} keys 27 returned 27
orders 379 index keys 680
$elemMatch keys 27 docs 27 returned 5
CannotIndexParallelArrays: cannot index parallel arrays [payments] [items]379 sipariş, 680 index key'i üretti: sipariş başına ortalama 1,8 kalem. Index'in boyutu document sayısıyla değil array element'lerinin sayısıyla büyüyor; sınırsız büyüyen bir array'e index koymak, 4. yazıdaki 16 MB sorununun index tarafı. 3. yazıdaki $elemMatch sorgusu da aynı index'i kullandı: index 27 siparişi buldu, "en az 2 adet" koşulu document'ler okunurken aynı element üzerinde kontrol edildi ve 5 sonuç kaldı.
Son satır multikey'in en önemli kısıtı: bir compound index'te en fazla bir alan array olabilir. İki array'in her element çifti için key üretmek kartezyen çarpım demek ve MongoDB buna izin vermiyor. Index önceden kurulmuşsa bu kuralı bozacak document'in insert'i reddedilir. Diğer kısıtlar dokümanda: multikey index shard key olamaz, hashed index multikey olamaz ve multikey index ancak array alanı projection'da yoksa ve sorguda $elemMatch yoksa covered query sağlayabilir.
Unique, Partial, Sparse ve TTL
3. yazıda sepet için upsert kullanmış ve aynı müşteri için iki eşzamanlı upsert'in iki sepet oluşturabileceğini, bunu unique index'in önlediğini söylemiştik. İşte o index ve yanında iki seçici index türü:
// 06 - unique, partial ve sparse index'ler
db.carts.createIndex({ customerId: 1 }, { unique: true });
db.carts.insertOne({ customerId: 3, items: [{ bookId: 26, quantity: 1 }] });
try {
    db.carts.insertOne({ customerId: 3, items: [{ bookId: 42, quantity: 1 }] });
} catch (err) {
    print(err.message);
}
// Unique index varken customerId üzerindeki upsert ikinci bir sepet oluşturamaz
const r = db.carts.updateOne({ customerId: 3 }, { $push: { items: { bookId: 42, quantity: 1 } } }, { upsert: true });

// Partial index: yalnız açık siparişler index'lenir (depo ekranı)
db.orders.createIndex({ status: 1, orderedAt: 1 },
    { partialFilterExpression: { status: { $in: ["Pending", "Paid", "Shipped"] } } });

// Sparse index: alanı olmayan document'ler index'te yer almaz
db.books.createIndex({ subtitle: 1 }, { sparse: true });
E11000 duplicate key error collection: bookstore.carts index: customerId_1 dup key: { customerId: 3 }
upsert: matched 1, upserted 0, carts 1
index size FETCH <- IXSCAN keys 10 docs 10 returned 10
status Shipped FETCH <- IXSCAN keys 8 docs 8 returned 8
status Delivered SORT <- COLLSCAN keys 0 docs 379 returned 345
subtitle exists FETCH <- IXSCAN keys 6 docs 6 returned 6
subtitle null COLLSCAN keys 0 docs 77 returned 71İkinci sepet E11000 (duplicate key) hatasıyla reddedildi ve upsert mevcut sepeti güncelledi. Unique index'in bilinmesi gereken bir davranışı var: alanı olmayan document'ler index'e null olarak girer ve unique bir index'te yalnız bir tane null olabilir. Alanı olmayan document'lere izin vermek istiyorsan unique'i partial index'le birleştir; o zaman kural yalnız filtreye uyan document'lere uygulanır.
Partial index yalnız partialFilterExpression'a uyan document'leri index'ler. Depo ekranı yalnız açık siparişlerle ilgileniyor ve 379 siparişin yalnız 10'u açık; index de 10 key'den ibaret. Bedeli şu: sorgu index'in filtresinin kapsadığı bir koşul içermiyorsa planner index'i kullanamaz, çünkü sonuç eksik çıkar. Shipped sorgusu index'i kullandı, Delivered sorgusu bütün collection'ı taradı. Sparse index aynı fikrin eski ve kaba hâli: yalnız alanı olan document'leri tutar. 77 kitabın 6'sının alt başlığı var; subtitle: null sorgusu alanı olmayanları da istediği için sparse index'i kullanamadı. Doküman yeni tasarımlarda sparse yerine partial index'i öneriyor.
TTL Index: Süresi Dolan Document'ler
TTL index, tarih alanı üzerinde tek alanlı bir index ve arka plandaki bir thread süresi dolan document'leri siler. İki kullanım şekli var: son değişiklikten itibaren sayılan süre ve her document'in kendi bitiş zamanı.
// Kayan süre: sepet son değişiklikten 30 gün sonra silinir
db.carts.createIndex({ updatedAt: 1 }, { expireAfterSeconds: 30 * 24 * 3600 });

// Sabit bitiş: her rezervasyon kendi bitiş zamanını taşır (expireAfterSeconds: 0)
db.stock_reservations.createIndex({ expiresAt: 1 }, { expireAfterSeconds: 0 });
db.stock_reservations.insertMany([
    { bookId: 26, orderId: 380, quantity: 1, expiresAt: new Date(Date.now() - 60 * 1000) },
    { bookId: 26, orderId: 381, quantity: 2, expiresAt: new Date(Date.now() + 15 * 60 * 1000) },
    { bookId: 26, orderId: 382, quantity: 1, expiresAt: "2026-06-30T10:00:00Z" }     // date değil, string
]);
before: carts 2 reservations 3
after the TTL pass: carts 1 reservations 2
[
{
orderId: 381,
expiresAtType: 'date'
},
{
orderId: 382,
expiresAtType: 'string'
}
]45 gün önce güncellenmiş sepet ve bir dakika önce süresi dolan stok rezervasyonu silindi. Süresi geçmiş ama expiresAt'i string olan rezervasyon duruyor: TTL yalnız date tipindeki değerlere bakar, 1. yazıdaki string ile tarih karışıklığı burada sessizce sonsuza kadar yaşayan document'ler üretir. Silme anlık değil; doküman TTL thread'inin 60 saniyede bir çalıştığını söylüyor ve script bu yüzden silme gerçekleşene kadar, en fazla 150 saniye bekliyor. Replica set'te silmeyi yalnız primary yapar, secondary'ler silmeyi replication ile alır. TTL compound index'te çalışmaz ve tam saatinde silme garantisi vermez; "15 dakikadan eski rezervasyon geçersizdir" kuralını uygulama sorgularken de kontrol etmeli.
Collation ile Türkçe Arama ve Sıralama
3. yazıda $regex ile i seçeneğinin bütün kitapları taradığını görmüştük. Büyük/küçük harf duyarsız arama ve dile göre sıralamanın doğru yolu collation: karşılaştırma kurallarını dil (locale) ve hassasiyet (strength) ile tanımlayan ayar. strength: 2 büyük/küçük harf farkını yok sayar, aksanları ayırt eder.
// 06 - collation: index'le büyük/küçük harf duyarsız Türkçe arama ve sıralama
const tr = { locale: "tr", strength: 2 };
db.books.createIndex({ title: 1 }, { collation: tr });

// Sorgu index'le aynı collation'ı kullanmalı
summary("with collation", db.books.find({ title: "ince memed" }).collation(tr).explain("executionStats"));
summary("without collation", db.books.find({ title: "ince memed" }).explain("executionStats"));

// Sıralama: ikili sıra ve Türk alfabesi
const titles = c => db.books.find({ title: { $gte: "H" } }, { _id: 0, title: 1 }).sort({ title: 1 }).collation(c).limit(5).toArray().map(b => b.title);
print("simple:", db.books.find({}, { _id: 0, title: 1 }).sort({ title: -1 }).limit(3).toArray().map(b => b.title).reverse().join(" | "));
print("tr    :", titles(tr).join(" | "));

// Locale önemli: Türkçede I ve i farklı harflerdir (I/ı, İ/i)
for (const c of [tr, { locale: "en", strength: 2 }]) {
    print(`${c.locale}: city "istanbul" ->`, db.customers.countDocuments({ city: "istanbul" }, { collation: c }),
          ` title "ince memed" ->`, db.books.countDocuments({ title: "ince memed" }, { collation: c }));
}
with collation FETCH <- IXSCAN keys 1 docs 1 returned 1
without collation COLLSCAN keys 0 docs 77 returned 0
simple: War and Peace | Wuthering Heights | İnce Memed
tr : Hyperion | I, Robot | İnce Memed | Jane Eyre | Kürk Mantolu Madonna
tr: city "istanbul" -> 0 title "ince memed" -> 1
en: city "istanbul" -> 16 title "ince memed" -> 0Collation'lı index yalnız aynı collation'ı belirten sorguya hizmet ediyor; collation'sız sorgu ikili karşılaştırma yaptı, bütün collection'ı taradı ve "İnce Memed"i bulamadı. Sıralamada fark daha görünür: varsayılan ikili sıralama "İ" harfini Z'den sonraya, listenin en sonuna atıyor; tr collation'ı onu Türk alfabesindeki yerine, I'dan sonraya koyuyor.
Son iki satır asıl tuzak. Türkçede I ile i ayrı harflerin büyük ve küçük hâlleri değil: I'nın küçüğü ı, i'nin büyüğü İ. Müşteri verisinde şehir ASCII (Türkçe harfler olmadan) olarak "Istanbul" yazılmış. tr collation'ında bu "ıstanbul" demek ve "istanbul" araması hiçbir müşteri bulmuyor; en collation'ı 16 müşteri buluyor ama bu sefer "ince memed" araması "İnce Memed"i bulamıyor. Collation'ın dili verinin yazılışına uymalı: Türkçe karakterli alanlara tr, ASCII'ye çevrilmiş alanlara en. Bir collection'ın bütün sorgularında aynı collation'ı kullanacaksan createCollection sırasında varsayılan collation tanımla; collection'ın sorguları ve index'leri onu miras alır ve her sorguya collation eklemeyi unutma riski kalkar.
Wildcard, Text Index ve Arama
Wildcard index ({ "$**": 1 } ya da { "attributes.$**": 1 }) adı önceden bilinmeyen alanların hepsini index'ler. Doküman onu yalnız alanlar gerçekten bilinmediğinde öneriyor ve hedefli index'lerden yavaş olduğunu belirtiyor; 5. yazıdaki attribute pattern aynı ihtiyaca tek bir compound index'le cevap veriyordu.
Kelime araması için klasik araç text index ve $text operator'ü. Türkçe kök bulma (stemming) desteği var, ama bir collection'da yalnız bir text index olabiliyor ve yazım hatası toleransı, otomatik tamamlama gibi özellikler yok. MongoDB dokümanı artık $text yerine MongoDB Search'ün $search stage'ini öneriyor. Self-managed tarafta bu ayrı bir mongot süreciyle çalışıyor; release notes'a göre Community ve Enterprise için 1.70.1 sürümüyle (Haziran 2026) GA (genel kullanıma açık sürüm) oldu ve uyumluluk tablosu MongoDB Server 8.3 ve sonrasını listeliyor, 8.0'ı değil. Bu lab'da mongot kurmadım, bu yüzden burada yalnız dokümandan aktarıyorum.
Kullanılmayan ve Gereksiz Index'leri Bulmak
Her index her yazmada güncellenir ve bellekte yer kaplar, bu yüzden index eklemek kadar silmek de iş. $indexStats her index'in son restart'tan beri kaç kez kullanıldığını söylüyor. Bu stage ve index gizleme readWrite'ın kapsamında değil, script admin olarak çalışıyor:
// 06 - kullanılmayan ve gereksiz index'leri bulmak; silmeden önce gizlemek (dbAdmin yetkisi ister)
bookstore.orders.createIndex({ "customer.customerId": 1, orderedAt: -1 });
bookstore.orders.createIndex({ "customer.customerId": 1 });          // yukarıdaki index'in prefix'i
bookstore.orders.createIndex({ status: 1 });

// $indexStats: son restart'tan beri her index kaç kez kullanıldı
bookstore.orders.aggregate([{ $indexStats: {} }, { $project: { name: 1, ops: "$accesses.ops" } }, { $sort: { name: 1 } }])
    .forEach(s => print(s.name.padEnd(36), "ops", Number(s.ops)));

// Gereksiz: key'leri başka bir index'in key'lerinin prefix'i olan index
const indexes = bookstore.orders.getIndexes();
for (const a of indexes) for (const b of indexes) {
    const ka = Object.entries(a.key), kb = Object.entries(b.key);
    if (a.name !== b.name && ka.length < kb.length && ka.every(([k, v], i) => kb[i][0] === k && kb[i][1] === v)
        && !a.unique && !a.partialFilterExpression && !a.collation) {
        print("redundant:", a.name, "is a prefix of", b.name);
    }
}

// Önce gizle, uygulamayı izle, sonra sil (unhideIndex onu anında geri getirir)
bookstore.orders.hideIndex("customer.customerId_1");
_id_ ops 0
customer.customerId_1 ops 0
customer.customerId_1_orderedAt_-1 ops 20
status_1 ops 1
redundant: customer.customerId_1 is a prefix of customer.customerId_1_orderedAt_-1
hidden: true plan uses: customer.customerId_1_orderedAt_-1Tek alanlı customerId index'i hiç kullanılmamış; zaten compound index'in prefix'i olduğu için onun yapabildiği her şeyi compound index de yapıyor. Prefix kontrolü unique, partial ve collation'lı index'leri dışarıda bırakıyor, çünkü onlar başka bir index'in prefix'i olsa bile farklı bir iş görüyor. Sayaçlar restart'ta sıfırlanır ve her member kendi sayacını tutar; karar vermeden önce yeterince uzun bir dönemi ve bütün member'ları kontrol et. Silmeden önce hideIndex ile gizlemek güvenli yol: gizli index planner'a görünmez ama güncellenmeye devam eder; bir sorgu yavaşlarsa unhideIndex onu index'i yeniden kurmadan anında geri getirir.
Bütün bu denemelerin sonunda Bookstore'un index seti ekranların sorgularından çıkıyor ve 06-bookstore-indexes.js'te duruyor:
db.orders.createIndex({ "customer.customerId": 1, orderedAt: -1 });              // siparişlerim, en yeniden eskiye
db.orders.createIndex({ "items.bookId": 1 });                                     // bir kitabı içeren siparişler (multikey)
db.orders.createIndex({ status: 1, orderedAt: 1 },
    { partialFilterExpression: { status: { $in: ["Pending", "Paid", "Shipped"] } } });   // yalnız açık siparişler
db.reviews.createIndex({ bookId: 1, reviewedAt: -1 });                            // bir kitabın son yorumları
db.books.createIndex({ title: 1 }, { collation: { locale: "tr", strength: 2 } }); // büyük/küçük harf duyarsız başlık araması
db.books.createIndex({ "authors.authorId": 1 });                                  // bir yazarın kitapları (multikey)
db.carts.createIndex({ customerId: 1 }, { unique: true });                        // müşteri başına bir sepet
db.carts.createIndex({ updatedAt: 1 }, { expireAfterSeconds: 30 * 24 * 3600 });  // terk edilmiş sepetler silinir
Üretimde Dikkat
Index build'in maliyetini planla. Dokümana göre build collection üzerinde yalnız başta ve sonda kısa bir exclusive lock alıyor, arada okuma ve yazmalara yol veriyor; yine de büyük bir collection'da saatlerce süren yoğun bir I/O (disk okuma ve yazma) işi. Replica set'te build bütün member'larda aynı anda yürür ve primary, varsayılan olarak oy hakkı olan bütün veri taşıyan member'lar bitirmeden index'i hazır saymaz; bu member'lardan biri erişilemez durumdaysa build bekleyebilir.
Index'lerin belleğe sığdığını izle. Sık kullanılan index'ler WiredTiger cache'inde (1. yazı) durmalı; db.collection.stats() içindeki totalIndexSize ve indexSizes ile index boyutlarını takip et. Bir collection'da en fazla 64 index, bir compound index'te en fazla 32 alan olabiliyor, ama pratik sınır bundan çok önce yazma maliyetinde geliyor.
Her yeni index'i bir sorgu şekline bağla. Profiler ve slow query log (14. yazı) yavaş sorguların şekillerini gösterir; index kararı o sorgunun explain sayılarına dayanmalı, "belki lazım olur"a değil.
Sık Düşülen Tuzaklar
Her alana ayrı index koymak. "Önce Tahmin Et"teki sorguyu customerId, total ve orderedAt üzerinde üç ayrı index'le çalıştırdım (06-esr.js'in son bölümü): planner yalnız customerId index'ini seçti, 39 key ve 39 document okudu ve sonucu bellekte sıraladı (SORT <- FETCH <- IXSCAN). Üç alanlı bir sorguya üç tek alanlı index değil, doğru sırada tek bir compound index gerekir; kullanılmayan tek alanlı index'ler yalnız yazma maliyeti olarak kalır.
Compound index sırasını sorguya göre değil alışkanlığa göre koymak. Alfabetik sıra, şemadaki sıra ya da "en seçici alan önce" kuralı ESR'nin yerini tutmaz: "Önce Tahmin Et"te aralığı başa koyan index 11 yerine 148 key okudu. Sıra sorgunun eşitlik, sıralama ve aralık kısımlarından çıkar ve explain ile doğrulanır.
Collation'ı index'te tanımlayıp sorguda unutmak. Collation'sız sorgu collation'lı index'i kullanmaz ve sessizce COLLSCAN'e düşer, sonucu da farklıdır. .NET tarafında FindOptions.Collation ile her sorguya eklemek gerekir (9. yazı); en sağlamı collection'ın varsayılan collation'ı.
Küçük Bir Deneme
★☆☆ reviews için "bir kitabın 4 ve 5 puanlı yorumları, en yeniden eskiye" sorgusunu yaz. { bookId, rating, reviewedAt } ve { bookId, reviewedAt, rating } index'lerini hint ile karşılaştır; $in: [4, 5] ile $gte: 4 arasındaki farkı SORT_MERGE üzerinden açıkla.
★★☆ customers.email için unique ve büyük/küçük harf duyarsız bir index kur (en, strength: 2). ADA.LOVELACE@example.com adresiyle yeni bir müşteri eklemeyi dene; aynı index'i collation'sız kurup sonucu karşılaştır.
★★★ Katalog sayfası kitapları kategoriye göre filtreleyip fiyata göre sıralıyor, bir fiyat aralığı ve isActive: true koşulu da var. Bu sorgu için bir index tasarla, explain ile key/document/sonuç oranını ölç ve sorguyu covered hâle getirmek için projection'ı nasıl değiştirmen gerektiğini göster.
Index'ler tek collection'dan hızlı okumayı çözdü. Bir sonraki yazıda birden çok document'i işleyip yeni sonuçlar üreten aggregation pipeline'a geçiyoruz: $match, $group, $project, $unwind, $lookup ve $facet ile kategori bazında ciro, müşteri başına sipariş sayısı ve arama sayfası için facet'ler, SQL Temelleri'ndeki GROUP BY sorgularıyla yan yana.