

Replica Set ve Sharding: Election, Oplog, Shard Key Seçimi ve Hot Shard

Replica set primary çöktüğünde yeni primary'yi yaklaşık 10 saniyede seçer ve bu sürede yazmalar durur; sharding'de ise shard key, yazmaların bir shard'a yığılıp yığılmayacağını belirler. Gerçek çıktılarla: kill -9 sonrası iki başarısız yazma ve 10 saniyelik boşluk, delayed member'dan silinen siparişi geri almak, orderedAt key'iyle son 2.000 siparişin tek shard'a gitmesi, targeted ve scatter-gather sorgular ve beş dakikalık resharding.
Sürüm notu: Bu yazıdaki örnekler MongoDB 9.0.8 Community Server, mongosh 2.6, .NET 10 ve MongoDB.Driver 3.14 ile çalıştırılmıştır. Script'ler MongoDB 8.0.38'de de çalıştırıldı; farklar ilgili bölümlerde.
Önce Tahmin Et
Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) sipariş servisi 12. yazıdaki üç üyeli replica set'e her 100 ms'de bir yazıyor. failover komutu bunu 45 saniye boyunca yapıyor ve yavaş ya da başarısız her yazmayı, primary her değiştiğinde de yeni primary'yi yazdırıyor. 6. saniyede primary'yi rs.stepDown() ile planlı olarak görevden çekiyoruz; 20. saniyede yeni primary'nin process'ini kill -9 ile öldürüyoruz:
docker compose -f compose.rs3.yaml exec rs3 mongosh "mongodb://admin@localhost:27021,localhost:27022,localhost:27023/?authSource=admin&replicaSet=rs3" --eval "rs.stepDown(30)" -p
docker compose -f compose.rs3.yaml exec rs3 bash /lab/scripts/13-member.sh kill 27022
"Replica set otomatik failover yapar" cümlesini herkes bilir. Uygulama kaç saniye yazamaz, kaç hata görür?
   0.1s  primary localhost:27021  write    74 ms  ok
   5.8s  primary localhost:27022  write    11 ms  ok
  25.2s  primary none             write  5008 ms  TimeoutException: A timeout occurred after 5001ms selecting a server
  30.3s  primary none             write  5001 ms  TimeoutException: A timeout occurred after 5000ms selecting a server
  30.9s  primary localhost:27023  write   440 ms  ok
writes ok 326, failed 2, slowest 5008 ms
Öldürülen üyeyi deneyden sonra 13-member.sh start 27022 ile yeniden başlatıyorsun. Planlı geçişte uygulama hiçbir şey fark etmedi: primary 27022'ye geçti, yazma 11 ms sürdü. Çökmede ise 20. saniyeden 30.9. saniyeye kadar yaklaşık 10 saniye hiçbir yazma tamamlanmadı ve iki istek TimeoutException ile düştü. 9. yazıda ServerSelectionTimeout'u 5 saniyeye indirmiştik; driver uygun bir primary bulamayınca her istek 5 saniye bekleyip vazgeçti. Bu yazıda replica set'in ve sharding'in içine bu türden ölçümlerle bakıyoruz: election ve failover süresi, oplog penceresi, arbiter, hidden ve delayed üyeler, ardından sharded cluster, shard key seçimi, hot shard ve resharding. Teorinin kendisi System Design serisinin "Veri Katmanını Ölçeklemek: Replication, Sharding ve SQL mi NoSQL mi?" yazısında.
Election ve Failover Süresi
Üyeler birbirine iki saniyede bir heartbeat gönderiyor. Secondary'ler primary'den electionTimeoutMillis (varsayılan 10.000 ms) boyunca haber alamazsa bir seçim başlatıyor; oyların çoğunluğunu alan aday primary oluyor. Ölçtüğümüz 10 saniye bu ayarın kendisi; 8.0.38'de aynı deney bir başarısız ve bir 4.8 saniyelik yazma verdi, boşluk yine 10 saniye civarındaydı. 13-replset.js son seçimin nedenini primary'nin kendisinden okuyor:
last election: electionTimeout | electionTimeoutMillis 10000 | votes needed 2Doküman varsayılan ayarlarla yeni primary seçilmesinin medyanının genellikle 12 saniyeyi geçmemesi gerektiğini söylüyor. rs.stepDown() ise primary'nin kendi isteğiyle çekilmesi: secondary'lerden biri hemen aday oluyor ve zaman aşımı beklenmiyor. Bakım için üyeleri tek tek yeniden başlatırken (rolling restart) primary'yi en sona bırakıp önce stepDown yapmak bu yüzden önemli. Uygulama tarafında iki ders var. Birincisi, driver'ın varsayılan ServerSelectionTimeout'u 30 saniye; election süresini kapsayan bir değer. 5 saniye gibi kısa bir değer "hızlı hata" verir ama her failover'da hata üretir; seçimini buna göre yap. İkincisi, retryable writes (driver'ın varsayılan olarak açık tuttuğu, ağ hatasında yazmayı bir kez retry) planlı geçişi görünmez yaptı, ama 10 saniyelik bir boşluğu tek retry kapatamaz; sipariş akışında bir üst katmanda kısa bir retry ya da kullanıcıya "tekrar dene" gerekiyor.
Oplog: Boyut ve Pencere
oplog size 39737 MB | used 0.41 MB | first to last entry 0.02 hoursOplog sabit boyutlu, dolunca en eskisini silen bir collection. WiredTiger'da varsayılan boyut boş disk alanının %5'i; en az 990 MB, en fazla 50 GB. Lab'daki 39 GB, Docker'ın sanal diskinin %5'i. Asıl önemli sayı boyut değil pencere: oplog'daki ilk ve son kayıt arasındaki süre. Bir secondary bu süreden uzun kapalı kalırsa geri döndüğünde kaldığı yerden devam edemez, bütün veriyi baştan kopyalar (initial sync). 10. yazıdaki change stream'in resume token'ı için de sınır aynı pencere. Lab'da pencere 0.02 saat görünüyor çünkü lab yeni kuruldu; production'da bu sayıyı yoğun bir gündeki yazma hızıyla izle. Pencere kısa kalıyorsa replSetResizeOplog ile oplog'u büyütebilir ya da oplogMinRetentionHours ile en az kaç saatlik kayıt tutulacağını belirleyebilirsin.
Arbiter, Hidden ve Delayed Üyeler
Arbiter veri tutmayan, yalnız oy veren bir üye; üç makine yerine iki makineyle çoğunluk kurmanın ucuz yolu gibi görünüyor. Doküman primary-secondary-arbiter (PSA) kurulumunun sorunlarını ayrıca anlatıyor: veri taşıyan secondary düştüğünde w: "majority" yazmalar tamamlanamıyor ve performans sorunları çıkıyor; 12. yazıdaki varsayılan majority, veri taşıyan oy veren üye sayısı oy çoğunluğundan büyük değilse w: 1'e düşüyor. Yani arbiter'lı üç üye, 12. yazının kalıcılık hesabını bozuyor. Üçüncü üye için küçük de olsa veri taşıyan bir makine tercih et.
Hidden üye driver'ların göremediği, primary olamayan (priority 0) bir secondary; 12. yazıda söz verdiğimiz analitik raporlar için doğru yer, çünkü ağır sorgular uygulamanın okuduğu üyeleri yormaz. Delayed üye ise oplog'u belirli bir gecikmeyle uygulayan hidden bir üye. Script bir secondary'yi hidden, priority 0 ve 60 saniye gecikmeli yapıyor, sonra primary'de bir siparişi "yanlışlıkla" siliyor:
// Bir secondary hidden, priority 0 ve 60 saniye gecikmeli olur
const cfg = rs.conf();
const primary = db.hello().primary;
const member = cfg.members.filter(m => m.host !== primary).at(-1);
Object.assign(member, { priority: 0, hidden: true, secondaryDelaySecs: 60 });
rs.reconfig(cfg);

// Primary'de yanlışlıkla silme: delayed üyede document hâlâ duruyor
orders.deleteOne({ _id: 378 }, { writeConcern: { w: "majority" } });
const delayed = direct(member.host).getDB("bookstore").orders.findOne({ _id: 378 });
orders.insertOne(delayed);
localhost:27022 is hidden; members the drivers see: localhost:27021, localhost:27023
order 378 on the primary: deleted | on the delayed member: found (Paid)
restored from the delayed member: Paidhello çıktısındaki üye listesinde 27022 yok; driver'lar ona okuma göndermeyecek. Silme w: "majority" ile onaylandı, ama gecikmeli üye onu 60 saniye sonra uygulayacak; o süre içinde sipariş oradan okunup geri yazıldı. Bu bir backup yerine geçmez, ama "az önce yanlış bir deleteMany çalıştırdım" türünden hatalara karşı dakikalar kazandırır. Gecikmenin bir bedeli var: delayed üye oplog'u geç uyguladığı için w: "majority" onayına sayılırsa yazmaları dakikalarca bekletebilir. Doküman bu yüzden delayed üyeleri oy vermeyen (votes: 0) üye yapmayı anlatıyor; o zaman majority onayına sayılmıyorlar.
Sharded Cluster: mongos, Config Server ve Shard'lar
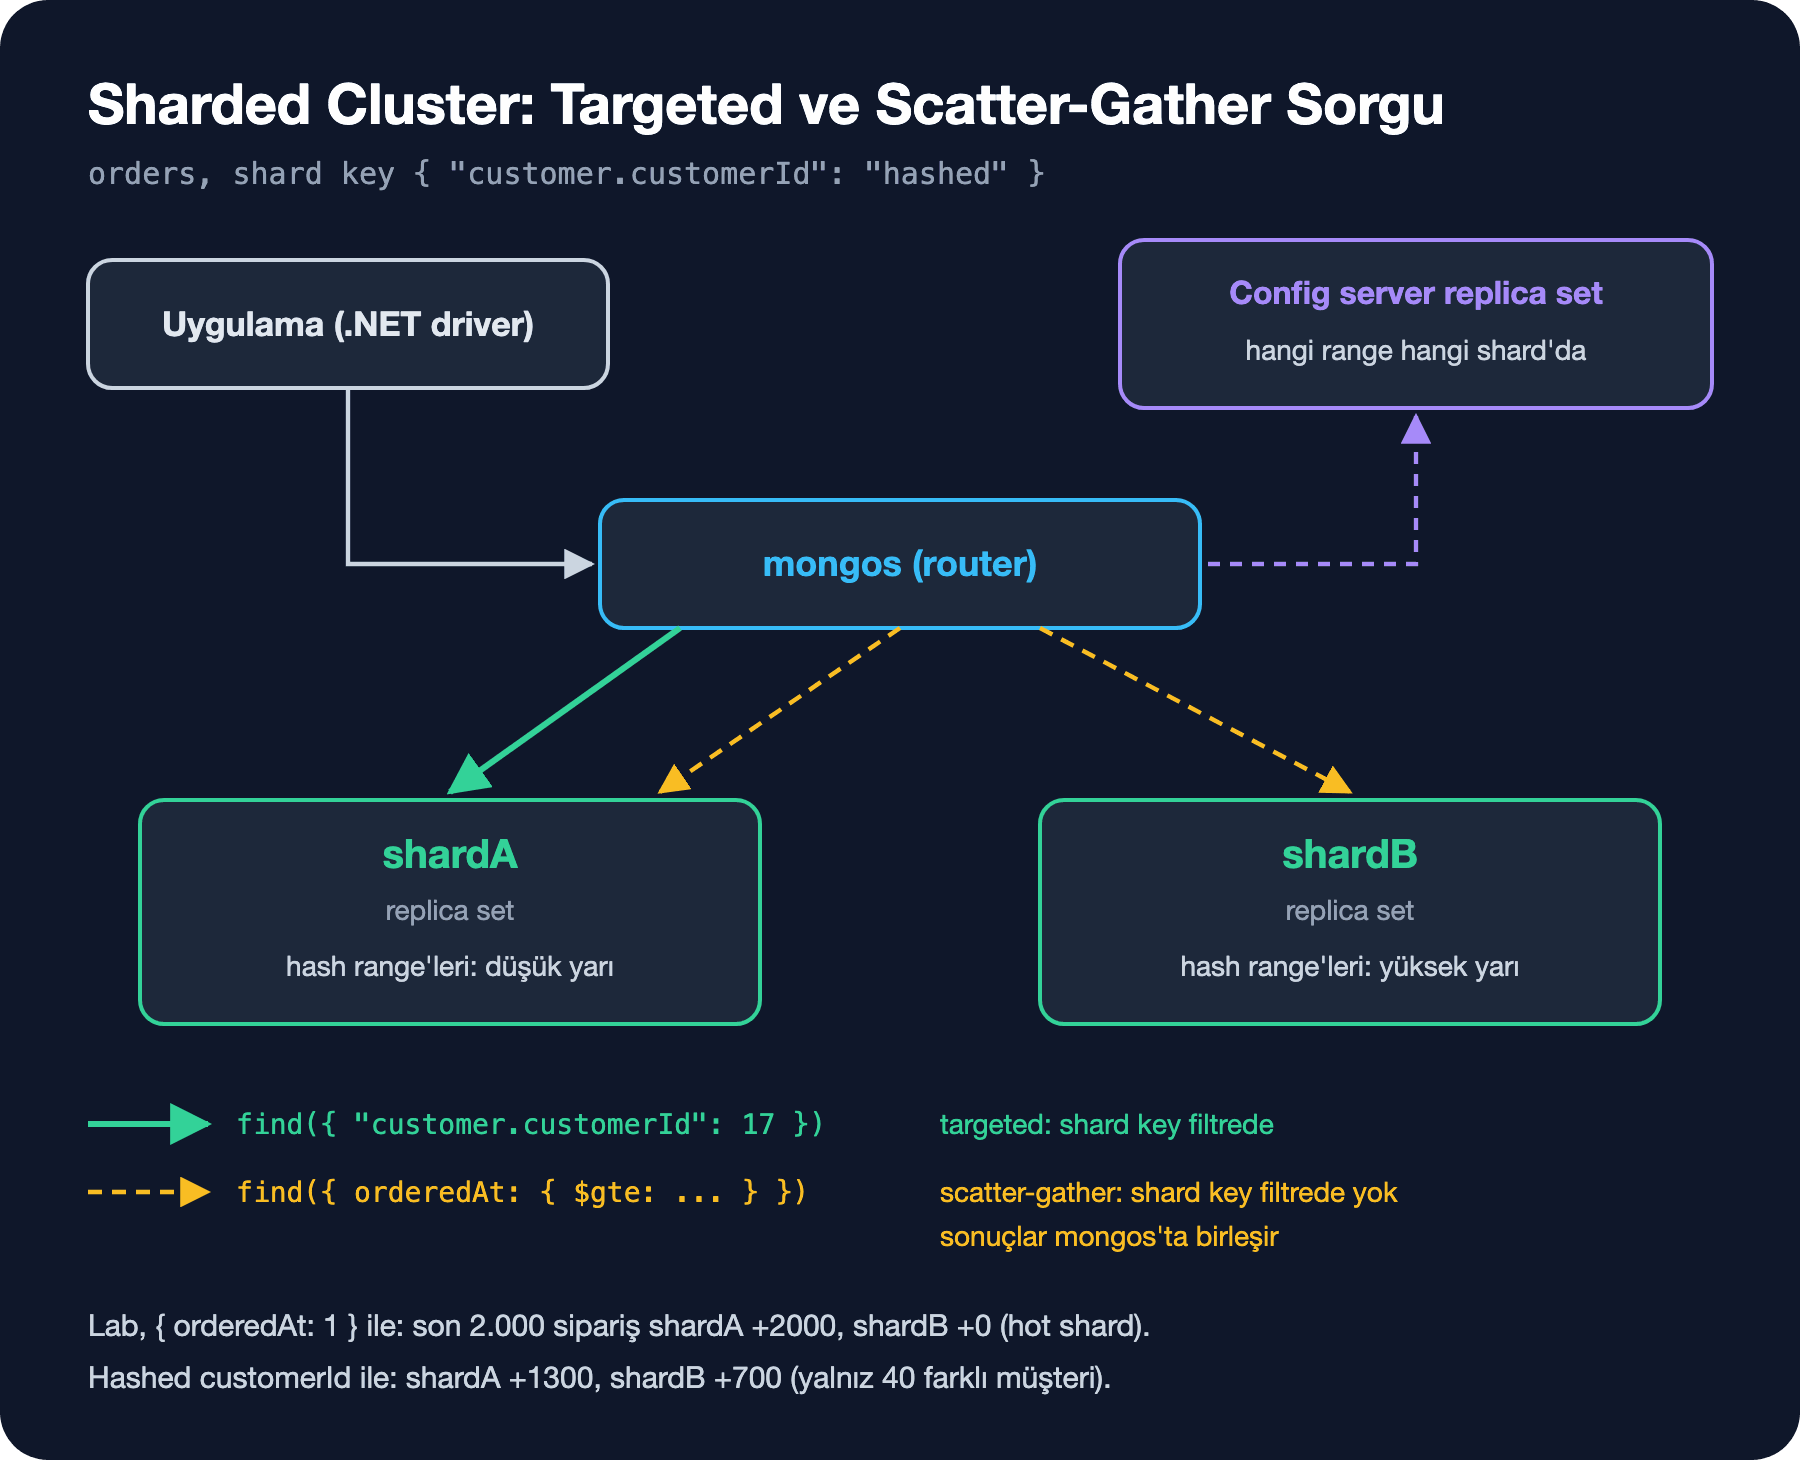
Sharding veriyi shard key'e göre parçalara (range) bölüp her parçayı bir shard'a, yani ayrı bir replica set'e koymak. Uygulama shard'lara değil mongos'a bağlanıyor; mongos hangi range'in hangi shard'da olduğunu config server replica set'inden öğrenip sorguyu yönlendiriyor. Lab'da bu da tek container: bir config server, iki shard (her biri tek üyeli replica set) ve bir mongos, hepsi 0.25 GB cache ile; makinede ikinci container olarak çalışıyor. compose.shard.yaml ve 13-shard-init.sh 12. yazıdakilerle aynı düzende; bellek için önce üç üyeli lab'ı durdur:
docker compose -f compose.rs3.yaml down
docker compose -f compose.shard.yaml up -d
docker compose -f compose.shard.yaml exec shard bash /lab/scripts/13-shard-init.sh
docker compose -f compose.shard.yaml exec shard mongosh "mongodb://admin@localhost:27030/?authSource=admin" --quiet /lab/scripts/13-shard-keys.js -p
Shard Key Seçimi ve Hot Shard
Doküman shard key'i üç ölçüyle değerlendiriyor: cardinality (kaç farklı değer), frequency (değerlerin ne kadar eşit dağıldığı) ve monotonluk (değerin sürekli artıp artmadığı). 13-shard-keys.js siparişleri iki collection'a yazıyor: biri { orderedAt: 1 } ile range sharding, diğeri { "customer.customerId": "hashed" } ile hashed sharding. Önce 18.000 sipariş, sonra son 2.000 siparişin hangi shard'a gittiği ölçülüyor:
sh.shardCollection("bookstore.orders_by_date", { orderedAt: 1 });
sh.shardCollection("bookstore.orders_by_customer", { "customer.customerId": "hashed" });

// Shard başına document; migration bir süre orphan kopyalar bırakır, onlar sayılmaz
const countsPerShard = name => Object.fromEntries(bookstore[name]
    .aggregate([{ $collStats: { storageStats: {} } }]).toArray()
    .map(s => [s.shard, s.storageStats.count - (s.storageStats.numOrphanDocs ?? 0)]));
orders_by_date: last 2,000 inserts went to shardA +2000, shardB +0 | documents per shard: shardA 13871, shardB 6129
orders_by_customer: last 2,000 inserts went to shardA +1300, shardB +700 | documents per shard: shardA 13000, shardB 7000
orders_by_date last day: SINGLE_SHARD [shardA] customer 17: SHARD_MERGE [shardA, shardB]
orders_by_customer last day: SHARD_MERGE [shardA, shardB] customer 17: SINGLE_SHARD [shardA]Tarih key'inde son 2.000 siparişin hepsi shardA'ya gitti. Balancer arka planda eski range'leri shardB'ye taşıyor (6.129 document), ama yeni sipariş her zaman en büyük orderedAt değerini taşıdığı için hep "son" range'e, yani tek bir shard'a düşüyor: hot shard. İkinci shard eklemek yazma kapasitesini artırmadı. Hashed customerId yazmaları iki shard'a böldü, ama eşit değil: 1.300'e 700. Lab'da yalnız 40 müşteri var; 40 farklı değer hash'lendiğinde range'lere eşit düşmüyor. Gerçek Bookstore'da müşteri sayısı yüz binlerle ölçülür ve bu dengesizlik kaybolur; ama "kategori" ya da "ülke" gibi düşük cardinality'li bir key aynı sorunu kalıcı yaşar.
Son iki satır sorgu tarafı. Filtrede shard key varsa mongos sorguyu tek shard'a gönderiyor (SINGLE_SHARD, targeted); yoksa bütün shard'lara gönderip sonuçları birleştiriyor (SHARD_MERGE, scatter-gather). Tarih key'i "son gün" raporunu hedefliyor ama "müşterinin siparişleri" sayfasını bütün shard'lara dağıtıyor; hashed customerId tersini yapıyor. Hashed key'in bir bedeli daha var: range sorgusunu hedefleyemiyor. Bookstore'un en sık sorgusu 4. yazıdaki "müşterinin siparişleri, yeniden eskiye" olduğu için benim seçimim { "customer.customerId": 1, orderedAt: 1 }: müşteri sorgusu tek shard'a gidiyor, müşteri içindeki tarih sıralaması korunuyor, yeni siparişler müşteriler arasında dağılıyor. 6. yazıdaki compound index'le aynı mantık. Zone sharding ile belirli range'leri belirli shard'lara bağlamak da mümkün (ör. AB (Avrupa Birliği) müşterilerinin verisini AB'deki shard'larda tutmak); bunu lab'da çalıştırmadım.
Resharding: Key'i Sonradan Değiştirmek
const result = db.adminCommand({ reshardCollection: "bookstore.orders_by_date", key: { "customer.customerId": 1, orderedAt: 1 } });reshardCollection ok: 1 after 333 s
new shard key: {"customer.customerId":1,"orderedAt":1}
shardB 10342 documents
shardA 9658 documents20.000 siparişlik bir collection'ı yeni key'e taşımak 333 saniye sürdü. 8.0.38'de aynı işlem 331 saniye sürdü; shard key deneyinin sayıları da iki sürümde birebir aynıydı. Bu sürenin büyük kısmı veri değil kural: doküman bir resharding işleminin en az 5 dakika sürdüğünü söylüyor. İşlem online; okuma ve yazmalar devam ediyor, yalnız sonunda yazmalar en fazla iki saniye bloklanıyor. Bedeli disk ve yük: her shard'da collection'ın yeni hâli ayrıca kuruluyor. Mümkünse key'i baştan doğru seç; resharding hatayı düzeltmenin yolu, rutin bir araç değil.
Ne Zaman Sharding Gerekmez?
Sharding bir mongos katmanı, üç üyeli bir config server ve her shard için ayrı bir replica set demek; işletim maliyeti üç ila dört kat. Önce daha ucuz adımlar: doğru index'ler (6. yazı), şişkin document'leri küçültmek ve eski siparişleri arşivlemek (5. yazı), primary'yi büyütmek (dikey ölçek) ve okumayı 12. yazıdaki kurallarla dağıtmak. Tek bir replica set'in diski, belleği ya da yazma kapasitesi gerçekten tükendiğinde sharding gündeme gelir. Genel yolculuk bu turda yazılan Veritabanı Performansı ve Scaling serisinde.
Üretimde Dikkat
Failover'ı test et, varsayma. Bu yazıdaki failover komutu gibi bir yük altında primary'yi gerçekten öldür ve uygulamanın log'una bak: kaç istek düştü, kullanıcı ne gördü, retry'lar işi tekrar etti mi? Zaman aşımı ayarları ve retry politikası bu testle belirlenir.
Sharded cluster'da shard key'i filtreye koy. Shard key içermeyen sık bir sorgu her shard'a gider; shard sayısı arttıkça maliyeti de artar. Balancer'ı da izle: göç (migration) sırasında shard'larda bir süre orphan document'ler kalıyor; yukarıdaki sayımda bunları çıkarmamız bu yüzden gerekti.
Sık Düşülen Tuzaklar
Monotonik shard key. _id olarak ObjectId (1. yazı: ilk dört byte zaman) ya da orderedAt gibi sürekli artan bir alanla range sharding, bütün yeni yazmaları tek shard'a gönderir. Ya hashed key kullan ya da monotonik alanı yüksek cardinality'li bir alanın arkasına koy.
İki veri merkezine iki üye. Üyelerin yarısının bulunduğu taraf çökerse kalan taraf çoğunluğu kuramaz ve primary seçemez. Üye sayısı tek olmalı ve üyeler, tek bir yerin kaybı çoğunluğu götürmeyecek şekilde dağılmalı.
Küçük Bir Deneme
★☆☆ rs.reconfig ile settings.electionTimeoutMillis'i 5000 yapıp failover deneyini tekrarla. Boşluk ne kadar kısaldı? Bu değeri düşürmenin hangi riski var?
★★☆ failover komutunda ServerSelectionTimeout'u varsayılan 30 saniyeye çek. Aynı kill -9 deneyinde başarısız yazma sayısı ve en yavaş yazma nasıl değişiyor?
★★★ 13-shard-keys.js'e { "customer.customerId": 1, orderedAt: 1 } key'li üçüncü bir collection ekle. Son 2.000 yazmanın dağılımını ve iki sorgunun hedeflenip hedeflenmediğini diğer ikisiyle karşılaştır.
Bir sonraki yazıda bu cluster'ları korumaya geçiyoruz: kullanıcılar ve custom role'ler, TLS (bağlantıyı şifreleyen protokol), Queryable Encryption, backup ve restore testi ve izleme.