

Document Modeling 1: Embed mi Reference mı? Access Pattern'den Şemaya

Embed mi reference mı sorusunun cevabı ilişkinin adından değil, birlikte okunma sıklığından, array'in üst sınırından ve tek document atomikliğine ihtiyaçtan çıkar: sınırlı ve birlikte okunan veri gömülür, sınırsız büyüyen ya da bağımsız yaşayan veri referansla ayrılır. Gerçek ölçümlerle Bookstore'un workload'u, 110.000 yorumda 16 MB sınırı, kopyalanan alanların güncelleme maliyeti, aggregate sınırı ve her okumada $lookup yapan ilişkisel kopya.
Sürüm notu: Bu yazıdaki örnekler MongoDB 9.0.8 Community Server ve mongosh 2.6 ile çalıştırılmıştır. Script'ler MongoDB 8.0.38'de de aynı sonucu verdi; tek fark 16 MB hatasının mesaj metni, aşağıda belirttim.
Önce Tahmin Et
Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) kitap sayfası kitabı ve yorumlarını birlikte gösteriyor. "Birlikte okunan veri birlikte durur" kuralını duyan biri yorumları kitabın içine bir array olarak gömmeyi öneriyor. Lab'daki yorumların ortalama boyutu 142 byte. Dune'a yorumları 10.000'lik gruplarla ekleyen bir script yazalım:
// 04 - sınırsız büyüyen array: bir kitabın bütün yorumlarını kitaba gömmek
db.lab_books.drop();
const template = db.reviews.findOne({ body: { $exists: true } }, { _id: 0, bookId: 0 });
const book = db.books.findOne({ _id: 26 });
db.lab_books.insertOne(book);
print("book alone           :", bsonsize(db.lab_books.findOne({ _id: 26 })), "bytes");

const batch = Array.from({ length: 10000 }, () => template);
let pushed = 0;
try {
    while (true) {
        db.lab_books.updateOne({ _id: 26 }, { $push: { reviews: { $each: batch } } });
        pushed += batch.length;
        if (pushed % 20000 === 0) {
            print(`${String(pushed).padStart(6)} reviews  :`, bsonsize(db.lab_books.findOne({ _id: 26 })), "bytes");
        }
    }
} catch (e) {
    print(`after ${pushed} reviews: ${e.name} code ${e.code}`);
    print(e.message);
}
db.lab_books.drop();
Kaç yorumdan sonra yazma reddedilir? Ve asıl soru: sınıra varmadan önce kitap sayfasının her açılışında ne kadar veri taşınıyordur?
book alone           : 339 bytes
 20000 reviews  : 2829243 bytes
 40000 reviews  : 5669243 bytes
 60000 reviews  : 8509243 bytes
 80000 reviews  : 11349243 bytes
100000 reviews  : 14189243 bytes
after 110000 reviews: MongoServerError code 10334
Plan executor error during update :: caused by :: Resulting document after update is larger than 16777216
110.000 yorum sığdı, 120.000'e çıkaracak $push reddedildi. Sınır 16 MiB, yani 16.777.216 byte; MongoDB 8.0'da aynı hata BSONObj size: 17049243 (0x104269B) is invalid mesajıyla geliyor, deneyen yazmanın varacağı boyutu da gösteriyor. Ama hata asıl sorun değil. Popüler bir kitabın 20.000 yorumu varken kitap document'i 2,8 MB; kitap sayfasının, katalog listesinin, sepetin bu kitabı okuyan her isteği bu kadar veriyi diskten cache'e, cache'ten ağa taşıyor. Projection ağdan dönen kısmı küçültür, ama document yine bir bütün olarak saklanır ve okunur. Her yeni yorum da bu büyük document'i yeniden yazdırır. Bu yazıda bu türden kararları sezgiyle değil, workload'dan ve ölçümden başlayarak veriyoruz.
Önce Workload: Bookstore'un Access Pattern Listesi
İlişkisel modeling'de önce verinin kendisini modeller, erişim şeklini index seçerken düşünürsün. Document modeling'de sıra tersine döner: MongoDB'nin şema tasarım sürecinin ilk adımı uygulamanın workload'unu çıkarmak, yani hangi işlemin hangi veriyi ne sıklıkla okuyup yazdığını listelemek. Bookstore için bu liste kabaca şöyle:
| İşlem | Tür | Sıklık | Birlikte okunan / yazılan |
|---|---|---|---|
| Kitap sayfası | okuma | çok yüksek | kitap, yazar adları, kategori, fiyat, stok durumu, son yorumlar |
| Katalog ve arama listesi | okuma | çok yüksek | kitap özeti (başlık, yazar, fiyat) |
| Sipariş vermek | yazma | orta | sipariş, kalemler, kitap başına stok düşümü |
| Siparişlerim ve sipariş detayı | okuma | orta | sipariş, kalemler, ödemeler |
| Yorum yazmak | yazma | orta | yorum, kitabın yorum özeti |
| Yorumları sayfalı listelemek | okuma | orta | bir kitabın yorumları, yeniden eskiye |
| Yazar sayfası | okuma | düşük | yazar bilgisi, yazarın kitapları |
| Raporlar | okuma | düşük, ağır | sipariş, kalem ve kategori üzerinden toplamlar |
Listeye sayılar da eklemek gerekiyor, çünkü "one-to-many" gibi bir etiket büyüklük hakkında bir şey söylemiyor. Lab'daki veriye bakalım:
// 04 - collection başına document boyutları ($bsonSize)
for (const name of ["books", "orders", "reviews", "customers"]) {
    const [s] = db.getCollection(name).aggregate([
        { $group: { _id: null, n: { $sum: 1 },
                    avg: { $avg: { $bsonSize: "$$ROOT" } }, max: { $max: { $bsonSize: "$$ROOT" } } } }
    ]).toArray();
    print(`${name.padEnd(9)} n=${String(s.n).padStart(3)}  avg=${Math.round(s.avg)} B  max=${s.max} B`);
}

// Kitap başına yorum ve sipariş başına kalem sayıları
const [r] = db.reviews.aggregate([
    { $group: { _id: "$bookId", n: { $sum: 1 } } },
    { $group: { _id: null, books: { $sum: 1 }, avg: { $avg: "$n" }, max: { $max: "$n" } } }
]).toArray();
print(`reviews per book: books=${r.books} avg=${r.avg.toFixed(1)} max=${r.max}`);
const [o] = db.orders.aggregate([
    { $group: { _id: null, avg: { $avg: { $size: "$items" } }, max: { $max: { $size: "$items" } } } }
]).toArray();
print(`items per order : avg=${o.avg.toFixed(2)} max=${o.max}`);
books n= 77 avg=344 B max=542 B
orders n=379 avg=429 B max=696 B
reviews n=181 avg=142 B max=172 B
customers n= 40 avg=159 B max=185 B
reviews per book: books=58 avg=3.1 max=9
items per order : avg=1.79 max=4Bir sipariş ortalama 1,79 kalem taşıyor ve en kalabalık sipariş 4 kalemli; bütün siparişin, kalemleri ve ödemeleriyle, 700 byte'ın altında olduğunu görüyoruz. Bir kitap ise bugün en fazla 9 yorum almış. Bu sayı yanıltıcı: siparişin kalem sayısının doğal bir üst sınırı var (bir sepet), kitabın yorum sayısının yok. Bugünkü veri küçük diye yorumları gömmek, "Önce Tahmin Et"teki document'e doğru yola çıkmak demek. Modeli bugünkü sayılarla değil, sayıların nereye kadar büyüyebileceğiyle kurarsın.
İlişkinin Kardinalitesine Göre Karar
MongoDB topluluğunda yaygın kullanılan bir sınıflandırma, William Zola'nın MongoDB blogundaki 2014 tarihli "6 Rules of Thumb for MongoDB Schema Design" yazı dizisinden geliyor: one-to-many demek yetmez, "many"nin ne kadar olduğunu söylemek gerekir. Bunu Bookstore'a uygulayınca kararlar şöyle çıkıyor:
- One-to-few, birkaç ile birkaç düzine arası ve sınırlı: gömülür. Siparişin kalemleri ve ödemeleri, kitabın yazar özeti. Parent ile birlikte okunur, parent'sız anlamı yoktur.
- One-to-many, yüzler ile binler arası ya da üst sınırı belirsiz: child kendi collection'ında durur ve parent'ın id'sini taşır. Kitabın yorumları: her yorumda
bookIdvar, kitapta yorum listesi yok. - One-to-squillions, milyonlara kadar büyüyebilen olay ve kayıtlar: kesinlikle child tarafında referans, çoğu zaman da gruplanarak. Kitabın görüntülenme kayıtları; bucket pattern ile 5. yazıda.
- Many-to-many, kitap ile yazar: referans array'i sınırlı olan tarafta tutulur. Bir kitabın birkaç yazarı var, bu yüzden
authorskitapta; bir yazarın kitap sayısı büyüyebilir, yazar document'inde kitap listesi tutmuyoruz. - One-to-one: neredeyse her zaman gömülür; ayrı tutmanın tek iyi nedeni, nadiren okunan büyük bir parçayı sık okunan document'ten uzak tutmak.
Many-to-many satırının sonucu sorguda da görünüyor: yazar sayfası "bu yazarın kitapları" için kitaplarda authors.authorId üzerinden arama yapıyor. Bu alan bir array'in içinde, ileride üzerine konan index de multikey index olacak (6. yazı).
// Many-to-many: yazarın kitapları için referans kitapta duruyor
printjson(db.books.find({ "authors.authorId": 18 }, { _id: 0, title: 1 }).sort({ _id: 1 }).toArray());
printjson(db.authors.findOne({ _id: 18 }));
[
{
title: 'Dune'
},
{
title: 'Dune Messiah'
}
]
{
_id: 18,
firstName: 'Frank',
lastName: 'Herbert',
birthYear: 1920
}Bookstore'un Kararları
2. yazıda yüklediğimiz verinin şekli bu kuralların sonucu. Bütün modeli tek resimde görelim:
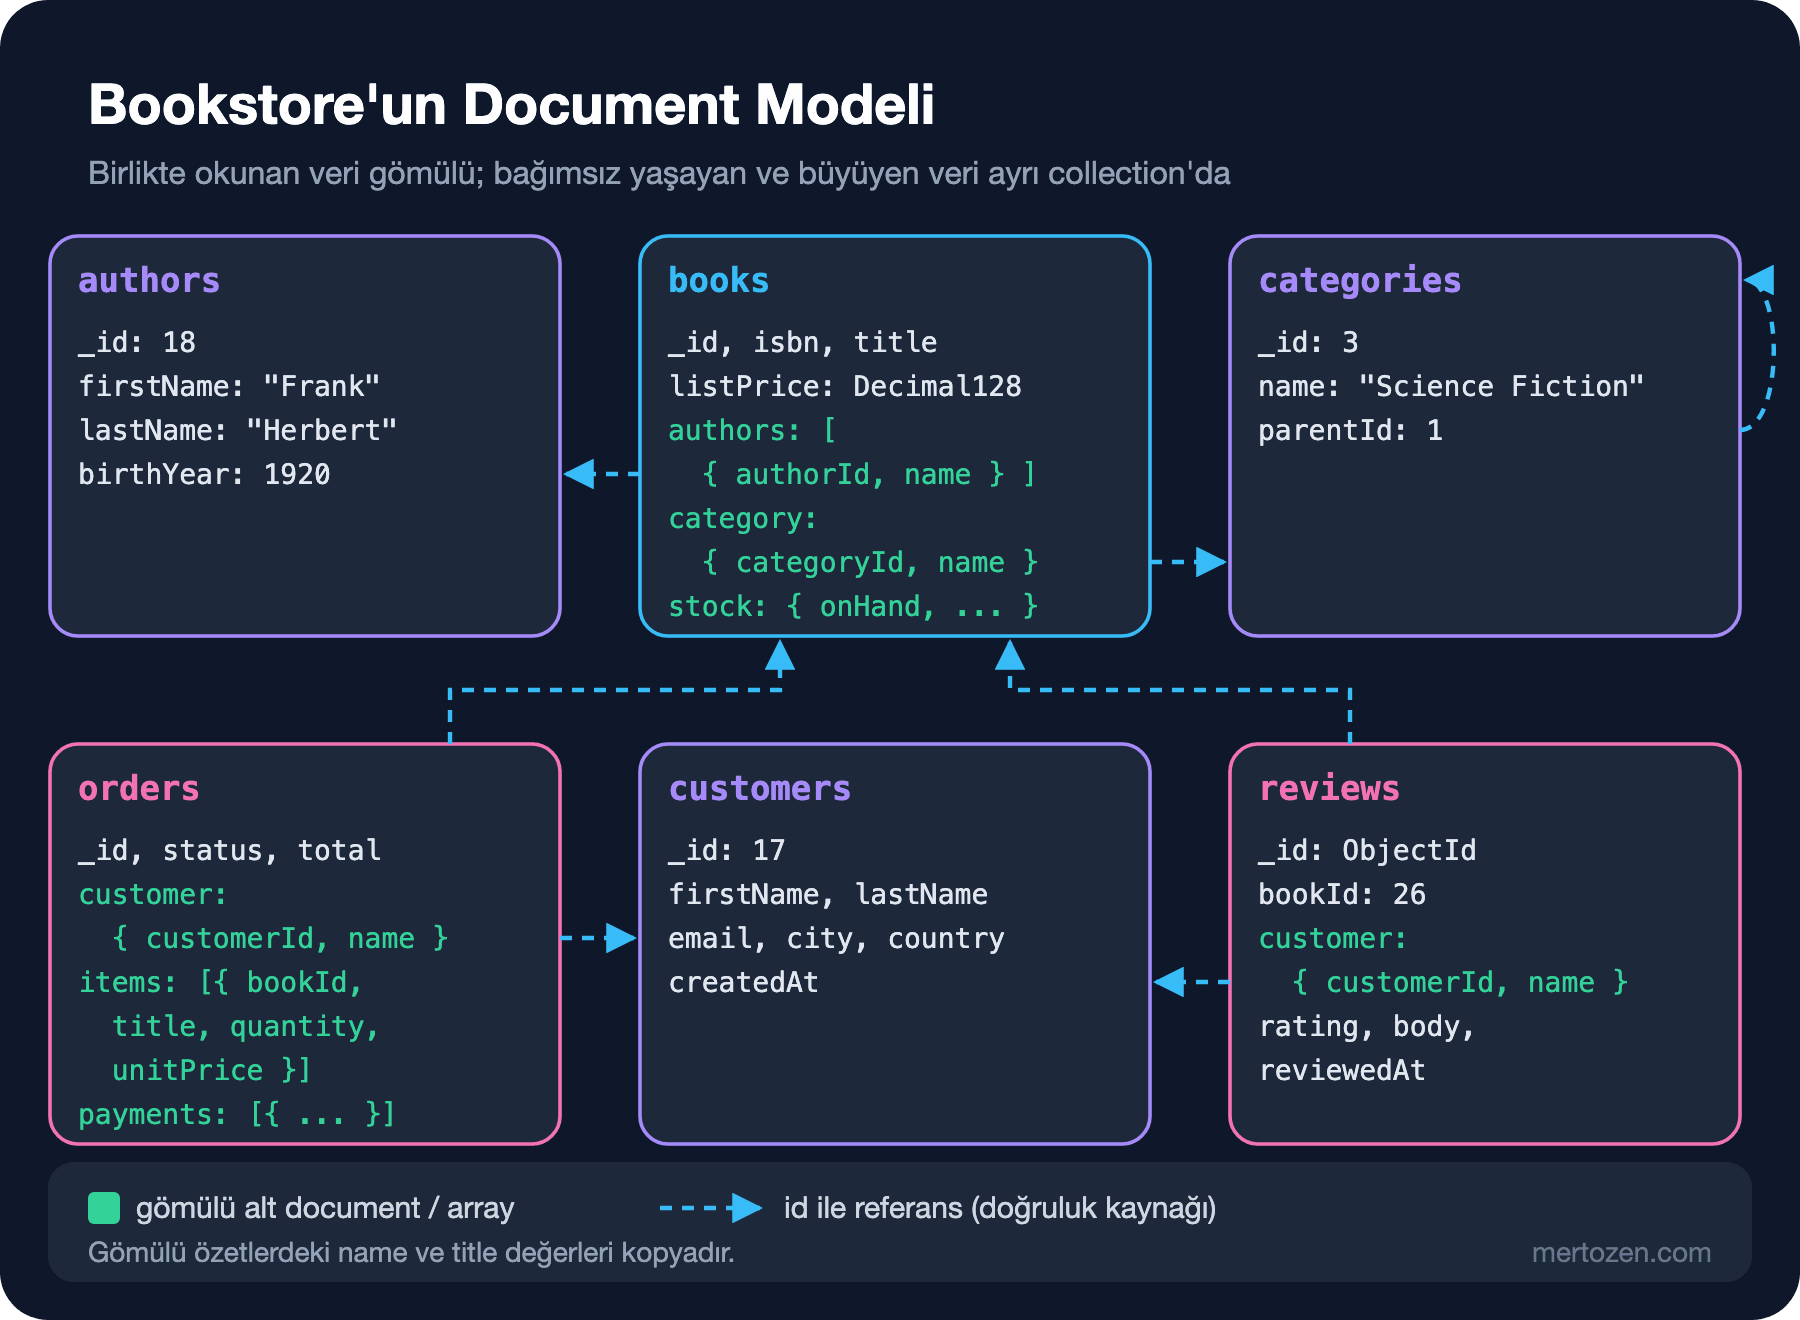
Sipariş kalemleri ve ödemeler siparişin içinde: sınırlılar, her zaman siparişle okunuyorlar ve siparişin toplamıyla tutarlı kalmaları gerekiyor. Kalemdeki title ve unitPrice kitabın kopyası değil, satış anının kaydı. Bir kaynağın birkaç alanını referansla birlikte kopyalamaya MongoDB literatüründe extended reference deniyor; siparişteki customer: { customerId, name } de aynı türden. Kitap, yazarlarının ve kategorisinin özetini taşıyor, çünkü katalog listesi ve kitap sayfası bunları her seferinde gösteriyor; yazarın tam bilgisi authors collection'ında, kategori ağacı categories collection'ında. Yorumlar ayrı, çünkü sınırsızlar ve sayfalı okunuyorlar. Yorumdaki customer.name da bir kopya; yorumu gösterirken müşteriyi okumamak için.
Tartışmaya açık bir karar stok. stock.onHand kitabın içinde; avantajı, 3. yazıdaki koşullu $inc'in tek document üzerinde atomik çalışması ve kitap sayfasının stok durumunu ek bir okuma olmadan göstermesi. Bedeli, en sık okunan document'in aynı zamanda sık yazılan bir alan taşıması: her satış kitabı yeniden yazdırır ve kitabı cache'leyen katmanların sık sık invalidation yapması gerekir (ayrıntısı Caching serisinin cache invalidation stratejilerini anlatan yazısında). Bookstore'un tek deposu ve makul bir satış hızı varken bu bedel küçük. Birden çok depo, rezervasyon ve depo hareketleri gelince stok, Bookstore'un Inventory module'üne ait ayrı bir inventory collection'ına taşınmalı; bu, modelin workload'la birlikte değişmesine iyi bir örnek.
Kopyanın Maliyeti ve Kabul Edilebilir Bayatlık
Embed ve extended reference kopya üretir; her kopya için iki soruyu cevaplamak gerekir: source of truth nerede ve kaynak değişince kopyaya ne olacak? Bir kategorinin adı değişince kaç kitabın güncellenmesi gerektiğine ve sipariş kaleminin kitaptaki fiyat değişikliğine nasıl davrandığına bakalım:
// 04 - kopyalanan alanlar: kategori adı değişince kaç document etkilenir?
const r = db.books.updateMany(
    { "category.categoryId": 3 },
    { $set: { "category.name": "Sci-Fi" } }
);
print("category rename:", r.matchedCount, "books");
db.categories.updateOne({ _id: 3 }, { $set: { name: "Sci-Fi" } });

// Sipariş kalemindeki fiyat bir snapshot: kitabın fiyatını izlemez
const oldPrice = db.books.findOne({ _id: 47 }).listPrice;
db.books.updateOne({ _id: 47 }, { $set: { listPrice: Decimal128("320.00") } });
print("book 47 listPrice:", db.books.findOne({ _id: 47 }).listPrice,
      " order 1 item unitPrice:", db.orders.findOne({ _id: 1 }).items[0].unitPrice);
db.books.updateOne({ _id: 47 }, { $set: { listPrice: oldPrice } });
category rename: 9 books
book 47 listPrice: Decimal128('320.00') order 1 item unitPrice: Decimal128('290.90')Kategori adı değişikliği 9 kitaba dokundu ve bu, kategorinin kendisini güncellemekten ayrı bir işlem; arada kısa bir süre kategori sayfası yeni adı, kitap kartları eski adı gösterebilir. Kategori adları yılda birkaç kez değişiyor, kitaplar ise saniyede yüzlerce kez okunuyor, bu yüzden takas açıkça okumanın lehine. Sipariş kalemi ise kitaptaki fiyat değişikliğinden etkilenmedi ve etkilenmemeli: sipariş 1, 290,90 TL'ye satıldı. Kopyaları bu açıdan üç gruba ayırmak işe yarıyor:
| Kopya | Source of truth | Kaynak değişince |
|---|---|---|
books.authors.name, books.category.name | authors, categories | Hemen updateMany; kısa süreli tutarsızlık kabul |
reviews.customer.name | customers | Arka planda güncelle ya da hiç güncelleme; iş kararı |
orders.items.title, unitPrice, orders.customer.name | Satış anı | Asla güncelleme; bu bir snapshot |
Hangi alanın kopyalanacağına karar verirken kural basit: sık okunan, nadiren değişen ve küçük alanlar iyi aday; sık değişen alanların kopyası her değişiklikte çok sayıda document'e yazma demek. Arka planda güncelleme için change stream'le kaynak collection'ı dinlemek 10. yazıda. İlişkisel taraftaki karşılığı, yani denormalization'ın tutarlılığını kimin koruduğu sorusu Data Modeling ve Normalizasyon serisinin "Denormalization: Ne Zaman, Nasıl ve Tutarlılığı Kim Korur?" yazısında.
Aggregate Sınırı ve Tek Document Atomikliği
MongoDB'de tek bir document'e yazma, document içindeki kaç alanı ya da kaç alt document'i değiştirirse değiştirsin, atomiktir. Bu, modeli kurarken elindeki en güçlü araç: birlikte tutarlı kalması gereken veriyi tek document'e koyarsan transaction'a ihtiyacın kalmaz. Bekleyen sipariş 379'un ödemesini kaydedelim; ödeme eklenmesi ve durumun Paid olması ya birlikte olmalı ya hiç:
// 04 - tek document atomikliği: ödeme ve durum aynı anda değişir
db.orders.updateOne({ _id: 379 }, { $set: { status: "Pending", payments: [] } });

for (let attempt = 1; attempt <= 2; attempt++) {
    const r = db.orders.updateOne(
        { _id: 379, status: "Pending" },
        {
            $set: { status: "Paid" },
            $push: { payments: { method: "card", amount: Decimal128("440.00"), paidAt: ISODate("2026-06-30T08:12:00Z") } }
        }
    );
    print(`attempt ${attempt}: matched ${r.matchedCount}, modified ${r.modifiedCount}`);
}
printjson(db.orders.findOne({ _id: 379 }, { _id: 0, status: 1, total: 1, payments: 1 }));
attempt 1: matched 1, modified 1
attempt 2: matched 0, modified 0
{
status: 'Paid',
total: Decimal128('440.00'),
payments: [
{
method: 'card',
amount: Decimal128('440.00'),
paidAt: ISODate('2026-06-30T08:12:00.000Z')
}
]
}İlk deneme ödemeyi ekledi ve durumu değiştirdi. Ödeme sağlayıcısından aynı bildirim ikinci kez geldiğinde filtredeki status: "Pending" eşleşmedi; ödeme iki kez eklenmedi. Durum ve ödeme aynı document'te olduğu için "ödeme eklendi ama durum değişmedi" gibi bir ara hâl hiçbir okuyucuya görünmez. Domain-Driven Design serisinin "Aggregate Tasarımı: Consistency Boundary, Küçük Aggregate'ler ve Id ile Referans" yazısındaki aggregate tanımı burada doğrudan karşılığını buluyor: aggregate birlikte tutarlı kalması gereken sınır, document de MongoDB'nin atomik yazma birimi. İyi bir document modelinde ikisi çoğunlukla örtüşür; sipariş bir aggregate ve bir document.
Sınırın dışında kalan iş de belli: bir sipariş birden çok kitabın stoğunu düşürüyor ve her kitap ayrı bir document. Burada iki yol var. Birincisi multi-document transaction; replica set'te çalışıyor ve 10. yazıda .NET'ten kullanacağız, ama tek document yazmasından pahalı ve kısa tutulması gerekiyor. İkincisi stoğu siparişten ayrı bir adım olarak düşünmek: sipariş Pending olarak yazılır, her kitap için koşullu $inc ile rezervasyon yapılır, biri başarısız olursa yapılanlar geri alınır ve sipariş iptal edilir. Bu, mikroservislerde saga diye bilinen yaklaşımın tek veritabanındaki hâli. Hangisi seçilirse seçilsin, "her şeyi tek document'e koyalım" diye bütün kitapları siparişin içine gömmek çözüm değil; aggregate'i büyütmek eşzamanlılığı ve document boyutunu bozar.
Üretimde Dikkat
Access pattern listesini modelle birlikte sakla. Gömme ve kopyalama kararlarının her biri bir satıra dayanıyor; ekip yeni bir ekran ya da rapor istediğinde önce o listeye bakılır. Liste değişince model de değişebilir ve MongoDB'de model değişikliği bir migration işidir (5. yazı).
Büyüyen her array için bir üst sınır yaz. Sınır bir iş kuralından (sepet, en fazla 3 son görüntülenen) gelmiyorsa array'i bir collection'a taşı. Mevcut verinin en büyük document'lerini $bsonSize ile düzenli ölç; 16 MB'a yaklaşmak çok geç bir uyarı, birkaç yüz KB'yi geçen document'ler çoğu zaman bir modelleme hatasının işaretidir.
Kopyalanan her alan için güncelleme yolunu kodla. Yukarıdaki tablonun her satırı ya bir updateMany, ya bir arka plan işi ya da bilinçli bir "asla" kararı. Yazılmamış bir güncelleme yolu, yıllar sonra eski adla görünen kitap kartları demek.
Sık Düşülen Tuzaklar
İlişkisel şemayı birebir collection'lara çevirmek. Siparişleri ve kalemleri SQL'deki gibi ayrı collection'lara koyup sipariş detayını $lookup ile birleştirelim ve sunucunun ne kadar iş yaptığını ölçelim:
const pipeline = [
    { $match: { _id: 1 } },
    { $lookup: { from: "order_items_flat", localField: "_id", foreignField: "orderId", as: "items" } },
    { $lookup: { from: "customers", localField: "customerId", foreignField: "_id", as: "customer" } }
];
orders_flat: 379 order_items_flat: 680
without index on orderId
order_items_flat: docsExamined 680, collectionScans 1
customers: docsExamined 1, collectionScans 0
with index on orderId
order_items_flat: docsExamined 2, collectionScans 0
customers: docsExamined 1, collectionScans 0
embedded order: docsExamined 1orderId üzerinde index yokken tek bir siparişin iki kalemini bulmak için 680 kalemin hepsi tarandı. Index'le bu 2'ye indi, ama sipariş detayı yine üç collection'dan okuma ve bir aggregation pipeline'ı; gömülü modelde ise tek document. Üstelik kalemler ile sipariş ayrı document'lerde olduğu için toplamla tutarlılık artık transaction ister ve MongoDB'de ilişkisel veritabanındaki foreign key ya da JOIN optimizer'ı yok. Her okumada $lookup yapıyorsan ya model yanlış ya da veritabanı seçimi; $lookup'ın doğru yeri raporlar ve seyrek okumalar (7. yazı).
Her şeyi gömmek. Ters yöndeki hata da yaygın: müşteriye bütün siparişlerini, kitaba bütün yorumlarını gömmek. "Önce Tahmin Et" bunun sonunu gösterdi. Bir veriyi gömmeden önce sor: parent olmadan okunuyor mu, kendi başına güncelleniyor mu, sayısının üst sınırı ne? Bu sorulardan birinin cevabı gömmeye karşıysa ayır.
Bugünkü veriye göre modellemek. Lab'da bir kitabın en fazla 9 yorumu var ve bu sayıya bakan biri gömmeyi güvenli bulabilir. Model, verinin bugünkü değil olası büyüklüğüne göre kurulur; bir kampanya, bir viral kitap ya da bir bot saldırısı sayıları bir gecede değiştirir.
Küçük Bir Deneme
★☆☆ 04-sizes.js'e authors ve categories collection'larını ekle. Bir kitabın yazar özetini gömmek yerine her seferinde authors'tan okumanın, katalog listesinde 20 kitap için kaç ek okuma demek olduğunu hesapla.
★★☆ Bir yazarın adını (örneğin Frank Herbert'i "Frank P. Herbert" olarak) hem authors'ta hem de kitaplardaki kopyalarda güncelleyen bir script yaz. arrayFilters kullan ve matchedCount ile modifiedCount'u yazdır. Script iki kez çalışınca ne değişiyor?
★★★ Stoğu inventory adında ayrı bir collection'a taşıyan bir tasarım çiz: document'in _id'si ne olmalı, depo eklenince yapı nasıl değişir, kitap sayfası stok durumunu nasıl gösterir? Sipariş verirken iki kitabın stoğunu düşüren akışı hem transaction'la hem de koşullu $inc ve geri alma adımlarıyla yaz, iki yaklaşımın hata durumundaki davranışını karşılaştır.
Bu yazıda neyi gömüp neye referans vereceğimize karar verdik. Bir sonraki yazıda bu kararların üstüne MongoDB'nin schema pattern'lerini koyuyoruz: kitapta hesaplanmış yorum özeti, son yorumların alt kümesi, saatlik görüntülenme bucket'ları, basılı, e-kitap ve sesli kitabın tek collection'da tutulması, schema validation ve şemanın zaman içinde evrimi.