

Full-Text Search Nedir? Inverted Index, Relevance ve Elasticsearch'ün Yeri

Full-text search metni önceden kelimelere ayırıp her kelimenin geçtiği document'ları bir inverted index'te tutar; bu yüzden LIKE '%…%' gibi tabloyu taramaz, ekleri ve büyük/küçük harfi analyzer'la ele alır ve sonuçları BM25 ile sıralar. Gerçek çıktılarla 200 bin satırda LIKE'ın Index Scan'i ve Türkçe karakter sorunları, C#'ta oyuncak inverted index ve Elasticsearch _explain ile birebir aynı BM25 skoru, standard analyzer'ın Türkçe'deki eksikleri, shard/replica kavramları ve lisans geçmişi.
Sürüm notu: Bu yazıdaki örnekler Elasticsearch 9.5.6 (Lucene 10.5.2, resmî docker.elastic.co/elasticsearch/elasticsearch:9.5.6 image'ı), SQL Server 2025 ve .NET 10 ile çalıştırılmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) kataloğunu SQL Server'da tutuyor. dbo.Books tablosunda 200.036 kitap var: 36'sı elle hazırladığımız gerçek klasikler (İnce Memed, Kürk Mantolu Madonna, Çalıkuşu, Dune, Emma…), gerisi deterministik üretilmiş İngilizce demo başlıklar. Title kolonunda bir nonclustered index var, kolonun collation'ı Latin1_General_100_CI_AS. Arama kutusunun arkasında bugün şu sorgular çalışıyor:
SET STATISTICS IO ON;

SELECT BookId, Title FROM dbo.Books WHERE Title LIKE N'İnce%';           -- 1
SELECT BookId, Title FROM dbo.Books WHERE Title LIKE N'ince%';           -- 2
SELECT BookId, Title FROM dbo.Books WHERE Title LIKE N'%memed%';         -- 3
SELECT BookId, Title FROM dbo.Books WHERE Title LIKE N'%kurk mantolu%';  -- 4
SELECT BookId, Title FROM dbo.Books WHERE Title LIKE N'%memed ince%';    -- 5
SELECT BookId, Title FROM dbo.Books WHERE Description LIKE N'%öğretmenler%'; -- 6
Hangileri İnce Memed'i ya da Kürk Mantolu Madonna'yı bulur? Hangisi index'ten birkaç sayfa okuyup biter, hangisi tablonun tamamını dolaşır? Çalıkuşu'nun açıklamasında "öğretmen olarak" geçiyor; altıncı sorgu onu bulur mu? Cevaplara bakmadan bir tahmin yap.
LIKE Neden Yetmiyor?
Script repo'da sql/01-like.sql; tabloyu dotnet run --project src/Bookstore.SearchLab -- seed-sql dolduruyor (bağlantı dizesini BOOKSTORE_SQL ortam değişkeninden okuyor; boş bir veritabanı yeterli, tabloları sql/schema.sql ile kendisi oluşturuyor). Çıktıyı kısalttım; STATISTICS IO satırlarında sıfır olan sayaçları attım:
--- 1: prefix
1 İnce Memed
2 İnce Memed 2
Table 'Books'. Scan count 1, logical reads 3, read-ahead reads 0 ...
--- 2: prefix, lowercase
Table 'Books'. Scan count 1, logical reads 3, read-ahead reads 0 ...
--- 3: contains
1 İnce Memed
2 İnce Memed 2
Table 'Books'. Scan count 1, logical reads 2229, read-ahead reads 0 ...
--- 4: without Turkish characters
Table 'Books'. Scan count 1, logical reads 2229, read-ahead reads 0 ...
--- 5: words in a different order
Table 'Books'. Scan count 1, logical reads 2229, read-ahead reads 0 ...
--- 6: a different word form
Table 'Books'. Scan count 1, logical reads 5656, read-ahead reads 0 ...
Altı sorgudan yalnız ikisi bir şey buldu. Birinci sorgu 3 logical read ile bitti, çünkü LIKE N'İnce%' bir aralık sorgusuna çevrilebiliyor. SHOWPLAN_TEXT bunu açıkça gösteriyor:
|--Index Seek(OBJECT:([esseries_01].[dbo].[Books].[IX_Books_Title]), SEEK:([esseries_01].[dbo].[Books].[Title] >= N'İnce' AND [esseries_01].[dbo].[Books].[Title] < N'İncF'),  WHERE:([esseries_01].[dbo].[Books].[Title] like N'İnce%') ORDERED FORWARD)
|--Index Scan(OBJECT:([esseries_01].[dbo].[Books].[IX_Books_Title]),  WHERE:([esseries_01].[dbo].[Books].[Title] like N'%memed%'))
Baştaki % bu aralığı yok ediyor. B-tree index sıralı bir liste; "içinde memed geçen" değerler listenin her yerine dağılmış olabilir, bu yüzden SQL Server index'in 2.229 sayfasının hepsini okuyup her satırda karakter karşılaştırması yapıyor. Açıklama kolonunda index yok; altıncı sorgu tablonun kendisini, 5.656 sayfayı taradı. 200 bin satırda bu milisaniyeler sürer, ama maliyet satır sayısıyla doğrusal büyür ve aynı anda gelen her arama isteği aynı taramayı tekrar yapar.
Performanstan daha önemli olan, bulunamayan kitaplar:
- İkinci sorgu:
Latin1_General_100_CI_ASbüyük/küçük harfe duyarsız ama "İ" ile "i" bu collation'da büyük/küçük harf çifti değil. Aynı sorguCOLLATE Turkish_100_CI_ASile 2 satır buluyor. - Dördüncü sorgu: kullanıcı "kürk" yerine "kurk" yazdı. Aksana duyarsız
Latin1_General_100_CI_AIbunu bulur (1 satır),Turkish_100_CI_AIbulmaz (0 satır), çünkü Türkçe'de ü ile u ayrı harf, aksan farkı değil. - Beşinci sorgu: kelimeler doğru, sırası farklı.
LIKEkarakter dizisine bakar, kelimeye değil. - Altıncı sorgu: metinde "öğretmen", aramada "öğretmenler" var.
LIKEekleri bilmez; metin aramadaki kelimeyi içermiyorsa sonuç yok.
Bir de hiç görmediğimiz sorun var: LIKE bulduğu satırları sıralamaz. "memed" araması için İnce Memed ile İnce Memed 2'nin hangisi daha alakalı? LIKE için bu soru yok; ya eşleşir ya eşleşmez. SQL Temelleri serisinin "NULL ve Predicate'ler: Üç Değerli Mantık, LIKE, IN, BETWEEN ve COALESCE" yazısı LIKE'ın kurallarını ayrıntılı anlatıyor; burada önemli olan, bu kuralların kelime aramak için tasarlanmamış olması.
Inverted Index: Kelimeden Document'a
Full-text search bu sorunları veriyi baştan farklı saklayarak çözer. Satırdan kelimeye gitmek yerine kelimeden satıra gider: her kelime (term) için o kelimenin geçtiği document'ların listesini tutar. Bu listeye posting list, yapının tamamına inverted index denir. Fikri görmek için Lucene'in yaptığının en sade hâlini C#'ta yazdım:
// term -> (document id -> terimin o document'taki geçiş sayısı)
SortedDictionary<string, SortedDictionary<int, int>> postings = new(StringComparer.Ordinal);
Dictionary<int, int> lengths = [];

foreach ((int docId, string title) in Titles)
{
    List<string> terms = Tokenize(title);
    lengths[docId] = terms.Count;
    foreach (string term in terms)
    {
        if (!postings.TryGetValue(term, out SortedDictionary<int, int>? docs))
        {
            docs = [];
            postings[term] = docs;
        }
        docs[docId] = docs.GetValueOrDefault(docId) + 1;
    }
}

// Türkçe kurallarıyla küçük harfe çevir, harf ya da rakam olmayan her yerden böl
private static List<string> Tokenize(string text)
{
    List<string> terms = [];
    StringBuilder current = new();
    foreach (char c in text.ToLower(Turkish))
    {
        if (char.IsLetterOrDigit(c))
        {
            current.Append(c);
        }
        else if (current.Length > 0)
        {
            terms.Add(current.ToString());
            current.Clear();
        }
    }
    if (current.Length > 0)
    {
        terms.Add(current.ToString());
    }
    return terms;
}
dotnet run --project src/Bookstore.SearchLab -- inverted-index memed üç başlıktan şu index'i kuruyor:
Documents:
  1: İnce Memed (length 2)
  2: İnce Memed 2 (length 3)
  3: Kürk Mantolu Madonna (length 3)
Inverted index (term -> posting list):
  2        -> [2]
  ince     -> [1, 2]
  kürk     -> [3]
  madonna  -> [3]
  mantolu  -> [3]
  memed    -> [1, 2]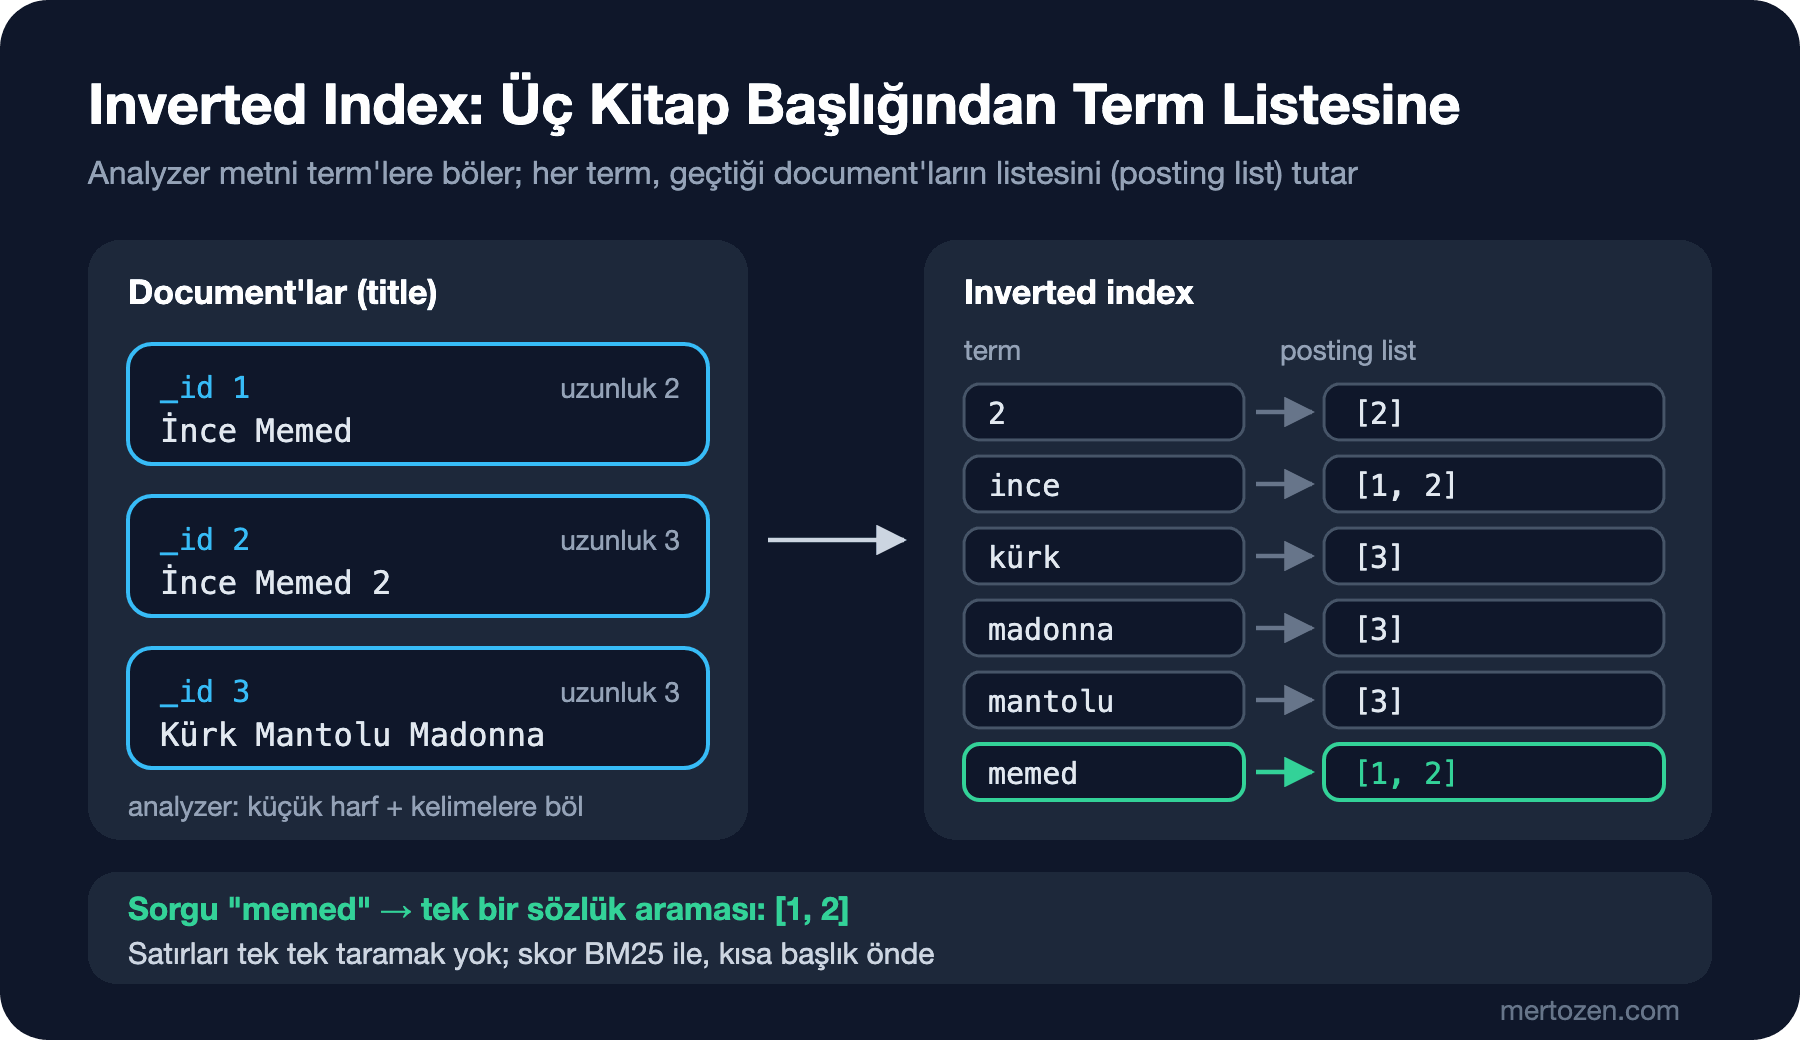
Artık "memed" araması bir sözlük araması: memed anahtarına git, [1, 2] listesini al. Kaç milyon document olursa olsun satırları tek tek dolaşmıyoruz. "memed ince" gibi çok kelimeli bir arama, iki listenin kesişimi ya da birleşimi demek; kelime sırası önemli değilse sorun da yok. Büyük/küçük harf, ekler ve Türkçe karakter ise index'e yazmadan önce metni nasıl işlediğimize bağlı: bu örnekte ToLower(tr-TR) kullandığım için "İnce" ile "ince" aynı term oldu. Bu işleme analysis, onu yapan bileşene analyzer deniyor. Elasticsearch'teki analyzer'lar tokenizer ve filter zincirlerinden oluşuyor; Türkçe için bunları 4. yazıda ayrıntılı kuruyoruz.
Gerçek inverted index bu sözlükten çok daha fazlasını saklıyor: her term'in document içindeki pozisyonları (phrase araması için), sıkıştırılmış posting list'ler, alan uzunlukları. Ama temel fikir bu kadar.
Relevance ve BM25: Hangi Sonuç Önce?
Inverted index hangi document'ların eşleştiğini söylüyor. Kullanıcı ise ilk sayfaya bakıyor; asıl soru hangisinin önce geleceği. Buna relevance (alaka düzeyi) deniyor ve Elasticsearch varsayılan olarak BM25 (Best Matching 25; bir term'in document'ta ne sıklıkta geçtiğine, koleksiyonda ne kadar nadir olduğuna ve alanın uzunluğuna bakan skor fonksiyonu) kullanıyor. Formülü ezberlemeye gerek yok, üç sezgi yeterli:
Nadir term daha değerli: her kitapta geçen bir kelime ayırt edici değildir. Bu kısma idf (inverse document frequency; term ne kadar az document'ta geçiyorsa o kadar yüksek) deniyor.
Tekrar fayda sağlar ama doyar: bir kelimenin üç kez geçmesi bir kez geçmesinden iyidir, otuz kez geçmesi ise on kat iyi değildir. Doyma hızını k1 parametresi belirliyor.
Kısa alanda eşleşme daha anlamlı: iki kelimelik bir başlıkta "memed" geçmesi, uzun bir başlıkta geçmesinden daha güçlü bir sinyal. Bunun ağırlığı b parametresinde.
Oyuncak index'imiz BM25'i Lucene'in formülüyle, k1 = 1.2 ve b = 0.75 ile hesaplıyor:
Query term 'memed': in 2 of 3 documents, idf = 0.4700
  doc 1: freq 1, length 2, avg length 2.6667, tf part 0.5063, score 0.5235
  doc 2: freq 1, length 3, avg length 2.6667, tf part 0.4324, score 0.4471
Ranking for "memed":
  0.5235  İnce Memed
  0.4471  İnce Memed 2
Aynı üç başlığı Elasticsearch'e koyup gerçek skoru soralım. Önce tek seferlik bir container açıyoruz; security'yi yalnız bu ilk yazıda, sadece kendi makinende ve 127.0.0.1'e bağlı olarak kapatıyoruz. 2. yazıda security açık, kalıcı bir lab kuracağız:
docker run -d --name bookstore-es -p 127.0.0.1:9200:9200 -e discovery.type=single-node -e xpack.security.enabled=false -e node.name=bookstore-es -e ES_JAVA_OPTS="-Xms512m -Xmx512m" docker.elastic.co/elasticsearch/elasticsearch:9.5.6İstekleri Kibana Dev Tools biçiminde yazıyorum (method, path, altında JSON gövde). Kibana'yı 2. yazıda kuruyoruz; şimdilik aynı istekleri curl ile gönderebilirsin, ör. curl -s -H "Content-Type: application/json" "localhost:9200/title-demo/_search?pretty" -d '{"query":{"match":{"title":"memed"}}}'. Windows'ta PowerShell 7 ile curl.exe yaz; Windows PowerShell 5.1 gövdedeki tırnakları bozuyor.
PUT /title-demo
{ "settings": { "number_of_replicas": 0 }, "mappings": { "properties": { "title": { "type": "text" } } } }

PUT /title-demo/_doc/1
{ "title": "İnce Memed" }

PUT /title-demo/_doc/2
{ "title": "İnce Memed 2" }

PUT /title-demo/_doc/3?refresh=true
{ "title": "Kürk Mantolu Madonna" }

GET /title-demo/_explain/1
{ "query": { "match": { "title": "memed" } } }
_explain çıktısının özü:
"value" : 0.52354836,
"description" : "score(freq=1.0), computed as boost * idf * tf from:",
  "value" : 2.2,         "description" : "boost"
  "value" : 0.47000363,  "description" : "idf, computed as log(1 + (N - n + 0.5) / (n + 0.5)) from:"
      "value" : 2,       "description" : "n, number of documents containing term"
      "value" : 3,       "description" : "N, total number of documents with field"
  "value" : 0.50632906,  "description" : "tf, computed as freq / (freq + k1 * (1 - b + b * dl / avgdl)) from:"
      "value" : 1.0,     "description" : "freq, occurrences of term within document"
      "value" : 1.2,     "description" : "k1, term saturation parameter"
      "value" : 0.75,    "description" : "b, length normalization parameter"
      "value" : 2.0,     "description" : "dl, length of field"
      "value" : 2.6666667, "description" : "avgdl, average length of field"
Rakamlar bizim hesapla birebir aynı: 2.2 × 0.4700 × 0.5063 = 0.5235. Buradaki 2.2'lik boost k1 + 1; Elasticsearch skorları eski sürümlerle karşılaştırılabilir tutmak için bu çarpanı koruyor. "kürk memed" araması ise Kürk Mantolu Madonna'yı 0.9331 ile en üste koyuyor: "kürk" tek document'ta geçtiği için idf'i 0.9808, "memed"inki 0.4700. Kullanıcı iki kelime yazdı, nadir olan kelime sıralamayı belirledi.
Relevance'ı konuşurken iki ölçü sık geçer. Precision, getirdiğin sonuçların ne kadarının gerçekten ilgili olduğu; recall, ilgili olanların ne kadarını getirebildiğin. LIKE ile ikisini birlikte ayarlayamazsın: %kelime% recall'u artırır ama "kelime"yi başka kelimelerin içinde de bulup precision'ı düşürür. Full-text search'te ikisi ayrı araçlarla ayarlanır: recall'u analyzer (ekler, eş anlamlılar, Türkçe karakter), precision'ı sorgu tipi ve skor (operator, phrase, boost) belirler.
Elasticsearch de Analyzer Kadar İyi
Elasticsearch'e geçmek tek başına çözüm değil. 36 kitabı books index'ine, hiçbir mapping vermeden yükleyelim (dosya repo'da data/books.ndjson, Bulk API biçiminde):
curl -s -H "Content-Type: application/x-ndjson" -X POST "localhost:9200/books/_bulk?refresh=true" --data-binary "@data/books.ndjson"Mapping vermediğimiz için Elasticsearch metin alanlarına standard analyzer atadı (bunun ayrıntısı 3. yazıda). Birkaç arama:
GET /books/_search
{ "query": { "match": { "description": "memed" } } }
→ hits.total.value: 0

GET /books/_search
{ "query": { "match": { "description": "öğretmen" } } }
→ 1 hit: Çalıkuşu (3.4578454)

GET /books/_search
{ "query": { "match": { "description": "öğretmenler" } } }
→ hits.total.value: 0
İlk arama boş döndü, oysa İnce Memed'in açıklaması "Memed'in Çukurova'da…" diye başlıyor. Sebebi _analyze ile görülüyor:
POST /_analyze
{ "analyzer": "standard", "text": "Memed'in Çukurova'da ağalara karşı başkaldırısını" }

memed'in | çukurova'da | ağalara | karşı | başkaldırısını
standard analyzer kesme işaretini kelimenin parçası sayıyor; index'te memed diye bir term yok, memed'in var. "öğretmenler" de aynı sebeple boş: analyzer kelimeyi köküne indirmiyor. Recall'u sayıyla görelim. Açıklamasında "roman" kökü geçen 9 kitap var, ama match "roman" yalnız 6'sını buluyor; "aşkın romanı", "öncü romanı" ve "distopya romanı" diye biten üçü dışarıda. Recall 6/9. Precision tarafında ise ters bir örnek: başlıkta "the hobbit" araması 3 sonuç getiriyor (The Hobbit 5.65, Hobbit 3.49, The Lord of the Rings 2.76), çünkü match varsayılan olarak kelimeleri OR ile bağlıyor. "operator": "and" ile tek sonuç kalıyor. Sıralama zaten doğru kitabı üste koydu; precision'ı ne kadar sıkacağın bir ürün kararı.
Yani Elasticsearch, LIKE'ın yapamadığını yapabilecek araçları veriyor; ama Türkçe metinde bu araçları senin seçmen gerekiyor. 4. yazıda turkish analyzer'ın kesme işaretini nasıl attığını, "öğretmenler"i nasıl "öğretmen"e indirdiğini ve nerede fazla kestiğini göreceğiz.
Elasticsearch'ün Yeri: Lucene, Index, Shard, Replica, Node
Elasticsearch, inverted index'i yazan ve sorgulayan Java kütüphanesi Lucene'in üzerine kurulmuş, dağıtık çalışan, REST (HTTP üzerinden JSON ile konuşulan API tarzı) arayüzlü bir arama motoru. Lucene tek bir dizindeki index'i yönetir; Elasticsearch bunun üzerine birden çok makineye dağıtmayı, kopyalamayı, JSON API'yi, güvenliği ve aggregation'ları ekler. Temel kavramlar:
- Document: index'lenen JSON kaydı; bizde bir kitap. Her document'ın bir
_id'si var; biz ISBN'i (International Standard Book Number; kitabın uluslararası standart numarası) kullandık. - Index: aynı türden document'ların toplandığı yer; SQL Server'daki tablo ile veritabanı arasında bir kavram. Alan tiplerini mapping tanımlar.
- Shard: index'in parçası; her shard kendi başına bir Lucene index'i. Elasticsearch 7'den beri yeni bir index varsayılan olarak 1 primary shard ile açılıyor.
- Replica: primary shard'ın kopyası; hem node kaybına karşı koruma hem okuma kapasitesi. Varsayılan 1 replica.
- Node ve cluster: her Elasticsearch process'i bir node; birlikte çalışan node'lar cluster'ı oluşturur.
GET /_cat/shards/books?v&h=index,shard,prirep,state,docs,node

index shard prirep state      docs node
books 0     p      STARTED      36 bookstore-es
books 0     r      UNASSIGNED
Tek node'da replica atanamıyor: bir shard'ın kopyasını aynı node'a koymak koruma sağlamaz, Elasticsearch de bunu yapmıyor. Bu yüzden index'in sağlık durumu yellow. Hata değil; 2. yazıda cluster health'i okurken buna döneceğiz. Bir de near-real-time kavramı var: yazdığın document bir sonraki refresh'e (varsayılan saniyede bir, index'e son 30 saniyede arama gelmişse) kadar aramada görünmez. Yukarıda ?refresh=true kullanmamın sebebi bu; bedelini 5. yazıda konuşuyoruz.
Lisans, OpenSearch ve Bugünkü Durum
Elasticsearch'ü seçerken lisans geçmişini bilmek gerekiyor, çünkü managed servis seçenekleri buradan ayrıştı:
7.10'a kadar çekirdek kod Apache 2.0 lisanslıydı. Ocak 2021'de Elastic, 7.11'den itibaren kodu SSPL (Server Side Public License; yazılımı servis olarak sunanların servisin kodunu da açmasını şart koşan lisans) ve Elastic License ile çift lisansa geçirdi.
AWS (Amazon Web Services; Amazon'un bulut platformu için kullanılan kısaltma) buna Nisan 2021'de 7.10.2'den çatallanan, Apache 2.0 lisanslı OpenSearch ile cevap verdi. Eylül 2024'te proje Linux Foundation altındaki OpenSearch Software Foundation'a devredildi. Docker Hub'daki son sürüm 3.9.0.
Ağustos 2024'ün sonunda Elastic, kaynak koda üçüncü seçenek olarak AGPLv3'ü (GNU Affero General Public License; açık kaynak kabul edilen, ağ üzerinden sunulan değiştirilmiş sürümün kodunun paylaşılmasını isteyen açık kaynak lisans) ekledi. Bugün kaynak kod AGPLv3, SSPL ve ELv2 (Elastic License 2.0; Elastic'in kendi lisansı, yazılımı başkalarına managed servis olarak satmayı yasaklıyor) arasından seçilerek kullanılabiliyor; Elastic'in dağıttığı hazır binary'ler ve Docker image'ları ise ELv2 ile geliyor.
Pratikte bir .NET ekibi için karar şuna iniyor: Bookstore'u kendi sunucunda ya da Kubernetes'te işletiyorsan resmî image'ı ELv2 ile kullanmak bir uygulamanın backend'i için genelde sorun değil; ELv2'nin yasakladığı şey, Elasticsearch'ü başkalarına managed servis olarak satmak. Hukuk ekibin yalnız OSI (Open Source Initiative; açık kaynak lisanslarını onaylayan kuruluş) onaylı lisans kabul ediyorsa AGPLv3 ya da OpenSearch'e bakarsın. Bulut tarafında Elastic Cloud (AWS, Azure ve Google Cloud üzerinde) Elasticsearch'ü, Amazon OpenSearch Service ise OpenSearch'ü işletiyor. Bu seri Elasticsearch 9.x ile ilerliyor; OpenSearch'ün ayrıştığı noktaları yeri geldikçe not edip 13. yazıda topluca karşılaştırıyoruz.
Ne Zaman Elasticsearch Gerekmez?
Elasticsearch ikinci bir veri deposu demek: ayrı bir cluster, senkronize tutulması gereken bir kopya, izlenecek bir JVM (Java Virtual Machine; Elasticsearch'ün üzerinde çalıştığı Java çalışma ortamı). Katalog küçükse ve arama ürünün merkezinde değilse daha az parça yeterli olabilir:
SQL Server Full-Text Search: ayrı kurulan bir bileşen; tablo başına bir full-text index, CONTAINS/FREETEXT ve CONTAINSTABLE ile skor. Veri zaten SQL Server'da olduğu için senkronizasyon derdi yok. Bu yazıdaki SQL Server container'ında kurulu olmadığı için burada denemedim.
PostgreSQL: PostgreSQL serisinin "PostgreSQL Full-Text Search: tsvector, tsquery, Türkçe Configuration, unaccent ve pg_trgm" yazısı Türkçe stemming'i, unaccent ile Türkçe karaktersiz aramayı ve pg_trgm ile yazım hatası toleransını gerçek çıktılarla anlatıyor.
MongoDB: MongoDB serisinin "MongoDB Index'leri: Compound Index ve ESR Kuralı, Multikey, Partial, TTL, Collation ve explain" yazısı text index'i ve MongoDB Search'ü anlatıyor.
Redis: Redis serisinin "Redis JSON ve Query Engine: JSON Document'lar, FT.CREATE, FT.SEARCH, FT.AGGREGATE ve NRedisStack" yazısı bellekte tutulan, hızlı ama sınırlı bir arama seçeneği gösteriyor.
Elasticsearch'e geçme sinyalleri ise genelde bir arada geliyor: relevance'ı ayarlamak (başlık açıklamadan önemli, çok satan önde), Türkçe ve İngilizce için ayrı analyzer'lar, eş anlamlılar, yazım hatası toleransı, autocomplete, facet'li filtreler (kategori, fiyat aralığı, dil) ve büyüyen veri. Bookstore'un "kitap ara" sayfası bunların hepsini istiyor; seri boyunca o sayfanın backend'ini kuruyoruz. Vector search, semantic_text ve hybrid search ise RAG (Retrieval-Augmented Generation; modelin cevabını aranıp bulunan belgelerle besleme) serisinin "Vector Database Seçimi: pgvector, SQL Server 2025, Qdrant, Azure AI Search ve Elasticsearch" ve "Hybrid Search ve Reciprocal Rank Fusion: Keyword ile Vector Aramayı Birleştirmek" yazılarının konusu.
Üretimde Dikkat
Elasticsearch'ü eklemek verinin asıl kaydının yerini değiştirmiyor. Kitabın fiyatı, stoğu, adı SQL Server'da; Elasticsearch bunların aranabilir bir kopyası. Kopyanın ne kadar gecikmeyle güncellendiği (refresh ve senkronizasyon), kopya bozulursa nasıl baştan kurulacağı (reindex) ve iki taraf ayrıştığında hangisine güvenileceği ilk günden tasarlanmalı. 5. yazı bu senkronizasyonu, 11. yazı alias ile kesintisiz reindex'i anlatıyor.
Ölçerken doğru şeyi ölç. LIKE ile karşılaştırırken yalnız süreye bakma; bu yazıdaki SQL Server sayıları sıralı logical read sayıları, süre değil. Aramada asıl kalite ölçüsü relevance: gerçek kullanıcı aramalarından küçük bir "sorgu → beklenen ilk sonuçlar" seti çıkar ve her değişiklikte o seti çalıştır. Bunun Elasticsearch'teki karşılığı olan _rank_eval API'sini 7. yazıda kullanıyoruz.
Son olarak, açık bir Elasticsearch internete bağlıysa birkaç saatte bulunur. Bu yazıdaki security'si kapalı container yalnız 127.0.0.1'e bağlı ve yalnız denemelik; production ayarları (TLS, API key, rol) 2. ve 12. yazılarda.
Sık Düşülen Tuzaklar
Baştaki %'yi bir index ile hızlandırmaya çalışmak. B-tree index sıralı değerler için; "içinde geçen" araması için ya full-text index ya da başka bir yapı gerekir.
Elasticsearch'e geçince Türkçe aramanın kendiliğinden düzeleceğini sanmak. Varsayılan standard analyzer "Memed'in"i tek term olarak saklıyor ve ekleri bilmiyor; analyzer seçimi senin işin.
Skoru mutlak bir değer sanmak. BM25 skoru aynı sorgunun sonuçlarını sıralamak için var; farklı sorguların ya da farklı index'lerin skorlarını karşılaştırmak, "skor 2'nin altındaysa gösterme" gibi eşikler koymak genelde yanlış sonuç verir.
Elasticsearch'ü ana veritabanı yapmak. Transaction yok, constraint yok, mapping sonradan değişmiyor; siparişin ve stoğun asıl kaydı SQL Server'da kalmalı.
Lisansı sonradan düşünmek. Managed servis seçimi (Elastic Cloud mu, Amazon OpenSearch Service mi) ve kullanılabilecek özellikler lisansa bağlı; mimari kararla birlikte verilmeli.
Küçük Bir Deneme
★☆☆ inverted-index komutuna "ince memed 2" sorgusunu ver. Hangi document en üste çıkıyor ve neden? Aynı sorguyu title-demo index'inde match ile çalıştırıp skorları karşılaştır.
★★☆ 01-like.sql'deki altıncı sorguyu Description LIKE N'%öğretmen%' olarak değiştir. Çalıkuşu bulunuyor mu, kaç logical read oluyor? Sonra Description kolonuna bir nonclustered index ekleyip tekrar dene: SQL Server index'i oluştururken hangi uyarıyı veriyor, logical read sayısı düşse de sorgu neden hâlâ index'in tamamını okuyor?
★★★ title-demo index'ine "Memed Memed Memed" başlıklı dördüncü bir document ekle ve "memed" aramasını tekrar çalıştır. _explain çıktısında freq, dl, avgdl ve idf nasıl değişti? Aynı document'ı oyuncak index'e ekleyip C# hesabının hâlâ Elasticsearch ile aynı sonucu verdiğini doğrula.
Bir sonraki yazıda bu tek seferlik container'ı bırakıp kalıcı bir lab kuruyoruz: Elastic'in start-local script'i ne yapıyor, security açık bir Elasticsearch ve Kibana'yı Docker Compose ile ayağa kaldırmak, Dev Tools'ta cluster health'i okumak, API key üretmek ve Elastic.Clients.Elasticsearch ile .NET'ten ilk bağlantı.