

Elasticsearch'e Veri Taşımak: Bulk API, Refresh, Versiyonlama ve SQL Server ile Senkronizasyon

Elasticsearch'e veriyi tek tek değil Bulk API ile yazarsın; ama bulk atomik değildir, yazılan document refresh'e kadar aranamaz ve SQL Server ile senkronizasyonda dual write sessizce veri kaybettirir. Gerçek çıktılarla IndexAsync ile bulk farkı, BulkAll ve refresh_interval, satır satır bulk hataları, if_seq_no ve external version, rowversion ile polling yapan bir BackgroundService ve MIN_ACTIVE_ROWVERSION ile açık transaction'ları kaçırmamak.
Sürüm notu: Bu yazıdaki örnekler Elasticsearch 9.5.6, SQL Server 2025, .NET 10, Elastic.Clients.Elasticsearch 9.5.3 ve Microsoft.Data.SqlClient 7.1.2 ile, 2. yazıda kurduğumuz lab'da çalıştırılmıştır. Süre ölçümleri tek bir geliştirme makinesinde, tek node'lu lab'da alındı; mutlak değer değil, oran olarak oku.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) kataloğunu Elasticsearch'e yüklemenin zamanı geldi. Lab konsolundaki bulk-compare komutu boş bir books-load index'ine aynı üretilmiş kitapları iki yoldan yazıyor:
// 1) Her kitap için ayrı bir istek, 2.000 kitap
foreach (Book book in books.Take(2_000))
{
    IndexResponse response = await client.IndexAsync(book, i => i.Index(LoadIndex));
}

// 2) 1.000'lik paketler hâlinde Bulk API, 20.000 kitap
foreach (Book[] chunk in books.Chunk(1_000))
{
    BulkResponse response = await client.BulkAsync(b => b.Index(LoadIndex).IndexMany(chunk));
}
On kat fazla kitap yazan ikinci yol daha mı uzun sürer? Bir bulk isteğinin içindeki tek bir hatalı document bütün isteği düşürür mü? Ve yazdığın kitabı hemen ardından aradığında bulabilir misin?
Bulk API: Tek İstekte Binlerce İşlem
dotnet run --project src/Bookstore.SearchLab -- create-index books-load --no-data
dotnet run --project src/Bookstore.SearchLab -- bulk-compare

IndexAsync x 2,000: 9,076 ms
BulkAsync 20 x 1,000: 1,226 ms
Tek tek yazmak kitap başına yaklaşık 4,5 ms tuttu, bulk ile 20.000 kitap 1,2 saniyede bitti. Fark Elasticsearch'ün yazma hızından değil, istek başına sabit maliyetten geliyor: HTTP gidiş-dönüşü, kimlik doğrulama, shard'a yönlendirme, translog'a yazma. Bulk API bu maliyeti bin işleme bölüyor. İstek gövdesi NDJSON (newline-delimited JSON; her satırı ayrı bir JSON olan metin): önce işlemi söyleyen bir satır, sonra (gerekiyorsa) document'ın kendisi. İlk yazıda curl ile gönderdiğimiz books.ndjson da bu biçimdeydi:
POST /_bulk
{ "index": { "_index": "books-load", "_id": "9781000000016" } }
{ "isbn": "9781000000016", "title": "İnce Memed", "price": 385.0 }
{ "create": { "_index": "books-load", "_id": "9781000000023" } }
{ "isbn": "9781000000023", "title": "İnce Memed 2", "price": 395.0 }
{ "update": { "_index": "books-load", "_id": "9781000000016" } }
{ "doc": { "price": 370.0 } }
{ "delete": { "_index": "books-load", "_id": "9781000000337" } }
Dört işlem var: index (yoksa oluştur, varsa değiştir), create (yalnız yoksa oluştur), update (kısmi değişiklik) ve delete (gövdesiz). Elasticsearch 9.0 bu satırların ayrıştırılmasını sıkılaştırdı: kapanmayan süslü parantez, işlemden sonra fazladan anahtar ya da kapanan parantezden sonra gelen veri 8.x'te uyarıyla geçiyordu, artık hata. Elle NDJSON üreten script'lerin varsa 9'a geçmeden kontrol et.
Paket boyutu için sabit bir doğru yok. Elastic'in önerisi tek node ve tek shard üzerinde 100 document'la başlayıp verim artmayı bırakana kadar ikiye katlamak, eşitlikte küçük olanı seçmek ve bir isteği birkaç on megabaytın altında tutmak. Kitap gibi küçük document'larda bin ile birkaç bin arası genelde iyi bir başlangıç.
Büyük ilk yüklemede client'ın BulkAll yardımcısı işini kolaylaştırıyor: bir IEnumerable'ı paketlere bölüyor, paketleri paralel gönderiyor ve 429 (Too Many Requests; cluster'ın yetişemediğini söyleyen cevap) alınca bekleyip tekrar deniyor:
BulkAllObservable<Book> bulkAll = client.BulkAll(SyntheticBooks.Generate(count), b => b
    .Index(LoadIndex)
    .Size(2_000)
    .MaxDegreeOfParallelism(2)
    .BackOffRetries(3)
    .BackOffTime(TimeSpan.FromSeconds(2))
    .DroppedDocumentCallback((item, book) => Console.WriteLine($"Dropped {book.Isbn}: {item.Error?.Reason}")));

int pages = 0;
bulkAll.Wait(TimeSpan.FromMinutes(10), response => pages++);
Console.WriteLine($"BulkAll: {count:N0} books in {pages} pages, {watch.ElapsedMilliseconds:N0} ms");
Aynı yüklemeyi iki kez, her seferinde boş bir index'e yaptım; ikincisinde yükleme boyunca refresh'i kapattım:
dotnet run --project src/Bookstore.SearchLab -- bulk-all 100000
BulkAll: 100,000 books in 50 pages, 3,853 ms

PUT /books-load/_settings
{ "index": { "refresh_interval": "-1" } }

dotnet run --project src/Bookstore.SearchLab -- bulk-all 100000
BulkAll: 100,000 books in 50 pages, 3,178 ms

PUT /books-load/_settings
{ "index": { "refresh_interval": null } }
POST /books-load/_refresh
100 bin küçük document'ta fark yüzde 20 civarında; milyonlarca document ve birkaç replica'lı bir cluster'da çok daha büyük olur. Elastic'in ilk yükleme önerisi ikisini birlikte yapmak: yükleme boyunca refresh_interval'ı -1 ve replica sayısını 0 yap, bitince ikisini eski hâline getir. Replica'yı sıfıra çekmek, yükleme sırasında node kaybında verinin gitmesi demek; kaynak veri SQL Server'da durduğu için yüklemeyi tekrarlayabilirsin. null vermek ayarı varsayılana döndürüyor; refresh'i açmayı unutursan yeni kitaplar hiç aramaya düşmez.
Bulk Atomik Değil: Hataları Satır Satır İşlemek
Bir bulk isteğinde her işlem kendi başına başarılı ya da başarısız oluyor; transaction yok. bulk-errors komutu dört işlem gönderiyor: geçerli bir kitap, mapping'de olmayan bir alan içeren bir document (index "dynamic": "strict"), bir create ve aynı _id ile ikinci bir create:
BulkRequest request = new(LoadIndex)
{
    Operations =
    [
        new BulkIndexOperation<Book>(books[0]) { Id = books[0].Isbn },
        // Mapping'de yok ve mapping "dynamic": "strict"
        new BulkIndexOperation<object>(new { isbn = "9789999999991", title = "Draft", pageCount = 412 }) { Id = "9789999999991" },
        new BulkCreateOperation<Book>(books[1]) { Id = books[1].Isbn },
        new BulkCreateOperation<Book>(books[1]) { Id = books[1].Isbn }
    ]
};

BulkResponse response = await client.BulkAsync(request);
Console.WriteLine($"HTTP {response.ApiCallDetails.HttpStatusCode}, IsValidResponse {response.IsValidResponse}, errors {response.Errors}");
foreach (ResponseItem item in response.Items)
{
    Console.WriteLine(item.Error is null
        ? $"  {item.Operation} {item.Id}: {item.Status} {item.Result}"
        : $"  {item.Operation} {item.Id}: {item.Status} {item.Error.Type}: {item.Error.Reason}");
}
HTTP 200, IsValidResponse False, errors True
index 9781000000016: 201 created
index 9789999999991: 400 strict_dynamic_mapping_exception: [1:53] mapping set to strict, dynamic introduction of [pageCount] within [_doc] is not allowed
create 9781000000023: 201 created
create 9781000000023: 409 version_conflict_engine_exception: [9781000000023]: version conflict, document already exists (current version [1])HTTP durumu 200, çünkü istek bir bütün olarak işlendi. İki kitap yazıldı, iki işlem reddedildi. Client errors: true'yu görünce IsValidResponse'u false yapıyor ama hangi işlemin neden düştüğünü Items ya da ItemsWithErrors söylüyor; sırası gönderdiğin işlemlerin sırasıyla aynı. Hataların iki türü var ve ayrı ele alınmalı: 429 gibi geçici hatalar (tekrar dene) ve 400 ya da 409 gibi kalıcı hatalar (tekrar denemek işe yaramaz; logla, bir hata tablosuna ya da dead letter queue'ya koy, kalanlara devam et). BulkAll'ın DroppedDocumentCallback'i tam bu ikinci grup için.
Near-Real-Time: Refresh'in Bedeli
Elasticsearch'te yazılan document önce bellekteki bir buffer'a ve dayanıklılık için translog'a gidiyor. Aranabilir olması için buffer'ın yeni bir Lucene segment'ine dönüşmesi gerekiyor; buna refresh deniyor. refresh komutu:
await client.IndexAsync(book, i => i.Index(LoadIndex));
Console.WriteLine($"After index:              {await CountAsync(client, book.Isbn)} hit(s)");

await Task.Delay(TimeSpan.FromSeconds(2));
Console.WriteLine($"Two seconds later:        {await CountAsync(client, book.Isbn)} hit(s)");

Book second = book with { Isbn = "9789999999977" };
Stopwatch watch = Stopwatch.StartNew();
await client.IndexAsync(second, i => i.Index(LoadIndex).Refresh(Refresh.WaitFor));
Console.WriteLine($"After refresh=wait_for:   {await CountAsync(client, second.Isbn)} hit(s), index call took {watch.ElapsedMilliseconds} ms");
After index: 0 hit(s)
Two seconds later: 1 hit(s)
After refresh=wait_for: 1 hit(s), index call took 532 msTahminin cevabı: hayır, hemen bulamıyorsun. Varsayılan refresh saniyede bir, ama yalnız son 30 saniyede arama almış index'ler için; hiç aranmayan bir index refresh yapmayı bırakıyor (search idle) ve ilk aramada refresh'i tetikliyor. Yazdığını hemen okuman gerekiyorsa üç seçenek var:
refresh=true: o anda refresh yaptırır. Her yazmada yapılırsa çok sayıda küçük segment oluşur, merge yükü artar; toplu yazmalarda en pahalı seçenek.refresh=wait_for: yeni bir refresh zorlamaz, sıradaki refresh'i bekler. Çağrı uzar (burada 532 ms) ama cluster'a ek yük bindirmez.- Hiçbiri: kullanıcı arayüzünde "kaydedildi" mesajını yazma isteğinin cevabından ver, arama sonucundan değil. Arama sonuçları zaten birkaç saniye geride olabilir.
Unutma: 2. yazıda gördüğümüz gibi GET /books/_doc/{id} real-time; tek bir kitabı id'siyle okumak için refresh beklemene gerek yok.
Optimistic Concurrency ve External Version
İki süreç aynı kitabı okuyup değiştirirse ikincisi birincinin değişikliğini ezer. Elasticsearch her document için bir _seq_no ve _primary_term tutuyor; yazarken "okuduğumdan beri değişmediyse yaz" diyebiliyorsun. concurrency komutu iki yazarı taklit ediyor:
// İki yazar da aynı _seq_no'yu okudu ve ikisi de yazmaya çalışıyor
IndexResponse first = await client.IndexAsync(read.Source with { Price = 499.00m }, i => i
    .Index(LoadIndex).IfSeqNo(read.SeqNo!.Value).IfPrimaryTerm(read.PrimaryTerm!.Value));

IndexResponse second = await client.IndexAsync(read.Source with { Price = 450.00m }, i => i
    .Index(LoadIndex).IfSeqNo(read.SeqNo!.Value).IfPrimaryTerm(read.PrimaryTerm!.Value));

// External versioning: version kaynak sistemden geliyor (senkronizasyonda SQL Server rowversion'ı)
IndexResponse v10 = await client.IndexAsync(dune with { Price = 510.00m }, i => i
    .Index(LoadIndex).Id("external-demo").Version(10).VersionType(VersionType.External));
IndexResponse v9 = await client.IndexAsync(dune with { Price = 505.00m }, i => i
    .Index(LoadIndex).Id("external-demo").Version(9).VersionType(VersionType.External));
Read: price 520.0, _seq_no 22004, _primary_term 1
Writer A: 200 Updated, _seq_no 22005
Writer B: 409 version_conflict_engine_exception
[9781000000221]: version conflict, required seqNo [22004], primary term [1]. current document has seqNo [22005] and primary term [1]
External version 10: 201 Created
External version 9: 409 version_conflict_engine_exceptionB'nin yazması 409 ile reddedildi; doğru davranış document'ı yeniden okuyup değişikliği tekrar uygulamak. (_seq_no'nun 22004 olması, bu index'e o ana kadar yapılan bütün yazmaların sayısı; shard başına artan bir sayaç.) İkinci kısım bu yazının asıl konusu için önemli: version_type: external ile version'ı sen veriyorsun ve Elasticsearch yalnız mevcut version'dan büyük olanı kabul ediyor. Version kaynak sistemden gelirse, sıra dışı gelen eski bir değişiklik yenisinin üstüne yazamıyor. SQL Server'ın rowversion'ı tam olarak böyle bir sayı.
SQL Server'dan Elasticsearch'e: Seçenekler
Bookstore'da verinin asıl kaydı SQL Server'da. Bir kitabın fiyatı ya da stoğu değiştiğinde arama index'i de güncellenmeli. Akla ilk gelen yol, kodda SQL Server'a yazdıktan hemen sonra Elasticsearch'e de yazmak (dual write). Sorunu basit: iki yazma tek bir transaction değil. SQL Server commit oldu, Elasticsearch isteği zaman aşımına düştüyse index eski fiyatla kalır; ters sırada yaparsan arama, hiç commit olmamış bir fiyatı gösterir. Uygulama iki yazma arasında çökerse kimse fark etmez. Messaging ve Event-Driven Architecture serisinin "Transactional Outbox ve Inbox: Dual Write Problemini Anlamak ve Doğru Tasarlamak" yazısı bu sorunu genel olarak anlatıyor. Arama için gerçekçi seçenekler:
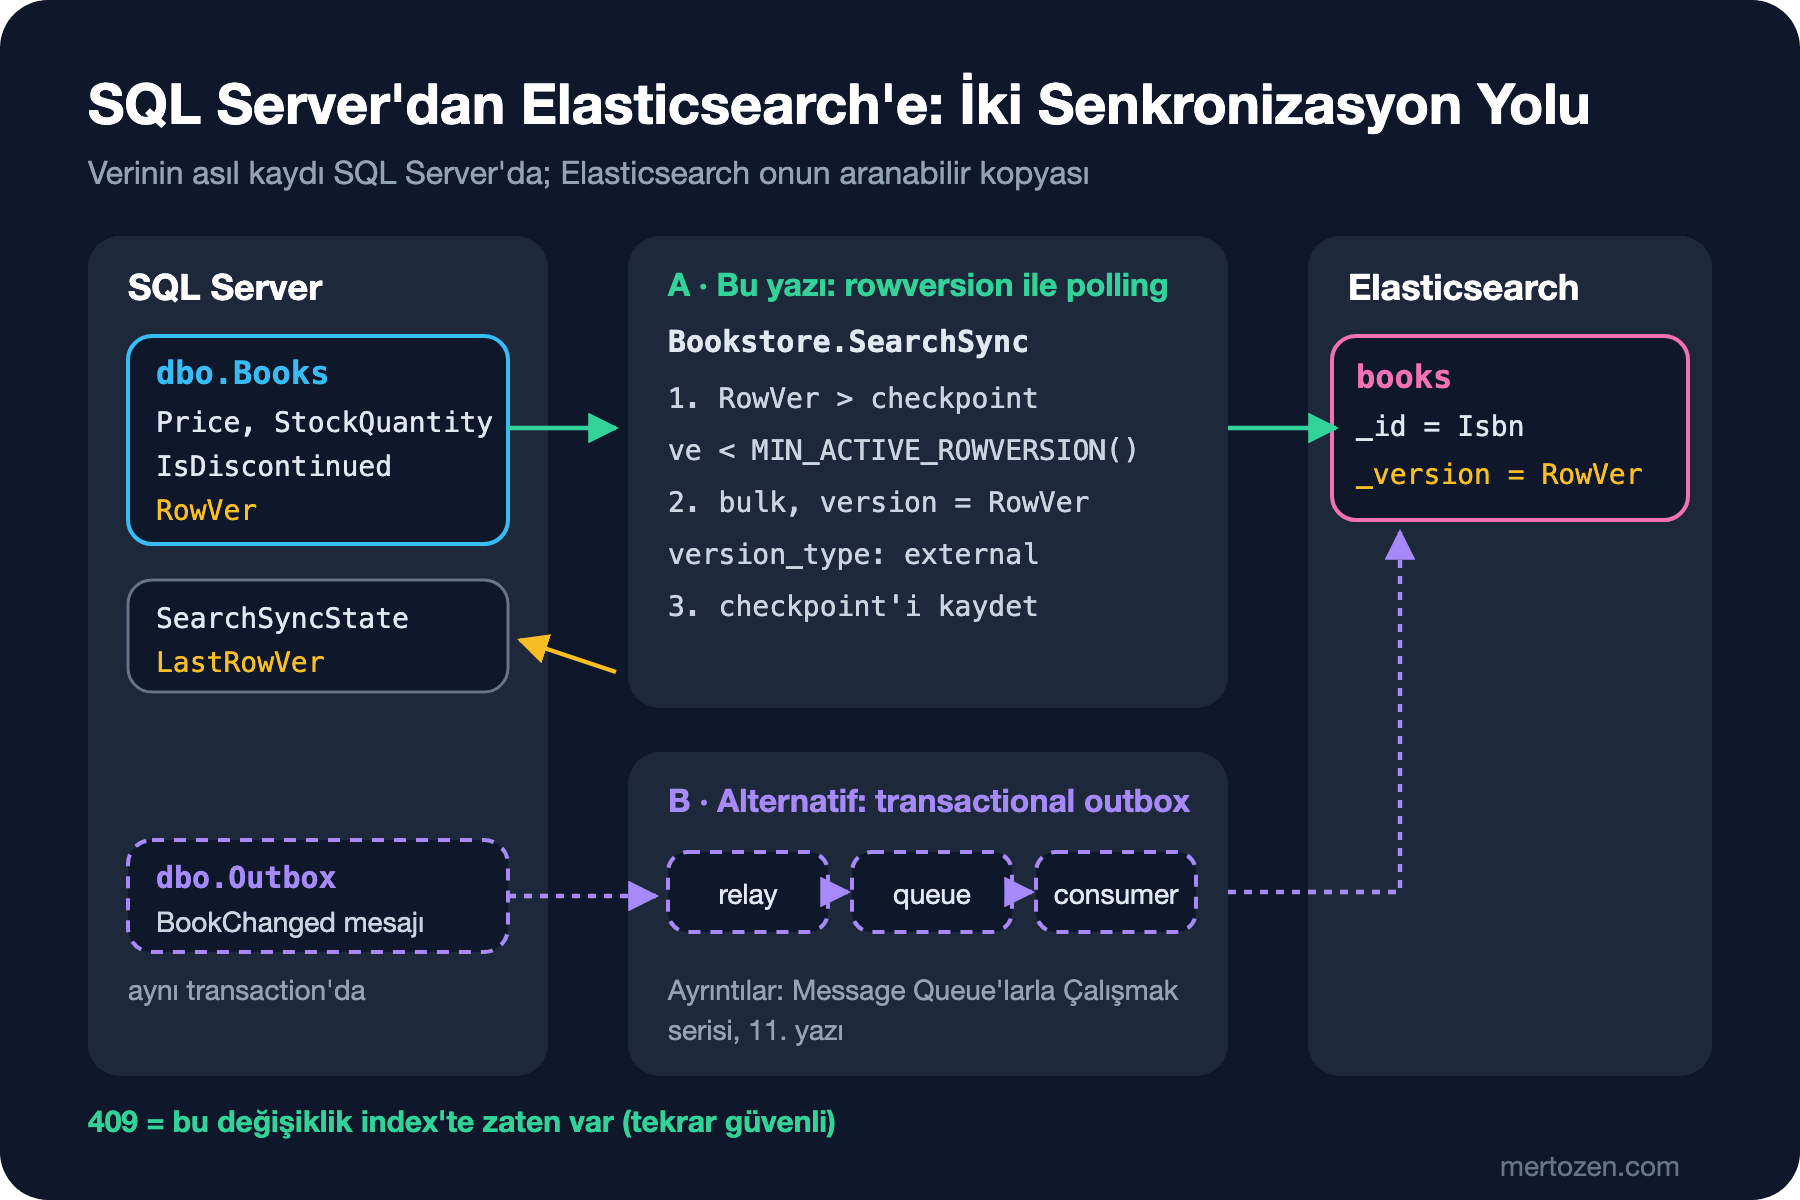
Transactional outbox: kitabı güncelleyen transaction aynı veritabanında bir outbox tablosuna "BookChanged" kaydı ekliyor, bir relay bu kayıtları bir queue'ya taşıyor, consumer Elasticsearch'i güncelliyor. Değişiklik kaybolmuyor ve başka consumer'lar (cache, öneri sistemi) aynı olayı dinleyebiliyor; bedeli queue altyapısı ve bütün yazma kodunun outbox'a yazmayı unutmaması. Message Queue'larla Çalışmak serisinin ".NET'te Transactional Outbox: EF Core, BackgroundService Relay ve MassTransit/Wolverine Outbox" yazısı bunu kuruyor.
Değişenleri periyodik okumak (polling): tabloya bir rowversion kolonu ekleyip "son okuduğumdan sonra değişenleri" belirli aralıklarla okumak. Uygulama kodunda değişiklik gerektirmiyor; SQL Server'a doğrudan yazan bir back office ekranı ya da toplu bir fiyat güncellemesi script'i de yakalanıyor. Bedeli birkaç saniyelik gecikme ve periyodik sorgu. SQL Server'ın Change Tracking ve Change Data Capture özellikleri aynı fikrin veritabanının kendi sunduğu hâlleri.
Tam yeniden index: bütün kataloğu yeni bir index'e yazıp alias'ı çevirmek (11. yazı). Tek başına senkronizasyon yöntemi değil ama her yöntemin yanında olmalı; mapping değişince ya da index bozulunca dönülecek yol bu.
Bir de EF Core (Entity Framework Core; .NET'in tabloları nesnelere eşleyen veri erişim kütüphanesi) SaveChanges interceptor'ında Elasticsearch'e yazma fikri var. Dual write'ın daha gizli bir hâli: interceptor'da yazma commit'ten önce ya da sonra olsun, iki sistem yine ayrı transaction'larda ve ExecuteUpdate gibi toplu işlemler change tracker'dan geçmediği için hiç yakalanmıyor. Bookstore için polling'i seçiyoruz: arama birkaç saniye gecikmeyi kaldırıyor ve fiyatı değiştiren her yol aynı tabloya yazıyor.
Bookstore.SearchSync: rowversion ile Polling
sql/schema.sql'e üç şey eklendi: kitap silinmek yerine satıştan kaldırıldığında işaretlenen IsDiscontinued, satır her değiştiğinde SQL Server'ın otomatik artırdığı RowVer ve senkronizasyonun nerede kaldığını tutan SearchSyncState tablosu:
    IsDiscontinued bit           NOT NULL CONSTRAINT DF_Books_IsDiscontinued DEFAULT 0,
    RowVer        rowversion     NOT NULL
);
CREATE INDEX IX_Books_Title ON dbo.Books (Title);
CREATE INDEX IX_Books_RowVer ON dbo.Books (RowVer);

CREATE TABLE dbo.SearchSyncState
(
    Name       varchar(50) NOT NULL CONSTRAINT PK_SearchSyncState PRIMARY KEY,
    LastRowVer binary(8)   NOT NULL,
    UpdatedAt  datetime2(3) NOT NULL
);
Değişenleri okuyan sorgu worker'ın kalbi:
DECLARE @upper binary(8) = MIN_ACTIVE_ROWVERSION();
SELECT TOP (@batchSize) BookId, Isbn, Title, Language, Categories, Price, StockQuantity, PublishedOn,
       AverageRating, Description, IsDiscontinued, RowVer
FROM dbo.Books
WHERE RowVer > @last AND RowVer < @upper
ORDER BY RowVer;
RowVer > @last tek başına yetmiyor. rowversion değeri yazma anında veriliyor, commit anında değil. Uzun süren bir transaction 0x5668'i alıp henüz commit olmamışken, ardından gelen kısa bir transaction 0x5669'u alıp commit olabilir. Worker 0x5669'u okuyup checkpoint'i oraya taşırsa, birinci transaction commit olduğunda onun 0x5668'i checkpoint'in gerisinde kalır ve sonsuza kadar kaçırılır. MIN_ACTIVE_ROWVERSION() veritabanındaki en küçük aktif (henüz commit olmamış) rowversion'ı, aktif transaction yoksa sıradaki değeri döndürüyor; ondan küçük her satır commit olmuş demek. Okumayı o sınırın altında tutunca bu boşluk kapanıyor.
Worker'ın döngüsü kısa: checkpoint'ten sonrasını oku, bulk ile uygula, ancak Elasticsearch kabul ettikten sonra checkpoint'i kaydet:
ChangeBatch batch = await reader.ReadChangesAsync(checkpoint, settings.BatchSize, stoppingToken);
if (batch.Changes.Count > 0)
{
    await ApplyAsync(batch, stoppingToken);
    // Yalnız Elasticsearch batch'i kabul ettikten sonra: bu satırdan önce çökersek batch tekrar oynatılır
    await reader.SaveCheckpointAsync(CheckpointName, batch.LastRowVer, stoppingToken);
    checkpoint = batch.LastRowVer;
}

if (batch.Changes.Count < settings.BatchSize)
{
    await Task.Delay(settings.PollInterval, stoppingToken);
}
private static IBulkOperation ToOperation(BookChange change) => change.IsDiscontinued
? new BulkDeleteOperation<Book>(change.Book.Isbn) { Version = change.Version, VersionType = VersionType.External }
: new BulkIndexOperation<Book>(change.Book) { Id = change.Book.Isbn, Version = change.Version, VersionType = VersionType.External };Version, 8 baytlık RowVer'ın big-endian long karşılığı (BinaryPrimitives.ReadInt64BigEndian). Bu iki kararın birleşimi senkronizasyonu güvenli yapıyor: checkpoint'i sonradan kaydettiğimiz için en az bir kez teslim (at-least-once) garantisi var, external version sayesinde aynı değişikliği ikinci kez uygulamak zararsız. Bulk cevabındaki her işlemi tek tek sınıflandırıyoruz; 409, "bu version ya da daha yenisi index'te zaten var" demek ve başarı sayılıyor. Kalıcı bir hata (400 gibi) batch'i durduruyor, checkpoint ilerlemiyor ve sorun log'da görünüyor.
Çalıştırmak için boş bir veritabanında seed-sql 20000 ile 20.036 kitap oluşturup worker'ı başlattım. Bağlantı dizesi ve API key user-secrets'ta:
dotnet user-secrets set "ConnectionStrings:Bookstore" "<connection-string>" --project src/Bookstore.SearchSync
dotnet user-secrets set "Elasticsearch:ApiKey" "<encoded>" --project src/Bookstore.SearchSync
dotnet run --project src/Bookstore.SearchSync

info: Bookstore.SearchSync.SearchSyncWorker[0]
      Starting from RowVer 0x0000000000000000
info: Bookstore.SearchSync.SearchSyncWorker[0]
      Synced 1000 changes (1000 indexed, 0 deleted, 0 already up to date) up to RowVer 0x0000000000000BBC
...
info: Bookstore.SearchSync.SearchSyncWorker[0]
      Synced 36 changes (36 indexed, 0 deleted, 0 already up to date) up to RowVer 0x0000000000005664

GET /books/_count
{"count":20036, ...}
İlk yükleme ayrı bir kod yolu gerektirmedi: checkpoint sıfırken "değişenler" bütün tablo. Şimdi fiyatı ve stoğu değiştiriyoruz, bir kitabı da satıştan kaldırıyoruz (sql/05-changes.sql):
UPDATE dbo.Books SET Price = 545.00, StockQuantity = 12 WHERE Isbn = '9781000000221';
UPDATE dbo.Books SET IsDiscontinued = 1 WHERE Isbn = '9781000000337';

Isbn          Title     Price  StockQuantity IsDiscontinued RowVer
9781000000221 Dune      545.00 12            0              0x0000000000005666
9781000000337 Moby-Dick 270.00 8             1              0x0000000000005667

info: Bookstore.SearchSync.SearchSyncWorker[0]
      Synced 2 changes (1 indexed, 1 deleted, 0 already up to date) up to RowVer 0x0000000000005667

GET /books/_doc/9781000000221?filter_path=_version,_source.price,_source.stockQuantity
{"_version":22118,"_source":{"price":545.0,"stockQuantity":12}}

GET /books/_doc/9781000000337?filter_path=found
{"found":false}
Dune'un _version'ı 22118, yani 0x5666; Elasticsearch'teki version doğrudan SQL Server'daki satırın rowversion'ı. Tekrar oynatmanın güvenli olduğunu görmek için checkpoint'i elle geri aldım (UPDATE dbo.SearchSyncState SET LastRowVer = 0x0000000000005640) ve worker'ı yeniden başlattım:
info: Bookstore.SearchSync.SearchSyncWorker[0]
      Starting from RowVer 0x0000000000005640
info: Bookstore.SearchSync.SearchSyncWorker[0]
      Synced 38 changes (0 indexed, 0 deleted, 38 already up to date) up to RowVer 0x0000000000005667
38 değişikliğin hepsi 409 aldı, hiçbir document eski bir değerle ezilmedi. Son olarak MIN_ACTIVE_ROWVERSION() korumasını izledim. Bir oturumda transaction açıp Kürk Mantolu Madonna'nın fiyatını değiştirdim ve 20 saniye commit etmeden beklettim; bu sırada başka bir oturum Çalıkuşu'nun stoğunu değiştirip commit etti:
1. oturum:
BEGIN TRANSACTION;
UPDATE dbo.Books SET Price = 199.00 WHERE Isbn = '9781000000030';
SELECT RowVer AS OpenTxRowVer FROM dbo.Books WHERE Isbn = '9781000000030';
WAITFOR DELAY '00:00:20';
COMMIT;

OpenTxRowVer
0x0000000000005668
2. oturum, hemen ardından:
UPDATE dbo.Books SET StockQuantity = 64 WHERE Isbn = '9781000000061';
SELECT Isbn, RowVer, MIN_ACTIVE_ROWVERSION() AS MinActive FROM dbo.Books WHERE Isbn = '9781000000061';

Isbn          RowVer             MinActive
9781000000061 0x0000000000005669 0x0000000000005668
Worker log'unda transaction açıkken yeni satır yok; commit'ten sonra:
info: Bookstore.SearchSync.SearchSyncWorker[0]
      Synced 2 changes (2 indexed, 0 deleted, 0 already up to date) up to RowVer 0x0000000000005669
Çalıkuşu'nun değişikliği commit olmuş olmasına rağmen, daha küçük bir rowversion açıkta olduğu için worker onu bekletti; commit'ten sonra ikisini birlikte aldı. Koruma olmasaydı checkpoint 0x5669'a ilerler, Kürk Mantolu Madonna'nın yeni fiyatı aramaya hiç yansımazdı.
Bu tasarımın bilinçli sınırları var. BookAuthors tablosundaki bir değişiklik Books.RowVer'ı değiştirmiyor; yazar düzeltmesi yapan kod kitabın satırına da dokunmalı (ör. UpdatedAt gibi bir kolonu güncelleyerek). Kitabı fiziksel olarak silen bir DELETE polling'de görünmez; bu yüzden satıştan kaldırmayı IsDiscontinued ile yapıyoruz. EF Core serisinin "EF Core'da Global Query Filter: Soft Delete, Multi-Tenancy ve IgnoreQueryFilters" yazısı soft delete'in uygulama tarafını anlatıyor.
Üretimde Dikkat
Gecikmeyi ölç. Arama index'inin SQL Server'ın ne kadar gerisinde kaldığı tek önemli metric: SearchSyncState.UpdatedAt ile son değişikliğin zamanı arasındaki fark ya da worker'ın her batch'te logladığı RowVer ile MAX(RowVer) farkı. Bunu bir alarm eşiğine bağla; worker sessizce durursa kullanıcılar eski fiyatları görür ve kimse fark etmez.
Tek worker çalıştır. İki instance aynı checkpoint'i okursa external version sayesinde veri bozulmaz ama iş iki kez yapılır. Birden çok instance deploy ediyorsan leader seçimi ya da veritabanında bir lock (sp_getapplock gibi) kullan.
Büyük ilk yüklemeyi senkronizasyondan ayır. 20 bin kitapta ilk yükleme aynı döngüyle birkaç saniyede bitti; milyonlarca satırda ayrı bir index'e BulkAll ile, refresh kapalı ve replica sıfırken yükleyip alias'ı çevirmek daha hızlı ve kesintisiz (11. yazı). Senkronizasyon sonra kaldığı yerden devam eder.
Hata türlerini ayır. 429 ve bağlantı hataları tekrar denenmeli; mapping hatası gibi kalıcı hatalar ise batch'i sonsuza kadar tekrar denetmemeli. Gerçek bir sistemde kalıcı hatayı bir hata tablosuna yazıp checkpoint'i ilerletmek, tek bir bozuk kitabın bütün senkronizasyonu durdurmasını engeller.
Sık Düşülen Tuzaklar
Her kayıttan sonra refresh. refresh=true ile yapılan her yazma yeni bir küçük segment demek; toplu yüklemede index'leme hızını ciddi biçimde düşürür.
Büyük ilk yüklemede replica'ları ve refresh'i açık bırakmak. Her document replica'ya da yazılır ve saniyede bir yeni segment açılır; yükleme bitince ayarları geri almayı da unutma.
Bulk cevabında yalnız HTTP durumuna bakmak. 200 dönen bir bulk isteğinde işlemlerin yarısı reddedilmiş olabilir; errors ve her işlemin status'u kontrol edilmeli.
Checkpoint'i Elasticsearch'e yazmadan önce kaydetmek. Arada bir çökme olursa o batch hiç uygulanmamış ama "okundu" sayılmış olur; kaybolan güncelleme sessizdir.
RowVer > @last ile yetinmek. Açık transaction'lar yüzünden checkpoint'in gerisinde commit olan satırlar kaçar; MIN_ACTIVE_ROWVERSION() sınırını unutma.
Dual write'ı "nasılsa nadiren hata olur" diye kabul etmek. Zaman aşımı, deploy sırasında yeniden başlatma ve ağ kesintisi nadir değil; her biri index'te sessizce eski kalan bir kitap demek.
Küçük Bir Deneme
★☆☆ bulk-compare'deki paket boyutunu 100, 1.000 ve 5.000 yap ve süreleri karşılaştır. Elastic'in önerdiği "ikiye katlayarak dene" yöntemiyle bu lab için en iyi boyutu bul.
★★☆ Worker çalışırken UPDATE dbo.BookAuthors SET Name = N'Yaşar Kemal (düzeltme)' WHERE BookId = 1 çalıştır. Değişiklik index'e geliyor mu? Books satırına da dokunan bir düzeltme yaz ve tekrar dene.
★★★ Worker'ın iki kopyasını aynı anda çalıştır ve 1.000 kitabın fiyatını tek bir UPDATE ile değiştir. Log'larda "already up to date" sayıları nasıl dağılıyor? sp_getapplock ile yalnız bir kopyanın çalışmasını sağla ve farkı ölç.
Bir sonraki yazıda veri hazır, sıra sorguda: match ile term farkı, multi_match'in tipleri, bool sorgusunda must/should/filter, query ve filter context'in skor ve cache farkı, from/size'ın 10.000 sınırı ve search_after ile derin sayfalama.