

Analyzer'lar ve Türkçe: Tokenizer, Token Filter, turkish Analyzer, ASCII Folding ve Eş Anlamlılar

Elasticsearch'te Türkçe arama, yerleşik turkish analyzer'ı olduğu gibi kullanmakla düzelmez: apostrophe ve Türkçe lowercase filtreleri işe yarar ama Snowball stemmer "İnce"yi "i"ye, "kasaba"yı "kasap"a indirir; çözüm keyword_marker, Türkçe karaktersiz bir alt alan ve birden çok alanı birlikte sorgulamak. Gerçek çıktılarla analyzer zinciri, stemmer'ın sınırları, ICU ile Türkçe sıralama ve reindex gerektirmeyen Synonyms API.
Sürüm notu: Bu yazıdaki örnekler Elasticsearch 9.5.6 (analysis-icu plugin'i ile), Kibana 9.5.6 Dev Tools, .NET 10 ve Elastic.Clients.Elasticsearch 9.5.3 ile, 2. yazıda kurduğumuz lab'da çalıştırılmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) kataloğu için Türkçe aramayı düzeltmenin en kısa yolu yerleşik turkish analyzer gibi görünüyor. 36 kitabın başlık ve açıklamasını, iki alanı da "analyzer": "turkish" olan bir turkish-test index'ine koyup dört arama yapıyoruz:
GET /turkish-test/_search
{ "query": { "multi_match": { "query": "ince", "fields": ["title", "description"] } } }

# aynı istek "öğretmenler", "kasaba" ve "roman" için
"ince" araması İnce Memed'i ilk sıraya koyar mı? Çalıkuşu'nun açıklamasında "kasabalarına öğretmen olarak" geçiyor; "öğretmenler" ve "kasaba" onu bulur mu? İlk yazıda standard analyzer "roman" için 9 kitaptan 6'sını bulmuştu; turkish kaçını bulur?
Analyzer'ın Anatomisi
Bir analyzer üç parçadan oluşuyor ve metin bu sırayla geçiyor: sıfır ya da daha fazla char filter (ham metin üzerinde karakter düzeyinde değişiklik, ör. HTML etiketlerini atmak), tam olarak bir tokenizer (metni token'lara bölmek) ve sıfır ya da daha fazla token filter (token'ları değiştirmek, atmak ya da eklemek). Her adımı _analyze API'sinin explain seçeneğiyle görebiliyoruz. Yerleşik turkish analyzer'ın zincirini elle kurup "Kürk Mantolu Madonna'nın" metnini veriyoruz:
POST /_analyze
{
  "tokenizer": "standard",
  "filter": [
    "apostrophe",
    { "type": "lowercase", "language": "turkish" },
    { "type": "stop", "stopwords": "_turkish_" },
    { "type": "stemmer", "language": "turkish" }
  ],
  "text": "Kürk Mantolu Madonna'nın",
  "explain": true
}
tokenizer standard ['Kürk', 'Mantolu', "Madonna'nın"]
apostrophe ['Kürk', 'Mantolu', 'Madonna']
__anonymous__lowercase ['kürk', 'mantolu', 'madonna']
__anonymous__stop ['kürk', 'mantolu', 'madonna']
__anonymous__stemmer ['kürk', 'mantol', 'madonna']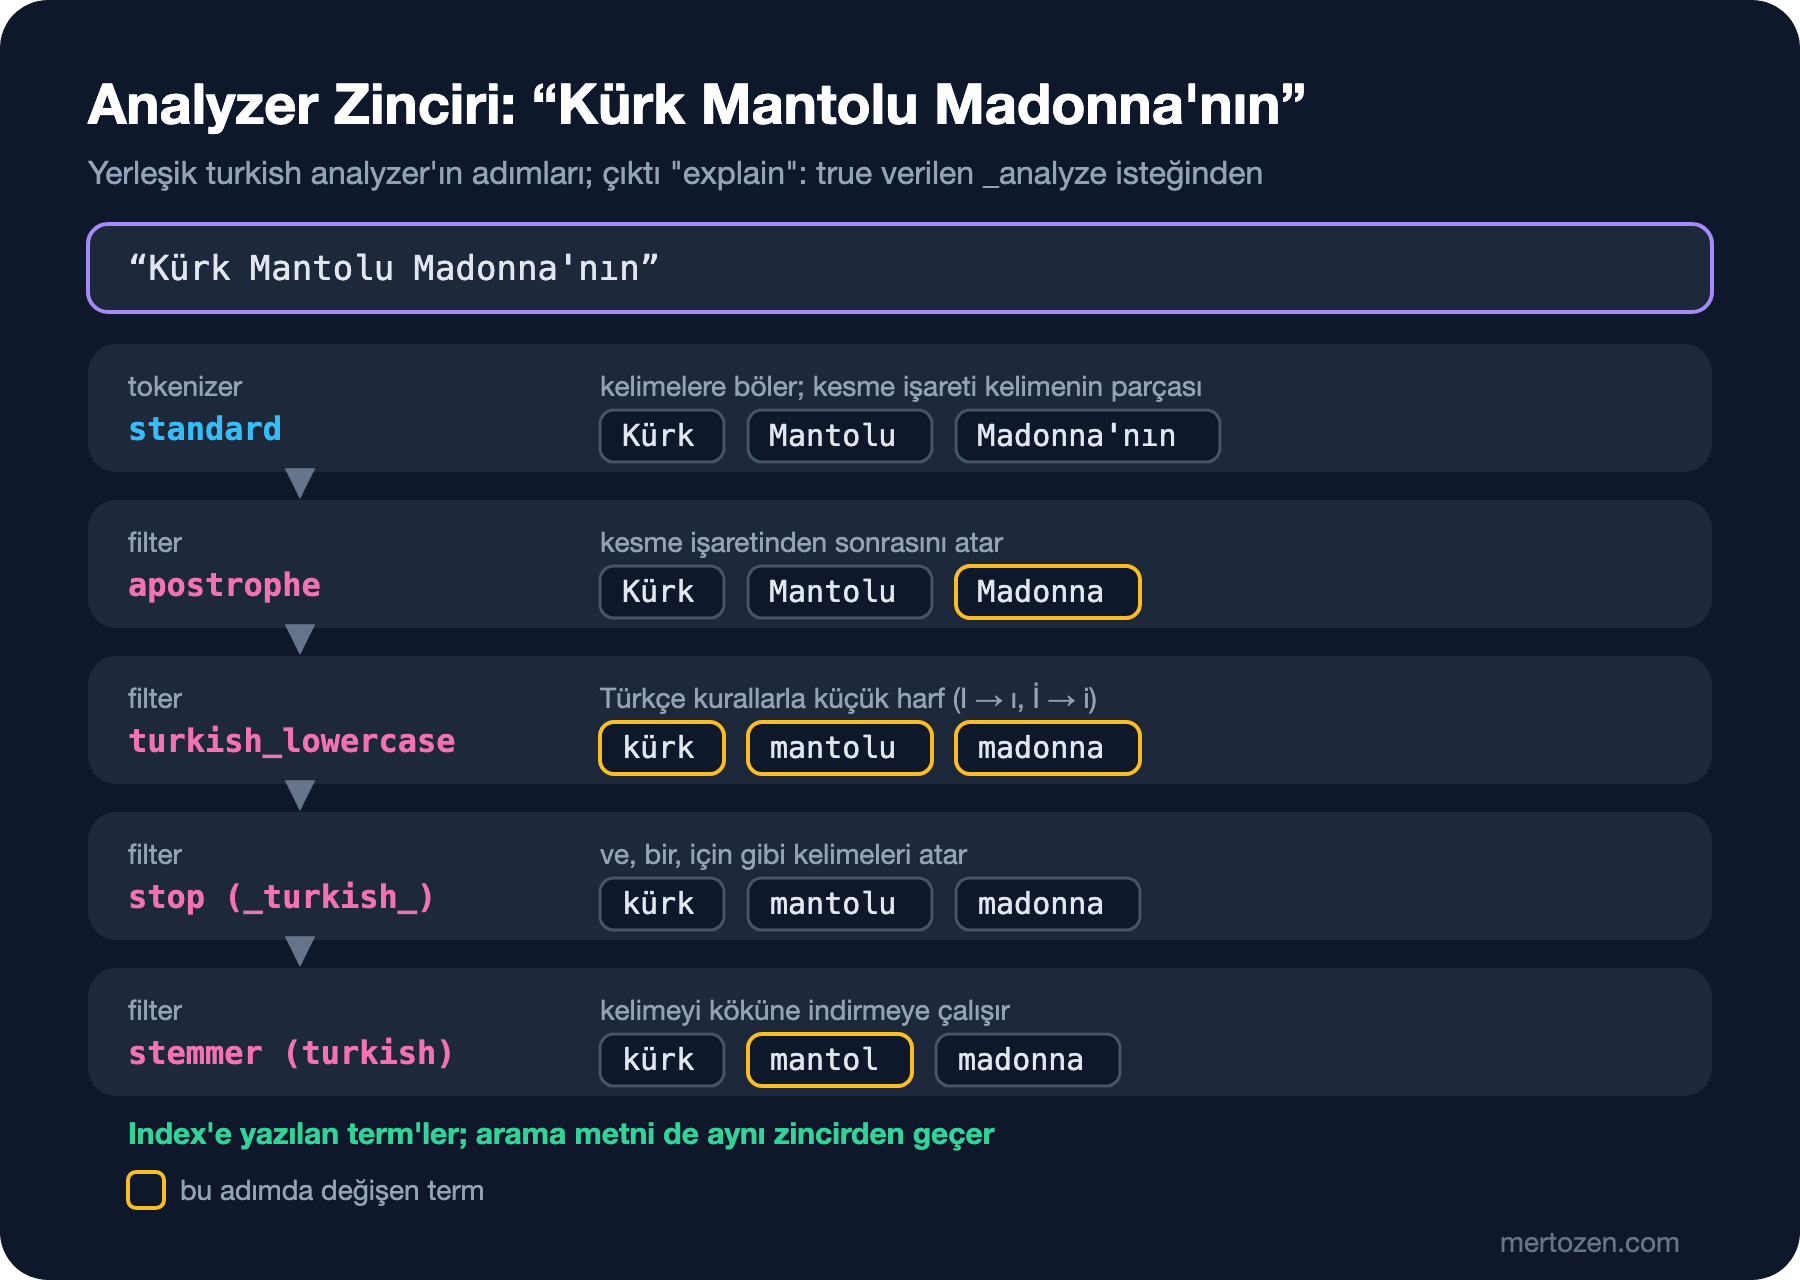
(Çıktıyı okunur olsun diye adım başına tek satıra indirdim; gerçek cevap her token için pozisyon ve offset de veriyor.) Analyzer iki yerde çalışıyor: document index'lenirken (index-time) ve sorgu metni üzerinde (search-time). Varsayılan olarak ikisi aynı; match sorgusu aranan metni alanın analyzer'ından geçirip çıkan term'leri index'te arıyor. İki tarafın aynı term'leri üretmesi gerekiyor; "mantolu" index'te mantol olarak duruyorsa, arama da "mantolu"yu mantol'e çevirmeli. Mapping'de search_analyzer ile search-time'da farklı bir analyzer verebilirsin; eş anlamlılarda bunu kullanacağız.
turkish Analyzer'ın Parçaları
Elastic'in dokümanı turkish analyzer'ı yeniden kurmak için şu filtreleri bu sırayla veriyor: apostrophe, Türkçe lowercase, Türkçe stop, keyword_marker ve Türkçe stemmer. Her birinin ne yaptığını tek tek görelim.
apostrophe kesme işaretini ve sonrasını atıyor. Türkçe'de özel isimlere gelen ekler kesmeyle ayrıldığı için bu tek filtre İlk yazıdaki "Memed'in" sorununu çözüyor:
POST /_analyze
{ "tokenizer": "standard", "filter": ["apostrophe"], "text": "Madonna'nın Memed'in İstanbul'da" }

Madonna | Memed | İstanbul
Türkçe lowercase ise noktalı/noktasız i sorununu çözüyor. Aynı metin, standart lowercase ile ve "language": "turkish" ile:
{ "tokenizer": "standard", "filter": ["lowercase"], "text": "IŞIK ILIK İSTANBUL Iron" }
işik | ilik | istanbul | iron

{ "tokenizer": "standard", "filter": [{ "type": "lowercase", "language": "turkish" }], "text": "IŞIK ILIK İSTANBUL Iron" }
ışık | ılık | istanbul | ıron
Standart lowercase "IŞIK"ı "işik" yapıyor; Türkçe metinde yanlış. Türkçe lowercase doğru "ışık"ı veriyor ama bu sefer İngilizce "Iron" kelimesini "ıron" yapıyor. Bir alanın analyzer'ı içeriğin diline göre seçilmeli; Türkçe ve İngilizce kitapları aynı katalogda tutan Bookstore için bu, aşağıda göreceğimiz gibi alan başına birden çok analyzer demek.
stop filtresi tek başına anlam taşımayan sık kelimeleri atıyor:
{ "tokenizer": "standard", "filter": [{ "type": "lowercase", "language": "turkish" }, { "type": "stop", "stopwords": "_turkish_" }], "text": "Ve bir de bu kitap için çok güzel ama" }

kitap | güzel
Stemmer kelimeyi köküne indirmeye çalışıyor; keyword_marker ise listesindeki kelimeleri stemmer'dan koruyor. Asıl sorunlar da burada başlıyor.
Stemmer'ın Sınırları
Elasticsearch'ün Türkçe stemmer'ı kural tabanlı bir Snowball stemmer'ı. Kelimenin sözlükte ne olduğunu bilmiyor, sondaki ekleri kurallarla kesiyor. Birkaç kelimeyi tek başına verelim:
{ "tokenizer": "standard", "filter": ["apostrophe", { "type": "lowercase", "language": "turkish" }, { "type": "stemmer", "language": "turkish" }],
  "text": "İnce Memed'in kasabalarına öğretmenler kitaplarımızdan romanı romanlar roman kitap Mantolu madonna" }

i | memedi | kasaba | öğretmen | kitap | roma | roman | roma | kitap | mantol | madonna

{ ..., "text": "öğretmenler kasaba kasabalar öğretmen" }
öğretmen | kasap | kasaba | öğretme
"kitaplarımızdan" doğru biçimde "kitap" oldu. Ama "İnce" "i"ye indi (over-stemming: fazla kesmek), "öğretmen" tek başına "öğretme"ye, "kasaba" "kasap"a döndü; "öğretmenler" ise "öğretmen", "kasabalarına" "kasaba" oldu. Yani kelimenin yalın hâli ile ekli hâli farklı term'lere iniyor (under-stemming: eşleşmesi gereken biçimleri ayırmak). "roman" ve "romanı" roma olurken "romanlar" roman kaldı. "Memed"in "memedi" olması ise bir hata değil, stemmer'ın d ile biten köklere ünlü ekleyen kuralı; index ve sorgu aynı kuralı uyguladığı için eşleşme bozulmuyor. PostgreSQL serisinin "PostgreSQL Full-Text Search: tsvector, tsquery, Türkçe Configuration, unaccent ve pg_trgm" yazısı aynı Snowball stemmer ailesiyle "kasaba" ve "öğretmenler" aramalarının benzer biçimde kaçtığını gösteriyor; sorun Elasticsearch'e özgü değil.
Tahmindeki aramaların sonucu:
ince:         3 hit  [Kuyucaklı Yusuf 3.47, İnce Memed 2.71, İnce Memed 2 2.26]
öğretmenler:  0 hit
kasaba:       0 hit
roman:        9 hit
"roman" için recall 6/9'dan 9/9'a çıktı, stemmer burada işe yaradı. Ama "ince" araması Kuyucaklı Yusuf'u İnce Memed'in önüne koydu: açıklamadaki "ileri" kelimesi de "i"ye iniyor ve kısa bir term, kısa bir alanda yüksek skor alıyor. "öğretmenler" ve "kasaba" ise yukarıdaki tutarsızlık yüzünden Çalıkuşu'nu bulamadı.
Bunun pratik çözümü keyword_marker: katalogda önemli olan ve stemmer'ın bozduğu kelimeleri listeye koyuyorsun, stemmer onlara dokunmuyor. Bookstore'un tr_text analyzer'ında liste şimdilik üç kelime:
"tr_keywords": { "type": "keyword_marker", "keywords": ["ince", "kasaba", "öğretmen"] }

POST /books/_analyze
{ "field": "description.tr", "text": "öğretmenler kasaba kasabalarına öğretmen İnce" }

öğretmen | kasaba | kasaba | öğretmen | ince
"öğretmenler" yine kendi kuralıyla "öğretmen"e iniyor, "öğretmen" ise artık korunuyor; iki biçim aynı term'de buluştu. Belirli bir ekli biçimi istediğin köke eşlemek için stemmer_override filtresi de var. Bu listeler küçük kalmalı ve gerçek arama loglarından beslenmeli; her kelimeyi elle düzeltmeye çalışmak sürdürülebilir değil. Türkçe'nin biçimbilimini sözlükle çözen morfolojik analiz araçları da var (Zemberek gibi), ama Elasticsearch için bunları kullanan eklentiler üçüncü parti ve bakım durumları belirsiz; production'a koymadan önce sürüm uyumluluğunu kontrol etmen gerekir. Bu seride stemmer'ı tek başına bırakmak yerine onu birden çok alanla dengeliyoruz.
Türkçe Karakter Yazmayan Kullanıcı
Kullanıcıların bir kısmı "Çalıkuşu" yerine "calikusu", "Yaşar Kemal" yerine "yasar kemal" yazıyor. 3. yazıdaki folded analyzer'ını Türkçe için düzeltip tr_folded yapıyoruz: önce apostrophe, sonra Türkçe lowercase, en son asciifolding:
{ "tokenizer": "standard", "filter": ["apostrophe", { "type": "lowercase", "language": "turkish" }, "icu_folding"], "text": "Kürk Çalıkuşu IŞIK İnce ılık Öğretmen Madonna'nın" }
kurk | calikusu | isik | ince | ilik | ogretmen | madonna

{ "tokenizer": "standard", "filter": ["lowercase", "asciifolding"], "text": "Kürk Çalıkuşu IŞIK İnce ılık Öğretmen" }
kurk | calikusu | isik | ince | ilik | ogretmen
Türkçe metinde ICU (International Components for Unicode; dillerin sıralama ve harf kurallarını bilen Unicode kütüphanesi) plugin'inin icu_folding'i ile yerleşik asciifolding aynı sonucu verdi; icu_folding daha fazla Unicode karakterini kapsıyor ama Türkçe karakterler için fark yok. Mapping'de plugin gerektirmeyen asciifolding'i kullanıyoruz. Bu alan precision'dan feragat ediyor: "ılık" ile "ilik" artık aynı term. Bu yüzden onu tek başına değil, Türkçe karakterli alanlarla birlikte ve daha düşük ağırlıkla sorguluyoruz.
GET /books/_search
{ "query": { "match": { "title.folded": { "query": "kurk mantolu", "operator": "and" } } } }
→ 1 hit: Kürk Mantolu Madonna

{ "query": { "match": { "title.folded": "calikusu" } } }
→ 1 hit: Çalıkuşu

{ "query": { "nested": { "path": "authors", "query": { "match": { "authors.name.folded": "yasar kemal" } } } } }
→ 2 hit: İnce Memed, İnce Memed 2
ICU ile Türkçe Sıralama
3. yazıda title.keyword'e göre sıralamanın Ç ve İ ile başlayan kitapları listenin sonuna attığını gördük. Dile göre sıralama için ICU plugin'inin icu_collation_keyword tipi gerekiyor. Plugin resmî image'da yok; lab'a küçük bir Dockerfile ekliyoruz:
# Resmî image artı ICU analysis plugin'i (04. yazı: icu_folding, icu_collation_keyword)
ARG ES_VERSION=9.5.6
FROM docker.elastic.co/elasticsearch/elasticsearch:${ES_VERSION}
RUN bin/elasticsearch-plugin install --batch analysis-icu
elasticsearch:
# analysis-icu plugin'i eklenmiş resmî image (lab/elasticsearch/Dockerfile, 04. yazı)
build:
context: ./elasticsearch
args:
ES_VERSION: ${ES_VERSION:-9.5.6}
image: bookstore-search-es:${ES_VERSION:-9.5.6}docker compose -f lab/compose.yaml --profile kibana up -d --build --wait
GET /_cat/plugins?v
name component version
bookstore-es analysis-icu 9.5.6Plugin sürümü Elasticsearch sürümüyle birebir aynı olmak zorunda; Elasticsearch'ü yükseltirken image'ı yeniden build etmek gerekiyor. Container yeniden oluşturulsa da veri es-data volume'unda kaldığı için index'ler kaybolmuyor. Başlığa bir sort alt alanı ekleyince Türkçe kitaplar alfabeye göre diziliyor:
"sort": { "type": "icu_collation_keyword", "language": "tr" }

GET /books/_search
{ "_source": ["title"], "sort": [{ "title.sort": "asc" }], "query": { "term": { "language": "tr" } } }

Aylak Adam, Benim Adım Kırmızı, Bin Dokuz Yüz Seksen Dört, Çalıkuşu, Dokuzuncu Hariciye Koğuşu, Dune, Hobbit, Huzur, İçimizdeki Şeytan, İnce Memed, İnce Memed 2, Kuyucaklı Yusuf, Kürk Mantolu Madonna, Puslu Kıtalar Atlası, Saatleri Ayarlama Enstitüsü, Savaş ve Barış, Sinekli Bakkal, Suç ve Ceza, Tutunamayanlar, Yaban, Yaprak Dökümü
Çalıkuşu B'den sonra, İçimizdeki Şeytan ve İnce Memed H'den sonra geliyor; Kürk Mantolu Madonna da Kuyucaklı Yusuf'un arkasında. Küçük bir denemede ICU'nun I ile İ'yi de doğru ayırdığını gördüm: "Ilık, Işıklar, İçimizdeki Şeytan, İnce Memed" sırası. Sort değeri olarak dönen değer okunabilir bir metin değil, bir collation key; ekranda _source'taki başlığı göster.
Eş Anlamlılar: Synonyms API
Türkçe kullanıcı "roman", İngilizce kullanıcı "novel" yazıyor; katalogda iki dil de var. Eş anlamlıları analyzer'a sabit bir liste olarak gömmek, her değişiklikte analyzer'ı yeniden yüklemeyi gerektiriyordu. Elasticsearch'ün Synonyms API'si eş anlamlıları cluster'da ayrı bir kaynak olarak tutuyor ve değişince analyzer'ları kendisi yeniden yüklüyor:
PUT /_synonyms/bookstore-synonyms
{
  "synonyms_set": [
    { "id": "novel", "synonyms": "roman, novel" },
    { "id": "sci-fi", "synonyms": "bilim kurgu, science fiction, sci-fi" }
  ]
}

{ "result" : "created", "reload_analyzers_details" : { ... } }
Mapping'de bir synonym_graph filtresi bu set'e işaret ediyor ve yalnız search-time'da, description'ın search_analyzer'ında kullanılıyor:
"bookstore_synonyms": { "type": "synonym_graph", "synonyms_set": "bookstore-synonyms", "updateable": true }

"search_synonyms": {
  "type": "custom",
  "tokenizer": "standard",
  "filter": ["lowercase", "bookstore_synonyms"]
}
updateable: true şart: synonym'leri set'ten okuyan bir filtreyi index-time analyzer'ında kullanmayı denediğimde Elasticsearch Can't apply [synonyms_set]! Loading synonyms from index is supported only for search time synonyms! hatası verdi. Mantıklı da: index-time eş anlamlıları term'leri diske yazar, kural değişince bütün veriyi yeniden index'lemek gerekir. Search-time'da ise kural değişikliği bir sonraki sorguda geçerli. Bunu canlı görelim. "translated" araması önce yalnız İngilizce bir kitabı buluyor; set'e tek bir kural ekleyince Türkçe çevirileri de buluyor:
dotnet run --project src/Bookstore.SearchLab -- search translated
"translated": 1 hits
    3.26  Crime and Punishment (en)

PUT /_synonyms/bookstore-synonyms/translation
{ "synonyms": "çeviri, translated, translation" }

"result" : "created",
"reload_details" : [ { "index" : "books", "reloaded_analyzers" : [ "search_synonyms" ], ... } ]

dotnet run --project src/Bookstore.SearchLab -- search translated
"translated": 5 hits
    3.26  Crime and Punishment (en)
    2.43  Savaş ve Barış (tr)
    2.35  Suç ve Ceza (tr)
    2.35  Hobbit (tr)
    2.13  Dune (tr)
Index'e dokunmadık, reindex yok. Set'in son hâli repo'da search/synonyms.json'da duruyor. Set'i yönetmek bir cluster yetkisi (manage_search_synonyms); uygulamanın API key'inde bu yetki yok ve olmamalı, set'i Dev Tools'ta ya da deploy pipeline'ında bir yönetici kimliğiyle güncelliyoruz.
Bookstore'un Yeni Mapping'i ve Çok Alanlı Arama
Bu kararların hepsi search/books.index.json'ın yeni hâlinde. Analysis bölümü:
"filter": {
  "tr_lowercase": { "type": "lowercase", "language": "turkish" },
  "tr_stop": { "type": "stop", "stopwords": "_turkish_" },
  "tr_keywords": { "type": "keyword_marker", "keywords": ["ince", "kasaba", "öğretmen"] },
  "tr_stemmer": { "type": "stemmer", "language": "turkish" },
  "bookstore_synonyms": { "type": "synonym_graph", "synonyms_set": "bookstore-synonyms", "updateable": true }
},
"analyzer": {
  "tr_text": {
    "type": "custom",
    "tokenizer": "standard",
    "filter": ["apostrophe", "tr_lowercase", "tr_stop", "tr_keywords", "tr_stemmer"]
  },
  "tr_folded": {
    "type": "custom",
    "tokenizer": "standard",
    "filter": ["apostrophe", "tr_lowercase", "asciifolding"]
  },
  "search_synonyms": {
    "type": "custom",
    "tokenizer": "standard",
    "filter": ["lowercase", "bookstore_synonyms"]
  }
}
Başlık ve açıklama artık birden çok alt alanla index'leniyor: standard ile ana alan (kelimenin yazıldığı gibi hâli), tr (Türkçe kök), en (yerleşik english analyzer'ı, İngilizce kitaplar için), folded (Türkçe karaktersiz) ve başlıkta sort (ICU collation):
"title": {
  "type": "text",
  "fields": {
    "keyword": { "type": "keyword", "ignore_above": 256 },
    "tr": { "type": "text", "analyzer": "tr_text" },
    "en": { "type": "text", "analyzer": "english" },
    "folded": { "type": "text", "analyzer": "tr_folded" },
    "sort": { "type": "icu_collation_keyword", "language": "tr" }
  }
},
"description": {
  "type": "text",
  "search_analyzer": "search_synonyms",
  "fields": {
    "tr": { "type": "text", "analyzer": "tr_text" },
    "en": { "type": "text", "analyzer": "english" },
    "folded": { "type": "text", "analyzer": "tr_folded" }
  }
}
Her kitap, dili ne olursa olsun bütün alt alanlara yazılıyor. Daha temiz alternatif, dile göre ayrı alanlar (title_tr, title_en) ve kitabın diline göre yalnız birini doldurmak; bunun bedeli uygulamada ya da bir ingest pipeline'da dil seçimi yapmak. 36 kitapta disk farkı önemsiz; büyük bir katalogda ölçerek karar ver. Analyzer değiştiği için index'i yeniden kurmak gerekiyor; 3. yazıda gördüğümüz gibi mapping yerinde değişmiyor. Lab'da Dev Tools'ta DELETE /books, ardından dotnet run --project src/Bookstore.SearchLab -- create-index. Synonyms set'i index'ten önce oluşturmayı unutma.
Sorgu tarafında bu alanların hepsini birden aramak gerekiyor. Lab konsoluna bir search komutu ekledik:
// title ve description'ın bütün analiz edilmiş biçimleri; en ağır olan yazıldığı gibi başlık
private static readonly string[] SearchFields =
[
    "title^3", "title.tr^2", "title.folded^2", "title.en",
    "description", "description.tr", "description.folded", "description.en"
];

SearchResponse<Book> response = await client.SearchAsync<Book>(s => s
    .Size(5)
    .Query(q => q.MultiMatch(m => m
        .Query(text)
        .Fields(Fields.FromStrings(SearchFields)))));
"kurk mantolu": 1 hits
11.28 Kürk Mantolu Madonna (tr)
"öğretmenler": 1 hits
3.60 Çalıkuşu (tr)
"ince": 2 hits
8.47 İnce Memed (tr)
7.11 İnce Memed 2 (tr)
"novel": 7 hits
3.26 Nineteen Eighty-Four (en)
1.94 İnce Memed (tr)
1.94 Yaprak Dökümü (tr)
1.94 Suç ve Ceza (tr)
1.88 Yaban (tr)
"memedin": 2 hits
5.43 İnce Memed (tr)
4.52 İnce Memed 2 (tr)Tahmindeki sorunların hepsi kapandı: "ince" yalnız İnce Memed'leri buluyor, "öğretmenler" Çalıkuşu'nu, Türkçe karaktersiz yazım doğru kitabı, kesme işareti yazılmamış "memedin" de İnce Memed'i. ^3 ve ^2 alan ağırlıkları (boost) şimdilik tahmini değerler; multi_match'in tipleri ve skorun nasıl birleştiği 6. yazıda, ağırlıkları ölçerek ayarlamak 7. yazıda.
Üretimde Dikkat
Analyzer değişikliği bir şema değişikliği. Yeni bir filtre, yeni bir keyword_marker kelimesi, farklı bir stemmer index-time analyzer'ına dokunuyorsa mevcut document'lar eski term'lerle duruyor ve reindex gerekiyor. Yalnız search-time'da kalan değişiklikler (synonyms set'i gibi) bunun dışında. Bu yüzden sık değişecek kuralları search-time'a, yavaş değişenleri index-time'a koy.
Değişikliği ölç. Stemmer'a eklediğin her istisna bir aramayı düzeltip başka birini bozabilir. Arama loglarından en sık 100 sorguyu ve beklenen ilk sonuçları bir sette tut, her analyzer değişikliğinde çalıştır (7. yazıda _rank_eval ile).
Plugin'i sürümle birlikte yönet. analysis-icu her Elasticsearch sürümü için ayrı derleniyor; image'ı CI'da build edip sürüm etiketiyle sakla. Managed servislerde (Elastic Cloud, Amazon OpenSearch Service) hangi plugin'lerin kurulabildiği servise göre değişiyor; ICU'ya bağlı bir tasarım yapmadan önce kontrol et.
Sık Düşülen Tuzaklar
Index ve search analyzer'larını uyumsuz bırakmak. Index'te stemmer, aramada stemmer'sız bir analyzer kullanırsan "kitaplar" araması index'teki kitap'ı bulamaz. search_analyzer yalnız bilinçli bir fark için (eş anlamlılar gibi) kullanılmalı.
Stemmer'ı kısa alanlarda körü körüne kullanmak. Başlıklar kısa, özel isimlerle dolu; "İnce" gibi bir isim "i"ye inince sıralama bozuluyor. Başlıkta stemmed alanı tek başına değil, yazıldığı gibi hâliyle birlikte ve daha düşük ağırlıkla sorgula.
Türkçe lowercase'i İngilizce metne uygulamak. "Iron" "ıron" olur ve "iron" araması bulamaz. Dil başına alan ya da dil başına alt alan kullan.
Analyzer değişince reindex'i unutmak. Mapping'deki analyzer'ı değiştiren bir deploy, eski document'ları yeni kurallarla aramaya başlar ve sonuçlar sessizce kötüleşir.
Eş anlamlıları index-time'da uygulamak. Her kural değişikliği tam reindex demek; Synonyms API ile search-time kullan.
Küçük Bir Deneme
★☆☆ _analyze ile "Saatleri Ayarlama Enstitüsü'nün" ve "Puslu Kıtalar Atlası'ndaki" metinlerini önce turkish, sonra books index'inin tr_text ve tr_folded analyzer'larından geçir ("analyzer": "tr_text" ile). Hangi kelimeler over-stemming'e uğruyor?
★★☆ bookstore-synonyms set'ine "polisiye, cinayet, mystery" kuralını ekle ve search mystery çalıştır. Hangi kitaplar geliyor, neden? Kuralı DELETE /_synonyms/bookstore-synonyms/<id> ile kaldırıp sonucu tekrar karşılaştır.
★★★ keyword_marker listesine eklemek yerine stemmer_override ile "romanlar => roma" kuralını yazan yeni bir analyzer tanımla ve books-test adında ayrı bir index'te dene. "roman", "romanı" ve "romanlar" artık aynı term'e iniyor mu? Bu yaklaşımın keyword_marker'a göre bakım maliyeti ne?
Bir sonraki yazıda katalog SQL Server'dan Elasticsearch'e akmaya başlıyor: Bulk API ve .NET'te BulkAll, satır satır hata işlemek, refresh'in bedeli, if_seq_no ile optimistic concurrency ve fiyatı ya da stoğu değişen kitabı index'e taşıyan bir BackgroundService.