

Index Yaşam Döngüsü: Alias ile Kesintisiz Reindex, Index Template, Shard Boyutu ve ILM

Uygulamayı gerçek index adına değil bir alias'a bağlarsan mapping değişikliği bir kesinti değil, template'ten yeni bir index, _reindex ve tek bir atomik _aliases isteği olur. Gerçek çıktılarla: ilk geçişte remove_index, yarım uygulanan alias isteği ve must_exist, version_type external, reindex sürerken gelen değişikliklerin checkpoint'ten tekrar oynatılması, require_alias, shard sayısı kararı, ILM ile data stream ve snapshot/restore.
Sürüm notu: Bu yazıdaki örnekler Elasticsearch 9.5.6, .NET 10 ve Elastic.Clients.Elasticsearch 9.5.3 ile, 2. yazıda kurduğumuz lab'da ve 5. yazıdaki SQL Server senkronizasyonuyla çalıştırılmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için kurduğumuz arama, 3. yazıdan beri tek bir index'e bağlı: books. API, senkronizasyon worker'ı, lab komutları ve testler bu adı kullanıyor. 8. yazıda title.sayt ve title.complete alanlarını denemek için eklediğimiz ama API'nin hiç kullanmadığı iki alan var; ikisi index'te boşuna yer kaplıyor. Mapping'i yerinde değiştiremediğimizi 3. yazıda görmüştük, yol yeni bir index. Bu yüzden şablondan books-v2'yi açtık, veriyi kopyaladık ve uygulamanın adı değişmesin diye books adında bir alias'ı yeni index'e yönlendirmek istiyoruz:
POST /_aliases
{
  "actions": [
    { "add": { "index": "books-v2", "alias": "books" } }
  ]
}
Bu istek ne döndürür? Dönmüyorsa önce DELETE /books çalıştırıp sonra alias'ı eklemek güvenli olur mu? Bu iki istek arasında senkronizasyon worker'ı books'a bir kitap yazarsa ne olur?
Alias: Uygulama Gerçek Index Adını Bilmemeli
Cevap:
{
  "error": {
    "type": "invalid_alias_name_exception",
    "reason": "Invalid alias name [books]: an index, data stream, ESQL view, or ESQL dataset exists with the same name as the alias"
  },
  "status": 400
}
Alias, bir veya birden çok index'e verilen ikinci bir ad. Arama ve yazma istekleri alias'a gider, Elasticsearch onları arkadaki index'e yönlendirir. Ama alias ile index aynı adı paylaşamıyor. Önce books'u silmek ise iki istek arasında bir boşluk bırakıyor: o anda gelen arama 404 alır, gelen yazma ise daha kötüsünü yapar. Uygulamanın API key'inde books* için create_index yetkisi var ve Elasticsearch olmayan bir index'e yazılınca onu varsayılan olarak kendisi oluşturuyor. Bunu bir yazım hatasıyla denedim:
PUT /books-typo/_doc/1
{ "title": "Dune", "price": "520.0" }

{"_index":"books-typo","_id":"1","_version":1,"result":"created", ...}

GET /books-typo/_mapping
{"books-typo":{"mappings":{"properties":{"price":{"type":"text","fields":{"keyword":{"type":"keyword","ignore_above":256}}},...}}}}
Analyzer'sız, dynamic: strict'siz, fiyatı text olan bir index: 3. yazıda kaçtığımız dynamic mapping'in ta kendisi. Doğru yol, silmeyi ve alias eklemeyi aynı istekte yapmak. _aliases API'sinin remove_index action'ı tam bunun için var:
POST /_aliases
{
  "actions": [
    { "add": { "index": "books-v2", "alias": "books" } },
    { "remove_index": { "index": "books" } }
  ]
}

{"acknowledged":true,"errors":false}
Dokümana göre bir istekteki action'lar birlikte uygulanıyor ve remove_index'ler dizideki sırasından bağımsız olarak önce çalışıyor. "Birlikte" sözünün sınırlarını boş index'lerle denedim. İstekteki bir index yoksa bütün istek 404 ile reddediliyor ve hiçbir şey değişmiyor. Ama remove action'ındaki alias yoksa durum farklı: HTTP 200, "errors": true, add uygulanmış, remove uygulanmamış ve alias iki index'i birden gösteriyor. O hâldeyken alias'a yazmaya çalışınca:
{
  "error": {
    "type": "illegal_argument_exception",
    "reason": "no write index is defined for alias [demo]. The write index may be explicitly disabled using is_write_index=false or the alias points to multiple indices without one being designated as a write index"
  },
  "status": 400
}
Okumalar iki index'ten birden sonuç getirir (aynı kitap iki kez), yazmalar durur. remove'a "must_exist": true eklendiğinde aynı istek 404 dönüyor ve hiçbiri uygulanmıyor; geçişlerde bunu her zaman kullan. Dokümanda ve client'ta remove_index için de must_exist var, ama 9.5.6 onu [remove_index] unknown field [must_exist] diyerek reddediyor; orada gerek de yok, çünkü olmayan index zaten bütün isteği düşürüyor.
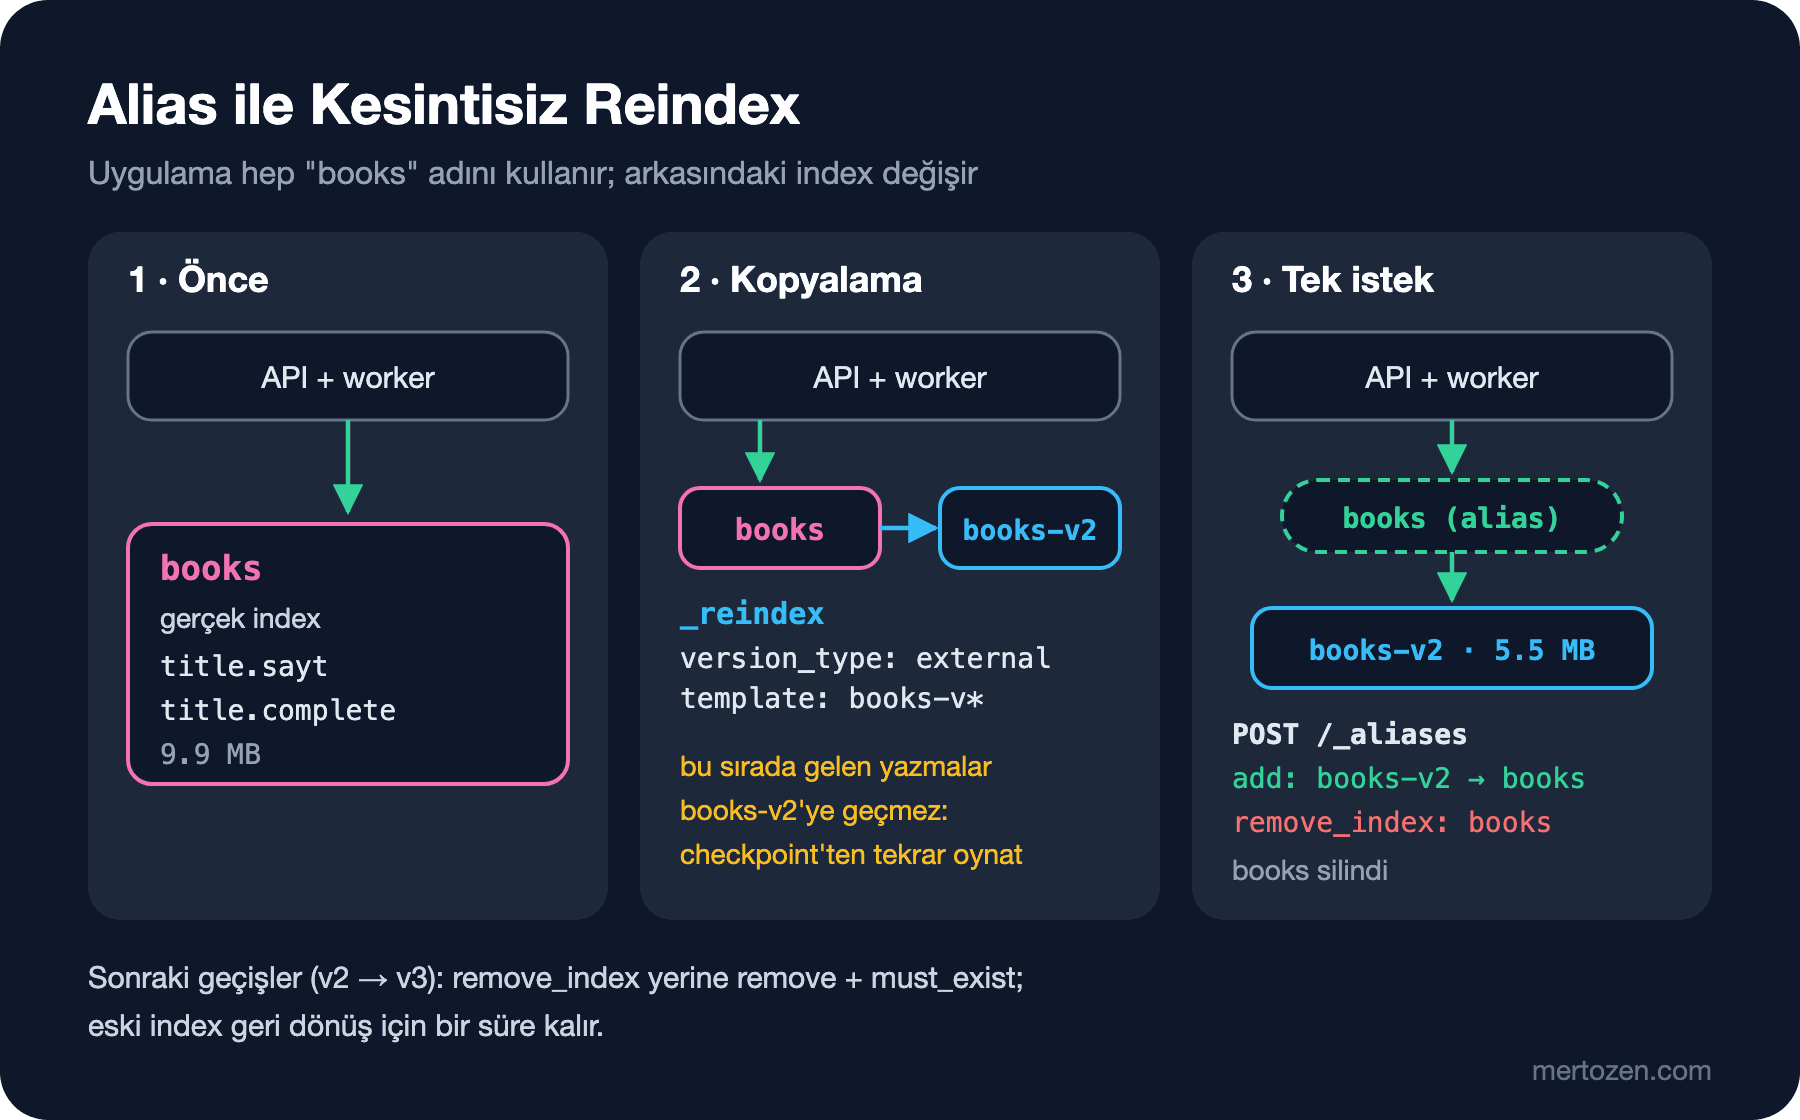
Fikir, Deployment Stratejileri serisinin "Blue-Green Deployment: Nginx ile İki Environment, App Service Slot'ları ve Anında Geri Dönüş" yazısındakiyle aynı: yeni sürümü yanda hazırla, trafiği tek hamlede çevir, eskisini geri dönüş için bir süre tut. Burada load balancer'ın yerini alias alıyor. İlk geçiş bir istisna: books gerçek bir index olduğu için onu silmek zorundayız ve geri dönülecek bir eski index kalmıyor. Sonraki geçişlerde (books-v2 → books-v3) remove_index yerine remove kullanılıyor ve eski index yerinde duruyor.
Index Template ve Component Template
Her yeni sürümde index'i JSON dosyasından elle açmak yerine Elasticsearch'e bir kalıp veriyoruz: adı books-v*'a uyan her index aynı analysis ve mapping'le açılsın. Index template'in parçaları component template'ler; birden çok index template'in paylaşabileceği ayar blokları. Lab'a templates komutunu ekledik:
// Shard ve replica sayısı ortama bağlı: kendi component template'inde duruyor.
JsonObject environment = new()
{
    ["template"] = new JsonObject
    {
        ["settings"] = new JsonObject { ["number_of_shards"] = 1, ["number_of_replicas"] = replicas }
    },
    ["_meta"] = new JsonObject { ["description"] = "Shard and replica counts for this environment" }
};
await PutAsync(client, "/_component_template/bookstore-env", environment);

// Analysis ve mapping testlerin de kullandığı dosyadan geliyor; yalnız ortam ayarları çıkarılıyor.
JsonObject definition = JsonNode.Parse(await File.ReadAllTextAsync(Path.Combine("search", "books.index.json")))!.AsObject();
JsonObject settings = definition["settings"]!.AsObject();
settings.Remove("number_of_shards");
settings.Remove("number_of_replicas");

JsonObject template = new()
{
    ["index_patterns"] = new JsonArray(IndexPattern),
    ["priority"] = 200,
    ["composed_of"] = new JsonArray("bookstore-env"),
    ["template"] = definition.DeepClone(),
    ["_meta"] = new JsonObject { ["source"] = "search/books.index.json" }
};
await PutAsync(client, $"/_index_template/{SearchClientFactory.BooksIndex}", template);
Mapping için tek kaynak hâlâ search/books.index.json: 10. yazıdaki Testcontainers testleri index'i bu dosyadan açıyor, template de ondan üretiliyor. Bu yazıda dosyadan title.sayt ve title.complete'i çıkardık; production'da bir mapping değişikliği her zaman bu sırayla gelir: önce dosya ve testler, sonra template, sonra yeni index. Komutu çalıştırınca:
dotnet run --project src/Bookstore.SearchLab -- templates
PUT /_component_template/bookstore-env: HTTP 200 {"acknowledged":true}
PUT /_index_template/books: HTTP 200 {"acknowledged":true}
Simulated books-v0: shards 1, replicas 0, title fields: autocomplete, en, folded, keyword, sort, tr
Son satır _simulate_index API'sinden: books-v0 adında bir index açılsaydı hangi ayarları alacağını, index oluşturmadan gösteriyor. Template'i değiştirdikten sonra bir kez buna bakmak, "neden mapping'im uygulanmadı" sorusunun çoğunu baştan çözüyor.
Birkaç kural. Bir index'e birden çok index template uyarsa yalnız priority'si en yüksek olan uygulanıyor; Elasticsearch'ün kendi template'leri (logs-*-*, metrics-*-* gibi) 100 önceliğinde, bu yüzden kendi kalıplarını bunlarla çakıştırma. composed_of'taki component template'ler sırayla birleşiyor, sonra gelen öncekini eziyor; index template'in kendi template bloğu hepsini eziyor; index oluşturma isteğinde verilen ayar ise template'i eziyor. Template yalnız index oluşturulurken uygulanıyor; değiştirmek mevcut index'lere dokunmuyor. Kalıbı bilerek books* değil books-v* yaptık: books-typo gibi kazara oluşan bir index template'i almasın, alias adı da kalıba girmesin.
Template ve alias yönetimi uygulamanın işi değil. 2. yazıdaki bookstore-api-dev key'i ile denersen:
action [indices:admin/index_template/put] is unauthorized for API key id [<id>] of user [elastic], this action is granted by the cluster privileges [manage_index_templates,manage,all]

action [indices:admin/aliases] is unauthorized for API key id [<id>] of user [elastic] on indices [books-v2], this action is granted by the index privileges [manage,all]
Geçişi yapan araca ayrı ve kısa ömürlü bir key verdik; lab komutları onu BOOKSTORE_ES_ADMIN_API_KEY'den okuyor:
POST /_security/api_key
{
  "name": "bookstore-search-admin-dev",
  "expiration": "1d",
  "role_descriptors": {
    "bookstore-search-admin": {
      "cluster": ["manage_index_templates", "monitor"],
      "indices": [
        { "names": ["books*"], "privileges": ["manage", "read", "write", "create_index"] }
      ]
    }
  }
}
books-v2: _reindex ve Atomik Geçiş
Geçişin tamamı migrate komutunda. Önce books'un neyi gösterdiğine bakıyor; GET /books hem alias hem de gerçek index için cevap veriyor ve anahtar olarak gerçek index adını döndürüyor:
GetIndexResponse current = await client.Indices.GetAsync(alias);
string source = current.Indices.Keys.Single();
bool isAlias = source != alias;

// Template (books-v*) analysis, mapping, shard ve replica'yı veriyor; yükleme boyunca refresh yok.
CreateIndexResponse created = await client.Indices.CreateAsync(new CreateIndexRequest(target)
{
    Settings = new IndexSettings { RefreshInterval = Duration.MinusOne }
});

// Kopyalama arka planda. External version'lar SQL Server'daki RowVer değerlerini koruyor (5. yazı).
ReindexResponse started = await client.ReindexAsync(new ReindexRequest
{
    Source = new Elastic.Clients.Elasticsearch.Core.Reindex.Source { Indices = source },
    Dest = new Elastic.Clients.Elasticsearch.Core.Reindex.Destination { Index = target, VersionType = VersionType.External },
    RequestsPerSecond = requestsPerSecond,
    WaitForCompletion = false
});

GetReindexResponse progress;
do
{
    await Task.Delay(TimeSpan.FromSeconds(2));
    progress = await client.GetReindexAsync(started.Task!);
    Console.WriteLine($"  {watch.Elapsed.TotalSeconds,4:F0} s: {progress.Status?.Created:N0} / {progress.Status?.Total:N0} created");
}
while (!progress.Completed);
Üç ayrıntı önemli. _reindex mapping'i ve ayarları kopyalamıyor, yalnız document'ları kopyalıyor; hedef index'in önceden doğru mapping'le açılmış olması gerekiyor, template'in işi bu. version_type: external olmadan her kitap yeni index'te _version 1 ile başlardı ve worker'ın RowVer'e dayanan version'ları anlamını kaybederdi; 8. yazıda _update_by_query'nin version'ları nasıl artırdığını görmüştük. WaitForCompletion = false ile istek hemen bir task id döndürüyor ve ilerlemeyi 9.5.0'da eklenen GET /_reindex/<task_id> ile izliyoruz (client'ta GetReindexAsync); eski sürümlerde aynı bilgi GET /_tasks/<task_id>'te.
Kopyalama bitince refresh aralığı geri açılıyor, iki index'teki kitap sayısı karşılaştırılıyor ve eşitse alias tek istekte çevriliyor:
UpdateAliasesResponse swapped = await client.Indices.UpdateAliasesAsync(new UpdateAliasesRequest
{
    Actions =
    [
        new AddAction { Index = target, Alias = alias },
        isAlias
            ? new RemoveAction { Index = source, Alias = alias, MustExist = true }
            // İlk seferde "books" gerçek bir index: aynı istekte silinmeli, yoksa alias adı dolu.
            // MustExist yok: 9.5.6 remove_index'te onu reddediyor, olmayan index de zaten bütün isteği düşürüyor.
            : new RemoveIndexAction { Index = source }
    ]
});AddAction, RemoveAction ve RemoveIndexAction, implicit operator'lerle IndexUpdateAliasesAction'a dönüşüyor; 10. yazıda anlattığımız container'ların object initializer'daki karşılığı. Sayıları _count ile karşılaştırıyoruz, _cat/indices'taki docs.count ile değil: o, nested yazarları da ayrı document olarak sayıyor (20.036 kitap için 40.078). Çalıştırınca (worker ve API çalışırken):
dotnet run --project src/Bookstore.SearchLab -- migrate books-v2 --rps 2000
"books" -> books (a plain index, not an alias yet)
Created books-v2 from the template, refresh_interval -1
Reindex task <task-id> started, requests_per_second 2000
     2 s: 4,000 / 20,036 created
     4 s: 8,000 / 20,036 created
     6 s: 12,000 / 20,036 created
     8 s: 16,000 / 20,036 created
    10 s: 19,000 / 20,036 created
    12 s: 20,036 / 20,036 created
books-v2: 20,036 books, books: 20,036 books
"books" -> books-v2 (index books deleted), 12.2 s in total

GET /_cat/indices/books*?v&h=index,docs.count,store.size
index    docs.count store.size
books-v2      40078      5.5mb
Eski index 9,9 MB'tı, yenisi 5,5 MB; farkın büyük kısmı çıkardığımız iki alan (8. yazıda title.sayt'ın tek başına 2,6 MB olduğunu ölçmüştük). --rps 2000, requests_per_second parametresi: Elasticsearch saniyede en fazla 2.000 document yazacak şekilde batch'lerin arasına bekleme koyuyor, çıktıdaki iki saniyede 4.000'lik ilerleme bu. 20 bin kitapta gerek yok; ama milyonlarca document'lık bir index'i canlı cluster'da kopyalarken kullanıcı aramalarıyla aynı disk ve CPU'yu paylaşıyorsun. Hız ayarını çalışan bir task'ta POST /_reindex/<task_id>/_rethrottle?requests_per_second=... ile değiştirebilirsin; büyük index'lerde slices: auto kopyalamayı shard başına paralel işlere bölüyor.
Alias çevrildikten sonra API'ye, worker'a ve lab komutlarına dokunmadık; hepsi books'a gidiyor ve artık books-v2'yi görüyor. Bir istisna çıktı. 7. yazıdaki rank-eval komutu geçişten hemen sonra:
dotnet run --project src/Bookstore.SearchLab -- rank-eval --tuned
nDCG@5 0.000
  0.000  ince memed                 top: 9781000000016(-), 9781000000023(-), 9781000000238(-)
  0.000  crime and punishment       top: 9781000000306(-), 9781000000245(-), 9781000000146(-)
Doğru kitaplar yine ilk sırada ama hepsi "puanlanmamış" ((-)). _rank_eval, verdiğimiz puanları hit'lerle _index ve _id ikilisinden eşleştiriyor; hit'ler gerçek index adını (books-v2) taşıyor, puanlar ise books diyordu. Düzeltme, puanlara alias'ın arkasındaki index'i yazmak:
ElasticsearchClient client = LabClient.Create();
// Hit'ler alias'ı değil gerçek index'i (books-v2) gösteriyor: puanlar da aynı index'i yazmalı (11. yazı).
string index = (await client.Indices.GetAsync(SearchClientFactory.BooksIndex)).Indices.Keys.Single();
Sonrasında nDCG@5 yine 0,979. Kodunda hit.Index'i bir sabitle karşılaştıran her yer bu geçişte aynı şekilde kırılır.
Reindex Sürerken Gelen Değişiklikler
Geçiş boyunca worker çalışıyordu. Reindex başladıktan beş saniye sonra SQL Server'da iki kitabı değiştirdim:
UPDATE dbo.Books SET Price = 189.90 WHERE Isbn = '9781000000030';
UPDATE dbo.Books SET StockQuantity = 0 WHERE Isbn = '9781000000221';
Isbn Title Price StockQuantity RowVer
9781000000030 Kürk Mantolu Madonna 189.90 120 0x000000000000566B
9781000000221 Dune 520.00 0 0x000000000000566CWorker bunları birkaç saniye içinde yazdı (Synced 2 changes (2 indexed, 0 deleted, 0 already up to date) up to RowVer 0x000000000000566C), ama geçişten sonra:
GET /books/_doc/9781000000030?filter_path=_index,_version,_source.price
{"_index":"books-v2","_version":22121,"_source":{"price":165.0}}
Kürk Mantolu Madonna yeni index'te eski fiyatıyla duruyor. _reindex, kaynak index'i başladığı andaki hâliyle okuyor; sonradan gelen yazmalar eski index'e gitti ve eski index geçişin son adımında silindi. Version 22121 (0x5669) bunu doğruluyor: değişiklikten önceki RowVer.
Çözüm, 5. yazıda checkpoint'i geri alarak yaptığımız denemede: senkronizasyonu güvenle tekrar oynatabiliyoruz, çünkü version'lar external ve Elasticsearch eski bir version'ı reddediyor. Geçişten önce checkpoint'i not ettim (SELECT LastRowVer FROM dbo.SearchSyncState → 0x000000000000566A), geçişten sonra worker'ı durdurup checkpoint'i geri aldım ve yeniden başlattım:
UPDATE dbo.SearchSyncState SET LastRowVer = 0x000000000000566A WHERE Name = 'books';info: Bookstore.SearchSync.SearchSyncWorker[0]
Starting from RowVer 0x000000000000566A
info: Bookstore.SearchSync.SearchSyncWorker[0]
Synced 2 changes (2 indexed, 0 deleted, 0 already up to date) up to RowVer 0x000000000000566C
GET /books/_doc/9781000000030?filter_path=_index,_version,_source.price
{"_index":"books-v2","_version":22123,"_source":{"price":189.9}}Reindex'in zaten kopyaladığı bir değişiklik olsaydı satırda "already up to date" (409) görecektik; tekrar oynatmanın hiçbir zararı yok. Daha basit bir yol, geçiş boyunca worker'ı durdurmak: değişiklikler SQL Server'da bekler, alias çevrildikten sonra worker kaldığı yerden devam eder. Bedeli, arama sonuçlarının geçiş süresi kadar eski kalması; 12 saniyede sorun değil, saatler süren bir reindex'te sorun. İkisinde de anahtar aynı: index'i SQL Server'daki RowVer ile yeniden üretilebilir tutmak.
Worker'a bir satır daha ekledik:
BulkRequest request = new(SearchClientFactory.BooksIndex)
{
    // 11. yazı: "books" bir alias olmalı. Bu olmadan, yanlışlıkla yapılan bir DELETE'ten sonraki yazma
    // dynamic mapping'li düz bir "books" index'i oluşturur.
    RequireAlias = true,
    Operations = [.. batch.Changes.Select(ToOperation)]
};
PUT /books-typo/_doc/1?require_alias=true
{ "title": "Dune", "price": "520.0" }
{"error":{"type":"index_not_found_exception","reason":"no such index [books-typo] and [require_alias] request flag is [true] and [books-typo] is not an alias", ...},"status":404}Bu bayrak geçişten sonra açılmalı; ilk geçişten önce books gerçek bir index olduğu için worker her batch'te bu hatayı alırdı.
Shard ve Replica Sayısı
GET /_cat/shards/books*?v&h=index,shard,prirep,state,docs,store
index    shard prirep state    docs store
books-v2 0     p      STARTED 40078 5.5mb
Primary shard sayısı index açılırken belirleniyor ve sonradan değiştirilemiyor; yalnız _split (artırmak), _shrink (azaltmak) ya da reindex ile değişiyor. Elastic'in shard boyutlandırma rehberinin önerileri: shard başına 10–50 GB ve 200 milyondan az document. Bookstore'un 5,5 MB'lık index'i bu aralığın binlerce kat altında, bu yüzden tek shard doğru karar. Küçük bir index'i "ileride büyür" diye beş shard'a bölmek, her aramanın beş parçaya gidip sonuçları birleştirmesi demek; 9. yazıda beş shard'lı index'te terms aggregation'ın yanlış sonuç verdiğini görmüştük. Cluster her shard için bellek ve master node'da cluster state'te yer ayırıyor; varsayılan sınır node başına 1.000 shard (cluster.max_shards_per_node, lab'da bu değeri include_defaults ile okudum). Ölçek büyüdüğünde yeni bir books-vN daha fazla shard'la açılır ve alias çevrilir; yani shard sayısı kararı geri alınabilir bir karar.
Replica sayısı ise canlı değiştirilebilir ve bu yüzden bookstore-env component template'inde. Lab'da tek node var, replica 0; production'da en az 1 olmalı, aksi hâlde bir node kaybı index'in bir kısmını kaybetmek demek. 5. yazıda büyük ilk yüklemede replica'yı geçici olarak 0 yapıp sonra açmayı önermiştik; template'te ortama göre değer, yükleme sırasında geçici değer.
ILM ve Data Stream'e Kısa Bakış
Kitap kataloğu zamanla büyüyen ama eskimeyen bir veri: her kitap güncellenebilir, alias ile sürümlenir. Zaman serisi veride durum farklı. Bookstore'da kullanıcıların ne aradığını (7. yazıdaki judgment listesini beslemek için) kaydetmek istediğimizi düşünelim: sadece eklenir, hiç güncellenmez ve 90 gün sonra değeri kalmaz. Bunun için ILM (Index Lifecycle Management; index'leri yaşlarına ve boyutlarına göre otomatik yöneten özellik) ve data stream var:
PUT /_ilm/policy/search-queries
{
  "policy": {
    "phases": {
      "hot": { "actions": { "rollover": { "max_primary_shard_size": "50gb", "max_age": "7d" } } },
      "delete": { "min_age": "90d", "actions": { "delete": {} } }
    }
  }
}

PUT /_index_template/search-queries
{
  "index_patterns": ["search-queries*"],
  "data_stream": {},
  "priority": 200,
  "template": {
    "settings": { "index.lifecycle.name": "search-queries", "number_of_replicas": 0 },
    "mappings": {
      "properties": {
        "@timestamp": { "type": "date" },
        "query": { "type": "keyword" },
        "hits": { "type": "integer" }
      }
    }
  }
}

POST /search-queries/_doc
{ "@timestamp": "2026-11-14T17:10:00Z", "query": "kurk mantolu", "hits": 1 }

{"_index":".ds-search-queries-2026.11.14-000001", "result":"created", ...}
Data stream da bir ad, arkasında backing index'ler var; yazmalar her zaman en yenisine gidiyor. Rollover, koşullardan biri sağlanınca (en büyük primary shard 50 GB ya da en eski document 7 gün) yeni bir backing index açıyor; delete phase 90 günü dolan index'i bütünüyle siliyor. Tek tek document silmek yerine bütün bir index'i silmek çok daha ucuz. Elle bir rollover:
POST /search-queries/_rollover
{"old_index":".ds-search-queries-2026.11.14-000001","new_index":".ds-search-queries-2026.11.14-000002","rolled_over":true, ...}
ILM koşulları sürekli değil periyodik kontrol ediyor (indices.lifecycle.poll_interval, varsayılan 10 dakika); rollover'ın tam 7. günde olmasını bekleme. Daha yeni ve daha basit bir alternatif data stream lifecycle: phase'ler yerine yalnız saklama süresi (data_retention) veriliyor. Log ve metric için data stream kullanımı, Observability serisinin konusu. Arama index'imiz için ILM gerekmiyor; demo'yu sildim.
Snapshot ve Restore
Yeni bir index sürümüne geçmeden önce eskisinin yedeği iyi bir alışkanlık. Elasticsearch'te yedek, data klasörünü kopyalamak değil, snapshot API'si. Lab'da paylaşılan dosya sistemi repository'si kullandık: compose.yaml'a path.repo=/usr/share/elasticsearch/snapshots ve bir volume ekledik. İlk denememde repository kaydı access_denied_exception ile düştü: volume root'a aitti, Elasticsearch ise kendi kullanıcısıyla çalışıyor. Klasörü Dockerfile'da oluşturunca (RUN mkdir -p /usr/share/elasticsearch/snapshots) Docker yeni volume'ü o klasörün sahibiyle açıyor.
PUT /_snapshot/lab-backups
{ "type": "fs", "settings": { "location": "lab-backups" } }

PUT /_snapshot/lab-backups/books-2026.11.14?wait_for_completion=true
{ "indices": "books-v2", "include_global_state": false, "feature_states": ["synonyms"] }

{"snapshot":{"snapshot":"books-2026.11.14", "version":"9.5.6", "indices":["books-v2",".synonyms-2"], "state":"SUCCESS",
 "duration_in_millis":201, "shards":{"total":2,"failed":0,"successful":2},
"feature_states":[{"feature_name":"synonyms","indices":[".synonyms-2"]}]}}feature_states'e dikkat: 4. yazıdaki bookstore-synonyms seti bir system index'inde (.synonyms-2) duruyor ve index'in mapping'i ona bağlı. Yalnız books-v2'yi yedekleyip boş bir cluster'a dönersen önce synonyms setini yeniden oluşturman gerekir; feature state ile birlikte geliyor. Restore'u var olan index'e dokunmadan, yeni bir adla denedim:
POST /_snapshot/lab-backups/books-2026.11.14/_restore?wait_for_completion=true
{ "indices": "books-v2", "rename_pattern": "books-(.+)", "rename_replacement": "restored-books-$1", "include_aliases": false }

GET /restored-books-v2/_count
{"count":20036, ...}
Production'da repository paylaşılan bir dosya sistemi değil, bir object storage olur: S3 (Amazon'un nesne depolama servisi), Azure Blob Storage ya da Google Cloud Storage. Snapshot'lar artımlı; her snapshot yalnız yeni segment'leri yazıyor. Düzenli snapshot ve "SQL Server'dan yeniden index'leriz" yaklaşımının ne kadar sürdüğünü 12. yazıda ölçeceğiz.
Üretimde Dikkat
Geçişi bir script'e bağla, elle Dev Tools'tan yapma. migrate komutundaki sıra (template'ten index, yükleme ayarları, reindex, ayarları geri al, sayıları karşılaştır, alias'ı çevir) her seferinde aynı olmalı ve sayılar tutmazsa alias'a dokunmadan durmalı. Kitap sayısına ek olarak 7. yazıdaki rank-eval'i yeni index'e karşı alias'ı çevirmeden önce çalıştırmak, mapping değişikliğinin relevance'ı bozup bozmadığını gösterir.
Eski index'i hemen silme. Sonraki geçişlerde books-v2'yi bir gün ya da bir deploy döngüsü tut; sorun çıkarsa geri dönüş tek bir _aliases isteği. Ama geri döndüğünde arada gelen değişiklikleri yine checkpoint'ten tekrar oynatman gerektiğini unutma.
Disk alanını hesapla. Geçiş sırasında iki index birlikte duruyor; büyük bir index'te bu, diskin geçici olarak iki katı dolması demek. Disk doluluk eşiklerini (watermark) 12. yazıda göreceğiz; aşılırsa Elasticsearch yeni shard'ları yerleştirmeyi bırakıyor.
Geçiş anahtarı uygulama anahtarından ayrı olsun. Template, alias ve index silme yetkileri yalnız geçişi yapan araçta; uygulama books*'ta okuma ve yazmayla kalıyor. Admin key'e kısa bir expiration ver.
Sık Düşülen Tuzaklar
Uygulamayı gerçek index adına bağlamak. Alias yoksa her mapping değişikliği bir kesinti ya da kod değişikliği demek. İlk günden books-v1 + books alias'ı.
Önce silip sonra alias eklemek. Aradaki boşlukta aramalar 404 alır, yazmalar dynamic mapping'li bir index oluşturur. remove_index aynı istekte; yazan uygulamada require_alias.
must_exist'i unutmak. Alias'ta olmayan bir index'i remove ile çıkarmaya çalışan istek yarım uygulanıyor ve alias iki index'i birden gösteriyor.
Mapping'i yerinde değiştirmeye çalışmak. Yeni alan ya da multi-field eklemek mümkün (yeni bir analyzer gerekiyorsa 8. yazıdaki gibi index'i kapatarak), ama mevcut bir alanın tipini ya da analyzer'ını değiştirmek değil; bir alanı mapping'den çıkarmak da değil. Yol yeni index ve alias.
Reindex sırasında gelen yazmaları unutmak. _reindex başladığı andaki veriyi kopyalıyor; checkpoint'ten tekrar oynatma ya da worker'ı durdurma planı olmadan geçiş veri kaybettirir.
Küçük Bir Deneme
★☆☆ migrate books-v3'ü çalıştır. Bu kez çıktıda ne değişiyor? books-v2 silindi mi? Sonra books alias'ını tek istekle books-v2'ye geri çevir ve books-v3'ü sil.
★★☆ 6. yazıda yazar adını kök seviyede aranabilir yapmak için copy_to'yu reindex'e bırakmıştık. authors.name'e "copy_to": "authorNames" ve köke bir authorNames text alanı ekle, templates ve migrate books-v3'ü çalıştır, authorNames üzerinde bir match sorgusu dene. Testlerin hâlâ geçtiğini kontrol et.
★★★ migrate'i büyük bir index için güvenli hâle getir: reindex başlamadan önce SQL Server'daki checkpoint'i kaydetsin, alias çevrildikten sonra worker'a "bu RowVer'den itibaren tekrar oynat" desin (ör. SearchSyncState'e bir satır). --rps 500 ile çalıştırırken SQL Server'da değişiklik yap ve hiçbirinin kaybolmadığını göster.
Bir sonraki yazıda Elasticsearch'ü production'da işletmeye geçiyoruz: TLS (istemci ile cluster arasındaki trafiği şifreleyen protokol), uygulama başına rol ve API key, heap ve disk eşikleri, slow log ve cluster sağlığı, sık görülen hataların teşhisi ve yedekten dönmenin gerçekte ne kadar sürdüğü.