

String Arama Algoritmaları: Naive, KMP, Rabin-Karp, Aho-Corasick ve .NET'in IndexOf/SearchValues<string>'i
Tek pattern için KMP metinde hiç geri dönmeyerek O(n + m) garanti eder; çok pattern için Aho-Corasick trie'ye failure link'ler ekleyip hepsini tek geçişte bulur. C# ile naive, KMP, Rabin-Karp ve Aho-Corasick'i yazıyor, .NET'in vektörize IndexOf'u ve SearchValues<string>'in içindeki Teddy ve Aho-Corasick'le ölçüyor, Türkçe I tuzağını gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve C# 14 ile derlenip xUnit v3 4.0.2 testleriyle doğrulanmıştır; ölçümler BenchmarkDotNet 0.15.8 ile alınmıştır.
Önce Tahmin Et
10.000 tane "a" harfinden oluşan bir metinde, 99 tane "a" ve sonunda bir "b" olan 100 karakterlik bir pattern arıyoruz. Pattern metinde yok. En düz algoritma her başlangıç pozisyonunu dener, eşleşmeyen ilk karakterde bir sağa kayar ve pattern'i baştan karşılaştırır. Kaç karakter karşılaştırması yapar: 10.000 civarı mı, 20.000 mi, yoksa bir milyon mu?
İkinci soru: sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı), kitap yorumlarını yayınlamadan önce 500 kelimelik bir yasaklı kelime listesine karşı kontrol ediyor. Her kelime için ayrı bir Contains çağırmak ile bütün listeyi tek seferde arayan bir yapı arasında kaç kat fark beklersin?
Naive Arama ve Worst Case'i
// Her başlangıç pozisyonunu dene; eşleşmezse bir kay ve pattern'e baştan başla
public static int IndexOf(string text, string pattern, out long comparisons)
{
    comparisons = 0;
    for (int start = 0; start <= text.Length - pattern.Length; start++)
    {
        int j = 0;
        while (j < pattern.Length)
        {
            comparisons++;
            if (text[start + j] != pattern[j]) break;
            j++;
        }

        if (j == pattern.Length) return start;
    }

    return -1;
}
text n=10000, pattern m=100
naive comparisons: 990,100
KMP comparisons: 19,901Bir milyona yakın: 9.901 başlangıç pozisyonunun her birinde 100 karşılaştırma. Naive aramanın worst case'i O(n·m); tahmin ettiğin "10.000 civarı", gerçek metinlerde çoğu zaman gördüğün durum, çünkü eşleşmeme genelde ilk bir iki karakterde olur. Worst case'in ne demek olduğu ve neden ayrıca düşünüldüğü Big-O ve Complexity serisinin "Big-O Notation Nedir: Büyüme Hızı, O, Ω, Θ ve Worst Case" yazısında. Sorun, kullanıcının kontrol ettiği girdide worst case'i bir saldırganın üretebilmesi: tekrar eden karakterlerden oluşan bir yorum ve tekrar eden bir pattern.
KMP: Metinde Geri Dönmemek
Naive aramanın israfı, 99 karakter eşleştikten sonra öğrendiğini unutması. Knuth, Morris ve Pratt'ın 1977'de yayımladığı ve kısaca KMP (yazarlarının soyadlarının baş harfleri) denen algoritma bu bilgiyi saklar: pattern'in her prefix'i için, kendisinin hem prefix'i hem suffix'i olan en uzun parçanın uzunluğunu önceden hesaplar. Buna failure function (ya da prefix function) denir:
// failure[i] = pattern[..(i + 1)]'in hem prefix'i hem suffix'i olan en uzun (kendisi hariç) parçasının uzunluğu
public static int[] BuildFailure(string pattern)
{
    int[] failure = new int[pattern.Length];
    int k = 0;
    for (int i = 1; i < pattern.Length; i++)
    {
        while (k > 0 && pattern[i] != pattern[k]) k = failure[k - 1];
        if (pattern[i] == pattern[k]) k++;
        failure[i] = k;
    }

    return failure;
}
failure("ababaca") = [0, 0, 1, 2, 3, 0, 1]"ababa" prefix'inin değeri 3: "aba" hem başta hem sonda. Arama sırasında 5 karakter eşleşip altıncıda takılırsak pattern'i baştan başlatmak yerine "zaten 3 karakter eşleşiyor" diye devam ederiz. Metindeki index i hiç geri gitmez:
for (int i = 0; i < text.Length; i++)
{
    while (k > 0 && text[i] != pattern[k])
    {
        comparisons++;
        k = failure[k - 1]; // pattern içinde geri düş; i asla geri gitmez
    }

    comparisons++;
    if (text[i] == pattern[k]) k++;
    if (k == pattern.Length)
    {
        matches.Add(i - k + 1);
        k = failure[k - 1];
    }
}
Aynı girdide 19.901 karşılaştırma: 2n'nin altında. KMP'nin maliyeti O(n + m) ve bu bir garanti; girdinin ne kadar kötü olduğu fark etmez. Eşleşme bulunca da k = failure[k - 1] ile devam ettiğimiz için örtüşen eşleşmeleri de bulur: "aaaa" içinde "aa" için 0, 1 ve 2.
Rabin-Karp: Rolling Hash ile Çoklu Pattern
Rabin ve Karp'ın 1987 tarihli fikri karakterleri değil hash'leri karşılaştırmak. Metin üzerinde m uzunluğunda bir pencere kayar; pencerenin hash'i, çıkan karakterin katkısını çıkarıp gireni ekleyerek O(1)'de güncellenir (rolling hash). Hash eşleşirse gerçek bir karşılaştırmayla doğrularız, çünkü iki farklı string'in hash'i aynı çıkabilir:
ulong window = Hash(text.AsSpan(0, m));
for (int start = 0; ; start++)
{
    if (byHash.TryGetValue(window, out List<string>? candidates))
    {
        foreach (string c in candidates)
        {
            if (text.AsSpan(start, m).SequenceEqual(c)) matches.Add((start, c));
        }
    }

    if (start + m == text.Length) break;
    // Kaydır: text[start]'ı çıkar, sola kaydır, text[start + m]'i ekle
    window = AddMod(window, Mod - MulMod(text[start], highPower));
    window = AddMod(MulMod(window, Base), text[start + m]);
}
Modül olarak 2⁶¹−1 (bir Mersenne asal sayısı) kullandık; çarpım UInt128 ile taşmadan hesaplanıyor. Rabin-Karp'ın asıl gücü byHash'te: aynı uzunluktaki binlerce pattern'in hash'ini bir Dictionary'ye koyup metni tek geçişte tarayabiliriz. İntihal tespiti tam olarak bu: orijinal metnin 20 karakterlik bütün pencerelerini pattern yapıp gönderilen metinde arıyoruz.
103 windows of 20 chars, 37 matching positions in the submission
copied: " his family takes control of the desert planet Arrakis, "
Ortalama maliyet O(n + m); hash'ler sık çakışırsa worst case yine O(n·m). İyi bir modül ve gerçek doğrulama bunu pratikte önler, ama garanti KMP'deki gibi deterministik değil.
Aho-Corasick: Trie ve Failure Link'ler
Yasaklı kelime listesindeki kelimelerin uzunlukları farklı; Rabin-Karp burada zorlanır. Aho ve Corasick'in 1975'te bir bibliyografya arama aracı için geliştirdiği algoritma, KMP'nin failure fikrini serinin 14. yazısındaki trie'ye uygular. Bütün pattern'ler bir trie'ye eklenir; sonra her node için "buradan bir karakter ilerleyemezsem, şu ana kadar okuduğumun en uzun suffix'i hangi node'a karşılık geliyor?" sorusunun cevabı, failure link, hesaplanır:
// Breadth-first: bir node'un failure link'i her zaman daha sığ bir node'u gösterir, o node zaten hazır
private void BuildFailureLinks()
{
    Queue<int> queue = new();
    foreach (int child in _next[0].Values) queue.Enqueue(child); // derinlik 1 köke düşer
    while (queue.Count > 0)
    {
        int node = queue.Dequeue();
        foreach ((char c, int child) in _next[node])
        {
            int f = _fail[node];
            while (f != 0 && !_next[f].ContainsKey(c)) f = _fail[f];
            _fail[child] = _next[f].TryGetValue(c, out int target) && target != child ? target : 0;
            _output[child].AddRange(_output[_fail[child]]); // "she" bulununca "he" de raporlanır
            queue.Enqueue(child);
        }
    }
}
Arama, KMP'deki döngünün trie üzerindeki karşılığı: geçiş yoksa failure link'i izle, varsa ilerle ve o node'da biten pattern'leri raporla. Makaledeki klasik örnek he, she, his ve hers pattern'leriyle "ushers" metni:
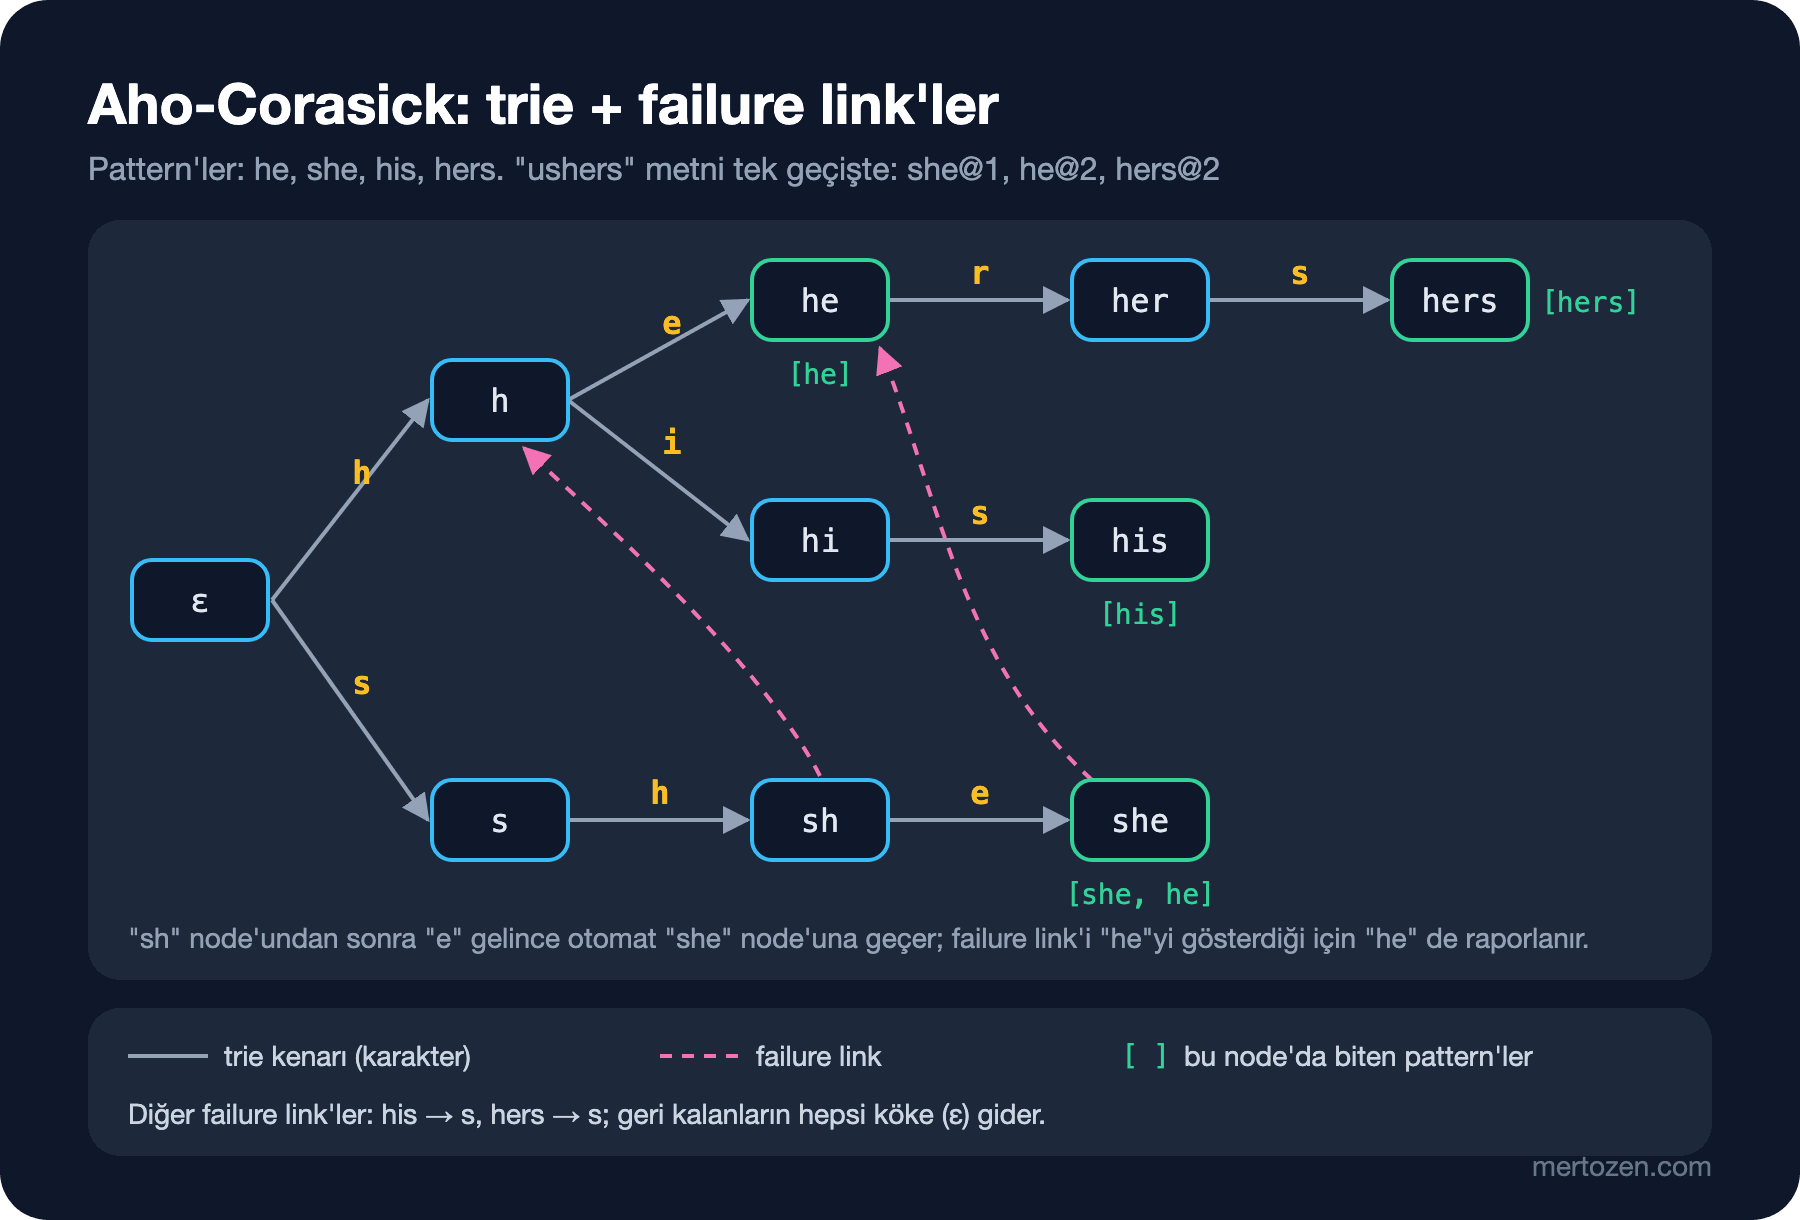
ushers -> she@1, he@2, hers@2Bookstore'un yorum moderasyonunda aynı yapı:
string[] banned = ["scam", "casino", "free money", "click here", "spam"];
AhoCorasick ac = new(banned);
string review = "Great book! Not a scam. Click here for free money at our casino.";
foreach ((int index, string word) in ac.FindAll(review.ToLowerInvariant()))
    Console.WriteLine($"{index,3}: {word}");
18: scam
24: click here
39: free money
57: casinoKitap açıklamasında yazar adlarını bulmak da aynı iş. "Jane Austen" ile "Austen" ikisi de listedeyse ikisi de raporlanıyor; hangisini tutacağın (en uzun eşleşme, ilk eşleşme) senin kararın:
 24: Mary Shelley
 41: Bram Stoker
 76: George Eliot
 94: Jane Austen
 99: Austen
Maliyet O(n + toplam pattern uzunluğu + eşleşme sayısı): metin bir kez okunur, pattern sayısı 5 de olsa 5.000 de olsa. Trie'nin bellek maliyeti (5 ifade için 33 node) serinin 14. yazısındaki gibi; her node'da bir Dictionary<char, int> tutmak pahalı, daha kompakt implementation'lar tek bir array'de tutar.
.NET Gerçeği: IndexOf ve SearchValues<string>
Kendi algoritmalarımızı BCL (.NET ile gelen temel class kütüphanesi) ile ölçtüm. Tek kelime: 100.000 karakterlik bir metnin sonunda "Middlemarch".
| Method                | Mean         | Ratio | Allocated |
|---------------------- |-------------:|------:|----------:|
| Naive                 |    31.097 us |  1.00 |         - |
| Kmp                   |    50.851 us |  1.64 |      72 B |
| IndexOfOrdinal        |     5.867 us |  0.19 |         - |
| IndexOfCurrentCulture | 1,063.311 us | 34.19 |         - |
Benchmark'ları tek tek çalıştırdım ama makinede paralel işler vardı; mutlak süreler makineye bağlı, karşılaştırılacak olan Ratio sütunu. İlk sürpriz KMP'nin naive'den yavaş olması. Normal metinde eşleşmeme neredeyse her zaman ilk karakterde olur, yani naive aramanın worst case'i hiç oluşmaz; KMP'nin failure array'i ve fazladan dalları ise her karakterde sabit bir maliyet ekler. KMP'nin değeri garantisinde, ortalama hızında değil. İkinci sonuç: string.IndexOf(string, StringComparison.Ordinal) naive aramadan 5 kat hızlı ve bunun sebebi asimptotik değil. Runtime kaynağına göre (dotnet/runtime, SpanHelpers.Char.cs) ordinal arama, pattern'in ilk karakterini ve ondan farklı son karakterlerinden birini SIMD (tek komutla birden çok veri üzerinde çalışan işlemci komutları) ile aynı anda onlarca pozisyonda karşılaştırıyor ve yalnız ikisi birden tutan adaylarda tam karşılaştırma yapıyor. Kaynakta açık bir worst case garantisi yok; adayların çoğu tutan patolojik girdilerde iş artar. Son satır ayrı bir ders: StringComparison vermezsen IndexOf(string) current culture ile karşılaştırır ve bu çok daha yavaştır.
Çok kelime için .NET 9 ile SearchValues<string> geldi. Yalnız Ordinal ve OrdinalIgnoreCase kabul ediyor:
SearchValues<string> sv = SearchValues.Create(banned, StringComparison.OrdinalIgnoreCase);
ReadOnlySpan<char> span = review;
Console.WriteLine($"ContainsAny: {span.ContainsAny(sv)}, first at {span.IndexOfAny(sv)}");
ContainsAny: True, first at 18Yazım günü (2026-11-15) dotnet/runtime'ın StringSearchValues.cs dosyasına baktım. Tek değerde vektörize bir tek string araması seçiliyor. Birden çok değerde, CPU SIMD destekliyorsa ve değer sayısı 80'i geçmiyorsa, en kısa değer en az 2 karakterse ve prefix'ler ASCII (128 karakterlik temel Latin karakter seti) ise Intel'in Hyperscan kütüphanesinden gelen Teddy algoritması kullanılıyor; Teddy'nin işleyemediği çok kısa girdiler için Rabin-Karp yedekte. Diğer bütün durumlarda kullanılan algoritma, bizim yazdığımız Aho-Corasick. Yani BCL aynı algoritmayı, uygun durumlarda üstüne SIMD ile bir ön tarama ekleyerek kullanıyor. Bu ayrıntılar sürümden sürüme değişebilir; değişmeyen, API'nin sözleşmesi.
Yasaklı kelime senaryosu: 1.000 yorum, her biri 500 karakter; yasaklı kelimeler 5–9 harflik rastgele diziler, yani yorumlar temiz. Gerçek hayatta da yorumların çoğu temizdir ve en pahalı durum budur, çünkü arama erken bitmez.
| Method                  | BannedCount | Mean         | Ratio | Allocated |
|------------------------ |------------ |-------------:|------:|----------:|
| LoopContains            | 10          |    382.42 us |  1.00 |   88000 B |
| AhoCorasickOurs         | 10          |  2,384.73 us |  6.24 |         - |
| SearchValuesContainsAny | 10          |     52.19 us |  0.14 |         - |
|                         |             |              |       |           |
| LoopContains            | 500         | 19,550.39 us |  1.00 |   88000 B |
| AhoCorasickOurs         | 500         |  4,561.39 us |  0.23 |         - |
| SearchValuesContainsAny | 500         |  2,910.92 us |  0.15 |         - |
Açılıştaki ikinci sorunun cevabı tablonun alt yarısında. Kelime listesi 50 kat büyüyünce kelime başına Contains çağıran döngü de yaklaşık 50 kat yavaşlıyor. Bizim Aho-Corasick'in süresi yalnız 2 kat artıyor; metin yine bir kez okunuyor, artış daha büyük bir trie'nin getirdiği cache miss'lerden. SearchValues iki durumda da en hızlısı, ama iki satır arasındaki fark runtime kaynağında okuduğumuzu doğruluyor: 10 kelimede Teddy ile 52 mikrosaniye, 500 kelimede 80 sınırı aşıldığı için içerideki Aho-Corasick'e geçiyor ve süre 56 kat artıyor. 10 kelimede bizim implementation'ımızın döngüden 6 kat yavaş olması da öğretici: Dictionary<char, int> ile karakter karakter ilerlemek, SIMD ile on kelimeyi taramaktan pahalı. Algoritmanın complexity'si doğru, sabiti kötü.
Türkçe I ve Case Folding
Örnek metin bilerek Türkçe; aynı aramaları ordinal ve tr-TR karşılaştırmayla yaptım:
string text = "KİTAP KULÜBÜ: Istanbul'da bu hafta";OrdinalIgnoreCase "kitap": False
tr-TR IgnoreCase "kitap": True
OrdinalIgnoreCase "istanbul": True
tr-TR IgnoreCase "istanbul": False
SearchValues OrdinalIgnoreCase: False
tr-TR ToLower: "kitap kulübü: ıstanbul'da bu hafta" contains kitap: TrueOrdinalIgnoreCase "İ"yi "i"nin büyük hali saymaz; o eşleme yalnız Türkçe kültürde var. tr-TR karşılaştırması "KİTAP"ı bulur ama bu sefer "Istanbul"u kaçırır, çünkü Türkçede "I"nın küçüğü "ı". Bütün algoritmalarımız karakterleri birebir karşılaştırıyor; dil kurallarını bilmiyorlar. Doğru yaklaşım, aramadan önce hem metni hem pattern'leri aynı katlama fonksiyonundan geçirmek. Serinin 14. yazısındaki SearchKey.Fold gibi, Türkçe karakterleri ASCII'ye indiren bir fonksiyonla hem "KİTAP" hem "Istanbul" aynı biçime gelir; ondan sonra ordinal arama güvenle kullanılabilir. Kültüre duyarlı aramayı kendi KMP'n ya da SearchValues ile yapamazsın.
Üretimde Dikkat
Yapıyı bir kez kur. SearchValues ve Aho-Corasick'in kurulması pahalı, aranması ucuz. Yasaklı kelime listesini uygulama açılırken ya da liste değiştiğinde kurup bir singleton'da ya da static readonly field'da tut; her request'te yeniden kurma.
Kelime sınırını ayrıca kontrol et. "scam" aranırken "scampi" de eşleşir. Moderasyon için eşleşmenin iki yanında harf olup olmadığına bakan bir ikinci adım gerekir; bu, string araması değil, iş kuralı.
Girdiye üst sınır koy. KMP ve Aho-Corasick lineer, ama 10 MB'lık bir yorum yine de 10 MB okumak demek. Yorum uzunluğunu model doğrulamasında sınırla.
Pattern eşleme gerekiyorsa başka bir araç gerekir. "Rakam, sonra tire, sonra harf" gibi kurallar sabit string araması değil; onlar Regular Expressions serisinin konusu.
Sık Düşülen Tuzaklar
IndexOf(string)'i StringComparison vermeden çağırmak. Current culture ile karşılaştırır: hem yavaştır hem de sunucunun kültürüne göre farklı sonuç verebilir. Teknik string'ler (key, kod, yasaklı kelime) için her zaman Ordinal ya da OrdinalIgnoreCase yaz.
OrdinalIgnoreCase'in Türkçeyi bildiğini sanmak. Yukarıdaki çıktıda "KİTAP" bulunmadı. Türkçe içerikte önce normalize et.
Production'da kendi KMP'ni kullanmak. Ölçümdeki gibi BCL'nin vektörize araması pratikte açık ara hızlı ve test edilmiş. Kendi implementation'ın yalnız BCL'nin desteklemediği bir ihtiyaçta (örneğin hangi pattern'in eşleştiğini raporlamak, akan veride arama) anlamlı.
SearchValues'tan hangi kelimenin eşleştiğini beklemek. IndexOfAny yalnız pozisyonu verir. Hangi kelime olduğunu raporlamak gerekiyorsa o pozisyonda adayları kontrol et ya da Aho-Corasick'in FindAll'u gibi pattern'i döndüren bir yapı kullan.
Küçük Bir Deneme
★☆☆ Kmp.BuildFailure'ı "aabaaab" için elle hesapla, sonra kodla doğrula. Hangi pozisyonda değer düşüyor ve neden?
★★☆ AhoCorasick'e kelime sınırı kontrolü ekle: eşleşmenin hemen önündeki ve arkasındaki karakter char.IsLetter ise raporlama. "scampi" artık "scam" olarak işaretlenmemeli; bunu bir testle sabitle.
★★★ AhoCorasick'teki List<Dictionary<char, int>>'i, alfabeyi küçük harflerle sınırlayıp tek bir int[] geçiş tablosuna çevir (node × 26). Benchmark'ı tekrar çalıştır: 10 kelimede döngüyü geçebiliyor musun, bellek ne kadar artıyor?
Bir sonraki yazıda metinden zamana geçiyoruz: kargo teslim slotları, çakışan kampanya tarihleri ve depo vardiyaları. Aralıkları sıralayıp birleştirmek, sweep line ile "aynı anda en fazla kaç" sorusunu cevaplamak ve monotonic bir deque'yi fiyat geçmişinde kullanmak.