

Hash Table Nasıl Çalışır: C# ile Kendi HashMap'ini Yazmak, Collision ve Load Factor

Hash table, key'in hash code'undan bucket index'i hesaplayıp collision'ları chaining ya da open addressing ile çözer; her zaman 42 dönen bir GetHashCode, 10.000 key'lik Dictionary'yi 967 kat yavaşlatıyor. Yazıda .NET Dictionary ile aynı iç yapıda (buckets + entries, free list, prime boyutlar) kendi HashMap'imizi, tombstone'lu linear probing'i, randomized string hashing'i ve bir Bloom filter'ı xUnit testleriyle yazıyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve C# 14 ile derlenip xUnit v3 4.0.2 testleriyle doğrulanmıştır; ölçümler BenchmarkDotNet 0.15.8 ile alınmıştır.
Önce Tahmin Et
Bir geliştirici ISBN'i (International Standard Book Number) saran bir key class'ı yazmış. Equals doğru, ama GetHashCode'u hızlıca geçmek için her zaman 42 dönüyor. Bu kural dışı değil: eşit iki key aynı hash code'u veriyor, sözleşme bozulmuyor. Testler yeşil.
Bookstore bu key ile 10.000 kitabı bir Dictionary'ye koyup her birini bir kez arıyor. Doğru bir GetHashCode ile bu iş 0,3 ms sürüyorsa, 42 dönen versiyonla ne kadar sürer: iki kat mı, 10 kat mı, 1.000 kat mı?
Hash Function'dan Bucket'a
Hash table'ın fikri basit: key'den bir tamsayı üret (hash code), bu sayıyı array boyutuna göre küçült ve element'i o index'teki "bucket"a koy. Arama aynı hesabı tekrarlayıp doğrudan o bucket'a gidiyor; diğer element'lere hiç bakmıyor. Dictionary'nin ortalama O(1) olmasının nedeni bu.
Sorun şu: sonsuz sayıda olası key var ama array'in boyutu sınırlı, yani iki farklı key'in aynı bucket'a düşmesi kaçınılmaz. Buna collision deniyor. Hatta beklenenden çok daha erken oluyor: 365 bucket'lık bir tabloya rastgele 23 key koyduğunda en az bir collision olma olasılığı yüzde 50'yi geçiyor (doğum günü paradoksu). Bir hash table'ı tasarlamak demek, collision'ları nasıl çözeceğine karar vermek demek. İki ana yol var: separate chaining ve open addressing.
Separate Chaining: Dictionary ile Aynı İç Yapı
Separate chaining'de her bucket, o bucket'a düşen element'lerin zincirini tutuyor. Ders kitaplarında bu zincir genelde bir linked list; serinin üçüncü yazısında gördüğümüz node başına allocation ve cache maliyetiyle. .NET'in Dictionary'si daha akıllıca bir yol seçiyor ve bizim versiyonumuz da onu taklit ediyor: bütün element'ler tek bir Entry[] array'inde duruyor, zincir de node reference'larıyla değil, array index'leriyle kuruluyor.
namespace Algorithms.Hashing;

// .NET Dictionary ile aynı şekilde separate chaining:
// buckets[] entries[]'e 1 tabanlı index tutar, entries "next" index'iyle zincirlenir.
public sealed class ChainedHashMap<TKey, TValue> where TKey : notnull
{
    private struct Entry
    {
        public uint HashCode;
        public int Next;      // aynı bucket'taki sonraki entry'nin index'i, -1 = zincirin sonu
        public TKey Key;
        public TValue Value;
    }

    private int[] _buckets;
    private Entry[] _entries;
    private int _count;       // _entries'te kullanılan slot sayısı (boşaltılanlar dahil)
    private int _freeList = -1;
    private int _freeCount;
    private readonly IEqualityComparer<TKey> _comparer;

    public ChainedHashMap(int capacity = 0, IEqualityComparer<TKey>? comparer = null)
    {
        int size = Primes.AtLeast(Math.Max(capacity, 3));
        _buckets = new int[size];
        _entries = new Entry[size];
        _comparer = comparer ?? EqualityComparer<TKey>.Default;
    }

    public int Count => _count - _freeCount;
    public int BucketCount => _buckets.Length;

    private ref int Bucket(uint hashCode) => ref _buckets[hashCode % (uint)_buckets.Length];

    public bool TryGetValue(TKey key, out TValue value)
    {
        uint hashCode = (uint)_comparer.GetHashCode(key);
        for (int i = Bucket(hashCode) - 1; i >= 0; i = _entries[i].Next)
        {
            ref Entry entry = ref _entries[i];
            // önce saklanan hash'i karşılaştır: ucuz bir int karşılaştırması eşleşmeyenlerin çoğunu eler
            if (entry.HashCode == hashCode && _comparer.Equals(entry.Key, key))
            {
                value = entry.Value;
                return true;
            }
        }
        value = default!;
        return false;
    }

    public void Set(TKey key, TValue value)
    {
        uint hashCode = (uint)_comparer.GetHashCode(key);
        for (int i = Bucket(hashCode) - 1; i >= 0; i = _entries[i].Next)
        {
            if (_entries[i].HashCode == hashCode && _comparer.Equals(_entries[i].Key, key))
            {
                _entries[i].Value = value; // var olan key'in değerini ez
                return;
            }
        }

        int index;
        if (_freeCount > 0)
        {
            index = _freeList;
            _freeList = -3 - _entries[index].Next; // Dictionary'deki free list kodlama hilesinin aynısı
            _freeCount--;
        }
        else
        {
            if (_count == _entries.Length) Resize(); // load factor 1,0: bucket başına ortalama bir entry
            index = _count++;
        }

        ref int bucket = ref Bucket(hashCode);
        _entries[index] = new Entry { HashCode = hashCode, Next = bucket - 1, Key = key, Value = value };
        bucket = index + 1; // yeni entry zincirin başına geçer
    }

    public bool Remove(TKey key)
    {
        uint hashCode = (uint)_comparer.GetHashCode(key);
        ref int bucket = ref Bucket(hashCode);
        int previous = -1;
        for (int i = bucket - 1; i >= 0; previous = i, i = _entries[i].Next)
        {
            ref Entry entry = ref _entries[i];
            if (entry.HashCode != hashCode || !_comparer.Equals(entry.Key, key)) continue;

            if (previous < 0) bucket = entry.Next + 1;
            else _entries[previous].Next = entry.Next;

            entry.Key = default!;
            entry.Value = default!;
            entry.Next = -3 - _freeList; // -1'den küçük değerler boş slotu işaretler
            _freeList = i;
            _freeCount++;
            return true;
        }
        return false;
    }

    private void Resize()
    {
        int newSize = Primes.AtLeast(_count * 2);
        Entry[] entries = new Entry[newSize];
        Array.Copy(_entries, entries, _count);
        _buckets = new int[newSize];
        // her entry'yi yeniden bağla: bucket'ı yeni uzunluğa bağlı; saklanan hash GetHashCode çağrısını önler
        for (int i = 0; i < _count; i++)
        {
            ref int bucket = ref _buckets[entries[i].HashCode % (uint)newSize];
            entries[i].Next = bucket - 1;
            bucket = i + 1;
        }
        _entries = entries;
    }

    public int LongestChain()
    {
        int longest = 0;
        foreach (int head in _buckets)
        {
            int length = 0;
            for (int i = head - 1; i >= 0; i = _entries[i].Next) length++;
            longest = Math.Max(longest, length);
        }
        return longest;
    }
}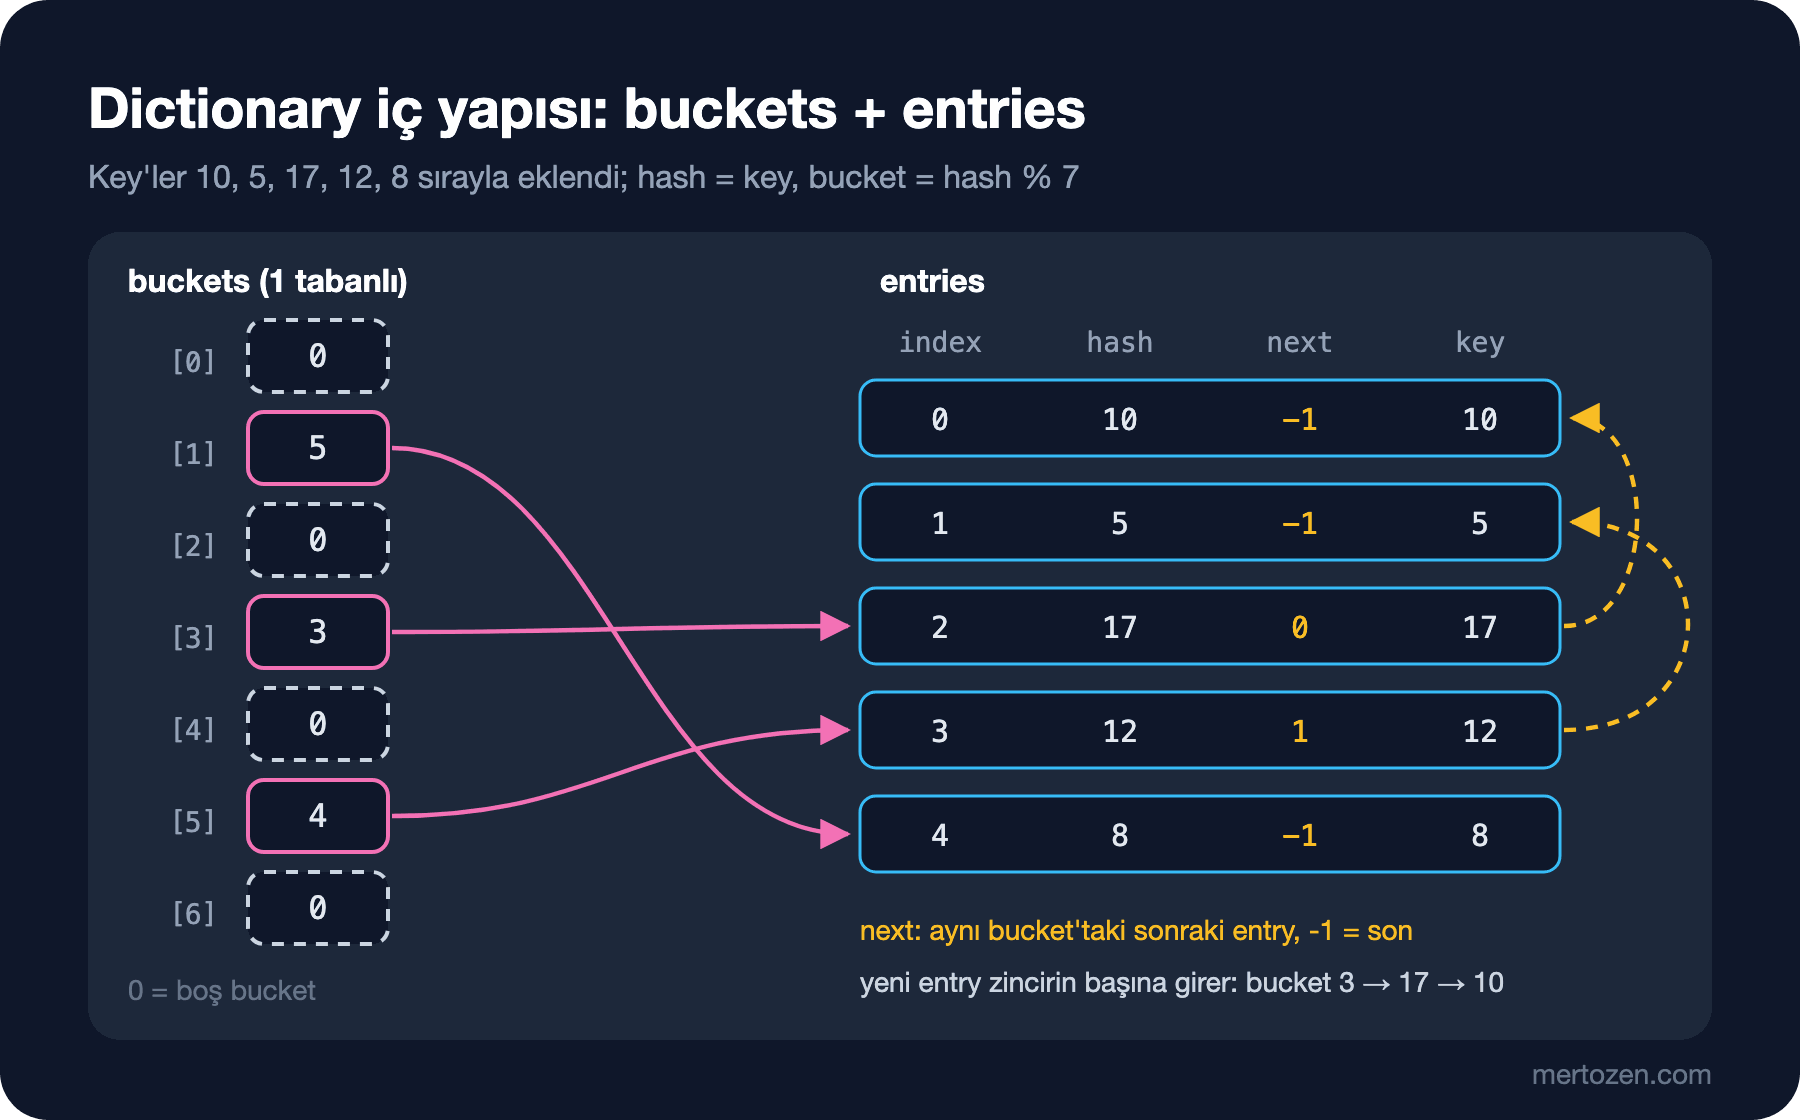
Bu kodda üç hile var ve üçü de dotnet/runtime'daki Dictionary.cs'ten geliyor. Birincisi 1 tabanlı bucket'lar: new int[size] her slotu 0 ile başlatıyor; bucket'ta index + 1 saklayınca 0 "boş bucket" anlamına geliyor ve array'i -1 ile doldurmaya gerek kalmıyor. Bucket(hashCode) - 1 boş bucket için -1 verir ve döngü hiç başlamaz. İkincisi her entry'de saklanan hash code: aramada önce iki uint karşılaştırılıyor, pahalı olabilecek Equals yalnızca hash'ler eşitse çağrılıyor; resize sırasında da GetHashCode hiç çağrılmıyor. Üçüncüsü free list: silinen entry'nin slotu boşa gitmesin diye boş slotlar kendi aralarında zincirleniyor ve Next alanı -3 - sonrakiIndex olarak kodlanıyor. Böylece -1'den küçük her değer "bu slot boş" anlamına geliyor ve enumerator bu slotları atlayabiliyor.
Entry'lerin tek bir array'de durmasının iki faydası var: element başına ayrı bir object yok (GC (Garbage Collector) için tek bir büyük array) ve zinciri gezmek aynı array içinde zıplamak. Linked list'li klasik chaining'e göre hem daha az bellek hem daha iyi cache davranışı.
.NET Dictionary'nin Büyümesi: Prime Boyutlar
Bizim Resize'ımız boyutu iki katının üstündeki ilk asal sayıya çıkarıyor. Dictionary de aynı kararı veriyor ama asal sayıları hesaplamak yerine hazır bir tablodan alıyor. EnsureCapacity(0) mevcut capacity'yi büyütmeden döndürdüğü için, 2.000 element eklerken capacity'nin geçtiği değerleri görebiliyoruz:
Dictionary capacity steps: 3 -> 7 -> 17 -> 37 -> 89 -> 197 -> 431 -> 919 -> 1931 -> 404937'den sonra 79 değil 89 geliyor, çünkü dotnet/runtime'daki HashHelpers.ExpandPrime boyutu ikiye katlıyor (74) ve Primes tablosunda bundan büyük ya da eşit ilk sayıyı alıyor: tablo 3, 7, 11, 17, 23, 29, 37, 47, 59, 71, 89, ... diye gidiyor. Neden asal? Bucket index'i hash % size ile hesaplanıyor. Size ikinin bir kuvveti olsaydı yalnızca hash'in son birkaç biti kullanılırdı ve son bitleri benzer olan hash'ler (ör. hep 8'in katı olan değerler) aynı bucket'lara yığılırdı. Asal bir boyut hash'in bütün bitlerini hesaba katıyor. 64-bit process'lerde Dictionary pahalı % işlemini de kullanmıyor: HashHelpers.FastMod, önceden hesaplanmış bir çarpanla aynı sonucu çarpma ve kaydırmayla buluyor.
Load factor, element sayısının bucket sayısına oranı. Bizim versiyonumuz da Dictionary de entries array'i tamamen dolunca büyüyor; load factor en fazla 1,0. Chaining için bu rahat bir değer: bucket başına ortalama bir element, zincirler kısa. Her resize bütün entry'leri yeniden bağlıyor ve O(n), ama boyut her seferinde ikiye katlandığı için amortized maliyet sabit. Serinin ikinci yazısındaki dynamic array hesabının aynısı; ispatı Big-O ve Complexity serisinin "Amortized Analysis" yazısında.
Open Addressing: Linear Probing ve Tombstone
İkinci yol zincir tutmamak: collision olursa element'i tablonun bir sonraki boş slotuna koymak. Arama da aynı yolu izliyor: hash'in gösterdiği slottan başla, key'i bulana ya da gerçekten boş bir slota rastlayana kadar ilerle.
namespace Algorithms.Hashing;

// Open addressing: her key slots array'inin kendisinde durur; collision olunca sonraki slota geçilir.
public sealed class LinearProbingHashMap<TKey, TValue> where TKey : notnull
{
    private enum SlotState : byte { Empty, Occupied, Deleted }

    private struct Slot
    {
        public SlotState State;
        public TKey Key;
        public TValue Value;
    }

    private const double MaxLoad = 0.5; // tablo doldukça probing hızla kötüleşir
    private Slot[] _slots = new Slot[8];
    private int _occupied;
    private int _deleted; // tombstone'lar da probe zincirini uzatır, load'a sayılırlar

    public int Count => _occupied;

    private int IndexFor(TKey key) => (EqualityComparer<TKey>.Default.GetHashCode(key) & 0x7FFF_FFFF) % _slots.Length;

    public bool TryGetValue(TKey key, out TValue value)
    {
        for (int i = IndexFor(key); ; i = (i + 1) % _slots.Length)
        {
            ref Slot slot = ref _slots[i];
            if (slot.State == SlotState.Empty) break;        // gerçekten boş slot aramayı bitirir
            if (slot.State == SlotState.Occupied && EqualityComparer<TKey>.Default.Equals(slot.Key, key))
            {
                value = slot.Value;
                return true;
            }
            // Deleted: devam et, key probe zincirinin ilerisinde olabilir
        }
        value = default!;
        return false;
    }

    public void Set(TKey key, TValue value)
    {
        if (_occupied + _deleted + 1 > _slots.Length * MaxLoad) Resize();

        int firstTombstone = -1;
        for (int i = IndexFor(key); ; i = (i + 1) % _slots.Length)
        {
            ref Slot slot = ref _slots[i];
            if (slot.State == SlotState.Occupied && EqualityComparer<TKey>.Default.Equals(slot.Key, key))
            {
                slot.Value = value;
                return;
            }
            if (slot.State == SlotState.Deleted && firstTombstone < 0) firstTombstone = i;
            if (slot.State == SlotState.Empty)
            {
                int target = firstTombstone >= 0 ? firstTombstone : i; // yol üstünde tombstone varsa onu kullan
                if (target == firstTombstone) _deleted--;
                _slots[target] = new Slot { State = SlotState.Occupied, Key = key, Value = value };
                _occupied++;
                return;
            }
        }
    }

    public bool Remove(TKey key)
    {
        for (int i = IndexFor(key); ; i = (i + 1) % _slots.Length)
        {
            ref Slot slot = ref _slots[i];
            if (slot.State == SlotState.Empty) return false;
            if (slot.State == SlotState.Occupied && EqualityComparer<TKey>.Default.Equals(slot.Key, key))
            {
                // Empty değil tombstone: buraya Empty yazmak sonraki key'lerin probe zincirini keser
                slot = new Slot { State = SlotState.Deleted };
                _occupied--;
                _deleted++;
                return true;
            }
        }
    }

    private void Resize()
    {
        Slot[] old = _slots;
        // yalnızca canlı key'ler gerektiriyorsa büyü; baskıyı tombstone'lar yaptıysa aynı boyutta yeniden kur
        int newSize = _occupied + 1 > old.Length * MaxLoad / 2 ? old.Length * 2 : old.Length;
        _slots = new Slot[newSize];
        _occupied = _deleted = 0;
        foreach (Slot slot in old)
            if (slot.State == SlotState.Occupied) Set(slot.Key, slot.Value);
    }
}
Open addressing'in en ince noktası silme. 8 slotluk tabloda int key'ler kendilerine hash'leniyor; 1, 9 ve 17'nin üçü de slot 1'den başlıyor ve 1, 2, 3 numaralı slotlara yerleşiyor. 9'u silip slotunu Empty yaparsan, 17'yi arayan kod slot 1'de 1'i görüp ilerliyor, slot 2'de boşluğa rastlıyor ve "17 yok" diyor. Oysa 17 bir adım ötede duruyor. Çözüm silinen slotu "tombstone" ile işaretlemek: arama tombstone'da durmuyor, ekleme ise onu yeniden kullanabiliyor.
[Fact]
public void LinearProbing_RemoveMiddleOfCluster_LaterKeyStillFound()
{
    // int'ler kendilerine hash'lenir: 1, 9 ve 17 sekiz slotluk tabloda slot 1'den başlar
    LinearProbingHashMap<int, string> map = new();
    map.Set(1, "a");
    map.Set(9, "b");
    map.Set(17, "c");

    map.Remove(9); // 1 ile 17 arasında bir tombstone

    Assert.True(map.TryGetValue(17, out string? value));
    Assert.Equal("c", value);
}
Tombstone'ların bedeli de var: zamanla tabloyu doldurup probe zincirlerini uzatıyorlar. Bu yüzden Set load'u hesaplarken tombstone'ları da sayıyor ve Resize, baskının kaynağı tombstone'larsa tabloyu büyütmeden aynı boyutta temiz bir şekilde yeniden kuruyor. Linear probing'in load factor'ü 0,5–0,7'yi geçince performansı hızla düşüyor; collision'lar yan yana kümeler (primary clustering) oluşturuyor ve kümeler birbirine yapışıp büyüyor. Chaining 1,0'da rahatken probing'in daha düşük bir eşikte büyümesi bu yüzden. Karşılığında open addressing'in pointer'ı yok, element'ler array'de art arda duruyor ve küçük, sabit boyutlu key'lerde cache dostu.
Her iki implementation'ı da aynı yöntemle test ediyoruz: 20.000 rastgele Set, Remove ve TryGetValue işlemini hem kendi map'imize hem Dictionary'ye uygulayıp her adımda aynı cevabı verdiklerini doğruluyoruz:
[Fact]
public void ChainedHashMap_SetGetRemove_BehavesLikeDictionary()
{
    ChainedHashMap<string, int> map = new();
    Dictionary<string, int> reference = [];
    Random random = new(1);

    for (int step = 0; step < 20_000; step++)
    {
        string key = "isbn-" + random.Next(2_000);
        switch (random.Next(3))
        {
            case 0:
                map.Set(key, step);
                reference[key] = step;
                break;
            case 1:
                Assert.Equal(reference.Remove(key), map.Remove(key));
                break;
            default:
                Assert.Equal(reference.TryGetValue(key, out int expected), map.TryGetValue(key, out int actual));
                Assert.Equal(expected, actual);
                break;
        }
    }
    Assert.Equal(reference.Count, map.Count);
}
$ dotnet test --project tests/Algorithms.Tests -- --filter-class Algorithms.Tests.HashingTests
tests/Algorithms.Tests/bin/Debug/net10.0/Algorithms.Tests.dll (net10.0|arm64) passed (611ms)
Test run summary: Passed!
total: 6
failed: 0
succeeded: 6GetHashCode ve Equals Sözleşmesi
Hash table'ın doğru çalışması tek bir kurala bağlı: Equals'a göre eşit olan iki key aynı GetHashCode'u döndürmeli. Tersi gerekmiyor; farklı key'lerin aynı hash'i vermesi collision, hata değil. Kural bozulursa eşit bir key başka bir bucket'a gidiyor ve Dictionary var olan kaydı bulamıyor.
Elle yazarken HashCode.Combine kullan; birden fazla alanı iyi dağılan tek bir hash'e karıştırıyor. Record'lar ise Equals ve GetHashCode'u bütün alanlarına göre otomatik üretiyor; key olarak kullanmaya hazır geliyorlar:
public sealed record OrderLineKey(int OrderId, string Isbn);

public sealed class ShelfLocation(string aisle, int shelf) : IEquatable<ShelfLocation>
{
    public string Aisle { get; } = aisle;
    public int Shelf { get; } = shelf;
    public bool Equals(ShelfLocation? other) => other is not null && other.Aisle == Aisle && other.Shelf == Shelf;
    public override bool Equals(object? obj) => Equals(obj as ShelfLocation);
    public override int GetHashCode() => HashCode.Combine(Aisle, Shelf);
}
Override etmeyen bir class ise reference equality kullanıyor: aynı değerlere sahip iki farklı instance farklı key sayılıyor. Key olarak kullanılan bir object'in hash'e giren alanlarını değiştirmek, kaydı sözlükte "kaybetmenin" en yaygın yolu; bu tuzak C# Koleksiyonlar serisinin "C# Dictionary ve HashSet: TryGetValue, Key Eşitliği ve Comparer" yazısında ayrıntılı anlatıldı.
Kötü Hash: Her Şey Aynı Bucket'ta
Açılıştaki soruya dönelim. 42 dönen GetHashCode, sözleşmeyi bozmuyor ama hash table'ı tek bir uzun zincire çeviriyor. Test bunu doğrudan gösteriyor: 1.000 key ile kendi map'imizde en uzun zincir 1.000:
public sealed class BadIsbnKey(string isbn) : IEquatable<BadIsbnKey>
{
    public string Isbn { get; } = isbn;
    public bool Equals(BadIsbnKey? other) => other is not null && other.Isbn == Isbn;
    public override bool Equals(object? obj) => Equals(obj as BadIsbnKey);
    // kurallara uygun (eşit key'ler eşit hash verir) ama işe yaramaz: her key aynı bucket'a düşer
    public override int GetHashCode() => 42;
}

[Fact]
public void ChainedHashMap_ConstantHash_SingleLongChain()
{
    ChainedHashMap<BadIsbnKey, int> bad = new();
    ChainedHashMap<GoodIsbnKey, int> good = new();
    for (int i = 0; i < 1_000; i++)
    {
        bad.Set(new BadIsbnKey($"978{i:D10}"), i);
        good.Set(new GoodIsbnKey($"978{i:D10}"), i);
    }

    Assert.Equal(1_000, bad.LongestChain());
    Assert.True(good.LongestChain() <= 8, $"longest chain {good.LongestChain()}");
}
Benchmark, N key'i bir Dictionary'ye koyup her birini bir kez arıyor:
BenchmarkDotNet v0.15.8, macOS 27.0.1 (26A434) [Darwin 27.0.0]
Apple M5, 1 CPU, 10 logical and 10 physical cores
.NET SDK 10.0.402
  [Host] : .NET 10.0.13 (10.0.13, 10.0.1326.50504), Arm64 RyuJIT armv8.0-a

| Method             | N     | Mean          | Ratio  | Allocated |
|------------------- |------ |--------------:|-------:|----------:|
| GoodHash           | 1000  |      24.65 us |   1.00 |  30.21 KB |
| ConstantHash       | 1000  |   2,861.57 us | 116.10 |  30.21 KB |
| OwnChainedGoodHash | 1000  |      15.64 us |   0.63 |   27.7 KB |
|                    |       |               |        |           |
| GoodHash           | 10000 |     304.83 us |   1.00 | 276.43 KB |
| ConstantHash       | 10000 | 294,835.74 us | 967.33 | 276.38 KB |
| OwnChainedGoodHash | 10000 |     286.57 us |   0.94 | 273.78 KB |
10.000 key'de 0,3 ms'lik iş 295 ms'ye çıkıyor: 967 kat. Her ekleme, aynı key var mı diye bütün zinciri geziyor; her arama da. Toplam karşılaştırma n² civarı, yani O(1) ortalamalı bir yapı O(n)'e düşüyor. Key sayısı 10 kat artınca oran 116'dan 967'ye çıkıyor; bu, quadratic büyümenin ta kendisi. Allocated sütunu aynı: sorun bellek değil, karşılaştırma sayısı. Kendi chaining versiyonumuz iyi hash ile BCL'den (Base Class Library) biraz hızlı çıkıyor; Dictionary'nin enumerator koruması, alternate lookup ve randomized string geçişi gibi bizim yapmadığımız işleri var. Ölçüm makinede başka işler çalışırken alındı.
Güvenlik: Hash Flooding ve Randomized String Hashing
Kötü hash yalnızca bir performans hatası değil, bir saldırı yüzeyi. Bir saldırgan, hash fonksiyonunu biliyorsa aynı bucket'a düşen binlerce farklı key üretip (form alanı adları, JSON (JavaScript Object Notation) property'leri, query string parametreleri) sunucunun hash table'larını tek zincire çevirebilir. Az bir trafikle CPU'yu (Central Processing Unit) kilitleyen bu DoS (Denial of Service) saldırısına hash flooding deniyor; 2011'de birçok web platformunu etkiledi.
.NET Core'un savunması string hash'ini her process'te rastgele bir seed ile hesaplamak. Aynı programı iki kez çalıştırınca bunu görüyorsun:
$ dotnet Algorithms.Demos.dll string-hash
"Dune".GetHashCode() = -1172752349
42.GetHashCode()     = 42
$ dotnet Algorithms.Demos.dll string-hash
"Dune".GetHashCode() = 1391195764
42.GetHashCode()     = 42
Saldırgan seed'i bilmediği için çakışan key'leri önceden hesaplayamıyor. Bunun bir sonucu var: string.GetHashCode()'u asla diske yazma, veritabanına koyma ya da process'ler arasında karşılaştırma; bir sonraki çalıştırmada farklı. Dictionary bir adım daha ileri gidiyor: string key'lerde varsayılan comparer ile önce daha hızlı, randomize edilmemiş bir hash kullanıyor ve tek bir zincirde 100'den fazla collision görürse (HashHelpers.HashCollisionThreshold) randomized comparer'a geçip bütün tabloyu yeniden hash'liyor.
İleri Not: Bloom Filter
Bazen "bu key kesinlikle yok" cevabı tek başına değerli. Bookstore'un kayıt formu, girilen e-posta adresinin daha önce kullanılıp kullanılmadığını veritabanına sormadan önce bellekte bir filtreye soruyor. Bloom filter, bir bit array'i ve k hash fonksiyonu kullanıyor: eklerken k bit'i 1 yapıyor, sorarken k bit'in hepsi 1 mi diye bakıyor. Bit'lerden biri bile 0'sa key kesinlikle yok; hepsi 1'se "muhtemelen var", çünkü o bit'ler başka key'ler tarafından da 1 yapılmış olabilir. False negative yok, kontrollü oranda false positive var:
using System.Collections;

namespace Algorithms.Hashing;

// "Kesinlikle yok" ya da "muhtemelen var": false negative yok, biraz false positive var.
public sealed class BloomFilter(int bitCount, int hashCount)
{
    private readonly BitArray _bits = new(bitCount);

    public void Add(string item)
    {
        (uint h1, uint h2) = Hash(item);
        for (int i = 0; i < hashCount; i++) _bits[Index(h1, h2, i)] = true;
    }

    public bool MightContain(string item)
    {
        (uint h1, uint h2) = Hash(item);
        for (int i = 0; i < hashCount; i++)
            if (!_bits[Index(h1, h2, i)]) return false;
        return true;
    }

    // iki hash'ten k hash: g_i = h1 + i * h2 (Kirsch ve Mitzenmacher)
    private int Index(uint h1, uint h2, int i) => (int)((h1 + (uint)i * h2) % (uint)bitCount);

    // FNV-1a 64-bit: string.GetHashCode'un aksine process'ler arasında aynı
    private static (uint, uint) Hash(string item)
    {
        ulong hash = 14695981039346656037UL;
        foreach (char c in item)
        {
            hash ^= c;
            hash *= 1099511628211UL;
        }
        return ((uint)hash, (uint)(hash >> 32) | 1);
    }
}
5 bits/item, k= 3: 61 KB, false positives 9,095/100,000 = 9.10%
10 bits/item, k= 7: 122 KB, false positives 810/100,000 = 0.81%
20 bits/item, k=14: 244 KB, false positives 9/100,000 = 0.01%100.000 e-posta adresi için 122 KB'lık bir filtre, olmayan adreslerin yüzde 99,19'unu veritabanına hiç gitmeden eliyor. Aynı adresleri bir HashSet<string>'te tutmak megabaytlar alırdı. Hash için FNV (Fowler–Noll–Vo) ailesinden FNV-1a'yı kullanmamızın nedeni, string.GetHashCode'un process'e göre değişmesi; filtreyi diske kaydedip sonra yüklemek istersen deterministic bir hash şart. Bloom filter'lar Cassandra ve RocksDB gibi depolama motorlarında (diskte olmayan bir key için dosya okumamak) ve cache'lerin önünde kullanılıyor. Sınırı: eleman silemezsin, çünkü bir bit'i 0 yapmak başka key'leri de siler.
Üretimde Dikkat
Kendi key tipini yazıyorsan hash dağılımını ölç. Kendi map'imizdeki LongestChain gibi bir teşhis BCL'de yok, ama keys.GroupBy(k => k.GetHashCode()).Max(g => g.Count()) ile kaç key'in aynı hash'i paylaştığını görebilirsin. Sonuç 1'den büyük çıkıyorsa nedenini anla.
Capacity'yi biliyorsan ver. new Dictionary<string, Book>(100_000), 10'dan fazla resize'ı ve her resize'daki yeniden bağlamayı ortadan kaldırıyor. Bellekte uzun süre kalacak, sık okunan ve hiç değişmeyen sözlükler için ise FrozenDictionary var; oluştururken daha fazla iş yapıp okumayı hızlandırıyor (C# Koleksiyonlar serisinin "C# 11–12 ve .NET 7–8: Generic Math, Frozen ve Collection Expressions" yazısı).
Dışarıdan gelen key'lerle sınırsız büyüyen sözlük kurma. Kullanıcının gönderdiği her farklı değer için bir kayıt açan bir Dictionary, hash flooding olmasa bile belleği tüketen bir saldırı yüzeyi. Sayıyı sınırla ya da gerçek bir cache kullan.
Sık Düşülen Tuzaklar
Equals'ı override edip GetHashCode'u unutmak. Derleyici bunu uyarıyla söylüyor ama sonuç sessiz: eşit key'ler farklı bucket'lara gidiyor ve ContainsKey false dönüyor. İkisini her zaman birlikte yaz ya da record kullan.
Hash'i sabit ya da zayıf yazmak. 42 dönen bir hash testleri geçer, production'da 967 kat yavaşlar. Benzer şekilde yalnızca bir alanı hash'leyip o alanın hep aynı değeri aldığı key'ler (ör. hep "TR" olan ülke kodu) aynı sonucu doğurur.
Open addressing'de silinen slotu boşaltmak. Tombstone yerine Empty yazmak, aynı kümedeki sonraki key'leri görünmez yapar. Test bu yüzden kümenin ortasından siliyor.
string.GetHashCode'u kalıcı yere yazmak. Değer her process'te farklı; bir sonraki deploy'da bütün eşleşmeler kaybolur. Kalıcı hash gerekiyorsa SHA (Secure Hash Algorithm) ailesinden SHA-256 ya da XxHash gibi deterministic bir algoritma kullan.
Küçük Bir Deneme
★☆☆ BadIsbnKey.GetHashCode'u ISBN'in son karakterinin değerini dönecek şekilde değiştir (yalnızca 10 farklı hash). 10.000 key'de en uzun zincir ne oluyor? Benchmark'ta süre nereye düşüyor?
★★☆ LinearProbingHashMap'e MaxLoad'u parametre olarak ver ve 0,5, 0,7 ve 0,9 için ortalama probe uzunluğunu ölçen bir test yaz. Uzunluk load factor'le nasıl büyüyor?
★★★ Bloom filter için, eklenecek eleman sayısı n ve hedef false positive oranı p verildiğinde bit sayısını ve k'yi hesaplayan bir factory method yaz (m = −n·ln p / (ln 2)², k = (m/n)·ln 2). %1 hedefle 100.000 adres için ölçtüğün oran hedefe ne kadar yakın?
Hash table'ı içeriden gördük. Bir sonraki yazıda onu bir araç olarak kullanıyoruz: two sum'ı O(n²)'den O(n)'e indiren frequency map, two pointers, sliding window ve prefix sum gibi array ve hashing pattern'leri, hepsi Bookstore'un sipariş ve satış verisi üzerinde.