

Algoritmalar ve Data Structure'lar Neden Hâlâ Önemli: .NET Geliştiricisi İçin Yol Haritası

Doğru data structure, aynı kodu veri büyüdüğünde ayakta tutar: 100.000 kitaplık katalogda 100 ISBN araması List ile 9,7 ms, sıralı array'de binary search ile 6,5 µs, Dictionary ile 0,93 µs sürüyor. Yazı abstract data type ile implementation farkını, serinin xUnit ve BenchmarkDotNet'li çalışma düzenini ve 22 yazılık yol haritasını anlatıyor.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve C# 14 ile derlenip xUnit v3 4.0.2 testleriyle doğrulanmıştır; ölçümler BenchmarkDotNet 0.15.8 ile alınmıştır.
Önce Tahmin Et
Bookstore'un kataloğunda 100.000 kitap var ve sipariş ekranı her sepet için 100 kez "bu ISBN (International Standard Book Number) hangi kitap?" diye soruyor. Aynı soruyu üç farklı yapıyla cevaplıyoruz: kitapları bir List<Book>'te tutup baştan sona aramak, ISBN'e göre sıralanmış bir array'de binary search yapmak ve ISBN'i key olarak kullanan bir Dictionary<string, Book>.
Katalog 1.000 kitapken List ile Dictionary arasındaki fark yaklaşık kaç kat? Katalog 100 kat büyüyüp 100.000 kitap olduğunda bu fark kaç kat olur: yine aynı mı, 100 katına mı çıkar, yoksa başka bir şey mi? Sıralı array bu ikisinin neresinde durur? Cevabı yazının ortasındaki ölçüm veriyor; tahminini bir kenara yaz.
Abstract Data Type ile Implementation Arasındaki Fark
Bu serinin bütün yazıları tek bir ayrımın üzerine kurulu. Abstract data type (ADT), bir yapının ne vaat ettiğini söyler: "ISBN ver, kitabı döneyim", "en son eklediğini geri ver", "en küçüğü ver". Implementation ise bu vaadin bellekte nasıl tutulduğunu ve her işlemin kaça mal olduğunu belirler. Aynı ADT'nin birden fazla implementation'ı olur ve aralarındaki fark yalnızca performans değildir; bellek kullanımı, sıralama garantisi ve hangi işlemin ucuz, hangisinin pahalı olduğu da değişir.
.NET'te bunun en tanıdık örneği IList<T>. Bu interface index ile okuma, yazma, araya ekleme ve silme vaat ediyor. List<T> bu vaadi arka plandaki bir array ile yerine getiriyor: index ile erişim tek bir adres hesabı, ama ortaya ekleme sağdaki bütün element'leri kaydırıyor. LinkedList<T> ise IList<T>'yi hiç implement etmiyor. Yalnızca ICollection<T> ve okuma tarafındaki interface'leri implement ediyor; BCL (Base Class Library) tasarımcıları index ile erişimi O(n) olacak bir yapıya o sözleşmeyi vermeyi bilerek reddetmiş. Interface'e bakıp "index ile erişim ucuzdur" diye düşünen kodu yanıltmamak için.
Bookstore senaryosundaki ADT şu kadar:
namespace Bookstore;

public sealed record Book(string Isbn, string Title, decimal Price);

// ADT: katalog ne vaat ediyor, kitapları nasıl tuttuğu değil
public interface IBookCatalog
{
    Book? FindByIsbn(string isbn);
}
Kodun geri kalanı bu interface'i bilir; arkasında hangi yapının durduğunu bilmez. Bu, yapıyı sonradan değiştirebilmenin ön koşulu. Yanlış seçimi düzeltmek, interface'in arkasındaki tek bir class'ı değiştirmekten ibaret olur.
Aynı Sözleşmeye Üç Implementation
İlk implementation en düz olanı: bütün kitapları gez, ISBN'i eşleşeni dön.
public sealed class ListCatalog(IEnumerable<Book> books) : IBookCatalog
{
    private readonly List<Book> _books = [.. books];

    public Book? FindByIsbn(string isbn)
    {
        foreach (Book book in _books)
        {
            if (book.Isbn == isbn)
                return book;
        }
        return null;
    }
}
İkincisi kitapları bir kez ISBN'e göre sıralıyor, sonra her aramada aralığı yarıya indiriyor. Sıralama maliyeti constructor'da bir kez ödeniyor; her arama en fazla log₂(n) karşılaştırma yapıyor.
public sealed class SortedArrayCatalog : IBookCatalog
{
    private readonly Book[] _books;

    public SortedArrayCatalog(IEnumerable<Book> books)
    {
        _books = [.. books];
        Array.Sort(_books, (a, b) => string.CompareOrdinal(a.Isbn, b.Isbn));
    }

    public Book? FindByIsbn(string isbn)
    {
        int lo = 0, hi = _books.Length;
        while (lo < hi)
        {
            int mid = lo + (hi - lo) / 2;
            int cmp = string.CompareOrdinal(_books[mid].Isbn, isbn);
            if (cmp == 0) return _books[mid];
            if (cmp < 0) lo = mid + 1;
            else hi = mid;
        }
        return null;
    }
}
Üçüncüsü ISBN'den bir hash code üretip doğrudan ilgili bucket'a gidiyor:
public sealed class DictionaryCatalog(IEnumerable<Book> books) : IBookCatalog
{
    private readonly Dictionary<string, Book> _byIsbn = books.ToDictionary(b => b.Isbn, StringComparer.Ordinal);

    public Book? FindByIsbn(string isbn) => _byIsbn.GetValueOrDefault(isbn);
}
Üçünün de complexity'si tek satırda şöyle: List'te arama O(n), sıralı array'de O(log n), Dictionary'de ortalama O(1). Bu notasyonun ne demek olduğu, neden "ortalama" dediğimiz ve sabitlerin neden atıldığı Big-O ve Complexity serisinin "Big-O Notation Nedir" yazısında; burada yalnızca sonuca bakıyoruz.
Önce Test: Üç Implementation Aynı Cevabı Veriyor mu?
Hız ölçmeden önce doğruluğu sabitlemek gerekiyor. Yanlış cevap veren hızlı bir yapı hiçbir işe yaramaz. Seri boyunca her yapı için düzen aynı: önce xUnit testi, sonra implementation, en son ölçüm. Bu yazıdaki test, üç catalog'u aynı 1.000 kitapla kuruyor ve her ISBN için aynı Book instance'ının döndüğünü doğruluyor:
public class BookCatalogTests
{
    private static readonly Book[] Books = SampleBooks.Create(1_000);

    public static TheoryData<string> CatalogNames => ["list", "sorted", "dictionary"];

    private static IBookCatalog Create(string name) => name switch
    {
        "list" => new ListCatalog(Books),
        "sorted" => new SortedArrayCatalog(Books),
        _ => new DictionaryCatalog(Books),
    };

    [Theory]
    [MemberData(nameof(CatalogNames))]
    public void FindByIsbn_ExistingIsbn_ReturnsSameBook(string name)
    {
        IBookCatalog catalog = Create(name);

        foreach (Book book in Books)
            Assert.Same(book, catalog.FindByIsbn(book.Isbn));
    }

    [Theory]
    [MemberData(nameof(CatalogNames))]
    public void FindByIsbn_MissingIsbn_ReturnsNull(string name)
    {
        IBookCatalog catalog = Create(name);

        Assert.Null(catalog.FindByIsbn("9780000000000x"));
    }
}
$ dotnet test --project tests/Algorithms.Tests -- --filter-class Algorithms.Tests.BookCatalogTests
Running tests from tests/Algorithms.Tests/bin/Debug/net10.0/Algorithms.Tests.dll (net10.0|arm64)
tests/Algorithms.Tests/bin/Debug/net10.0/Algorithms.Tests.dll (net10.0|arm64) passed (658ms)
Test run summary: Passed!
total: 6
failed: 0
succeeded: 6
skipped: 0
duration: 782msSampleBooks.Create sabit seed'li bir Random ile 978 ile başlayan, birbirinden farklı 13 haneli ISBN'ler üretiyor; her koşuda aynı veri geliyor, bu yüzden testler ve ölçümler tekrarlanabilir. Test komutundaki --filter-class, xUnit v3'ün Microsoft Testing Platform (MTP) üzerinde çalışan runner'ına ait bir argüman; .NET 10 SDK (Software Development Kit) ile xUnit v3 4.x paketleri MTP ile koşuyor ve solution'ın global.json dosyasında bunun için "test": { "runner": "Microsoft.Testing.Platform" } satırı var.
Ölçüm: 100 Kat Büyüyen Katalog
Stopwatch ile tek bir döngüyü ölçmek JIT (Just-In-Time) derlemesini, ısınmayı ve gürültüyü ayıramaz. Seri boyunca bütün ölçümler BenchmarkDotNet ile; kurulumu ve sonuçların nasıl okunacağı C# İleri serisinin "C#'ta Performans: Allocation, Struct'lar ve BenchmarkDotNet ile Ölçmek" yazısında. Benchmark her N için üç catalog'u kuruyor ve rastgele seçilmiş 100 mevcut ISBN'i arıyor:
[MemoryDiagnoser]
public class CatalogBenchmarks
{
    private IBookCatalog _list = null!, _sorted = null!, _dictionary = null!;
    private string[] _lookups = null!;

    [Params(1_000, 100_000)]
    public int N;

    [GlobalSetup]
    public void Setup()
    {
        Book[] books = SampleBooks.Create(N);
        _list = new ListCatalog(books);
        _sorted = new SortedArrayCatalog(books);
        _dictionary = new DictionaryCatalog(books);
        Random random = new(7);
        // rastgele seçilmiş, katalogda var olan 100 ISBN
        _lookups = [.. Enumerable.Range(0, 100).Select(_ => books[random.Next(N)].Isbn)];
    }

    [Benchmark(Baseline = true)]
    public int List() => Run(_list);

    [Benchmark]
    public int SortedArray() => Run(_sorted);

    [Benchmark]
    public int Dictionary() => Run(_dictionary);

    private int Run(IBookCatalog catalog)
    {
        int found = 0;
        foreach (string isbn in _lookups)
            if (catalog.FindByIsbn(isbn) is not null) found++;
        return found;
    }
}
BenchmarkDotNet v0.15.8, macOS 27.0.1 (26A434) [Darwin 27.0.0]
Apple M5, 1 CPU, 10 logical and 10 physical cores
.NET SDK 10.0.402
[Host] : .NET 10.0.13 (10.0.13, 10.0.1326.50504), Arm64 RyuJIT armv8.0-a
| Method | N | Mean | Median | Ratio | Allocated |
|------------ |------- |---------------:|---------------:|------:|----------:|
| List | 1000 | 79,000.6 ns | 76,585.9 ns | 1.01 | - |
| SortedArray | 1000 | 2,055.1 ns | 2,018.0 ns | 0.03 | - |
| Dictionary | 1000 | 882.7 ns | 882.9 ns | 0.01 | - |
| | | | | | |
| List | 100000 | 9,693,796.6 ns | 9,634,433.9 ns | 1.004 | - |
| SortedArray | 100000 | 6,548.1 ns | 4,696.6 ns | 0.001 | - |
| Dictionary | 100000 | 930.2 ns | 913.9 ns | 0.000 | - |Tahminine dönelim. 1.000 kitapta List 100 aramayı 79 µs'de, Dictionary 0,88 µs'de bitiriyor: yaklaşık 90 kat. 100.000 kitapta List 9,7 ms'ye çıkıyor, Dictionary 0,93 µs'de kalıyor: fark 10.000 katı aşıyor. Katalog 100 kat büyüdü, List'in süresi de yaklaşık 120 kat büyüdü; Dictionary'nin süresi neredeyse hiç değişmedi. Sıralı array ise iki uçtan da farklı davranıyor: süre 2 µs'den 4,7–6,5 µs'ye çıktı. Arama başına karşılaştırma sayısı log₂(1.000) ≈ 10'dan log₂(100.000) ≈ 17'ye çıktı, üstüne 100.000 elemanlı array artık işlemcinin cache'ine sığmıyor.
Bu tabloda iki şey daha var. Birincisi, sıralı array'in 100.000'deki ortalaması (6,5 µs) ile medyanı (4,7 µs) arasındaki fark gürültü: ölçüm, makinede başka işler de çalışırken alındı. Mutlak sayılara değil, oranlara ve büyüme yönüne bak. İkincisi, "Allocated" sütunu üçünde de boş: arama sırasında hiçbiri heap'te yer ayırmıyor. Maliyet tamamen bellekte gezinmekten ve karşılaştırmadan geliyor.
BCL Hazırken Neden Kendin Yazarsın?
Production kodunda bu yazıdaki üç catalog'dan hiçbirini kendin yazmazsın. Dictionary, Array.BinarySearch ve List<T> zaten var, yıllardır test ediliyor ve senin yazacağın versiyondan büyük ihtimalle hızlılar. Bu seride yine de her yapıyı sıfırdan yazacağız. Bunun üç nedeni var.
Birincisi maliyeti görmek. List<T>.Insert(0, x)'in neden yavaş olduğunu, Dictionary'ye kötü GetHashCode veren bir key koyunca neden her şeyin çöktüğünü, Array.Sort'un neden eşit element'lerin sırasını korumadığını bir kez kendi elinle yazınca unutmazsın. Bu bilgi, bir code review'da "bu döngü içindeki Contains 50.000 kayıtta ne yapar?" sorusunu sorabilmeni sağlar.
İkincisi BCL'de olmayan ihtiyaçlar. Son N log satırını tutan ve dolunca en eskiyi ezen bir ring buffer, autocomplete için bir trie, duplicate müşteri hesaplarını gruplamak için union-find, bağımlılık sırası için topological sort BCL'de hazır gelmiyor. Bunları yazarken bu yazılardaki parçaları birleştireceksin.
Üçüncüsü interview'lar. Seri bunu hedef almıyor ama yan ürün olarak veriyor: two pointers, sliding window, BFS (Breadth-First Search), dynamic programming gibi pattern'leri gerçek Bookstore problemleri üzerinden öğrenince, tahta başında karşına çıkan soru da tanıdık gelir.
Serinin Çalışma Düzeni
Bütün kod tek bir solution'da duruyor. Solution dosyası XML (Extensible Markup Language) tabanlı .slnx formatında; .NET 10 SDK'da dotnet new sln artık varsayılan olarak bu formatı üretiyor:
Algorithms.slnx
# sdk 10.0.402 ve test runner olarak Microsoft.Testing.Platform
global.json
# net10.0, C# 14, Nullable ve ImplicitUsings açık
Directory.Build.props
# kendi yapılarımız: Linear, Hashing, Sorting, Trees, Graphs...
src/Algorithms/
# BenchmarkDotNet 0.15.8
src/Algorithms.Benchmarks/
# xUnit v3 4.0.2
tests/Algorithms.Tests/
Her yazıda sıra aynı. Önce yapının sözleşmesini bir test olarak yazıyoruz; çoğu zaman BCL'deki karşılığıyla karşılaştıran bir test, çünkü Dictionary ya da SortedSet elimizdeki en güvenilir referans. Rastgele işlemler üretip her adımda iki yapının aynı cevabı verdiğini doğrulayan testler seri boyunca sık karşına çıkacak. Sonra implementation, en son ölçüm. Benchmark'lar dotnet run -c Release --project src/Algorithms.Benchmarks -- --filter '*Catalog*' ile tek tek çalışıyor.
Seri Haritası
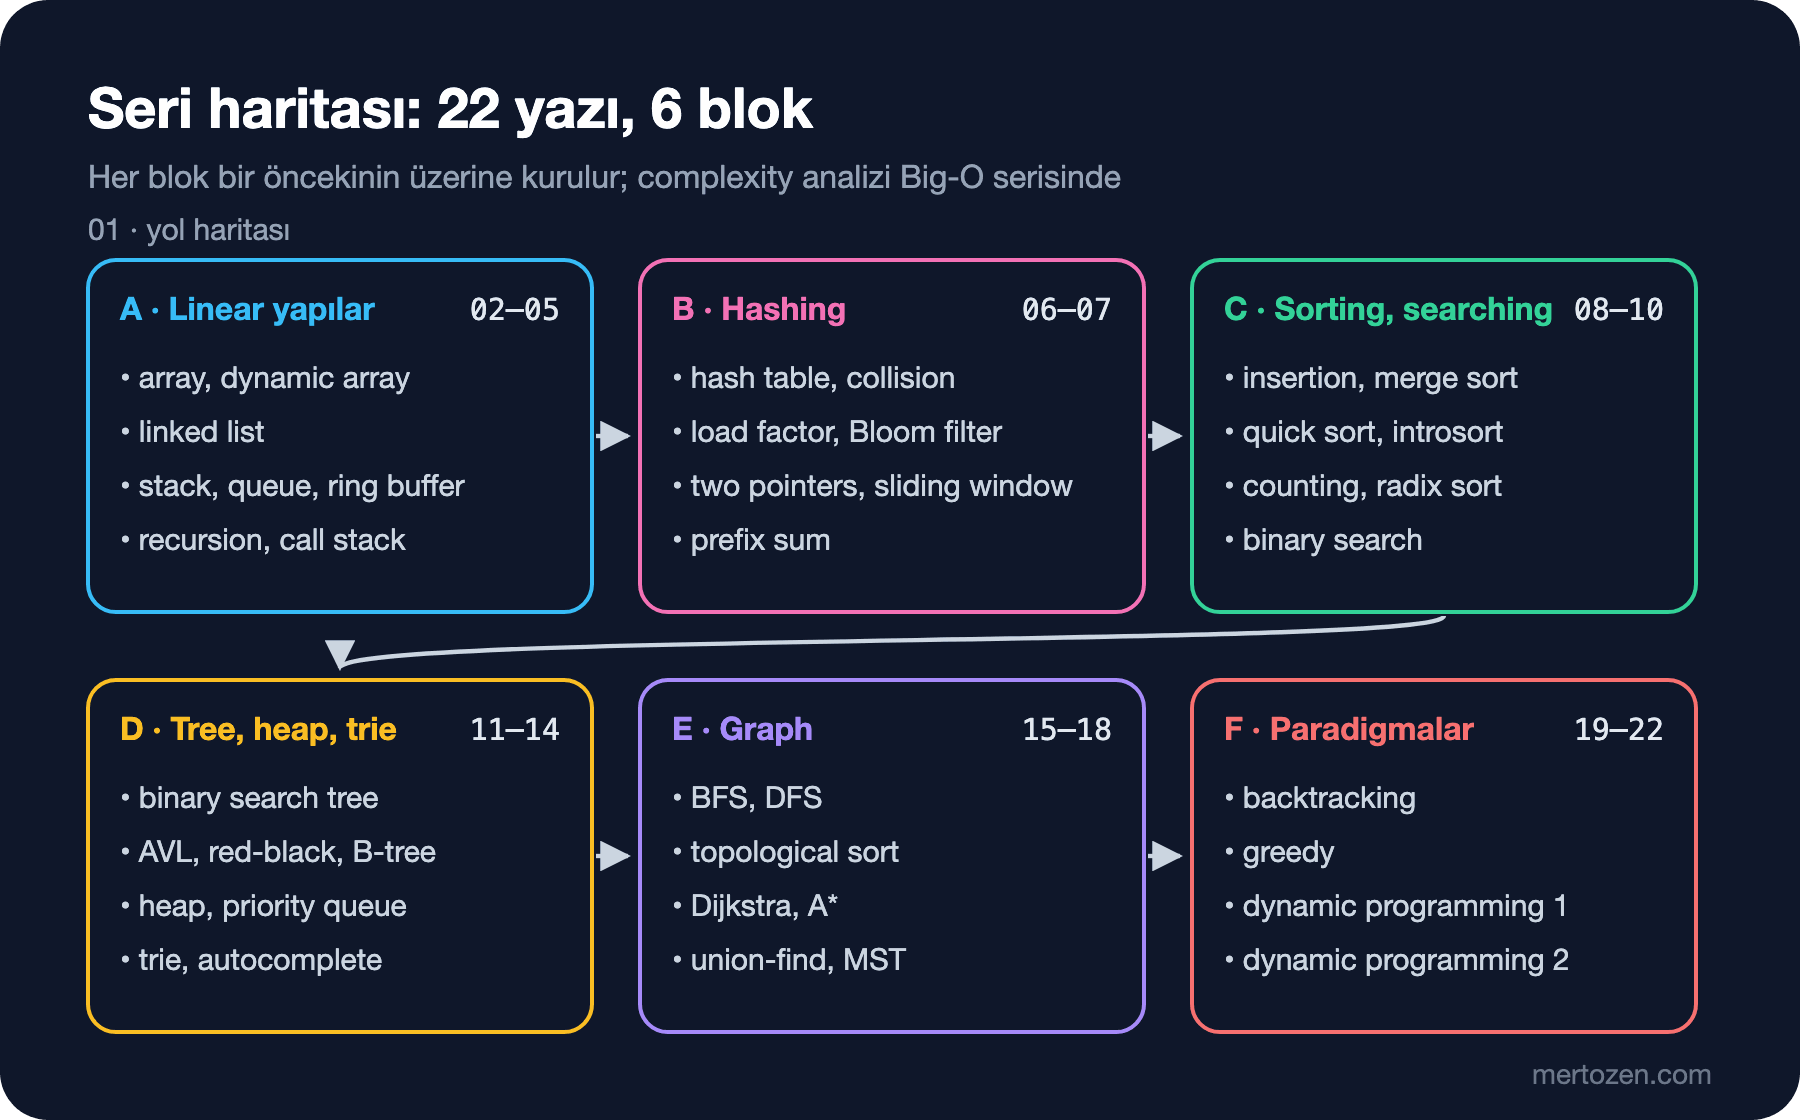
Seri 22 yazıdan oluşuyor ve altı blokta ilerliyor. Her blok bir öncekinin üzerine kuruluyor; sırayla okumanı öneririm.
- Linear yapılar (02–05): array ve dynamic array, linked list, stack, queue ve ring buffer, recursion ve call stack.
- Hashing (06–07): hash table'ı sıfırdan yazmak, ardından two pointers, sliding window ve prefix sum gibi array pattern'leri.
- Sorting ve searching (08–10): insertion ve merge sort, quick sort ile .NET'in introsort'u, binary search'ün bütün varyantları.
- Tree, heap ve trie (11–14): binary search tree, balanced tree'ler ve B-tree, heap ve priority queue, trie.
- Graph (15–18): BFS ve DFS (Depth-First Search), topological sort, Dijkstra, union-find ve minimum spanning tree.
- Paradigmalar (19–22): backtracking, greedy algoritmalar ve iki yazılık dynamic programming.
Seri iki yayınlanmış seriye yaslanıyor. .NET collection'larının API'si (Application Programming Interface) C# Koleksiyonlar serisinde anlatıldı; burada API tekrar edilmiyor, yalnızca iç yapıya ve kendi versiyonumuzla karşılaştırmaya bakılıyor. O serinin "C# Immutable Collection'lar ve Doğru Collection'ı Seçmek" yazısındaki complexity haritası bu serinin özeti gibi; yanında açık tutmaya değer. Complexity analizinin kendisi, yani O, Ω ve Θ'nın anlamı, koddan complexity çıkarmak ve amortized analysis Big-O ve Complexity serisinde. Bu seride her yapının complexity'si tek satırla verilip oraya gönderiliyor.
Üretimde Dikkat
n'i bugünkü veriye göre değil, iki yıl sonraki veriye göre düşün. Lansman günü 800 kitaplık bir katalogda List ile arama kimsenin dikkatini çekmez; tablo ölçümü 79 µs diyor. Aynı kod 100.000 kitapta, sepet başına 100 aramayla 9,7 ms'ye çıkıyor ve bu süre her istekte ödeniyor. Saniyede 200 istek alan bir endpoint'te bu, yalnızca arama için iki CPU (Central Processing Unit) çekirdeğinin neredeyse tamamı demek. Kod değişmedi; veri büyüdü.
Her yapının bir kurulum ve güncelleme maliyeti var. Sıralı array aramada iyi ama yeni bir kitap eklemek, sırayı korumak için sağdaki bütün element'leri kaydırmak demek. Katalog günde bir kez yükleniyorsa sorun değil; dakikada yüzlerce fiyat ve stok güncellemesi geliyorsa sorun. Dictionary hem aramada hem eklemede hızlı ama sıra bilgisi tutmuyor. "ISBN aralığındaki kitapları ver" gibi bir sorguya cevap veremiyor. Yapıyı seçerken yalnız en sık işleme değil, bütün işlemlerin karışımına bak.
Bellek de bir maliyet. Dictionary her kayıt için key'in hash code'unu ve zincir bilgisini de tutuyor; aynı veriyi sıralı bir array'den daha fazla bellekle saklıyor. Birkaç milyon kayıtta bu fark bir container'ın bellek sınırını belirleyebilir. Ölçerken [MemoryDiagnoser]'ı açık tut ve kurulum maliyetini ayrıca ölç.
Sık Düşülen Tuzaklar
Küçük veriyle ölçüp karar vermek. 1.000 kayıtta List ile Dictionary arasındaki 78 µs'lik fark kimseye bir şey ifade etmez; aynı fark 100.000 kayıtta 10.000 kata çıkıyor. Ölçümü production'daki gerçek n ile ya da ondan büyüğüyle yap.
Interface'in arkasındaki maliyeti görmemek. IEnumerable<Book> alan bir method'da books.Contains(x) çağırmak, arkada bir HashSet varsa ucuz, bir List ya da lazy bir LINQ (Language Integrated Query) sorgusu varsa pahalı. Kod aynı görünüyor; maliyet tamamen implementation'a bağlı.
Stopwatch ile tek seferlik ölçüm. İlk çağrı JIT derlemesini içeriyor, sonraki çağrılar cache'ten faydalanıyor; tek bir ölçüm ikisini de karıştırıyor. Performans iddiası BenchmarkDotNet çıktısıyla gelmeli.
Her şeyi kendin yazmaya kalkmak. Bu seri yapıları öğrenmek için yazıyor; production'da BCL'nin test edilmiş collection'ları varsayılan seçim. Kendi yapını ancak BCL'de karşılığı yoksa ya da ölçüm BCL'nin ihtiyacını karşılamadığını gösteriyorsa yaz.
Küçük Bir Deneme
★☆☆ CatalogBenchmarks'a [Params] ile 10.000 ve 1.000.000 değerlerini ekle. List'in süresi n ile doğru orantılı mı büyüyor? Sıralı array'in süresi hangi noktada belirgin biçimde artıyor?
★★☆ Aranan 100 ISBN'in yarısını katalogda olmayan ISBN'lerle değiştir. Hangi implementation'ın süresi değişiyor, hangisininki değişmiyor? Nedenini her birinin döngüsüne bakarak açıkla.
★★★ IBookCatalog'a IReadOnlyList<Book> FindByIsbnPrefix(string prefix) ekle. Üç implementation'dan hangisi bu işi verimli yapabiliyor, hangisi yapamıyor? Sıralı array için lower bound fikrini kullanarak bir çözüm yaz ve List versiyonuyla karşılaştıran bir test ekle.
Bir sonraki yazıda serinin en temel yapısıyla başlıyoruz: array. int[] ile object[]'in bellekte nasıl durduğuna, index hesabına ve bounds check'e bakıp kendi DynamicArray<T>'imizi yazacağız; List<T>'nin capacity'si dolduğunda tam olarak ne olduğunu göreceğiz.