

LRU ve LFU Cache: Dictionary + LinkedList ile O(1) Eviction ve .NET'teki Hazır Seçenekler
LRU cache, key'i bulmak için bir Dictionary'yi, kullanım sırasını tutmak için bir LinkedList'i birleştirir; Dictionary node'un kendisini tuttuğu için get ve put O(1) olur. C# ile LRU ve O(1) LFU yazıyor, List tabanlı versiyonun 13 kat yavaşladığını, tarama trafiğinde LRU'nun hit ratio'sunun yüzde 52'ye düştüğünü ve IMemoryCache'in neden bir LRU olmadığını ölçüyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve C# 14 ile derlenip xUnit v3 4.0.2 testleriyle doğrulanmıştır; ölçümler BenchmarkDotNet 0.15.8 ile alınmıştır. Karşılaştırmada Microsoft.Extensions.Caching.Memory 10.0.15 ve BitFaster.Caching 2.6.1 kullanıldı.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı), katalog sayfasında her kitabın kapak thumbnail'ini gösteriyor. Bunları her istekte diskten ya da blob storage'dan okumak yerine process içinde, sınırlı bir bellekle tutmak istiyoruz: en fazla 100 kapak, yer kalmayınca en uzun süredir kullanılmayan çıkar. Bu politikanın adı LRU (Least Recently Used; en uzun süredir kullanılmayanı çıkaran eviction politikası).
İki soru. Birincisi: "en uzun süredir kullanılmayan"ı bulmak için kaç element'e bakmak gerekir; 100 mü, log₂ 100 mü, 1 mi? İkincisi: trafiğin yarısı 80 popüler kitaptan, diğer yarısı da bütün kataloğu sırayla okuyan bir sitemap crawler'ından geliyorsa, 100 kapaklık LRU cache popüler kitaplarda isteklerin yüzde kaçını cache'ten karşılar? Popüler kitapların hepsi cache'e sığıyor; sezgin "neredeyse hepsini" diyor olabilir.
İki Yapıyı Birleştirmek: Dictionary + LinkedList
LRU iki ayrı soruya hızlı cevap ister: "bu key cache'te mi?" ve "en eski kullanılan hangisi?". İlkine hash table, ikincisine kullanım sırasını tutan bir liste cevap verir. Liste tek başına yetmez; key'i listede bulmak O(n). Hash table tek başına da yetmez; sıra tutmaz. Hile, hash table'ın değer olarak listedeki node'un kendisini tutması:
// Dictionary: key -> liste node'u (O(1) arama); LinkedList: en yeni başta, en eski sonda
public sealed class LruCache<TKey, TValue> where TKey : notnull
{
    private readonly int _capacity;
    private readonly Dictionary<TKey, LinkedListNode<KeyValuePair<TKey, TValue>>> _map;
    private readonly LinkedList<KeyValuePair<TKey, TValue>> _order = new();

    public bool TryGet(TKey key, out TValue value)
    {
        if (_map.TryGetValue(key, out LinkedListNode<KeyValuePair<TKey, TValue>>? node))
        {
            MoveToFront(node);
            value = node.Value.Value;
            return true;
        }

        value = default!;
        return false;
    }

    public void Put(TKey key, TValue value)
    {
        if (_map.TryGetValue(key, out LinkedListNode<KeyValuePair<TKey, TValue>>? node))
        {
            node.Value = new(key, value);
            MoveToFront(node);
            return;
        }

        if (_map.Count == _capacity)
        {
            LinkedListNode<KeyValuePair<TKey, TValue>> lru = _order.Last!;
            _order.RemoveLast();
            _map.Remove(lru.Value.Key);
            Evicted?.Invoke(lru.Value.Key, lru.Value.Value);
        }

        _map[key] = _order.AddFirst(new KeyValuePair<TKey, TValue>(key, value));
    }

    private void MoveToFront(LinkedListNode<KeyValuePair<TKey, TValue>> node)
    {
        if (node == _order.First) return;
        _order.Remove(node); // O(1): node elimizde
        _order.AddFirst(node);
    }
}
Constructor kapasiteyi doğruluyor, Remove ve Evicted event'i de class'ta var; yukarıda yalnız işin kalbi duruyor. Node'un içinde key'i de tutmamızın sebebi eviction: listenin sonundaki node'u çıkarınca Dictionary'den hangi key'i sileceğimizi bilmemiz gerekiyor.
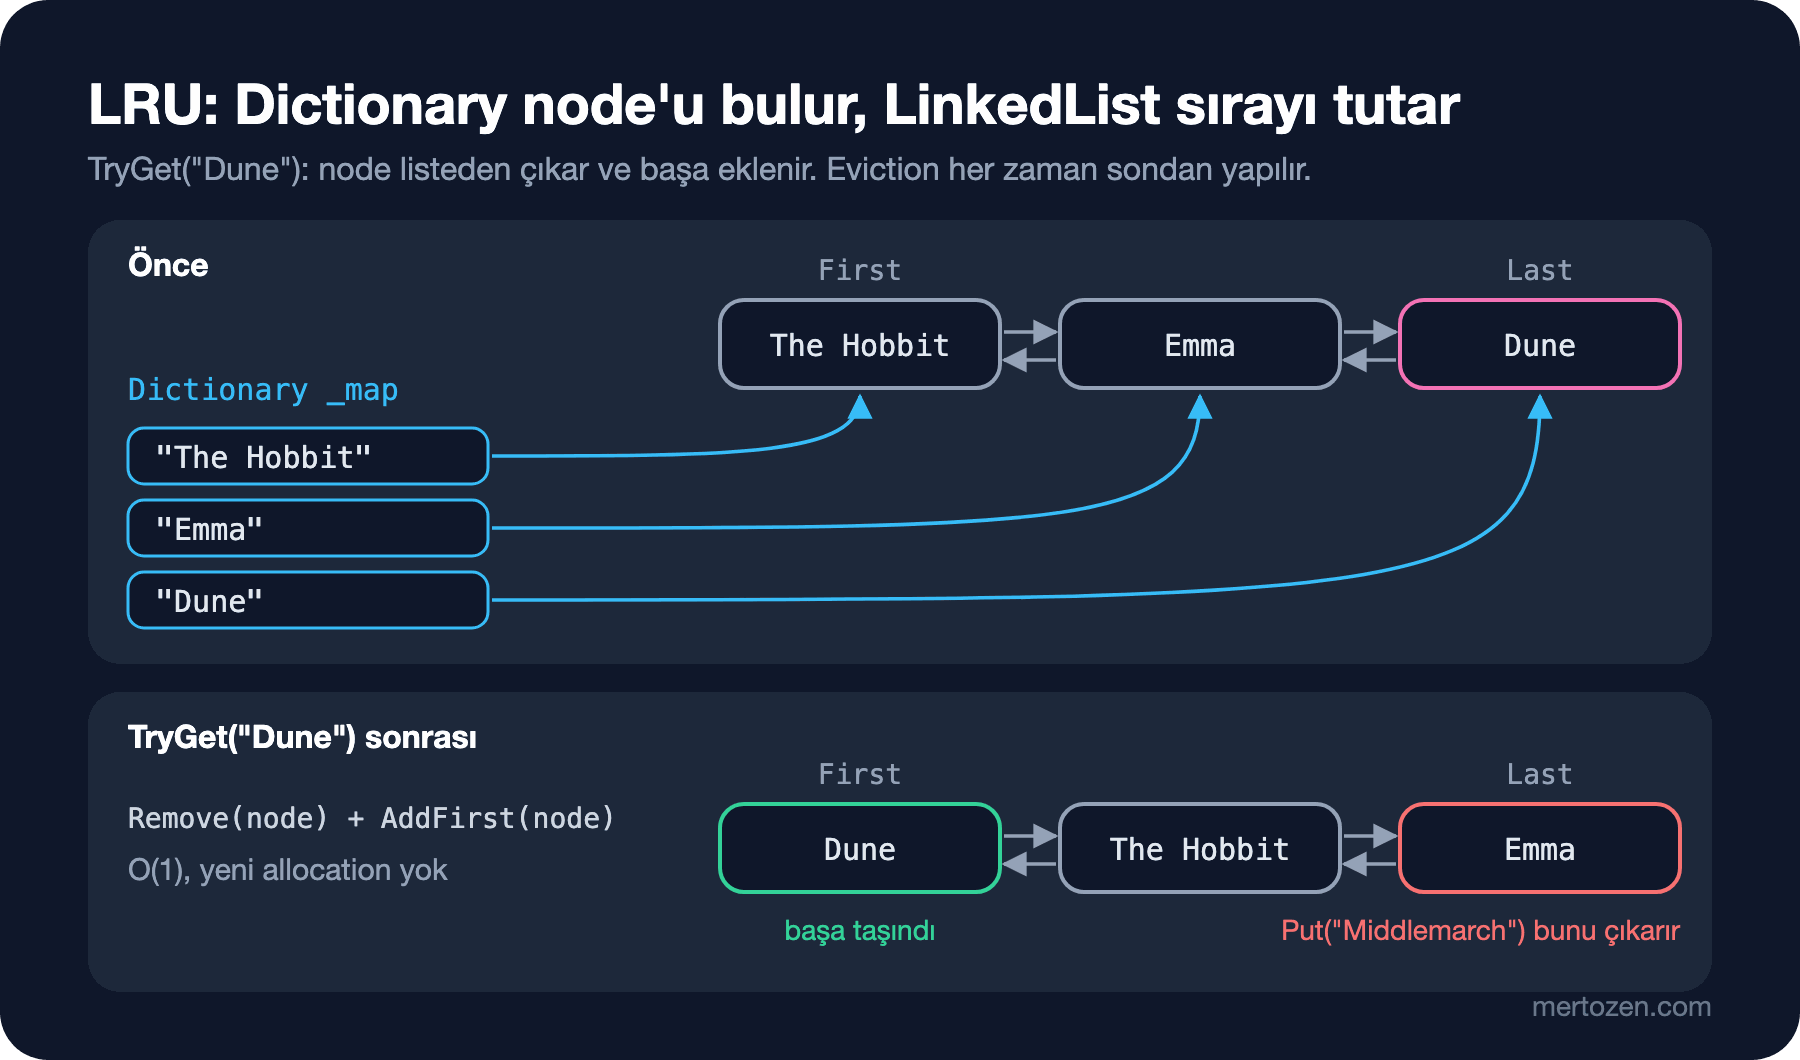
order: The Hobbit, Emma, Dune
after get Dune: Dune, The Hobbit, Emma
evicted: Emma
after put Middlemarch: Middlemarch, Dune, The Hobbit
Dune cache'e ilk girendi; okunduğu için başa geçti ve Middlemarch geldiğinde çıkan Emma oldu. İlk sorunun cevabı 1: en eski kullanılan her zaman listenin son node'u, aramaya gerek yok. LinkedList<T>'nin doubly linked ve circular olduğunu, Remove(LinkedListNode<T>)'nin bu yüzden O(1) çalıştığını C# Koleksiyonlar serisinin "C# Queue, Stack, LinkedList ve PriorityQueue: Sırayla Çalışan Collection'lar" yazısında, node'ları elle yeniden bağlamayı da serinin 3. yazısında gördük. Hem TryGet hem Put ortalama O(1); "ortalama" kelimesi Dictionary'den geliyor, resize maliyetinin neden dağıtılmış sayıldığı Big-O ve Complexity serisinin "Amortized Analysis: List<T>.Add Neden O(1) Sayılır" yazısında.
O(1) ile O(n) Arasındaki Farkı Ölçmek
Aynı sözleşmeyi sırayı bir List<TKey>'de tutarak da yazabilirsin; her hit'te _order.Remove(key) listeyi baştan tarar. Kod daha kısa ve ilk bakışta masum. 100.000 istekte, yaklaşık yarısı hit olacak şekilde üç implementation'ı ölçtüm; üçüncüsü BitFaster.Caching paketinin thread-safe ConcurrentLru'su:
[Benchmark(Baseline = true)]
public int DictionaryPlusLinkedList()
{
    LruCache<int, int> cache = new(Capacity);
    int hits = 0;
    foreach (int key in _keys)
    {
        if (cache.TryGet(key, out _)) hits++;
        else cache.Put(key, key);
    }

    return hits;
}
Benchmark'ları tek tek çalıştırdım ama makinede paralel işler vardı. Mutlak süreler makineye bağlı; sen kendi makinende farklı sayılar görürsün, karşılaştırılacak olan Ratio sütunu.
| Method                   | Capacity | Mean      | Ratio | Allocated  |
|------------------------- |--------- |----------:|------:|-----------:|
| DictionaryPlusLinkedList | 1000     |  1.967 ms |  1.00 | 2395.45 KB |
| DictionaryPlusList       | 1000     |  6.793 ms |  3.45 |   25.63 KB |
| BitFasterConcurrentLru   | 1000     |  3.091 ms |  1.57 | 3686.91 KB |
|                          |          |           |       |            |
| DictionaryPlusLinkedList | 10000    |  3.029 ms |  1.00 | 2755.11 KB |
| DictionaryPlusList       | 10000    | 40.259 ms | 13.29 |  236.57 KB |
| BitFasterConcurrentLru   | 10000    |  5.200 ms |  1.72 | 5001.24 KB |
Kapasite 10 katına çıkınca LinkedList'li versiyonun süresi 1,5 kat artıyor (Dictionary büyüyor, cache miss'ler artıyor); List'li versiyonun süresi 6 kat. Aradaki oran 3,45'ten 13,29'a çıkıyor ve kapasiteyle birlikte büyümeye devam eder. Bedeli allocation tarafında: her yeni key bir LinkedListNode ayırıyor, List versiyonu ise neredeyse hiç ayırmıyor. Hit'lerde node yeniden kullanıldığı için allocation yok; ayrılan bellek miss sayısıyla orantılı. ConcurrentLru bizimkinden 1,6–1,7 kat yavaş görünüyor, ama bu adil bir karşılaştırma değil: o, lock almadan birden fazla thread'den kullanılabiliyor, bizimki kullanılamıyor.
LRU'nun Çöktüğü Yer: Tarama Trafiği
Açılıştaki ikinci soruya gelelim. 200.000 isteklik bir trace hazırladım: her istek yüzde 50 ihtimalle 80 popüler kitaptan biri, yüzde 50 ihtimalle de 5.000 kitaplık kataloğu sırayla gezen crawler'ın bir sonraki kitabı. Kapasite 100. Aynı trace'i dört cache'e verdim:
trace: 200,000 requests, capacity 100
LruCache (ours)          hit ratio on popular covers: 51.9%
LfuCache (ours)          hit ratio on popular covers: 99.8%
BitFaster ConcurrentLru  hit ratio on popular covers: 99.8%
BitFaster ConcurrentLfu  hit ratio on popular covers: 98.4%
Popüler 80 kitabın hepsi 100'lük cache'e sığdığı halde LRU isteklerin ancak yarısını karşılıyor. Sebep: bir popüler kitap ortalama 160 istekte bir okunuyor ve bu arada crawler 80 tane, bir daha hiç istenmeyecek kitap getiriyor. LRU için "son kullanılan" ile "değerli olan" aynı şey; crawler'ın her kitabı listenin başına geçip popüler kitabı sondan itiyor. Bu davranışa cache pollution denir; rapor job'ları, export'lar ve crawler'lar onu üretim trafiğinde sürekli yaratır.
Literatür bu sorunu birkaç yoldan çözüyor. LRU-K (O'Neil, O'Neil ve Weikum, 1993) son K erişimin zamanına bakar; yalnız bir kez görülen key'i değerli saymaz. 2Q (Johnson ve Shasha, 1994) yeni gelenleri önce küçük bir giriş queue'sunda tutar, ikinci kez istenirse asıl alana alır. BitFaster'ın ConcurrentLru'su 2Q ailesinden türetilmiş bir politika kullanıyor; tablodaki 99,8 bu yüzden. W-TinyLFU (Einziger, Friedman ve Manes) ise yeni key'i cache'e almadan önce, çıkacak olanla yaklaşık frekanslarını karşılaştırır; Java'nın Caffeine kütüphanesi ve BitFaster'ın ConcurrentLfu'su bunu kullanıyor. Frekansı az bellekle tahmin etmek için kullandığı Count-Min Sketch'i serinin ilerideki probabilistic data structure yazısında yazacağız.
LFU: Frekans Başına Bir Liste
LFU (Least Frequently Used; en az kullanılanı çıkaran politika) "kaç kez istendi?" sorusuna bakar. Saf haliyle bunun için bir heap kullanılabilir (serinin 13. yazısı), ama her hit'te frekans değiştiği için her erişim O(log n) olur. Shah, Mitra ve Matani'nin 2010 tarihli makalesindeki fikirle O(1) yapılabilir: her frekans için bir liste ve en küçük frekansı tutan tek bir sayı.
private void Touch(LinkedListNode<Entry> node)
{
    int f = node.Value.Frequency;
    LinkedList<Entry> list = _byFrequency[f];
    list.Remove(node);
    if (list.Count == 0)
    {
        _byFrequency.Remove(f);
        if (_minFrequency == f) _minFrequency = f + 1;
    }

    node.Value.Frequency = f + 1;
    Bucket(f + 1).AddFirst(node);
}
Eviction _byFrequency[_minFrequency] listesinin son node'unu çıkarır: en az kullanılanlar arasında da en eski kullanılan. Yeni key her zaman frekans 1 ile girer ve _minFrequency 1'e döner. Frekans yalnız bir artar ve boşalan liste en küçük frekanssa en küçük frekans da yalnız bir artar; bu yüzden hiçbir yerde arama yok.
LFU'nun kendi zayıflığı da var: dün çok satan bir kitabın frekansı bugün de yüksek kalır ve cache'te yer tutmaya devam eder. Gerçek implementation'lar frekansları periyodik olarak yarıya indirir (aging) ya da W-TinyLFU gibi bir pencereyle sınırlar.
Thread-Safety: Okumak da Yazmaktır
ASP.NET Core'da bu cache singleton olur ve aynı anda onlarca request'ten çağrılır. Bizim LruCache'imizi Parallel.For ile bir milyon kez çağırdım:
ArgumentNullException: Value cannot be null. (Parameter 'node')
synchronized: Count = 100
İlk satır bir koşunun sonucu; hata her seferinde farklı yerde, bazen başka bir exception olarak çıkar, bazen hiç çıkmaz ve sadece liste ile Dictionary birbirini tutmaz. Kritik nokta: TryGet salt okuma değil, listenin sırasını değiştiriyor. Bu yüzden ReaderWriterLockSlim ile okumaları paralel bırakmak işe yaramaz; en basit doğru çözüm her işlemi aynı lock'a almak:
// TryGet de listenin sırasını değiştirir; okumalar da yazmalarla aynı lock'u almalı
public sealed class SynchronizedLruCache<TKey, TValue>(int capacity) where TKey : notnull
{
    private readonly LruCache<TKey, TValue> _inner = new(capacity);
    private readonly Lock _gate = new();

    public bool TryGet(TKey key, out TValue value)
    {
        lock (_gate) return _inner.TryGet(key, out value);
    }

    public void Put(TKey key, TValue value)
    {
        lock (_gate) _inner.Put(key, value);
    }
}
Tek lock yoğun trafikte darboğaz olur. ConcurrentDictionary bunu çözmez; thread-safe bir dictionary'dir ama ne kapasitesi ne eviction'ı var. Yüksek eşzamanlılıkta okumaları buffer'a yazıp sırayı sonradan güncelleyen ConcurrentLru/ConcurrentLfu gibi hazır bir implementation, kendi lock'lu versiyonundan genellikle daha iyi bir seçimdir.
IMemoryCache LRU Değil
.NET'in hazır process içi cache'i IMemoryCache. SizeLimit verip doldurunca ne yaptığına baktım: 100 entry koydum, ilk 50'sini okudum, sonra 101'incisini ekledim.
MemoryCacheOptions options = new() { SizeLimit = 100 };
Console.WriteLine($"CompactionPercentage default: {options.CompactionPercentage}");
using MemoryCache cache = new(options);
for (int i = 0; i < 100; i++)
{
    cache.Set(i, $"cover-{i}", new MemoryCacheEntryOptions { Size = 1 });
    Thread.Sleep(1); // LastAccessed değerleri birbirinden farklı olsun
}

for (int i = 0; i < 50; i++) cache.TryGetValue(i, out _); // 0..49 artık en son kullanılanlar

cache.Set("new", "cover-new", new MemoryCacheEntryOptions { Size = 1 });
CompactionPercentage default: 0.05
right after Set(new): Count=95, contains new=False
after compaction: Count=95, removed=[50, 51, 52, 53, 54]
Set(new) again: contains new=TrueLRU, yeni gelen için en eskiyi çıkarırdı. MemoryCache ise limiti aşacak yeni entry'yi hiç kaydetmiyor ve arka planda bir compaction başlatıyor. Compaction, kaynak koduna göre önce süresi dolmuşları, sonra priority sırasıyla (önce Low) ve aynı priority içinde en eski erişilenleri siliyor; varsayılan oran yüzde 5. Çıkarılanların 50–54 olması bu son adımın sonucu. Yani yer açıldıktan sonraki ikinci Set başarılı oluyor, ilk istek ise cache'e hiç girmiyor. SizeLimit, Size zorunluluğu ve eviction ayrıntıları Caching serisinin "IMemoryCache Derinlemesine: SizeLimit, Eviction, Change Token ve GetOrCreate'in Gizli Stampede'i" yazısında; burada önemli olan, IMemoryCache'i "hazır bir LRU" diye düşünmemek.
Bookstore: Kapakları Byte ile Sınırlamak
"En fazla 100 kapak" kulağa iyi geliyor ama kapakların boyutu 8 KB ile 60 KB arasında değişiyor. Bellek sınırı gerçekten bir byte sınırıysa, kapasiteyi entry sayısıyla ölçmek yanlış soruyu cevaplar. Eviction döngüsü yeni element sığana kadar sondan çıkarır:
public bool Put(TKey key, byte[] data)
{
    if (data.Length > _maxBytes) return false; // asla sığmaz; bunun için bütün cache'i boşaltma
    Remove(key);
    while (CurrentBytes + data.Length > _maxBytes)
    {
        (TKey oldKey, byte[] oldData) = _order.Last!.Value;
        _order.RemoveLast();
        _map.Remove(oldKey);
        CurrentBytes -= oldData.Length;
    }

    _map[key] = _order.AddFirst((key, data));
    CurrentBytes += data.Length;
    return true;
}
Aynı 1.000 kapağı iki cache'e koydum:
capacity 100 entries: 100 covers, 3.12 MB
capacity 2 MB:        62 covers, 1.97 MB
"100 kapak" diye planlanan cache 3,12 MB tutuyor; kapaklar büyüdükçe bu sayı da büyür. Byte sınırlı versiyon her zaman 2 MB altında kalıyor, ama tuttuğu kapak sayısı değişiyor. İlk satırdaki kontrol önemli: limitten büyük tek bir dosya gelirse döngü bütün cache'i boşaltır ve yine de sığdıramaz.
Üretimde Dikkat
Hit ratio'yu ölç. Cache'in işe yarayıp yaramadığını yalnız hit/miss sayıları söyler; tarama trafiğindeki yüzde 51,9 gibi bir değeri metrik olmadan fark edemezsin. Ölçümün nasıl yapılacağı Caching serisinin "Cache'i Ölçmek ve Test Etmek: Hit Ratio, Metric'ler, Bellek Kullanımı ve Tutarlılık Testleri" yazısında.
Value'nun boyutunu hesaba kat. Node, KeyValuePair ve Dictionary entry'si entry başına sabit bir overhead ekler; küçük value'larda bu overhead value'nun kendisinden büyük olabilir.
Process içi cache her instance'ta ayrıdır. Üç pod çalışıyorsa üç ayrı LRU vardır ve her biri kendi trafiğini görür. Paylaşılan bir cache gerekiyorsa Redis gibi bir dış cache'e geçmek gerekir; o zaman eviction politikası da Redis'in ayarıdır.
Kendin yazma, ama nasıl çalıştığını bil. Production'da BitFaster.Caching gibi test edilmiş bir kütüphane ya da IMemoryCache çoğu zaman doğru seçim. Kendi LRU'nu yazdığında hangi trafiğe dayanıp hangisinde çöktüğünü bilirsin.
Sık Düşülen Tuzaklar
Dictionary'den silip listeden silmemek. Remove yalnız _map.Remove(key) yaparsa node listede kalır. Aynı key tekrar eklendiğinde listede iki node olur; eski node sona ulaşıp evict edildiğinde Dictionary'den aynı key'i, yani yeni ve canlı entry'yi siler. Sonuç: hem bellek sızıntısı hem de az önce eklenen bir key'in miss vermesi. Remove_ExistingKey_RemovesNodeFromListToo testi bunu liste ve Dictionary sayılarının eşitliğiyle yakalıyor.
Kapasiteyi entry sayısıyla tanımlamak. Value boyutları değişkense, sınırı byte cinsinden koy ve limitten büyük value'yu reddet.
Okumaları lock'suz bırakmak. LRU'da her okuma bir yazmadır; "sadece get çağırıyoruz" diye lock'u atlamak, yukarıdaki ArgumentNullException gibi rastgele ve tekrarlanması zor hatalar doğurur.
LRU'yu her trafik için doğru sanmak. Tek seferlik taramalar LRU'yu boşaltır. Trafiğinde rapor, export ya da crawler varsa scan'e dayanıklı bir politika seç ya da bu istekleri cache'i hiç kullanmadan geçir.
Küçük Bir Deneme
★☆☆ LruCache'e TimeSpan cinsinden bir TTL (time to live; entry'nin geçerli kalacağı süre) ekle: TryGet süresi dolmuş entry'yi miss sayıp silsin. Zamanı testte kontrol edebilmek için TimeProvider kullan.
★★☆ Tarama trace'ini 2Q'nun basit bir versiyonuyla tekrar çalıştır: yeni key'ler önce kapasitenin yüzde 25'i kadar bir giriş listesine girsin, yalnız ikinci kez istenenler asıl LRU'ya geçsin. Popüler kitaplardaki hit ratio 51,9'dan kaça çıkıyor?
★★★ LfuCache'e aging ekle: her 10.000 erişimde bütün frekansları yarıya indir. İlk 100.000 istekte 80 kitabın, sonraki 100.000 istekte başka 80 kitabın popüler olduğu bir trace yaz ve aging'li ile aging'siz versiyonların ikinci yarıdaki hit ratio'larını karşılaştır.
LRU, hash table ile linked list'i birleştirdi. Bir sonraki yazıda da benzer bir birleşimi string aramasında göreceğiz: Aho-Corasick, serinin trie yazısındaki yapıya failure link'ler ekleyerek yüzlerce yasaklı kelimeyi bir yorum metninde tek geçişte bulur; .NET'in SearchValues<string>'inin içinde ne olduğuna da bakacağız.