

Dynamic Programming 2: Edit Distance, LCS ve Knapsack ile Gerçek Problemler

İki boyutlu DP tabloları iki string'in ya da bir bütçenin prefix'lerini tutar: Levenshtein ile "Bunu mu demek istediniz?", LCS ile git diff'le aynı çıktıyı veren bir diff, 0/1 knapsack ile bütçe sınırlı kampanya seçimi. C# ile üçünü yazıyor, eşikli Levenshtein'ın 20 kat hızlandığını ölçüyor, tek satırlık knapsack'te döngü yönü tuzağını gösteriyor ve seriyi bir pattern karar tablosuyla kapatıyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve C# 14 ile derlenip xUnit v3 4.0.2 testleriyle doğrulanmıştır; ölçümler BenchmarkDotNet 0.15.8 ile, diff karşılaştırması Git 2.54 ile alınmıştır.
Önce Tahmin Et
Bookstore'un arama kutusuna bir kullanıcı "dnue" yazıyor. Kataloğumuzda "Dune" var. İki kelime arasındaki farkı, bir kelimeyi diğerine çevirmek için gereken en az harf ekleme, silme ve değiştirme sayısıyla ölçüyoruz (edit distance). "dnue" ile "dune" arasındaki mesafe kaç? İki harfin yeri değişmiş, o halde 1 mi? Ve bunu hesaplayan kod, kataloğumuzdaki 10.000 başlığı her aramada tararsa ne kadar sürer?
İki Boyutlu State: Prefix'ler Tablosu
Serinin 21. yazısında state tek bir sayıydı. İki string'i karşılaştırırken state iki boyutlu: d[i, j], a'nın ilk i harfini b'nin ilk j harfine çevirmenin en az maliyeti. Beş adımlı tarifle okuyalım. Transition: a'nın i'nci harfi ile b'nin j'nci harfine bakarız. Eşitse maliyetsiz ilerleriz (d[i-1, j-1]). Değilse üç seçenek var: harfi değiştir (d[i-1, j-1] + 1), a'dan sil (d[i-1, j] + 1), b'nin harfini ekle (d[i, j-1] + 1); en küçüğünü alırız. Base case: boş string'e çevirmek için her şeyi sil (d[i, 0] = i), boş string'den çevirmek için her şeyi ekle (d[0, j] = j). Sıra: satır satır, soldan sağa. Cevap: d[n, m].
// d[i, j] = a'nın ilk i harfini b'nin ilk j harfine çevirmenin en az işlemi
public static int[,] Table(string a, string b)
{
    int[,] d = new int[a.Length + 1, b.Length + 1];
    for (int i = 0; i <= a.Length; i++) d[i, 0] = i; // hepsini sil
    for (int j = 0; j <= b.Length; j++) d[0, j] = j; // hepsini ekle
    for (int i = 1; i <= a.Length; i++)
    {
        for (int j = 1; j <= b.Length; j++)
        {
            int replace = d[i - 1, j - 1] + (a[i - 1] == b[j - 1] ? 0 : 1);
            int delete = d[i - 1, j] + 1;
            int insert = d[i, j - 1] + 1;
            d[i, j] = Math.Min(replace, Math.Min(delete, insert));
        }
    }

    return d;
}
Bu Levenshtein distance; Vladimir Levenshtein'ın 1965 tarihli çalışmasından adını alır. Açılıştaki sorunun tablosu:
      ε d u n e
   ε  0 1 2 3 4
   d  1 0 1 2 3
   n  2 1 1 1 2
   u  3 2 1 2 2
   e  4 3 2 2 2
dnue -> dune: 2
kitten -> sitting: 3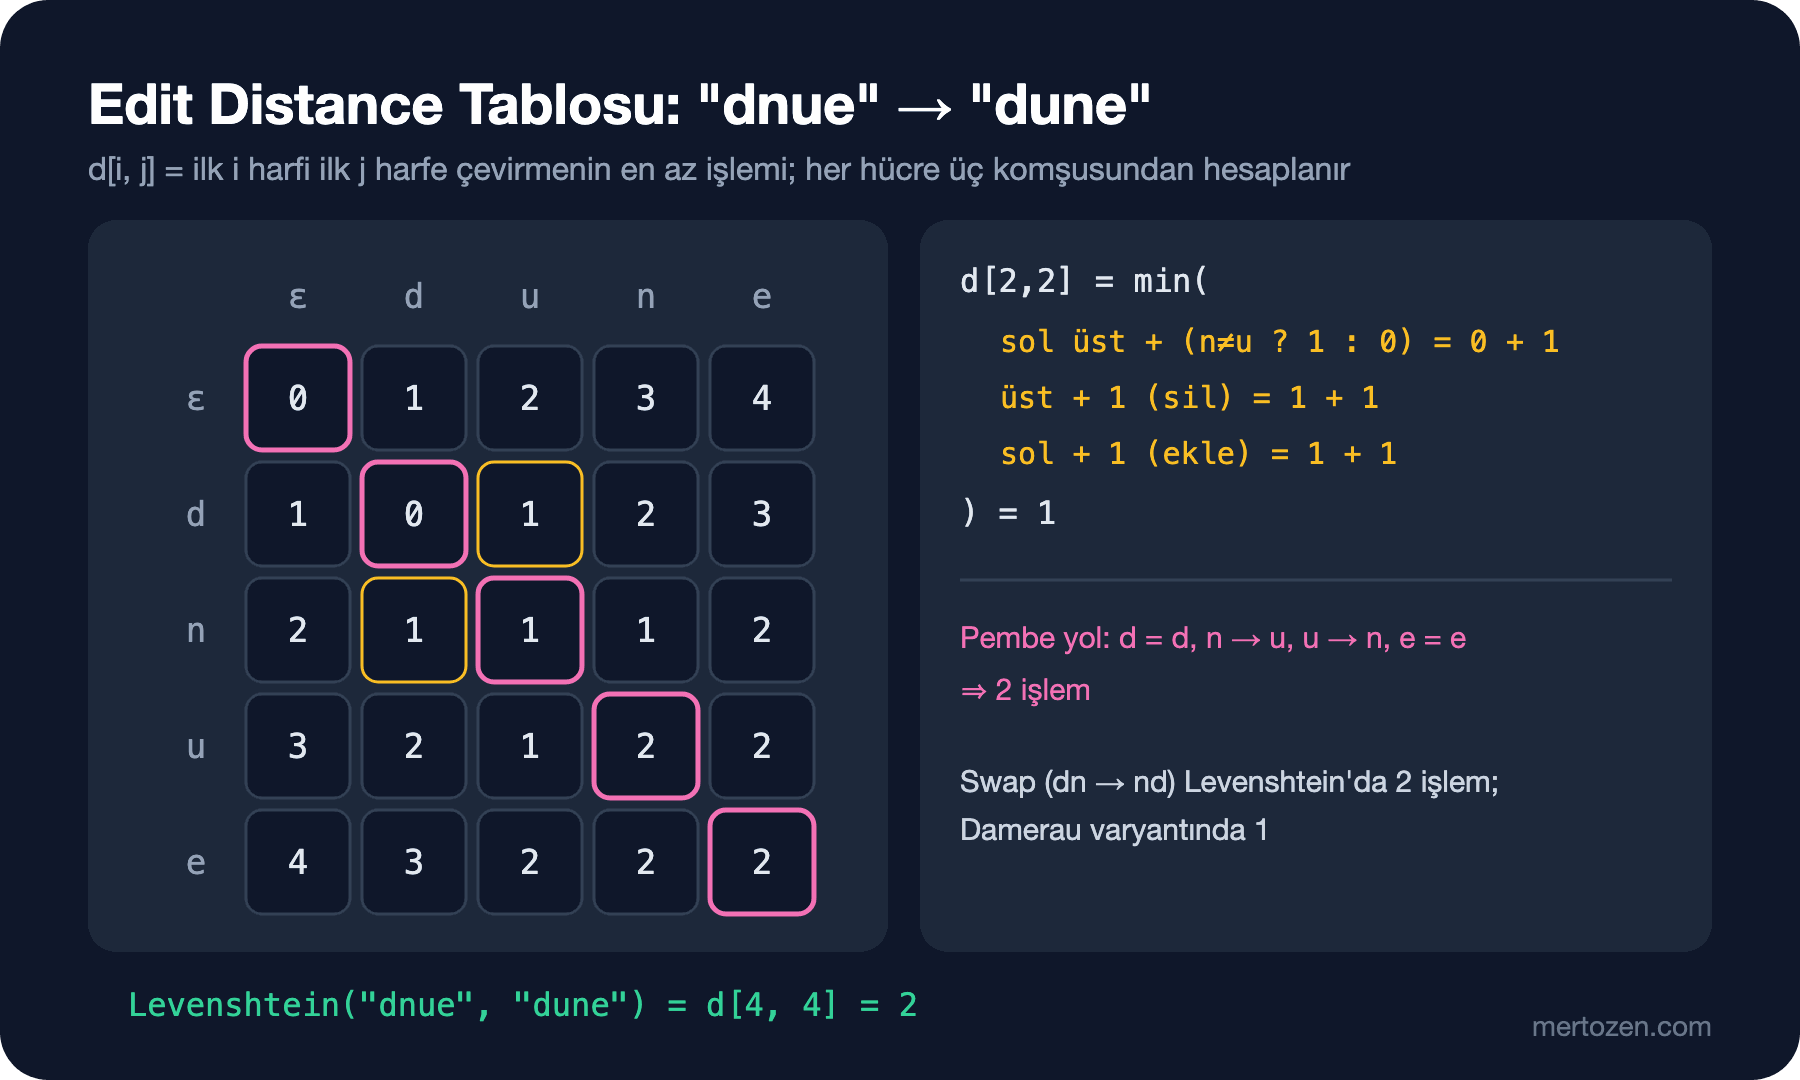
Cevap 1 değil 2. Levenshtein'ın üç işleminde "iki komşu harfin yerini değiştir" yok; yer değiştirme bir değiştirme ve bir değiştirme daha, ya da bir silme ve bir ekleme olarak sayılır. Komşu harf yer değiştirmesini tek işlem sayan varyant Damerau-Levenshtein distance; klavyede en sık yapılan hata bu olduğu için yazım önerilerinde sıkça tercih edilir. Hangisini seçeceğin, "dnue" araması için "Dune"un ne kadar yakın sayılacağını belirler.
"Bunu mu Demek İstediniz?"
Bir arama sonuç döndürmediğinde katalogdaki başlıklar arasında mesafesi küçük olanı önerebiliriz. Tablonun tamamına ihtiyaç yok: her satır yalnız bir önceki satırı kullanıyor, o yüzden iki satır yeterli. Üstelik bizi yalnız "2'den küçük mü" sorusu ilgilendiriyorsa, bir satırın en küçük değeri sınırı aştığında dururuz; o satırdan sonra hiçbir değer küçülemez:
// Yalnız bir önceki satır gerekli: O(min(n, m)) bellek ve isteğe bağlı erken çıkış
public static int Levenshtein(string a, string b, int maxDistance = int.MaxValue)
{
    if (a.Length < b.Length) (a, b) = (b, a);
    if (a.Length - b.Length > maxDistance) return maxDistance + 1;

    int[] previous = new int[b.Length + 1];
    int[] current = new int[b.Length + 1];
    for (int j = 0; j <= b.Length; j++) previous[j] = j;
    for (int i = 1; i <= a.Length; i++)
    {
        current[0] = i;
        int rowMin = current[0];
        for (int j = 1; j <= b.Length; j++)
        {
            int cost = a[i - 1] == b[j - 1] ? 0 : 1;
            current[j] = Math.Min(previous[j - 1] + cost, Math.Min(previous[j] + 1, current[j - 1] + 1));
            rowMin = Math.Min(rowMin, current[j]);
        }

        if (rowMin > maxDistance) return maxDistance + 1; // buradan sonra daha iyisi olamaz
        (previous, current) = (current, previous);
    }

    return previous[b.Length];
}

public static string? DidYouMean(string query, IEnumerable<string> titles, int maxDistance = 2)
{
    string q = query.Trim().ToLowerInvariant();
    return titles
        .Select(t => (Title: t, Distance: Levenshtein(q, t.ToLowerInvariant(), maxDistance)))
        .Where(x => x.Distance <= maxDistance)
        .OrderBy(x => x.Distance)
        .ThenBy(x => x.Title, StringComparer.Ordinal)
        .Select(x => x.Title)
        .FirstOrDefault();
}
pride and prejudise -> Pride and Prejudice
frankenstien -> Frankenstein
dun -> Dune
middlemrach -> Middlemarch
harry potter -> (no suggestion)"harry potter" kataloğumuzda yok ve en yakın başlık bile 2'den uzak; öneri yapmamak, saçma bir öneri yapmaktan iyidir. İki eşik var: uzunluk farkı zaten maxDistance'tan büyükse tabloya hiç girmiyoruz; tablonun içinde bir satırın tamamı sınırı aşınca duruyoruz. Etkisini 10.000 rastgele iki kelimelik başlıkta ölçtüm:
[Benchmark(Baseline = true)]
public int FullTable() => _titles.Count(t => EditDistance.Table(Query, t)[Query.Length, t.Length] <= 2);

[Benchmark]
public int TwoRows() => _titles.Count(t => EditDistance.Levenshtein(Query, t) <= 2);

[Benchmark]
public int TwoRowsBounded() => _titles.Count(t => EditDistance.Levenshtein(Query, t, maxDistance: 2) <= 2);
Ölçümler Apple M5 (10 çekirdek), macOS 27.0.1, .NET 10.0.13, BenchmarkDotNet 0.15.8 ile alındı. Benchmark'ları tek tek çalıştırdım ama makinede paralel işler vardı; mutlak sayılara değil oranlara bak.
| Method         | Mean        | Ratio | Allocated |
|--------------- |------------:|------:|----------:|
| FullTable      | 13,907.5 us |  1.00 |  16.95 MB |
| TwoRows        | 12,663.9 us |  0.91 |   1.97 MB |
| TwoRowsBounded |    666.3 us |  0.05 |    1.1 MB |
İki satıra geçmek zamanı az değiştiriyor ama allocation'ı 17 MB'dan 2 MB'a indiriyor; tam tablo her başlık için bir int[,] ayırıyor. Asıl kazanç erken çıkıştan geliyor: 20 kat. Başlıkların çoğu sorgudan çok farklı ve ilk birkaç satırda eleniyor. Maliyet tam tabloda O(n·m); eşikli versiyonda pratikte bunun küçük bir kesri. Daha büyük kataloglarda bu da yetmez; adayları önce n-gram index'i ya da BK (Burkhard-Keller) tree gibi bir yapıyla daraltıp Levenshtein'ı yalnız onlara uygulamak gerekir.
LCS ve Diff Araçlarının Temeli
LCS (Longest Common Subsequence), iki dizinin sırayı koruyarak ortak olan en uzun alt dizisidir; elemanların ardışık olması gerekmez. Tablo edit distance'a çok benzer: elemanlar eşitse çapraz komşudan bir fazla, değilse üst ve sol komşudan büyük olanı.
// len[i, j] = a[..i] ile b[..j]'nin LCS uzunluğu
public static int[,] Table<T>(IReadOnlyList<T> a, IReadOnlyList<T> b)
{
    EqualityComparer<T> eq = EqualityComparer<T>.Default;
    int[,] len = new int[a.Count + 1, b.Count + 1];
    for (int i = 1; i <= a.Count; i++)
        for (int j = 1; j <= b.Count; j++)
            len[i, j] = eq.Equals(a[i - 1], b[j - 1])
                ? len[i - 1, j - 1] + 1
                : Math.Max(len[i - 1, j], len[i, j - 1]);
    return len;
}
Elemanlar satır olunca LCS bir diff aracına dönüşür: iki dosyada ortak olan satırlar "değişmedi", birinci dosyada olup LCS'te olmayanlar "silindi", ikincide olup LCS'te olmayanlar "eklendi". Tabloyu sondan başa yürüyerek bunu üretiriz:
// Tabloyu geri yürüyerek satır diff'i üretir: ' ' aynı, '-' silindi, '+' eklendi
public static List<string> Diff(IReadOnlyList<string> oldLines, IReadOnlyList<string> newLines)
{
    int[,] len = Table(oldLines, newLines);
    List<string> result = [];
    int i = oldLines.Count, j = newLines.Count;
    while (i > 0 || j > 0)
    {
        if (i > 0 && j > 0 && oldLines[i - 1] == newLines[j - 1])
        {
            result.Add("  " + oldLines[--i]);
            j--;
        }
        else if (j > 0 && (i == 0 || len[i, j - 1] >= len[i - 1, j]))
        {
            result.Add("+ " + newLines[--j]);
        }
        else
        {
            result.Add("- " + oldLines[--i]);
        }
    }

    result.Reverse();
    return result;
}
Bookstore'un fiyat listesi CSV'sinin (Comma-Separated Values) iki versiyonu: Dune'un fiyatı değişmiş, Dracula eklenmiş.
LCS length = 3
  isbn,title,price
- 9780441013593,Dune,18.99
+ 9780441013593,Dune,16.99
  9780141439518,Pride and Prejudice,9.99
+ 9780486411095,Dracula,7.25
  9780486282114,Frankenstein,6.50
Aynı iki dosyayı diske yazıp Git'e de sordum:
$ git -c core.pager=cat diff --no-index --no-color books-v1.csv books-v2.csv
diff --git a/books-v1.csv b/books-v2.csv
index 9f133c6..523b7d4 100644
--- a/books-v1.csv
+++ b/books-v2.csv
@@ -1,4 +1,5 @@
 isbn,title,price
-9780441013593,Dune,18.99
+9780441013593,Dune,16.99
 9780141439518,Pride and Prejudice,9.99
+9780486411095,Dracula,7.25
 9780486282114,Frankenstein,6.50
Satırlar birebir aynı. Git'in dokümanına göre varsayılan diff algoritması "myers": Eugene Myers'ın 1986 tarihli "An O(ND) Difference Algorithm and Its Variations" makalesindeki algoritma. Bizim tablomuz O(n·m) zaman ve bellek harcar; Myers'ınki O((n + m)·D), D fark sayısı. İki büyük ama az farklı dosyada (tipik bir commit) D küçüktür ve fark dramatik olur. Git ayrıca --diff-algorithm ile patience ve histogram gibi, okunabilirliği önceliklendiren algoritmalar da sunar. Fikir aynı: en uzun ortak alt diziyi bul, geri kalanı ekleme ve silmedir.
0/1 Knapsack: Bütçe Sınırlı Kampanya Seçimi
Pazarlama ekibinin 10 birimlik bir bütçesi ve beş aday kampanyası var; her kampanyanın bir maliyeti ve beklenen ek cirosu var. Her kampanya ya yapılır ya yapılmaz (0/1); yarım kampanya yok. Bütçeyi aşmadan ciroyu en büyük yapan seçim hangisi?
public sealed record Campaign(string Name, int Cost, int ExpectedRevenue);

// best[i, b] = ilk i kampanyayla, b bütçeyle en iyi ciro. O(n * B)
public static (int Revenue, List<Campaign> Chosen) Solve(IReadOnlyList<Campaign> items, int budget)
{
    int n = items.Count;
    int[,] best = new int[n + 1, budget + 1];
    for (int i = 1; i <= n; i++)
    {
        Campaign c = items[i - 1];
        for (int b = 0; b <= budget; b++)
        {
            best[i, b] = best[i - 1, b];                                   // yapma
            if (c.Cost <= b)
            {
                best[i, b] = Math.Max(best[i, b], best[i - 1, b - c.Cost] + c.ExpectedRevenue); // yap
            }
        }
    }

    // Hangi kampanyaların seçildiğini tabloyu geri yürüyerek bul
    List<Campaign> chosen = [];
    for (int i = n, b = budget; i > 0; i--)
    {
        if (best[i, b] != best[i - 1, b])
        {
            chosen.Add(items[i - 1]);
            b -= items[i - 1].Cost;
        }
    }

    chosen.Reverse();
    return (best[n, budget], chosen);
}
Campaign[] campaigns =
[
new("Newsletter", 1, 4), new("Podcast", 5, 15), new("Search ads", 5, 15),
new("Book fair", 6, 17), new("Influencer", 4, 10),
];DP: revenue=30, chosen=Podcast + Search ads
greedy by ratio: revenue=29, chosen=Newsletter + Podcast + Influencer"Birim maliyet başına en çok ciro" sırasıyla seçen greedy en verimli kampanyayı (Newsletter, oranı 4) önce alıyor ve bu yüzden bütçeyi en iyi dolduran ikiliyi kaçırıyor: 29'a karşı 30. Bu, serinin 20. yazısındaki bozuk para hikâyesinin aynısı: oran sırası, kesirli knapsack'te (kampanyanın yarısını yapabildiğin durumda) optimaldir, 0/1'de değildir. Maliyet O(n·B); B bütçenin sayısal değeri olduğu için buna pseudo-polynomial denir. Bütçe kuruş cinsinden milyonlarsa tablo da o kadar büyür.
İki Satırla, Sonra Tek Satırla
Satır i yalnız satır i-1'i kullanıyor; edit distance'taki gibi iki satır yeter. Bir adım daha ileri gidebiliriz: tek bir array, ama bütçe döngüsü geriye doğru. Geriye gidince best[b - c.Cost] hâlâ bir önceki satırın değeri, çünkü daha küçük index'ler bu turda henüz güncellenmedi:
// Bütçe döngüsü geriye giderse tek satır yeter: her kampanya en fazla bir kez kullanılır
public static int SolveOneRow(IReadOnlyList<Campaign> items, int budget)
{
    int[] best = new int[budget + 1];
    foreach (Campaign c in items)
        for (int b = budget; b >= c.Cost; b--)
            best[b] = Math.Max(best[b], best[b - c.Cost] + c.ExpectedRevenue);
    return best[budget];
}

// İleri döngü: aynı kampanya aynı turda tekrar alınabilir (unbounded knapsack)
public static int SolveOneRowForward(IReadOnlyList<Campaign> items, int budget)
{
    int[] best = new int[budget + 1];
    foreach (Campaign c in items)
        for (int b = c.Cost; b <= budget; b++)
            best[b] = Math.Max(best[b], best[b - c.Cost] + c.ExpectedRevenue);
    return best[budget];
}
one row backwards=30, one row forwards=40İleri döngü 40 diyor: Newsletter'ı on kez yapmak (10 × 4). Döngü ileri gidince best[b - c.Cost] bu turda zaten güncellenmiş, yani aynı kampanyayı içeren bir değer; kampanya kendini tekrar tekrar ekliyor. Bu, bir önceki yazıdaki CountWays ile CountSequences farkının kardeşi: tek satırlık bir yön değişikliği problemi 0/1 knapsack'ten unbounded knapsack'e çeviriyor. Testler bu yüzden üç versiyonu birbirine karşı doğruluyor:
Test run summary: Passed!
  total: 13
  failed: 0
  succeeded: 13
  skipped: 0
  duration: 236ms
Seri Kapanışı: Problemi Görünce Hangi Pattern
22 yazı boyunca her yapıyı önce kendimiz yazdık, sonra .NET'teki karşılığına baktık, sonra gerçek bir projede nerede işe yaradığını gördük. Interview soruları da gerçek iş problemleri de genellikle bir sinyalle gelir; sinyali tanırsan doğru araç kendiliğinden gelir:
| Problemdeki sinyal | Düşüneceğin yapı ya da pattern | Serideki yazı |
|---|---|---|
| Index ile erişim, sona ekleme | Array, dynamic array (List<T>) | 2 |
| Son giren önce, geri alma, parantez eşleme; geliş sırasıyla işleme | Stack; queue, ring buffer | 4 |
| "Var mı?", sayma, gruplama, iki eleman toplamı | Hash table, frequency map | 6, 7 |
| Ardışık aralık, alt dizi toplamı, pencere | Two pointers, sliding window, prefix sum | 7 |
| Sıralı veri, aralık sorgusu, "en az şu kadar olan ilk" | Sorting, binary search, lower bound | 8, 9, 10 |
| Veri değişirken sıralı kalsın; disk üzerinde index | Balanced tree, SortedSet, B+tree | 11, 12 |
| En küçük, en acil, ilk K, sürekli medyan | Heap, PriorityQueue | 13 |
| Prefix, autocomplete | Trie ya da sıralı array + binary search | 14 |
| İlişkiler, en az adım, bağlı parçalar | Graph, BFS (Breadth-First Search), DFS (Depth-First Search) | 15 |
| "Önce bu, sonra şu", bağımlılık | Topological sort, cycle detection | 16 |
| Ağırlıklı en ucuz yol | Dijkstra (negatif ağırlıkta Bellman-Ford), A* | 17 |
| Aynı gruptalar mı, birleştir; en ucuz bağlantı ağı | Union-Find, Kruskal | 18 |
| Bütün kombinasyonlar, kısıtlar | Backtracking ve budama | 19 |
| Yerel en iyi seçim ispatlanabiliyor | Greedy (hakem testiyle) | 20 |
| Tekrar eden alt problemler, "en az, en çok, kaç yol" | Dynamic programming | 21, 22 |
Tablonun en önemli satırı aslında yazılmamış olanı: çoğu zaman cevap BCL'de (Base Class Library) zaten var. Dictionary, SortedSet, PriorityQueue, Array.Sort ve BinarySearch test edilmiş, optimize edilmiş ve bakımı yapılan yapılar. Bu seride onları yeniden yazmamızın sebebi production'da kullanmak değil, maliyetlerini görmek ve doğru olanı seçebilmekti. Complexity'nin dilini Big-O ve Complexity serisinde, collection API'lerini (Application Programming Interface) C# Koleksiyonlar serisinde, ölçmeyi C# İleri serisinin BenchmarkDotNet yazısında bulabilirsin.
Üretimde Dikkat
Bellek O(n·m) büyür. Edit distance'ın tam tablosu iki 10.000 karakterlik metin için 10⁸ hücre, yani 400 MB'lık bir int[,] demek. Yalnız mesafe gerekiyorsa iki satıra geç; hizalamanın kendisi de gerekiyorsa Hirschberg gibi lineer bellekli teknikler ya da Myers'ın algoritması var.
Kullanıcı girdisini sınırla. "Bunu mu demek istediniz?" endpoint'i her çağrıda bütün katalogla karşılaştırma yapıyorsa, uzun bir sorgu metni doğrudan CPU (Central Processing Unit) maliyetine dönüşür. Sorgu uzunluğuna bir üst sınır koy ve eşikli versiyonu kullan.
Karşılaştırmadan önce normalize et. Büyük/küçük harf, boşluklar ve Türkçe karakterler mesafeyi şişirir. Serinin 14. yazısındaki SearchKey.Fold gibi tek bir katlama fonksiyonunu hem başlıklara hem sorguya uygula; "Şu Çılgın Türkler" ile "su cilgin turkler" arasındaki mesafe 0 olmalı.
Knapsack'te birimleri küçük tut. Bütçe kuruş cinsinden 1.000.000 ise tablo bir milyon sütunlu olur. Maliyetleri anlamlı bir birime yuvarlamak (bin TL) tabloyu yönetilebilir tutar; yuvarlamanın sonuca etkisini bir testle kontrol et.
Sık Düşülen Tuzaklar
Levenshtein'dan swap'ı tek işlem saymasını beklemek. "dnue" için 2 çıkar; komşu harf yer değiştirmesini 1 saymak istiyorsan Damerau varyantını yaz ve hangisini kullandığını belgelendir.
Tek satırlık knapsack'te döngü yönünü ters çevirmek. İleri döngü sessizce unbounded knapsack'e dönüşür ve bizim örneğimizde 30 yerine 40 der. Exception yok; yalnız gerçekte imkânsız bir kampanya planı.
Index kaydırmasını karıştırmak. Tablo bir fazla satır ve sütunla tutulur (boş prefix için); a[i - 1] yerine a[i] yazmak hem IndexOutOfRangeException'a hem de bir harf kaymış sonuçlara yol açar. Küçük örnekleri ("kitten" ile "sitting" = 3) testte sabitle.
Diff'i eşitlik tanımından bağımsız sanmak. Satır sonu farkı (Windows'ta CRLF (Carriage Return + Line Feed), Unix'te yalnız LF (Line Feed)) ya da sondaki boşluk farkı, bütün dosyayı "değişti" gösterir. Karşılaştırmadan önce satırları normalize et ya da bir IEqualityComparer ile eşitliği açıkça tanımla.
Küçük Bir Deneme
★☆☆ EditDistance.Table'a komşu harf yer değiştirmesini de ekleyerek Damerau-Levenshtein (optimal string alignment) yaz: a[i-1] == b[j-2] && a[i-2] == b[j-1] ise d[i-2, j-2] + 1 de bir seçenek. "dnue" ile "dune" artık 1 mi?
★★☆ Lcs.Diff'i ardışık değişiklikleri git'teki gibi @@ -1,4 +1,5 @@ başlıklı hunk'lara gruplayacak şekilde genişlet; 3 satırlık bağlam ekle ve çıktıyı aynı dosyalar için git diff ile karşılaştır.
★★★ Knapsack'e ikinci bir kısıt ekle: bütçeye ek olarak ekibin en fazla 3 kampanya yürütebileceği bir kapasite. State üç boyutlu olur (kampanya, bütçe, sayı); önce tam tabloyla çöz, sonra kaç boyutu tek satıra indirebildiğini dene.
Bu yazıyla "Algoritmalar ve Data Structures" serisi tamamlanıyor. Array'den başlayıp hash table'a, sorting'den tree'lere, graph'lardan dynamic programming'e kadar her yapıyı kendimiz yazdık, BCL'deki karşılığıyla ölçtük ve Bookstore'un gerçek problemlerine uyguladık. Bir sonraki adım senin projen: bir sonraki yavaş endpoint'te, ya da "bu kod 10.000 kayıtta neden çöküyor" sorusunda, yukarıdaki tablonun hangi satırının karşına çıktığını ara.