

Balanced Tree'ler: AVL, Red-Black ve Veritabanı Index'lerinin B-Tree'si

Balanced tree, insert sırası ne olursa olsun yüksekliği O(log n) tutar: sıralı 10.000 id'de düz BST'nin yüksekliği 10.000, AVL'ninki 14. C# ile AVL insert ve rotation'ları yazıyor, SortedSet'in red-black tree'sine reflection ile bakıyor, PostgreSQL'de pageinspect ile gerçek bir B+tree index'in seviyelerini ve leaf zincirini inceliyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve C# 14 ile derlenip xUnit v3 4.0.2 testleriyle doğrulanmıştır; ölçümler BenchmarkDotNet 0.15.8 ile, index örnekleri PostgreSQL 18.6 ile alınmıştır.
Önce Tahmin Et
Serinin 11. yazısında yazdığımız BST (Binary Search Tree, ikili arama ağacı) ile bugün yazacağımız AVL (Adelson-Velsky ve Landis'in 1962'de yayımladığı kendini dengeleyen ağaç) tree'ye aynı veriyi veriyoruz: Bookstore kataloğundaki kitap id'leri, veritabanından geldiği gibi, yani 1'den 10.000'e sıralı. Sonra iki tree'nin yüksekliğine bakıyoruz.
foreach (int n in new[] { 1_023, 10_000 })
{
    AvlTree<int> avl = new();
    UnbalancedBst<int> bst = new();
    Stopwatch sw = Stopwatch.StartNew();
    for (int i = 1; i <= n; i++) bst.Add(i);
    long bstMs = sw.ElapsedMilliseconds;
    sw.Restart();
    for (int i = 1; i <= n; i++) avl.Add(i);
    long avlMs = sw.ElapsedMilliseconds;
    Console.WriteLine($"n={n,6}: BST height={bst.Height(),6} ({bstMs} ms), AVL height={avl.Height,2} ({avlMs} ms), rotations={avl.Rotations}");
}

AvlTree<int> big = new();
for (int i = 1; i <= 1_000_000; i++) big.Add(i);
Console.WriteLine($"n=1000000: AVL height={big.Height}, rotations={big.Rotations}, valid={big.IsValid()}");
BST için cevabı 11. yazıdan biliyorsun: sıralı insert her yeni node'u bir öncekinin sağına koyar, tree bir linked list'e döner. Asıl soru AVL tarafında. 10.000 elemanda yükseklik kaç olur? 100 mü, 50 mi, 14 mü? Bir de şunu düşün: 1.000.000 kitap id'si için bu sayı ne kadar büyür?
Neden Balance: Height = O(log n) Garantisi
Gerçek koşunun çıktısı:
n=  1023: BST height=  1023 (4 ms), AVL height=10 (0 ms), rotations=1013
n= 10000: BST height= 10000 (141 ms), AVL height=14 (1 ms), rotations=9986
n=1000000: AVL height=20, rotations=999980, valid=True
BST'de her arama, insert ve delete kökten yaprağa giden yol kadar sürer, yani maliyet height ile orantılıdır. Rastgele sırada gelen veride height ortalama olarak log n civarında kalır, ama "ortalama" bir garanti değildir. Gerçek hayatta veri sıralı gelmeye bayılır: auto-increment id'ler, tarih sırasındaki siparişler, alfabetik ISBN (International Standard Book Number) listeleri. Sıralı insert'te height n olur ve 10.000 elemanlık tree'ye 10.000 elemanı eklemek 141 ms sürer, çünkü her insert bütün zinciri yürür (toplamda yaklaşık n²/2 karşılaştırma).
Balanced tree'lerin tek vaadi şu: hangi sırayla insert edersen et, height O(log n) kalır. 1.023 elemanda AVL height'ı 10, yani mükemmel dolu bir binary tree ile aynı. 1.000.000 elemanda 20. Bir milyon kitap arasından bir id'yi en fazla 20 karşılaştırmayla buluyorsun. Bu maliyetin nasıl hesaplandığını Big-O ve Complexity serisinin "Koddan Time Complexity Çıkarmak" yazısında anlattık; burada bize gereken tek satır: arama, insert ve delete O(height) ve balanced tree'de height O(log n).
Bu garantiyi sağlamanın bedeli rotation'lar. Yukarıdaki çıktıda 1.000.000 sıralı insert 999.980 rotation yaptı; yani neredeyse her insert'te bir tane. Rotation sabit maliyetli birkaç pointer değişikliğidir; asıl iş, tree'nin şeklini bozulmadan önce düzeltmek.
Rotation: Sola ve Sağa Döndürmek
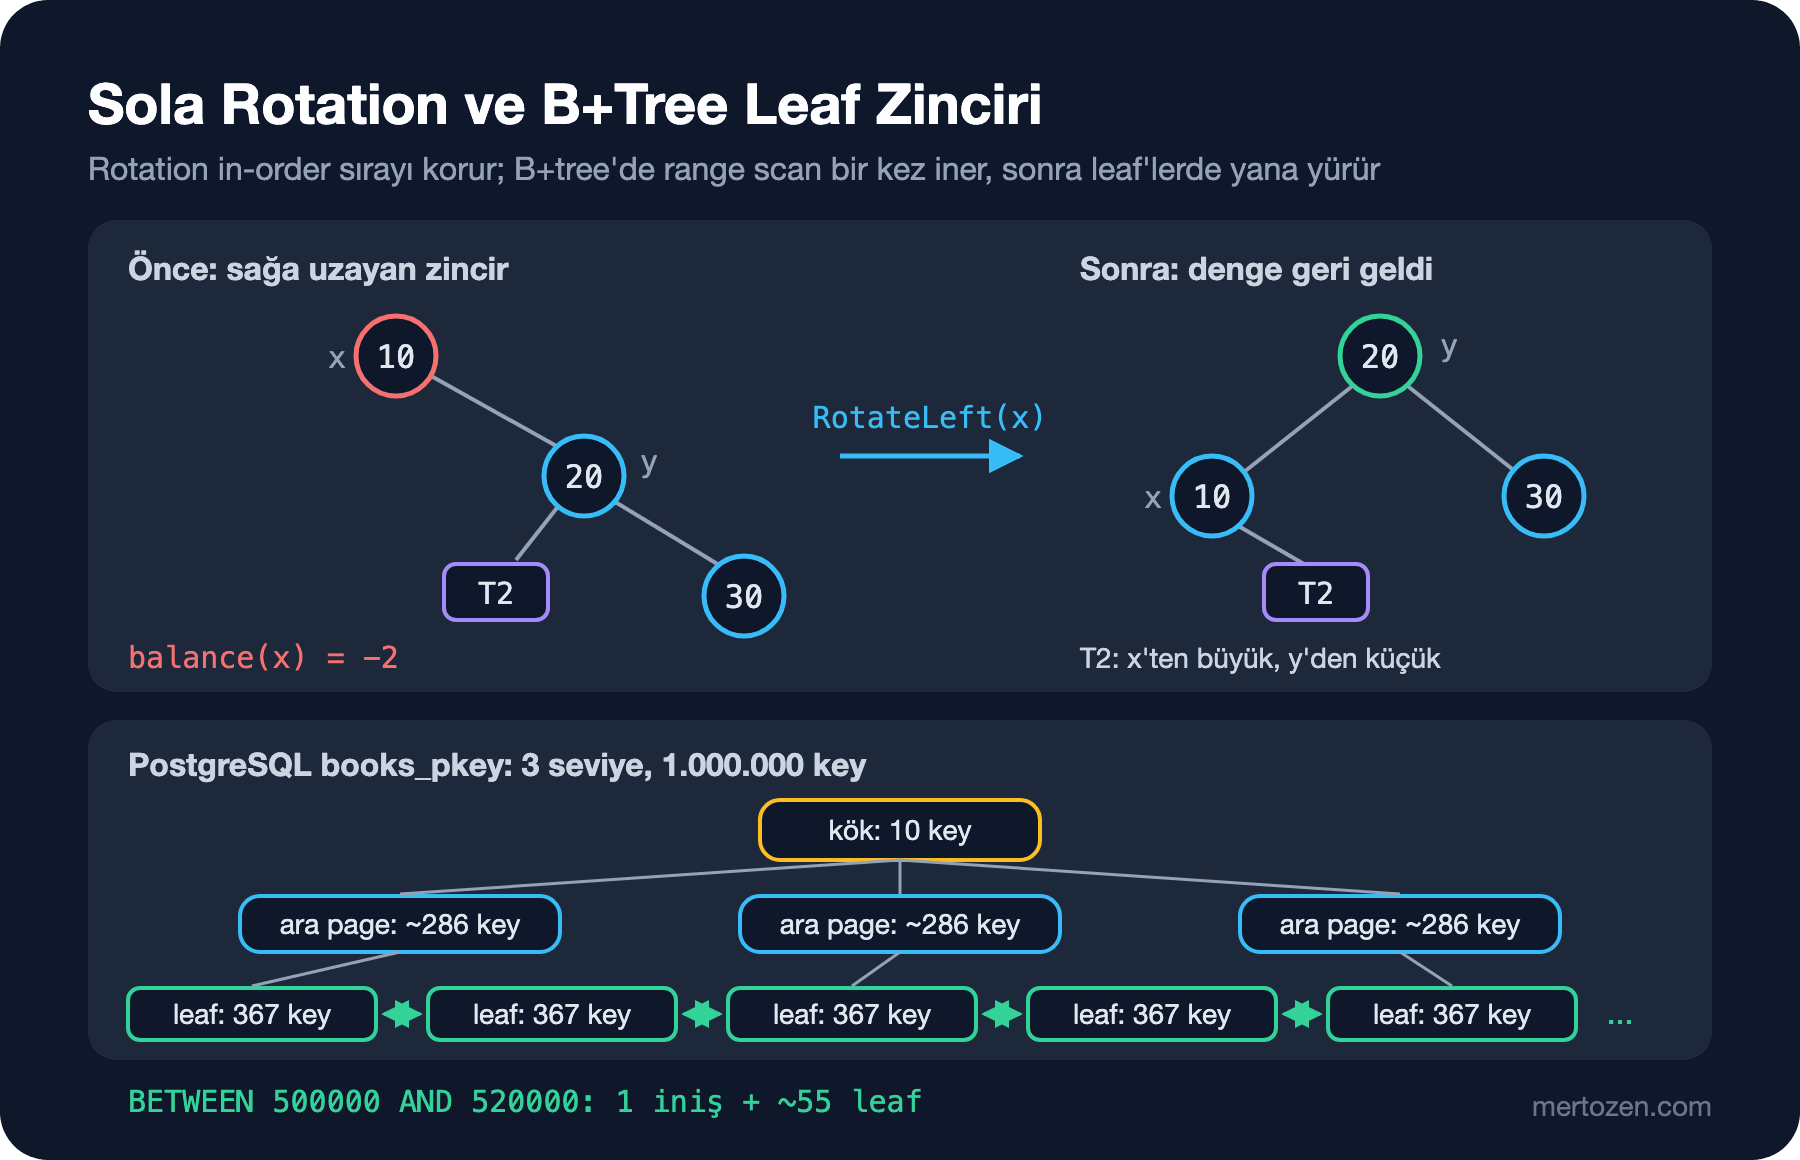
Rotation, BST sıralamasını bozmadan iki node'un parent/child ilişkisini ters çevirir. Sola rotation'da x'in sağ child'ı y yukarı çıkar, x onun sol child'ı olur, y'nin eski sol subtree'si de x'in sağına geçer:
private Node RotateLeft(Node x)
{
    Node y = x.Right!;
    x.Right = y.Left;   // y'nin sol subtree'si x'ten büyük, y'den küçük: x'in sağına uyar
    y.Left = x;
    Update(x);          // önce aşağıda kalan x, sonra y
    Update(y);
    Rotations++;
    return y;           // subtree'nin yeni kökü
}

private Node RotateRight(Node y)
{
    Node x = y.Left!;
    y.Left = x.Right;
    x.Right = y;
    Update(y);
    Update(x);
    Rotations++;
    return x;
}
Neden sıralama bozulmuyor? y.Left subtree'sindeki her değer x'ten büyük (çünkü x'in sağındaydı) ve y'den küçük (çünkü y'nin solundaydı). Rotation sonrası bu subtree x'in sağında ve y'nin solunda kalıyor, yani in-order sıra aynı. Değişen tek şey yükseklikler: bir taraf bir seviye kısalıyor, diğer taraf bir seviye uzuyor.
AVL Insert Implementasyonu
AVL kuralı basit: her node'da sol ve sağ subtree yükseklikleri arasındaki fark (balance factor) en fazla 1 olabilir. Her node kendi yüksekliğini tutar; insert normal BST insert'i gibi aşağı iner, dönüşte her node yüksekliğini günceller ve gerekirse rotation yapar:
public sealed class AvlTree<T>(IComparer<T>? comparer = null)
{
    private sealed class Node(T value)
    {
        public T Value = value;
        public Node? Left;
        public Node? Right;
        public int Height = 1;
    }

    private readonly IComparer<T> _comparer = comparer ?? Comparer<T>.Default;
    private Node? _root;

    public int Count { get; private set; }
    public int Rotations { get; private set; }
    public int Height => HeightOf(_root);

    public bool Add(T value)
    {
        bool added = false;
        _root = Insert(_root, value, ref added);
        if (added)
        {
            Count++;
        }

        return added;
    }

    private Node Insert(Node? node, T value, ref bool added)
    {
        if (node is null)
        {
            added = true;
            return new Node(value);
        }

        int cmp = _comparer.Compare(value, node.Value);
        if (cmp < 0)
        {
            node.Left = Insert(node.Left, value, ref added);
        }
        else if (cmp > 0)
        {
            node.Right = Insert(node.Right, value, ref added);
        }
        else
        {
            return node; // aynı key zaten var
        }

        Update(node);
        return Rebalance(node);
    }

    private Node Rebalance(Node node)
    {
        int balance = BalanceOf(node);
        if (balance > 1)
        {
            if (BalanceOf(node.Left!) < 0)
            {
                node.Left = RotateLeft(node.Left!);   // left-right durumu
            }

            return RotateRight(node);                 // left-left durumu
        }

        if (balance < -1)
        {
            if (BalanceOf(node.Right!) > 0)
            {
                node.Right = RotateRight(node.Right!); // right-left durumu
            }

            return RotateLeft(node);                   // right-right durumu
        }

        return node;
    }

    private static int HeightOf(Node? node) => node?.Height ?? 0;

    private static int BalanceOf(Node node) => HeightOf(node.Left) - HeightOf(node.Right);

    private static void Update(Node node) =>
        node.Height = 1 + Math.Max(HeightOf(node.Left), HeightOf(node.Right));
}
Dört durumun hepsi üç key'le görülebilir. 10, 20, 30 sırası sağa doğru uzayan bir zincir üretir (right-right) ve tek sola rotation onu düzeltir. 30, 10, 20 ise bir "dirsek" oluşturur (left-right): önce alttaki node sola, sonra üstteki sağa döndürülür. Programın çıktısı:
insert [10, 20, 30] -> root=20, rotations=1
insert [30, 20, 10] -> root=20, rotations=1
insert [30, 10, 20] -> root=20, rotations=2
Recursive insert burada güvenli, çünkü recursion derinliği tree yüksekliği kadar ve bu yükseklik 1.000.000 elemanda bile 20. Serinin 5. yazısındaki StackOverflowException uyarısı degenerate BST için geçerliydi; o yüzden UnbalancedBst'nin insert'ini ve Height()'ını iterative yazdık.
Testlerde iki şeyi ayrı ayrı doğruluyoruz: sıralı veride yükseklik ve rastgele veride invariant. IsValid() her node'da sıralamayı, saklanan yüksekliği ve balance factor'ü kontrol ediyor; 10.000 rastgele insert'ten sonra sonucu SortedSet<int> ile karşılaştırıyoruz:
[Fact]
public void Add_RandomInput_StaysValidAndSorted()
{
    Random random = new(42);
    AvlTree<int> avl = new();
    SortedSet<int> expected = [];
    for (int i = 0; i < 10_000; i++)
    {
        int key = random.Next(50_000);
        Assert.Equal(expected.Add(key), avl.Add(key));
    }

    Assert.True(avl.IsValid());
    Assert.Equal(expected, avl.InOrder());
    Assert.True(avl.Height <= 1.44 * Math.Log2(avl.Count + 2));
}
Test run summary: Passed!
total: 10
failed: 0
succeeded: 10
skipped: 0
duration: 278msSon assert'teki 1,44 sabiti AVL'nin bilinen üst sınırından geliyor: en kötü AVL tree, aynı yükseklikteki mükemmel binary tree'den en fazla yaklaşık %44 daha yüksektir. Delete'i burada yazmadık; mantık aynı (BST delete'in üç durumu, ardından dönüş yolunda Rebalance), tek farkı delete'in yol boyunca birden fazla rotation gerektirebilmesi. Küçük denemede onu sana bırakıyorum.
Red-Black Tree: Kurallar ve Sezgi
.NET'in sıralı collection'ları AVL değil red-black tree kullanır. Red-black tree, her node'a tek bir renk biti ekleyip şu kuralları korur:
- Her node ya kırmızı ya siyahtır; kök siyahtır.
- Yapraklar (null child'lar) siyah sayılır.
- Kırmızı bir node'un iki child'ı da siyahtır: iki kırmızı alt alta gelemez.
- Bir node'dan aşağıdaki her yaprağa giden her yolda aynı sayıda siyah node vardır.
Sezgisi şu: son kural en kısa yolu "hepsi siyah" yapar, üçüncü kural en uzun yolu "siyah-kırmızı-siyah-kırmızı" yapar. Yani en uzun yol en kısanın en fazla iki katı olabilir ve height 2·log₂(n+1) ile sınırlıdır. AVL'nin sınırı daha sıkı (yaklaşık 1,44·log₂ n), bu yüzden AVL'de arama biraz daha kısa yoldan gider. Buna karşılık red-black tree dengeyi daha gevşek tuttuğu için insert'te en fazla iki rotation yapar, geri kalan düzeltmeler renk değişimidir. Çok yazılan, çok değişen veri için red-black, çok okunan veri için AVL avantajlı sayılır; pratikte fark çoğu zaman sabit çarpan düzeyindedir.
dotnet/runtime'daki SortedSet.cs dosyası red-black tree'yi 2-3-4 tree'lerin BST olarak gösterimi diye tanımlıyor ve insert'i yukarıdan aşağı (top-down) yapıyor: arama yolunda dolu 4-node'ları bölerek ilerliyor. Bunu reflection ile kendimiz de görebiliriz:
Type nodeType = typeof(SortedSet<int>).GetNestedType("Node", BindingFlags.NonPublic)!;
Console.WriteLine($"SortedSet<T>.Node properties: {string.Join(", ", nodeType.GetProperties().Select(p => $"{p.Name}:{p.PropertyType.Name}"))}");
FieldInfo setField = typeof(SortedDictionary<int, string>).GetField("_set", BindingFlags.NonPublic | BindingFlags.Instance)!;
Console.WriteLine($"SortedDictionary<TKey,TValue>._set: {setField.FieldType.Name} : {setField.FieldType.BaseType!.Name}");
SortedSet<T>.Node properties: Item:T, Left:Node, Right:Node, Color:NodeColor, IsBlack:Boolean, IsRed:Boolean, Is2Node:Boolean, Is4Node:Boolean
SortedDictionary<TKey,TValue>._set: TreeSet`1 : SortedSet`1Color property'si red-black tree'nin renk biti, Is2Node ve Is4Node da 2-3-4 tree bağlantısının izi. SortedDictionary kendi tree'sini yazmıyor, key/value çiftlerini bir TreeSet içinde tutuyor ve o da SortedSet'ten türüyor. Bu collection'ların API'sini (Application Programming Interface) ve ne zaman hangisini seçeceğini C# Koleksiyonlar serisinin "C# Sıralı Collection'lar" yazısında anlattık; burada önemli olan, SortedSet'e milyon tane sıralı id eklesen bile height'ın logaritmik kalacağını bilmek.
B-Tree ve B+Tree: Disk Page'leri ve Fanout
Bellekte bir node'dan diğerine geçmek nanosaniyeler sürer. Diskte ise birim "page"tir: PostgreSQL ve Microsoft SQL (Structured Query Language) Server veriyi 8 KB'lık page'ler halinde okur. Binary tree'de her seviye ayrı bir page okuması olsaydı, bir milyon satırda 20 page okurduk. B-tree bunu tersine çevirir: bir node bir page'dir ve içinde yüzlerce key tutar. Bir node'un child sayısına fanout denir.
Fanout'un yüksekliğe etkisini küçük bir hesapla görelim:
public static int Levels(long rows, int fanout)
{
    int levels = 1;
    double capacity = fanout;
    while (capacity < rows)
    {
        capacity *= fanout;
        levels++;
    }

    return levels;
}
rows binary fanout 100 fanout 300 fanout 500
1,000,000 20 3 3 3
100,000,000 27 4 4 3
1,000,000,000 30 5 4 4Bir milyar satırlık bir tabloda bile dört-beş page okuyarak aradığın satırı bulursun; üstelik kök ve üst seviyeler zaten bellekte (buffer cache'te) olduğundan diske giden okuma genelde bir-iki page'tir.
Veritabanları klasik B-tree'nin bir varyantını, B+tree'yi kullanır. İki fark var. Birincisi, iç node'lar yalnız yönlendirme için key tutar; asıl kayıtlar (ya da kayda giden pointer'lar) yalnız leaf seviyesindedir. Bu, iç node'lara daha çok key sığdırır ve fanout'u büyütür. İkincisi, aynı seviyedeki page'ler birbirine zincirlenir. WHERE id BETWEEN 500000 AND 520000 gibi bir range sorgusu tree'den bir kez aşağı iner, sonra leaf zincirinde yan yana yürür. Microsoft'un index mimarisi rehberi SQL Server rowstore index'lerinin B+tree olduğunu ve her seviyedeki page'lerin doubly linked list ile bağlandığını açıkça yazar; PostgreSQL dokümanı da B-tree index'in her seviyesinin doubly linked page listesi olarak kullanılabildiğini söyler.
PostgreSQL'de Gerçek Bir B+Tree
Teoriyi gerçek bir index'te görelim. Kendi geçici PostgreSQL 18 container'ımızda bir milyon kitaplık tablo oluşturup pageinspect extension'ı ile primary key index'inin içine baktım:
CREATE EXTENSION pageinspect;
CREATE TABLE books (id bigint PRIMARY KEY, isbn text NOT NULL, title text NOT NULL);
INSERT INTO books
SELECT i, lpad(i::text, 13, '978'), 'Book ' || i
FROM generate_series(1, 1000000) AS i;
VACUUM ANALYZE books;
SELECT level, root, fastroot FROM bt_metap('books_pkey');
SELECT relpages FROM pg_class WHERE relname = 'books_pkey';
SELECT live_items, btpo_level FROM bt_page_stats('books_pkey', (SELECT root FROM bt_metap('books_pkey')));
SELECT blkno, live_items, btpo_prev, btpo_next, btpo_level FROM bt_multi_page_stats('books_pkey', 1, 3);
level | root | fastroot
-------+------+----------
2 | 412 | 412
relpages
----------
2745
live_items | btpo_level
------------+------------
10 | 2
blkno | live_items | btpo_prev | btpo_next | btpo_level
-------+------------+-----------+-----------+------------
1 | 367 | 0 | 2 | 0
2 | 367 | 1 | 4 | 0
3 | 286 | 0 | 411 | 1Okuyalım. Kökün seviyesi 2, yani tree üç seviyeli: kök, bir ara seviye ve leaf'ler. Kökte yalnız 10 key var; her biri 286 civarında key tutan bir ara page'e, her ara page de 367 key tutan leaf page'lere gidiyor. 10 × 286 × 367 kabaca bir milyon eder. btpo_prev ve btpo_next kolonları leaf zincirinin kendisi: 1 numaralı leaf'in sağ komşusu 2, 2'nin sol komşusu 1. Index toplam 2.745 page, yani 2.745 × 8 KB ≈ 21,4 MB.
Bir id ile arama yapıp kaç page'e dokunduğumuza bakalım (ilk koşu planlama ve catalog okumalarını da içerdiği için ikinci koşunun çıktısı):
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF) SELECT title FROM books WHERE id = 734512; Index Scan using books_pkey on books (actual rows=1.00 loops=1)
Index Cond: (id = 734512)
Index Searches: 1
Buffers: shared hit=4
Planning Time: 0.018 ms
Execution Time: 0.033 msDört page: kök, ara page, leaf ve satırın kendisinin bulunduğu tablo page'i. Bir milyon satırda binary tree 20 adım atardı; B+tree üç index page'iyle iş bitirdi. Range scan'de leaf zinciri devreye giriyor:
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF) SELECT count(*) FROM books WHERE id BETWEEN 500000 AND 520000; Aggregate (actual rows=1.00 loops=1)
Buffers: shared hit=58
-> Index Only Scan using books_pkey on books (actual rows=20001.00 loops=1)
Index Cond: ((id >= 500000) AND (id <= 520000))
Heap Fetches: 0
Index Searches: 1
Buffers: shared hit=5820.001 satır, 58 page. 20.001 / 367 ≈ 55 leaf page, artı aşağı inerken okunan birkaç page. Tree'ye bir kez inip ("Index Searches: 1") gerisini leaf zincirinde yürüyerek okudu.
Clustered ve non-clustered ayrımı da bu resimle anlaşılır. SQL Server'da clustered index'in leaf seviyesi tablonun veri page'leridir; satırlar key sırasıyla bu leaf'lerde durur. Non-clustered index'in leaf'inde ise key'ler ve satıra giden bir row locator bulunur, satırın geri kalanı için bir adım daha atılır. PostgreSQL'de tablo her zaman heap'tir ve bütün index'ler bu ikinci türe benzer; yukarıdaki dört page'in sonuncusu o ek adımdı. Bu index'leri EF (Entity Framework) Core ile nasıl tanımlayıp sorguladığını EF Core serisinde gördük; burada sadece altlarındaki veri yapısını tanıdık.
Ölçüm: Sıralı Veride Arama
Üç tree'yi sıralı insert ile kurup 1.000 rastgele key arattım. UnbalancedBst baseline:
[MemoryDiagnoser]
public class TreeLookupBenchmarks
{
    private UnbalancedBst<int> _bst = null!;
    private AvlTree<int> _avl = null!;
    private SortedSet<int> _sortedSet = null!;
    private int[] _probes = null!;

    [Params(1_000, 10_000)]
    public int N;

    [GlobalSetup]
    public void Setup()
    {
        _bst = new();
        _avl = new();
        _sortedSet = [];
        for (int i = 0; i < N; i++) // sıralı input: plain BST için en kötü durum
        {
            _bst.Add(i);
            _avl.Add(i);
            _sortedSet.Add(i);
        }

        Random random = new(42);
        _probes = [.. Enumerable.Range(0, 1_000).Select(_ => random.Next(N))];
    }

    [Benchmark(Baseline = true)]
    public int UnbalancedBst() => _probes.Count(_bst.Contains);

    [Benchmark]
    public int Avl() => _probes.Count(_avl.Contains);

    [Benchmark]
    public int SortedSet() => _probes.Count(_sortedSet.Contains);
}
Ölçümler Apple M5 (10 çekirdek), macOS 27.0.1, .NET 10.0.13, BenchmarkDotNet 0.15.8 ile alındı. Benchmark'ları tek tek çalıştırdım, ama makinede aynı anda başka işler de çalışıyordu; mutlak sayılara değil oranlara bak.
| Method        | N     | Mean        | Ratio | Allocated |
|-------------- |------ |------------:|------:|----------:|
| UnbalancedBst | 1000  |   360.99 us |  1.00 |         - |
| Avl           | 1000  |    10.41 us |  0.03 |         - |
| SortedSet     | 1000  |    10.19 us |  0.03 |         - |
|               |       |             |       |           |
| UnbalancedBst | 10000 | 5,136.85 us | 1.000 |         - |
| Avl           | 10000 |    14.33 us | 0.003 |         - |
| SortedSet     | 10000 |    14.06 us | 0.003 |         - |
N on kat büyüyünce dengesiz BST'de 1.000 arama 361 µs'den 5,1 ms'ye çıkıyor (her arama zincirin ortalama yarısını yürüyor); AVL ve SortedSet'te 10 µs'den 14 µs'ye. Logaritmik büyüme tam olarak bu: eleman sayısı on katına çıkınca yol sadece üç-dört adım uzuyor. Kendi AVL'imiz ile BCL'nin (Base Class Library) red-black tree'si arasında ölçülebilir bir fark yok; ikisi de height'ı küçük tutuyor ve gerisi sabit çarpan. Hiçbir arama allocation yapmıyor.
Üretimde Dikkat
Kendi AVL'ini production'a koyma. Bu yazıdaki implementasyon öğrenmek için; sıralı bir set ya da map gerekiyorsa SortedSet<T> ve SortedDictionary<TKey, TValue> zaten balanced, test edilmiş ve bakımı yapılan yapılar. Kendin yazacaksan sebebi net olmalı: örneğin her node'da subtree boyutunu tutup "k'inci eleman" ya da "şu değerden küçük kaç kayıt var" sorusunu O(log n)'de cevaplamak (order statistic tree). BCL bunu sunmuyor.
Balanced tree pahalı bir yapıdır. Her eleman ayrı bir heap object'i, iki child referansı ve bir yükseklik ya da renk alanı taşır. Sadece "var mı?" sorusu soruluyorsa HashSet<T>, veri bir kez yüklenip çok okunuyorsa sıralı array ve binary search (serinin 10. yazısı) çoğu zaman daha hızlı ve daha az bellek harcar. Tree'yi gerçekten değerli kılan şey, veri değişirken sıralı kalması ve range sorgularına cevap verebilmesi.
Veritabanında key seçimi B+tree'nin şeklini belirler. Sürekli artan bir key (identity, sıralı GUID (Globally Unique Identifier) değerleri) her zaman en sağdaki leaf'e yazar ve page'ler dolu kalır. Rastgele bir key (rastgele GUID) her insert'te farklı bir leaf'e gider, dolu page'leri böler (page split) ve index'i şişirir. SQL Server'da clustered key ayrıca bütün non-clustered index'lerin row locator'ında taşındığı için geniş bir clustered key her index'i büyütür. Index tasarımını EF Core ve SQL serilerinde pratik olarak ele aldık.
Sık Düşülen Tuzaklar
Yüksekliği güncellemeyi unutmak. Rotation'dan sonra önce aşağıda kalan node'un, sonra yukarı çıkan node'un yüksekliği hesaplanmalı. Sırayı ters çevirirsen yanlış yükseklik yukarı taşınır ve tree bir süre sonra sessizce dengesizleşir. IsValid() gibi bir invariant kontrolünü testte rastgele veriyle çalıştırmak bu hatayı hemen yakalar.
Rotation'da kopan subtree. x.Right = y.Left satırını unutursan y'nin sol subtree'si tree'den düşer; test sırasında eleman sayısı tutar gibi görünür ama arama bazı key'leri bulamaz. Testte yalnız Count'a değil, in-order çıktının tamamına bakmak bu yüzden önemli.
Degenerate tree'yi recursive yürümek. Dengesiz bir BST'de recursive height ya da traversal, 100.000 seviyede StackOverflowException ile process'i öldürür. Tree'nin dengeli olduğunu bilmiyorsan iterative yaz.
B+tree'yi "her sorgu O(log n)" diye okumak. Index'te kolon sırası ve sorgunun şekli önemlidir: (AuthorId, PublishedAt) index'i, yalnız PublishedAt üzerindeki bir range'i tek parça halinde okuyamaz, çünkü leaf zinciri önce AuthorId'ye göre sıralı. PostgreSQL 18'in B-tree skip scan özelliği bu durumda her AuthorId değeri için ayrı bir arama yapar; farklı yazar sayısı arttıkça bu da pahalanır.
Küçük Bir Deneme
★☆☆ AvlTree<T>'ye Min() ve Max() ekle; sonra 1.000.000 sıralı insert'ten sonra InOrder().Take(5) ile ilk beş elemanı yazdır. Rotations sayısını rastgele sıralı input ile karşılaştır: hangisi daha çok rotation yapıyor?
★★☆ Remove(T value) yaz: BST delete'in üç durumu (yaprak, tek child, iki child ve in-order successor), ardından dönüş yolunda Update ve Rebalance. Testinde rastgele 5.000 insert ve 2.500 remove yap, her adımda IsValid()'i ve sonucu SortedSet<int> ile karşılaştır.
★★★ Kendi PostgreSQL container'ında books tablosunu bu kez id uuid DEFAULT gen_random_uuid() ile oluştur, bir milyon satır ekle ve relpages değerini bigint key'li index ile karşılaştır. Leaf page'lerdeki ortalama live_items neden düştü?
Balanced tree'ler "en küçük" ya da "en büyük" elemanı O(log n)'de bulur ama bunun için bütün sıralamayı korur. Çoğu zaman sadece en öncelikli işi almak isteriz: en eski sipariş, en acil kargo, en çok satan kitap. Bir sonraki yazıda tam sıralamayı bırakıp yalnız "en küçük hep tepede" kuralını koruyan daha ucuz bir yapıya geçiyoruz: heap ve priority queue.