

Probabilistic Data Structure'lar: Bloom Filter, Count-Min Sketch ve HyperLogLog
Probabilistic data structure'lar küçük ve kontrollü bir hata payı karşılığında belleği yüzlerce kat azaltır: Bloom filter "kesinlikle yok / muhtemelen var" der, Count-Min Sketch frekansı fazla sayarak tahmin eder, HyperLogLog tekil sayısını sabit bellekle bulur. C# ile üçünü yazıyor, 1 milyon e-postada 1,14 MB ile yüzde 1,01 false positive, 16 KB ile yüzde 0,8 hatalı tekil ziyaretçi sayısı ölçüyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, C# 14 ve System.IO.Hashing 10.0.15 ile derlenip xUnit v3 4.0.2 testleriyle doğrulanmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı), kayıt formunda e-posta alanından çıkıldığında "bu e-posta daha önce kayıt oldu mu?" diye kontrol ediyor. 1.000.000 kayıtlı kullanıcı var ve her kontrol bir veritabanı sorgusu. Bu sorguların çoğunu önlemek için e-postaları bellekte tutmak istiyoruz. Bir HashSet<string> kabaca kaç MB tutar? Peki "hayır" cevabında hiç yanılmayan, "evet" cevabında yüzde 1 ihtimalle yanılan bir yapı kaç MB tutar: 50 mi, 10 mu, 1 mi?
İkinci soru: günde 1,5 milyon ziyaret ve birkaç yüz bin tekil ziyaretçi var. Tekil ziyaretçi sayısını yüzde 1'den küçük bir hatayla bilmek için kaç KB gerekir?
Bloom Filter: k Hash ve Bir Bit Array
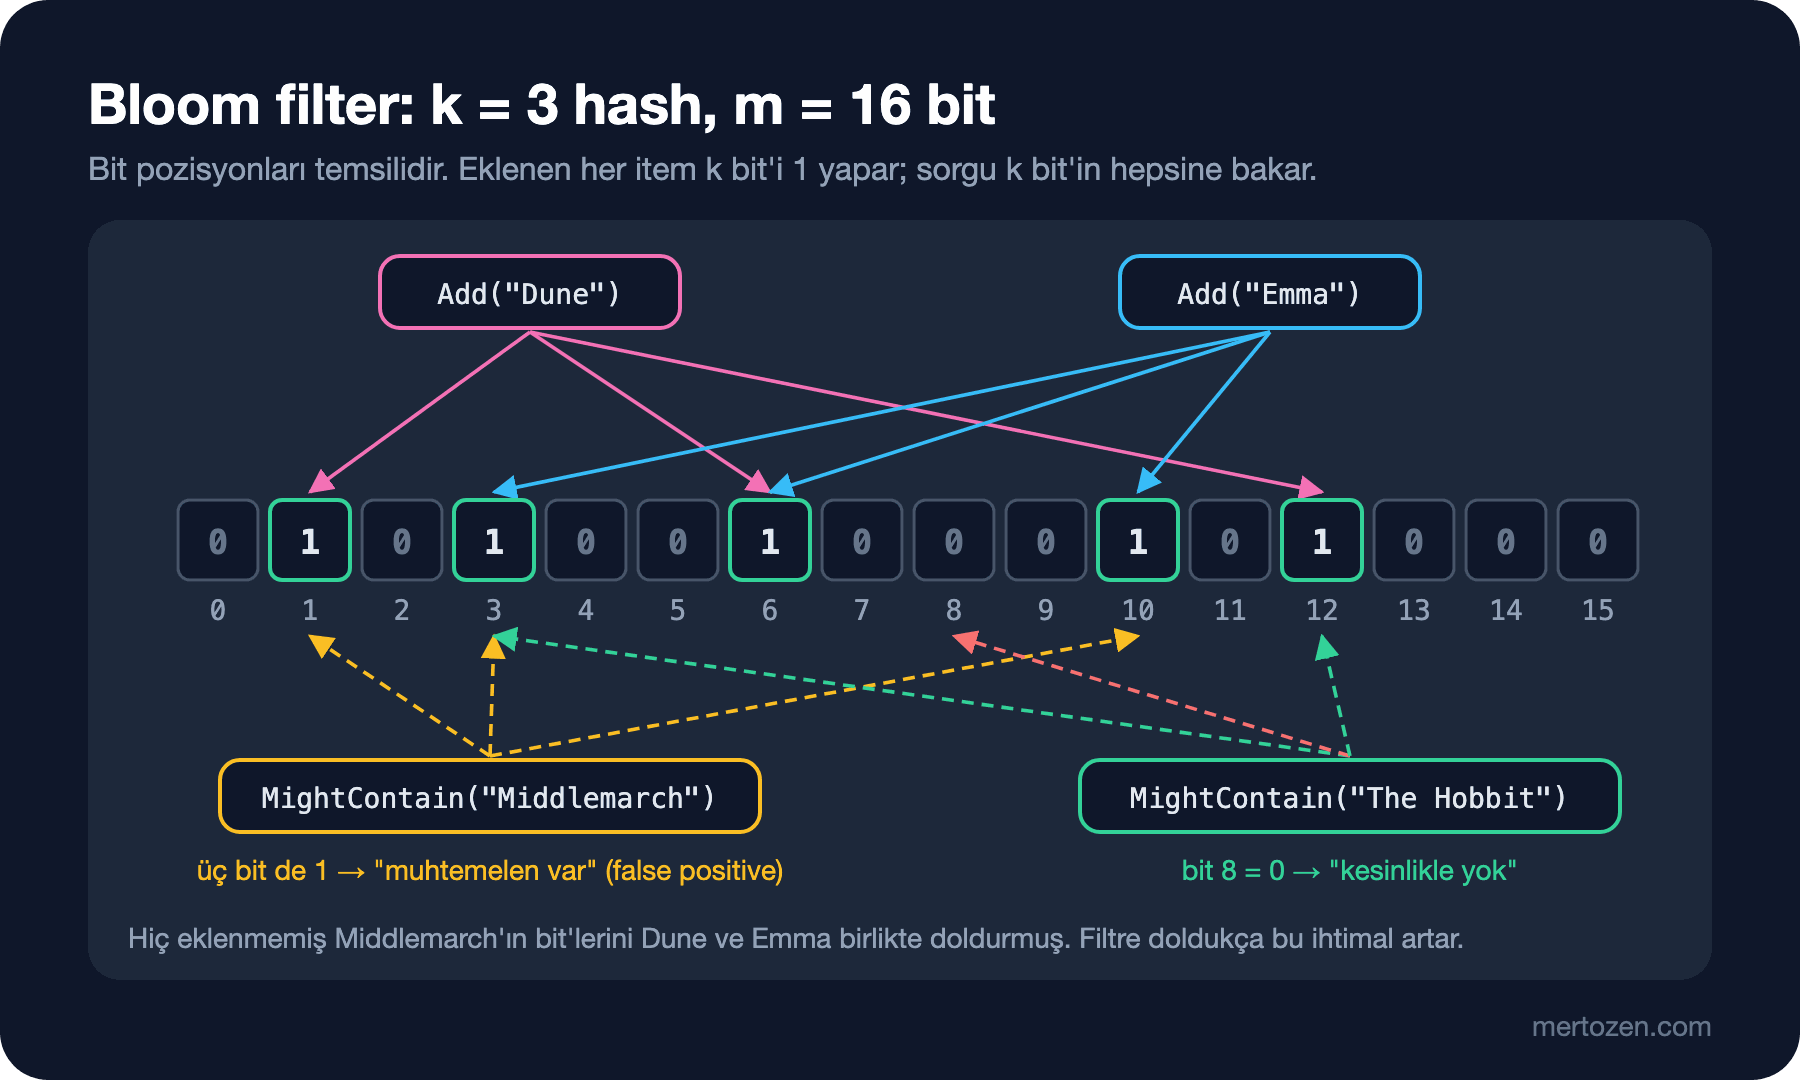
Burton Bloom'un 1970'te tanımladığı yapı m bit'lik bir array ve k hash fonksiyonundan oluşur. Eklenen her item k pozisyonu 1 yapar. Sorgu aynı k pozisyona bakar: biri bile 0 ise item kesinlikle eklenmemiştir; hepsi 1 ise muhtemelen eklenmiştir, çünkü o bit'leri başka item'lar da doldurmuş olabilir.
// m bit, item başına k hash pozisyonu. "false" = kesinlikle eklenmedi; "true" = muhtemelen eklendi
public sealed class BloomFilter
{
    private readonly ulong[] _bits;

    public void Add(string item)
    {
        (ulong h1, ulong h2) = ItemHash.Hash128(item);
        for (int i = 0; i < HashCount; i++)
        {
            long bit = Position(h1, h2, i);
            _bits[bit >> 6] |= 1UL << (int)(bit & 63);
        }
    }

    public bool MightContain(string item)
    {
        (ulong h1, ulong h2) = ItemHash.Hash128(item);
        for (int i = 0; i < HashCount; i++)
        {
            long bit = Position(h1, h2, i);
            if ((_bits[bit >> 6] & (1UL << (int)(bit & 63))) == 0) return false; // tek bir 0 bit yeter
        }

        return true;
    }

    // Double hashing (Kirsch ve Mitzenmacher): iki hash'ten k pozisyon
    private long Position(ulong h1, ulong h2, int i) => (long)((h1 + (ulong)i * h2) % (ulong)BitCount);
}
k tane bağımsız hash fonksiyonu yazmak gerekmiyor. Kirsch ve Mitzenmacher'in 2006 tarihli çalışması, iki hash'ten h1 + i·h2 ile üretilen k pozisyonun false positive oranını pratikte değiştirmediğini gösteriyor. İki hash'i de tek bir hesapla alıyoruz: ItemHash, item'ın byte'larının (UTF-8 kodlamasıyla) System.IO.Hashing paketindeki XxHash128 değerini ikiye bölüyor. string.GetHashCode() kullanmıyoruz, çünkü serinin 6. yazısında gördüğümüz gibi her process'te farklı bir seed'le çalışır; diske yazılan ya da başka bir sunucuyla paylaşılan bir filtre onunla anlamsız olur.
Boyutlandırma: Formül ve Ölçüm
n item eklenmiş, m bit'lik ve k hash'li bir filtrede false positive oranı yaklaşık (1 − e^(−kn/m))^k. Hedef oran p ise gereken bit sayısı ve en iyi hash sayısı bu formülden çıkar:
// n beklenen item, p hedef false positive oranı: m = -n ln p / (ln 2)^2, k = (m / n) ln 2
public static BloomFilter ForCapacity(long expectedItems, double falsePositiveRate)
{
    double m = -expectedItems * Math.Log(falsePositiveRate) / (Math.Log(2) * Math.Log(2));
    int k = Math.Max(1, (int)Math.Round(m / expectedItems * Math.Log(2)));
    return new BloomFilter((long)Math.Ceiling(m), k);
}
Yüzde 1 için item başına 9,6 bit ve 7 hash. Açılıştaki senaryoyu çalıştırdım: 1.000.000 e-posta ekleyip, sonra hiç eklenmemiş 1.000.000 e-postayı sordum.
bloom: m=9,585,088 bits (1.14 MB), k=7
HashSet<string> with the e-mails: 162.6 MB
false negatives: 0
false positives: 10,089 / 1,000,000 = 1.01 % (formula 1.00 %)
after 3,000,000 adds: 43.64 % (formula 43.60 %)
HashSet'in değeri GC.GetTotalMemory farkıyla ölçüldü ve string'lerin kendisini de içeriyor; tam sayı ortama göre değişir ama büyüklük sırası değişmez: yüz MB'ların karşısında 1,14 MB. Bloom filter e-postaları saklamıyor, yalnız bit'leri. Ölçülen oran formülle aynı ve false negative yok; eklenen her e-posta "muhtemelen var" dedi.
Son satır yapının en önemli uyarısı. Filtre 1 milyon için boyutlandırıldı; 3 milyon item eklenince bit'lerin çoğu 1 oldu ve yeni e-postaların yüzde 44'ü "muhtemelen var" cevabı aldı. Exception yok, log yok; yalnız filtre işe yaramaz hale geliyor. Hangi item'ların eklendiğini bilmediği için Bloom filter sonradan büyütülemez de; daha büyük bir filtreyi sıfırdan kurmak gerekir.
Bookstore'da akış şöyle: filtre "hayır" derse e-posta kesinlikle yeni, veritabanına gitmeye gerek yok; "evet" derse veritabanına sorulur. Böylece veritabanına yalnız gerçekten kayıtlı e-postalar ve yeni e-postaların yaklaşık yüzde 1'i gider. Filtre bir güvenlik önlemi değil, sorgu tasarrufu: kullanıcıya "bu e-posta kayıtlı" bilgisini verip vermemek ayrı bir karar.
Silme Yok: Counting ve Cuckoo Filter
Bir kullanıcı hesabını sildiğinde e-postasını filtreden çıkaramayız: bit'lerini 0 yapmak, aynı bit'leri paylaşan başka e-postalar için false negative üretir, yani yapının tek garantisini bozar. İki yaygın çözüm var. Counting Bloom filter her bit yerine küçük bir sayaç tutar (genellikle 4 bit); ekleme artırır, silme azaltır, bedeli yaklaşık 4 kat bellek. Cuckoo filter (Fan, Andersen, Kaminsky ve Mitzenmacher, 2014) item'ların kısa fingerprint'lerini cuckoo hashing ile bir tabloda tutar; silmeyi destekler ve düşük false positive oranlarında Bloom filter'dan daha az yer kaplayabilir. Silme seyrekse en basit çözüm genellikle filtreyi periyodik olarak kaynaktan yeniden kurmaktır.
Count-Min Sketch: Yaklaşık Frekans
Bloom filter "var mı?" sorusunu cevaplıyor; "kaç kez?" için Cormode ve Muthukrishnan'ın 2005'te yayımladığı Count-Min Sketch var. d satır ve w sütunluk bir sayaç tablosu: her item her satırda bir sayacı artırır, sorgu da item'ın d sayacının en küçüğünü döner.
public void Add(string item, long count = 1)
{
    (ulong h1, ulong h2) = ItemHash.Hash128(item);
    for (int row = 0; row < Depth; row++) _counts[row, Column(h1, h2, row)] += count;
    TotalCount += count;
}

public long Estimate(string item)
{
    (ulong h1, ulong h2) = ItemHash.Hash128(item);
    long min = long.MaxValue;
    for (int row = 0; row < Depth; row++) min = Math.Min(min, _counts[row, Column(h1, h2, row)]);
    return min; // her satır çakışmalar yüzünden fazla sayar; en küçüğü gerçeğe en yakın olanı
}
Garanti tek yönlü: tahmin hiçbir zaman gerçek sayının altında değil ve 1 − δ olasılıkla en fazla ε·N fazla (N toplam sayım). Boyutlar bundan çıkar: w = ⌈e/ε⌉, d = ⌈ln(1/δ)⌉. Bookstore'da 100.000 kitaplık bir katalogda, popülerliği 1/sıra ile azalan 2.000.000 görüntülenme ürettim ve ε = 0,001, δ = 0,01 ile ölçtüm:
sketch: 2719 x 5 counters = 106 KB, distinct books viewed: 94,026
9780000000000: exact 165,696, sketch 166,074
9780000000001: exact  82,257, sketch  82,406
9780000000002: exact  55,215, sketch  55,410
over-count: max 1,153, average 197.5, bound epsilon*N = 2,000
a book viewed once: exact 1, sketch 153
En çok görüntülenen kitaplarda hata binde 2–4; en kötü fazla sayım da 2.000'lik sınırın altında. Son satır ise sketch'in nerede işe yaramadığını gösteriyor: bir kez görüntülenen kitap için 153 diyor. Hata mutlak (ε·N), göreli değil; küçük sayılar çakışmaların gürültüsünde kaybolur. Count-Min Sketch heavy hitter'lar (en sık görülenler) içindir: "en çok görüntülenen 10 kitap" için sketch'i serinin 13. yazısındaki gibi 10 elemanlı bir min-heap'le birleştirirsin; her görüntülenmede tahmini heap'in en küçüğüyle karşılaştırırsın. 23. yazıdaki W-TinyLFU da frekansları bu yapıyla tahmin ediyordu.
HyperLogLog: Tekil Sayısını 16 KB ile Saymak
Tekil ziyaretçiyi saymanın kesin yolu bütün kimlikleri bir set'te tutmak; bellek tekil sayıyla büyür. Flajolet, Fusy, Gandouet ve Meunier'nin 2007 tarihli HyperLogLog'u, kısaca HLL (yapının adının kısaltması), farklı bir gözleme dayanır: rastgele hash'lerde başta k tane sıfır biti görmek yaklaşık 2^k farklı değerde bir olur. En uzun sıfır serisini hatırlamak kabaca kaç farklı değer gördüğünü söyler. Tek bir tahmin çok oynak olduğu için hash'in ilk p biti item'ı 2^p register'dan birine gönderir, tahminler harmonik ortalamayla birleştirilir:
public void Add(string item)
{
    ulong hash = XxHash3.HashToUInt64(Encoding.UTF8.GetBytes(item));
    int index = (int)(hash >> (64 - _p));                          // ilk p bit register'ı seçer
    ulong rest = (hash << _p) | (1UL << (_p - 1));                 // koruma biti rho'yu sınırlı tutar
    byte rho = (byte)(BitOperations.LeadingZeroCount(rest) + 1);   // ilk 1 bitinin pozisyonu
    if (rho > _registers[index]) _registers[index] = rho;
}

// İki set'in birleşimi: her register'ın büyük olanı
public void Merge(HyperLogLog other)
{
    if (other._p != _p) throw new ArgumentException("Precision must match.", nameof(other));
    for (int i = 0; i < _registers.Length; i++)
        _registers[i] = Math.Max(_registers[i], other._registers[i]);
}
Count makaledeki formülü uyguluyor; küçük sayılarda boş register sayısıyla çalışan linear counting'e geçiyor. Standart hata 1,04/√m; p = 14 ile m = 16.384 register ve yüzde 0,81. İki günlük ziyaret akışı ürettim, her gün 1,5 milyon ziyaret:
registers: 16,384 (1 byte each), standard error 0.81 %
monday unique: exact 390,808, HLL 391,358
monday + tuesday: exact 590,657, HLL 595,324
Pazartesi için hata binde 1,4, iki günün birleşimi için yüzde 0,8. İkinci sorunun cevabı 16 KB: register başına bir byte kullandık. Redis aynı hassasiyeti register'ları 6 bit'e sıkıştırarak en fazla 12 KB ile sağlıyor. Asıl güç Merge'de: her günün HLL'ini saklarsan haftalık ya da aylık tekil sayısını günlükleri birleştirerek bulursun; aynı ziyaretçi iki kez sayılmaz. Toplama yapılamaz (iki günün tekillerini toplamak ortak ziyaretçileri iki kez sayar), kesişim de doğrudan alınamaz. HLL kimlikleri saklamadığı için "bu kullanıcı dün geldi mi?" sorusunu da cevaplayamaz.
Hazır Çözümler: Redis
BCL'de (.NET ile gelen temel class kütüphanesi) bu yapıların hiçbiri yok. Production'da çoğunlukla Redis'tekileri kullanırsın: HyperLogLog için PFADD, PFCOUNT ve PFMERGE; Bloom filter, Cuckoo filter, Count-Min Sketch ve Top-K için de ayrı komut grupları var. Avantajı, yapının bütün sunuculardan paylaşılması ve kalıcı olması. Komutlar, bellek ayarları ve StackExchange.Redis ile kullanımları Redis serisinin "Özel Data Type'lar: Bitmap, HyperLogLog, Geospatial ve Probabilistic Yapılar (Bloom, Cuckoo, Top-K)" yazısında; burada amaç, o komutların arkasındaki algoritmayı bilmekti.
Üretimde Dikkat
Büyümeye göre boyutlandır. Bloom filter'ı bugünkü kullanıcı sayısına göre değil, bir sonraki yeniden kurulumuna kadar ulaşacağı sayıya göre kur. Eklenen item sayısını say ve ExpectedFalsePositiveRate hedefi aştığında filtreyi daha büyük boyutla yeniden kur.
Hash'i sabitle. Filtreyi diske yazıyor ya da sunucular arasında paylaşıyorsan hash fonksiyonu ve seed'i sözleşmenin parçasıdır. Hash'i değiştirmek, mevcut filtreyi sessizce bozar: eklenmiş item'lar "kesinlikle yok" cevabı almaya başlar.
Hata payını iş tarafına anlat. "Bugün 391 bin tekil ziyaretçi" bir tahmin; dashboard'da "yaklaşık" yazmak ve hata payını belgelemek gerekir.
Gerçekten gerekip gerekmediğini ölç. 10.000 item için bir HashSet birkaç yüz KB'tır ve kesindir. Bu yapılar milyonlarca item'da ya da birçok sunucuya dağıtılan sayaçlarda anlam kazanır.
Sık Düşülen Tuzaklar
Bloom filter'ın garantisini ters okumak. "Kesinlikle yok / muhtemelen var" yapısı, "evet" cevabına güvenip veritabanına sormamayı yanlış yapar. Yüzde 1'lik false positive, yeni bir kullanıcıya "bu e-posta zaten kayıtlı" demek olur.
Yaklaşık sayıyı kesinlik isteyen yerde kullanmak. Faturalama, stok, kampanya kotası ya da yasal raporlar HLL ya da Count-Min Sketch ile hesaplanmaz. Bir kitabın satış sayısını sketch'ten okumak, 153 ile 1 arasındaki farkı müşteriye fatura etmek demek.
Filtreyi aşırı doldurmak. Ölçümdeki gibi 3 katına çıkan item sayısı yüzde 1'i yüzde 44 yapar ve bunu kimse fark etmez; doluluk oranını metrik olarak izle.
Count-Min Sketch'i nadir item'lar için kullanmak. Hata toplam sayımla orantılı; az görülen item'ların sayıları anlamsız olur.
Küçük Bir Deneme
★☆☆ BloomFilter'a eklenen item sayısını tutan bir Count ve dolu bit oranını dönen bir FillRatio property'si ekle. 1 milyon e-posta sonrası dolu bit oranı kaç? Teoride yaklaşık yüzde 50 olmalı; neden?
★★☆ CountMinSketch ile 10 elemanlı bir min-heap'i birleştiren bir TopK class'ı yaz ve aynı 2.000.000 görüntülenmede bulduğu ilk 10 kitabı kesin sonuçla karşılaştır.
★★★ HyperLogLog'un precision değerini 10, 12, 14 ve 16 yaparak aynı 390.808 tekil ziyaretçiyi her biri için 20 farklı seed'le say. Ölçtüğün hata dağılımı 1,04/√m ile uyuşuyor mu?
Bu yazıda kesinlikten bilerek vazgeçtik ve hatayı ölçerek kontrol ettik. Serinin son yazısında rastgeleliğin kendisine bakıyoruz: doğru ve yanlış shuffle, akan veriden örnek almak, ağırlıklı seçim ve bir kullanıcının feature flag yüzdesinde her istekte aynı grupta kalmasını sağlayan deterministik hash.