

Pod'lar Nereye Yerleşir? nodeSelector, Affinity/Anti-Affinity, Taint/Toleration, Topology Spread ve PriorityClass
Pod'un hangi node'a gideceğini kube-scheduler filter ve score adımlarıyla seçer; zorunlu kurallar pod'u Pending bırakabilir, tercihler hiçbir şeyi garanti etmez. Zorunlu anti-affinity'nin rollout'u kilitlemesini, zone spread'in cordon'da takılmasını ve nodeTaintsPolicy: Honor ile çözülmesini, taint'li worker pool'unu, PriorityClass ile preemption'ı ve "0/3 nodes are available" mesajını gerçek çıktılarla okuyoruz.
Sürüm notu: Bu yazıdaki örnekler kind 0.33 ile Kubernetes 1.37, kubectl 1.37 ve .NET 10 ile build edilen Bookstore API image'ıyla denenmiştir.
Önce Tahmin Et
Üç node'lu bir cluster'da Bookstore API'sinin üç replica'sı çalışıyor. Bir node kapanınca iki replica birden gitmesin diye Deployment'a "aynı node'a iki api pod'u koyma" diyen zorunlu bir pod anti-affinity kuralı yazdın; rolling update ayarlarına dokunmadın. Yeni sürümü çıkarmak için kubectl rollout restart yapıyorsun. Rollout kaç saniyede biter? Bir ipucu: varsayılan strateji maxSurge: 25% ve maxUnavailable: 25%, üç replica için bunun hangi sayılara yuvarlandığını düşün. Cevabı ve çıkış yolunu yazının ortasında gerçek çıktıyla görüyoruz.
Scheduler Bir Pod'a Nasıl Node Seçer?
Bir pod oluşturulduğunda spec.nodeName alanı boştur. kube-scheduler bu pod'ları queue'sundan alır ve iki adımda karar verir. Filter adımında pod'u hiç kabul edemeyecek node'ları eler: request'ler sığmıyorsa (serinin dokuzuncu yazısı), taint'e karşılık gelen toleration yoksa, nodeSelector ya da zorunlu affinity tutmuyorsa, topology spread kuralı bozulacaksa. Score adımında kalan node'lara puan verir: daha az dolu node, tercih edilen affinity'ye uyan node, pod'ları daha dengeli dağıtan node daha yüksek puan alır. En yüksek puanlı node seçilir ve pod ona bağlanır (bind). Hiçbir node filter'dan geçemezse pod Pending kalır ve scheduler preemption'ı, yani daha düşük öncelikli pod'ları çıkararak yer açmayı dener.
Bu yazıdaki her kural bu iki adımdan birine yerleşir: "zorunlu" (required, DoNotSchedule, NoSchedule) olanlar filter'a, "tercih" (preferred, ScheduleAnyway, PreferNoSchedule) olanlar score'a. Filter'daki bir kural pod'u Pending bırakabilir; score'daki bir kural hiçbir zaman bırakmaz, ama garanti de vermez.
Lab'ı sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) üzerinde kuruyoruz. Seride veritabanı olarak PostgreSQL kullanmıştık; bu ek yazılarda konu scheduling olduğu için API'yi veritabanısız, Database__Provider=InMemory ile çalıştırıyorum. kind cluster'ında üç node'u üç ayrı zone gibi etiketledim; bulutta bu label'ı sağlayıcı kendisi koyar:
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
nodes:
  - role: control-plane
    labels:
      topology.kubernetes.io/zone: zone-a
  - role: worker
    labels:
      topology.kubernetes.io/zone: zone-b
  - role: worker
    labels:
      topology.kubernetes.io/zone: zone-c
$ kind create cluster --name k8sseries-lab --config kind-config.yaml
$ docker build -f src/Bookstore.Api/Dockerfile -t k8sseries-bookstore-api:1.0.0 .
$ kind load docker-image k8sseries-bookstore-api:1.0.0 --name k8sseries-lab
$ kubectl taint nodes k8sseries-lab-control-plane node-role.kubernetes.io/control-plane:NoSchedule-
$ kubectl get nodes -o custom-columns='NAME:.metadata.name,ZONE:.metadata.labels.topology\.kubernetes\.io/zone,TAINTS:.spec.taints[*].key'
NAME ZONE TAINTS
k8sseries-lab-control-plane zone-a <none>
k8sseries-lab-worker zone-b <none>
k8sseries-lab-worker2 zone-c <none>Control-plane node'unun taint'ini yalnız bu lab'da kaldırdım ki üç zone'un her birinde uygulama pod'u çalışabilsin. Production'da control plane'e uygulama koymazsın; managed cluster'da zaten göremezsin.
nodeSelector ve Node Affinity: Zorunlu ve Tercih
En basit araç nodeSelector: pod yalnız bu label'lara sahip node'lara gider. Node affinity aynı işi ifadelerle yapar (In, NotIn, Exists, Gt…) ve iki türü vardır. requiredDuringSchedulingIgnoredDuringExecution filter adımına girer; preferredDuringSchedulingIgnoredDuringExecution ise 1–100 arası bir ağırlıkla score'a eklenir. Adın sonundaki "IgnoredDuringExecution" önemli: pod yerleştikten sonra node'un label'ı değişirse pod yerinden oynamaz.
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
              - matchExpressions:
                  - key: kubernetes.io/os
                    operator: In
                    values: ["linux"]
          preferredDuringSchedulingIgnoredDuringExecution:
            - weight: 100
              preference:
                matchExpressions:
                  - key: topology.kubernetes.io/zone
                    operator: In
                    values: ["zone-a"]
"zone-a'yı tercih et ama şart değil" gibi zararsız görünen bu kuralla API'yi 6 replica'yla açtım:
$ kubectl -n bookstore get pods -l app.kubernetes.io/name=api -o custom-columns=NAME:.metadata.name,STATUS:.status.phase,NODE:.spec.nodeName
NAME                   STATUS    NODE
api-78849fcdc8-28cw7   Running   k8sseries-lab-control-plane
api-78849fcdc8-28t6s   Running   k8sseries-lab-control-plane
api-78849fcdc8-8fbb2   Running   k8sseries-lab-control-plane
api-78849fcdc8-cc8d6   Running   k8sseries-lab-control-plane
api-78849fcdc8-fdkpl   Running   k8sseries-lab-control-plane
api-78849fcdc8-tj58h   Running   k8sseries-lab-control-plane
Altı pod'un altısı da zone-a'da. "Tercih" bir puan, ve 100 ağırlık scheduler'ın varsayılan yayma eğilimini rahatça yendi. zone-a giderse API'nin tamamı gider. Preferred affinity'yi "maliyet için aynı zone'da olsun" gibi gerçekten toplanmak istediğin durumlarda kullan; dağılım istiyorsan aşağıdaki araçlara bak.
Pod Anti-Affinity: Replica'ları Ayırmak ve Rollout'u Kilitlemek
Pod affinity ve anti-affinity node label'larına değil, o topolojide zaten çalışan pod'lara bakar: "bu label'a sahip bir pod'un bulunduğu node'a (ya da zone'a) git" veya "gitme". Önce Tahmin Et'teki Deployment:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - topologyKey: kubernetes.io/hostname
              labelSelector:
                matchLabels:
                  app.kubernetes.io/name: api
$ kubectl -n bookstore rollout restart deploy/api
deployment.apps/api restarted
$ kubectl -n bookstore rollout status deploy/api --timeout=45s
Waiting for deployment "api" rollout to finish: 1 out of 3 new replicas have been updated...
error: timed out waiting for the condition
$ kubectl -n bookstore events --for pod/api-5f897cb965-rxnpn
LAST SEEN TYPE REASON OBJECT MESSAGE
45s Warning FailedScheduling Pod/api-5f897cb965-rxnpn 0/3 nodes are available: 3 node(s) didn't match pod anti-affinity rules. preemption: 0/3 nodes are available: 3 No preemption victims found for incoming pod.Rollout hiç bitmez. Üç replica'da maxUnavailable: 25% aşağı yuvarlanıp 0, maxSurge: 25% yukarı yuvarlanıp 1 olur: Deployment önce dördüncü bir pod açmak, sonra eskilerden birini kapatmak ister. Ama üç node'un her birinde zaten bir api pod'u var ve kural dördüncüye yer bırakmıyor. Eski pod'lar silinmeyecek, çünkü önce yeni pod hazır olmalı; döngü burada kilitlenir.
İlk aklıma gelen düzeltme, kurala matchLabelKeys: [pod-template-hash] eklemekti; bu alan 1.33'te GA (kararlı sürüm) oldu. Böylece seçiciye pod'un kendi revision hash'i eklenir ve yeni pod yalnız aynı revision'ın pod'larından kaçar. Uyguladım; yeni pod yine Pending kaldı, ama mesaj değişti:
0/3 nodes are available: 3 node(s) didn't satisfy existing pods anti-affinity rules. preemption: 0/3 nodes are available: 3 No preemption victims found for incoming pod."didn't match" yerine "didn't satisfy existing pods". Zorunlu anti-affinity simetriktir: scheduler yalnız yeni pod'un kuralına değil, node'daki mevcut pod'ların kurallarına da bakar. Eski üç pod hâlâ hash'siz kuralı taşıyor ve "yanıma hiçbir api pod'u gelmesin" diyor. Bu geçişi bir kerelik açmanın yolu, eski pod'lardan birinin önce kapanmasına izin vermek:
  strategy:
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 1
Bununla rollout bitti; sonraki rollout restart da artık hash'li kural sayesinde takılmadan geçti. Ama replica sayısını 4'e çıkarınca dördüncü pod yine didn't match pod anti-affinity rules ile Pending kaldı: zorunlu hostname anti-affinity, replica sayısını node sayısıyla sınırlar. HPA'nın (yüke göre pod sayısını ayarlayan Kubernetes bileşeni; serinin on birinci yazısı) büyütmek istediği bir Deployment'ta bu, yük anında ölçeklenememek demek. Çoğu durumda doğru araç anti-affinity değil, topology spread.
Topology Spread ile Zone'lara Yaymak
On birinci yazıda topologySpreadConstraints'i node seviyesinde kullanmış, nodeTaintsPolicy yüzünden takılan bir rollout görmüştük. Burada aynı aracı zone seviyesinde kuruyoruz: zone için zorunlu, node için tercih.
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: DoNotSchedule
          matchLabelKeys:
            - pod-template-hash
          labelSelector:
            matchLabels:
              app.kubernetes.io/name: api
        - maxSkew: 1
          topologyKey: kubernetes.io/hostname
          whenUnsatisfiable: ScheduleAnyway
          matchLabelKeys:
            - pod-template-hash
          labelSelector:
            matchLabels:
              app.kubernetes.io/name: api
maxSkew: 1, en kalabalık zone ile en boş zone arasındaki pod farkının en fazla 1 olabileceğini söyler. Bir dürüstlük notu: aynı 6 replica'yı hiçbir kural yazmadan üç kez açtığımda da her seferinde 2/2/2 dağıldı. Scheduler'ın varsayılan yayma kuralları var (hostname için maxSkew: 3, zone için maxSkew: 5, ikisi de ScheduleAnyway) ve boş bir cluster'da iyi iş çıkarıyorlar. Açık kuralın değeri, işler ters gittiğinde ortaya çıkıyor. zone-c'deki node'u bakım için kubectl cordon ile kapattım ve rollout başlattım:
$ kubectl cordon k8sseries-lab-worker2
node/k8sseries-lab-worker2 cordoned
$ kubectl -n bookstore rollout restart deploy/api
deployment.apps/api restarted
$ kubectl -n bookstore get pods -o custom-columns=NAME:.metadata.name,STATUS:.status.phase,NODE:.spec.nodeName --sort-by=.metadata.name
NAME                   STATUS    NODE
api-54c4d8bbdc-2tc4r   Running   k8sseries-lab-worker2
api-54c4d8bbdc-n8jk9   Running   k8sseries-lab-control-plane
api-54c4d8bbdc-njzv7   Running   k8sseries-lab-worker2
api-7db5d94b78-298xk   Pending   <none>
api-7db5d94b78-9nhps   Pending   <none>
api-7db5d94b78-dsckw   Pending   <none>
api-7db5d94b78-m2scf   Running   k8sseries-lab-worker
api-7db5d94b78-rcq9h   Running   k8sseries-lab-control-plane
$ kubectl -n bookstore events --for pod/api-7db5d94b78-298xk
LAST SEEN   TYPE      REASON             OBJECT                     MESSAGE
39s         Warning   FailedScheduling   Pod/api-7db5d94b78-298xk   0/3 nodes are available: 1 node(s) were unschedulable, 2 node(s) didn't match pod topology spread constraints. preemption: 0/3 nodes are available: 1 Preemption is not helpful for scheduling, 2 No preemption victims found for incoming pod.
Yeni revision zone-a ve zone-b'ye birer pod koydu ve durdu. Cordon, node'a node.kubernetes.io/unschedulable taint'i ekler; nodeTaintsPolicy'nin varsayılanı Ignore olduğu için zone-c hâlâ bir domain sayılıyor ve orada yeni revision'dan 0 pod var. zone-a'ya ikinci pod konursa fark 2 olur, maxSkew: 1 izin vermez. Bir zone kaybında tam olarak bunu istemezsin: kalan iki zone'da yer varken pod'lar Pending kalıyor. nodeTaintsPolicy: Honor eklediğimde cordon'lu node hesaptan çıktı ve rollout bitti:
$ kubectl -n bookstore get pods -o custom-columns=NAME:.metadata.name,STATUS:.status.phase,NODE:.spec.nodeName
NAME                   STATUS    NODE
api-599c5b474c-4pbhn   Running   k8sseries-lab-worker
api-599c5b474c-5s8kk   Running   k8sseries-lab-worker
api-599c5b474c-6vgfj   Running   k8sseries-lab-control-plane
api-599c5b474c-88cc8   Running   k8sseries-lab-control-plane
api-599c5b474c-gfmwc   Running   k8sseries-lab-worker
api-599c5b474c-mcknf   Running   k8sseries-lab-control-plane
$ kubectl uncordon k8sseries-lab-worker2
node/k8sseries-lab-worker2 uncordoned
$ kubectl -n bookstore scale deploy/api --replicas=7
deployment.apps/api scaled
$ kubectl -n bookstore get pods -o custom-columns=NAME:.metadata.name,STATUS:.status.phase,NODE:.spec.nodeName
NAME                   STATUS    NODE
api-599c5b474c-4pbhn   Running   k8sseries-lab-worker
api-599c5b474c-5s8kk   Running   k8sseries-lab-worker
api-599c5b474c-6vgfj   Running   k8sseries-lab-control-plane
api-599c5b474c-88cc8   Running   k8sseries-lab-control-plane
api-599c5b474c-gfmwc   Running   k8sseries-lab-worker
api-599c5b474c-jfwgd   Running   k8sseries-lab-worker2
api-599c5b474c-mcknf   Running   k8sseries-lab-control-plane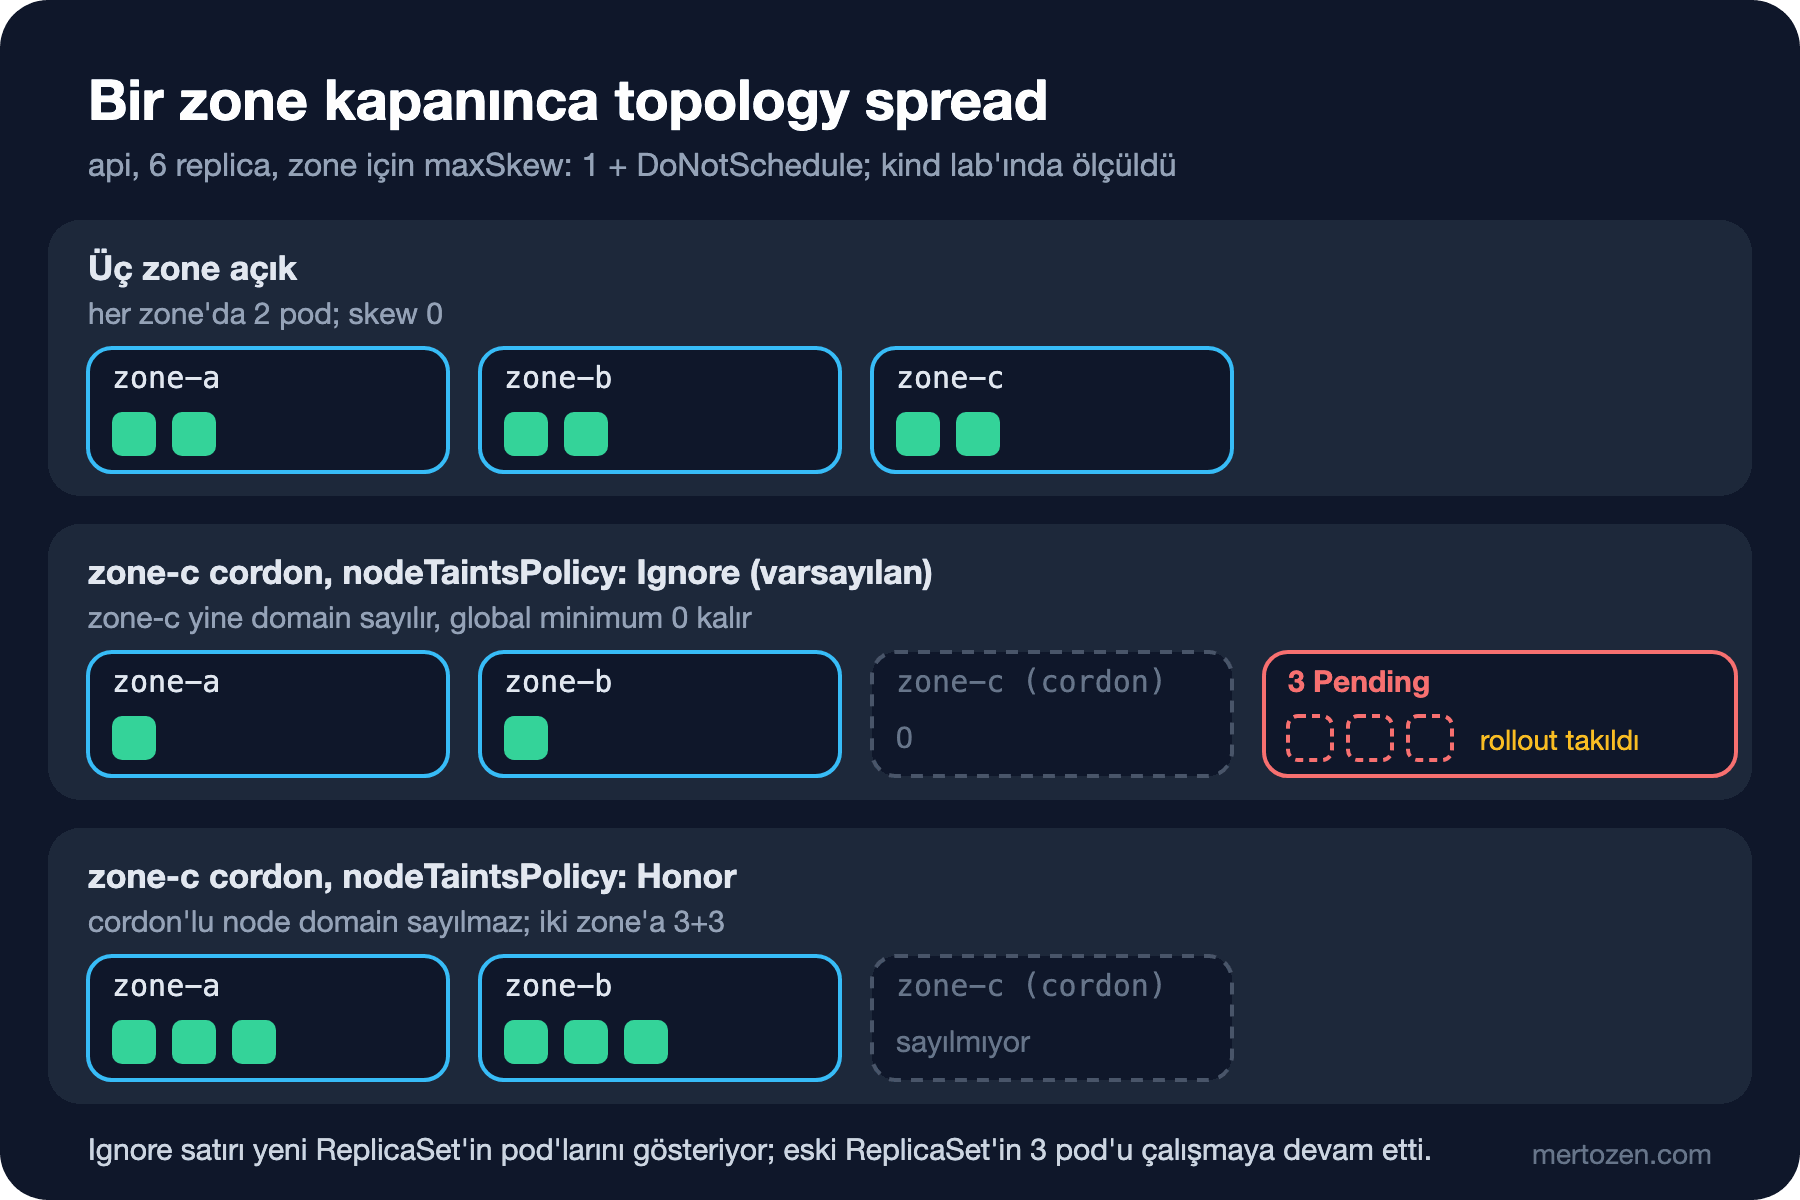
Son satır da önemli: node geri açılınca mevcut pod'lar kendiliğinden yeniden dağılmıyor. Scheduler yalnız yeni pod'ları yerleştirir; 3/3/0 dağılım, yeni bir rollout'a ya da Descheduler gibi ayrı bir bileşene kadar öyle kalır. Bir de minDomains var: autoscaler'ın bir zone'u sıfır node'a indirdiği cluster'larda scheduler o zone'u göremez; minDomains: 3 "en az üç domain olmalı, yoksa global minimumu 0 say" diyerek pod'ların eldeki iki zone'a yığılmasını engeller.
Taint ve Toleration ile Ayrılmış Node Pool
Bookstore'un background worker'larını (sipariş outbox'ı, rapor üretimi) API ile aynı node'larda çalıştırmak istemiyorsun: rapor job'ları CPU'yu yiyince API'nin latency'si artıyor. Çözüm, worker'lar için ayrı bir node pool. Lab'da zone-c'deki node'u bu pool'a çevirdim:
$ kubectl label node k8sseries-lab-worker2 bookstore.example.com/pool=workers
node/k8sseries-lab-worker2 labeled
$ kubectl taint node k8sseries-lab-worker2 bookstore.example.com/pool=workers:NoSchedule
node/k8sseries-lab-worker2 tainted
Taint "toleration'ı olmayan pod'lar buraya gelmesin" der. Worker Deployment'ına (lab'da worker'ın yerine busybox çalışıyor) önce yalnız toleration ekledim:
      tolerations:
        - key: bookstore.example.com/pool
          operator: Equal
          value: workers
          effect: NoSchedule
$ kubectl -n bookstore get pods -o custom-columns=NAME:.metadata.name,STATUS:.status.phase,NODE:.spec.nodeName
NAME STATUS NODE
api-599c5b474c-4pbhn Running k8sseries-lab-worker
api-599c5b474c-5s8kk Running k8sseries-lab-worker
api-599c5b474c-jfwgd Running k8sseries-lab-worker2
order-worker-5fc778b585-tdw4r Running k8sseries-lab-worker
order-worker-5fc778b585-wmr2r Running k8sseries-lab-worker2İki ders tek çıktıda. Toleration bir izin, çekim değil: worker pod'larından biri pool dışındaki bir node'a gitti. Ve NoSchedule mevcut pod'lara dokunmaz: taint'ten önce yerleşmiş api pod'u worker2'de çalışmaya devam ediyor. Pod'ları hemen çıkarmak isteseydin NoExecute etkisi gerekirdi. Kubernetes dokümanının önerdiği kalıp ikisini birlikte kullanmak: taint dışarıdakileri uzak tutar, aynı node'a konan label ve pod'daki nodeSelector (ya da required node affinity) worker'ları oraya bağlar:
    spec:
      nodeSelector:
        bookstore.example.com/pool: workers
      tolerations:
        - key: bookstore.example.com/pool
          operator: Equal
          value: workers
          effect: NoSchedule
Bununla iki worker pod'u da worker2'ye gitti; API'yi yeniden başlatınca (spread kuralında nodeTaintsPolicy: Honor vardı) api pod'ları da zone-a ve zone-b'ye çekildi. Managed cluster'da aynı şey node pool seviyesinde yapılır: serinin on yedinci yazısındaki AKS (Azure'un yönetilen Kubernetes servisi) user node pool'u ya da EKS'in (AWS'nin yönetilen Kubernetes servisi) managed node group'u oluşturulurken label ve taint verilir, pool'a eklenen her yeni node bunlarla gelir.
DaemonSet her node'a gider mi?
DaemonSet her uygun node'a bir pod koyar; ama "uygun" taint'leri de içerir. Log toplayıcıyı temsil eden bir DaemonSet'i toleration'sız açtım, sonra toleration ekledim:
NAME         DESIRED   CURRENT   READY   UP-TO-DATE   AVAILABLE   NODE SELECTOR   AGE
node-agent   2         2         2       2            2           <none>          15s
NAME         DESIRED   CURRENT   READY   UP-TO-DATE   AVAILABLE   NODE SELECTOR   AGE
node-agent   3         3         3       3            3           <none>          26s
DaemonSet controller'ı pod'lara not-ready, unreachable, disk-pressure, memory-pressure, pid-pressure ve unschedulable için toleration'ları kendisi ekliyor (pod'un spec.tolerations'ında gördüm); senin özel taint'lerini bilemez. Log ve metric toplayan bir DaemonSet'in ayrılmış pool'u atlaması, o node'lardan hiç log gelmemesi demek ve kimse fark etmeyebilir.
PriorityClass ve Preemption
Worker pool'unda iki tür iş var: sipariş işleme gecikmemeli, rapor üretimi bekleyebilir. Bunu scheduler'a PriorityClass ile söylüyorsun:
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: bookstore-critical
value: 100000
description: "Order processing: may preempt batch work."
---
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: bookstore-batch
value: -100
preemptionPolicy: Never
description: "Reports and exports: run when there is room, never preempt."
NAME VALUE GLOBAL-DEFAULT AGE PREEMPTIONPOLICY
bookstore-batch -100 false 0s Never
bookstore-critical 100000 false 0s PreemptLowerPriority
system-cluster-critical 2000000000 false 9m31s PreemptLowerPriority
system-node-critical 2000001000 false 9m31s PreemptLowerPriorityKullanıcı tanımlı değerler en fazla bir milyar olabilir; üstü cluster'ın kendi kritik bileşenlerine ayrılmış. PriorityClass'ı olmayan pod'ların önceliği 0'dır (globalDefault: true olan bir sınıf yoksa). Rapor pod'larına bookstore-batch verip her birine 3 CPU request'iyle worker2'nin allocatable CPU'sunun neredeyse tamamını doldurdum. Sonra sipariş worker'ını bookstore-critical ve pod başına 1 CPU request'iyle 3 replica'ya çıkardım:
$ kubectl -n bookstore events --types=Warning,Normal | grep Preempted
2s                      Normal    Preempted           Pod/report-batch-6d4dff8c7d-tq2rv    Preempted by pod <pod-uid> on node k8sseries-lab-worker2
$ kubectl -n bookstore get pods -l app.kubernetes.io/name=order-worker -o custom-columns=NAME:.metadata.name,PRIORITY:.spec.priority,NODE:.spec.nodeName
NAME                            PRIORITY   NODE
order-worker-7d87fd759d-ckbmz   100000     k8sseries-lab-worker2
order-worker-7d87fd759d-plhrs   100000     k8sseries-lab-worker2
order-worker-7d87fd759d-xphc2   100000     k8sseries-lab-worker2
$ kubectl -n bookstore get pods -l app.kubernetes.io/name=report-batch -o custom-columns=NAME:.metadata.name,PRIORITY:.spec.priority,STATUS:.status.phase
NAME                            PRIORITY   STATUS
report-batch-6d4dff8c7d-l8tgs   -100       Running
report-batch-6d4dff8c7d-pzpjk   -100       Running
report-batch-6d4dff8c7d-x76qw   -100       Pending
Scheduler bir rapor pod'unu çıkardı (preemption), yerine sipariş worker'larını koydu. ReplicaSet çıkarılan pod'un yerine yenisini açtı; o da yer bulamayıp Pending kaldı ve yerini geri almak için kimseyi çıkaramıyor, çünkü sınıfı preemptionPolicy: Never. Preemption'da kurban pod'lar normal graceful shutdown sürelerini alır; rapor pod'larına terminationGracePeriodSeconds: 5 vermemin sebebi, kritik pod'un 30 saniye beklememesi. Scheduler kurban seçerken PDB'lere (PodDisruptionBudget; gönüllü kesintide aynı anda kaç pod'un gidebileceğini sınırlayan kural) uymaya çalışır ama garanti etmez: başka kurban yoksa PDB'yi ihlal eder.
"0/3 nodes are available" Mesajını Okumak
Pending bir pod'un mesajı her zaman aynı kalıpla gelir: önce kaç node'un elendiği ve her grubun neden elendiği, sonra noktadan sonra preemption'ın bir işe yarayıp yaramayacağı. Rapor pod'unun mesajı:
0/3 nodes are available: 1 Insufficient cpu, 2 node(s) didn't match Pod's node affinity/selector. preemption: not eligible due to preemptionPolicy=Never.Sayıları topla: 1 + 2 = 3, her node bir kez sayılır. İki node nodeSelector'a uymuyor (pool'un dışında), tek uygun node'da CPU yetmiyor. Preemption kısmı bu pod'un hiç denemediğini söylüyor. Pool'a nodeSelector'la gidip toleration'ı unutan bir pod ise şunu aldı:
0/3 nodes are available: 1 node(s) had untolerated taint(s), 2 node(s) didn't match Pod's node affinity/selector. preemption: 0/3 nodes are available: 3 Preemption is not helpful for scheduling."Preemption is not helpful": hangi pod'u çıkarırsan çıkar, taint ve selector değişmeyecek. "No preemption victims found" ise preemption'ın işe yarayabileceği ama uygun kurbanın (daha düşük öncelikli pod) bulunamadığı durum. Kubernetes 1.37'de mesaj taint'in adını yazmıyor; hangi taint olduğunu kubectl get nodes -o custom-columns=NAME:.metadata.name,TAINTS:.spec.taints ile kendin bulursun. Aynı mesaj pod'un PodScheduled condition'ında da duruyor, event'ler silindikten sonra da okunabiliyor.
Üretimde Dikkat
Zone'a yayma kararını bölgedeki zone sayısına ve replica sayısına göre ver. Üç zone'a 2 replica yayamazsın; HPA'nın en az replica sayısını zone sayısının katı tutmak dağılımı tahmin edilebilir yapar. Zone için DoNotSchedule kullanıyorsan nodeTaintsPolicy: Honor ve matchLabelKeys: [pod-template-hash] ekle; ikisi olmadan cordon, drain ve rollout'lar beklenmedik Pending'ler üretiyor. Zone kaybında kapasiteyi de hesapla: üç zone'dan biri giderse kalan ikisi yükün tamamını taşıyabiliyor mu? Taşıyamıyorsa yayma kuralının Pending bıraktığı pod'lar sorunun yalnız görünen kısmı.
PriorityClass'ı cluster genelinde birkaç sınıfla sınırla ve kimin hangi sınıfı kullanabileceğini ResourceQuota ile kısıtla; herkesin en yüksek önceliği seçebildiği bir cluster'da öncelik anlamını yitirir. Ayrılmış pool'larda DaemonSet'lerin toleration'larını kontrol et. Pending pod sayısını bir metrik olarak izle (Observability serisindeki alert'ler gibi); scheduler hataları sessizdir.
Sık Düşülen Tuzaklar
En pahalısı, zorunlu anti-affinity ile PDB'nin birlikte bir node bakımını kilitlemesi. API'de hostname anti-affinity ve maxUnavailable: 1'lik bir PDB vardı; iki node'u sırayla drain ettim:
$ kubectl drain k8sseries-lab-worker2 --ignore-daemonsets
node/k8sseries-lab-worker2 cordoned
Warning: ignoring DaemonSet-managed Pods: kube-system/kindnet-2hhjh, kube-system/kube-proxy-lwdq6
evicting pod bookstore/api-6d44f5-rqk4f
pod/api-6d44f5-rqk4f evicted
node/k8sseries-lab-worker2 drained
$ kubectl -n bookstore get pdb api
NAME   MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS   AGE
api    N/A             1                 0                     53s
$ kubectl drain k8sseries-lab-worker --ignore-daemonsets --timeout=30s
node/k8sseries-lab-worker cordoned
Warning: ignoring DaemonSet-managed Pods: kube-system/kindnet-gr2f8, kube-system/kube-proxy-bbllj
evicting pod bookstore/api-6d44f5-nsrh9
error when evicting pods/"api-6d44f5-nsrh9" -n "bookstore" (will retry after 5s): Cannot evict pod as it would violate the pod's disruption budget.
...
error: unable to drain node "k8sseries-lab-worker" due to error: error when evicting pods/"api-6d44f5-nsrh9" -n "bookstore": global timeout reached: 30s, continuing command...
İlk drain'den çıkarılan pod'un yerine açılan pod hiçbir yere sığmadı (diğer iki node'da zaten api var, worker2 cordon'lu) ve Pending kaldı. PDB bu yüzden bir pod'u zaten "kayıp" sayıyor, izin verilen kesinti 0. İkinci node'un bakımı, anti-affinity yüzünden asla ayağa kalkamayacak bir pod'u bekliyor. Managed cluster'ın node upgrade'i tam olarak böyle takılır. Çıkış: hostname için zorunlu anti-affinity yerine topology spread, ya da node sayısından az replica.
Diğerleri: preferred affinity'yi dağılım garantisi sanmak (altı pod'un altısı zone-a'da). Toleration'ı nodeSelector'sız bırakıp worker'ların API node'larına taşmasını beklememek. NoSchedule taint'inin çalışan pod'ları çıkaracağını sanmak. Topology spread'in labelSelector'ını pod'un kendi label'larıyla eşleşmeyecek şekilde yazmak; doküman bu pod'ların hesabı bozduğunu açıkça söylüyor. spec.nodeName'i elle yazıp scheduler'ı tamamen atlamak; o zaman taint'ler de, request kontrolünün bir kısmı da devre dışı kalır.
Küçük Bir Deneme
★☆☆ Kendi cluster'ında kubectl get nodes -L topology.kubernetes.io/zone ile zone'ları listele ve Bookstore API'sinin pod'larının hangi zone'lara dağıldığını -o custom-columns ile çıkar. Bir zone'da birden fazla pod var mı?
★★☆ Bu yazıdaki zone spread kuralını nodeTaintsPolicy olmadan uygula, bir node'u cordon'la ve rollout başlat. Pending mesajını parça parça oku, sonra Honor ekleyip farkı gör. Aynı denemeyi whenUnsatisfiable: ScheduleAnyway ile tekrarla.
★★★ Worker pool'una bookstore-batch sınıfında rapor pod'ları doldur ve bookstore-critical bir pod açarak preemption'ı tetikle. Rapor pod'larına bir PDB ekle (minAvailable tüm replica'lar) ve scheduler'ın PDB'yi ihlal edip etmediğini event'lerden kontrol et.
Bu yazıda kubectl'i çoğunlukla -o custom-columns, events --for ve --field-selector ile kullandık. Bir sonraki yazıda bunları ve daha fazlasını toplu hâlde ele alıyoruz: output format'ları, jsonpath, patch türleri, server-side apply, k9s, stern ve krew ile kubectl'i günlük işte verimli kullanmak.