

Resource Request ve Limit'ler: QoS, OOMKilled, CPU Throttling ve Container'da .NET GC

Request scheduler'a ayrılacak yeri, limit kernel'e aşılamayacak sınırı söyler; bellek limit'i aşan process OOMKilled olur, CPU limit'ine çarpan throttle edilir. 500m limit'te .NET'in ProcessorCount'u 1'e inip Server GC'yi kapatmasını, heap limit'in limit'in yüzde 75'i olmasını, managed bellekte OutOfMemoryException ile native bellekte OOMKilled farkını, GCHeapHardLimitPercent'in hex tuzağını, throttling'i ve quota'yı gerçek çıktılarla görüyoruz.
Sürüm notu: Bu yazıdaki örnekler kind 0.33 ile Kubernetes 1.37 (cgroup v2), kubectl 1.37 ve .NET 10 (runtime 10.0.14) ile denenmiştir.
Önce Tahmin Et
Bookstore API'sinin (Application Programming Interface) pod'una limits.memory: 256Mi ve limits.cpu: 500m veriyorsun. Pod 10 çekirdekli bir node'da çalışıyor. Environment.ProcessorCount kaç döner, ASP.NET Core'un varsayılanı olan Server GC (Garbage Collector) açık mı kalır? Uygulama managed bellekte sürekli büyüyen bir liste tutarsa ne olur: pod OOMKilled ile mi ölür, yoksa başka bir şey mi? Son soru: GC heap limit'ini yüzde 50'ye çekmek için DOTNET_GCHeapHardLimitPercent=50 yazıyorsun. Gerçekte yüzde kaç olur?
Request ve Limit: İki Farklı Sözleşme
      resources:
        requests:
          cpu: 250m
          memory: 128Mi
        limits:
          cpu: 500m
          memory: 256Mi
Bu dört satır iki ayrı şey söylüyor. Request, scheduler ile yapılan bir sözleşme: "bu pod'a en az bu kadar yer ayır". Scheduler pod'u yalnız request'lerinin toplamı node'un allocatable kapasitesine sığan node'lara yerleştirir; node'daki gerçek kullanıma bakmaz. Limit ise kernel ile yapılan bir sözleşme: container'ın cgroup'una yazılır ve aşılamaz. 250m çeyrek çekirdek, Mi mebibyte demek.
İki kaynak limit'e farklı tepki verir. CPU (Central Processing Unit) sıkıştırılabilir bir kaynak: limit'e ulaşan container öldürülmez, yavaşlatılır (throttle edilir). Bellek sıkıştırılamaz: limit'i aşan process kernel'in OOM (Out Of Memory) killer'ı tarafından öldürülür. Bu farkı yazının ortasında iki ayrı deneyle göreceğiz.
QoS Class'ları: Kim Önce Gider?
Kubernetes request ve limit'lere bakarak her pod'a bir QoS (Quality of Service) class'ı atar. Dört pod yarattım: biri hiç resource'suz, biri request'i limit'inden küçük, biri request'i limit'ine eşit, sonuncusu birazdan göreceğimiz hex tuzağı için.
res-besteffort qos=BestEffort {"processorCount":10,"isServerGC":true,"totalAvailableMemoryMB":7836,"heapSizeMB":0,"gcHeapHardLimitMB":0,"workingSetMB":68}
res-burstable qos=Burstable {"processorCount":1,"isServerGC":false,"totalAvailableMemoryMB":192,"heapSizeMB":0,"gcHeapHardLimitMB":0,"workingSetMB":66}
res-guaranteed qos=Guaranteed {"processorCount":1,"isServerGC":false,"totalAvailableMemoryMB":192,"heapSizeMB":0,"gcHeapHardLimitMB":0,"workingSetMB":67}
res-hexpercent qos=Burstable {"processorCount":1,"isServerGC":false,"totalAvailableMemoryMB":204,"heapSizeMB":0,"gcHeapHardLimitMB":0,"workingSetMB":66}
Her satırda pod'un QoS class'ı ve API'nin /api/diag/runtime endpoint'inin cevabı var. Kurallar basit: hiçbir container'da request ya da limit yoksa BestEffort; bütün container'larda CPU ve bellek için request limit'e eşitse Guaranteed; arası Burstable. Class'ın pratik anlamı, node'un belleği daraldığında ortaya çıkar. kubelet eviction'da ve kernel OOM killer'ı seçim yaparken önce BestEffort, sonra request'inin üstünde bellek kullanan Burstable pod'lar gider; Guaranteed pod'lar en son. Bunu yedinci yazıda istemeden yaşadım: yük altındaki lokal cluster'da request'siz API pod'ları, kendi limit'leri olmadığı hâlde OOMKilled ile yeniden başladı.
.NET Container'ı Nasıl Görüyor?
Yukarıdaki çıktının asıl ilginç kısmı .NET runtime'ının sayıları. Resource'suz pod node'un bütün 10 çekirdeğini ve 7836 MB belleğini kendisininmiş gibi görüyor ve Server GC ile çalışıyor. Limit verilen pod'larda tablo tamamen değişiyor:
processorCount 1. .NET, cgroup'taki CPU quota'sını okuyup Environment.ProcessorCount'u ona göre ayarlıyor; 500m yukarı yuvarlanınca 1 çekirdek. Thread pool boyutu, Server GC heap sayısı ve paralel işlemler bu sayıya göre şekilleniyor. Ayrıca kontrol için 1500m limit'li bir pod açtım: processorCount 2 ve Server GC açık. Gerekirse DOTNET_PROCESSOR_COUNT environment variable'ıyla bu sayıyı elle verebilirsin.
isServerGC false. ASP.NET Core projeleri varsayılan olarak Server GC kullanır, ama runtime tek işlemcili bir ortamda Server GC yerine Workstation GC'ye düşüyor. 500m limit'li bir API pod'u, Dockerfile'da ya da csproj'da hiçbir şey değiştirmediğin hâlde farklı bir GC ile çalışıyor; benchmark'ları laptop'ta değil gerçek limit'lerle yap.
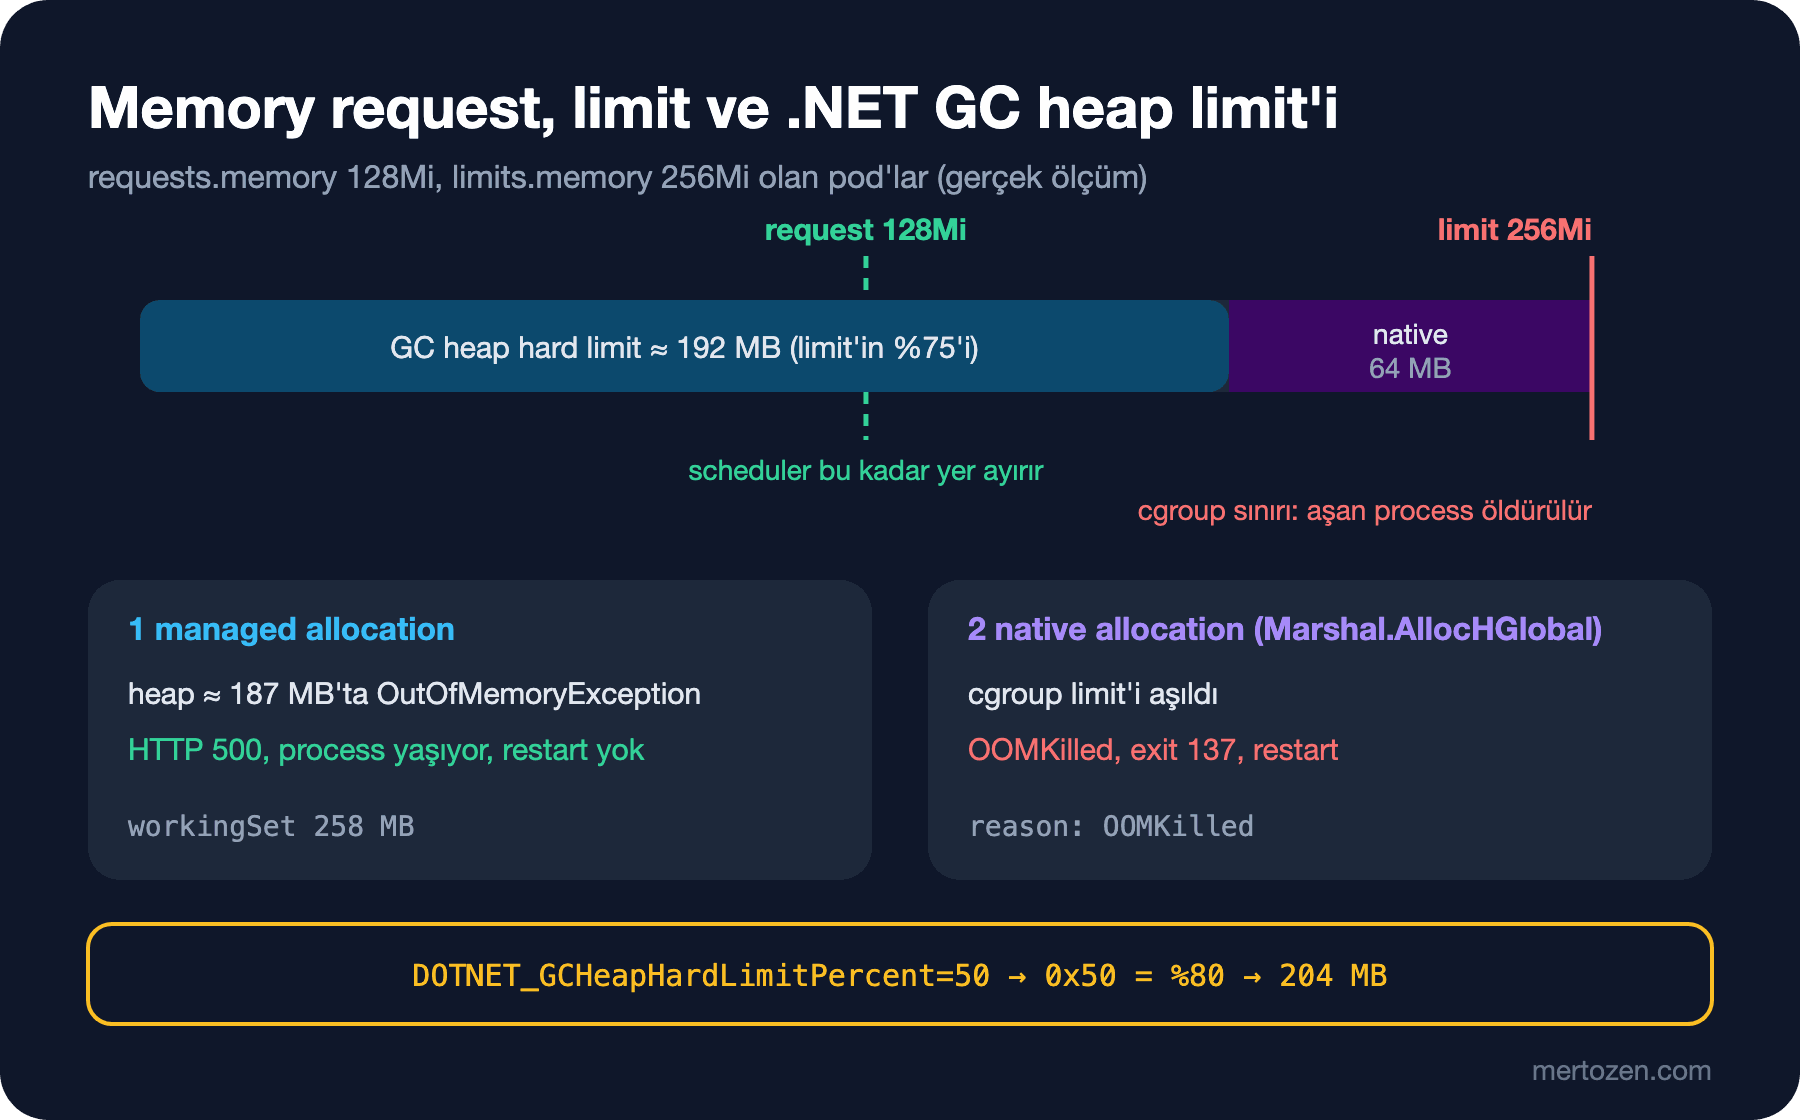
totalAvailableMemoryMB 192. Microsoft'un GC dokümantasyonuna göre container gibi bellek sınırı olan bir ortamda bu sınır "fiziksel bellek" sayılır ve heap hard limit için ayrıca bir ayar yoksa varsayılan, limit'in yüzde 75'i ile 20 MB'tan büyük olanıdır. 256Mi'nin yüzde 75'i 192 MB. Kalan 64 MB native bellek, thread stack'leri, JIT (Just-In-Time) derleyici ve runtime'ın kendisi için. (Çıktıdaki gcHeapHardLimitMB sıfır, çünkü o değer yalnız limit açıkça ayarlandığında dolu; etkin limiti GC.GetGCMemoryInfo().TotalAvailableMemoryBytes gösteriyor.)
.NET 9 ile Server GC için varsayılan olarak açılan DATAS (Dynamic Adaptation To Application Sizes) da konteyner dostu bir değişiklik: Server GC artık bütün çekirdekler için baştan heap açmak yerine tek heap'le başlayıp yüke göre ölçekleniyor, böylece aynı node'daki Server GC'li pod'ların boşta bellek tüketimi düşüyor. Kapatmak için DOTNET_GCDynamicAdaptationMode=0.
Limit'e Çarpmanın İki Yolu: OutOfMemoryException ve OOMKilled
Baştaki ikinci soru. res-burstable pod'unda managed bellek ayırıp tutan endpoint'i çağırdım:
$ kubectl exec client -- wget -S -qO- --post-data= "http://$ip:8080/api/diag/alloc-managed?mb=100"
  HTTP/1.1 200 OK
{"heldMB":100}
$ kubectl exec client -- wget -S -qO- --post-data= "http://$ip:8080/api/diag/alloc-managed?mb=150"
  HTTP/1.1 500 Internal Server Error
$ kubectl logs res-burstable | grep -i outofmemory
04:48:55.429 fail: Microsoft.AspNetCore.Server.Kestrel[13] Connection id "0HNPTAE88S79C", Request id "0HNPTAE88S79C:00000001": An unhandled exception was thrown by the application. System.OutOfMemoryException: Exception of type 'System.OutOfMemoryException' was thrown.
$ kubectl exec client -- wget -qO- http://$ip:8080/api/diag/runtime
{"processorCount":1,"isServerGC":false,"totalAvailableMemoryMB":192,"heapSizeMB":187,"gcHeapHardLimitMB":0,"workingSetMB":258}
$ kubectl get pod res-burstable
NAME            READY   STATUS    RESTARTS
res-burstable   1/1     Running   0
Pod ölmedi. GC heap 187 MB'ta, 192 MB'lık hard limit'e dayandığında GC yeni bellek istemek yerine OutOfMemoryException fırlattı; istek 500 döndü, process ayakta kaldı, restart yok. Heap hard limit'in amacı tam olarak bu: .NET'in kendi heap'ini cgroup limit'inin altında tutup OOM killer'a yakalanmadan önce uygulamaya kontrollü bir hata vermek. Ama dikkat: working set 258 MB, yani limit'e çok yakın; process artık her an öldürülebilir ve tuttuğu bellek hiç serbest kalmayacak. Liveness bunu görmez, çünkü /health/live hâlâ 200 dönüyor.
Şimdi aynı limit'li res-guaranteed pod'unda GC'nin görmediği native bellek ayırdım (Marshal.AllocHGlobal, 300 MB):
$ kubectl exec client -- wget -T 10 -qO- --post-data= "http://$ip:8080/api/diag/alloc-native?mb=300"
wget: error getting response
$ kubectl get pod res-guaranteed
NAME             READY   STATUS    RESTARTS
res-guaranteed   1/1     Running   1 (5s ago)
$ kubectl describe pod res-guaranteed
    Last State:     Terminated
      Reason:       OOMKilled
      Exit Code:    137
Bu sefer process cgroup limit'ini aştı ve kernel onu SIGKILL (kill signal) ile öldürdü: exit code 137 (128 + 9), reason OOMKilled. .NET'in hiçbir exception'ı, hiçbir log satırı yok; process bir anda yok oldu ve kubelet yeniden başlattı. Gerçek hayatta native bellek; büyük buffer'lar, unmanaged kütüphaneler (görüntü işleme, sıkıştırma), thread'ler ve memory-mapped dosyalarla büyür. OOMKilled gördüğünde sorulacak ilk soru "heap mi, native mi?": heap büyüyorsa OutOfMemoryException beklenirdi, ani ölüm genellikle native tarafa ya da limit'in heap limit'e göre çok dar olmasına işaret eder.
GCHeapHardLimitPercent'in Hex Tuzağı
Dördüncü pod'da tek fark DOTNET_GCHeapHardLimitPercent=50 environment variable'ıydı ve totalAvailableMemoryMB 192 yerine 204 çıktı. 204, 256'nın yüzde 80'i. Neden: GC dokümantasyonu, sayısal GC ayarlarının runtimeconfig.json'da decimal, environment variable'da ise hexadecimal yazıldığını söylüyor; 0x önekli ya da öneksiz. Environment variable'daki 50, 0x50 yani 80 olarak okundu. Yüzde 50 için doğru değer 0x32 (ya da 32). Daha okunur bir yol bu ayarları environment variable yerine csproj'da RuntimeHostConfigurationOption ile ya da runtimeconfig.template.json'da decimal olarak vermek. Aynı tuzak DOTNET_GCHeapHardLimit, DOTNET_GCHeapCount ve diğer sayısal GC ayarlarında da geçerli; DOTNET_gcServer=1 gibi 0/1 değerlerde fark etmez.
CPU Limit ve Throttling
CPU tarafında öldürme yok, yavaşlama var. API'de 5 saniye boyunca tek bir thread'de CPU yakan bir endpoint var; aynı isteği limit'siz pod'a ve limits.cpu: 200m olan pod'a attım:
res-besteffort {"seconds":5,"elapsedMs":5000,"iterations":205092352}
res-cpu200 {"seconds":5,"elapsedMs":5000,"iterations":39369482}
$ kubectl debug res-cpu200 --image=busybox:1.37 --target=api --profile=general -q -- cat /proc/1/root/sys/fs/cgroup/cpu.stat /proc/1/root/sys/fs/cgroup/cpu.max
usage_usec 1192108
nr_periods 65
nr_throttled 34
throttled_usec 956734
20000 100000
İki istek de 5 saniye sürdü, ama limit'li pod aynı sürede beşte bir iş yaptı (39 milyon döngü, 205 milyona karşı). cpu.max satırı limit'in kernel'deki karşılığı: her 100.000 mikrosaniyelik (100 ms) periyotta en fazla 20.000 mikrosaniye CPU. Quota bitince process periyodun sonuna kadar bekletilir; nr_throttled ve throttled_usec bu beklemelerin sayısı ve toplamı. Bir web API için bunun anlamı: istek CPU'yu tükettiği anda kalan 80 ms'yi bekler. Çok thread'li bir .NET uygulamasında quota daha da hızlı biter, çünkü 200m beş thread'in aynı anda 4 ms'de harcayabileceği bir bütçe. Sonuç, ortalama CPU kullanımı düşükken yükselen p99 (99th percentile) latency'si.
CPU limit'i konusunda sektörde iki görüş var. Birincisi CPU limit'i hiç koymamak, yalnız request vermek: request, çekişme anında CPU paylarını zaten orantılı dağıtır ve boş CPU'yu kullanmak serbest kalır; bedeli, bir pod'un davranışının node'daki komşularına göre değişmesi, yani daha az öngörülebilir performans. İkincisi limit'i request'in biraz üstünde tutmak: öngörülebilir ama throttling riskli. Bookstore API'si gibi gecikmeye duyarlı servisler için genel eğilim bellek limit'ini koymak, CPU limit'ini ya hiç koymamak ya da cömert tutmak. Hangi yolu seçersen seç, nr_throttled'ı izle.
LimitRange ve ResourceQuota
Her ekibin her pod'a doğru resource yazacağına güvenmek yerine namespace düzeyinde varsayılan ve sınır koyabilirsin:
apiVersion: v1
kind: LimitRange
metadata:
  name: defaults
  namespace: bookstore-dev
spec:
  limits:
    - type: Container
      defaultRequest:
        cpu: 100m
        memory: 128Mi
      default:
        memory: 256Mi
---
apiVersion: v1
kind: ResourceQuota
metadata:
  name: team-quota
  namespace: bookstore-dev
spec:
  hard:
    requests.cpu: "1"
    requests.memory: 1Gi
    limits.memory: 2Gi
    pods: "10"
$ kubectl create deployment api --image=bookstore-api:1.0.0 --replicas=2 -n bookstore-dev
$ kubectl get pod -n bookstore-dev -o jsonpath='{.items[0].spec.containers[0].resources}'
{"limits":{"memory":"256Mi"},"requests":{"cpu":"100m","memory":"128Mi"}}
$ kubectl scale deploy/api -n bookstore-dev --replicas=12
$ kubectl get deploy api -n bookstore-dev
NAME READY UP-TO-DATE AVAILABLE AGE
api 8/12 8 8 11s
$ kubectl describe resourcequota team-quota -n bookstore-dev
Resource Used Hard
-------- ---- ----
limits.memory 2Gi 2Gi
pods 8 10
requests.cpu 800m 1
requests.memory 1Gi 1GiResource yazılmadan yaratılan pod'lar LimitRange'in varsayılanlarını aldı. Quota'da önce bellek doldu: 8 pod × 256Mi = 2Gi. Kalan dört pod yaratılamadı ve ReplicaSet'in event'inde exceeded quota: team-quota hatası göründü. Dikkat: quota'ya takılan bir Deployment "hata" vermez, yalnız 8/12'de kalır; bunu fark etmenin yolu event'lere ve rollout status'una bakmak.
Üretimde Dikkat
Değerleri tahminle değil ölçümle koy. Uygulamayı gerçekçi yük altında çalıştırıp dotnet-counters ile GC heap boyutunu, working set'i, GC pause sürelerini ve thread pool'u izle (ayrıntısı ilerideki Profiling serisinde); memory request'i tipik working set'e, limit'i tepe değerin rahatça üstüne koy. Heap hard limit'in limit'in yüzde 75'i olduğunu unutma: heap'in 300 MB'a ihtiyacı varsa limit en az 400 MB olmalı.
Request'siz pod bırakma. BestEffort pod'lar node'da bellek daralınca ilk gidenlerdir ve scheduler onları yerleştirirken hiçbir kapasite hesabı yapmaz. 11. yazıda göreceğimiz HPA (Horizontal Pod Autoscaler) da yüzdeleri request'e göre hesapladığı için request'siz pod'larla çalışamaz.
CPU limit'i verdiğinde .NET'in davranışının değiştiğini hatırla: ProcessorCount, GC türü ve thread pool. Tek çekirdeğin altındaki limit'ler Server GC'yi kapatır; bu bilinçli bir seçim olmalı.
Sık Düşülen Tuzaklar
OOMKilled'ı "bellek sızıntısı" sanmak. Bazen öyledir; ama çoğu zaman limit, heap'in ve native kullanımın gerçek ihtiyacından küçüktür. Önce heap mi native mi ayrımını yap.
Hex değerleri decimal yazmak. DOTNET_GCHeapHardLimitPercent=50 yüzde 80 demek; yukarıda ölçtük.
Request'i limit'e çok yakın ya da çok uzak koymak. Request çok düşükse scheduler node'ları aşırı doldurur ve gerçek kullanım limit'lere ulaştığında herkes aynı anda sıkışır; çok yüksekse cluster boş kapasiteyle dolu ama yeni pod sığmaz.
Milicore ile çekirdeği karıştırmak. cpu: 1 bir çekirdek, cpu: 1m bir çekirdeğin binde biri. Benzer şekilde memory: 128M (megabyte) ile 128Mi (mebibyte) farklı sayılar.
Küçük Bir Deneme
★☆☆ limits.memory: 512Mi olan bir pod aç ve /api/diag/runtime'daki totalAvailableMemoryMB'ın 384 olduğunu doğrula. Sonra DOTNET_GCHeapHardLimitPercent=0x32 ile tekrar dene.
★★☆ Aynı pod'a önce limits.cpu: 900m, sonra 1100m ver; processorCount ve isServerGC değerlerinin nasıl değiştiğini tabloya dök. DOTNET_PROCESSOR_COUNT=4 ekleyince ne oluyor?
★★★ /api/diag/burn?seconds=10'u aynı anda 4 istekle çağır: önce limits.cpu: 1 ile, sonra CPU limit'siz ama requests.cpu: 1 ile. Her iki durumda cpu.stat'taki nr_throttled ve isteklerin süresini karşılaştır ve kendi API'n için CPU limit'i kararını gerekçesiyle yaz.
Pod'larımız artık doğru boyutta ve doğru sinyallerle çalışıyor. Geriye son bir hassas an kalıyor: pod'un ölümü. Bir sonraki yazıda bir pod silinirken gerçekte ne olduğunu, endpoint'ten çıkarılma ile SIGTERM'ün (termination signal) yarışını, preStop sleep action'ını ve .NET'in HostOptions.ShutdownTimeout'unu gerçek bir yük altında ölçüyoruz.