

Kubernetes'te Debugging: CrashLoopBackOff, ImagePullBackOff, Pending ve kubectl debug

Pod hatalarında sıra hep aynıdır: get ile belirtiyi, describe ile event'leri, logs --previous ile uygulamanın sesini oku, gerekirse kubectl debug ile shell'siz pod'a ephemeral container sok. Pending, ImagePullBackOff, CrashLoopBackOff, OOMKilled ve port uyuşmazlığını, PID 1 olarak asılı kalan .NET process'ini ve limite yakın pod'da dotnet-dump'ın pod'u nasıl öldürdüğünü gerçek çıktılarla görüyoruz.
Sürüm notu: Bu yazıdaki örnekler kind 0.33 ile Kubernetes 1.37, kubectl 1.37, .NET 10 ve dotnet-counters/dotnet-dump 10.0.750501 ile denenmiştir.
Önce Tahmin Et
Production'da Bookstore API'sinin (Application Programming Interface) bir pod'u bellek sızdırıyor gibi görünüyor: working set 160 MB, memory limiti 256Mi. Neyin yer kapladığını görmek için pod'a bir debug container ekleyip dotnet-dump collect ile full dump alıyorsun. Pod'a ne olur? Dump alınır ve teşhis biter mi, yoksa teşhis etmeye çalıştığın pod'u kendi elinle mi öldürürsün? Bu yazının sonunda gerçek çıktıyla cevaplıyoruz; o noktaya gelene kadar da pod'un hiç başlamadığı, sürekli çöktüğü ve çalıştığı halde trafik almadığı durumları sırayla teşhis ediyoruz.
Triage Akışı: get, describe, logs, debug
Kubernetes'te hata ayıklamanın sırası neredeyse hiç değişmez. kubectl get pods belirtiyi verir: STATUS ve READY sütunları. kubectl describe pod en alttaki Events bölümüyle scheduler'ın, kubelet'in ve probe'ların ne dediğini gösterir. kubectl logs (çökmüş container için --previous) uygulamanın kendi sesidir. Bunlar yetmezse kubectl port-forward ile pod'a doğrudan istek atar, kubectl debug ile pod'un içine bir araç kutusu sokarsın. STATUS sütunu hangi adımda zaman harcayacağını söyler:
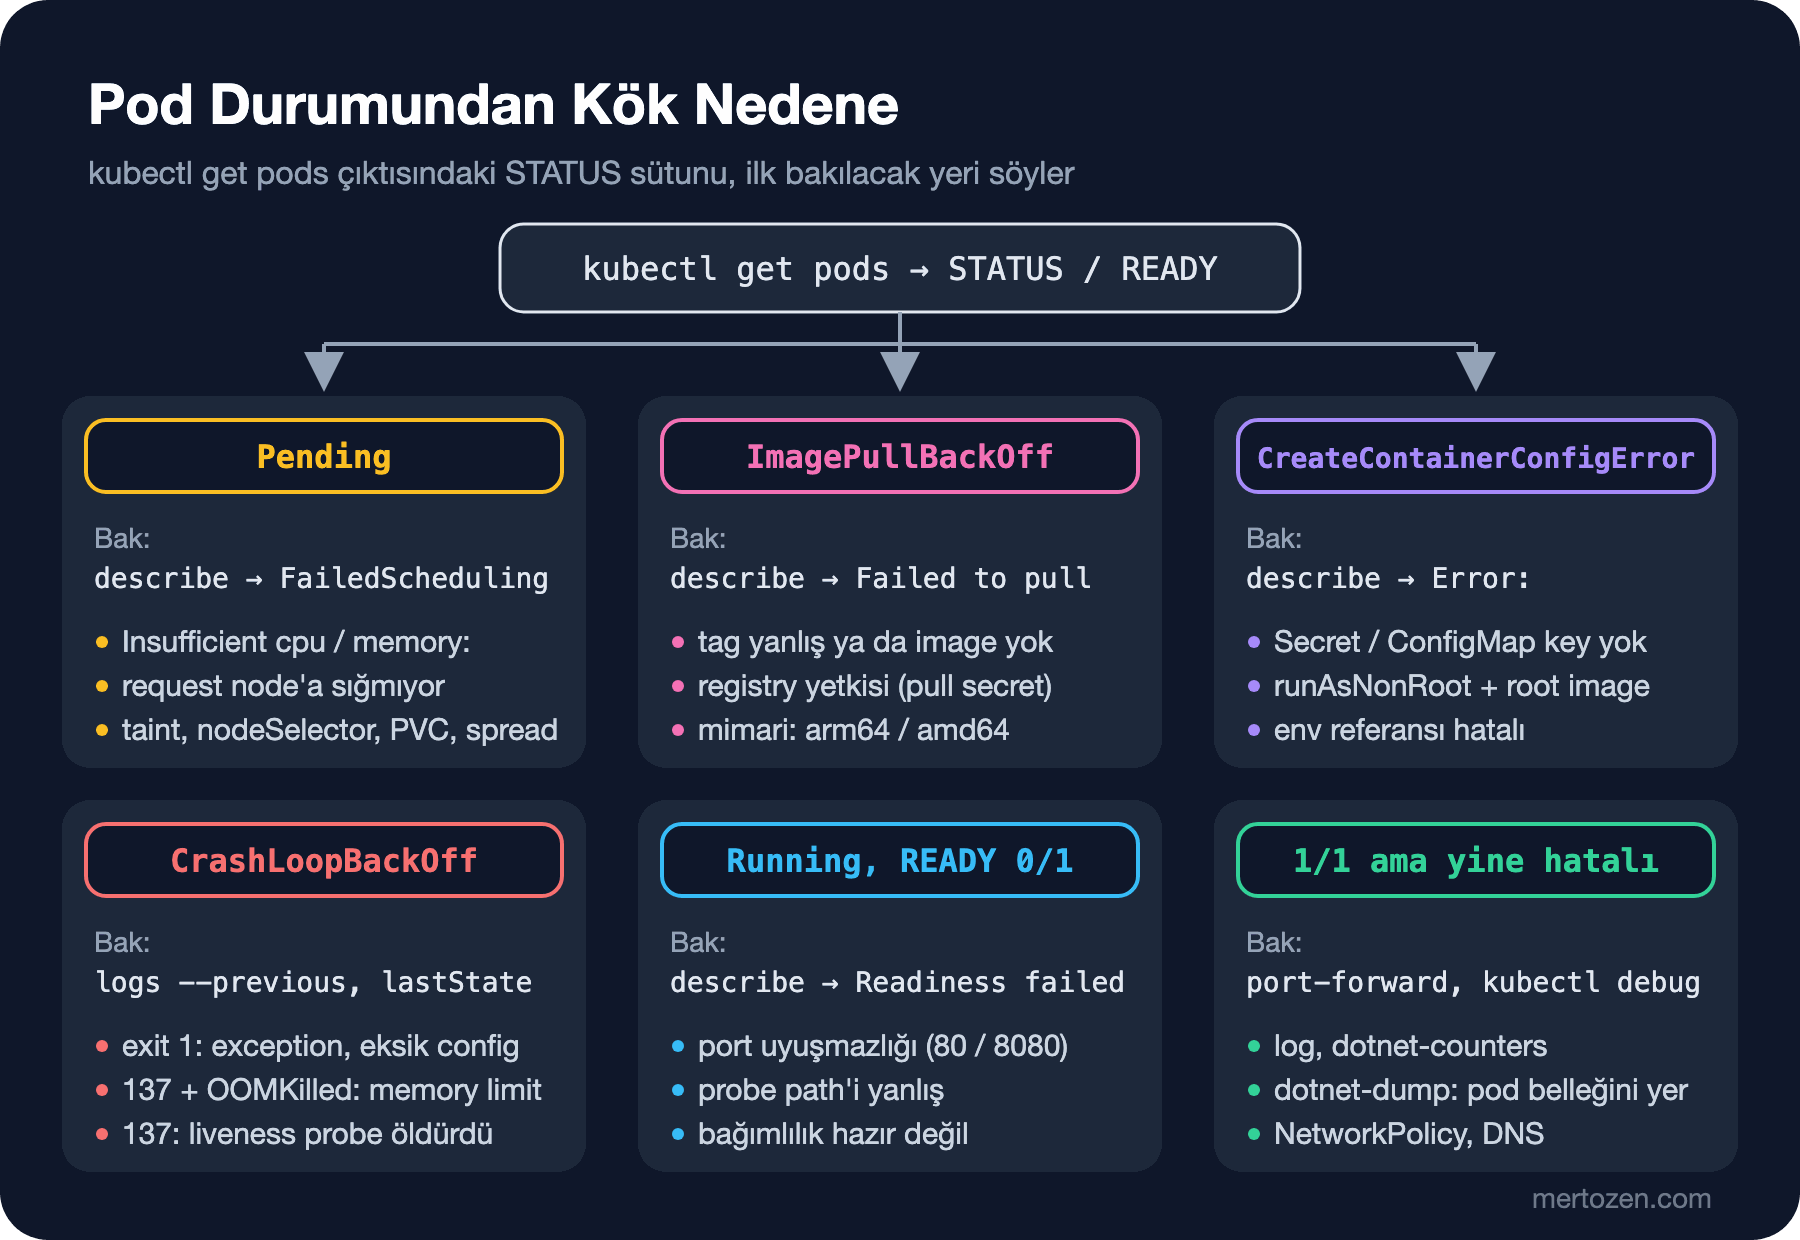
Bu yazı için bir namespace'e bilerek beş bozuk Deployment koyduk. Bir dakika sonra:
NAME                           READY   STATUS             RESTARTS      AGE
api-crash-7b5c79dd4b-8xb5v     0/1     CrashLoopBackOff   3 (18s ago)   60s
api-oom-5676979fb9-crg8v       1/1     Running            0             60s
api-pending-6b7fc577b8-zrkv8   0/1     Pending            0             60s
api-port-775dbc57cc-9ftrg      0/1     Running            3 (15s ago)   60s
api-typo-d6575f7d7-bcd2h       0/1     ImagePullBackOff   0             60s
İkisi sinsi. api-oom şu an sağlıklı görünüyor; sorunu yük gelince çıkacak. api-port ise Running ama 0/1 ve restart sayısı artıyor: STATUS sütunu tek başına yanıltıcı, READY ve RESTARTS ile birlikte okunmalı.
Pod Hiç Başlamıyorsa: Pending ve ImagePullBackOff
Pending, pod'un henüz bir node'a yerleştirilemediği anlamına gelir. Sebebi her zaman scheduler'ın event'inde yazar:
Warning FailedScheduling 68s default-scheduler 0/3 nodes are available: 1 node(s) had untolerated taint(s), 2 Insufficient cpu. preemption: 0/3 nodes are available: 3 Preemption is not helpful for scheduling.Mesajı node node oku: üç node'dan biri taint'li (control-plane), ikisinde CPU (Central Processing Unit) yetersiz. Bizim pod 16 çekirdek istiyordu. Önemli olan şu: scheduler kullanıma değil request'lere bakar. Node'lar boşta dursa bile request'lerin toplamı allocatable'ı aşıyorsa yeni pod yerleşmez; serinin dokuzuncu yazısında request'leri ölçerek seçmenin sebebi buydu. Diğer tipik Pending mesajları: bağlanamayan bir PVC (PersistentVolumeClaim), uyuşmayan nodeSelector/affinity ve on birinci yazıda gördüğümüz topology spread kısıtı. Cluster autoscaler varsa Pending pod yeni node açılmasını tetikler; bu durumda birkaç dakikalık bekleme normaldir.
ImagePullBackOff, kubelet'in image'ı çekemediği ve artan aralıklarla yeniden denediği anlamına gelir:
Normal   Pulling    24s (x3 over 68s)  kubelet  spec.containers{api}: Pulling image "bookstore-api:1.2.1"
Warning  Failed     23s (x3 over 67s)  kubelet  spec.containers{api}: Failed to pull image "bookstore-api:1.2.1": failed to pull and unpack image "docker.io/library/bookstore-api:1.2.1": failed to resolve reference "docker.io/library/bookstore-api:1.2.1": pull access denied, repository does not exist or may require authorization: server message: insufficient_scope: authorization failed
Warning  Failed     23s (x3 over 67s)  kubelet  spec.containers{api}: Error: ErrImagePull
Warning  Failed     8s (x3 over 66s)   kubelet  spec.containers{api}: Error: ImagePullBackOff
Tag'de bir harf hatası var (1.2.1, olması gereken 1.2.0), ama mesaj "authorization failed" diyor: registry, olmayan bir repository ile yetkin olmayan bir repository'yi çoğu zaman aynı cevapla geçiştirir. Registry adı yazılmamış bir image'ın docker.io/library/ önekiyle Docker Hub'da arandığına da dikkat et. Kontrol sırası: image adı ve tag gerçekten var mı, registry adresi doğru mu, imagePullSecrets veya node'un registry yetkisi tanımlı mı, image node'un mimarisi için (arm64/amd64) build edilmiş mi. Mimari uyuşmazlığı ise ya çekme sırasında platformla eşleşen manifest bulunamaması olarak ya da container başlarken exec format error olarak görünür.
CrashLoopBackOff ve OOMKilled: Container Başlıyor, Sonra Ölüyor
CrashLoopBackOff bir hata değil, kubelet'in bekleme durumudur: container çıktı, kubelet onu 10 saniyeden başlayıp beş dakikaya kadar katlanan aralıklarla yeniden başlatıyor. Çöken container'ın log'u yeni container'ın log'u değildir; --previous şart:
$ kubectl -n bookstore-dbg logs deploy/api-crash --previous
04:35:40.712 info: Bookstore.Api[0] Bookstore.Api 1.2.0 starting on api-crash-7b5c79dd4b-8xb5v: cpus=10 serverGC=True gcHeapLimitMB=192
04:35:40.714 crit: Bookstore.Api[0] Startup:FailFast is true, exiting with code 1
Log boşsa ya da yetmiyorsa container'ın son durumuna bak; exit code ve reason çoğu zaman yeterli ipucudur:
{"terminated":{"containerID":"containerd://5603bb4c...","exitCode":1,"finishedAt":"2026-11-08T04:35:40Z","reason":"Error","startedAt":"2026-11-08T04:35:40Z"}}Exit code'u doğru okumak yarı yolu katetmektir. 1, uygulamanın kendi kararıyla çıkmasıdır: bizim FailFast kontrolümüz ya da Main'in 1 döndürmesi gibi. Yakalanmamış bir exception ise .NET'te process'i abort eder. Tek satırı throw new InvalidOperationException(...) olan bir console uygulamasıyla denedik: docker run --init ile, yani .NET process'i PID (Process ID) 1 değilken, exit code 134 (128 + SIGABRT (abort sinyali)) geldi. Aynı image'ı kind'da pod olarak çalıştırınca tablo bambaşkaydı:
$ kubectl -n bookstore-dbg logs throwtest
Unhandled exception. System.InvalidOperationException: ConnectionStrings:Default is missing
$ kubectl -n bookstore-dbg get pod throwtest
NAME        READY   STATUS    RESTARTS   AGE
throwtest   1/1     Running   0          25s
$ kubectl -n bookstore-dbg top pod throwtest
NAME        CPU(cores)   MEMORY(bytes)
throwtest   1000m        23Mi
Process çıkmadı; bir çekirdeği yüzde yüz kullanarak asılı kaldı ve pod Running göründü. Container'da .NET process'i PID 1'dir ve PID 1'e varsayılan davranışlı sinyaller kernel tarafından iletilmez; abort'un gönderdiği SIGABRT etkisiz kaldı. Bunu arm64 node'larda (Apple Silicon üzerinde kind) gördük; x64 node'larda abort'un son çaresi farklı olduğu için sonuç değişebilir, kendi mimarinde dene. Ders mimariden bağımsız: Program.cs'te başlangıç hatalarını yakalayıp log'layan ve 1 döndüren bir try/catch her ortamda deterministik bir çıkış verir; web uygulamasında da liveness probe asılı kalan bir process'i en geç birkaç periyotta öldürür. Eksik bir connection string, ValidateOnStart ile doğrulaması başarısız olan bir options class'ı, okunamayan bir sertifika bu gruba düşer. Exit code 137 ise process'in SIGKILL (Unix'in yakalanamayan öldürme sinyali) ile öldürüldüğünü gösterir ve iki farklı sebebi vardır. Birincisini api-oom'da tetikledik: kubectl port-forward deploy/api-oom 18890:8080 ile lokalden pod'a bağlanıp POST /api/diag/alloc-native?mb=300 çağırdık; istek cevapsız kaldı (curl exit=52) ve:
NAME                       READY   STATUS    RESTARTS     AGE
api-oom-5676979fb9-crg8v   1/1     Running   1 (6s ago)   87s
{"terminated":{"containerID":"containerd://80d8a8fd...","exitCode":137,"finishedAt":"2026-11-08T04:36:19Z","reason":"OOMKilled","startedAt":"2026-11-08T04:34:59Z"}}
reason: OOMKilled: kernel, cgroup memory limitini aşan process'i öldürdü. Pod yeniden ayağa kalktığı için get pods'ta yalnız RESTARTS sütunu değişti; dikkat etmezsen kaçırırsın. Native bellek .NET GC'nin (Garbage Collector) heap limitinin dışında kaldığı için bu bir OutOfMemoryException değil, doğrudan ölüm; ayrım dokuzuncu yazının konusuydu. 137'nin ikinci sebebi liveness probe'un container'ı öldürmesidir; o durumda reason Error olur ve Events'te failed liveness probe, will be restarted yazar. Bir de 139 var: segmentation fault, .NET'te nadir, genelde native bir kütüphaneden gelir.
Running Ama Ready Değil: Port Uyuşmazlığı
api-port'ta ASPNETCORE_HTTP_PORTS=80 ayarlı, Deployment ise container port'u ve probe'ları 8080'e göre yazılmış. Log'a göre uygulama mutlu:
04:35:44.024 info: Microsoft.Hosting.Lifetime[14] Now listening on: http://[::]:80
04:35:58.836 info: Bookstore.Api[0] ApplicationStopping: SIGTERM received, draining
On beş saniye sonra SIGTERM (Unix'in sonlandırma sinyali) geliyor. Sebep Events'te:
Warning  Unhealthy  23s (x16 over 67s)  kubelet  spec.containers{api}: Readiness probe failed: Get "http://10.244.1.32:8080/health/live": dial tcp 10.244.1.32:8080: connect: connection refused
Warning  Unhealthy  23s (x9 over 63s)   kubelet  spec.containers{api}: Liveness probe failed: Get "http://10.244.1.32:8080/health/live": dial tcp 10.244.1.32:8080: connect: connection refused
Normal   Killing    8s (x4 over 53s)    kubelet  spec.containers{api}: Container api failed liveness probe, will be restarted
connection refused, o portta kimsenin dinlemediği anlamına gelir; timeout ise dinleyen var ama cevap vermiyor ya da bir NetworkPolicy engelliyor demektir. Bu ayrım teşhisin yarısıdır. .NET 8'den beri container image'larının varsayılan portu 8080 (ASPNETCORE_HTTP_PORTS); eski bir Dockerfile'dan gelen ASPNETCORE_URLS=http://+:80 ya da yukarıdaki gibi bir env değişkeni bu tuzağın en sık kaynağı. Non-root çalışan uygulamanın 80'e bağlanabilmesi de şaşırtıcı gelebilir: aşağıdaki debug container'ında gördüğümüz gibi container runtime pod'da net.ipv4.ip_unprivileged_port_start'ı 0 yapmış, yani bağlanma hatası almadık ve sorun yalnız probe'larda göründü.
Shell'siz Image'da kubectl debug
Chiseled image'da kubectl exec çalışmaz, çünkü çalıştıracak bir shell yok:
$ kubectl -n bookstore-dbg exec api-port-775dbc57cc-9ftrg -- sh
error: Internal error occurred: ... exec: "sh": executable file not found in $PATH
Bu bir güvenlik özelliği, kusur değil. Çözüm ephemeral container: çalışan pod'a, istediğin araçları içeren geçici bir container eklenir. --target onu hedef container'ın process namespace'ine bağlar:
kubectl -n bookstore-dbg debug api-port-775dbc57cc-9ftrg --image=busybox:1.37 --target=api --profile=general \
  -- sh -c 'ps; echo; cat /proc/sys/net/ipv4/ip_unprivileged_port_start; ls /proc/1/root/app | head -5; netstat -tln'
PID USER TIME COMMAND
1 1654 0:00 dotnet Bookstore.Api.dll
42 root 0:00 sh -c ps; echo; cat /proc/sys/net/ipv4/ip_unprivileged_port_start; ...
52 root 0:00 ps
0
Bookstore.Api
Bookstore.Api.deps.json
Bookstore.Api.dll
Bookstore.Api.pdb
Bookstore.Api.runtimeconfig.json
Active Internet connections (only servers)
Proto Recv-Q Send-Q Local Address Foreign Address State
tcp 0 0 :::80 :::* LISTENBusybox'ın ps'i, .NET process'ini PID (Process ID) 1 olarak görüyor; hedef container'ın dosya sistemine /proc/1/root üzerinden bakabiliyoruz ve netstat 80'de dinlendiğini doğruluyor. Ephemeral container pod spec'ine eklenir ve silinemez; işi bitince durur ama pod yaşadıkça kaydı kalır. Pod'u bozmak istemiyorsan kubectl debug --copy-to ile pod'un bir kopyasını yaratıp orada çalışmak da mümkün.
dotnet-counters ve dotnet-dump'ı Ephemeral Container'dan Almak
.NET'in teşhis araçları process'le /tmp'deki bir Unix domain socket üzerinden konuşur. Ephemeral container hedefin process'lerini görür ama dosya sistemi ayrıdır; araçları içeren bir image'la (SDK'dan (Software Development Kit) dotnet tool install --tool-path /tools ile kurulan dotnet-counters, dotnet-dump ve dotnet-trace, runtime:10.0 üzerine kopyalanmış) doğrudan denediğimizde:
No supported .NET processes were foundÇözüm, uygulamanın /tmp'sini bir emptyDir yapmak (on beşinci yazıda readOnlyRootFilesystem için zaten yapmıştık) ve debug container'ına aynı volume'u, aynı kullanıcıyla mount etmek. kubectl debug --custom bir container spec parçası kabul eder:
{
  "volumeMounts": [
    { "name": "tmp", "mountPath": "/tmp" }
  ],
  "securityContext": {
    "runAsUser": 1654,
    "runAsGroup": 1654
  }
}
$ kubectl -n bookstore-dbg debug api-diag-858db68f59-tgwtn --image=bookstore-diag:1.0.0 --target=api \
--profile=general --custom=debug-profile.json -- dotnet-counters ps
1 dotnet /usr/share/dotnet/dotnet dotnet Bookstore.Api.dllUzun süreli bir oturum için debug container'ını sleep 900 ile açıp içine kubectl exec -c ile girdik, API'ye 60 MB'lık managed allocation yaptırdık ve sayaçları topladık:
$ kubectl -n bookstore-dbg exec api-diag-858db68f59-tgwtn -c diag -- dotnet-counters collect -p 1 \
    --counters System.Runtime --duration 00:00:06 --format csv -o /tmp/counters.csv
File saved to /tmp/counters.csv
...System.Runtime,dotnet.gc.last_collection.heap.size (By)[gc.heap.generation=loh],Metric,50334336
...System.Runtime,dotnet.gc.last_collection.heap.size (By)[gc.heap.generation=gen2],Metric,1314736
...System.Runtime,dotnet.process.memory.working_set (By),Metric,160186368
1 MB'lık array'ler 85.000 byte sınırını aştığı için LOH'a (Large Object Heap) gitmiş; working set 160 MB. Şimdi Önce Tahmin Et'teki an: aynı container'dan full dump.
$ kubectl -n bookstore-dbg exec api-diag-858db68f59-tgwtn -c diag -- dotnet-dump collect -p 1 -o /tmp/api.dmp
Writing full to /tmp/api.dmp
command terminated with exit code 137
api restarts=1 last={"terminated":{...,"exitCode":137,"finishedAt":"2026-11-08T04:38:04Z","reason":"OOMKilled",...}}
Teşhis etmeye çalıştığımız pod'u öldürdük. Ephemeral container'ın kendi resource limiti yoktur, pod'un cgroup'unu paylaşır; dump'ın yazılması ve dump aracının kendisi, zaten limite yakın çalışan pod'un bellek bütçesinden yedi. Sızıntının kanıtı da process'le birlikte gitti. Pod'un memory limitini bir önceki yazılarda gördüğümüz in-place resize ile restart'sız 1Gi'ye çıkarıp tekrar denedik:
$ kubectl -n bookstore-dbg patch pod api-diag-858db68f59-tgwtn --subresource resize \
    --patch '{"spec":{"containers":[{"name":"api","resources":{"limits":{"memory":"1Gi"}}}]}}'
Writing full to /tmp/api.dmp
Complete
$ kubectl -n bookstore-dbg exec api-diag-858db68f59-tgwtn -c diag2 -- dotnet-dump analyze /tmp/api.dmp -c "dumpheap -stat -min 100000" -c exit
Statistics:
          MT Count  TotalSize Class Name
aaaad46746b0     1    110,512 Free
ffff65caae10    60 62,916,000 System.Byte[]
Total 61 objects, 63,026,512 bytes
Altmış adet 1 MB'lık byte[]: tam olarak yaptırdığımız allocation. Dump dosyası 403 MB tuttu ve emptyDir'de, yani node'un diskinde duruyor. Analizin kendisi Profiling serisinin konusu; burada önemli olan dump'ı pod'u öldürmeden almak.
Üretimde Dikkat
Teşhis bilgisi kaybolmadan yakalanmalı: kubectl logs --previous yalnız bir önceki container'ı tutar ve pod silindiğinde hepsi gider; merkezi log toplama ilerideki Observability serisinin konusu. Production pod'unda dump almadan önce üç şeyi yap: pod'u Service'ten çıkar (label'ını değiştirerek ya da trafiği başka replica'lara bırakarak), bellek payı yarat (in-place resize ya da en azından yeterli limit) ve dump'ın gideceği diskte yer olduğundan emin ol. dotnet-dump collect --type Heap full dump'tan küçüktür ama bellek baskısını ortadan kaldırmaz. Dump hassas veridir: connection string'ler, token'lar, müşteri verisi içinde düz metin durur; kopyalandığı yerin erişimini sınırla ve işin bitince sil. Debug image'ını önceden hazırla ve registry'ye koy; olay anında SDK image'ı çekip araç kurmak hem yavaş hem de production network policy'lerine takılır. kubectl debug yetkisi (pods/ephemeralcontainers üzerinde patch) RBAC'te (Role-Based Access Control) ayrı bir izin; kimin bu kapıyı açabildiğini bil.
Sık Düşülen Tuzaklar
Yalnız STATUS sütununa bakıp RESTARTS ve READY'yi atlamak. CrashLoopBackOff'ta --previous olmadan log okuyup yeni container'ın boş log'una bakmak. "authorization failed" mesajını görünce yalnız şifreyi aramak; tag'deki harf hatası da aynı mesajı verir. Exit code 137'yi her zaman OOM (Out Of Memory) sanmak; reason alanına bak. connection refused ile timeout'u aynı hata saymak. Chiseled image'a shell eklemek için image'ı değiştirmek, oysa ephemeral container var. /tmp'yi paylaşmadan dotnet araçlarını çalıştırıp "process bulunamadı" ile vakit kaybetmek. Ve limite yakın bir pod'da dump alıp kanıtı kendi elinle yok etmek.
Küçük Bir Deneme
★☆☆ api-typo Deployment'ındaki image'ı bookstore-api:1.2.0 yap ama imagePullPolicy: Always ekle. kind'da lokal yüklenmiş image'la ne oluyor, neden?
★★☆ api-crash'teki FailFast yerine, Bookstore API'sine ValidateOnStart ile doğrulanan zorunlu bir options class'ı ekle ve config'i vermeden deploy et. logs --previous çıktısında exception'ın adı ve mesajı ne? Exit code değişiyor mu?
★★★ Debug container'ından dotnet-trace collect -p 1 --duration 00:00:10 ile bir trace al, kubectl cp -c ile debug container'ından lokal makineye kopyala ve Visual Studio ya da PerfView ile aç. Trace alınırken pod'un bellek ve CPU kullanımını kubectl top pod --containers ile izle.
Lokal cluster'da her şeyi görebiliyor ve her şeyi kırabiliyoruz. Bir sonraki yazıda bu bilgileri bir araya getirip .NET + Angular uygulamasını managed Kubernetes'e, yani AKS (Azure Kubernetes Service), EKS (Amazon Elastic Kubernetes Service) ve GKE'ye (Google Kubernetes Engine) taşıyoruz ve production checklist'ini çıkarıyoruz.