

Kubernetes Nedir, Ne Zaman Gerekmez? Control Plane, Node ve Desired State

Kubernetes, ne istediğini bildirdiğin ve gerçek durumu sürekli o isteğe çeken bir container orchestration platformu. Silinen pod'un nasıl geri geldiğini, control plane ile node bileşenlerinin rolünü, kapanan bir node'da gerçekte ne kadar beklendiğini, yılda üç sürümlük destek takvimini ve Kubernetes'in ne zaman gereksiz bir maliyet olduğunu görüyoruz.
Sürüm notu: Bu yazıdaki örnekler kind 0.33 ile Kubernetes 1.37, kubectl 1.37, Docker 29 ve .NET 10 ile denenmiştir.
Önce Tahmin Et
Bookstore API'sinin (Application Programming Interface) üç kopyası üç ayrı pod'da çalışıyor. Birini kubectl delete pod ile siliyorsun. Birkaç saniye sonra kubectl get pods kaç pod gösterir: iki mi, üç mü? Üç ise yeni pod'u kim yarattı, sen hiçbir komut vermediğin hâlde? Daha zor soru: pod'u değil, pod'ların çalıştığı makinelerden birini kapatırsan, o makinedeki pod'lar ne kadar sürede başka bir makinede yeniden ayağa kalkar? Birkaç saniye mi, birkaç dakika mı?
Asıl Problem: Container'ı Çalıştırmak Değil, Çalışır Tutmak
Bookstore'u bugün tek bir VM (Virtual Machine) üzerinde Docker Compose ile çalıştırdığını düşün. docker compose up -d der, API'yi, Angular web'ini ve PostgreSQL'i ayağa kaldırırsın. restart: unless-stopped ile process çökünce container yeniden başlar. Küçük bir ekip ve tahmin edilebilir bir trafik için bu kurulum gayet iyi çalışır.
Sorunlar ikinci makineyle başlar. Trafik arttı, API'yi üç makineye yaymak istiyorsun. Hangi container hangi makinede çalışacak? Bir makine kapanırsa onun üzerindeki container'ları kim başka bir makineye taşıyacak? Yeni sürümü dağıtırken üç kopyayı aynı anda mı durduracaksın, yoksa birer birer mi? Load balancer'a hangi IP (Internet Protocol) adreslerini yazacaksın, adresler her yeniden başlatmada değişirken? Bu soruların hepsine container orchestration denir ve Kubernetes bu işi yapan araçların fiilî standardı.
Kubernetes'in sana verdiği söz tek cümleye sığar: "Ne istediğini söyle, onu sağlamak ve öyle tutmak benim işim." Bu cümlenin iki kelimesi bütün seriyi taşıyor: desired state (istenen durum) ve reconciliation (uzlaştırma).
Desired State ve Reconciliation Loop
Bookstore API'si için bir Deployment yazalım. Ayrıntılarını üçüncü ve dördüncü yazıda açacağız; şimdilik yalnız şunu söylüyor: bookstore namespace'inde, bookstore-api:1.0.0 image'ından üç kopya istiyorum.
apiVersion: v1
kind: Namespace
metadata:
  name: bookstore
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api
  namespace: bookstore
spec:
  replicas: 3
  selector:
    matchLabels:
      app.kubernetes.io/name: api
  template:
    metadata:
      labels:
        app.kubernetes.io/name: api
    spec:
      containers:
        - name: api
          image: bookstore-api:1.0.0
          ports:
            - containerPort: 8080
Dikkat et, bu dosyada hiçbir komut yok. "Üç container başlat" demiyoruz; "üç kopya olsun" diyoruz. Bu, declarative (bildirimsel) yaklaşım. Uyguladığımızda:
$ kubectl apply -f api.yaml
namespace/bookstore created
deployment.apps/api created
$ kubectl get pods -n bookstore -o wide
NAME                   READY   STATUS    AGE   NODE
api-7dd799865f-8tpf7   1/1     Running   1s    k8swork1-1-worker2
api-7dd799865f-fv9dt   1/1     Running   1s    k8swork1-1-worker2
api-7dd799865f-vftck   1/1     Running   1s    k8swork1-1-worker
(Çıktıyı okunur kalsın diye awk ile birkaç sütuna indirdim; sütun adları gerçek.) Şimdi baştaki ilk soru. Bir pod'u siliyoruz:
$ kubectl delete pod -n bookstore api-7dd799865f-8tpf7
pod "api-7dd799865f-8tpf7" deleted from bookstore namespace
$ kubectl get pods -n bookstore -o wide
NAME                   READY   STATUS    AGE   NODE
api-7dd799865f-85m2z   1/1     Running   4s    k8swork1-1-worker
api-7dd799865f-fv9dt   1/1     Running   11s   k8swork1-1-worker2
api-7dd799865f-vftck   1/1     Running   11s   k8swork1-1-worker
Yine üç pod var; silinenin yerine 4 saniye yaşında api-7dd799865f-85m2z gelmiş. Bunu yapan, Deployment'ın altında çalışan ReplicaSet controller'ı. Controller'ın yaptığı iş bir döngü: istenen durumu (spec.replicas: 3) oku, gerçek durumu (çalışan pod sayısı: 2) gözle, farkı kapatmak için bir adım at (bir pod yarat), sonra yine gözle. Kubernetes dokümantasyonu buna control loop diyor; literatürde reconciliation loop olarak da geçer. Isıtıcının termostatı gibi düşün: sen 22 derece istersin, termostat odayı ölçer, soğuksa ısıtıcıyı açar, sıcaksa kapatır; sen her dakika düğmeye basmazsın.
Bu modelin önemli bir sonucu var. Kubernetes'e "pod'u yeniden başlat" diye bir emir vermiyorsun; istenen durumu değiştiriyorsun ve sistem gerçek durumu ona doğru çekiyor. Deployment'ın kendisi de bu iki yarıyı açıkça taşır: spec senin isteğin, status sistemin gözlemi.
$ kubectl get deploy api -n bookstore -o yaml
...
status:
  availableReplicas: 3
  conditions:
  - message: ReplicaSet "api-7dd799865f" has successfully progressed.
    reason: NewReplicaSetAvailable
    status: "True"
    type: Progressing
  - message: Deployment has minimum availability.
    reason: MinimumReplicasAvailable
    status: "True"
    type: Available
  observedGeneration: 1
  readyReplicas: 3
  replicas: 3
  terminatingReplicas: 0
  updatedReplicas: 3
observedGeneration controller'ın spec'in hangi sürümünü gördüğünü söyler. Spec'i değiştirdiğinde metadata.generation artar; ikisi eşitlenene kadar controller henüz yeni isteğini işlememiştir. Bu ayrıntı CI (Continuous Integration) pipeline'larında "deploy bitti mi?" sorusunu doğru cevaplamanın temeli; kubectl rollout status tam olarak buna bakar.
Cluster'ın Parçaları: Control Plane ve Node
Control Plane: Beyin Nerede?
Bir Kubernetes cluster'ı iki kısımdan oluşur: cluster'ın durumunu yöneten control plane ve uygulamaların çalıştığı node'lar. Bu seride kullanacağımız lokal cluster'da (bir sonraki yazıda kuruyoruz) control plane bileşenleri kendileri de pod olarak çalışıyor, bu yüzden onları görebiliyoruz:
$ kubectl get pods -n kube-system -o wide
NAME                                               STATUS    NODE
coredns-559f6c778d-c6t8g                           Running   k8swork1-1-control-plane
coredns-559f6c778d-t6cp4                           Running   k8swork1-1-control-plane
etcd-k8swork1-1-control-plane                      Running   k8swork1-1-control-plane
kindnet-d5dpj                                      Running   k8swork1-1-control-plane
kindnet-lwf62                                      Running   k8swork1-1-worker
kindnet-v4brw                                      Running   k8swork1-1-worker2
kube-apiserver-k8swork1-1-control-plane            Running   k8swork1-1-control-plane
kube-controller-manager-k8swork1-1-control-plane   Running   k8swork1-1-control-plane
kube-proxy-7sz4f                                   Running   k8swork1-1-worker
kube-proxy-8mhcf                                   Running   k8swork1-1-control-plane
kube-proxy-llznk                                   Running   k8swork1-1-worker2
kube-scheduler-k8swork1-1-control-plane            Running   k8swork1-1-control-plane
Dört bileşen control plane'in çekirdeği:
kube-apiserver, cluster'ın tek kapısı. kubectl, controller'lar, scheduler ve node'lardaki kubelet'ler birbirleriyle değil, yalnız API server ile konuşur. Her istek burada authentication (kimlik doğrulama), authorization (yetkilendirme) ve admission kontrolünden geçer, sonra kalıcı hâle getirilir. YAML (YAML Ain't Markup Language) dosyan aslında bu API'nin bir HTTP (Hypertext Transfer Protocol) isteğidir.
etcd, cluster'ın hafızası: tutarlı, dağıtık bir key/value store. Deployment'ın, pod'ların, Secret'ların hepsi burada durur. etcd'yi kaybeden cluster'ını kaybeder; managed Kubernetes servislerinde (AKS (Azure Kubernetes Service), EKS (Amazon Elastic Kubernetes Service), GKE (Google Kubernetes Engine)) etcd'yi ve yedeğini sağlayıcı yönetir, bu da onları tercih etmenin büyük nedenlerinden biri.
kube-scheduler, henüz bir node'a atanmamış pod'ları izler ve her biri için uygun bir node seçer: yeterli CPU (Central Processing Unit) ve bellek var mı, affinity kuralları, taint'ler, topoloji yayılımı. Seçimini pod'un spec.nodeName alanına yazarak bildirir; container'ı kendisi başlatmaz.
kube-controller-manager, onlarca controller'ı tek bir process'te çalıştırır: Deployment, ReplicaSet, Job, Node, EndpointSlice controller'ı ve diğerleri. Her biri kendi resource türü için az önce gördüğümüz döngüyü işletir. Bulut sağlayıcısına özgü işler (load balancer açmak, disk bağlamak) ayrı ve isteğe bağlı bir bileşende, cloud-controller-manager'da durur; kind gibi lokal cluster'larda yoktur.
Node: İşin Yapıldığı Yer
Her node'da üç parça çalışır. kubelet node'un ajanıdır: API server'ı izler, kendi node'una atanmış pod'ları görür ve container runtime'a "şu image'dan şu container'ı başlat" der. Ardından container'ın sağlığını izler, probe'ları çalıştırır ve pod'un durumunu API server'a raporlar.
Container runtime, container'ları gerçekten çalıştıran yazılımdır. kubelet onunla CRI (Container Runtime Interface) üzerinden konuşur; bugün en yaygın iki runtime containerd ve CRI-O. Docker'ın kendisi Kubernetes 1.24'ten beri doğrudan kullanılmıyor, ama Docker ile build ettiğin image'lar OCI (Open Container Initiative) standardında olduğu için containerd'de aynen çalışır; bu konuyu 18. yazıda eski manifest'lerle birlikte açacağız. Bizim cluster'da runtime containerd://2.3.4.
kube-proxy, Service'lerin sanal IP adreslerini pod'lara yönlendiren ağ kurallarını her node'da kurar. Dokümantasyon onu isteğe bağlı olarak işaretliyor; bazı ağ eklentileri (örneğin eBPF (extended Berkeley Packet Filter) tabanlı Cilium) bu işi kendisi üstlenebiliyor. Pod'lar arası ağı ise CNI (Container Network Interface) eklentisi kurar; kind'da bu kindnet.
kubectl apply'dan Çalışan Container'a
Şimdi parçaları birleştirelim. Baştaki silme işleminden sonra namespace'in event'leri, kimin neyi hangi sırayla yaptığını tek tek gösteriyor:
$ kubectl get events -n bookstore --sort-by=.lastTimestamp
LAST SEEN   TYPE     REASON             OBJECT                     MESSAGE
4s          Normal   Killing            pod/api-7dd799865f-8tpf7   Stopping container api
4s          Normal   Scheduled          pod/api-7dd799865f-85m2z   Successfully assigned bookstore/api-7dd799865f-85m2z to k8swork1-1-worker
4s          Normal   SuccessfulCreate   replicaset/api-7dd799865f  Created pod: api-7dd799865f-85m2z
3s          Normal   Pulled             pod/api-7dd799865f-85m2z   Container image "bookstore-api:1.0.0" already present on machine and can be accessed by the pod
3s          Normal   Created            pod/api-7dd799865f-85m2z   Container created
3s          Normal   Started            pod/api-7dd799865f-85m2z   Container started
Okuması şöyle: kubelet eski container'ı durdurdu (Killing), ReplicaSet controller'ı eksik kopyayı fark edip yeni bir pod object'i yarattı (SuccessfulCreate), scheduler onu k8swork1-1-worker'a atadı (Scheduled), o node'daki kubelet image'ı buldu, container'ı yarattı ve başlattı. Aynı saniyeye düşen satırların sırası karışabilir; event'ler kesin bir sıralama garantisi vermez. Aşağıdaki şekil aynı akışı bileşenler üzerinden gösteriyor.
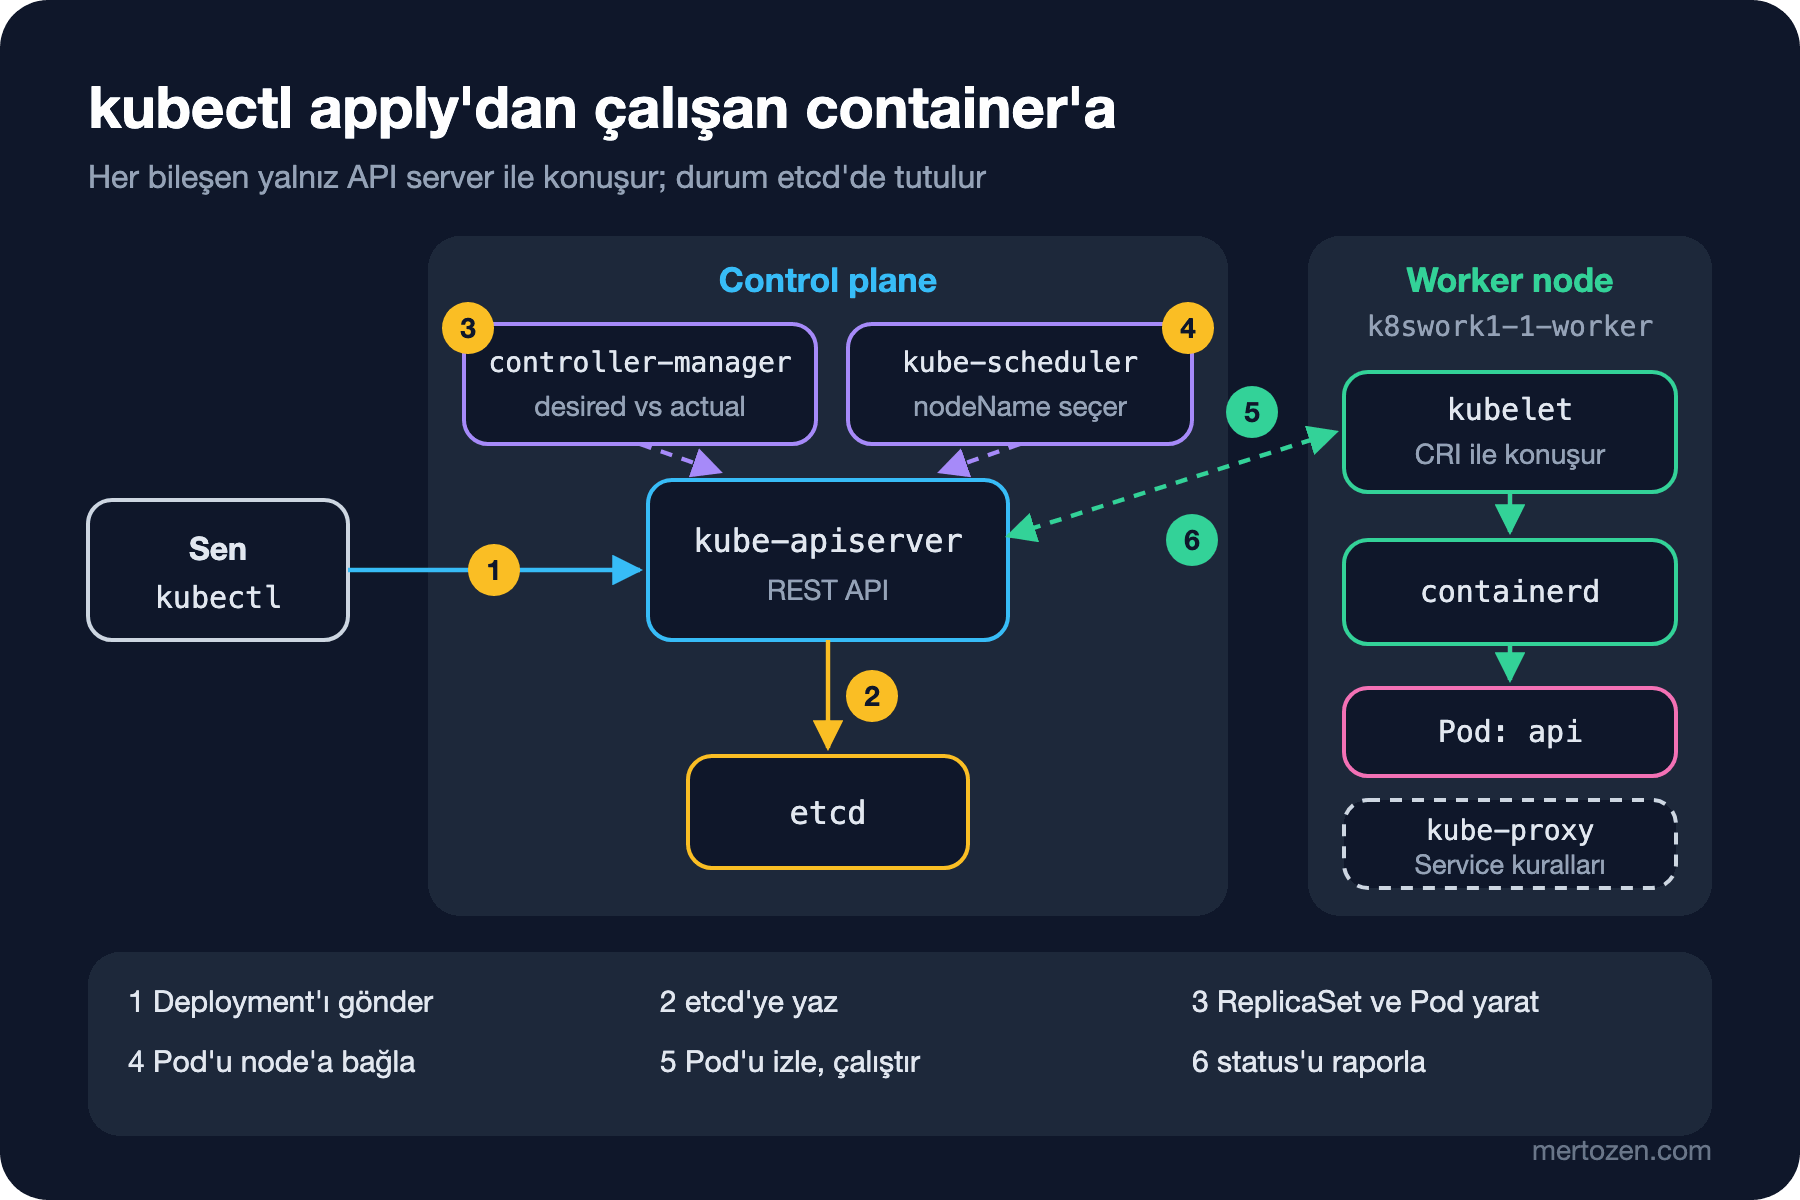
Şekildeki en önemli fikir kesikli oklarda: hiçbir bileşen bir başkasına "şunu yap" diye çağrı yapmaz. Scheduler kubelet'i aramaz; pod'a bir node adı yazar, kubelet bu değişikliği API server üzerinden watch ederek görür. Bu gevşek bağlılık sayesinde bileşenlerden biri bir süre çökse bile geri geldiğinde yalnız güncel durumu okur ve kaldığı yerden devam eder.
Makine Kapanınca Ne Olur?
Pod silmek kolay bir test. Gerçek hayattaki arıza bir node'un tamamen gitmesi. kind'da her node bir Docker container'ı olduğu için bunu docker stop ile taklit edebiliriz. İki API pod'u k8swork1-1-worker2 üzerindeyken o node'u durdurdum ve her 10 saniyede bir durumu kaydettim:
$ docker stop k8swork1-1-worker2
stopped worker2 at 06:24:18
--- 06:24:58
k8swork1-1-worker2 Ready
api-7dd799865f-fv9dt Running k8swork1-1-worker2
--- 06:25:08
k8swork1-1-worker2 NotReady
api-7dd799865f-fv9dt Running k8swork1-1-worker2
# ... 5 dakika boyunca aynı
--- 06:30:02
k8swork1-1-worker2 NotReady
api-7dd799865f-fv9dt Running k8swork1-1-worker2
--- 06:30:12
k8swork1-1-worker2 NotReady
api-7dd799865f-fv9dt Terminating k8swork1-1-worker2
api-7dd799865f-j8nz5 Running k8swork1-1-worker
(Çıktıyı yalnız worker2 ve oradaki pod'a indirdim.) Okunacak üç an var. Node durduktan sonra 40 ile 50 saniye arasında control plane onu NotReady olarak işaretledi; kubelet'ten düzenli gelen heartbeat'ler kesilince Node controller bir süre bekler, sonra node'u sağlıksız sayar. Ama pod hemen taşınmadı: tam beş dakika daha Running görünmeye devam etti. Nedeni pod'a otomatik eklenen bir toleration: kubectl get pod -o jsonpath='{.spec.tolerations}' çıktısında node.kubernetes.io/unreachable ve not-ready için "tolerationSeconds":300 görünüyor. Kubernetes kısa bir ağ kesintisi yüzünden bütün pod'ları gereksiz yere taşımamak için beş dakika sabreder. Bu sürenin sonunda (06:30:12) eski pod Terminating oldu ve ReplicaSet controller'ı sağlam node'da yerine api-7dd799865f-j8nz5'i yarattı. Eski pod, node 06:31:53'te geri gelene kadar Terminating'de kaldı; ölü bir node'daki kubelet "durdurdum" diyemez. Baştaki ikinci sorunun cevabı bu yüzden "yaklaşık 5 dakika 50 saniye". Bu arada çalışan iki kopya trafiği taşıdı; tek replica'lı bir uygulama bu sürenin tamamında kapalı kalırdı.
Ne Zaman Kubernetes Gerekmez?
Bu serinin en dürüst bölümü belki de bu. Kubernetes güçlü ama bedava değil; sana bir platform verir ve o platformu işletmeyi de sana bırakır. Yılda üç minor sürüm çıkar ve her biri yaklaşık 14 ay patch alır, yani en geç yılda bir upgrade yapmak zorundasın. Üstüne ağ eklentisi, dış trafik için Gateway, sertifikalar, log ve metric toplama, RBAC (Role-Based Access Control), yedekleme, güvenlik yamaları gelir. Managed bir servis kullansan bile node'ların, manifest'lerin ve upgrade'lerin sorumluluğu büyük ölçüde sende kalır.
| Seçenek | Ne zaman yeterli | Bedeli |
|---|---|---|
| Tek VM + Docker Compose | Tek ekip, birkaç servis, kısa kesintiye tahammül var | Makine giderse her şey gider; ölçek dikey |
| PaaS (App Service, Container Apps, Cloud Run) | Stateless web/API, hızlı başlangıç, küçük ops ekibi | Platformun sınırları ve fiyat modeli; ince ayar az |
| Managed Kubernetes (AKS, EKS, GKE) | Çok servis, çok ekip, standart bir platform ihtiyacı | Upgrade, ağ, güvenlik ve gözlem işi sende |
| Self-managed Kubernetes | On-premise zorunluluğu, özel donanım, platform ekibi var | Control plane ve etcd de sende |
PaaS (Platform as a Service) seçenekleri ilk bakışta "Kubernetes'in hafif hâli" gibi görünür; Azure Container Apps gibi bazıları arka planda zaten Kubernetes üzerinde çalışır ama onu sana göstermez. Bookstore'un tek bir API'si, bir Angular uygulaması ve bir veritabanı varsa, bunları bir PaaS'ta ya da iki VM'lik bir Compose kurulumunda çalıştırmak çoğu zaman daha ucuz ve daha az riskli. Kubernetes'in maliyeti, birden çok ekibin aynı platformda onlarca servis çalıştırdığı, ortak bir deploy, scaling ve gözlem diline ihtiyaç duyduğu noktada geri döner. Karar sorusu "Kubernetes iyi mi?" değil, "Bu karmaşıklığı işletecek insan ve zamanım var mı?" olmalı.
Sürüm Takvimi ve Destek Süresi
Kubernetes 2021'de KEP (Kubernetes Enhancement Proposal) 2572 ile yılda dört sürümden üç sürüme geçti. Sürüm numarası x.y.z biçiminde; minor sürüm (y) yeni özellikleri, patch sürümü (z) hata ve güvenlik düzeltmelerini getirir. Proje en son üç minor sürüm için release branch'i tutar ve her minor sürüm yaklaşık 14 ay patch alır: 12 aylık standart dönem ve iki aylık maintenance mode. Bu yazıyı yazdığım Kasım 2026'da kubernetes.io/releases sayfası 1.37, 1.36 ve 1.35'i (ve 28 Ekim 2026'da ömrü dolan 1.34'ü) listeliyor; 1.37'nin destek sonu 28 Ekim 2027. Bu serideki örnekler kind'ın varsayılan node image'ı olan 1.37.0 üzerinde çalıştı.
Pratik sonucu şu: production cluster'ını en geç yılda bir minor sürüm atlatman gerekir ve her atlamada kaldırılan API'leri kontrol etmen gerekir. Managed servislerin kendi destek takvimleri var ve genellikle upstream'den biraz geriden gelir; bu ayrıntıyı 17. yazıda açacağız.
Üretimde Dikkat
Desired state modeli, "çalışıyor" kavramını değiştirir. Pod'un Running olması uygulamanın istek karşılayabildiği anlamına gelmez; Kubernetes ancak ona söylediğin sinyallere bakar. Readiness ve liveness probe'larını (8. yazı) ve resource request'lerini (9. yazı) tanımlamadığın sürece scheduler ve controller'lar kör uçar.
Node arızasında pod'ların taşınması varsayılan ayarlarla dakikalar sürer, saniyeler değil. Bu yüzden tek replica'lı bir API, Kubernetes'te de tek makineli bir Compose kurulumundan daha yüksek erişilebilirlik vermez. En az iki replica, farklı node'lara yayılmış pod'lar ve bir PodDisruptionBudget (11. yazı) gerçek dayanıklılığın asgarisi.
Control plane'in kendisi de bir bağımlılık. API server'a ulaşılamadığında çalışan pod'lar çalışmaya devam eder, ama yeni deploy yapamazsın, ölen pod yerine yenisi gelmez, scaling durur. Managed servislerde control plane'in SLA (Service Level Agreement) değerine ve ücretli/ücretsiz katman farkına bak.
Sık Düşülen Tuzaklar
Kubernetes'i imperative bir araç gibi kullanmak. Production'da kubectl edit ile elle bir değeri değiştirirsen, Git'teki manifest ile cluster'daki gerçek durum ayrışır ve bir sonraki kubectl apply değişikliğini sessizce geri alır. Kaynak her zaman dosya olsun.
Pod'u kalıcı bir sunucu gibi düşünmek. Pod'un adı, IP adresi ve diski geçicidir; az önce silinen pod'un yerine gelen pod yeni bir ad ve yeni bir IP aldı. Uygulamanın yerel diske yazdığı her şey pod ile birlikte gider.
"Kubernetes'e geçtik, artık ölçekleniyoruz" sanmak. Kubernetes stateless bir uygulamayı kolayca çoğaltır; ama uygulama session'ı bellekte tutuyorsa, dosyayı yerel diske yazıyorsa ya da her replica başlarken migration koşuyorsa, çoğaltmak sorunu da çoğaltır. Bu tuzakların her birine serinin ilerleyen yazılarında tek tek bakacağız.
Küçük bir iş yükü için cluster kurmak. Ekip Kubernetes'i öğrenirken asıl ürün bekler. Önce yukarıdaki tabloya dürüstçe bak.
Küçük Bir Deneme
★☆☆ Bir sonraki yazıdaki kind cluster'ını kurduktan sonra yukarıdaki Deployment'ı uygula, bir pod'u sil ve kubectl get events -n bookstore --sort-by=.lastTimestamp çıktısında SuccessfulCreate, Scheduled ve Started satırlarını bul.
★★☆ kubectl scale deploy/api -n bookstore --replicas=5 çalıştır, sonra Deployment'ın metadata.generation ve status.observedGeneration değerlerini karşılaştır. Ardından ReplicaSet'i (kubectl get rs -n bookstore) doğrudan 1 replica'ya scale etmeyi dene; ne olduğunu ve neden olduğunu açıkla.
★★★ Bookstore'un bugünkü hâli (bir API, bir Angular uygulaması, bir PostgreSQL) için yukarıdaki tabloyu kendi ekibin açısından doldur: kaç kişi, haftada kaç deploy, ne kadar kesinti kabul edilebilir? Kubernetes'in sana ne zaman değer katmaya başlayacağını bir paragrafla yaz.
Bu yazıda Kubernetes'in ne olduğunu ve neden var olduğunu gördük. Bir sonraki yazıda kendi makinende çok node'lu bir cluster kuruyoruz: kind, k3d ve minikube'u karşılaştırıyor, kubectl'in context ve namespace kavramlarıyla, yanlış cluster'da komut çalıştırmamanın yollarıyla tanışıyoruz.