

Graceful Shutdown: SIGTERM, terminationGracePeriodSeconds, preStop ve .NET HostOptions

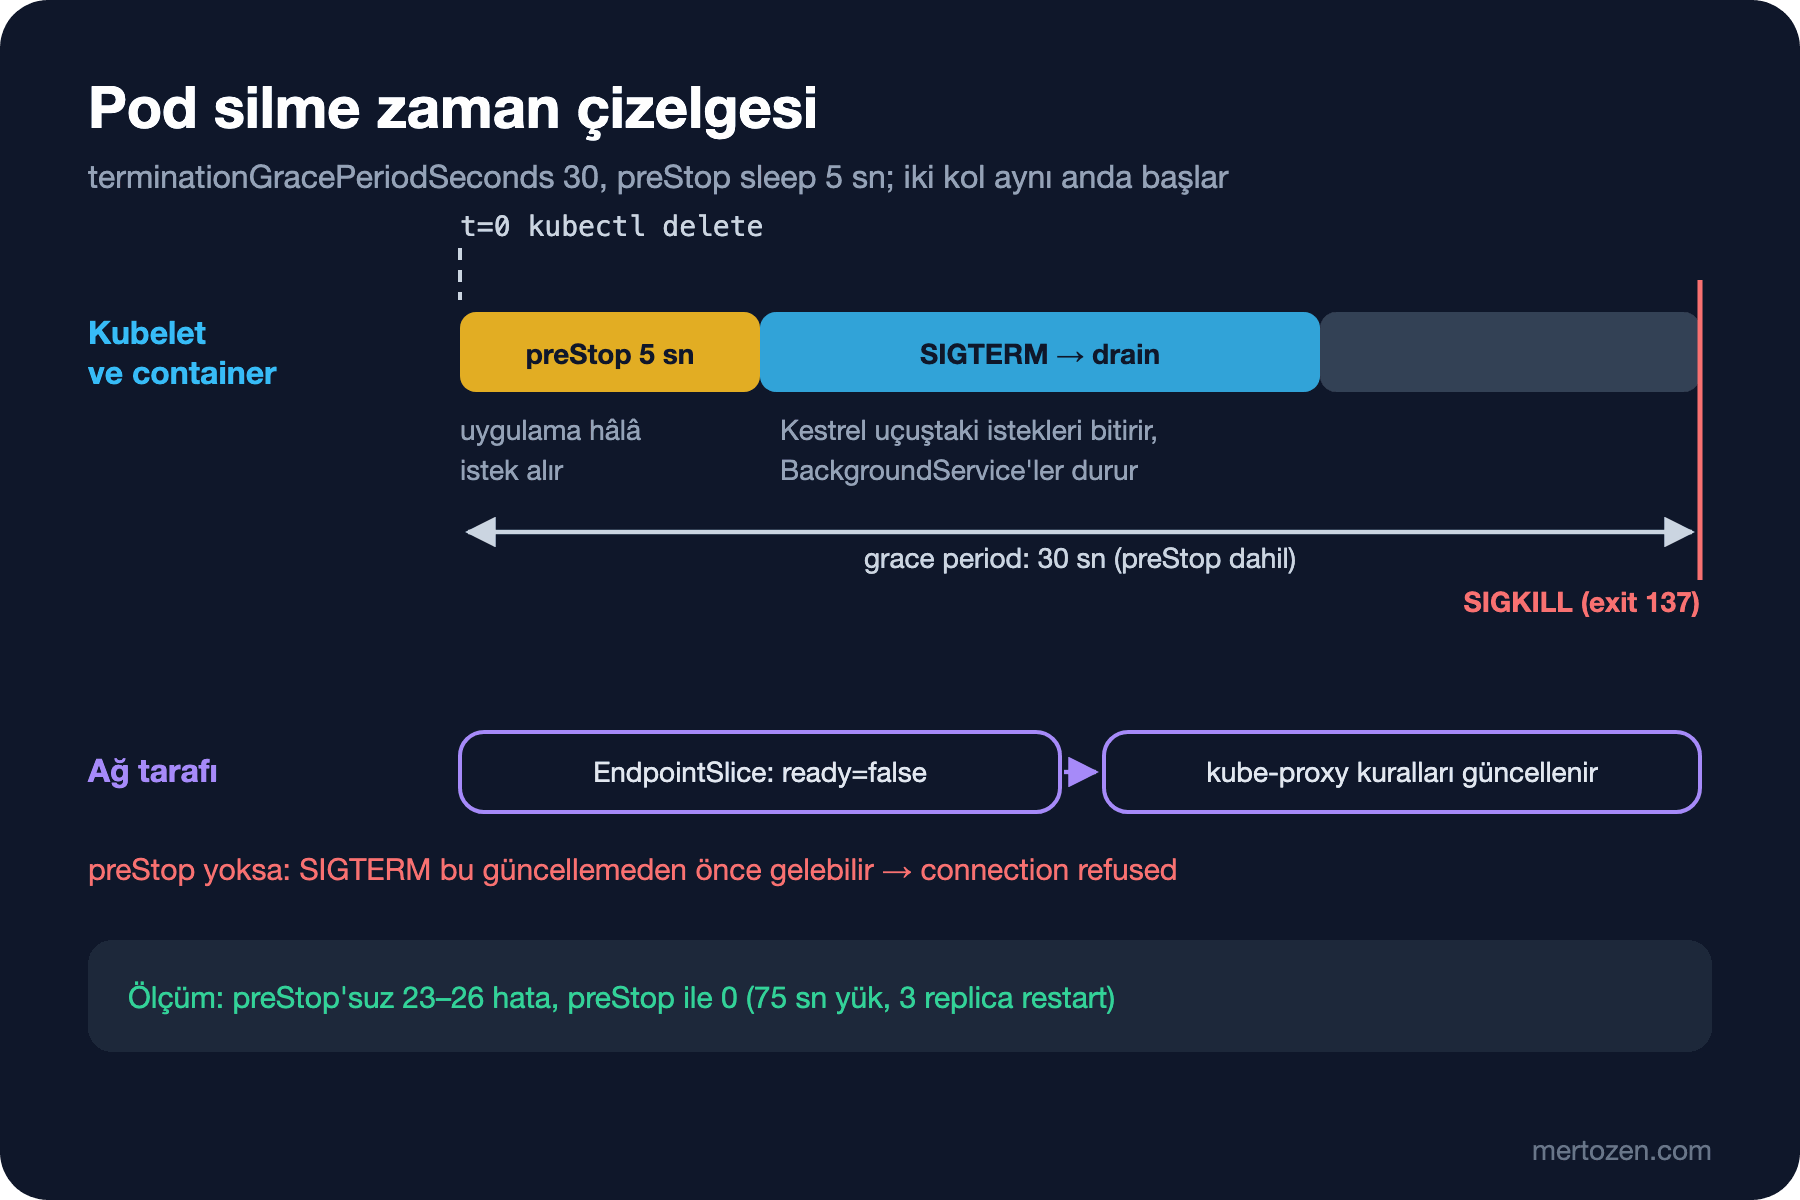
Pod silinince SIGTERM ile endpoint'ten çıkarılma aynı anda ve senkronizasyonsuz başlar; bu yarış, her şey doğru yapılmış bir rollout'ta bile 23–26 hataya yol açtı, 5 saniyelik preStop sleep action ile sıfıra indi. .NET'in SIGTERM'de istekleri ve BackgroundService'leri sırayla bitirmesini, ShutdownTimeout ve grace period'un birbirini nasıl kestiğini, chiseled image'da exec sleep'in başarısızlığını gerçek çıktılarla görüyoruz.
Sürüm notu: Bu yazıdaki örnekler kind 0.33 ile Kubernetes 1.37, kubectl 1.37 ve .NET 10 (ASP.NET Core 10.0.14) ile denenmiştir.
Önce Tahmin Et
Bookstore API'sinin (Application Programming Interface) üç replica'sı readiness probe'larıyla, maxUnavailable: 0 ile çalışıyor. Cluster içindeki bir client saniyede 700 ile 1300 arası istek atarken kubectl rollout restart yapıyorsun. Kaç istek başarısız olur: sıfır mı, birkaç mı, yüzlerce mi? Uygulama SIGTERM'ü (termination signal) doğru işliyor, rolling update kapasiteyi düşürmüyor; hata için bir neden var mı? İkinci soru: terminationGracePeriodSeconds: 5 olan bir pod'da 15 saniyelik bir istek işlenirken pod silinirse ne olur?
Bir Pod Silinirken Gerçekte Ne Olur?
Pod silme isteği API server'a ulaştığında pod Terminating durumuna geçer ve birbirinden bağımsız iki kol aynı anda başlar.
Birinci kol node'da: kubelet pod'un silindiğini görür, varsa container'ın preStop hook'unu çalıştırır, hook bitince container'ın ana process'ine SIGTERM gönderir. Process terminationGracePeriodSeconds (varsayılan 30 saniye) içinde çıkmazsa SIGKILL (kill signal) gelir. Önemli ayrıntı: grace period preStop başlamadan başlar; preStop'ta geçen süre bu bütçeden düşer.
İkinci kol ağda: EndpointSlice controller'ı pod'un endpoint'ini terminating: true, ready: false olarak işaretler, her node'daki kube-proxy bu değişikliği watch ile görür ve kendi kurallarından pod'u çıkarır. Gateway, Envoy ya da bir bulut load balancer'ı da aynı bilgiyi kendi hızında alır.
İki kol arasında hiçbir senkronizasyon yok. SIGTERM, bütün node'lardaki kurallar güncellenmeden gelebilir. .NET uygulaması SIGTERM'ü alınca Kestrel yeni bağlantı kabul etmeyi bırakır; ama başka bir node'daki kube-proxy hâlâ bu pod'a bağlantı yönlendiriyorsa, o bağlantılar "connection refused" alır. Baştaki ilk sorunun cevabı bu yarışta.
.NET Tarafı: SIGTERM, ApplicationStopping ve Sıra
Önce uygulamanın kendi kapanışını görelim. Bookstore API'si üç yerde log yazıyor: IHostApplicationLifetime.ApplicationStopping tetiklendiğinde, 8 saniyelik bir istek (/api/slow?seconds=8) bittiğinde ve OrderOutboxWorker adlı bir BackgroundService durduğunda. Worker, iptal edildiğinde bekleyen mesajları göndermeyi taklit etmek için 3 saniye harcıyor:
public sealed class OrderOutboxWorker(ILogger<OrderOutboxWorker> logger, IConfiguration configuration) : BackgroundService
{
    protected override async Task ExecuteAsync(CancellationToken stoppingToken)
    {
        int drainSeconds = configuration.GetValue("Shutdown:WorkerDrainSeconds", 0);
        try
        {
            while (!stoppingToken.IsCancellationRequested)
            {
                await Task.Delay(TimeSpan.FromSeconds(5), stoppingToken);
            }
        }
        catch (OperationCanceledException)
        {
            logger.LogInformation("OrderOutboxWorker stopping, flushing pending messages ({Seconds}s)", drainSeconds);
            await Task.Delay(TimeSpan.FromSeconds(drainSeconds));
            logger.LogInformation("OrderOutboxWorker stopped cleanly");
        }
    }
}
İstek işlenirken pod'u sildim (grace period 30 saniye):
04:54:34.484 info: Program[0] Slow request started (8s)
delete 04:54:36
04:54:36.496 info: Microsoft.Hosting.Lifetime[0] Application is shutting down...
04:54:36.496 info: Bookstore.Api[0] ApplicationStopping: SIGTERM received, draining
04:54:42.487 info: Program[0] Slow request finished
04:54:42.500 info: Bookstore.Api.Workers.OrderOutboxWorker[0] OrderOutboxWorker stopping, flushing pending messages (3s)
04:54:45.501 info: Bookstore.Api.Workers.OrderOutboxWorker[0] OrderOutboxWorker stopped cleanly
04:54:45.504 info: Bookstore.Api[0] ApplicationStopped
{"pod":"api-shutdown","seconds":8}
Okunacak üç şey var. SIGTERM aynı milisaniyede ApplicationStopping'i tetikledi; .NET'in generic host'u Linux'ta SIGTERM'ü kendisi dinler, ek kod gerekmez. Uçuştaki istek yarıda kesilmedi; Kestrel 6 saniye bekledi ve client tam yanıtı aldı. Hosted service'ler sırayla durdu: önce web sunucusu (uçuştaki istekleri bitirerek), sonra worker; worker'ın stoppingToken'ı ancak o zaman iptal edildi. Toplam 9 saniye, 30 saniyelik bütçenin içinde.
HostOptions.ShutdownTimeout ve terminationGracePeriodSeconds
Bu kapanışın bir süre sınırı var: HostOptions.ShutdownTimeout. Varsayılanı 30 saniye (.NET 5 ve öncesinde 5 saniyeydi); host bu süre içinde bitmeyen hosted service'leri beklemeyi bırakır. Bookstore API'sinde onu configuration'dan okuyoruz:
builder.Services.Configure<HostOptions>(o =>
    o.ShutdownTimeout = TimeSpan.FromSeconds(builder.Configuration.GetValue("Shutdown:TimeoutSeconds", 30)));
Aynı deneyi Shutdown__TimeoutSeconds=4 ve 10 saniyelik bir istekle tekrarladım:
04:55:01.538 info: Program[0] Slow request started (10s)
delete 04:55:03
04:55:03.552 info: Microsoft.Hosting.Lifetime[0] Application is shutting down...
04:55:03.552 info: Bookstore.Api[0] ApplicationStopping: SIGTERM received, draining
04:55:08.558 info: Bookstore.Api[0] ApplicationStopped
04:55:08.558 info: Bookstore.Api.Workers.OrderOutboxWorker[0] OrderOutboxWorker stopping, flushing pending messages (3s)
wget: error getting response: Connection reset by peer
Host 4 saniye bekledi, sonra kapanışı zorladı: client'ın bağlantısı "connection reset" ile koptu, istek hiç bitmedi ("Slow request finished" logu yok) ve worker mesajlarını göndermeye başladığı anda process çıktı ("stopped cleanly" yok). Pod'un grace period'u 30 saniye olduğu hâlde 5 saniyede kapandı. Bu sefer de grace period'u kısalttım: terminationGracePeriodSeconds: 5, ShutdownTimeout varsayılan 30 saniye, istek 15 saniye. Baştaki ikinci sorunun cevabı:
delete 04:55:25
04:55:25 running
04:55:30 exit=137 reason=Error finished=2026-11-08T04:55:30Z
wget: error getting response
5 saniye sonra SIGKILL geldi, exit code 137. Uygulamanın ne kadar beklemek istediği önemli değil; son sözü kubelet söyler. Kural: terminationGracePeriodSeconds > preStop süresi + ShutdownTimeout + birkaç saniye pay. Ve ShutdownTimeout, uygulamanın en uzun meşru işinden (en uzun istek, worker'ın batch'i) uzun olmalı. Sıralama tersine dönerse kapanış sessizce SIGKILL'e dönüşür ve log bile yazılmaz.
Endpoint Yarışı ve preStop Sleep
Şimdi baştaki ilk soru. Bookstore API Deployment'ı (3 replica, readiness ve liveness probe'ları, maxSurge: 1, maxUnavailable: 0) çalışırken busybox client'tan 75 saniye boyunca durmadan http://api/api/info'ya istek attım (her istek yeni bir bağlantı) ve arada kubectl rollout restart yaptım. İki kez:
run 1: ok=66433 fail=26
fail 04:56:03 wget: can't connect to remote host (10.96.24.23): Connection refused
fail 04:56:03 wget: can't connect to remote host (10.96.24.23): Connection refused
fail 04:56:05 wget: download timed out
run 2: ok=51034 fail=23
Readiness probe'u bu yarışı neden çözmüyor? Çünkü readiness'ın düşmesi de aynı ağ koluna bağlı: pod silindiği anda zaten ready: false işaretleniyor; sorun işaretlemede değil, bu bilginin her node'daki kurallara ulaşma süresinde. Hataların bir kısmı "connection refused" (kapanmış Kestrel'e yönlendirilen yeni bağlantılar), bir kısmı "download timed out" (kural güncellenirken askıda kalan bağlantılar). Beşinci yazıda gördüğümüz EndpointSlice koşulları burada anlam kazanıyor: kapanmakta olan bir pod terminating: true olurken hâlâ serving: true kalabilir; bazı Gateway implementation'ları bu bilgiyi kullanarak yeni istekleri göndermeyi keser ama açık bağlantıları bitirmeye izin verir.
Her şey "doğru" yapılmış olmasına rağmen her rollout 23–26 hata üretti. Çözüm, SIGTERM'ü birkaç saniye geciktirmek: pod endpoint listelerinden çıkarılırken uygulama gelen istekleri karşılamaya devam etsin, ağ tarafı yetiştikten sonra kapanış başlasın. Bunun yolu bir preStop hook'u. Ama Bookstore image'ı chiseled; içinde sleep yok:
      lifecycle:
        preStop:
          exec:
            command: ["sleep", "5"]
$ kubectl get events --field-selector involvedObject.name=api-shutdown
Normal Killing pod/api-shutdown Stopping container api
Warning FailedPreStopHook pod/api-shutdown PreStopHook failedHook başarısız oldu ve kubelet SIGTERM'ü hemen gönderdi; yani shell'siz image'da klasik sleep hilesi sessizce çalışmıyor. Kubernetes'in buna cevabı sleep action: kubelet'in kendisinin beklediği, container'da hiçbir binary gerektirmeyen bir preStop. 1.29'da alpha olarak geldi, 1.30'da varsayılan olarak açıldı ve 1.34'te stable oldu:
          lifecycle:
            preStop:
              sleep:
                seconds: 5
Aynı yük testi, aynı rollout, iki kez:
run 1: ok=95311 fail=0
run 2: ok=97482 fail=0
Sıfır hata. 5 saniye, kind'daki üç node'lu cluster'da ağ tarafının yetişmesi için yeterliydi. Production'da bu süre, trafiğin geçtiği bütün katmanların (kube-proxy, Gateway, bulut load balancer'ının health check'i) pod'u düşürme süresine göre seçilir; 5–15 saniye yaygın. Bedeli her pod kapanışının bu kadar uzaması; rolling update'in toplam süresi buna göre uzar. Kubernetes 1.33'ten beri seconds: 0 da geçerli bir değer; sleep'i manifest'te tutup ortama göre kapatmak için kullanışlı.
Uzun İstekler, BackgroundService'ler ve SignalR
Bütçeyi gerçek iş yüküne göre kur. Bookstore'da üç tür uzun iş var. Uzun HTTP (Hypertext Transfer Protocol) istekleri (rapor üretme, dosya yükleme): ShutdownTimeout en uzun meşru isteği kapsamalı, ya da bu işler istekten çıkarılıp bir queue'ya alınmalı. BackgroundService'ler: stoppingToken'ı her döngüde dinle, iptal edildiğinde yarım kalan işi ya bitir ya da güvenle bırak (mesajı ack'lemeden çık ki başka bir pod alsın); Background Job ve Message Queue serilerindeki idempotent consumer yaklaşımı burada işe yarıyor. SignalR ve WebSocket bağlantıları: hiç bitmeyen bağlantılardır; Kestrel ShutdownTimeout dolunca onları keser. Bu kaçınılmaz, o yüzden client tarafında otomatik yeniden bağlanmayı (SignalR'ın withAutomaticReconnect'i) açık tut ve yeniden bağlantıların yeni pod'lara dağıldığından emin ol.
Kapanışta yapılacak özel bir iş varsa (bir cache'i diske yazmak, bir lock'u bırakmak) IHostApplicationLifetime.ApplicationStopping'e kayıt ol ya da bir IHostedService.StopAsync içinde yap. Console.CancelKeyPress ya da AppDomain.ProcessExit ile kendi sinyal işleyicini yazmana gerek yok; generic host bunu senin yerine yapıyor.
Üretimde Dikkat
Üç süreyi birlikte tasarla ve manifest'te yan yana yaz: preStop sleep (ağın yetişmesi için), ShutdownTimeout (uygulamanın işini bitirmesi için) ve terminationGracePeriodSeconds (ikisinin toplamından büyük). Bookstore için: 5 + 30 < 45.
Ölç, tahmin etme. Yukarıdaki yük testi bir dakikalık bir iş; her yeni Gateway, yeni CNI (Container Network Interface) ya da yeni managed cluster'da tekrarla. Rollout sırasındaki 5xx (sunucu hatası) oranını gözlem sisteminde ayrı bir panelde izle.
Node drain'i ve autoscaler'ın node kapatmasını da hesaba kat. Pod'lar yalnız deploy'da değil, node bakımında ve cluster autoscaler küçülürken de aynı yoldan sonlandırılır; PodDisruptionBudget (11. yazı) aynı anda kaç pod'un gidebileceğini sınırlar.
Sık Düşülen Tuzaklar
Shell'siz image'da exec ile sleep çalıştırmak. Yukarıda gördüğün gibi hook başarısız olur, sadece bir Warning event'i kalır ve hiçbir şey beklemez. sleep action kullan.
Entrypoint'i shell sarmalayıcısı yapmak. sh -c "dotnet Bookstore.Api.dll" SIGTERM'ü uygulamaya iletmez; uygulama hiç ApplicationStopping görmez ve her kapanış grace period'un sonunda SIGKILL olur (üçüncü yazıdaki sidecar ile aynı sorun).
Grace period'u ShutdownTimeout'tan kısa tutmak. Uygulama nazikçe kapanmaya çalışırken SIGKILL gelir; log yok, flush yok.
Readiness'ı kapanışta elle düşürmeye çalışmak. ApplicationStopping'de health check'i 503'e çevirmek eski bir yöntem; ama SIGTERM geldiğinde pod zaten endpoint'lerden çıkarılıyor, asıl sorun kural güncellemelerinin gecikmesi. preStop sleep bu sorunu doğrudan çözüyor.
Küçük Bir Deneme
★☆☆ Shutdown__WorkerDrainSeconds=40 ver ve pod'u sil. Varsayılan 30 saniyelik grace period'da worker'ın "stopped cleanly" logunu görebiliyor musun? Görmek için hangi iki ayarı değiştirmen gerekiyor?
★★☆ Yük testini preStop sleep 1, 2 ve 5 saniye ile tekrarla ve hata sayısını tabloya dök. Kendi cluster'ında hatanın sıfıra indiği en küçük değeri bul.
★★★ Test client'ını, her isteği aynı bağlantı üzerinden gönderen (keep-alive) bir .NET konsol uygulamasıyla değiştir. preStop'lu ve preStop'suz rollout'ta hataları say; keep-alive bağlantılarının kapanışta nasıl davrandığını (Kestrel'in açık bağlantılara Connection: close göndermesi) loglarla açıkla.
Bu yazıyla serinin temel bloğu tamamlandı: pod'lar doğru başlıyor, doğru trafik alıyor, doğru boyutta çalışıyor ve düzgün kapanıyor. Bir sonraki yazıda production konularına geçiyoruz: HPA (Horizontal Pod Autoscaler) ile yatay ölçekleme, VPA (Vertical Pod Autoscaler), in-place resize, KEDA (Kubernetes Event-driven Autoscaling) ile queue uzunluğuna göre ölçekleme ve PodDisruptionBudget.